第23章:永霖推论——智能涌现与平凡方程
智能不是例外,涌现也不是;它们只是一条平凡方程在不同尺度上的名字。
假设一个模型面前只有三个答案。它现在的信念是
而训练数据留下的先验锚点是
第12章已经证明:只要步长落在合适的窗口里,这个信念会一步一步走向
但“会收敛”和“多快收敛”是两件事。你真正想知道的是:
- 它走几步才到?
- 是不是每个方向都一样快?
- 换一个先验、换一个模型、换一个规模,速度会怎么变?
先看它真的走起来是什么样。下面这张表用第12章的推断算子迭代,步长取
| 误差比值 | |||
|---|---|---|---|
| 0 | 0.648 | — | |
| 1 | 0.217 | 0.335 | |
| 2 | 0.102 | 0.470 | |
| 3 | 0.0438 | 0.429 | |
| 4 | 0.0211 | 0.482 | |
| 5 | 0.00997 | 0.473 |
两三步之后,误差每一步都大约乘上 0.45:
这个 0.45,就是本章的主角。它叫压缩率,记作
本章只做一件事:把这个数算出来,然后在一组真实模型的信念轨道上把它量出来。
这里会碰到另一条著名的曲线:scaling law。把损失画在双对数纸上,横轴是规模,它是一条直线。本章用三答案的单纯形做一件更基础的事:先把
本章走五步
- 23.1–23.3: 把“多快”压缩成一个数
; - 23.4: 说明这个数只由两个端点决定,端点从 Hessian 来;
- 23.5: 把
画成一条半对数直线,算出窗口; - 23.6: 在真实模型上验证切空间柯西列,量出收缩率;
- 23.7: 收束。
如果你时间不多,读 23.1、23.3、23.5、23.6 就够;23.2 和 23.4 回答的是“为什么”。
结论会反复出现同一个对象:
其中
为什么叫“推论”?因为收敛性的发动机仍然是巴拿赫不动点定理,能量面仍然是信息论里的 KL 散度。本章没有换发动机,只是把发动机的功率读出来。
任何以概率单纯形为输出空间的智能系统,都绕不开这一段几何。
永霖推论 = 信息论的能量面 + 巴拿赫的完备性 + 一个速率。
本章的完备性来自巴拿赫不动点定理,而它出自两次世界大战之间的波兰数学学派。学派的故事,以及“为什么要把收敛放进完备空间”的方法论,放在第12章的波兰学派注记里。本章只使用这个结果,不复述历史。
引子:推理与训练是同一条路
先把前向推理和反向训练放在同一张纸上。一次前向传播的输出,是单纯形上的一个点
这里的
反向训练的目标是交叉熵
把它拆开:
数据熵
这正好是
那为什么代码里看到的是 logits 的梯度
对数据分布取期望,就是
反向传播与前向推理共用同一个能量面,也都落在同一个切空间。本章的尺子从头到尾只有一把:切空间上的欧氏范数。
“经验单纯形”就是所有可能输出分布的集合:训练数据给它一个点
训练的反向梯度经过 softmax 雅可比后自动落在
参数空间的更新不在单纯形里;它经过输出映射推前,才落到切空间。所谓“切空间训练”,指的是输出分布的切向运动——参数本身并不在单纯形里走。
在
这就是永霖推论。它不只是“推理时会多快回到先验”,也是“训练最后一段会多快贴住标签分布”。训练把
这是输出分布上的局部动力学:训练最后一段在单纯形上的切向运动。非凸、随机、有限样本和参数化决定怎么进入这一段,不决定这一段的斜率。本章只用切空间上的欧氏范数,KL 只做能量面,不做距离。
“最后一段”足够解释本章要解释的事。训练造出锚点,推理回到锚点;同一个条件数,给两段路定价。
23.1 把“多快”变成一个数
先只看误差
收敛的意思是
先看一维
如果误差是一个数,更新是
矩阵在不同方向上的压缩不一样。它的特征值
长期看,最慢的方向决定一切。 如果两个方向一个乘
所以“多快”不是平均值,是最慢的那个乘数:
把乘数矩阵写出来
推断算子还是第12章那一个:
这里每个符号只做一件事:
是能量面, 是锚点; 是“往哪下山”; 把梯度投到切空间,去掉“所有答案一起加减”的法向分量; 把走出的点拉回概率单纯形。
在锚点处,能量面的曲率是
一步更新的导数——也就是误差的乘数矩阵——是
它的特征值是
别把两套特征值混了:
是能量面 的曲率, 才是一步更新的乘数。前者说“坡有多陡”,后者说“这一步之后误差剩多少”。
为什么是
这不是上界,是精确值。
为什么说它是精确速率,而不是上界
对
(如果初始误差在主导特征方向上的分量不为零;否则只会更快。)
把这段压缩放到真实模型上,就是 23.6 节要做的事:不再画示意图,而是用切空间里的欧氏距离,直接量每一步还剩多少。
读数的方向:
想让“数越大越快”,换两个量。 每步清掉的比例是
别和步长
这也是一笔学习效率的账。 把一次更新看成一次投入:步长
单步的投入产出比可以写成
一句话: 压缩率就是最慢方向的保留比例;每一步之后,误差最多剩下
倍,而且这个“最多”可以达到。
23.2 为什么只需要两个端点
不用。
先看一个更简单的问题。固定步长
画出来:它是一条 V 形折线,最低点在
我们要在区间
引理 23.1. 设
证明. 固定
这个引理把
它还给出稳定窗口的精确边界:
为什么是这个边界?步长太大时,最快模式
一句话: 只需盯住最平的方向和最陡的方向;中间那些特征值改变谱的形状,不改变最坏情况。
23.3 最优步长:让最慢和最快同时到位
现在选步长。
步长太小,慢方向几乎不动,误差早早卡住;步长太大,快方向一步冲过头,来回振荡,甚至发散。最优步长在两者之间。
把两个端点的误差画成两条线:
- 慢模式:
,随 增大而下降; - 快模式:
,随 增大而上升。
一条下降、一条上升,交点就是最优:
在最优点,两个分支相等:
解出
这个步长是两个倒数曲率的调和平均。 令
分别是快模式、慢模式单独归零时的步长。最优步长是它们的调和平均:
它落在
别把这个平均用到速率上。
定理 23.2(永霖推论的速率形式). 在稳定窗口内,
也就是说,最优步长让最慢模式和最快模式以完全相同的速度收缩。
这个速率有四个精确性质,每一个都只需要一行代数:
- 范围。
。当 (所有切向特征值相等)时 ,一步到位;当 时 ,收敛无限慢。 - 单调。
。条件数越大,速率越差,没有例外。 - 可逆。
。速率与条件数是一一对应的:知道速率就等于知道条件数,反之亦然。在这个意义上, 是条件数的完整不变量。 - 只依赖端点。 由引理 23.1,
只由 决定。中间的谱形状不进入公式。
第 3 条值得多看一眼。它说明“收敛多快”与“能量面多各向异性”不是两个独立的问题:它们是同一个数的两种写法。
这四条性质就是四行代数;不需要额外的图来支撑。
回到开头的例子。
这就是表里的 0.183 和 0.45。这里
谱调和步长法。 给定局部曲率界
同样的代数在第 8 章 ADS 的熵调控里出现过:把障碍
一句话: 最优步长不是最快的步长,是让最慢和最快同时到位的步长。
23.4 两个端点从哪里来
现在只剩最后一件事:
取一个
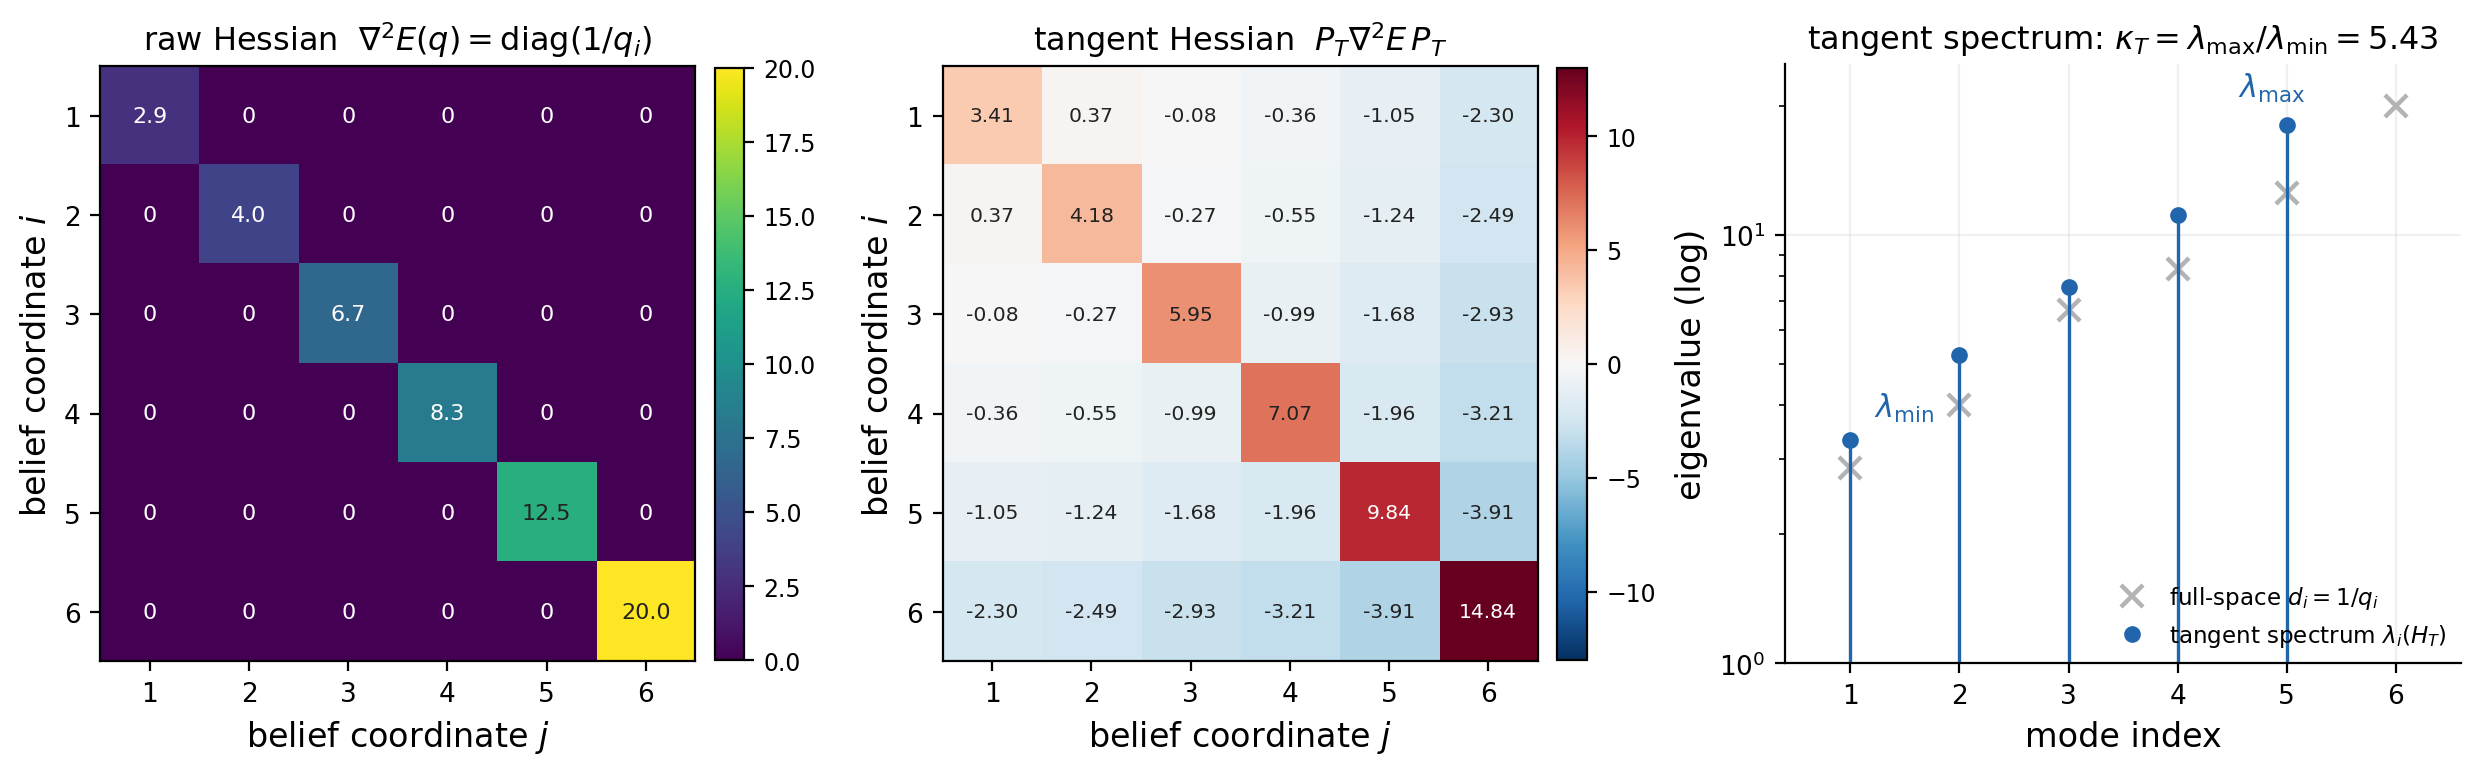
把这张图读成三张图:原始 Hessian、投影之后的 Hessian、以及它的谱。
面板 (a):原始 Hessian——每个答案的“局部硬度”
第
但概率不能独立变化。它们必须加起来等于 1。这个约束会把非对角元“种”进去。
面板 (b):切空间 Hessian——约束把答案耦合起来
投影之后,
读法有三条:
- 每一行加起来为零。 全 1 方向是法向,
。所有答案同时加同一个数,信念不变。 - 对角元为正,总迹变小。
,小于原始迹 。约束吃掉了一部分总曲率。 - 非对角元大多为负,但不是全部为负。 两个最稀有的答案之间耦合很强地为负(
与 之间是 ):抬高一个,必须压低另一个。两个最常见的答案之间有一个小的正耦合( 与 之间是 )。严格的陈述只有两条:行和为零,且在切空间上半正定。
一个类比:六个球穿在一根总长度固定的绳子上。你往左拉一个,其他球必须往右让。约束不是背景,它本身就是耦合的来源。
一个漂亮的特例:当
这是完全图
面板 (c):切空间谱——只需要两端
对这个锚点,切空间谱是
所以
- 最小特征值对应“在前两个最可能的答案之间重新分配质量”的慢模式;
- 最大特征值对应“修正最稀有答案”的快模式;
- 中间的三个特征值,对最优速率没有贡献。这就是引理 23.1 的实际含义。
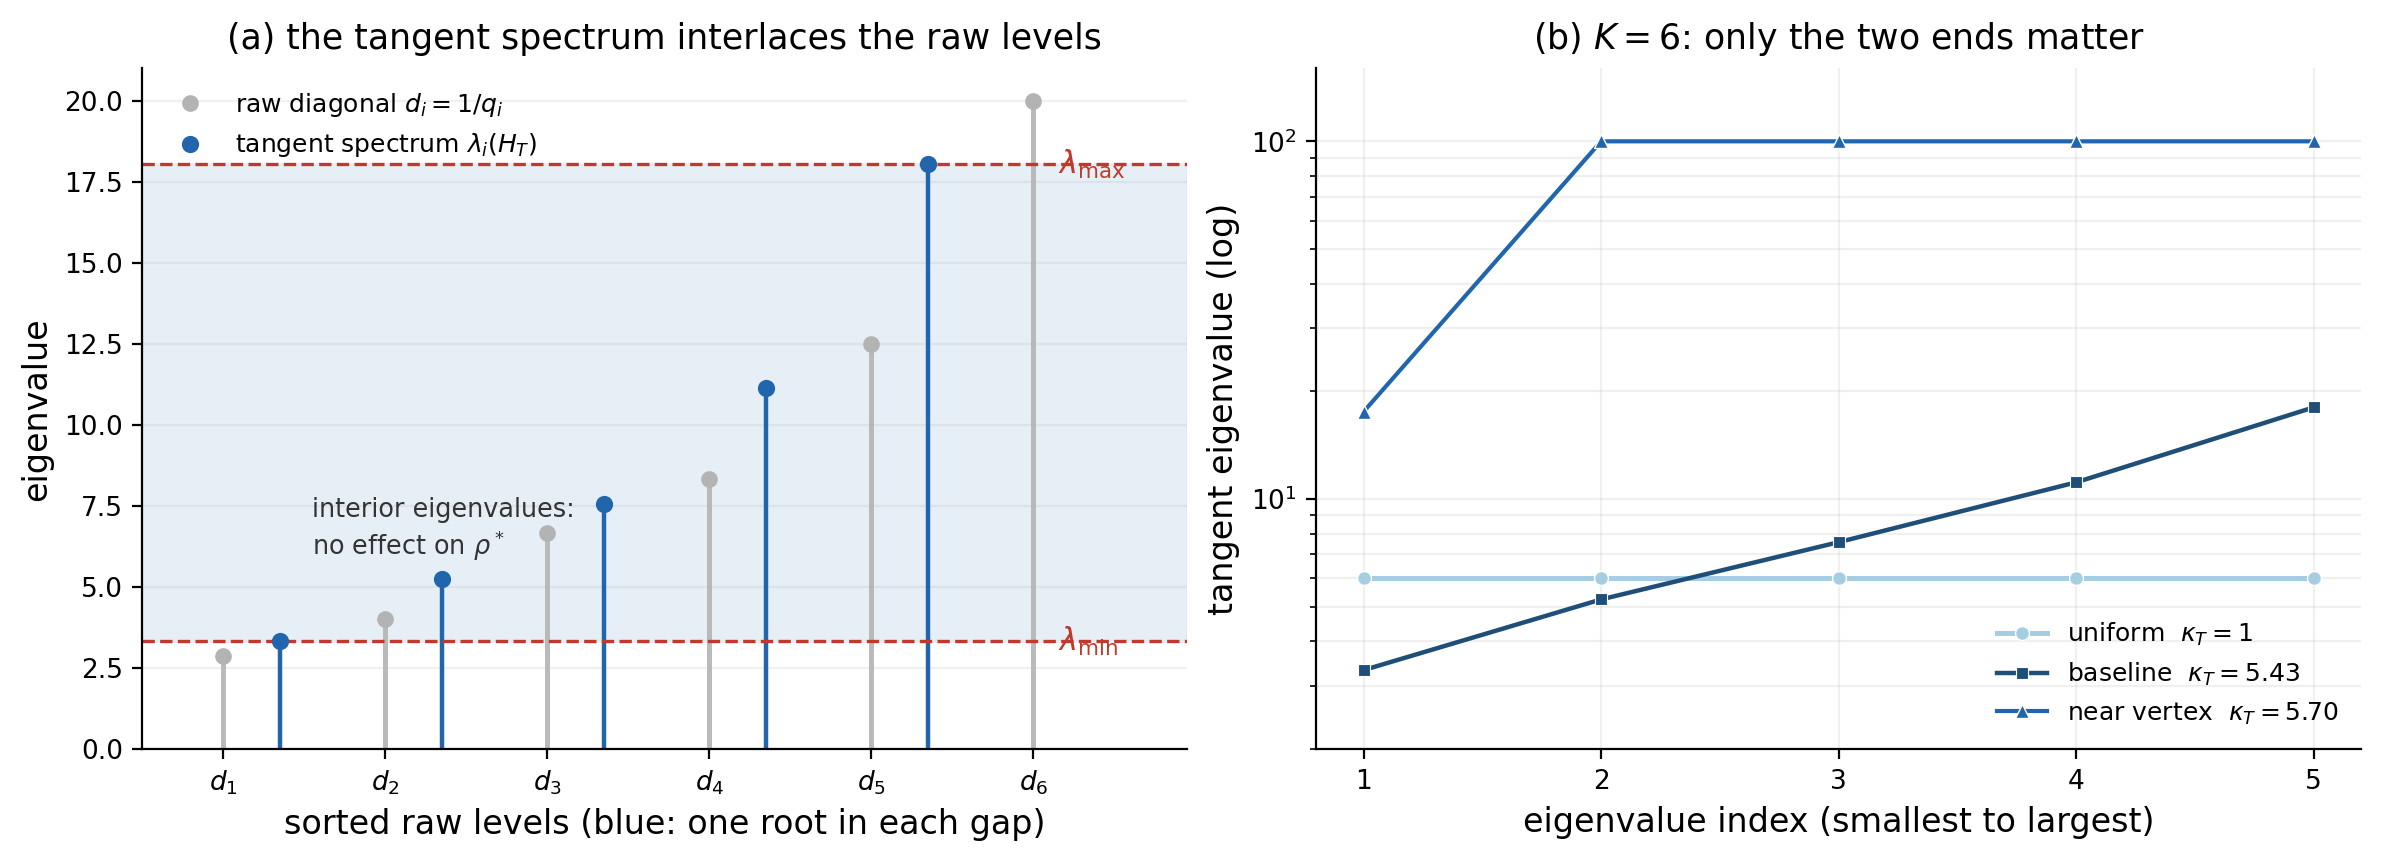
图 23.2 面板 (a) 把久期方程的“交错”画了出来:灰色是原始对角线
如果你想算:切空间谱由一个标量方程决定
设
它的
求
这正是第12章“直接证据”一节里出现的二次方程。
一个漂亮的极限:切空间条件数饱和到
原始 Hessian 在边界上会爆炸:
全空间条件数
数值上,
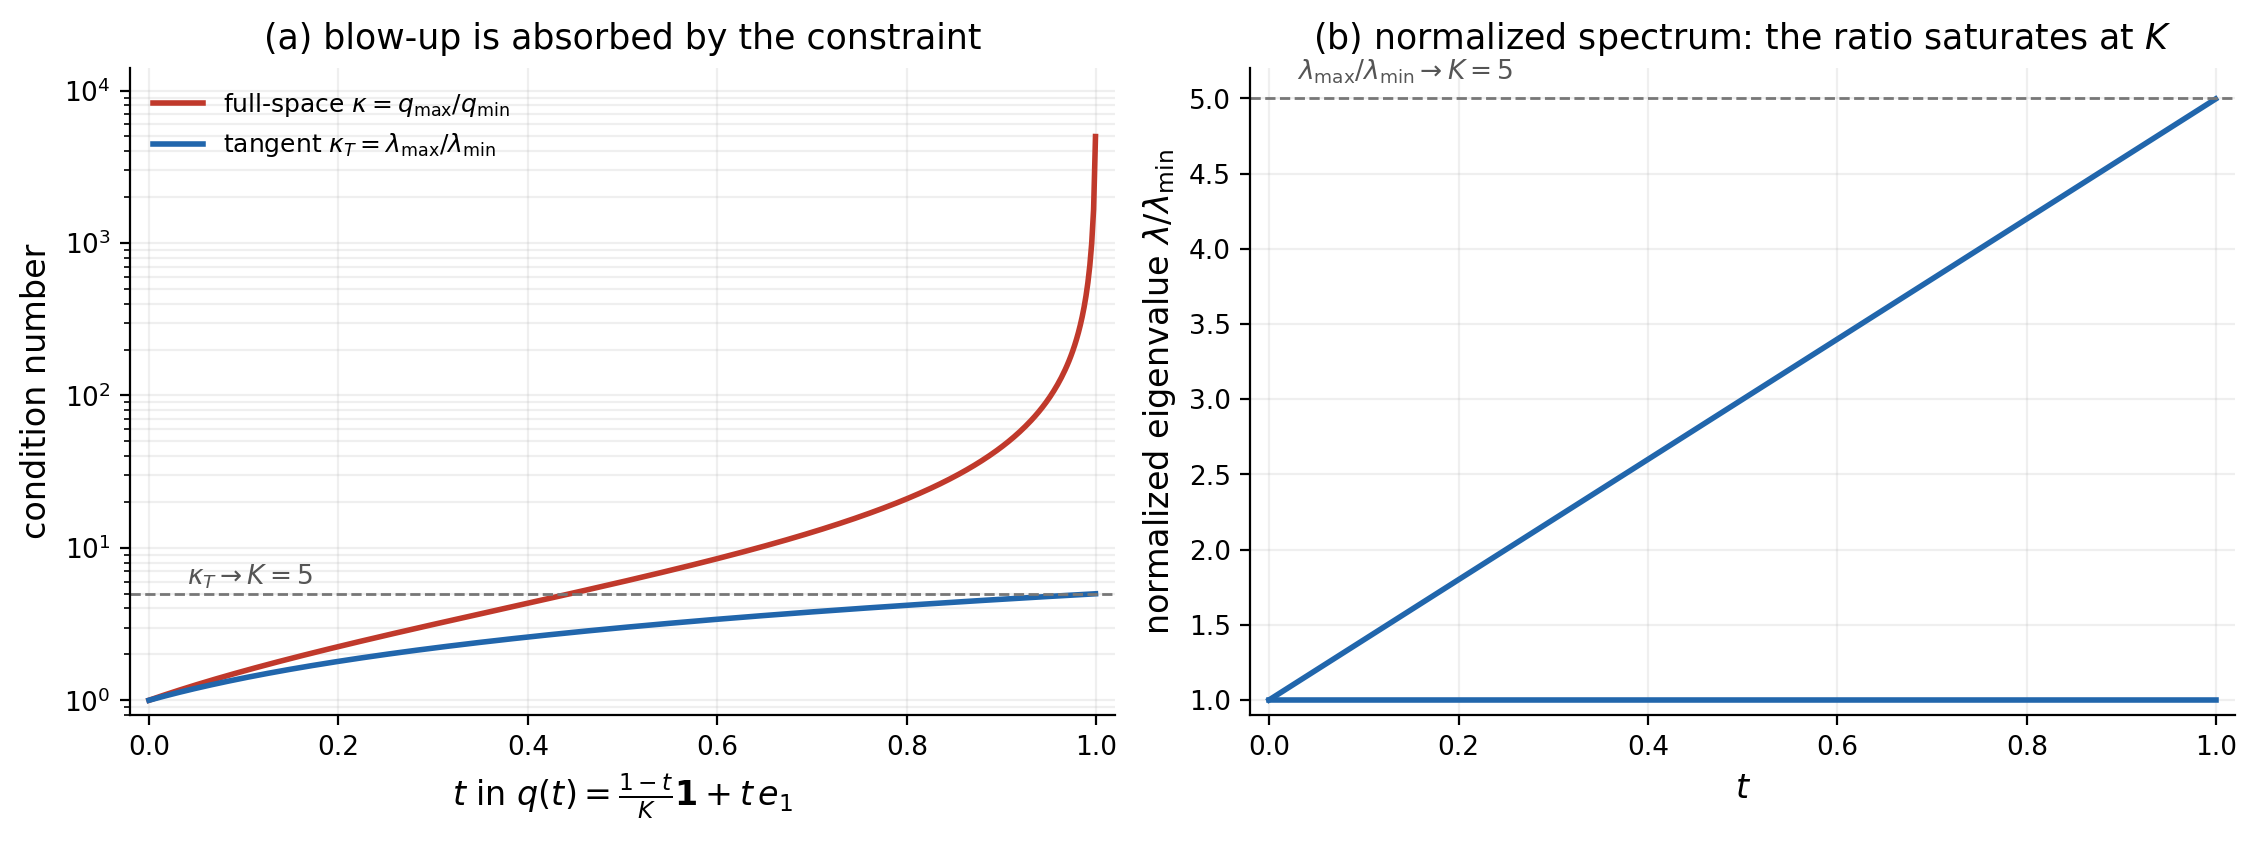
图 23.3 面板 (a) 是
一句话: 端点不是猜的,是矩阵交出来的;约束把“一个极小的概率”的爆炸,摊成了“
个答案之间”的耦合。
23.5 速率就是对数曲线的斜率
回到表。误差是
从第三个开始,每步大约乘
这是
“几何收敛”四个字的意思也在这里:不是每次减少同样的距离,而是每次按同样的比例缩短。
这里要分清两种坐标:
- 几何收敛在半对数坐标上是直线;
- 幂律在双对数坐标上是直线。
它们是两种不同的定律,不是同一条曲线的两种画法。下一节的图 23.4 会用真实模型的轨道把这两种坐标各画一次:半对数上接近直线,双对数上弯曲。
以速率
对基线
也就是说:大约三步。这与开头的表一致——第 2 步误差还是
下面给出一个更硬的说法:不用先算
定理 23.3(窗口的精确线性界). 对
证明
令
两个标准不等式给出
代入
取倒数再乘
这两个界都是精确的,不是渐近近似。它们把窗口夹在两条斜率分别为
对基线
窗口落在界内,并且上下界只差
一句话: 速率就是斜率;窗口是算出来的,不是感觉出来的。
下一节把这条区别带到真实模型上:如果轨道是几何收敛,半对数应该是直线;如果是幂律,双对数才应该是直线。我们用同一组 API 数据把两种坐标都画出来。
23.6 工业级验证:在真实模型上量一条柯西列
上一节把两种坐标分开了:几何收敛在半对数上是直线,幂律在双对数上才是直线。现在把尺子拿到真实模型上,量一条真实的信念轨道。
这里的“工业级”指的是三件事:接口是真的(DeepSeek 的 chat completions),协议是固定的(同一提示、同一温度、同一步数),数据是可审计的(采数代码、分析代码、图都写在下面)。一个模型、两个任务,是一个案例;案例的每一步都留在仓库里,可以被重跑、被反驳。
为什么把尺子搬到切空间
先解决一个度量问题。你可能想直接量相邻两步的 KL:
它不能当距离用。KL 不对称,不满足三角不等式;开放单纯形
也不是完备度量空间。在这样一个空间里谈“柯西列”,定义本身就不成立。
做法是把信念搬到切空间。令
对
并定义坐标
因为任意两个概率向量之差都落在
等价地,定义尾径
序列是柯西列,当且仅当
如果报告信念的更新映射
那么任意轨道都自动是柯西列:
并且由巴拿赫不动点定理,不动点
还有一把尺子值得对照。Bregman 切范数
是 KL 在
为什么
令
乘上
所以
一句话: 不在单纯形上量 KL,把信念搬到切空间,用欧氏距离量柯西列。
实验设计:两个任务,三种起点
实验协议:每步把当前信念写成一行文本,要求模型不要重新解题,只朝证据方向做一个小调整,并在最后用 \boxed{} 框出更新后的三元组;这个三元组就是下一步的输入。温度 0,每个任务三个起点,各 12 步。
实验用两个同族但条件数不同的任务。
任务 C3(两次 Blue 报告)。 袋子里有 7 个红球、2 个蓝球、1 个黑球。检测器以
似然是
贝叶斯后验是
任务 C4(一次 Blue 报告)。 同样的检测器,袋子里三种颜色各 4 个,先验是均匀的;只报告一次 Blue。于是
为什么选这两个?因为它们共用一套几何,却把条件数拉开:C3 的
每个任务从三个起点出发:
第一个是黑球主导,第二个是中性,第三个是红球主导。三个起点离得很远,用来检验它们是否落到同一个不动点。每个任务迭代 12 步,温度
在本章的记号里,
一句话: 两个条件数、三个起点、十二步,检验的是同一个不动点和同一条压缩律。
结果:几何成立,模型有自己的步长
先看表。
| 任务 | 三条轨道的 | 半对数 | ||
|---|---|---|---|---|
| C3(两次 Blue) | 8.60 | 0.792 | 0.610 / 0.653 / 0.753 | 0.911–0.982 |
| C4(一次 Blue) | 2.10 | 0.355 | 0.711 / 0.754 / 0.753 | 0.831–0.927 |
三条轨道是黑球主导、均匀、红球主导三个起点;
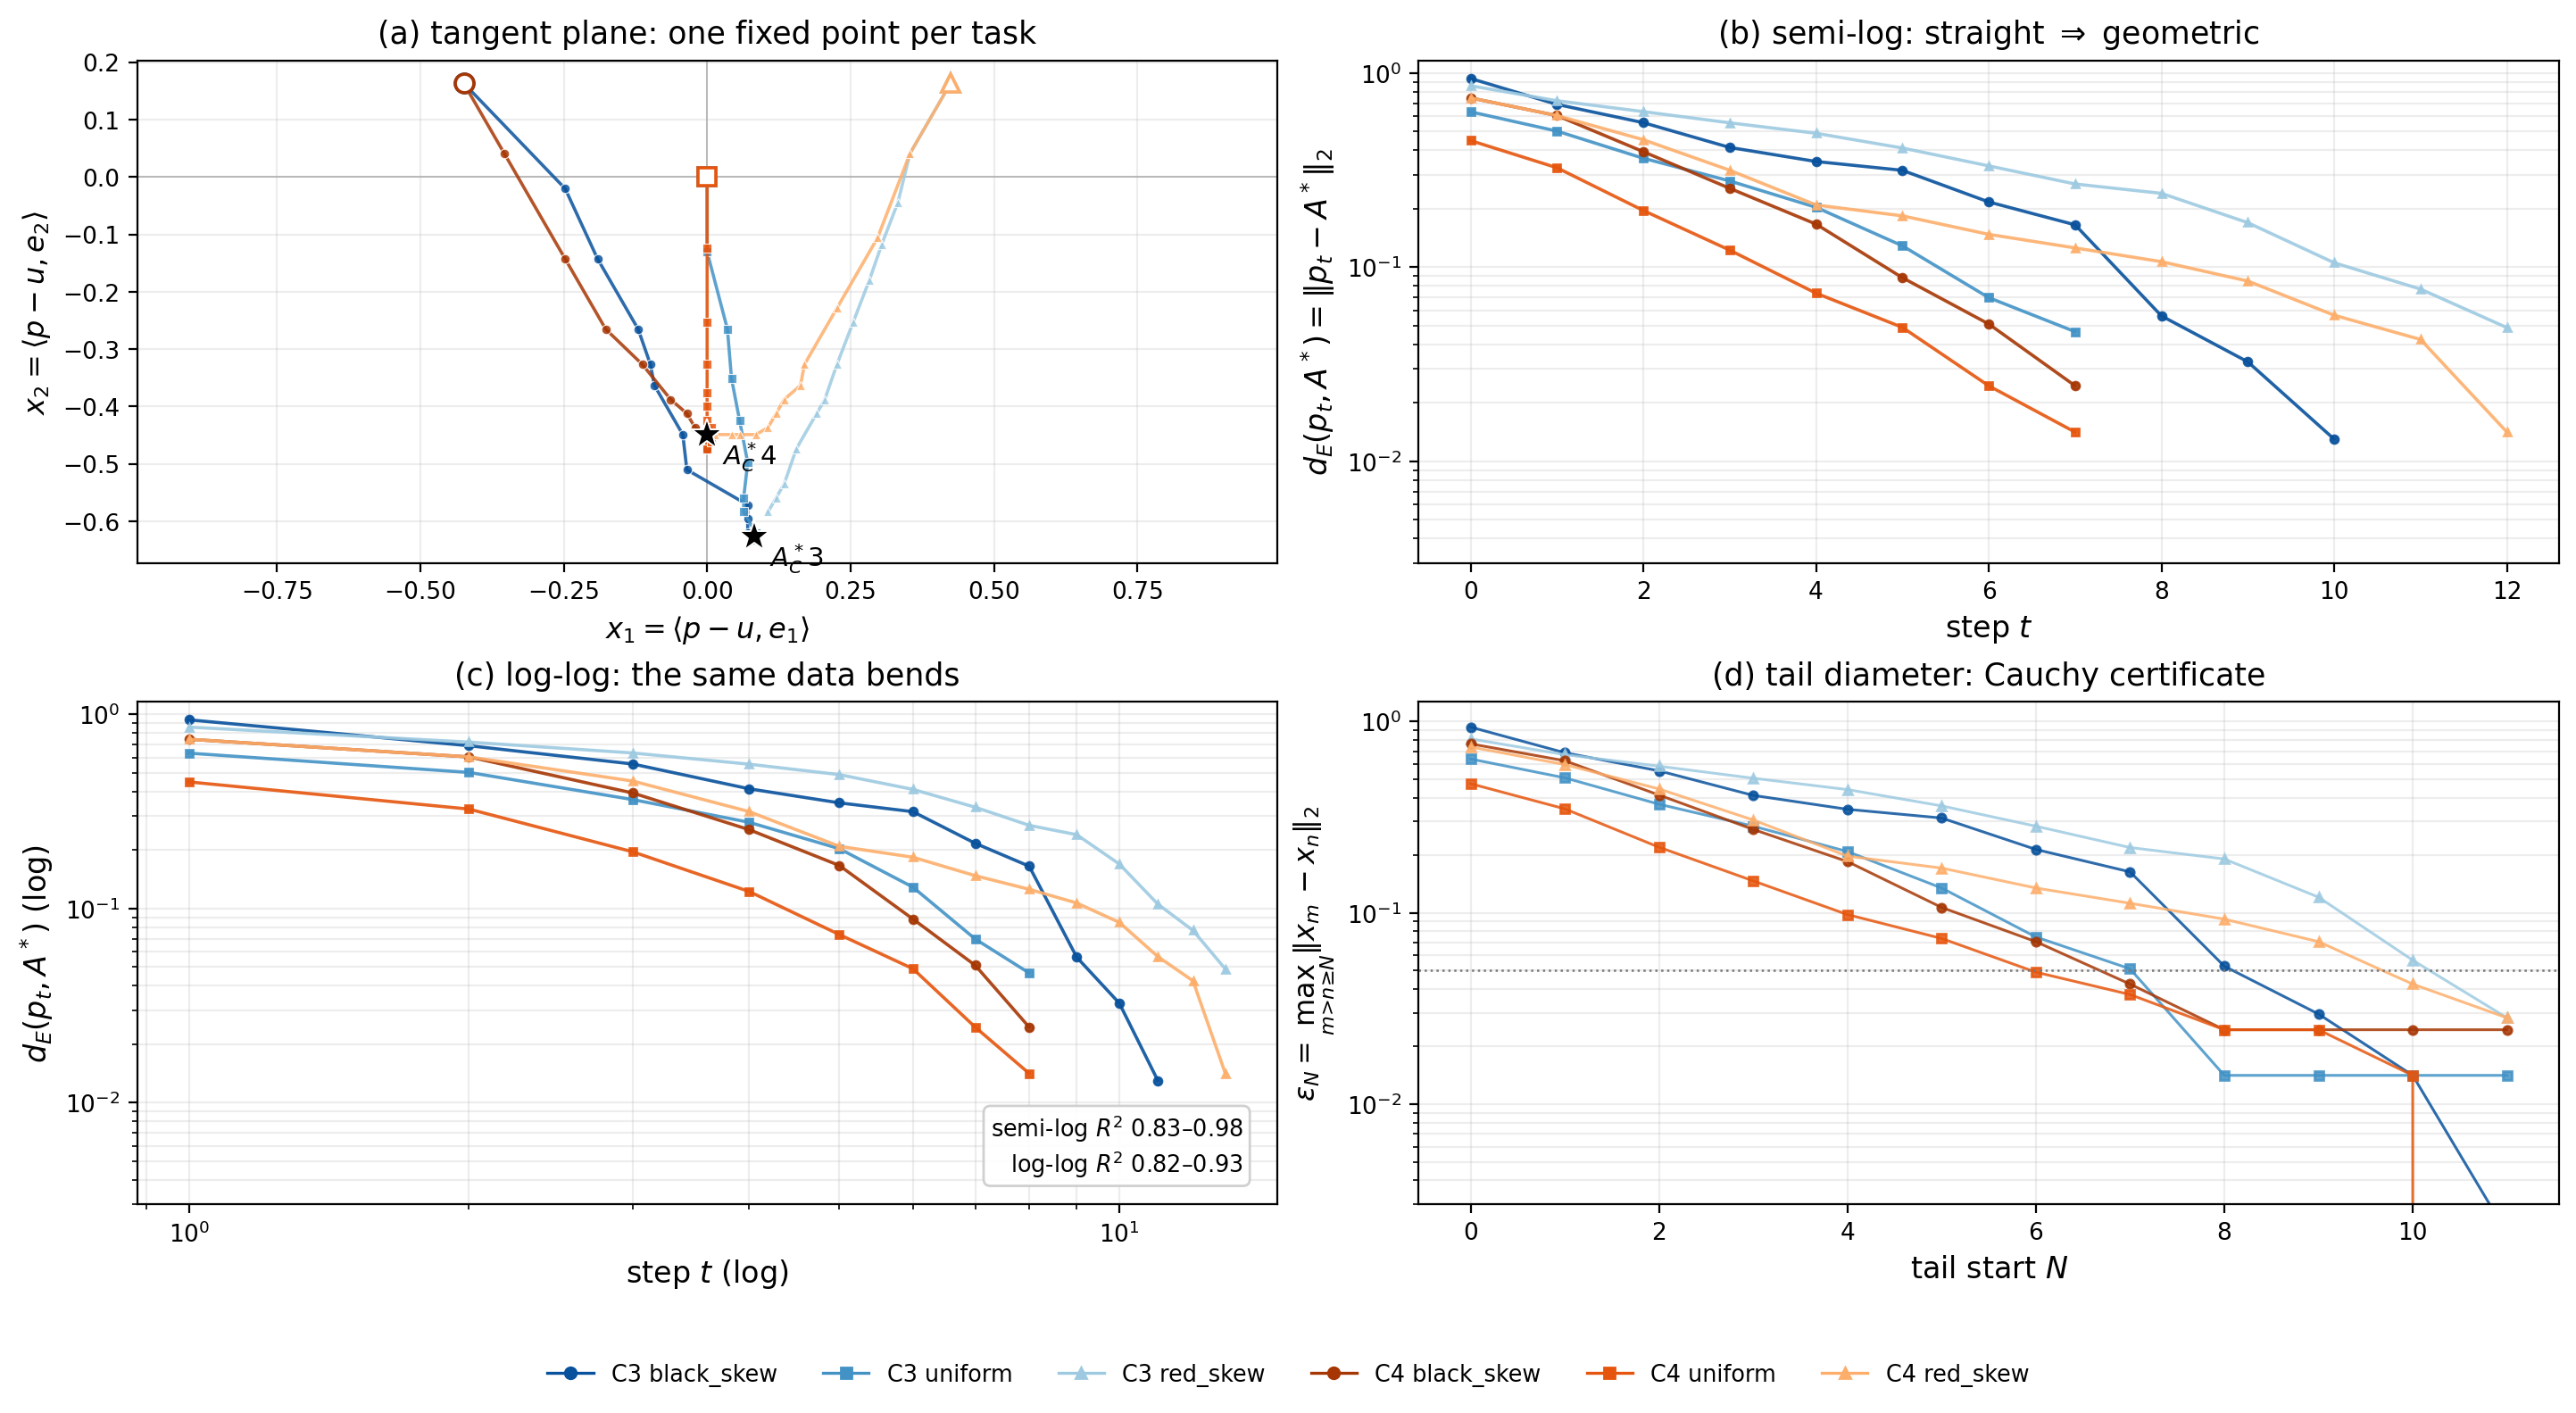
图 23.4 有四个面板,读法如下。
(a) 切平面:先看有没有共同的不动点。 横轴是
(b) 半对数:再看是不是几何收敛。 纵轴是
(c) 双对数:检查它是不是幂律。 横轴是
(d) 尾径:最后看柯西证书。 纵轴是
读图的顺序可以记成六个字:定点、定律、证书。 (a) 定点,(b)(c) 定律,(d) 证书。
现在说结果里最值得注意的地方。C3 三条轨道的
是定理 23.2 在最优步长 下给出的最优速率,即 。它是理想投影梯度算子的最小压缩因子,也是理论上能达到的最快收敛速度。 是模型在“一小步调整”提示下走出的速率。它用多大的步长,由模型自己决定。
C4 的差异说明模型没有停在
把调和平均代进去,两个任务各自的最优步长是:C3 的
两次实验的
这一步之后,误差最少剩
模型的步长没有直接写在输出里。实验设计希望它是一个不随任务调整的步长;把它记作公共的
要求两次实验的每一条轨道都落在自己的带里。最紧的两条约束是:C4 的最低速率要求
(上端保守地向下取)。取
| 实验 | 带宽 | 三条轨道 | ||
|---|---|---|---|---|
| C3 | 0.58 | 0.82 | 0.24 | 0.610 / 0.653 / 0.753 |
| C4 | 0.71 | 0.86 | 0.15 | 0.711 / 0.754 / 0.753 |
C3 的三条轨道全部落在自己的
这也把“经济学”说清楚了:带宽不是误差棒,而是同一个步长下不同模式留下的不同保留比例。
这也划出了实验能说什么。单看一个任务的速率,分不出步长;把两个任务放在同一个有效步长下,两条带同时包住各自的采样,才把步长限定在
读成两个存在性命题。 一个任务在固定步长下,合法速率是一条带,不是一条线:
把两个任务并排看:C3 的带更宽、位置更低,C4 的带更窄、位置更高;两条带在
这是证明,不是精度。 把命题写成类型:存在一个公共步长
柯里–霍华德同构的同一点。 存在命题的证明就是构造它的居民;现在有两个存在命题,所以有两个居民。实验不是给每个采样点发一张“最优”证书,而是看每个任务的读数是不是都住在自己的带里。这不是见证逻辑:采样不负责见证最优,只负责证明自己住得进去。C3 的三条住进 C3 的带,C4 的三条住进 C4 的带;两个构造都成立。反过来,如果所有样本都精确落在各自的
这一步证到什么程度。 它是在这两组任务、六个起点、十二步窗口里的两个存在性证明。
每个居民两条线就够了。 这是存在性构造,不是统计估计。构造一个任务的居民只需要两个端点:
这是健康上下界,不是封神区间。 居民带不是逐点拟合出来的;给定公共步长,它由切空间谱直接算出来,不拟合每条轨道的速率。公共步长本身从数据反推,是唯一从数据来的量;它取成让两条带同时包住六条轨道。这是构造,不是无数据的预测。带给的是一条健康带宽,不是“落在里面就最优”的通行证。带内大多数位置只是合法、正常、能收敛;靠近
顶级模型也在区间里。 这不是“DeepSeek 恰好合格”,而是构造在起作用:只要模型在单纯形上做小步贝叶斯更新,它的合法速率就落在所在任务的
这正是实验的价值:它验证了几何和不动点,量出了模型离最优步长有多远,也验证了两个居民都不是空的。
- 验证了几何。 六条轨道都在切空间里收缩,半对数大体接近直线,不动点是证据一致的后验,尾径下降。
- 验证了不动点。 C3 和 C4 的轨道分别落到各自的后验;起点不同,落点相同。
- 验证了两个居民。 C3 和 C4 各自有一条带,六条轨道全部落在自己的带内;不是一个大区间勉强包住所有点,而是两个带各自成立。
- 量出了步长。 两次实验把公共有效步长限定在
– 。模型走的是自己的合法步长,不在最优点。 量的是理想算子; 量的是模型。
还有两个技术细节。第一,六条轨道上
一句话: 两个居民同时存在;C3 的采样住在 C3 的
里,C4 的采样住在 C4 的 里。 是各自的最优线, 是模型的实际速率。
代码:把审计留在正文里
工业级验证和玩具实验的区别,不在于代码更长,而在于别人能不能沿着代码重走一遍。下面两段代码,一段采数,一段分析;注释用英文,只写坐标系、边界和选择理由。
除标准库外,两段代码只依赖 httpx 和 numpy;key 从环境变量读,正文不出现。
采数代码:
import json
import os
import re
import time
from pathlib import Path

import httpx

BOX = re.compile(r"boxed\s*\{([^{}]*)\}", re.I | re.S)
NUM = re.compile(r"-?\d+(?:\.\d+)?")

QUESTION = """Question: A bag contains 7 red balls, 2 blue balls, and 1 black ball.
The balls are otherwise identical. A detector examines a ball drawn at random
and reports its color. The detector is correct with probability 0.70; when it
is wrong, it reports each of the other two colors with equal probability.
The detector reports "Blue" on the first draw and "Blue" on the second draw
(after replacing the ball). Which color is the drawn ball most likely?"""


def ask_once(client, url, key, belief, decimals=2):
    """One API call. Return the reported belief as a probability vector.

    The model sees the current belief and is asked for one small adjustment;
    the boxed triple is the next point of the reported orbit.
    """
    user = (
        QUESTION
        + "\n\nCurrent belief: "
        + f"(red={belief[0]:.4f}, blue={belief[1]:.4f}, "
          f"black={belief[2]:.4f}).\n"
        + "Reconsider the question from the statement and make one small "
          "adjustment to your belief in the direction the evidence points. "
          "Do not re-solve the problem from scratch.\n"
        + f"At the very end, box the updated belief with {decimals} decimals "
          "in the order Red, Blue, Black, summing to 1."
    )
    body = {
        "model": "deepseek-flash",
        "messages": [{"role": "user", "content": user}],
        "thinking": {"type": "disabled"},
        "reasoning_effort": "none",
        "temperature": 0.0,       # greedy decoding; no sampling temperature
        "max_tokens": 2048,
    }
    r = client.post(url, json=body,
                    headers={"Authorization": f"Bearer {key}"}, timeout=120)
    r.raise_for_status()
    text = r.json()["choices"][0]["message"]["content"]
    for box in reversed(BOX.findall(text)):
        nums = [float(x) for x in NUM.findall(box)]
        if len(nums) == 3 and sum(nums) > 0:
            s = sum(nums)
            return tuple(x / s for x in nums)   # tolerate tiny rounding drift
    return None


def run_orbit(client, url, key, start, steps=12):
    """Iterate the reported-belief map and return the orbit."""
    path = [tuple(start)]
    for _ in range(steps):
        q = ask_once(client, url, key, path[-1])
        if q is None:
            break
        path.append(q)
        time.sleep(0.2)       # keep the request rate modest
    return path


STARTS = {
    "black_skew": (0.10, 0.20, 0.70),
    "uniform": (1 / 3, 1 / 3, 1 / 3),
    "red_skew": (0.70, 0.20, 0.10),
}
A_STAR = (0.1358, 0.8448, 0.0194)   # C3 posterior; swap in C4's for task c4


def save_orbit(task, A_star, orbits):
    """Write one experiment file next to this script."""
    path = Path(".") / f"ch23_orbit_{task}.json"
    path.write_text(json.dumps({"task": task, "A_star": A_star,
                                "orbits": orbits}, indent=1),
                    encoding="utf-8")
    return path


key = os.environ["DEEPSEEK_API_KEY"]   # read from the environment; never print it

url = "https://api.deepseek.com/chat/completions"
with httpx.Client() as client:
    orbits = {name: run_orbit(client, url, key, start)
              for name, start in STARTS.items()}
print(save_orbit("c3", A_STAR, orbits))
把三个起点各跑一遍,轨道写进 ch23_orbit_c3.json;分析代码从同级目录把它读回来。C4 只需把 QUESTION 换成一次 Blue 报告的题面,轨道写进 ch23_orbit_c4.json。
分析代码:
import json
import math
from pathlib import Path

import numpy as np

HERE = Path(".")
U = np.array([1 / 3, 1 / 3, 1 / 3])
E = np.array([[1, 0, -1], [1, -2, 1]], float)
E /= np.linalg.norm(E, axis=1, keepdims=True)


def load_orbit(task):
    """Read the JSON written by the collector from this directory."""
    path = HERE / f"ch23_orbit_{task}.json"
    with open(path, encoding="utf-8") as f:
        return json.load(f)


def tangent(p):
    """Coordinates of p - U in the orthonormal basis of T."""
    return E @ (np.asarray(p, float) - U)


def spectrum(A):
    """2x2 matrix of P_T diag(1/A) P_T in the tangent basis."""
    m = 1.0 / np.asarray(A, float)
    h11 = 0.5 * (m[0] + m[2])
    h22 = (m[0] + 4 * m[1] + m[2]) / 6
    h12 = (m[0] - m[2]) / math.sqrt(12)
    return np.array([[h11, h12], [h12, h22]])


def rho_star(A):
    """Optimal contraction rate from the two tangent eigenvalues."""
    lam = np.linalg.eigvalsh(spectrum(A))
    kappa = lam.max() / lam.min()
    return kappa, (kappa - 1) / (kappa + 1)


def distances(P, A):
    """Euclidean distance in T; equals ||p - A||_2 because p - A is in T."""
    X = np.array([tangent(p) for p in P])
    return np.linalg.norm(X - tangent(A), axis=1)


def fit_rate(d, floor=1e-2, dmax=0.5):
    """Fit log10 d = a + b t near the anchor; return rho = 10**b."""
    t = np.arange(len(d))
    m = (t >= 1) & (d > floor) & (d < dmax)
    if m.sum() < 2:
        return float("nan")
    b, _ = np.polyfit(t[m], np.log10(d[m]), 1)
    return 10 ** b


for task in ("c3", "c4"):
    data = load_orbit(task)
    A = np.array(data["A_star"], float)
    kappa, rho = rho_star(A)
    print(f"{task}: kappa_T={kappa:.3f}  rho*={rho:.3f}")
    # common effective step inferred from the two bands (see text)
    vals = np.abs(1 - 0.044 * np.linalg.eigvalsh(spectrum(A)))
    print(f"  band at eta=0.044: m={vals.min():.2f}  rho={vals.max():.2f}")
    for name, P in data["orbits"].items():
        d = distances(np.array(P, float), A)
        print(f"  {name:10s} rho_E={fit_rate(d):.3f}")
这段代码对每条轨道单独拟合,正文表里的三个数就是它逐行打印的 rho_E;band at eta=0.044 那一行打印每个任务的 ch23_orbit_c3.json 和 ch23_orbit_c4.json,由采数代码写在同级目录;同样的近锚点窗口和拟合方式,也用于图 23.4 的面板 (b) 和 (c)。
一句话: 代码不是附录里的装饰;它是让结论可以被审计的那一部分。
这个实验管什么
这条轨道是模型报告的信念,不是内部激活。报告是接口能给出的全部,也是读者能重跑的部分。
它只对“小幅调整”这个映射成立。同一道题,“立即回答”和“小幅调整”给出不同的不动点;换提示就是换映射。第12章的定理对固定映射说;这里把证据写进题面,锚点随之变成证据一致的后验。
它是 12 步、两位小数的窗口,一个模型、两个任务。这是这次实验的全部数据:窗口里的经验速率、尾径和不动点。把这里的数值当成普适常数,是误读;把同一套方法搬到别的模型和任务上,是下一步。
一句话: 窗口有限,结论明确:在这个窗口里,轨道是柯西列,几何成立。
23.7 结语:智能涌现与平凡方程
回到开头:三个答案,初始误差
这个数就是
它和它背后的
- 斜率。 半对数误差曲线的斜率是
。 - 步数。 到达
的步数精确地夹在 与 之间。 - 稳定性。 稳定窗口是
,最优步长是 。 - 经验读数。 真实模型的报告信念在切空间里是柯西列;半对数大体接近直线,双对数弯曲;不动点是证据一致的后验;实测
在三条轨道上为 C3 – 、C4 – 。这是模型在“一小步调整”下走出的速率。几何在真实轨道上成立,步长由模型自己决定。 - 涌现的判据。
不变而指标跳变,是读数; 跳变,才是动力学。
整条链只有三步:
一个数,由两个端点决定;两个端点,由切空间 Hessian 决定;切空间 Hessian,由锚点和单纯形约束决定。
第12章说:推理会收敛到先验锚点
多快,由一个条件数决定;条件数由切空间 Hessian 的两个端点决定;两个端点由矩阵决定。除此之外,没有第二个标量。
现在可以说清楚 scaling law 里哪一部分是平凡的,哪一部分不是。平凡的是它的格式:只要输出落在单纯形上、损失用 KL 记、样本是数出来的,
本章没有复现某一家公司的曲线,也没有用一个玩具去冒充它。本章量的是那条曲线背后的同一条几何:一个把输出放在单纯形上的系统,收敛会按
智能与涌现之所以看起来像奇迹,往往是因为我们只盯着某一个读数;把读数放回曲线上,它们就只是同一条平凡方程在不同尺度上的名字。
一句话: 曲线不专属于某一家公司,速率也不专属于某一个模型;它们属于所有在单纯形上收缩的轨道。
悬而未决
离开锚点邻域之后,速率怎么估? 本章的
能不能在大规模模型上直接测
12 步和两位小数够不够? 23.6 的柯西证书只覆盖一个有限窗口;两位小数的读出下限约在
为什么换一个接口,不动点就变了? 23.6 的“小幅调整”收敛到证据一致的后验;早先的“立即回答”却收敛到先验主导的点。哪个映射才是模型真实的推理动力学?这需要把接口、提示和读出方式都当成变量,而不是把某一次读出当成模型的全部。
思考题
★ 热身
- 用开头的表验证:误差比值从哪一步开始稳定在
附近?为什么第一步的比值明显更小? - 对
、 ,验证 ,写出它的全部特征值,并算出 。 - 对
,用久期方程算出 ,再算 与 。 - 用 23.6 的表,分别看 C3 三条轨道的
与 差多少;再用 C4 做同样的计算,比较两个任务的差值范围。
★★ 推导
- 证明引理 23.1:凸函数
在区间上的最大值在端点取得。 - 证明
。 - 证明定理 23.2:
是唯一最小值点, ,且两个端点分支在最优点的值相等。 - 证明定理 23.3 的两个界:
。 - 证明:对任意两个概率向量
, ,且 。再证明 上的欧氏范数与 Bregman 切范数 等价,并给出等价常数。 - 证明:若
满足 且 ,则任意轨道都是柯西列,极限唯一,且 。
★★★ 挑战
- 对
,把久期方程写成 ,并验证它与第12章的二次方程一致。 - 设计一个实验,只通过测量
随规模的变化,区分“读出效应”和“谱分岔”。说明每种情况下你会看到什么,以及如何排除混淆变量。 - 尝试构造一个反例,说明离开锚点邻域、二阶项不可忽略时,欧氏线性化速率
不再是精确速率;再说明需要加什么条件才能恢复一个精确的速率公式。 - 把 23.6 的 12 步延长到 30 步,或把输出精度提高到 6 位小数,重新估计
。如果 稳定但远离 ,说明模型的步长不是 ;如果它随窗口明显漂移,说明有限窗口还不够。设计一个能区分这两种解释的对照实验。
参考文献
- Banach, Stefan (1922). “Sur les opérations dans les ensembles abstraits et leur application aux équations intégrales.” Fundamenta Mathematicae 3(1), 133–181. DOI: 10.4064/fm-3-1-133-181.——压缩映射原理的原始文献
- Schaeffer, Rylan; Miranda, Brando; and Koyejo, Sanmi (2023). “Are Emergent Abilities of Large Language Models a Mirage?” arXiv:2304.15004.——涌现的度量伪影
- Wei, Jason; Tay, Yi; Bommasani, Rishi; Raffel, Colin; Zoph, Barret; Borgeaud, Sebastian; Yogatama, Dani; Bosma, Maarten; Zhou, Denny; Metzler, Donald; Chi, Ed H.; Hashimoto, Tatsunori; Vinyals, Oriol; Liang, Percy; Dean, Jeff; and Fedus, William (2022). “Emergent Abilities of Large Language Models.” arXiv:2206.07682.——涌现现象的系统描述
- Nesterov, Yurii (2018). Lectures on Convex Optimization, 2nd edition. Springer Optimization and Its Applications 137. Springer. DOI: 10.1007/978-3-319-91578-4.——强凸、光滑、步长与条件数
- Boyd, Stephen; and Vandenberghe, Lieven (2004). Convex Optimization. Cambridge University Press. DOI: 10.1017/CBO9780511804441.——投影的非扩张性与收敛率
- Cover, Thomas M.; and Thomas, Joy A. (2006). Elements of Information Theory, 2nd edition. Wiley.——KL 的局部二次展开与经验分布的协方差
- 本书第12章,永霖公式——永霖定理的全局版本、切空间谱界与直接证据