Chapters
On this page
双足系列
围绕双足、轮腿双足与人形机器人的高动态欠驱动平衡、强化学习与跨仿真验证,涵盖两条完整动手主线:一条是基于 NVIDIA Isaac Lab + 约束式强化学习(CaT)+ ONNX + MuJoCo Sim2Sim 的 8 自由度两轮足 Flamingo 6 章完整课程;另一条是从交互式奖励实验进阶到跑—跳—越墙—前滚翻—起身 12 步长链课程的 MicroDuck RL。
🗂️ 项目总览
| 分类 | 项目 | 简介 |
|---|---|---|
| 轮足完整课程(6 章) | 两轮足 Flamingo · Isaac Lab | 围绕 8 自由度双足轮腿机器人,从延迟/齿轮执行器建模、4096 环境并行 PPO、约束式强化学习(CaT),一路打通 ONNX 融合导出与 MuJoCo 零样本抗扰动压测 |
| 入门动手主线 | MicroDuck RL:教小黄鸭学会一个动作 | 通过网页内动作回放与奖励设计互动实验建立直觉,再用 mjlab + MuJoCo Warp 启动第一次双足 PPO 训练 |
| 进阶课程学习 | MicroDuck 跳墙课程:12 步复现跑跳滚翻全链 | 用 12 步课程串联助跑、起跳、越过 5 cm 矮墙、前滚翻与起身继续跑,拆解镜像对称损失、防套利奖励与反向课程破局 |
| 评测与探索 | MicroDuck:实验记录与创意动作 | 轮式起身、轮式转向、踢球收势与多模式固定条件离屏验收数据及创意动作探索 |
| AMD 专区旗舰 | MicroDuck RL|AMD ROCm | 在 Radeon AI PRO R9700 上从源码编译 ROCm Warp / MuJoCo Warp,修复动态接触缓存并完成双足 PPO 长训 |
| 规划章节 | 平衡控制 / 运动跟踪 / 任务规划 Demo | 双足抗扰动平衡、全身动作重定向跟踪(Motion Tracking)与高层任务规划(施工中) |
🎬 典型演示
两轮足 Flamingo · Isaac Lab 大规模并行训练
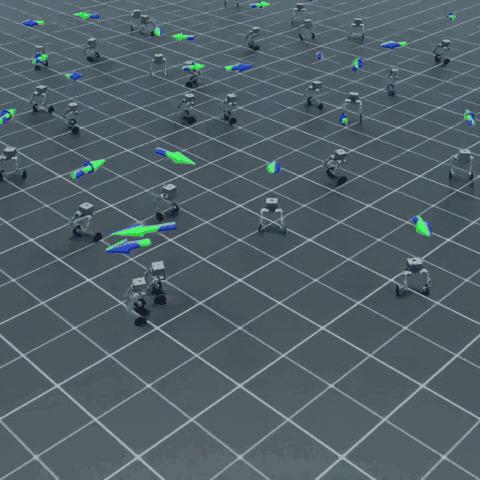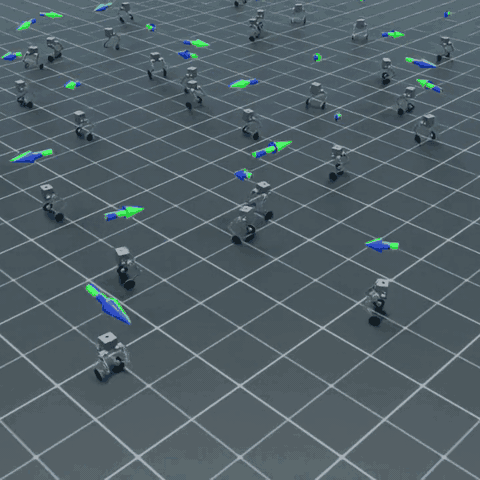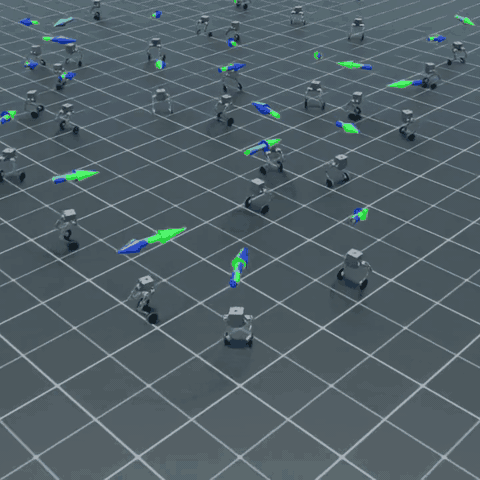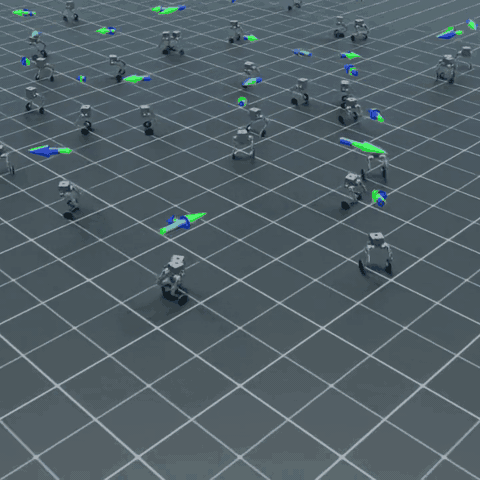 两轮足 Flamingo · Isaac Lab 6 章完整实战课程 8 自由度轮腿欠驱动动态平衡 · PPO vs CaT 约束式强化学习 · ONNX 导出与 MuJoCo 零样本抗扰动压测 |
|---|
MicroDuck 基础动作与固定条件验收
 MicroDuck 稳定行走与轮式转向 mjlab + MuJoCo Warp · 固定条件零倒地帧回放 | 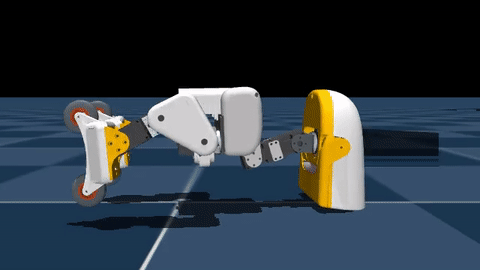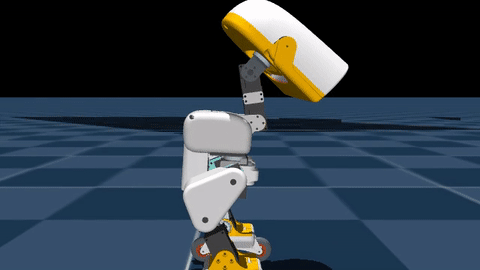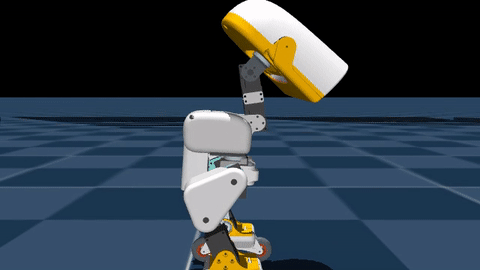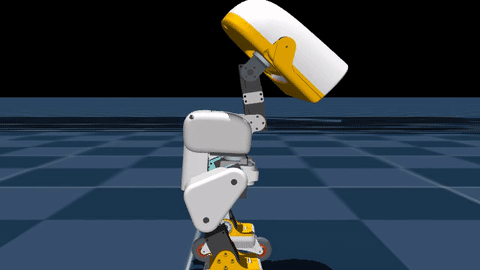 MicroDuck 趴地自主起身 RollerStandUp · 从俯卧状态发力起身并恢复直立平衡 | 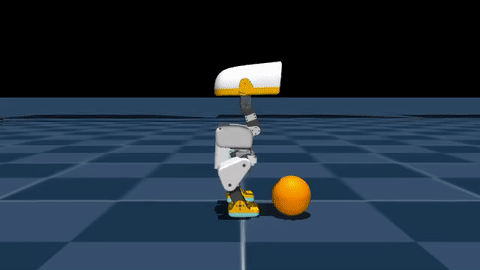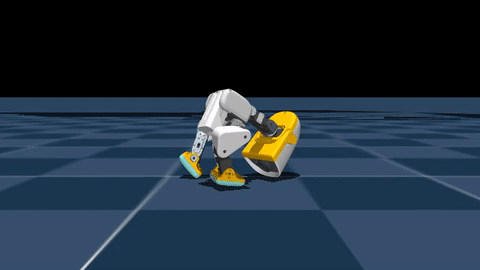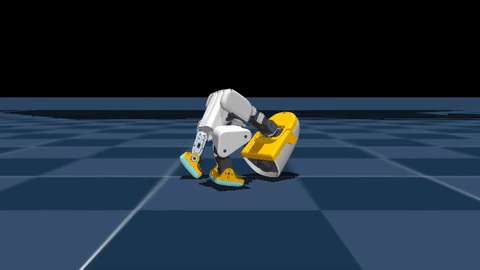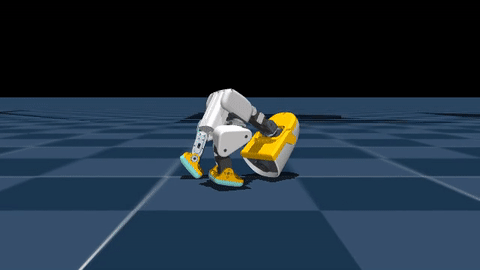 MicroDuck 踢球与收势平衡 BallKick-Flat · 支撑腿稳姿、摆腿击球并稳定收势 |
|---|
12 步跳墙越障课程与 AMD ROCm 并行训练
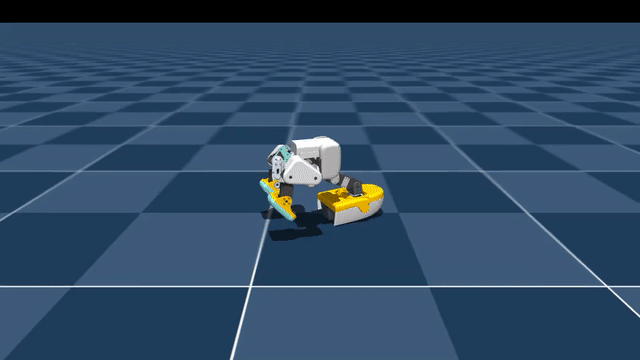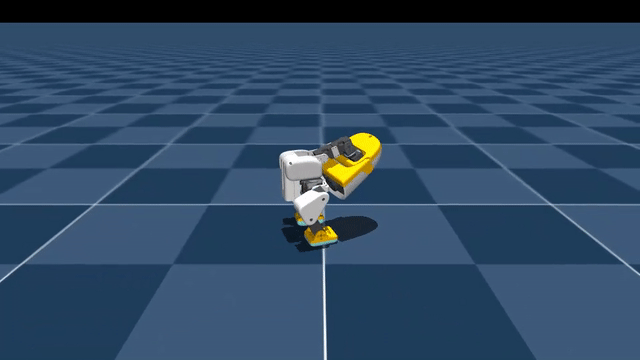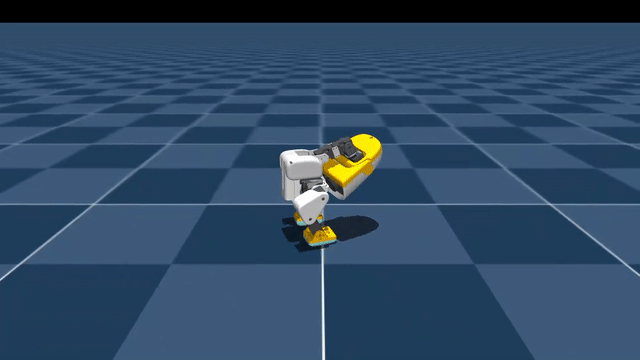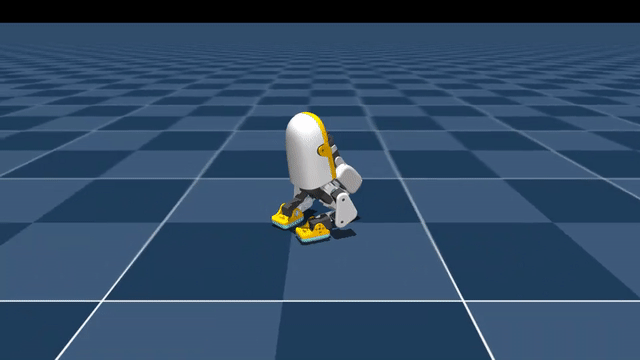 第 0 步:平地前滚翻(Roulade) 课程前传基础技能 · 翻滚角动量与抱膝姿态衔接 | 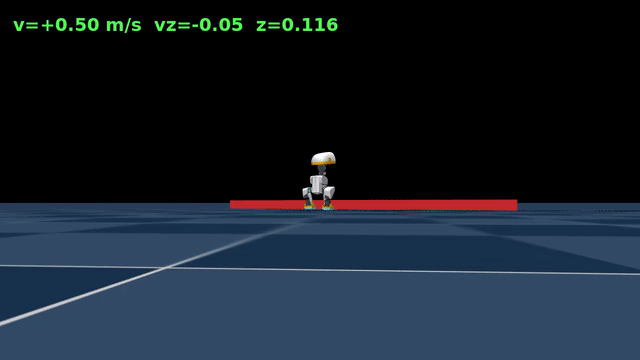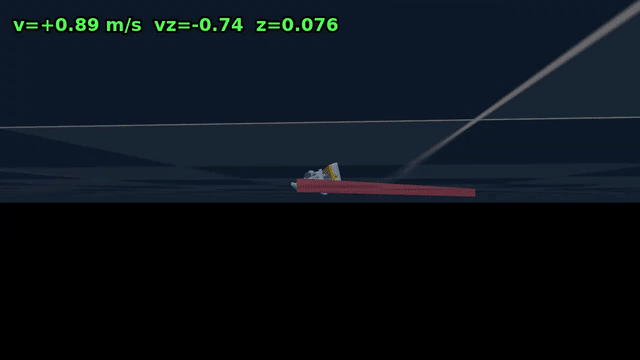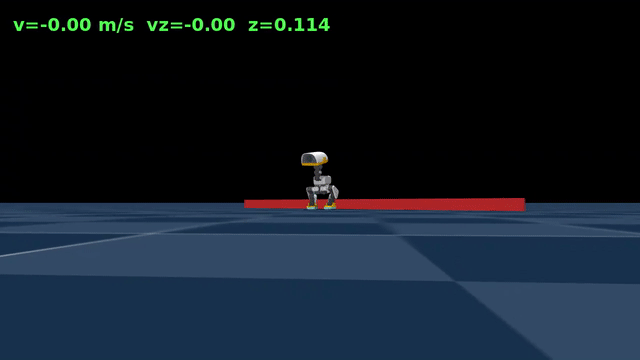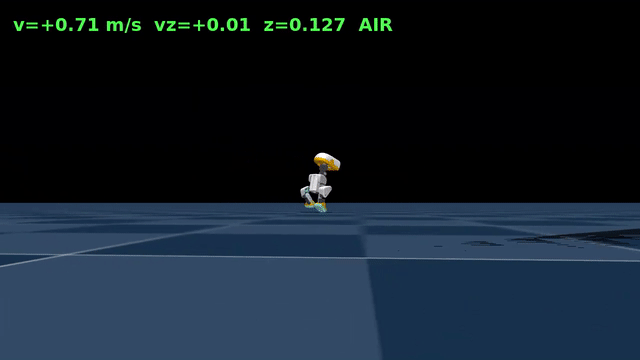 第 12 步:5 cm 越墙跑跳滚翻全链 助跑 → 起跳飞越矮墙 → 前滚翻缓冲 → 起身继续奔跑 |  MicroDuck RL · AMD ROCm 实测 Radeon R9700 · ROCm MuJoCo Warp 并行 PPO 步态 |
|---|
🧭 内容大纲
1. 两轮足 Flamingo · Isaac Lab(6 章完整课程)
围绕轮式倒立摆欠驱动平衡与轮腿异构控制,完整复刻工业界主流“Isaac Lab 大规模训练 → 约束式 RL 优化 → ONNX 部署图固化 → MuJoCo 跨引擎压测”工作流。
| 章节 | 核心内容 |
|---|---|
| 0. 课程总览 | 两轮足欠驱动特性、全链路架构图、双环境隔离配置(Isaac Sim 4.5 + Isaac Lab 2.1 / MuJoCo) |
| 1. 本体建模与环境注册 | 8-DoF 轮腿拓扑、膝关节同步带减速比 -1.5、0~20 ms 延迟执行器、混合动作与非对称堆叠观测 |
| 2. 奖励设计与 PPO 训练 | 非最小相位起步分析、16 项奖励拆解、三层域随机化、4096 环境并行 PPO 与四类病态步态排障 |
| 3. 约束式强化学习(CaT) | Constraints as Terminations 虚拟随机终止与 GAE 连续折现推导、ConstraintManager 源码与 PPO 对照 |
| 4. 策略导出与 MuJoCo Sim2Sim | Normalizer + Actor 融合导出 ONNX、攻克 DFS/BFS 关节序与四元数五大跨引擎陷阱、零样本闭环 |
| 5. 鲁棒性与抗扰动评测 | 矢状面/冠状面速度脉冲、低摩擦路面、转动惯量三角不等式配平与 5 项量化指标矩阵 |
| 6. 项目复盘与工程交付 | 标准化交付档案清单、四大架构权衡复盘、后空翻/台阶进阶路线与 5 道高频面试深度问答 |
2. MicroDuck RL 基础与奖励工程
不需要先推完所有强化学习公式:先在网页端通过交互式实验理解观测、动作、奖励权重与套利行为(Reward Hacking),再在本地 GPU 环境跑通完整训练与离屏渲染。
| 篇章 | 内容 |
|---|---|
| MicroDuck RL:教小黄鸭学会一个动作 | 动作回放画廊、交互式奖励实验室、Mjlab-Velocity-Flat-MicroDuck 并行训练与 checkpoint 回放 |
| MicroDuck:实验记录与创意动作 | 固定 seed 离屏验收标准、evaluation.tsv 量化筛查与跨模式训练记录复盘 |
3. 12 步跳墙课程:复杂多阶段动作链设计
展示如何把单一运动技能扩展为“助跑—起跳—越障—前滚翻—起身续跑”的高动态长时程动作链,包含真实踩坑记录与破局方法。
| 阶段 | 核心内容 |
|---|---|
| 前传与起跳(第 0–5 步) | 平地翻滚预训练、无墙跳跃引导、1 cm / 2 cm 真实矮墙引入与推墙/趴爬防套利门控 |
| 反向课程破局(第 6–9 步) | 突破 180°–220° 仰面势阱的 midroll 反向课程初始化,打通翻滚后起身继续奔跑全链 |
| 墙高递进验收(第 10–12 步) | 保持奖励结构不变,沿 0.5 cm → 1 cm → 2 cm → 3.5 cm → 5 cm 逐档升墙并通过 GIF 验收 |
4. AMD ROCm 平台适配与后续进阶方向
| 篇章 | 内容 |
|---|---|
| MicroDuck RL|AMD ROCm | ROCm Warp / MuJoCo Warp 源码构建、动态 broadphase 接触缓存修复、graph capture 回归与 R9700 训练评测 |
| 平衡控制 | 双足推力扰动恢复与质心/角动量平衡控制(施工中) |
| 运动跟踪 | 动作捕捉参考轨迹重定向与全身模仿跟踪(施工中) |
| 任务规划 Demo | 高层多模态指令分解与底层双足运动技能衔接(施工中) |