强化学习与控制
In questa pagina
2. 马尔可夫决策过程
马尔可夫决策过程(MDP) 是强化学习的核心问题模型。无论是训练四足机器人行走,还是让机械臂完成抓取任务,第一步都是将问题建模为 MDP,明确状态空间、动作空间、状态转移概率和奖励函数等要素。
遇到陌生符号,可查看 术语与公式速查;本章公式旁的“通俗解释”可以原地展开。
具身智能视角:以机械臂抓取为例,状态
可以是关节角度 + 物体位姿,动作 是各关节的目标力矩,奖励 是抓取成功与否的信号。将这些要素明确后,就可以用 RL 算法来求解最优策略。
2.1 智能体与环境交互
如下图所示,智能体(Agent)与环境(Environment)在一系列离散的时步中交互。在每个时步
第 2–6 章(MDP、动态规划、蒙特卡洛、时序差分与 DQN)统一按收到奖励的时步编号:执行
大写
后续策略梯度、Actor-Critic 和 SAC 章节保留按产生奖励的动作时步编号的记法。两种记法的样本对应关系是
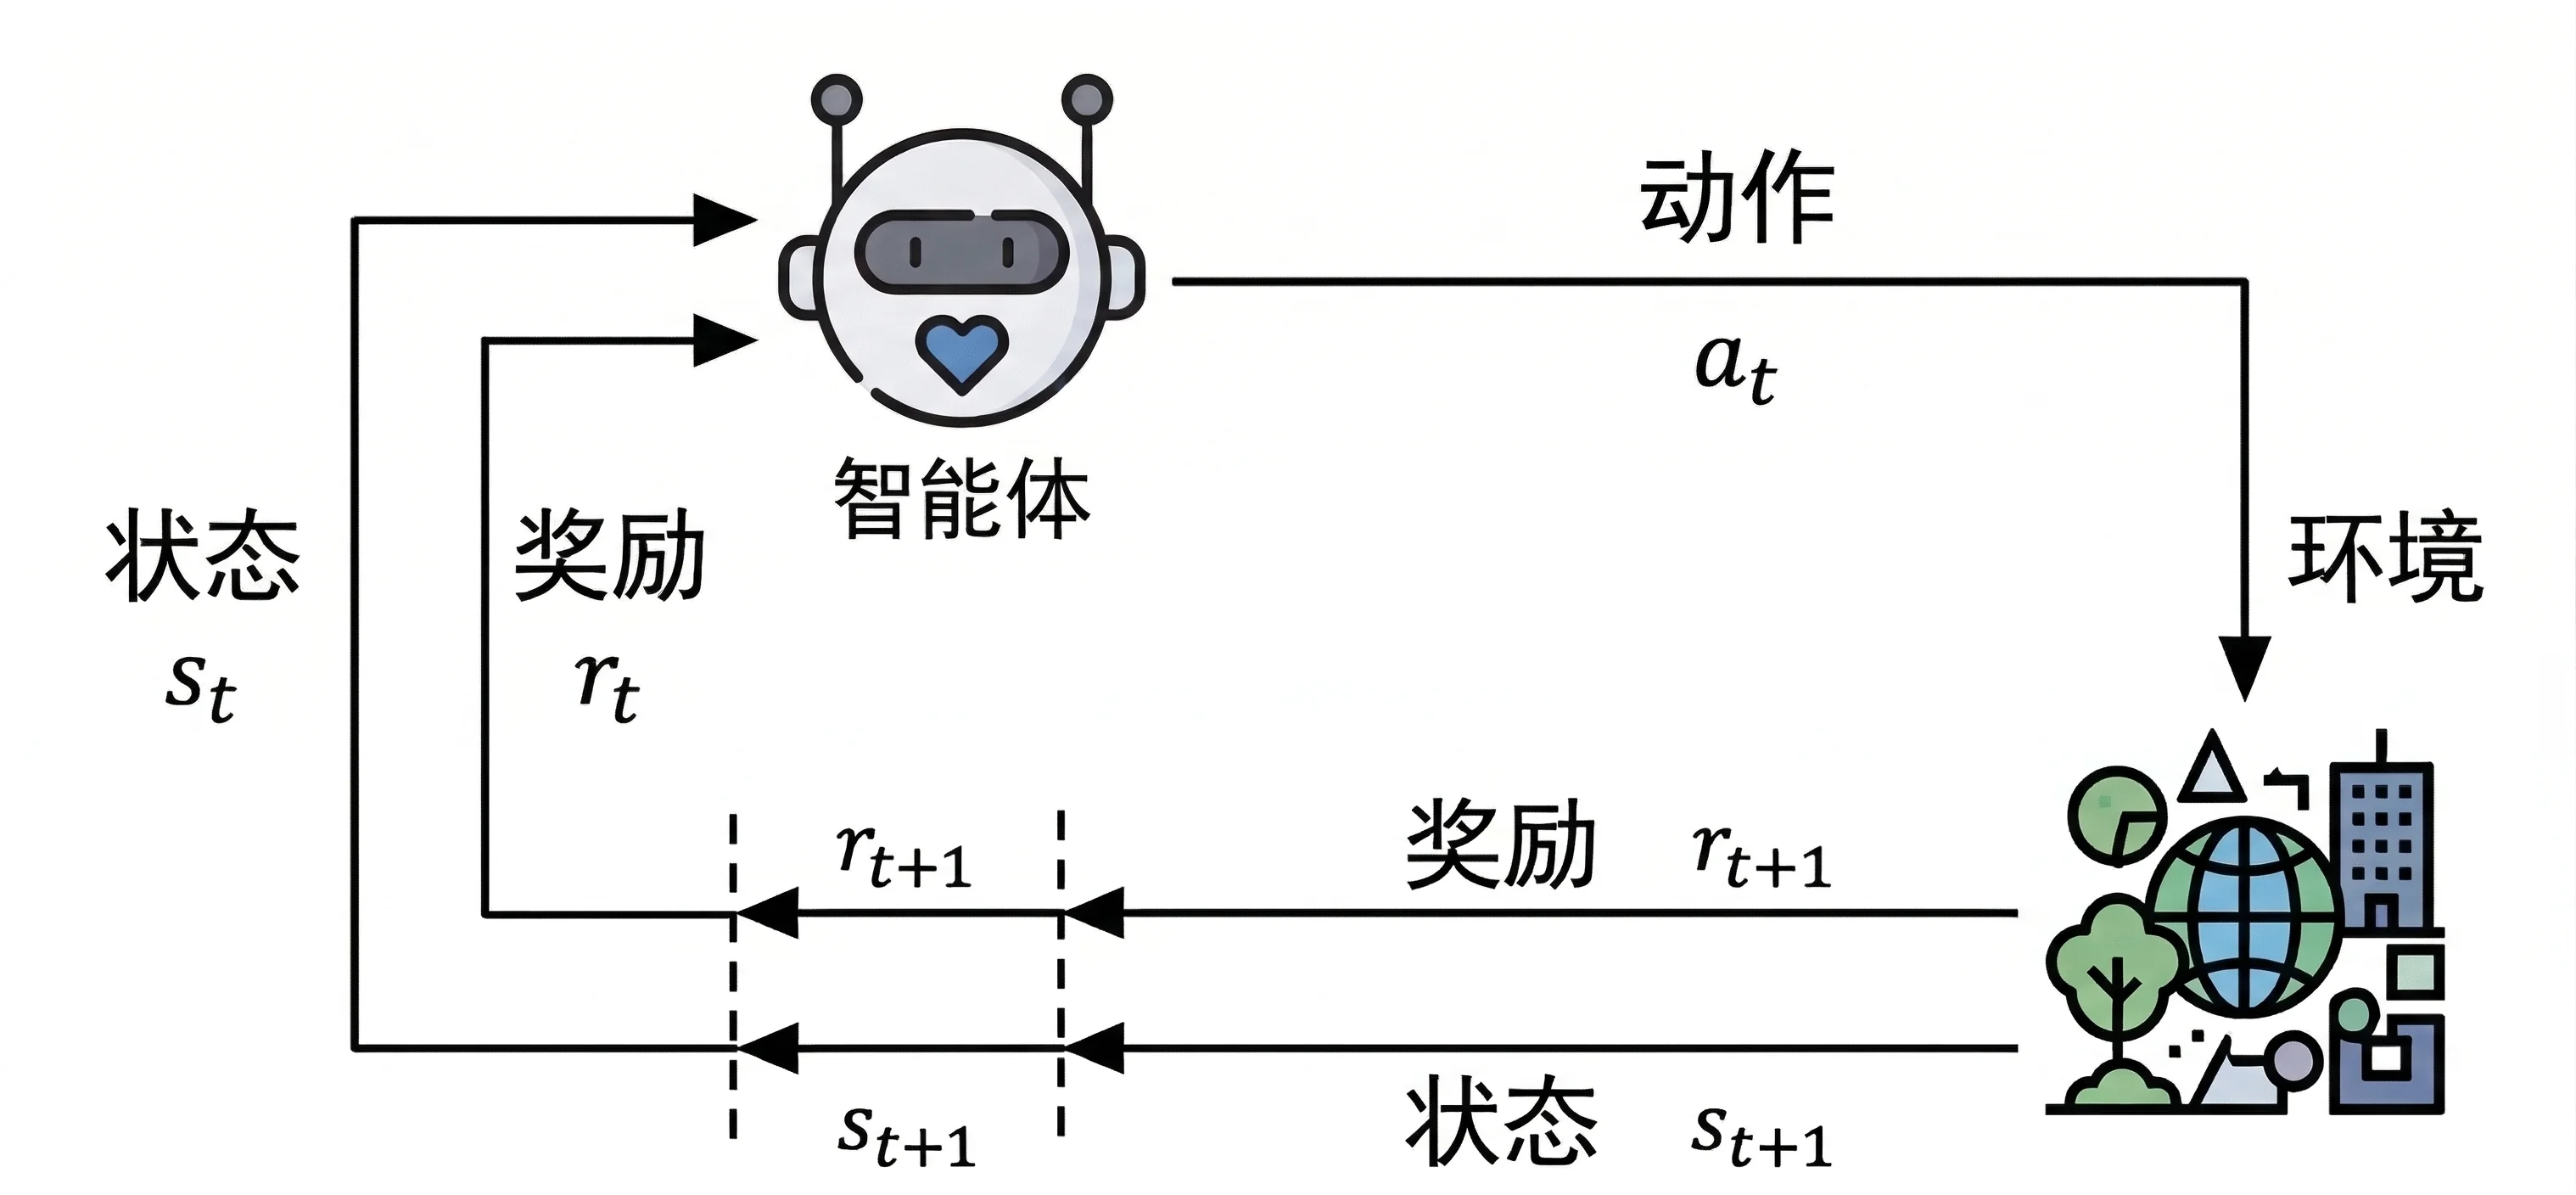
这个过程不断重复,形成一条轨迹:
完成一条完整的轨迹(从初始状态到终止状态)也称为一个回合(episode),通常在有限的时步
如果要用强化学习来解决问题,首先需要将问题建模为马尔可夫决策过程,即明确状态空间、动作空间、状态转移概率和奖励函数等要素。通常用一个五元组来定义:
其中
2.2 马尔可夫性质
马尔可夫决策过程的核心假设是马尔可夫性质,即系统未来状态的概率分布只依赖于当前的状态和动作,而与过去的状态和动作无关:
通俗解释:马尔可夫性质为什么只看“现在”?
关键是“现在的状态包含了足够的信息”,不是“机器人必须忘掉过去”。只知道球的位置,通常不能判断它下一刻往哪边走;如果状态还包括速度,预测就有了更多依据。公式中的竖线表示“在这些信息已知的条件下”,左右相等表示:补充过去的记录不会改变下一状态的条件分布。
更多说明:状态与观测的区别。
真实机器人通常只能获得部分观测。例如在机器人导航中,当前的激光雷达扫描可能不足以完全描述环境状态(存在遮挡)。这类问题可以建模为部分可观测马尔可夫决策过程(POMDP)。叠加历史帧可以帮助近似马尔可夫状态,但不保证恢复完整状态。
2.3 状态转移矩阵
对于有限状态空间,可以用状态流向图表示状态之间的转移关系。如下图所示:
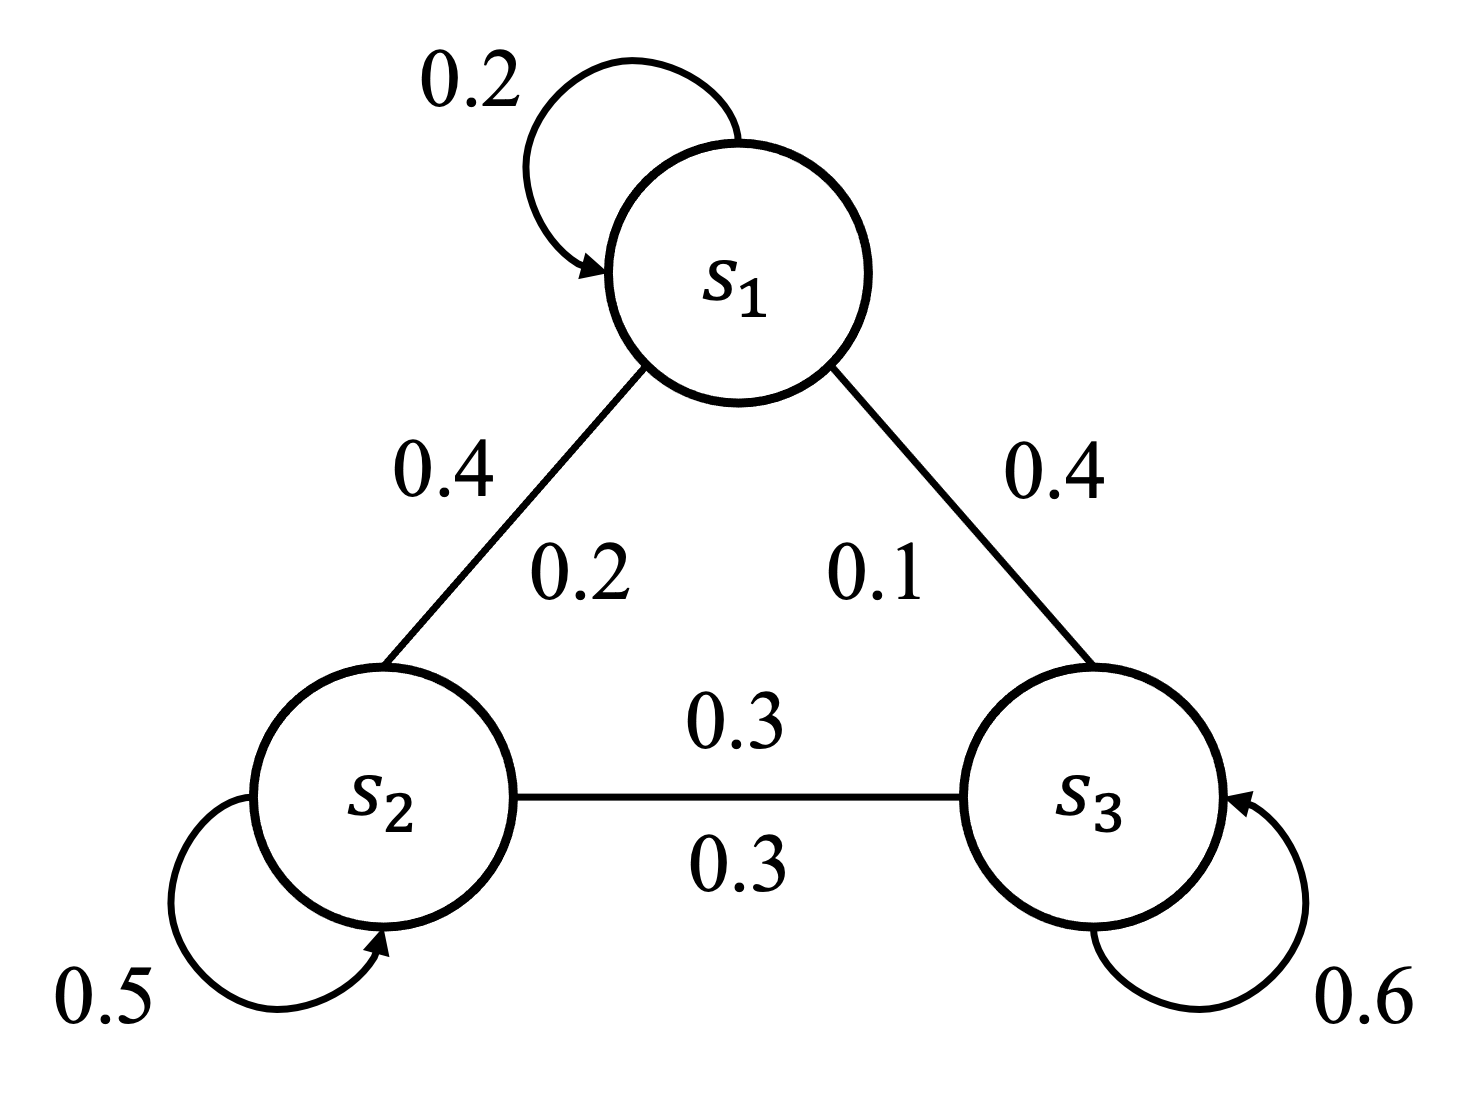
状态之间的切换概率可以用矩阵表示:
其中
2.4 目标与回报
智能体的目标是通过与环境的交互,学习一个最优策略,使得在每个状态下选择的动作能够最大化期望累积奖励。这个累积的奖励称为回报(Return):
折扣因子
对于在
折扣因子可以用来衡量智能体对长期回报的关注度,称之为有效视界:
当
回报的递归定义:
通俗推导:为什么能把一长串奖励写成两项?
- 先留下第一项
,它是当前动作刚产生的奖励。 - 后面的每一项都至少带一个
,把这个公共因子提出来。 - 括号里恰好是“从下一时刻开始的回报”
:
所以这一步只是提取公因子,没有删掉未来的奖励。用前面的两步例子检查:
符号速查:
2.5 策略与价值
2.5.1 策略
策略(Policy) 表示智能体在每个状态下选择动作的规则,用
策略可以是确定性的(在每个状态下总是选择同一个动作)或随机性的(根据概率分布选择动作)。在具身智能中,随机性策略更为常用,因为它能提供更好的探索能力和鲁棒性。
2.5.2 状态价值
状态价值函数表示在给定状态下,按照策略
通俗解释:期望符号和条件竖线怎么读?
把整式读成:“从状态
例如两种回报
术语速查:期望与价值。
2.5.3 动作价值
动作价值函数表示在给定状态
2.5.4 状态价值与动作价值的关系
通俗解释:为什么 V 是 Q 的加权平均?
若左右两个动作的
状态价值是对所有可能的动作价值的加权平均。状态价值反映了策略本身的好坏,动作价值则更具体地反映了在特定状态下选择某个动作的好坏。
2.6 有模型与无模型
- 有模型方法(Model-Based):利用环境模型(状态转移概率和奖励函数)来进行规划和决策,如动态规划。在仿真环境中,有时可以获得环境模型来加速学习。
- 无模型方法(Model-Free):不依赖于环境模型,通过与环境的直接交互来学习,如 PPO、SAC 等。在真实机器人场景中应用更广泛,因为真实环境的动力学模型通常难以精确获取。
2.7 预测与控制
- 预测:在给定策略下,评估该策略的好坏,即计算价值函数。
- 控制:寻找最优策略,使得累积回报最大化。
复杂问题中通常需要同时解决预测和控制问题,即在学习最优策略的过程中,同时评估当前策略的好坏(这正是 Actor-Critic 框架的思想)。