Capitoli
In questa pagina
Petoi Quaddle VLA:10GB 显存训一个导航策略
只告诉机器人“走到红色积木旁”,不写死每一步动作,它能自己转向、分辨颜色、走到目标停下吗?再换一个约束:只有一张预算 10GB 显存的本地显卡,这条 VLA 训练链路还跑得通吗?这一课用 Petoi Quaddle(4 舵机桌面四足)给出一个可复现的答案。
效果预览 ↓ · 看懂分层 ↓ · 动手复现 ↓ · 能力边界 ↓
先说结论:10GB 显存训 VLA 完全可行——SmolVLA 450M 在本地走通了“数据采集 → 微调 → 闭环评估”的全流程。当前模型是一个前侧方导航基线:目标在机器人前侧方时可靠到达,目标在正后方时还会失败。补齐“原地转”原语的 v4 试验与后续路线,放在实验记录与 v5 路线图。
️ 环境统一说明(2026-11-13):本教程的 10GB 复现基线使用 cs123 环境 (
codes/practices/quadruped/cs123/,差频转向 1.0↔3.0Hz)。该环境已弃用于 VLA 主线。 当前 VLA 管线统一在 《Quaddle 入门》环境(codes/practices/quadruped/quaddle-mujoco/, 官方 URDF 自建、duty 不对称转向 0.6–1.2 rad/s、MuJoCo 3.8.1)。两套环境的数据/策略不可互换。 最新进展(v5/v6、temporal ensembling 验收达标 3/3+85%、L1/L3/L4 路线)见 实施现状与计划 与 实验记录。本页保留作 10GB 复现基线。
效果预览:当前主线成果
以下视频与 GIF 是当前主线(《Quaddle 入门》环境 + temporal ensembling / 任务分解)跑出来的 真实评估录像,不是渲染动画。注意它们与本页下方可复现的 cs123 基线不是同一套环境/策略, 验收数据与训练细节见实施现状与计划。
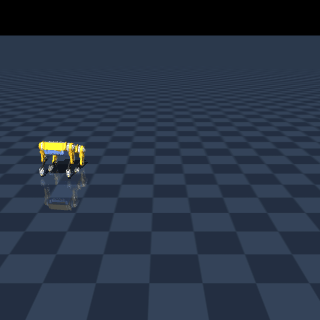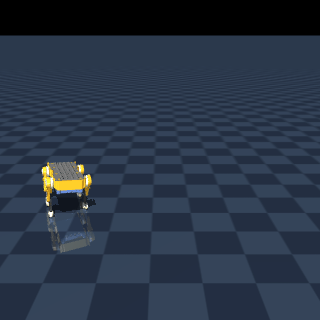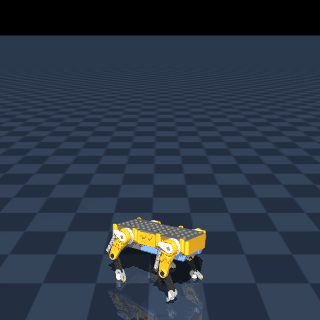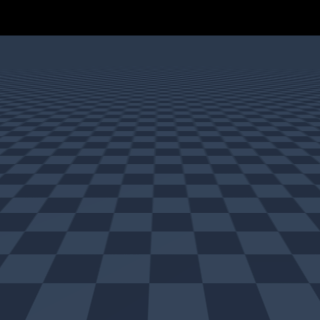
L2 语言导航 best:SmolVLA 18k + temporal ensembling + seq-depart 微调,20eps 18/20=90% (VLA 策略 rollout,960×720 25fps、1x 真实速度、逐集指令标注):
丝滑版 GIF(同一策略,50fps 渲染 + 3x 播放,适合快速浏览):
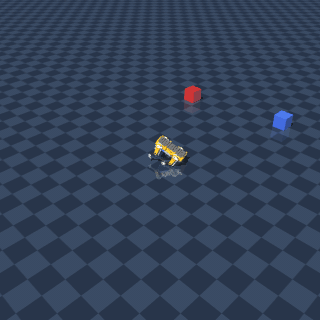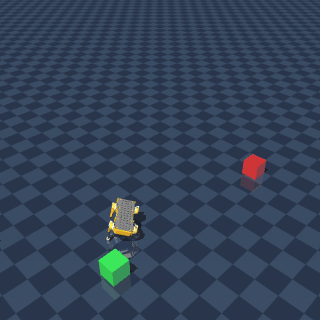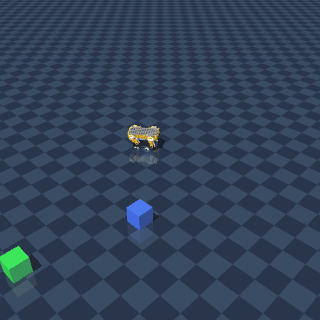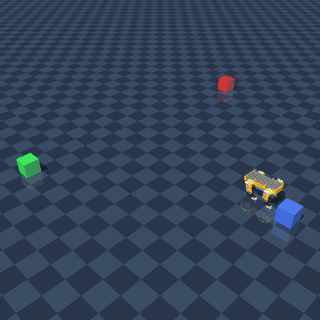
L3 避障分解版:L2 技能 + 非目标块反射层,20eps 16/20=80%:
L4 条件组合分解版:编排器 + L2 技能,看到绿停 10/10、先红后蓝 7/10,合计 17/20=85%:
低层步态对照(非 VLA,无策略)——原始 CPG 步态开环前进(kp=0.15,upright、69.8mm/s、 弹跳 0.86mm),证明底层行走顺畅、模型无需修改:
你将完成什么
| 你的路线 | 需要什么 | 完成后你能做到 |
|---|---|---|
| 看懂闭环 | 浏览器即可 | 理解“SmolVLA 高层决策 + 查表 CPG 低层运控”的分层导航 |
| 复现基线 | Linux、NVIDIA GPU(≥10GB 预算)、Git、uv | 采集 400 条数据、微调 SmolVLA、跑一次闭环评估并生成 GIF |
| 继续挑战 | 完成基线复现 | 按实验记录补“原地转”原语、过采样后方场景、扩展任务考纲 |
不需要先掌握 flow matching 的全部公式。先弄清三个问题:它能感到什么?它能控制什么?什么指令算完成?
它不是在照着视频走
高层策略看画面、读指令,输出一个“档位”;低层控制器把档位翻译成四条腿的舵机轨迹。视频是训练后的回放,不是策略的输入。
| 概念 | 在这个导航任务里是什么 | 你可以这样理解 |
|---|---|---|
| 观测 observation | 3 路相机 RGB(320²)+ 8 维状态 + 语言指令 walk to the {color} block | 我看到什么颜色、现在朝哪、目标还有多远? |
| 动作 action | 档位指令 (vx_dir, wz_dir),量化为前进/转向/停(v4 起再加 spin 旗标) | 下一步该前进、转向还是停? |
| 高层策略 policy | SmolVLA 450M,10Hz 重规划,模仿学习 + flow matching | 看颜色决定往哪走 |
| 低层运控 | 查表 CPG,50Hz,免学习(W2 标定) | 把档位变成四条腿的周期舵机目标 |
| checkpoint | 保存下来的模型与训练状态 | 把当前学到的导航习惯存个档 |
任务本身:桌面散布 red/green/blue 三个 5cm 立方积木,指令指定目标颜色,机器人从随机初始朝向出发,走到目标积木旁(<12cm)停下。非目标颜色积木同时在场景里,强迫策略学会颜色分辨。
系统怎样分层
SmolVLA 高层(10Hz 重规划,450M,模仿学习 + flow matching)
  输入:3 路相机 RGB(320²)+ 状态 8 维 + 语言指令 "walk to the {color} block"
  输出:动作 (vx_dir, wz_dir) —— 量化为档位
    ↓
查表 CPG 低层(50Hz,免学习,W2 标定)
  forward / turn_left_weak|strong / turn_right_weak|strong / stop
  差频转向强度插值(1.0↔3.0Hz),每腿独立相位钟
    ↓
MuJoCo 物理(1kHz,闭链四连杆 + 滚轮足端,q=0 = 平衡站姿)
**注意“决策一次”和“走一步”的区别:**高层每 0.1s 重规划一个档位;低层 CPG 在 50Hz 上连续生成舵机目标;MuJoCo 在 1kHz 上算闭链物理。三层各跑各的频率,档位是它们之间的接口。
观测的 8 维状态是 [4 舵机角, vx, wz, bearing, dist]。其中 bearing/dist(目标方位与距离)是特权信息:仿真里直接给出,真机上需要外置相机定位求出,或让 VLA 从图像里学。这一点在迁移到真机时要特别留意。
关键交付物在哪里
代码(全部新增,零改动既有课程文件)
| 路径 | 内容 |
|---|---|
codes/practices/quadruped/cs123/7.quaddle-mjcf/ | MJCF 构建(官方 URDF→MuJoCo)+ 站立/步态/渲染脚本 + 测试 |
codes/practices/quadruped/cs123/8.rl_quaddle/ | CPG 控制器(W2)+ RL 环境存档 + 标定数据 |
codes/practices/vla/quaddle-data/ | 数据采集 + 训练 + rollout 评估(W3–W5) |
codes/practices/vla/act/ | lerobot 0.6.1 环境(pyproject 已锁定 GPU 可用依赖栈) |
模型与数据(本地产物,未纳入 git)
| 路径 | 内容 |
|---|---|
quaddle-data/outputs/smolvla_quaddle_v{1,2,3}/ | 三轮正式训练检查点 |
quaddle-data/outputs/dataset/lerobot/ | 400 条数据集(camera1/2/3 视频 + parquet + scene.xml) |
quaddle-data/outputs/rollout*.gif | v1/v3 闭环行为 GIF |
~/.cache/huggingface/hub/ | smolvla_base(873MB)+ SmolVLM2(6.7GB),离线训练就绪 |
文档
| 路径 | 内容 |
|---|---|
Petoi-Quaddle-VLA训练方案-10GB.md(仓库根,本地保留不入库) | 总方案 + W1/W2/W5 执行记录 |
7.quaddle-mjcf/README.md | MJCF 构建、验收、踩坑 |
8.rl_quaddle/README.md | RL 三轮迭代、CPG 控制器、评估报告 |
quaddle-data/README.md | 数据管线、SmolVLA 训练命令、W5 三轮评估 + 根因分析 |
动手:复现导航基线
以下命令使用 Linux Bash,在教程仓库中运行,统一使用 codes/practices/vla/act 的 lerobot 0.6.1 环境(Python 3.12,torch 2.10+cu128)。首次安装需要下载较大的依赖与基座权重,请预留网络和磁盘空间。
1. 准备环境:确认 GPU 可用
先获取教程仓库,进入仓库根目录,再执行:
cd codes/practices/vla/act
uv sync --frozen
uv run python -c "import torch; print('CUDA available:', torch.cuda.is_available())"
**成功信号:**CUDA 检查输出 True。后续命令都在这个代码目录下执行。依赖版本已写入锁文件,首次运行先保持原配置。
所有依赖变更必须进 pyproject 锁定(torch 2.10+cu128、transformers 5.4–5.6、cusparselt 补丁),否则 pip 装的会被下一次 uv run 悄悄还原。下面命令用 --no-sync,前提是这一步已经 uv sync 准备好环境。
2. 采集 400 条专家数据
MUJOCO_GL=egl uv run --no-sync python ../quaddle-data/collect.py \
  --episodes 400 --repo-id local/quaddle_nav_400b --seed 5000
专家是查表 CPG 控制器 + 方位闭环(死区 ±25°,到达半径 12cm)。成功信号:../quaddle-data/outputs/dataset/lerobot/ 下生成 LeRobotDataset(mp4 视频 + parquet)和 scene.xml。--episodes 的语义是成功数——翻倒/超时(45s)的 episode 整段丢弃、自动补采,所以实际耗时比 400×单条更长(EGL 渲染约 60 分钟)。
3. 微调 SmolVLA(30k 步,离线)
基座权重已缓存后,可离线训练:
HF_HUB_OFFLINE=1 MUJOCO_GL=egl uv run --no-sync lerobot-train \
  --policy.path=lerobot/smolvla_base \
  --dataset.repo_id=local/quaddle_nav_400b --dataset.revision=v3.0 \
  --dataset.root=../quaddle-data/outputs/dataset/lerobot \
  --batch_size=4 --steps=30000 --save_freq=7500 \
  --policy.device=cuda --policy.use_amp=false --policy.push_to_hub=false \
  --policy.scheduler_decay_steps=30000 \
  --output_dir=../quaddle-data/outputs/smolvla_quaddle_v3
**成功信号:**终端出现训练迭代信息,outputs/smolvla_quaddle_v3/checkpoints/ 下留下检查点。batch_size=4 是 4070 Ti / 10GB 预算的起点(官方 batch8≈10–16GB),按剩余显存二分调整。短训必须同步缩 scheduler_decay_steps(默认 30000),否则学习率不衰减、不收敛。
4. 闭环评估 + 生成 GIF
MUJOCO_GL=egl HF_HUB_OFFLINE=1 uv run --no-sync python \
  ../quaddle-data/eval_rollout_gif.py --episodes 3 --seed 7000 \
  --ckpt ../quaddle-data/outputs/smolvla_quaddle_v3/checkpoints/last/pretrained_model \
  --out ../quaddle-data/outputs/rollout_v3.gif
**成功信号:**生成 outputs/rollout_v3.gif。把它下载到自己的电脑播放,观察机器人是否朝目标颜色移动、是否到达停下、是否翻倒。seed 7000 的三场景与 v1/v3 完全一致(同 eval 脚本同 seed 流),成功率可直接对比。
低层 MJCF / RL 环境的冒烟测试在另一个代码目录运行:
cd ../../quadruped/cs123
uv run pytest -q 7.quaddle-mjcf/tests 8.rl_quaddle/tests
当前能力边界
诚实地区分“已验证”和“还没做到”,比一段好看的视频更重要。
| 场景 | 表现 | 说明 |
|---|---|---|
| 目标在前侧方 ±60° 扇区 | 可靠到达 | ep2(blue)类场景三版模型全部成功,约 2.8s / 0.5m |
| 初始 bearing > 120°(目标近正后方) | 失败 | 陷入转向-弧线循环或翻倒 |
| seed 7000 三场景整体 | 1/3 | 均匀 yaw 下后方场景仅约 1/3 覆盖 |
失败根因不是“数据不够”,而是动作空间缺纯原地转原语:差频转向档自带直行分量,弧线稳态中 bearing 恒定,目标在正后方时无限绕弧。v4 试验已定位到更深的根因(弧线档本身不可靠)并补上 spin 原语,闭环专家验证从 v3 的 2/24 提升到 23/24——但模型训练仍在进行中,尚未回填成功率。详见实验记录与 v5 路线图。
关键技术发现
每一条都花了真实迭代成本,复现时可以直接避开这些坑:
- 闭链装配解是解析的:Quaddle 四连杆在 y-z 平面天然闭合,x 向 1.9mm 为 CAD 间隙;平行曲柄(ψ=θ)即整腿刚性——不要对闭链盲跑数值求解器。
- 官方 power-on 是蹲姿不是站姿:前腿悬空前倾 5.7°;FK 扫描出前腿 +6.95° 补偿实现四足等高,配合全关节
ref技巧让 ctrl=0 恰好是平衡站姿。 - 足端方向性决定行走能力:球足端(各向同性滑动摩擦)稳定行走上限约 10–20mm/s,RL 三轮收敛到 3→6→14mm/s 就是在逼近这个物理上限;换成滚轮圆柱(真机 omni 轮机制)后 forward 实测 +113mm/s。仿真保真度 > 控制器智能。
- 滚轮是单向棘轮:正/倒相位、skew 反号全部产生 +x 位移——仿真模型无倒挡(真机 OpenCat 有 kbwF,无此限制);后方目标用 180° 弧线转向替代。
- CPG 相位钟必须每腿独立:全局共享时差频转向从未生效(W2 的 turn 档实为直线冲刺),修复后左右转向半径对称(约 220mm)。
- uv run 会按 uv.lock 静默恢复环境:依赖变更必须进 pyproject 锁定,否则 pip 装的会被下一次
uv run还原。 - flow matching 输出幅值保守:one-hot 档位训练下模型输出 ±0.4 而非 ±1.0,绝对阈值量化会全判成 stop——用 argmax 相对判别 + 连续强度编码。
- 弧线几何死锁(当前能力边界根因):turn 档自带直行分量 → 弧线稳态中 bearing 恒定 → 目标在正后方时无限绕弧。缺“纯原地转”原语,是能力缺口而非数据缺口。
资源占用实测
| 阶段 | 显存 | 时长 |
|---|---|---|
| SmolVLA 训练(batch1 fp32) | 1.69 GB | 300 步 30s(14.7 steps/s) |
| SmolVLA 训练(batch4 fp32,v1 正式) | 约 5 GB | 20k 步 51 min |
| 数据采集(400 条,EGL 渲染) | CPU 为主 | 约 60 min |
| 推理 rollout(每 0.5s 一次) | 约 1.5 GB | 30s 场景约 1 min |
GPU 14.7 steps/s 相对 CPU 约 395 倍。唯一注意:显存与用户其他进程共享时,batch 按剩余量调整。
继续深入
- 想看 v4 如何补“原地转”、与真机《细化方案》的逐维对照、以及 v5+ 任务考纲?查看实验记录与 v5 路线图。这些材料供复核和拓展使用,不是完成本课基线复现的前置要求。
- 想理解低层 MJCF 闭链、平衡站姿与查表 CPG 的标定细节?读
7.quaddle-mjcf/README.md与8.rl_quaddle/README.md。 - 总方案与 W1/W2/W5 执行记录见仓库根的
Petoi-Quaddle-VLA训练方案-10GB.md(本地保留,不入库)。