ONNX 导出与量化
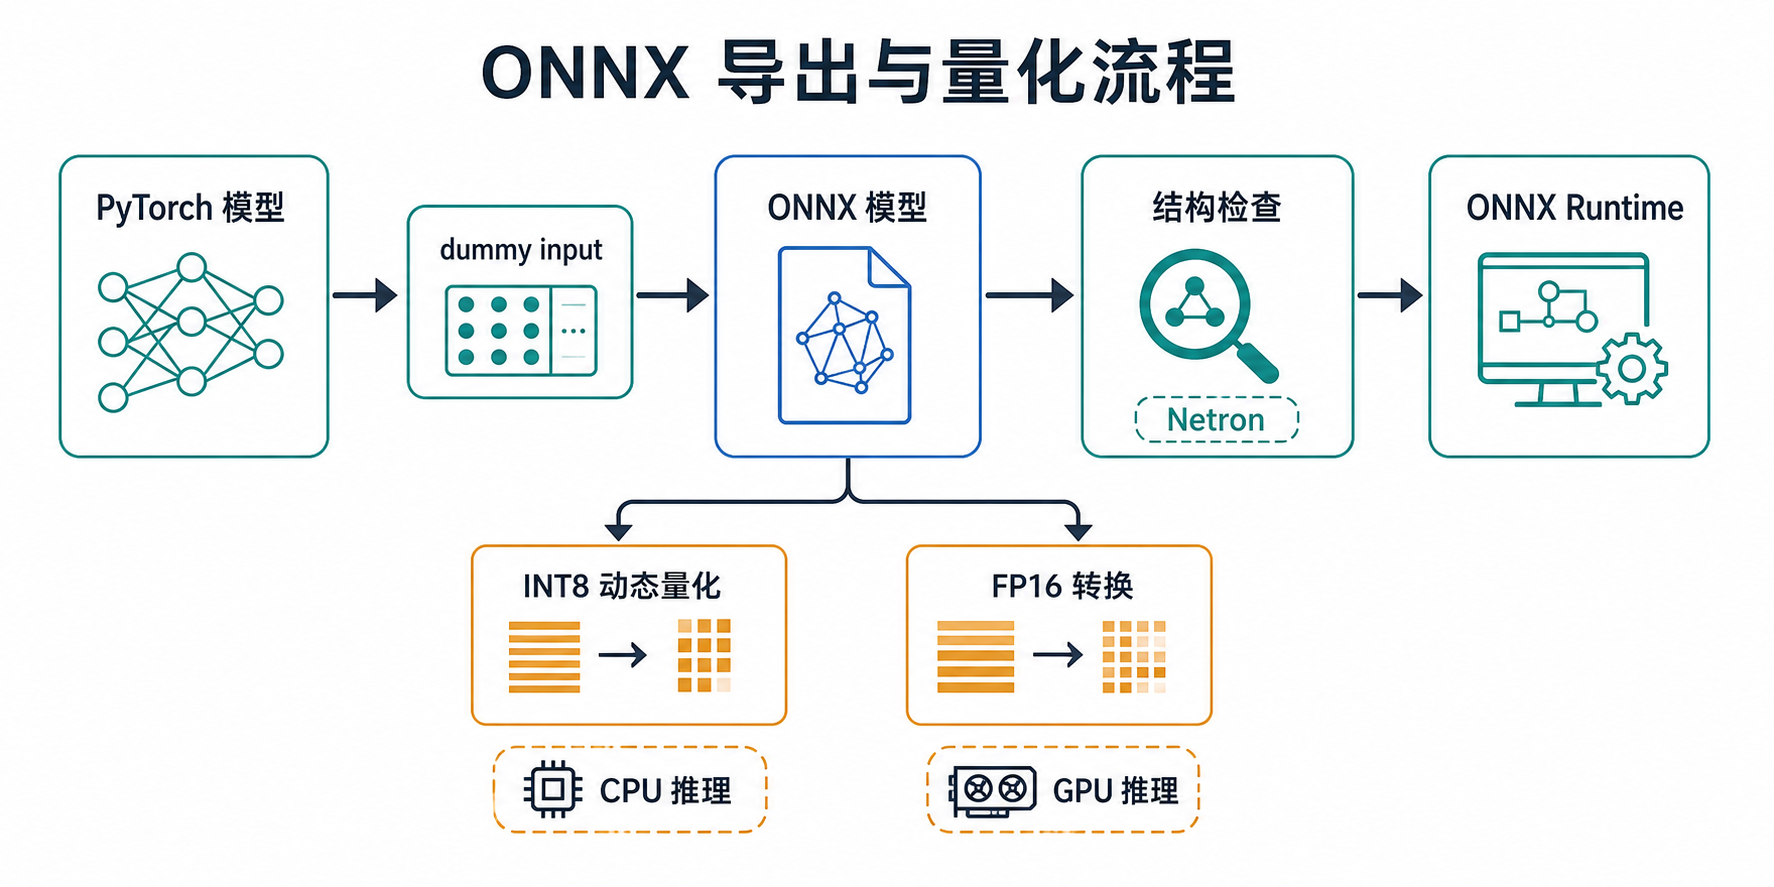
Torch-RecHub 已支持将训练好的模型导出为 ONNX,用于跨平台推理部署。面向工业推理场景(低延迟、低内存), ONNX 导出 与 量化(INT8/FP16) 的完整用法与建议实践。
安装依赖
ONNX 相关依赖是可选的,按需安装:
pip install "torch-rechub[onnx]"说明:
torch-rechub[onnx]会安装ml-dtypes、onnx、onnxscript、onnxruntime,以及用于 FP16 转换的onnxconverter-common。- 如需 GPU 推理,请改用与本机 CUDA/驱动匹配的
onnxruntime-gpu,并确认环境中实际导入的是期望的 Runtime 变体。
导出 ONNX(训练器 export_onnx)
Torch-RecHub 各训练器均提供 export_onnx() 方法(CTR/Matching/MTL/Seq),导出过程会自动构造 dummy input,并可支持 动态 batch size。
CTR(排序/精排)导出
from torch_rechub.trainers import CTRTrainer

# ... trainer.fit(train_dl, val_dl)
trainer.export_onnx("deepfm.onnx")
Matching(召回)导出:全模型 / 双塔分导
双塔模型通常建议分开导出用户塔与物品塔,线上分别做 embedding 计算:
from torch_rechub.trainers import MatchTrainer

# 导出用户塔(用于 user embedding)
trainer.export_onnx("user_tower.onnx", mode="user")

# 导出物品塔(用于 item embedding)
trainer.export_onnx("item_tower.onnx", mode="item")
多任务(MTL)导出
from torch_rechub.trainers import MTLTrainer

trainer.export_onnx("mmoe.onnx")
导出参数与高级控制(onnx_export_kwargs)
如需选择导出器或传入封装尚未占用的 torch.onnx.export() 参数,可以通过 onnx_export_kwargs 透传:
trainer.export_onnx(
    "model.onnx",
    dynamic_batch=True,  # 动态 batch size(推荐)
    onnx_export_kwargs={
        "dynamo": False,  # 此处演示强制使用 legacy 导出器
    },
)f、input_names、output_names、opset_version、do_constant_folding、verbose 和自动生成的 dynamic_axes 已由封装设置,不得在 onnx_export_kwargs 中重复传入,否则会抛出 ValueError。
导出器选择建议:
- CTR / Matching / MTL:默认先尝试
dynamo=True,动态 batch 通过dynamic_shapes表达;失败时会自动回退到 legacy 导出器与dynamic_axes。 - SeqTrainer:动态 batch/序列长度默认使用 legacy 导出器;固定 shape 时可按需显式传
dynamo=True。 - 老版本 PyTorch:若不支持
dynamo,导出器会忽略该参数并使用兼容路径。不同 PyTorch 版本的算子覆盖仍可能不同。
查看 ONNX 模型结构
导出 ONNX 后,可以使用 Netron 在线查看模型结构:
- 打开 https://netron.app/
- 拖拽或上传导出的
.onnx文件 - 即可可视化查看模型的网络结构、各层参数和张量形状
提示:Netron 支持多种模型格式(ONNX、TensorFlow、PyTorch 等),是调试和验证导出模型的便捷工具。
ONNX 量化(Quantization)
在工业推理中,FP32 往往不是最优解。常用两类压缩方式:
- INT8 动态量化(Dynamic Quantization):用于 CPU 推理,主要量化 Linear/MatMul 等算子。是否加速、精度是否满足要求,需要用自己的数据测量。
- FP16 转换:用于支持 FP16 的 GPU 推理,可以降低浮点权重占用;实际吞吐取决于显卡与算子支持。
这两个模式不是按显存大小划分的两档 GPU 量化。当前 INT8 接口不包含 TensorRT 的 GPU INT8 校准流程,也不处理超过 2 GB 的外部权重大模型。
Torch-RecHub 在量化模块提供统一 API:
from torch_rechub.utils.quantization import quantize_model1) INT8 动态量化(推荐 CPU)
from torch_rechub.utils.quantization import quantize_model

quantize_model("model_fp32.onnx", "model_int8.onnx", mode="int8")
可选参数(按需):
per_channel=True:对权重启用 per-channel 量化reduce_range=True:缩小量化范围(部分 CPU 可能更稳)weight_type="qint8"|"quint8":权重量化类型
原有 dynamic_int8、dynamic 模式别名和节点筛选参数继续可用;不再静默丢弃不受支持的参数。optimize_model 只在 ORT < 1.16 中可用,且保留原默认 False;ORT >= 1.16 已移除该参数,显式设置 True 会清楚报错。如需优化,请先单独使用 ORT 的 quant_pre_process()。
兼容说明:部分 Dynamo 导出的 Gemm 模型在 ORT 转置权重后会留下冲突的重复 shape 元信息。ORT >= 1.18 支持直接接收 ModelProto,本工具会在内存副本中移除与 initializer 重名的冗余 value_info,保留其他中间张量元信息与原文件,避免该冲突;不改变导出器。更旧 ORT 仍使用原来的文件路径接口,如遇到这类 Dynamo/Gemm 问题,可显式使用 trainer.export_onnx(..., onnx_export_kwargs={"dynamo": False}) 或给 torch.onnx.export() 传 dynamo=False。
2) FP16 转换(推荐 GPU)
from torch_rechub.utils.quantization import quantize_model

quantize_model("model_fp32.onnx", "model_fp16.onnx", mode="fp16")
Python API 与命令行均默认 keep_io_types=True,保留浮点输入/输出为 FP32;整数类别 ID 不改变。只有显式设置 keep_io_types=False 或 CLI 的 --no-keep-io-types 时,才转换浮点 I/O。float16 模式别名继续支持。
脚本示例与基准测试(Benchmark)
仓库内提供脚本,便于快速验证:
量化脚本
python examples/serving/quantize_onnx.py --input model_fp32.onnx --output model_int8.onnx --mode int8
python examples/serving/quantize_onnx.py --input model_fp32.onnx --output model_fp16.onnx --mode fp16
性能对比脚本
对比 FP32 / INT8 / FP16 的 模型大小 与 推理耗时:
python examples/serving/benchmark_onnx_quantization.py --fp32 model_fp32.onnx --int8 model_int8.onnx --inputs batch.npz
python examples/serving/benchmark_onnx_quantization.py --fp32 model_fp32.onnx --fp16 model_fp16.onnx --inputs batch.npz --provider CUDAExecutionProvider
batch.npz 保存一批已完成预处理的真实输入,键必须与 ONNX 输入名一致,例如 np.savez("batch.npz", user_id=user_ids, item_id=item_ids)。整数组件必须使用模型要求的 dtype。所有待比较模型共用这批输入;如果 FP16 模型改变了浮点 I/O 类型,脚本只做相应的浮点 dtype 转换。
没有 --inputs 时,脚本只为浮点输入生成固定随机种子的演示数据;类别 ID、mask、长度等整数/布尔输入必须提供真实数据,避免猜测词表和有效取值。脚本检查 provider 是否可用并成功注册,不会把 CPU 回退误报成 GPU 成功;注册 CUDA 仍不代表全部节点运行在 GPU。
打印的文件大小仅指 .onnx 文件,不包含外部权重;基准固定 ORT CPU 算子线程为 1,耗时包含输入/输出拷贝,不是纯 GPU kernel 耗时。
导出成功只说明模型文件已生成。上线前还应使用真实样本分别运行 PyTorch 与 ONNX Runtime,核对输出形状、数值误差和动态 batch,并在量化后重新评估业务指标;基准脚本不会替代这些一致性检查。