强化学习与控制
On this page
10. PPO 算法
PPO 的前身是 TRPO 算法,旨在克服 TRPO 算法中的一些计算上的困难和训练上的不稳定性。TRPO 通过定义策略更新的信赖域来保证每次更新的策略不会太远离当前的策略,但需要解决复杂的约束优化问题。PPO 则通过更简单的方式实现了类似的效果。
具身智能视角:PPO 是目前具身智能领域使用最广泛的 RL 算法。NVIDIA Isaac Gym 默认使用 PPO 训练四足机器人行走、灵巧手操作等任务;OpenAI 用 PPO 训练了灵巧手解魔方。PPO 的优势在于简单、稳定、易调参,是具身智能的首选基线算法。
从工程实现上看,PPO 并不是某一个孤立的公式,而是一整套训练范式:先用当前策略采样一批轨迹,借助 Critic 估计优势函数(通常使用 GAE),再在这批数据上做多轮小批量更新,同时用 clip 或 KL 惩罚约束新旧策略之间的差距。理解这个“采样 -> 估计优势 -> 受限更新 -> 丢弃旧数据”的闭环,比死记某一个损失函数更重要。
10.1 重要性采样
在展开 PPO 算法之前,先铺垫重要性采样(importance sampling)。重要性采样是一种估计随机变量的期望或者概率分布的统计方法。假设需要从分布
对于离散分布:
通常把
比例
当
重要性采样也是蒙特卡洛估计的一部分,只不过它是一种比较特殊的蒙特卡洛估计,允许我们在复杂问题中利用已知的简单分布进行采样,从而避免了直接采样困难分布的问题。
直观地说,重要性采样做的事情是:样本虽然来自“旧分布”,但通过乘上一个合适的权重,我们仍然可以近似估计“新分布”下的期望。这正是 PPO 能够使用“上一轮策略采样的数据”来更新“当前策略”的关键。
10.2 PPO 核心思想
回忆 Actor-Critic 中的策略梯度形式:
其中
PPO/TRPO 共享的代理目标可以写成:
其中旧策略分布
如果
10.2.1 Clip 约束
为了保证重要性权重不偏离 1 太远,PPO 使用 clip 约束:
其中
10.2.2 为什么 Clip 能稳定训练
- 当
时,说明这个动作比平均水平更好,我们希望提高它的概率。但如果 已经大于 ,目标就不再继续奖励这种上升,避免“好动作”被一次性推得太猛。 - 当
时,说明这个动作比平均水平更差,我们希望降低它的概率。但如果 已经小于 ,目标同样会被截住,避免“坏动作”的概率被一次性压得过低。 - 因此,PPO 的
min操作本质上构造了一个保守下界:宁可少更新一点,也不要让新旧策略差异过大而破坏训练稳定性。
10.2.3 KL-Penalty 约束
另一种方式是在损失中加入 KL 散度惩罚项:
其中惩罚系数
10.2.4 PPO 的完整损失函数
在真实实现里,PPO 通常不只优化策略项,还会同时训练 Critic 并加入熵正则。一个常见的总目标写法如下:
这里:
负责更新 Actor,在提升期望回报的同时限制策略漂移。 负责训练 Critic,让值函数去拟合回报目标或 bootstrap 目标。 用来鼓励探索,避免策略在训练初期过早塌缩到近乎确定性的分布。
很多代码实现会把最大化目标改写成最小化损失,例如 loss = -L_clip + c_v * L_value - c_e * L_entropy,符号不同但思想完全一致。部分实现还会引入 value clipping,使 Critic 的更新也不要过于激进。
10.3 一个标准 PPO 训练循环
PPO 真正好用的地方,不只在公式,还在于整个训练流程设计得非常工程友好。一个标准的 PPO 训练循环通常如下:
- 用当前策略在
个并行环境中采样 步,记录状态、动作、奖励、终止标记、旧策略的 log_prob和 Critic 估计的 value。 - 用 bootstrap + GAE 计算每个时间步的 advantage 和 return target。
- 对 advantage 做标准化,必要时对观测或奖励做归一化,减少梯度尺度波动。
- 将这一整批样本打乱后切成多个 mini-batch,在同一批数据上训练
个 epoch,联合更新 Actor 和 Critic。 - 训练时监控
approx_kl、clip_fraction、entropy、value loss 等指标;如果 KL 偏移过大,通常会提前停止本轮更新。 - 本轮更新结束后丢弃旧数据,重新用最新策略采样下一批轨迹。
如果策略网络带有 RNN/LSTM,通常不能像前馈网络那样把单步样本完全打散,而需要按序列块切分并保留隐藏状态边界。
10.4 PPO 算法伪代码
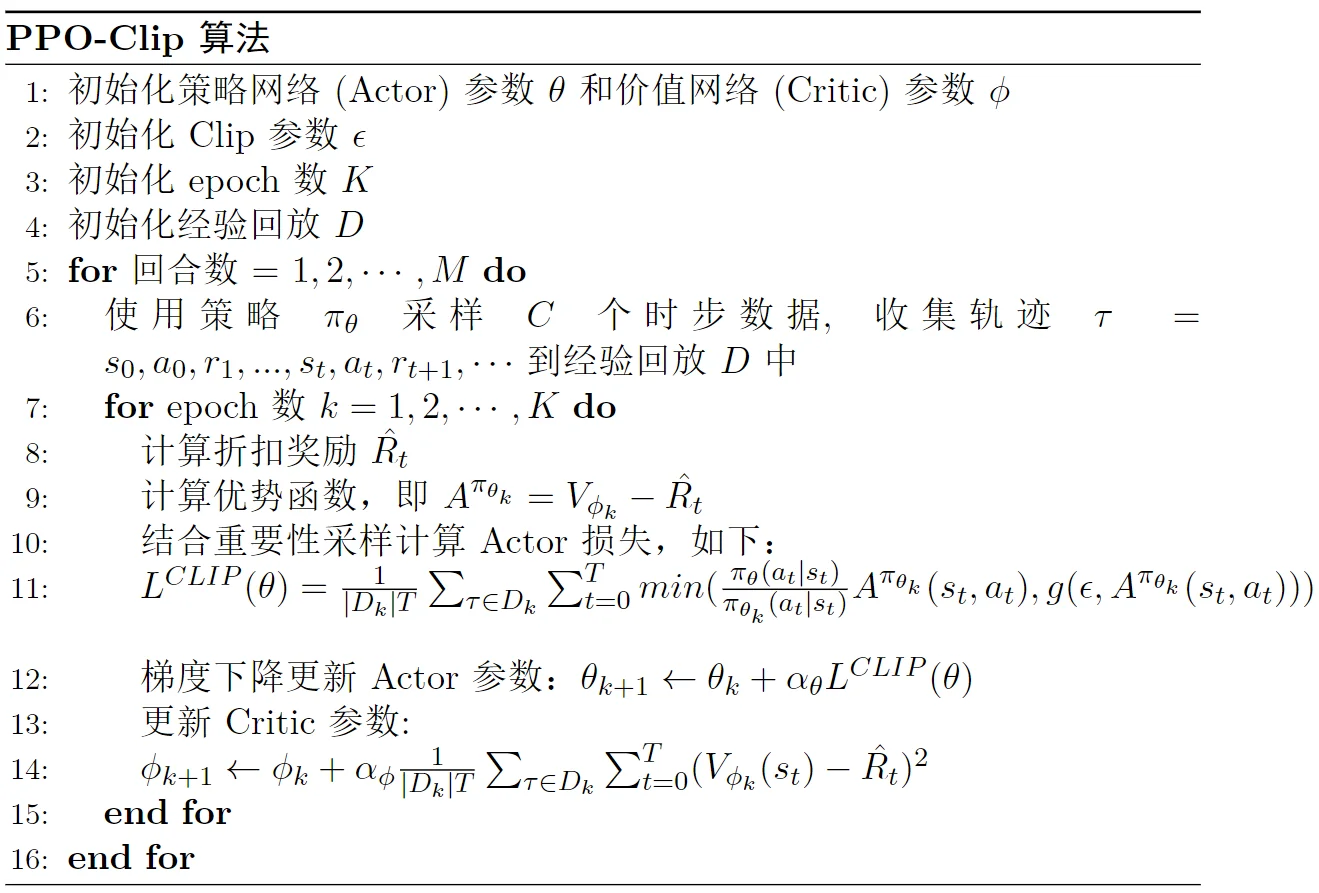
10.5 PPO 是 on-policy 的
一个常见误区:有人认为 PPO 使用了旧策略的样本,所以它应该是 off-policy。这个说法不准确。PPO 的确会在一轮更新中反复利用“刚刚由旧策略采样得到”的那一批数据,但这些更新都围绕同一个 behavior policy 快照展开,并通过重要性采样来修正分布偏差。一旦这一轮更新结束,这批数据通常就会被丢弃,而不会像 DQN/SAC 那样长期放进 replay buffer 中反复复用。
换句话说,PPO 允许的是短时间、受约束的数据复用,而不是长期、无约束的经验回放。因此从算法范式上看,PPO 仍然是 on-policy 的。
这也意味着 PPO 的样本效率不如 off-policy 的 SAC/TD3,但在具身智能中,仿真环境(如 Isaac Gym)可以大规模并行采样,弥补了这一劣势。
10.6 具身智能中的实践要点
| 要点 | 说明 |
|---|---|
| 大规模并行采样 | PPO 样本效率不算高,但在 Isaac Gym、Isaac Lab、ManiSkill 等并行仿真环境中,可以用环境数换稳定性。 |
| GAE 与优势归一化 | 常用 |
| 观测与奖励归一化 | 机器人任务的状态量纲差异很大,归一化能显著减轻 Critic 拟合难度。 |
| 监控 KL 与 clip fraction | 如果 KL 激增,或 clip fraction 长期偏高,通常说明学习率过大或 clip range 设得太宽。 |
| 连续动作的方差控制 | 对高斯策略来说,动作标准差过大容易发散,过小又会过早收敛,通常需要配合 entropy bonus 或对 log_std 做限幅。 |
| Critic 不能太弱 | 很多 PPO 训练失败并不是 Actor “学坏了”,而是 Critic 估值不准,导致 advantage 噪声太大。 |
10.7 思考
为什么 PPO 在具身智能中如此流行?
- 简单稳定:clip 约束实现简单,训练稳定性好
- 通用性强:同时适用于离散和连续动作空间
- 并行友好:on-policy 特性天然适合多环境并行采样(Isaac Gym 可同时运行数千个环境)
- 调参简单:超参数少且不敏感
为什么 DQN 和 DDPG 算法不使用重要性采样技巧呢?
DQN 和 DDPG 的核心目标是基于 Bellman 方程做 off-policy 更新。对于这类方法,经验回放中的样本本来就允许来自旧行为策略,分布不一致的问题主要由 TD 学习、目标网络和 replay buffer 来吸收,而不是像 PPO 一样通过“限制策略变化幅度”来解决。严格来说,off-policy 方法里也会出现重要性采样,例如 Prioritized Experience Replay 会用它来修正“按优先级采样”带来的偏差,但它的用途与 PPO 中用于约束策略更新的比值修正并不相同。
PPO 算法原理上是 on-policy 的,但它可以是 off-policy 的吗?
可以做成“部分 off-policy”,但条件比较严格。难点在于 replay buffer 中的数据一旦过旧,重要性比值
PPO 算法更新过程中将轨迹样本切分成多个小批量时,可以将样本顺序打乱吗?
对于前馈策略网络,通常可以,而且建议打乱,这样可以降低样本相关性、减小过拟合风险,并让每个 mini-batch 的分布更均匀。但如果使用的是 RNN/LSTM 策略,或者任务强依赖时序上下文,那么就不能简单地把单步样本完全随机打散,而应该按序列块进行采样和训练。
为什么说重要性采样是一种特殊的蒙特卡洛采样?
因为它依然是在做“通过样本均值估计期望”的事情,这一点与普通蒙特卡洛方法完全一致。不同之处在于,普通蒙特卡洛通常直接从目标分布采样,而重要性采样则从一个更容易采样的分布中取样,再用权重