双足 / 人形机器人
In questa pagina
MicroDuck RL:让小黄鸭学会起身、转向和踢球
先看结果,再拆训练过程。
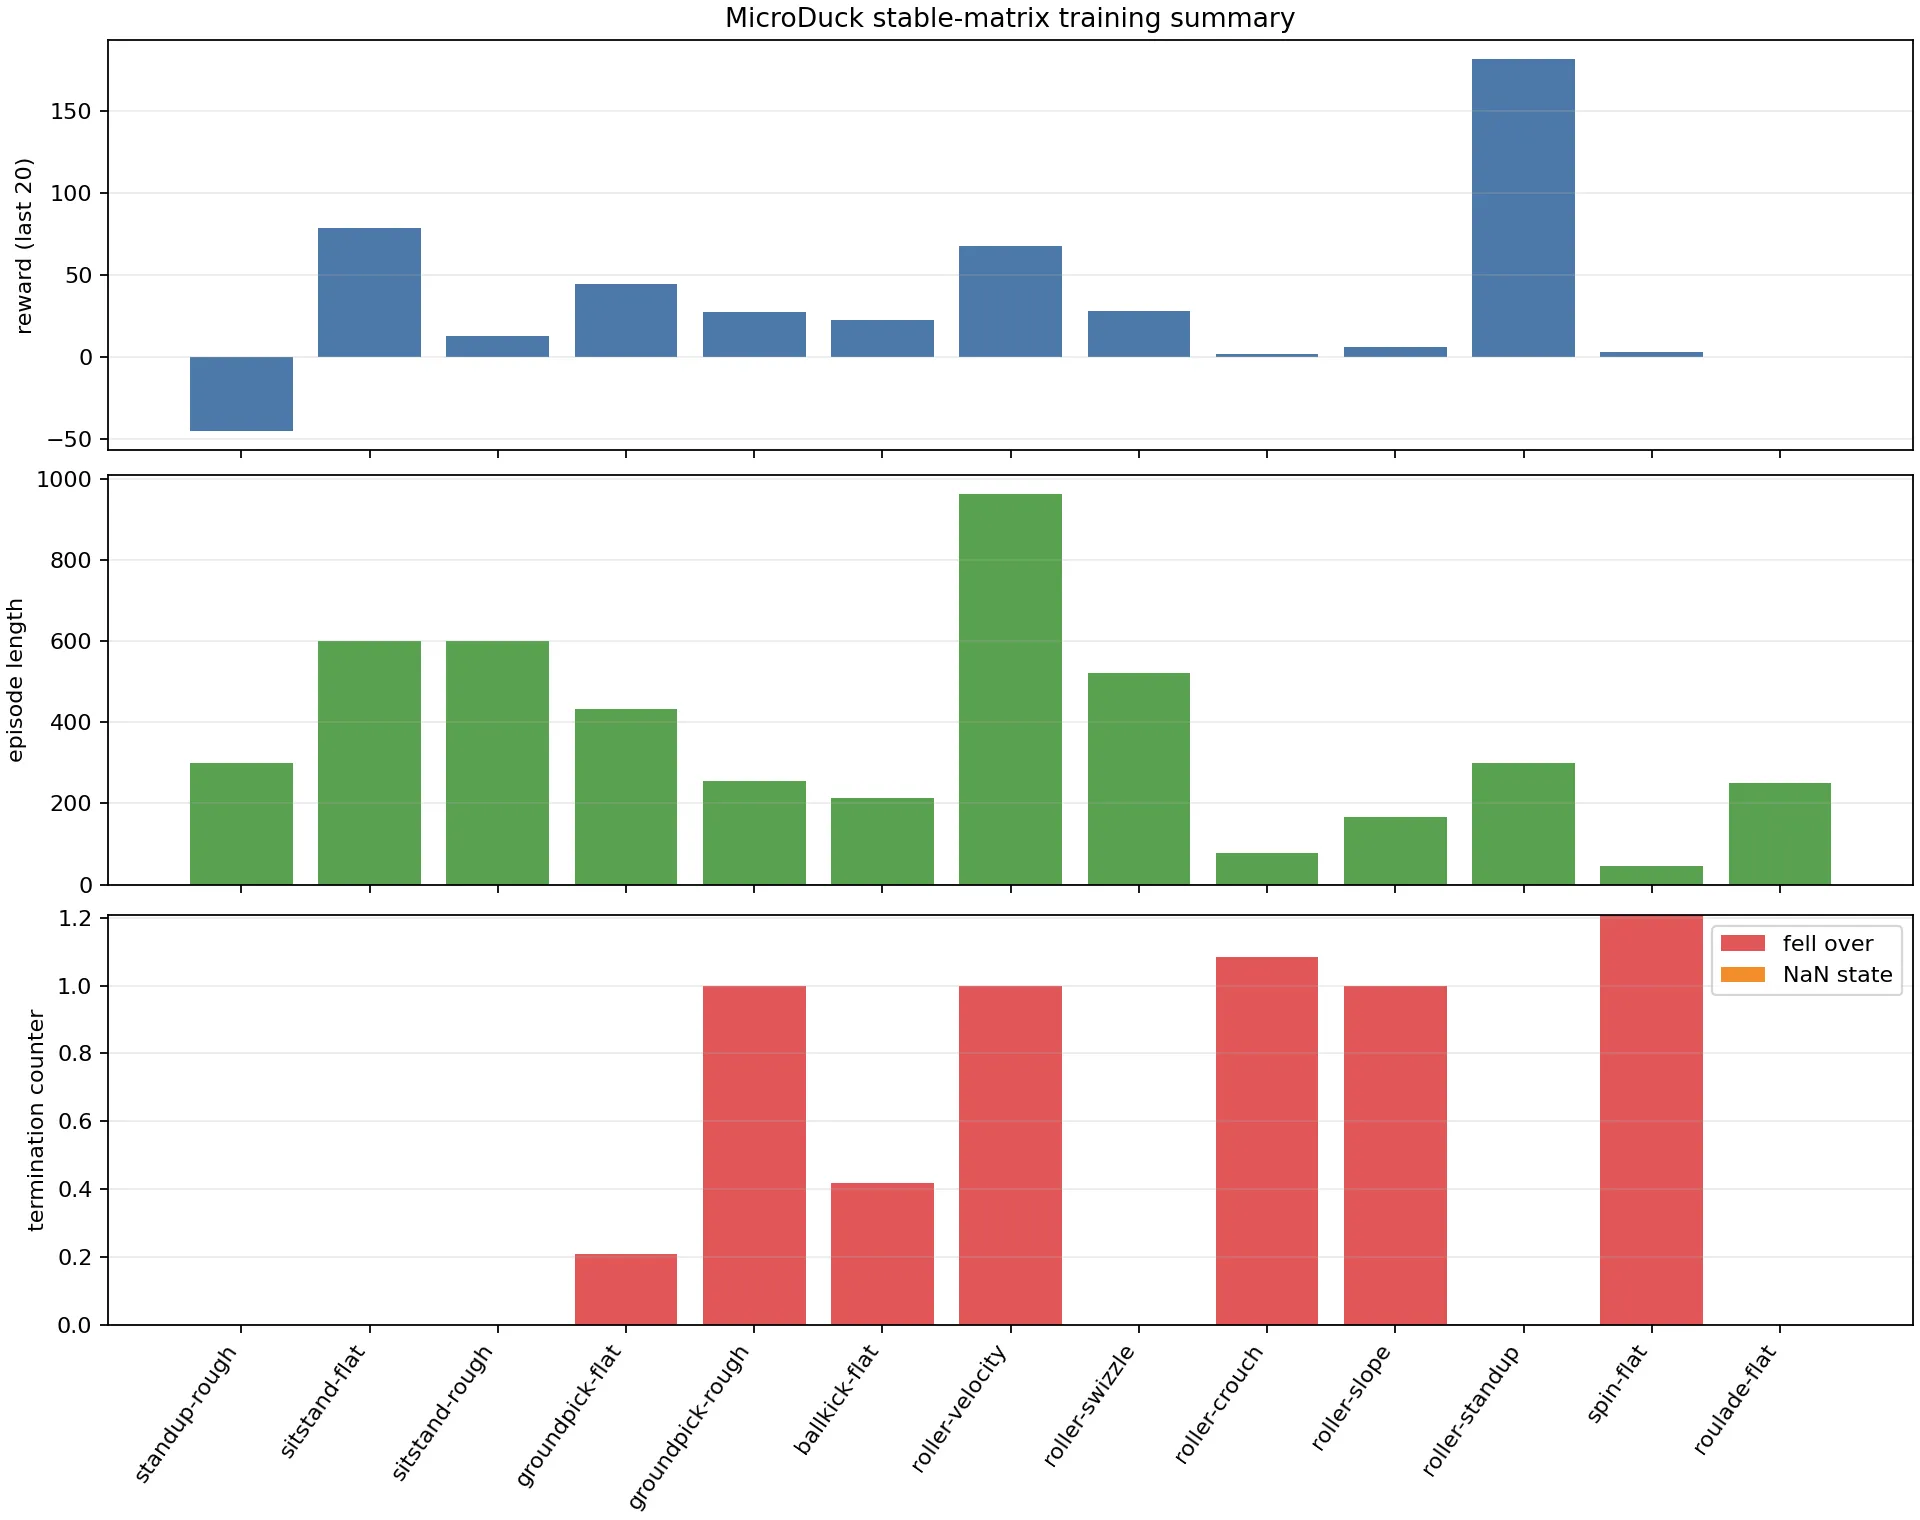
这张图展示能从 TensorBoard 汇总出的训练指标;18 个模式的最终 checkpoint 和回放状态,以后面的结果表为准。
这不是一段手工编排的动作序列。上面的每个 checkpoint 都经过 PPO 训练,再由同一个离屏评估脚本回放成视频。小黄鸭在仿真里可以走路、从地上站起来、捡东西、踢球,也可以切换到轮式底盘滑行。
- 18/18 个任务完成独立训练,并生成了可加载的 checkpoint;
- 18/18 个任务完成 200 帧离屏回放,回放结果和统计文件保存在
logs/mode_matrix_stable/; - 重点动作已经整理成 GIF 和 MP4,下面可以直接播放;
- 这里的“稳定”指固定命令、单环境、约 4 秒的仿真回放通过,不等同于多 seed 鲁棒性,更不等同于真机安全验证。
三个可直接观看的动作
下面三段是本页的主展示素材,统一使用实际 mjlab 环境、固定 seed 42 和近距离镜头渲染。GIF 直接嵌在教程里,点击下方链接可以下载同源 MP4。
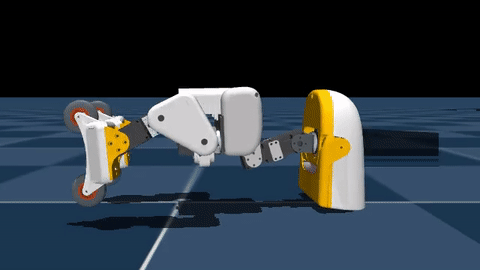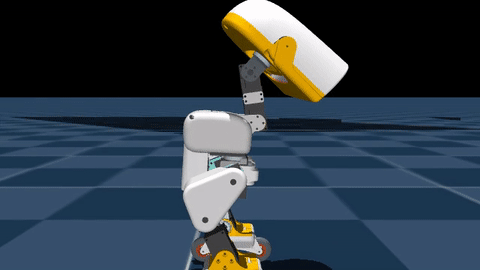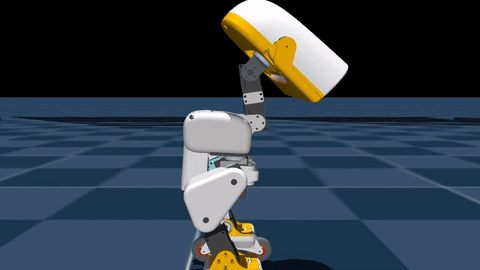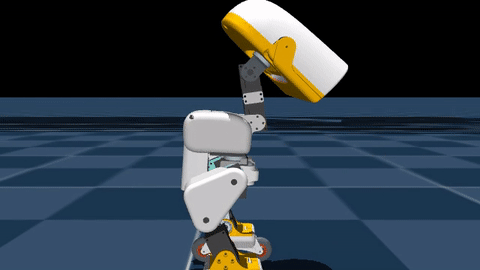
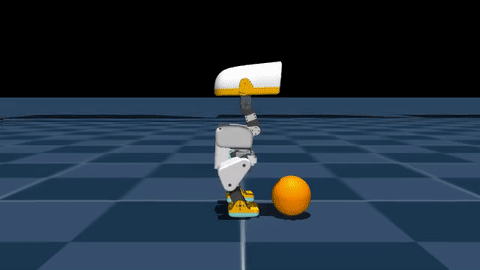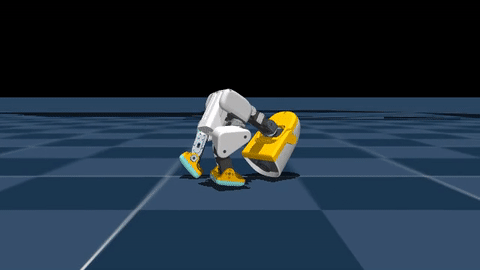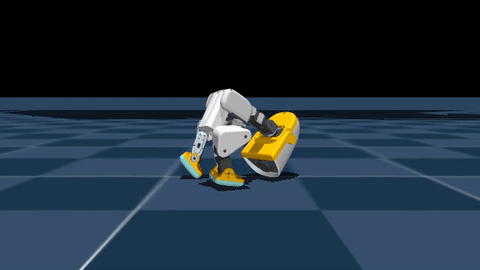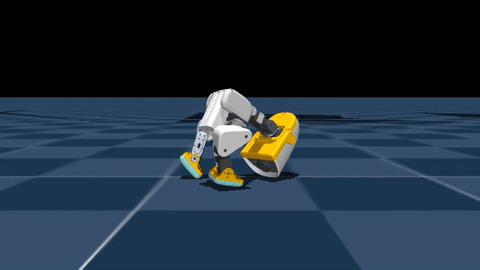
轮式起身
从趴地状态起身,完成后保持站立。
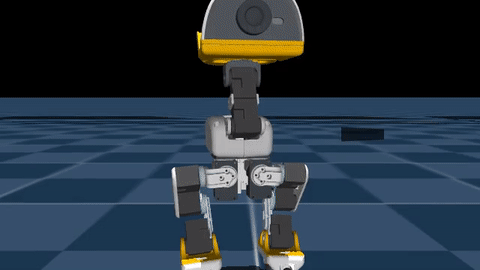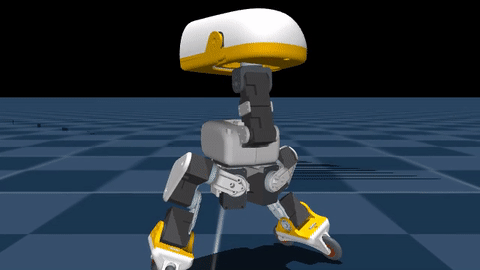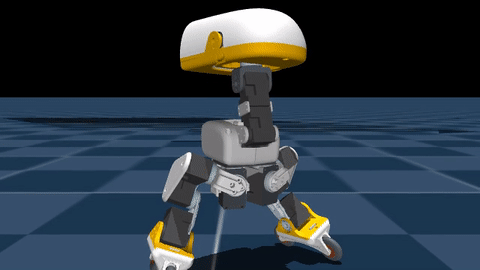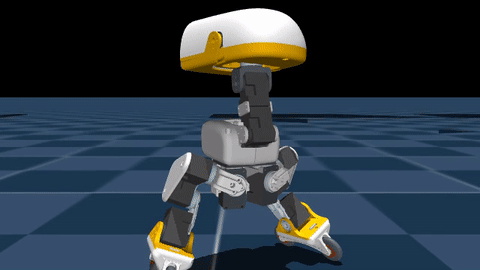
轮式转向
使用 Swizzle 的阶段命令完成转向,转过来后保持稳定。
踢球
策略抬脚完成触球,视频保留触球和收势过程,避免把后续 episode 重置画面混进演示。
实验中的新动作:奶龙大笑
这个动作需要手臂参与:先双手捧腹、身体前仰大笑,再向后倒,随后左手左腿、右手右腿交替敲击地面,最后回到抱腹姿态。原始 MicroDuck 模型只有腿部和头部的 14 个舵机,因此我为这个实验动作增加了左右肩、左右肘四个手臂关节,以及手掌碰撞几何。
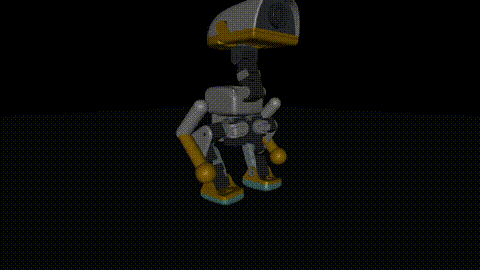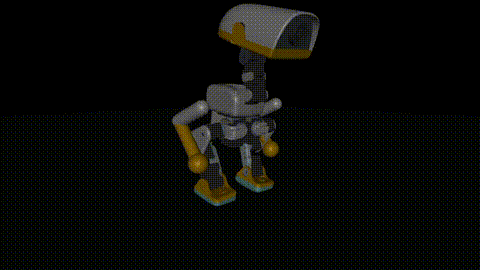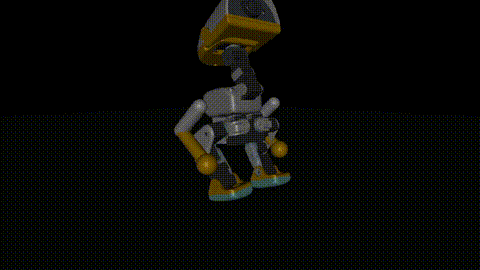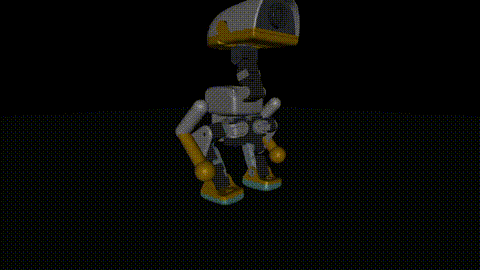
这段视频是按同一组动作关键帧生成的稳定参考轨迹,用来确认动作设计和镜头效果;带手臂的 PPO 策略仍在训练和验收中,暂不计入上面的三个正式结果。当前模型没有独立下颌舵机,所以视频里的“大笑”由捧腹、身体后仰、头部动作和交替敲地表达,嘴部开合需要后续加入真实的 jaw actuator。
其余训练 case
其余任务的 checkpoint、日志和原始回放继续保留在开发机实验目录,当前不进入教程发布页。发布页只展示上面三段已经人工验收过的动作,避免读者把静态姿态、失稳过程或 episode 重置误认为完成动作。
这个项目到底在做什么
MicroDuck 是 Pollen Robotics 的小型双足机器人,约 800 g、约 25 cm 高,腿部和身体使用 Dynamixel XL330 舵机。它的体型很小,但训练链路并不小:需要把 3D 资产、执行器特性、接触动力学、观测、奖励和部署接口放到同一个可复现工程里。
这也是它适合放进 Dive into 教程的原因:读者可以从一个很具体的“小黄鸭”出发,看清楚强化学习机器人项目中每一层是怎么接起来的。
| 层次 | 在 MicroDuck 里对应什么 |
|---|---|
| 机器人模型 | MJCF、STL 网格、关节限位和碰撞几何 |
| 执行器 | BAM(电机力矩、摩擦、饱和等非理想因素的近似) |
| 仿真 | MuJoCo + MuJoCo Warp,多个环境并行 stepping |
| 学习算法 | PPO / rsl_rl |
| 策略接口 | 61D actor observation → 14D 舵机动作 |
| 交付形式 | PyTorch checkpoint、ONNX 推理模型、离屏回放 |
训练不是拿视频当真值
视频是训练后的结果展示,不是训练标签。每个仿真步里,环境知道机器人当前的姿态、速度、接触和命令;策略根据观测输出动作,物理引擎推进一小步,然后环境给出奖励和是否结束的信号。
每个模式都是一条独立的 PPO 训练任务。共享的是机器人模型、观测和动作接口;最终网络权重不共享。这样做的原因很实际:走路希望持续跟踪速度,起身希望完成一个阶段动作,踢球希望在短时间内产生冲击,翻滚则允许身体主动接触地面,它们的目标并不相同。
奖励函数怎么把动作“塑形”出来
奖励不是一句“做得像人就加分”,而是几类可测量的量加起来。不同任务会删减或调整其中一些项。
| 奖励 / 终止信号 | 直观含义 | 典型用途 |
|---|---|---|
| 速度或方向跟踪 | 实际速度接近期望命令 | Velocity、滚轮速度 |
| 姿态与站立高度 | 身体保持可控姿态,不塌腰、不钻地 | 走路、起身 |
| 目标动作进度 | 头部下探、回到站立位、球的位移等 | GroundPick、BallKick、StandUp |
| 足端接触与步态 | 交替支撑、抬脚、落脚更自然 | 双足行走 |
| 动作变化与力矩 | 少抖动、少用不必要的力 | 几乎所有任务 |
fell_over / nan_state | 跌倒或数值异常,直接结束 episode | 安全边界与数值保护 |
例如速度模式里,策略不能只“躺着不动”:躺着可能让某些姿态项变好,但速度跟踪、存活时间、足端接触和跌倒终止会一起把这个投机解压下去。滚轮模式则会换成 wheel_speed、heading_hold 等更适合轮式运动的项。
从 smoke test 到正式训练
开发机和兼容性
本次正式训练使用 dev1-docker 上的 8 张 RTX 4090。宿主机 Driver 535.98,系统报告 CUDA 12.2;没有升级驱动,而是使用 CUDA 12.6 的用户态 Torch wheel。
| 组件 | 本次使用版本 |
|---|---|
| Python | 3.12.13 |
| PyTorch | 2.7.1 + cu126 |
| Warp | 1.12.0 |
| mjlab | 1.3.0 |
| MuJoCo Warp | 3.8.1 |
| GPU | 8 × NVIDIA RTX 4090,单卡约 24.6 GiB |
Driver 535 下会看到 CUDA Graphs disabled。这意味着少了一项性能优化,不意味着 CUDA stepping 或 PPO 训练不可用。要迁移到其他机器,先跑 smoke test,不要直接照搬吞吐和训练时间。
第一步:5 个 iteration 的闭环检查
cd codes/practices/humanoid/microduck-rl
UV_HTTP_TIMEOUT=600 uv sync --locked

uv run list-envs | grep MicroDuck

WANDB_MODE=offline uv run train Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --env.seed 42 \
  --agent.seed 42 \
  --agent.max-iterations 5
这个阶段只看四件事:任务能否注册、MJCF 和网格能否加载、GPU 是否能正常 stepping、是否出现 NaN / Inf / OOM。5 个 iteration 的 checkpoint 只能证明管线通了,不能拿来宣传“学会走路”。
第二步:分阶段训练 18 个任务
训练脚本把任务串行跑,先从 smoke checkpoint 续训,再按每个任务的目标轮数继续训练。串行是为了控制单卡显存和日志数量;并不是 18 个模式共享一个 PPO 网络。
cd codes/practices/humanoid/microduck-rl
./scripts/train_stable_matrix_stage1.sh
./scripts/train_stable_matrix_stage2.sh
训练完成后生成回放和汇总图:
./scripts/evaluate_stable_matrix.sh
uv run python scripts/summarize_training_matrix.py
最后一步会使用实际 mjlab 环境读取每个任务的 checkpoint,固定命令渲染 200 帧,并记录 done_count、躯干最低高度和直立度代理指标。教程里嵌入的 GIF/MP4 都来自这一步,不是从训练日志里截一段画面。
训练结果:18 个模式各自有一份策略
验收记录:三个主展示动作
本轮按实际 mjlab 的固定条件回放重新筛选主展示动作。最终使用轮式起身、轮式转向和踢球:动作过程清楚,素材经过近距离裁切,踢球片段还截去了后续重置画面。
| 动作 | 说明 | 固定条件验收 | GIF | MP4 |
|---|---|---|---|---|
| RollerStandUp | 从趴地状态起身并站稳 | 起身后保持站立;初始趴地帧单独计入筛查 | 播放 | 下载 |
| Velocity-Swizzle | 轮式转向 | 0/150 疑似倒地帧;最低躯干高度 0.0975 m;直立度最低 0.9887 | 播放 | 下载 |
| BallKick-Flat | 踢球并收势 | 0/120 疑似倒地帧;最低躯干高度 0.0955 m;直立度最低 0.7072 | 播放 | 下载 |
三段视频和完整验收字段见 figs/focus-final/evaluation.tsv。统一验收方式是实际 mjlab 环境、固定 seed 42、单环境、50 Hz;fell_like 只用于筛查画面中的明显失稳,不能替代多 seed 或真机测试。
原先集中训练的 StandUp-Flat、GroundPick-Flat 仍保留在训练脚本和实验日志中。当前复核显示 StandUp 中间姿态不连贯,GroundPick 微调后仍停在低伏姿态,因此暂不作为首页主展示。踢球主展示使用的是单独固定条件回放,并截取了完成踢球后的稳定收势段。
下表里的“轮数”是最终 checkpoint 的 iteration;“回放”表示该 checkpoint 已经被离屏脚本加载并生成视频。ok 是工程验收状态,不代表在所有随机地形、所有速度和真机上都稳定。
| 模式 | 任务 ID | checkpoint | 回放 |
|---|---|---|---|
| 平地走路 | Velocity-Flat | 3000 | ✅ |
| 粗糙地面走路 | Velocity-Rough | 3000 | ✅ |
| 平地速度 + 起立 | VelStand-Flat | 2500 | ✅ |
| 粗糙地面速度 + 起立 | VelStand-Rough | 2500 | ✅ |
| 平地起身 | StandUp-Flat | 4000 | ✅ |
| 粗糙地面起身 | StandUp-Rough | 4000 | ✅ |
| 平地坐下 / 起立 | SitStand-Flat | 2500 | ✅ |
| 粗糙地面坐下 / 起立 | SitStand-Rough | 2500 | ✅ |
| 平地拾取 | GroundPick-Flat | 2000 | ✅ |
| 粗糙地面拾取 | GroundPick-Rough | 2000 | ✅ |
| 平地踢球 | BallKick-Flat | 1500 | ✅ |
| 轮式速度 | Roller-Velocity | 5000 | ✅ |
| 轮式转向 / Swizzle | Roller-Swizzle | 3000 | ✅ |
| 轮式蹲伏 | Roller-Crouch | 1500 | ✅ |
| 轮式坡面 | Roller-Slope | 1500 | ✅ |
| 轮式起身 | Roller-StandUp | 4000 | ✅ |
| 原地旋转 | Spin | 3000 | ✅ |
| 翻滚 | Roulade | 6000 | ✅ |
其余训练 case 的 checkpoint 和日志仍可按训练脚本复现;教程仓库只保留精选的三段 GIF/MP4,避免把未通过画面验收的素材继续作为结果传播。
如何自己播放一个 checkpoint
有桌面显示会话时,可以直接打开 viewer:
cd codes/practices/humanoid/microduck-rl
uv run play Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file logs/rsl_rl/mode_matrix_stable/<run>/model_3000.pt \
  --num-envs 1
没有 DISPLAY 时,用同一套 mjlab 环境离屏渲染:
MUJOCO_GL=egl PYOPENGL_PLATFORM=egl \
uv run python scripts/render_mjlab_checkpoint.py \
  Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint logs/rsl_rl/mode_matrix_stable/<run>/model_3000.pt \
  --mp4 /tmp/microduck-velocity.mp4 \
  --gif /tmp/microduck-velocity.gif \
  --frames 200 --lin-vel-x 0.15
训练日志、checkpoint 和 W&B offline run 不放进教程仓库;页面只保留精选的演示素材和复现脚本。这样仓库不会被几十 GB 的实验中间文件拖慢,读者也能清楚地区分“代码”“模型”和“展示结果”。
这次迁移改了什么
原项目是一个面向研究和真机实验的工程,直接放进教程会有两个问题:读者不知道先看什么,训练结果也容易被误读成“只要跑通命令就能稳定走路”。这次集成主要做了几件事:
- 保留上游的 MJCF、BAM、任务注册和训练脚本,不把核心逻辑改写成玩具环境;
- 增加 CUDA 12.2 / Driver 535 的兼容组合,使用 Torch cu126 用户态 runtime,避免要求升级宿主机驱动;
- 修复滚轮起立任务的 articulated joint → servo joint 索引映射,补上 CPU 配置和奖励回归测试;
- 增加两阶段训练、离屏评估、回放统计和跨模式汇总图;
- 把教程叙事改成“先看视频,再看训练闭环,最后自己跑”,同时明确仿真候选策略与真机稳定性之间的边界。
继续玩:从小黄鸭迁移到二次元娃娃
如果要把项目做成一个会走、会做动作、还能和人互动的二次元娃娃,建议按下面的顺序迁移,而不是一开始就换掉全部模型:
- 先换外观:保留 MicroDuck 的腿部自由度和控制接口,只替换头部、外壳和材质,确认质量、碰撞和质心没有被破坏;
- 再换身体比例:重新标定关节限位、质量、惯量、脚底尺寸和执行器力矩上限;
- 重新做动作库:走路、起身、挥手、鞠躬、转身等动作分别定义命令与奖励,继续采用“一种技能一份策略”的方式;
- 最后接感知和交互:把视觉目标、语音或高层行为树作为命令生成器,不要把摄像头像素直接塞进第一版 locomotion 策略;
- sim2real 小步落地:先低速、吊绳或保护架测试,再做地面摩擦、舵机延迟、编码器偏置和电池电压的校准。
这条路线的商业价值也比较清晰:同一套仿真和训练基础设施可以服务于教育套件、展厅互动机器人、IP 角色玩具和小型服务机器人;真正需要重新训练的,通常是身体比例、执行器和动作目标,而不是从零重写整套工具链。
练习题
- 把 Velocity 的
--lin-vel-x从0.15改成-0.1,观察后退时的步态是否仍然稳定; - 在
microduck_velocity_env_cfg.py中找到pose、upright、action_rate_l2,解释每一项防止了哪种投机动作; - 给 GroundPick 增加一个“目标没有被抬起就不算完成”的终止或奖励项,再跑一次短训练;
- 比较同一个 checkpoint 的 viewer 回放和
render_mjlab_checkpoint.py回放,确认二者使用的是同一套观测和执行器链路。
代码和上游
- 教程代码:codes/practices/humanoid/microduck-rl(仓库网页)
- 上游项目:pollen-robotics/microduck_rl
- 上游版本:
develop分支,commitd424a0c - 许可证:代码 Apache-2.0;3D 模型按上游说明使用 CC BY-SA-NC
最后提醒一次:页面上的 GIF 是训练后 checkpoint 的固定场景回放,适合演示和教程复现;要把策略装上真实机器人,还需要多 seed、更多地形和速度范围、硬件限位、低速保护以及 sim2real 验证。