Skip to content

第1章:预备定理 ​

编辑:赵志民, 李一飞


本章将对书中出现或用到的重要定理进行回顾,并简要解释其证明和应用场景。对于可能不熟悉相关基础知识的读者,建议参考附录中的基础知识部分。通过这些定理的阐述,希望帮助读者更好地理解数学推导的核心原理,并为后续章节的学习打下坚实基础。大数定律(Law of Large Numbers)和集中不等式(Concentration Inequality)密切相关,二者共同揭示了随机变量偏离其期望值的行为。大数定律说明,当样本量足够大时,样本均值会以概率收敛于总体的期望值,反映了长期平均结果的稳定性。而集中不等式(定理 1.8 至 1.18)则更进一步,为随机变量在有限样本量下偏离其期望值的可能性提供了精确的上界。这些不等式描述了随机变量偏离期望值的程度有多大,通过对概率的约束,确保这种偏离发生的概率较小,从而为各种随机现象提供了更细致的控制。集中不等式在大数定律的基础上提供了有力的工具,用于分析有限样本中的波动。

1.1 Jensen 不等式 ​

对于任意凸函数 f,则有:

f(E[X])≤E[f(X)]

成立。

证明 ​

设 p(x) 为 X 的概率密度函数。由 Taylor 展开式及 f 的凸性,可知 ∃ξ 使得:

f(x)=f(E[X])+f′(E[X])(x−E[X])+f′′(ξ)2(x−E[X])2≥f(E[X])+f′(E[X])(x−E[X])

对上式取期望,得到:

E[f(X)]=∫p(x)f(x)dx≥f(E[X])∫p(x)dx+f′(E[X])∫p(x)(x−E[X])dx=f(E[X])

因此,原不等式得证。

如果 f 是凹函数,则 Jensen 不等式变为:

f(E[X])≥E[f(X)]

这一结论可以通过将上述证明中的 f 替换为 −f 得到。◻

1.2 Hölder 不等式 ​

对于任意 p,q∈R+,且满足 1p+1q=1,则有:

E[|XY|]≤(E[|X|p])1p(E[|Y|q])1q

成立。

证明 ​

设 f(x) 和 g(y) 分别为 X 和 Y 的概率密度函数,定义:

M=|x|(∫X|x|pf(x)dx)1p,N=|y|(∫Y|y|qg(y)dy)1q

代入 Young 不等式:

MN≤1pMp+1qNq

对该不等式两边同时取期望:

E[|XY|](E[|X|p])1p(E[|Y|q])1q=∫XY|xy|f(x)g(y)dxdy(∫X|x|pf(x)dx)1p(∫Y|y|qg(y)dy)1q≤∫X|x|pf(x)dxp∫X|x|pf(x)dx+∫Y|y|qg(y)dyq∫Y|y|qg(y)dy=1p+1q=1

因此,Hölder 不等式得证。◻

1.3 Cauchy-Schwarz 不等式 ​

当 p=q=2 时,Hölder 不等式退化为 Cauchy-Schwarz 不等式:

E[|XY|]≤E[X2]⋅E[Y2]

1.4 Lyapunov 不等式 ​

对于任意 0<r≤s,有:

E[|X|r]r≤E[|X|s]s

证明 ​

由 Hölder 不等式: 对任意 p≥1,有:

E[|X|r]=E[|X⋅1|r]≤(E[|X|rp])1p⋅(E[1q])1q=(E[|X|rp])1p

记 s=rp≥r,则:

E[|X|r]≤(E[|X|s])rs

因此,原不等式得证。◻

1.5 Minkowski 不等式 ​

对于任意 p≥1,有:

E[|X+Y|p]p≤E[|X|p]p+E[|Y|p]p

证明 ​

由三角不等式和 Hölder 不等式,可得:

E[|X+Y|p]≤E[(|X|+|Y|)|X+Y|p−1]=E[|X∥X+Y|p−1]+E[|Y∥X+Y|p−1]≤(E[|X|p])1p(E[|X+Y|(p−1)q])1q+(E[|Y|p])1p(E[|X+Y|(p−1)q])1q=[(E[|X|p])1p+(E[|Y|p])1p]⋅E[|X+Y|p](E[|X+Y|p])1p

化简后即得证。◻

1.6 Bhatia-Davis 不等式 ​

对 X∈[a,b],有:

V[X]≤(b−E[X])(E[X]−a)≤(b−a)24

证明 ​

因为 a≤X≤b,所以有:

0≤E[(b−X)(X−a)]=−E[X2]−ab+(a+b)E[X]

因此,

V[X]=E[X2]−E[X]2≤−ab+(a+b)E[X]−E[X2]=(b−E[X])(E[X]−a)

考虑 AM-GM 不等式:

xy≤(x+y2)2

将 x=b−E[X] 和 y=E[X]−a 带入并化简即得证。◻

1.7 Union Bound(Boole's)不等式 ​

对于任意事件 X 和 Y,有:

P(X∪Y)≤P(X)+P(Y)

证明 ​

根据概率的加法公式:

P(X∪Y)=P(X)+P(Y)−P(X∩Y)≤P(X)+P(Y)

由于 P(X∩Y)≥0,因此不等式得证。◻

1.8 Markov 不等式 ​

若 X≥0,则对于任意 ε>0,有:

P(X≥ε)≤E[X]ε

证明 ​

由定义可得:

E[X]=∫0∞xp(x)dx≥∫ε∞xp(x)dx≥ε∫ε∞p(x)dx=εP(X≥ε)

因此,原不等式得证。◻

1.9 Chebyshev 不等式 ​

对于任意 ε>0,有:

P(|X−E[X]|≥ε)≤V[X]ε2

证明 ​

利用 Markov 不等式,得到:

P(|X−E[X]|≥ε)=P((X−E[X])2≥ε2)≤E[(X−E[X])2]ε2=V[X]ε2

因此,Chebyshev 不等式得证。◻

1.10 Cantelli 不等式 ​

对于任意 ε>0,有:

P(X−E[X]≥ε)≤V[X]V[X]+ε2

证明 ​

设 Y=X−E[X],则对于任意 λ≥0,有:

P(X−E[X]≥ε)=P(Y≥ε)=P(Y+λ≥ε+λ)=P((Y+λ)2≥(ε+λ)2)≤E[(Y+λ)2](ε+λ)2=V[X]+λ2(ε+λ)2

通过对 λ 求导,得右端在 λ=V[X]ε 时取得最小值 V[X]V[X]+ε2,因此:

P(X−E[X]≥ε)≤V[X]V[X]+ε2

原不等式得证。◻

值得注意的是,Cantelli 不等式是 Chebyshev 不等式的加强版,也称为单边 Chebyshev 不等式。通过类似的构造方法,可以推导出比 Cantelli 不等式更严格的上界。

1.11 Chernoff 界(Chernoff-Cramér 界) ​

对于任意 λ>0,ε>0,有:

P(X≥ε)≤minλ>0E[eλX]eλε

对于任意 λ<0,ε>0,有:

P(X≤ε)≤minλ<0E[eλX]eλε

证明 ​

应用 Markov 不等式,有:

P(X≥ε)=P(eλX≥eλε)≤E[eλX]eλε,λ>0,ε>0

同理,

P(X≤ε)=P(eλX≤eλε)≤E[eλX]eλε,λ<0,ε>0

因此,Chernoff 界得证。◻

基于上述 Chernoff 界的技术,我们可以进一步定义次高斯性:

定义 1 (随机变量的次高斯性):若一个期望为零的随机变量 X 的矩母函数满足 ∀λ∈R+:

E[eλX]≤exp⁡(σ2λ22)

则称 X 服从参数为 σ 的次高斯分布。

实际上,Hoeffding 引理中的随机变量 X 服从 (b−a)2 的次高斯分布。Hoeffding 引理也是次高斯分布的直接体现。次高斯性还有一系列等价定义,这里不作详细讨论。

次高斯分布有一个直接的性质:假设两个独立的随机变量 X1,X2 都是次高斯分布的,分别服从参数 σ1,σ2,那么 X1+X2 就是服从参数为 σ12+σ22 的次高斯分布。这个结果的证明可以直接利用定义来完成。

显然,并非所有常见的随机变量都是次高斯的,例如指数分布。为此可以扩大定义:

定义 2 (随机变量的次指数性):若非负的随机变量 X 的矩母函数满足 ∀λ∈(0,a):

E[eλX]≤aa−λ

则称 X 服从参数为 (V[X],1/a) 的次指数分布。

同样地,次指数性也有一系列等价定义。一种不直观但更常用的定义如下:存在 (σ2,b),使得 ∀|s|<1/b:

E[es(X−E[X])]≤exp⁡(s2σ22)

常见的次指数分布包括:指数分布,Gamma 分布,以及任何有界随机变量。

类似地,次指数分布对于加法也是封闭的:如果 X1,X2 分别是服从 (σ12,b1) 和 (σ22,b2) 的次指数分布,那么 X1+X2 是服从 (σ12+σ22,max(b1,b2)) 的次指数分布。在高维统计问题中,次高斯分布和次指数分布的尾端控制能得到一些重要的结论。

1.12 Chernoff 不等式(乘积形式) ​

对于 m 个独立同分布的随机变量 xi∈[0,1],i∈[m],设 X=∑i=1mXi,μ>0 且 r≤1。若对所有 i≤m 都有 E[xi]≤μ,则:

P(X≥(1+r)μm)≤e−r2μm3,r≥0P(X≤(1−r)μm)≤e−r2μm2,r≥0

证明 ​

应用 Markov 不等式,有:

P(X≥(1+r)μm)=P((1+r)X≥(1+r)(1+r)μm)≤E[(1+r)X](1+r)(1+r)μm

由于 xi 之间是独立的,可得:

E[(1+r)X]=∏i=1mE[(1+r)xi]≤∏i=1mE[1+rxi]≤∏i=1m(1+rμ)≤erμm

其中,第二步使用了 ∀x∈[0,1] 都有 (1+r)x≤1+rx,第三步使用了 E[xi]≤μ,第四步使用了 ∀x∈[0,1] 都有 1+x≤ex。

又由于 ∀r∈[0,1],有 er(1+r)1+r≤e−r23,综上所述:

P(X≥(1+r)μm)≤(er(1+r)(1+r))μm≤e−r2μm3

当我们将 r 替换为 −r 时,根据之前的推导,并利用 ∀r∈[0,1] 有 er(1−r)1−r≤e−r22,可得第二个不等式的证明。◻

1.13 最优 Chernoff 界 ​

如果 X 是一个随机变量,并且 E[eλ(X−EX)]≤eϕ(λ) 对于所有 λ≥0 成立,则有以下结论:

P(X−EX≥ε)≤e−ϕ∗(ε),ε≥0

或

P(X−EX≤(ϕ∗)−1(ln⁡(1/δ)))≥1−δ,δ∈[0,1]

其中,ϕ∗ 是 ϕ 的凸共轭函数,即 ϕ∗(x)=supλ≥0(λx−ϕ(λ))。

证明 ​

根据 Chernoff 不等式,有:

P(X−EX≥ε)≤infλ≥0e−λεE[eλ(X−EX)]≤infλ≥0eϕ(λ)−λε=e−supλ≥0(λε−ϕ(λ))=e−ϕ∗(ε)

因此,最优 Chernoff 界得证。◻

1.14 Hoeffding 不等式 ​

设有 m 个独立随机变量 Xi∈[ai,bi],令 X¯ 为 Xi 的均值。Hoeffding 不等式表示:

P(X¯−E[X¯]≥ε)≤exp⁡(−2m2ε2∑i=1m(bi−ai)2)

证明 ​

首先,我们引入一个引理 (Hoeffding 定理):

对于 E[X]=0 且 X∈[a,b] 的随机变量,对于任意 λ∈R,有:

E[eλX]≤exp⁡(λ2(b−a)28)

由于 ex 是凸函数,对于任意 x∈[a,b],可以写为:

eλx≤b−xb−aeλa+x−ab−aeλb

对上式取期望,得到:

E[eλX]≤b−E[X]b−aeλa+E[X]−ab−aeλb=beλa−aeλbb−a

记 θ=−ab−a,h=λ(b−a),则:

beλa−aeλbb−a=[1−θ+θeh]e−θh=eln⁡(1−θ+θeh)e−θh=eln⁡(1−θ+θeh)−θh

定义函数 φ(θ,h)=ln⁡(1−θ+θeh)−θh。注意到 θ 实际上与 h 无关。对 h 求偏导数:

∂φ∂h=θeh1−θ+θeh−θ

显然有 ∂φ∂h|h=0+=0。同理,利用链式法则可得:

∂2φ∂h2=θeh(1−θ+θeh)−θ2e2h(1−θ+θeh)2=θeh1−θ+θeh(1−θeh1−θ+θeh)≤14

根据泰勒展开式,可以得到:

φ(θ,h)≤h28=λ2(b−a)28

由 Markov 不等式可知,对于任意 λ>0:

P(X¯−E[X¯]≥ε)=P(eλ(X¯−E[X¯])≥eλε)≤E[eλ(X¯−E[X¯])]eλε

利用随机变量的独立性及 Hoeffding 引理,有:

E[eλ(X¯−E[X¯])]eλε=e−λε∏i=1mE[eλ(Xi−E[Xi])/m]≤e−λε∏i=1mexp⁡(λ2(bi−ai)28m2)

考虑二次函数 g(λ)=−λε+λ28m2∑i=1m(bi−ai)2,其最小值为 −2m2ε2∑i=1m(bi−ai)2。

因此可以得到:

P(X¯−E[X¯]≥ε)≤exp⁡(−2m2ε2∑i=1m(bi−ai)2)

◻

注意,这里并未要求随机变量同分布,因此Hoeffding 不等式常用来解释集成学习的基本原理。

1.15 McDiarmid 不等式 ​

对于 m 个独立随机变量 Xi∈X,若函数 f 是差有界的,则对于任意 ε>0,有:

P(f(X1,⋯,Xm)−E[f(X1,⋯,Xm)]≥ε)≤exp⁡(−ε22∑i=1mci2)

证明 ​

构造一个鞅差序列:

Dj=E[f(X)∣X1,⋯,Xj]−E[f(X)∣X1,⋯,Xj−1]

容易验证:

f(X)−E[f(X)]=∑i=1mDi

由于 f 是差有界的,因此满足 Azuma-Hoeffding 引理。代入后可得:

P(f(X1,⋯,Xm)−E[f(X1,⋯,Xm)]≥ε)≤exp⁡(−ε22∑i=1mci2)

原不等式得证。◻

1.16 Bennett 不等式 ​

对于 m 个独立随机变量 Xi,令 X¯ 为 Xi 的均值,若存在 b>0,使得 |Xi−E[Xi]|<b,则有:

P(X¯−E[X¯]≥ε)≤exp⁡(−mε22(∑i=1mV[Xi]/m+bε/3))

证明 ​

首先,Bennett 不等式是 Hoeffding 不等式的一个加强版,对于独立随机变量的条件可以放宽为弱独立条件,结论仍然成立。

这些 Bernstein 类的集中不等式更多地反映了在非渐近观点下的大数定律表现,即它们刻画了样本均值如何集中在总体均值附近。

如果将样本均值看作是样本(数据点的函数),即令 f(X1,⋯,Xm)=∑i=1mXi/m,那么 Bernstein 类不等式刻画了如下的概率:

P(f(X1,⋯,Xm)−E[f(X1,⋯,Xm)]≥ε)

为了在某些泛函上也具有类似 Bernstein 类的集中不等式形式,显然 f 需要满足某些特定性质。差有界性是一种常见的约束条件。

定义 3: 差有界性 ​

函数 f:Xm→R 满足对于每个 i,存在常数 ci<∞,使得:

|f(x1,⋯,xi,⋯,xm)−f(x1,⋯,xi′,⋯,xm)|≤ci

则称 f 是差有界的。

为了证明这些结果,需要引入一些新的数学工具。

定义 4: 离散鞅 ​

若离散随机变量序列(随机过程)Zm 满足:

  1. E[|Zi|]<∞
  2. E[Zm+1∣Z1,⋯,Zm]=E[Zm+1∣Fm]=Zm

则称序列 Zi 为离散鞅。

引理 2: Azuma-Hoeffding 定理 ​

对于鞅 Zi,若 E[Zi]=μ,Z1=μ∘,则构造鞅差序列 Xi=Zi−Zi−1,且 |Xi|≤ci,则对于任意 ε>0,有:

P(Zm−μ≥ε)=P(∑i=1mXi≥ε)≤exp⁡(−ε22∑i=1mci2)

证明 ​

首先,若 E[X∣Y]=0,则有 ∀λ>0:

E[eλX∣Y]≤E[eλX]

因此,由恒等式 E[E[X∣Y]]=E[X] 及 Chernoff 一般性技巧,对于任意 λ>0:

P(Zm−μ≥ε)≥e−λεE[eλ(Zm−μ)]=e−λεE[E[eλ(Zm−μ)∣Fm−1]]=e−λεE[eλ(Zm−1−μ)E[eλ(Zm−Zm−1)∣Fm−1]]

由于 {Xi} 是鞅差序列,因此 E[Xm∣Fm−1]=0,E[Xi]=0。再结合不等式 E[eλX∣Y]≤E[eλX] 及 Hoeffding 引理,有:

P(Zm−μ≥ε)≤e−λεE[eλ(Zm−1−μ)]E[eλXn]≤e−λεE[eλ(Zm−1−μ)]exp⁡(λ2cm22)

迭代上不等式可得:

P(Zm−μ≥ε)≤e−λε∏i=1mexp⁡(λ2ci22)

当 λ=ε∑i=1mci2 时,上式右端取得极小值:

P(Zm−μ≥ε)≤exp⁡(−ε22∑i=1mci2)

原不等式得证。◻

1.17 Bernstein 不等式 ​

考虑 m 个独立同分布的随机变量 Xi,i∈[m]。令 X¯=∑i=1mXim。若存在常数 b>0,使得对所有 k≥2,第 k 阶矩满足 E[|Xi|k]≤k!bk−22V[X1],则该不等式成立:

P(X¯≥E[X¯]+ϵ)≤exp⁡(−mϵ22V[X1]+2bϵ)

证明 ​

首先,我们需要将矩条件(Moment Condition)转换为亚指数条件(Sub-exponential Condition),以便进一步推导,即:

  • 矩条件: 对于随机变量 X,其 k-阶中心矩 满足如下条件:

    E[|X−E[X]|k]≤k!bk−22V[X],∀k≥2

    其中:

    1. 中心矩:随机变量 X 的 k 阶中心矩为 E[|X−E[X]|k],表示 X 偏离其期望值的 k 次幂的期望值。中心矩用于衡量随机变量的分布形状,尤其是描述其尾部行为。当 k=2 时,中心矩即为随机变量的方差。
    2. k!2 是阶乘项,随着 k 增大迅速增长。
    3. bk−2 是一个修正因子,其中 b 为常数,用以控制高阶矩的增长速率。
    4. V[X] 表示随机变量 X 的方差,它作为标准的离散度量来标定中心矩的大小。
  • 亚指数条件: 给定随机变量 X,其均值为 E[X],方差为 V[X],则其偏离均值的随机变量 X−E[X] 的矩母函数(MGF)满足如下不等式:

    E[eλ(X−E[X])]≤exp⁡(V[X]λ22(1−bλ)),∀λ∈[0,1b)

    其中:

    1. 矩母函数:这是一个重要的工具,用于控制随机变量的尾部概率。矩母函数的形式是 E[eλX],它通过调整 λ 来捕捉不同程度的偏差行为。
    2. 方差主导项:不等式右边的表达式包含一个方差主导的项 V[X]λ22,类似于高斯分布的尾部特性,表明当 λ 较小时,X 的偏差行为主要由其方差控制,尾部概率呈现指数衰减。
    3. 修正项 (1−bλ):该项显示,当 λ 接近 1b 时,尾部偏差的控制变得更加复杂。这种形式通常出现在亚指数条件中,意味着随机变量的尾部行为介于高斯分布和重尾分布之间,尾部衰减较慢但仍比重尾分布快。

  • 步骤 1:中心化随机变量

设:

Y=X−E[X]

我们的目标是对 Y 的矩母函数(MGF)进行上界:

E[eλY]
  • 步骤 2:展开指数矩

将 MGF 展开为幂级数(Taylor展开):

E[eλY]=E[∑k=0∞(λY)kk!]=∑k=0∞λkk!E[Yk]

由于 E[Y]=0,故 k=1 项消失:

E[eλY]=1+∑k=2∞λkk!E[Yk]
  • 步骤 3:使用矩条件对中心矩进行上界

根据矩条件:

E[|Y|k]≤k!bk−22V[X]

因此:

|E[Yk]|≤E[|Y|k]≤k!bk−22V[X]
  • 步骤 4:代入 MGF 展开式

将上界代入 MGF 展开式:

E[eλY]≤1+∑k=2∞λkk!⋅k!bk−22V[X]=1+V[X]2∑k=2∞(bλ)k−2λ2

通过令 j=k−2 进行简化:

E[eλY]≤1+V[X]λ22∑j=0∞(bλ)j
  • 步骤 5:求解几何级数的和

当 bλ<1 时,几何级数收敛:

∑j=0∞(bλ)j=11−bλ

因此:

E[eλY]≤1+V[X]λ22(1−bλ)
  • 步骤 6:应用指数不等式

使用不等式 1+x≤ex 对所有实数 x 成立:

E[eλY]≤exp⁡(V[X]λ22(1−bλ))

这与亚指数条件相符:

E[eλY]≤exp⁡(V[X]λ22(1−bλ)),∀λ∈[0,1b)

接下来我们完成在给定矩条件下的Bernstein 不等式的证明,即:

陈述:

给定 m 个独立同分布的随机变量 Xi,i∈[m],令 X¯=1m∑i=1mXi。若存在常数 b>0,使得对所有 k≥2,

E[|Xi−E[Xi]|k]≤k!bk−22V[X1],

则对于任意 ϵ>0,

P(X¯≥E[X¯]+ϵ)≤exp⁡(−mϵ22V[X1]+2bϵ)
  • 步骤 1:定义单侧 Bernstein 条件

首先,回顾对于参数 b>0 的单侧 Bernstein 条件:

E[eλ(Y)]≤exp⁡(V[Y]λ2/21−bλ),∀λ∈[0,1b)

其中 Y=X−E[X]。

根据矩条件,我们已经证明 Y 满足亚指数条件:

E[eλY]≤exp⁡(V[Y]λ22(1−bλ)),∀λ∈[0,1b)

因此,Y 满足单侧 Bernstein 条件,且 V[Y]=V[X]。

  • 步骤 2:应用 Chernoff 界

考虑 m 个独立同分布随机变量 Yi=Xi−E[Xi] 的和:

Sm=∑i=1mYi=m(X¯−E[X¯])

我们的目标是对概率 P(Sm≥mϵ) 进行上界,这等价于 P(X¯≥E[X¯]+ϵ)。

使用Chernoff 界:

P(Sm≥mϵ)≤infλ>0exp⁡(−λmϵ)E[eλSm]
  • 步骤 3:对和的矩母函数进行上界

由于 Yi 是独立的:

E[eλSm]=∏i=1mE[eλYi]≤[exp⁡(V[Yi]λ22(1−bλ))]m=exp⁡(mV[Y]λ22(1−bλ))

因此:

P(Sm≥mϵ)≤infλ>0exp⁡(−λmϵ+mV[Y]λ22(1−bλ))
  • 步骤 4:对 λ 进行优化

为了找到最紧的界,我们需要对 λ 进行优化。最优的 λ 是使指数最小的值:

−λmϵ+mV[Y]λ22(1−bλ)

对 λ 求导并令其为零:

−ϵ+V[Y]λ1−bλ+V[Y]λ2b2(1−bλ)2=0

然而,直接求解该方程较为复杂。我们可以选择:

λ=ϵV[Y]+bϵ

此时 λ 满足 [0,1b) 的范围,因为:

λb=bϵV[Y]+bϵ<1
  • 步骤 5:将最优的 λ 代入界中

将 λ=ϵV[Y]+bϵ 代入指数中:

−λmϵ+mV[Y]λ22(1−bλ)=−mϵ2V[Y]+bϵ+mV[Y](ϵV[Y]+bϵ)22(1−bϵV[Y]+bϵ)

在第二项中简化分母:

1−bλ=1−bϵV[Y]+bϵ=V[Y]V[Y]+bϵ

现在,代入回去:

−mϵ2V[Y]+bϵ+mϵ22(V[Y]+bϵ)=−mϵ22(V[Y]+bϵ)

因此:

P(Sm≥mϵ)≤exp⁡(−mϵ22(V[Y]+bϵ))
  • 步骤 6:回到样本均值

回忆:

Sm=m(X¯−E[X¯])

因此:

P(X¯−E[X¯]≥ϵ)=P(Sm≥mϵ)≤exp⁡(−mϵ22(V[Y]+bϵ))

由于 V[Y]=V[X],我们得到:

P(X¯≥E[X¯]+ϵ)≤exp⁡(−mϵ22(V[X]+bϵ))

◻

1.18 Azuma–Hoeffding(Azuma)不等式 ​

对于均值为 Z0=μ 的鞅差序列 {Zm,m≥1},若 |Zi−Zi−1|≤ci,其中ci>0为已知常数,则对于任意 ε>0,有:

P(Zm−μ≥ε)≤exp⁡(−ε22∑i=1mci2)P(Zm−μ≤−ε)≤exp⁡(−ε22∑i=1mci2)

证明 ​

  1. 构造指数鞅

    考虑参数 s>0,构造如下的指数鞅:

    Mm=exp⁡(s(Zm−μ)−s22∑i=1mci2)

    我们需要证明 {Mm}m≥0 是一个超鞅。

  2. 验证鞅性质

    对于任意 m≥1,有

    E[Mm∣Fm−1]=E[exp⁡(s(Zm−Zm−1))∣Fm−1]⋅exp⁡(s(Zm−1−μ)−s22∑i=1mci2)

    由于 |Zm−Zm−1|≤cm,并且 E[Zm−Zm−1∣Fm−1]=0(鞅性质),可以应用 Hoeffding 引理得到:

    E[exp⁡(s(Zm−Zm−1))∣Fm−1]≤exp⁡(sE[Zm−Zm−1∣Fm−1]+s2(cm−(−cm))28)=exp⁡(s2cm22)

    因此,

    E[Mm∣Fm−1]≤exp⁡(s2cm22)⋅exp⁡(s(Zm−1−μ)−s22∑i=1mci2)=Mm−1

    这表明 {Mm} 是一个超鞅。

  3. 应用鞅不等式

    由于 {Mm} 是一个超鞅,且 M0=exp⁡(0)=1,根据超鞅的性质,有

    E[Mm]≤M0=1

    对于事件 {Zm−μ≥ε},有

    Mm=exp⁡(s(Zm−μ)−s22∑i=1mci2)≥exp⁡(sε−s22∑i=1mci2)

    我们令 a=exp⁡(sε−s22∑i=1mci2),由于 {Zm−μ≥ε} 蕴含了 {Mm≥a},所以:

    P(Zm−μ≥ε)≤P(Mm≥a)

    结合已知的 E[Mm]≤1,应用 Markov 不等式可得:

    P(Mm≥a)≤1a=exp⁡(−sε+s22∑i=1mci2)

    因此,我们得到:

    P(Zm−μ≥ε)≤exp⁡(−sε+s22∑i=1mci2)
  4. 优化参数 s

    为了得到最优的上界,选择 s 使得表达式 −sε+s22∑ci2 最小化。对 s 求导并取零:

    −ε+s∑i=1mci2=0⇒s=ε∑i=1mci2

    代入得:

    P(Zm−μ≥ε)≤exp⁡(−ε22∑i=1mci2)

    这即是 Azuma 不等式的上侧不等式。

  5. 下侧不等式的证明

    对于下侧不等式,可以类似地考虑 −Zm 作为鞅,应用相同的方法得到:

    P(Zm−μ≤−ε)≤exp⁡(−ε22∑i=1mci2)

    因此,Azuma 不等式得证。◻

1.19 Slud 不等式 ​

若 X∼B(m,p),则有:

P(Xm≥12)≥12[1−1−exp⁡(−mε21−ε2)]

其中 p=1−ε2。

证明 ​

二项随机变量 X 表示在 m 次独立伯努利试验中成功的次数,成功概率为 p。对于大的 m,二项分布 B(m,p) 可以近似为均值 μ=mp 和方差 σ2=mp(1−p) 的正态分布:

μ=m(1−ε)2σ2=m(1−ε2)4

令 Z=X−μσ,代入 μ 和 σ,有:

P[Xm≥12]=P[Z≥m2−μσ]=P[Z≥εm1−ε2]

根据正态分布不等式(定理 21),有:

P[Z≥x]≥12[1−1−exp⁡(−2x2π)]≥12[1−1−exp⁡(−x2)]

代入可得:

P[Z≥εm1−ε2]≥12[1−1−exp⁡(−mε21−ε2)]

◻

1.20 上界不等式之加性公式 ​

若 sup(f) 和 sup(g) 分别为函数 f 和 g 的上界,则有:

sup(f+g)≤sup(f)+sup(g)

证明 ​

假设 f,g 分别有相同的定义域 Df,Dg。根据上确界的定义,对于每一个 x∈Df∩Dg,我们有

g(x)≤supy∈Dgg(y),

从而

f(x)+g(x)≤f(x)+supy∈Dgg(y).

因为这对于每一个 x∈Df∩Dg 都成立,我们可以在不等式的两边取上确界,得到:

supx∈Df∩Dg(f(x)+g(x))≤supx∈Df∩Dgf(x)+supy∈Dgg(y)≤supz∈Dff(z)+supy∈Dgg(y).

这里我们使用了 supx∈Df∩Dgf(x)≤supz∈Dff(z),因为 Df∩Dg⊂Df。◻

值得注意的是,该不等式在(4.33)中利用过两次,且原推导并没有用到 Jensen 不等式的任何性质。

另外,加性公式有几个常见的变形,例如:

sup(f−g)−sup(f−k)≤sup(k−g)

该不等式在(4.29)中出现过。

1.21 正态分布不等式 ​

若 X 是一个服从标准正态分布的随机变量,那么对于任意 u≥0,有:

P[X≤u]≤121−e−2πu2

证明 ​

令 G(u)=P[X≤u],则有:

2G(u)=∫−uu(2π)−1/2e−x2/2dx=∫−uu(2π)−1/2e−y2/2dy

因此:

2π[2G(u)]2=∫−uu∫−uue−(x2+y2)/2dxdy

让我们考虑更一般的积分形式:

2π[2G(u)]2=∬Re−(x2+y2)/2dxdy

此时 R 为任意面积为 4u2 的区域。通过反证法可以证明,只有当 R 为以原点为中心的圆形区域 R0 时,积分值最大:

R0={(x,y):π(x2+y2)≤4u2}

此时,有:

2π[2G(u)]2≤∬R0e−(x2+y2)/2dxdy=∫02π∫02uπ−1/2e−r2/2rdrdφ=2π(1−e−2u2/π)

因此,有:

G(u)=P[X≤u]≤121−e−2πu2

进一步,我们可以得到:

P[X≥u]≥12(1−1−e−2πu2)

◻

1.22 AM-GM 不等式 ​

算术平均数和几何平均数的不等式,简称 AM-GM 不等式。该不等式指出非负实数序列的算术平均数大于等于该序列的几何平均数,当且仅当序列中的每个数相同时,等号成立。形式上,对于非负实数序列 {xn},其算术平均值定义为:

An=1n∑i=1nxi

其几何平均值定义为:

Gn=∏i=1nxin

则 AM-GM 不等式成立:

An≥Gn

证明 ​

我们可以通过 Jensen 不等式来证明 AM-GM 不等式。首先,我们考虑函数 f(x)=−ln⁡x,该函数是凸函数,因此有:

1n∑i=1n−ln⁡xi≥−ln⁡(1n∑i=1nxi)

即:

ln⁡(1n∑i=1nxi)≥1n∑i=1nln⁡xi=ln⁡(∏i=1nxin)⇒1n∑i=1nxi≥∏i=1nxin

当取 x1=x2=⋯=xn 时,等号成立。特别地,当 n=2 时,我们有:

x1+x22≥x1x2

◻

1.23 Young 不等式 ​

对于任意 a,b≥0 且 p,q>1,若 1p+1q=1,则有:

ab≤app+bqq

当且仅当 ap=bq 时,等号成立。

证明 ​

我们可以通过 Jensen 不等式来证明 Young 不等式。首先,当 ab=0 时,该不等式显然成立。当 a,b>0 时,我们令 t=1/p,1−t=1/q,根据 ln⁡(x) 的凹性,我们有:

ln⁡(tap+(1−t)bq)≥tln⁡(ap)+(1−t)ln⁡(bq)=ln⁡(a)+ln⁡(b)=ln⁡(ab)

当且仅当 ap=bq 时,等号成立。◻

1.24 Bayes 定理 ​

贝叶斯定理是概率论中的一个重要定理,它描述了在已知某些条件下更新事件概率的数学方法。贝叶斯定理的公式为:

P(A|B)=P(B|A)⋅P(A)P(B)

其中:

  • P(A|B) 是在事件 B 发生的情况下事件 A 发生的后验概率。
  • P(B|A) 是在事件 A 发生的情况下事件 B 发生的似然函数。
  • P(A) 是事件 A 的先验概率。
  • P(B) 是事件 B 的边缘概率。

证明 ​

根据条件概率的定义,事件 A 在事件 B 发生下的条件概率 P(A|B) 表示为:

P(A|B)=P(A∩B)P(B)

同样地,事件 B 在事件 A 发生下的条件概率 P(B|A) 表示为:

P(B|A)=P(A∩B)P(A)

通过这两个公式可以得到联合概率 P(A∩B) 的两种表示方式:

P(A∩B)=P(A|B)⋅P(B)

以及:

P(A∩B)=P(B|A)⋅P(A)

由于联合概率的性质,我们可以将上述两个等式等同:

P(A|B)⋅P(B)=P(B|A)⋅P(A)

将上述等式两边同时除以 P(B),得到贝叶斯定理:

P(A|B)=P(B|A)⋅P(A)P(B)

◻

通过先验和后验的更新过程,贝叶斯统计提供了一种动态的、不断修正认知的不确定性量化方法。

1.25 广义二项式定理 ​

广义二项式定理(Generalized Binomial Theorem)是二项式定理的扩展:

(x+y)r=∑k=0∞(rk)xr−kyk,|x|<|y|,k∈N,r∈R

其中我们令 (rk):=(r)kk!,(r)k=r(r−1)⋯(r−k+1) 为递降阶乘(falling factorial)。

证明 ​

首先代入定义,易证:

(r−k)(rk)+(r−(k−1))(rk−1)=r(rk)

我们从特殊情况 y=1 开始。首先我们证明只要 |x|<1,后者级数就会收敛。

通过使用幂级数收敛半径的商式来证明这一点,由于绝对值的连续性使我们可以先在绝对值内部计算极限,可得:

limk→∞|ak||ak+1|=limk→∞|k+1r−k|=|−1|=1

因此我们有一个为 1 的收敛半径。这种收敛使我们能够在 |x|<1 的收敛区域内应用逐项求导,得到:

ddx∑k=0∞(rk)xk=∑k=1∞(r−(k−1))(rk−1)xk−1

如果我们将我们正在考虑的级数定义的函数记为 g(x),我们得到:

(1+x)ddxg(x)=∑k=1∞(r−(k−1))(rk−1)xk−1+∑k=1∞(r−(k−1))(rk−1)xk=r+∑k=1∞((r−k)(rk)+(r−(k−1))(rk−1))xk=r+r∑k=1∞(rk)xk=rg(x),

上式的推导使用了前述引理。

现在定义 f(x)=(1+x)r,我们通过通常的求导规则得到:

ddx(g(x)f(x))=g′(x)f(x)−f′(x)g(x)f(x)2=rg(x)x+1(1+x)r−rg(x)(1+x)r−1f(x)2=0

|x|<1 意味着 f(x)≠0,因此 g/f 为常数。又 f(0)=g(0)=1 可得 f(x)=g(x)。

对于一般的 x,y∈R 且 |x|<|y|,我们有:

(x+y)ryr=(xy+1)r=∑k=0∞(rk)(xy)k;

收敛性由假设 |x/y|<1 保证。为了得到原定理的形式,我们只需乘以 yr 即可。◻

1.26 Stirling 公式 ​

Stirling 公式是用于近似计算阶乘的一种公式,即使在 n 很小时也有很高的精度。Stirling 公式的一种形式为:

n!=2πnn+1/2e−nern

其中,112n+1<rn<112n。

证明 ​

我们令:

Sn=ln⁡(n!)=∑p=1n−1ln⁡(p+1)

且

ln⁡(p+1)=Ap+bp−εp

其中:

Ap=∫pp+1ln⁡xdxbp=12[ln⁡(p+1)−ln⁡(p)]εp=∫pp+1ln⁡xdx−12[ln⁡(p+1)+ln⁡(p)]

此时:

Sn=∑p=1n−1(Ap+bp−εp)=∫1nln⁡xdx+12ln⁡n−∑p=1n−1εp

易证 ∫ln⁡xdx=xln⁡x−x+C,C∈R,故:

Sn=(n+1/2)ln⁡n−n+1−∑p=1n−1εp

此时:

εp=2p+12ln⁡(p+1p)−1

接下来我们对 ln⁡(p+1p) 进行级数展开,根据广义二项式定理,即:

令 a=−1,t=1p,t∈(−1,1),则有:

11+t=1−t+t2−t3+t4−⋯

对上式两边同时进行积分,我们有:

ln⁡(1+t)=t−12t2+13t3−14t4+⋯

如果我们令 −t 来代替 t,则有:

ln⁡11−t=t+12t2+13t3+14t4+⋯

将两式相加,我们有:

12ln⁡1+t1−t=t+13t3+15t5+⋯

回到我们的问题,我们令 t=(2p+1)−1∈(0,1),如此才满足 1+t1−t=p+1p,带入前式:

εp=13(2p+1)2+15(2p+1)4+17(2p+1)6+⋯

因此:

εp<13(2p+1)2∑i=0∞1(2p+1)2i=13(2p+1)211−1(2p+1)2=13[(2p+1)2−1]=112(1p−1p+1)

且

εp>13(2p+1)2∑i=0∞1[3(2p+1)2]i=13(2p+1)211−13(2p+1)2=13(2p+1)2−1

易证

(p+112)(p+1+112)=p2+76p+13144>p2+p+16=112[3(2p+1)2−1],p∈N+

因此:

εp>112(1p+112−1p+1+112)

我们令:

B=∑p=1∞εp,rn=∑p=n∞εp

那么易得:

113<B<112,112(n+1)<rn<112n

带入 Sn 的表达式:

Sn=(n+12)ln⁡n−n+1−B+rn

可得:

n!=e1−Bnn+1/2e−nern

令 C=e1−B,我们可知常数 C 的取值范围为 (e11/12,e12/13),此处我们取 C=2π,该公式得证。◻

1.27 散度定理 ​

散度定理(Divergence Theorem),也称为高斯定理(Gauss's Theorem),是向量分析中的重要定理,它将体积积分和曲面积分联系起来。

具体而言,如果考虑一个 n-维球体(n-ball)Bn 的体积为 V,其表面为 Sn−1,对于一个位于 n-维空间中的光滑向量场 F,则有:

∫Bn(∇⋅F)dV=∮Sn−1F⋅ndS

其中:

  • ∇⋅F 是向量场 F 的散度。
  • dV 是体积元素。
  • dS 是边界表面的面积元素。
  • n 是边界的单位外法向量。

体积积分计算的是在 n-球内的散度,而表面积分计算的是在 n−1 维球面上的通量。 这种形式的散度定理在物理学和工程学中广泛应用,比如电磁学中的高斯定理、流体力学中的质量守恒等。

1.28 分离超平面定理 ​

如果有两个不相交的非空凸集,则存在一个超平面能够将它们完全分隔开,这个超平面叫做分离超平面(Separating Hyperplane)。形式上,设 A 和 B 是 Rn 中的两个不相交的非空凸集,那么存在一个非零向量 v 和一个实数 c,使得:

⟨x,v⟩≥c且⟨y,v⟩≤c

对所有 x∈A 和 y∈B 都成立。即超平面 ⟨⋅,v⟩=c 以 v 作为分离轴(Separating Axis),将 A 和 B 分开。

进一步,如果这两个集合都是闭集,并且至少其中一个是紧致的,那么这种分离可以是严格的,即存在 c1>c2 使得:

⟨x,v⟩>c1且⟨y,v⟩<c2

在不同情况下,我们可以通过调整 v 和 c 来使得分离超平面的边界更加清晰。

AB⟨x,v⟩⟨y,v⟩
闭紧集闭集>c1<c2 且 c2<c1
闭集闭紧集>c1<c2 且 c2<c1
开集闭集>c≤c
开集开集>c<c

在支持向量机的背景下,最佳分离超平面(或最大边缘超平面)是分离两个点凸包并且与两者等距的超平面。

证明 ​

证明基于以下引理:

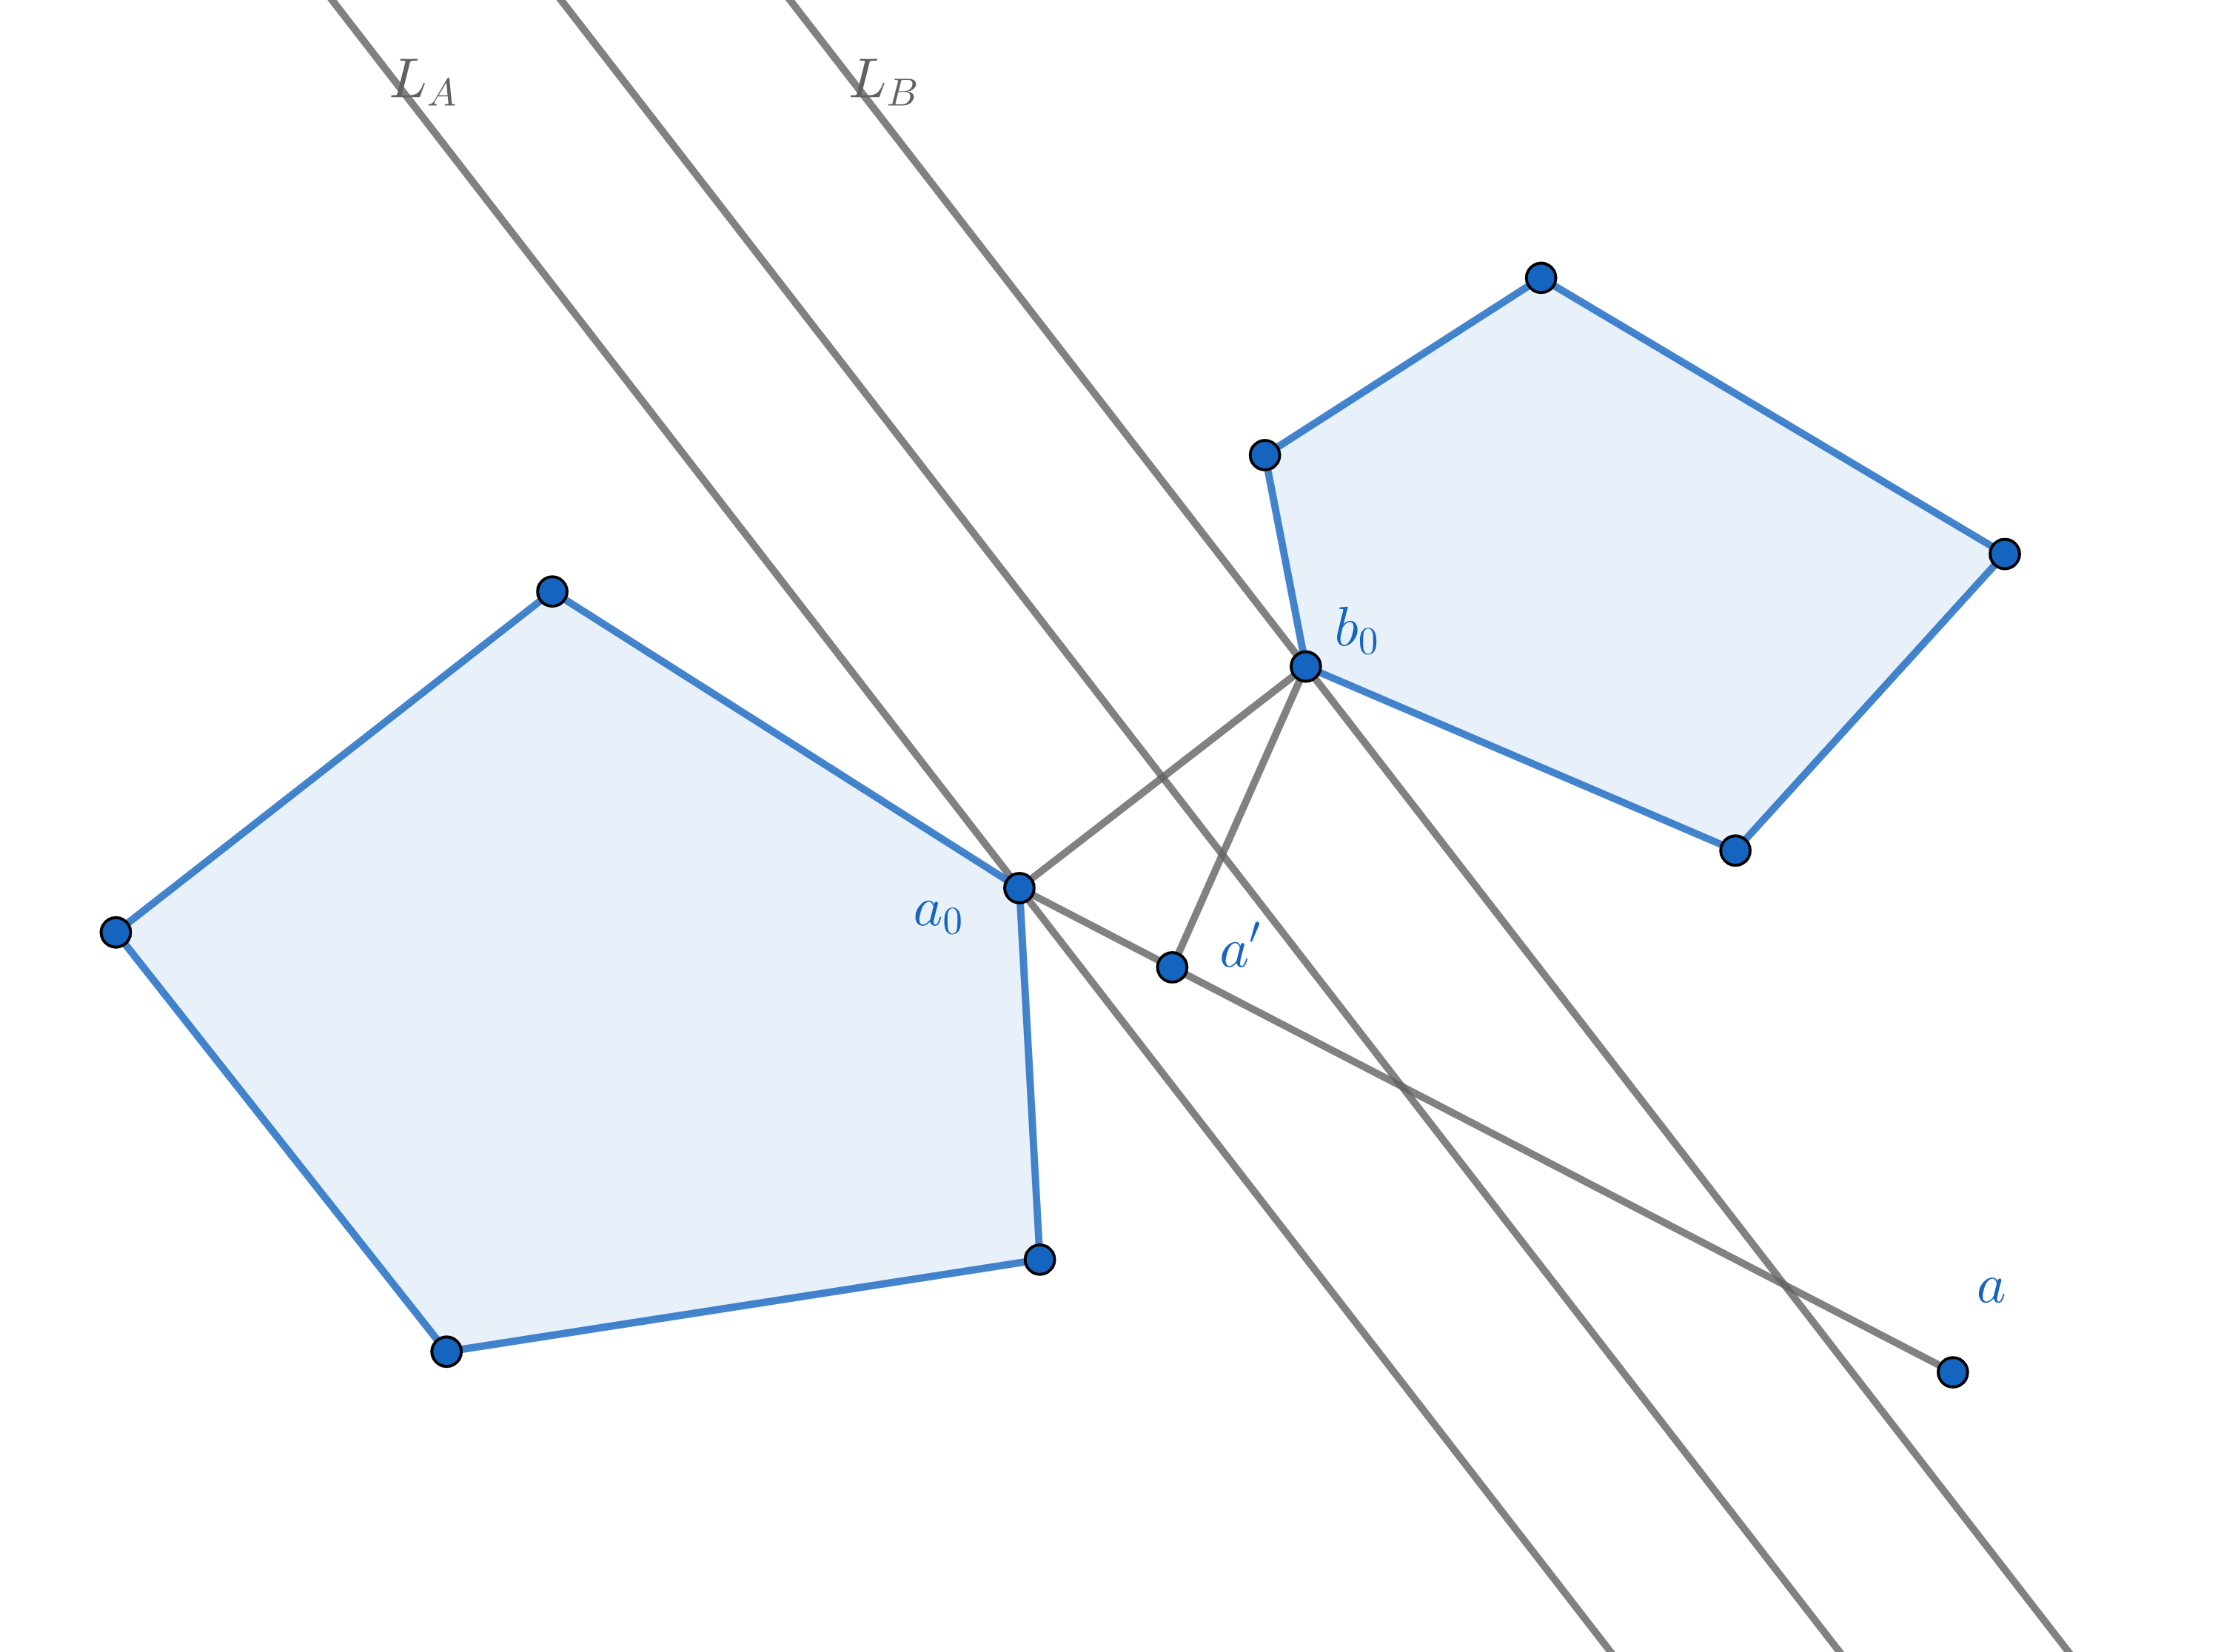
设 A 和 B 是 Rn 中两个不相交的闭集,且假设 A 是紧致的。则存在点 a0∈A 和 b0∈B 使得 ∥a−b∥ 在 a∈A 和 b∈B 之间取最小值。

我们给出引理的证明:

令 a∈A 和 b∈B 是任意一对点,并令 r1=∥b−a∥。由于 A 是紧致的,它被包含在以 a 为中心的一些球中,设该球的半径为 r2。令 S=B∩Br1+r2(a)― 为 B 与以 a 为中心、半径为 r1+r2 的闭球的交集。那么 S 是紧致且非空的,因为它包含 b。由于距离函数是连续的,存在点 a0 和 b0 使得 ∥a0−b0∥ 在所有 A×S 的点对中取最小值。现在要证明 a0 和 b0 实际上在所有 A×B 的点对中具有最小距离。假设存在点 a′ 和 b′ 使得 ∥a′−b′∥<∥a0−b0∥。则特别地,∥a′−b′∥<r1,并且根据三角不等式,∥a−b′∥≤∥a−a′∥+∥a′−b′∥<r1+r2。因此 b′ 包含在 S 中,这与 a0 和 b0 在 A×S 中的最小距离相矛盾。

separating_hyperplane_theorem

不失一般性地,假设 A 是紧致的。根据引理,存在点 a0∈A 和 b0∈B 使得它们之间的距离最小。由于 A 和 B 是不相交的,我们有 a0≠b0。现在,构造两条与线段 [a0,b0] 垂直的超平面 LA,LB,其中 LA 穿过 a0,LB 穿过 b0。我们声称 A 和 B 都没有进入 LA,LB 之间的空间,因此与 (a0,b0) 垂直的超平面满足定理的要求。

代数上,超平面 LA,LB 由向量 v:=b0−a0 定义,并由两个常数 cA:=⟨v,a0⟩<cB:=⟨v,b0⟩ 确定,使得 LA={x:⟨v,x⟩=cA},LB={x:⟨v,x⟩=cB}。我们的主张是 ∀a∈A,⟨v,a⟩≤cA 并且 ∀b∈B,⟨v,b⟩≥cB。

假设存在某个 a∈A 使得 ⟨v,a⟩>cA,则令 a′ 为从 b0 到线段 [a0,a] 的垂足。由于 A 是凸集,a′ 在 A 内部,并且根据平面几何,a′ 比 a0 更接近 b0,这与 a0 和 b0 的最小距离相矛盾。类似的论证适用于 B。◻

1.29 支撑超平面定理 ​

对于一个凸集,支撑超平面(Supporting Hyperplane)是与凸集边界切线的超平面,即它“支撑”了凸集,使得所有的凸集内的点都位于支撑超平面的一侧。形式上,若 S 是非空凸集,且 x0 是 S 的边界上的一点,那么存在一个包含 x0 的支撑超平面。 如果 x∗∈X∗∖{0}(X∗ 是 X 的对偶空间,x∗ 是一个非零的线性泛函),并且对于所有 x∈S 都有 x∗(x0)≥x∗(x),那么 H={x∈X:x∗(x)=x∗(x0)} 定义了一个支撑超平面。

证明 ​

定义 T 为所有支撑闭合半空间的交集,显然 S⊂T。现在令 y∉S,证明 y∉T。

设 x∈int(S),并考虑线段 [x,y]。令 t 为最大的数,使得 [x,t(y−x)+x] 被包含在 S 中。则 t∈(0,1)。令 b=t(y−x)+x,那么 b∈∂S。在 b 处画一条支撑超平面,令其表示为一个非零线性泛函 f:Rn→R,使得 ∀a∈T,f(a)≥f(b)。由于 x∈int(S),我们有 f(x)>f(b)。因此,由 f(y)−f(b)1−t=f(b)−f(x)t−0<0,我们得到 f(y)<f(b),所以 y∉T。◻

基于 CC BY-NC-SA 4.0 许可协议