Capitoli
In questa pagina
RECAP + π₀.₅ 的 LIBERO 长时程任务全流程复现
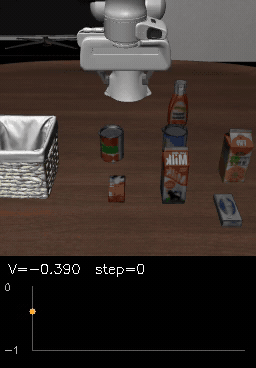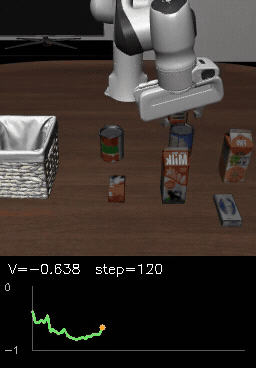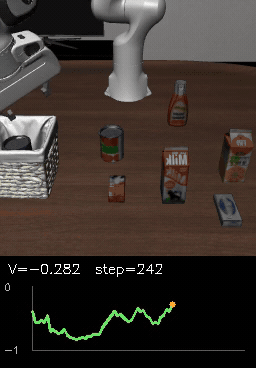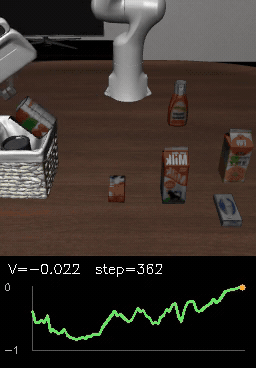
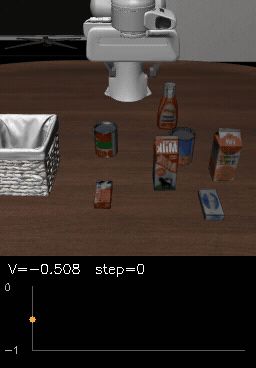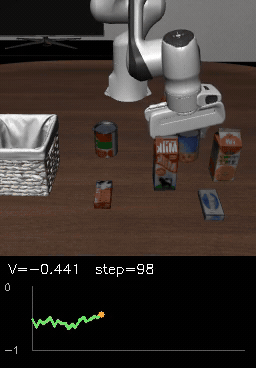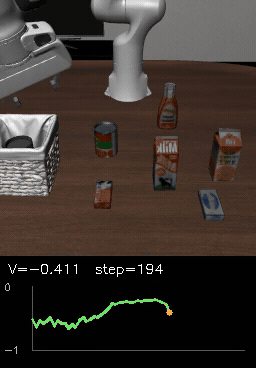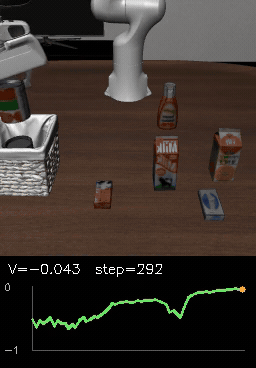
本教程使用 RLinf 发布的 LIBERO-10 数据,在 OpenPI 的 π₀.₅ 上复现 RECAP:训练价值模型、标注优势、微调 ACP 策略,最后在 LIBERO 仿真中评测并可视化 value。下面是两个成功回合的动图:
你将完成什么
这次实验走通一条完整的 RECAP 复现链路:
- 下载并准备含 4,096 条 rollout 的 RLinf 数据集,计算归一化统计量;
- 基于 π₀.₅ 训练价值模型,使用留出集选择 checkpoint;
- 计算优势标签,再用 ACP 进行策略微调;
- 在 LIBERO 仿真中评估成功率,记录并可视化 value 曲线。
RECAP 本身在于基于不完美的模型policy上优化模型,因此,为了更加贴合实际情况,数据集中既要有成功的 episode 以及失败的 episode,让模型学会什么是好的动作和坏的动作,实现自主学习进化。
项目文件
本项目是基于 Openpi 与 LIBERO 仿真项目进行复现实现的。
RECAP 项目文件目录:
codes/practices/vla/recap/
├── run.py          # 统一命令入口,转发 data/stats/train/annotate/serve/serve-value/rollout/checkpoint 子命令
├── config.py       # 注册 SFT、value、ACP 配置,定义数据变换、初始化权重和参数冻结规则
├── data.py         # 下载、完整性校验并准备 sft/train/eval 三份本地 LeRobot 数据
├── value_model.py  # 定义 π₀.₅ 的分布式价值头,以及从 pi05_base 加载骨干权重的逻辑
├── serve_value.py  # 独立加载价值 checkpoint,为仿真观测提供实时 value 推理
├── annotate.py     # 计算 value target、验证价值模型,并生成 advantage 和正负样本标签
├── rollout.py      # 在 LIBERO 中采集或评估 episode,保存轨迹、视频、value 曲线和成功率
├── test_recap.py   # 测试数据处理、回报/优势计算、模型接口和 OpenPI 训练器接入
└── README.md       # 本目录说明及指向本教程的链接
本次复现基于 OpenPI。若没有 OpenPI 环境,先安装:
git clone https://github.com/Physical-Intelligence/openpi.git
cd openpi
uv venv --python 3.11
GIT_LFS_SKIP_SMUDGE=1 uv sync --frozen
GIT_LFS_SKIP_SMUDGE=1 uv pip install -e .
uv run python -c 'import jax; print(jax.devices())' # 最后一行应列出 CUDA GPU 即为成功
在 OpenPI 根目录,将本项目 recap/ 的内容复制到 examples/recap/
mkdir -p examples/recap
cp -a ../dive-into-embodied-ai/codes/practices/vla/recap/. examples/recap/
数据与模型准备
模型
uv run python - <<'PY'
from openpi.shared import download

resources = [
    ("gs://openpi-assets/checkpoints/pi05_base/params", {}),
    ("gs://big_vision/paligemma_tokenizer.model", {"gs": {"token": "anon"}}),
]

for url, options in resources:
    path = download.maybe_download(url, **options)
    print(f"{url} -> {path}")
PY
数据集下载及相关介绍
export HF_LEROBOT_HOME="$PWD/data/lerobot"
export RECAP_REPO_ID="local/libero10_task0_train"
export RECAP_EVAL_REPO_ID="local/libero10_task0_eval"

# 镜像下载数据集
HF_ENDPOINT=https://hf-mirror.com \
HF_HUB_DISABLE_PROGRESS_BARS=0 \
HF_HUB_ETAG_TIMEOUT=60 \
HF_HUB_DOWNLOAD_TIMEOUT=120 \
uv run python examples/recap/run.py data download
该数据集区别于LIBERO官方数据集,本次复现是为了研究如何在一个不完美的数据让模型自主学习进化,因此,训练数据集包含了成功以及失败的episode,数据集的内容与用途如下:
| 发布目录 | 内容 | 本例用途 |
|---|---|---|
libero10_task0_sft | 30 条成功示教,覆盖 10 个任务,每任务 3 条 | 计算 π₀.₅ 的状态和动作 norm stats |
libero10_task0_train | Task 0 的 4,096 条 rollout,1,999 成功、2,097 失败 | 价值训练、优势标注、ACP |
libero10_task0_eval | Task 0 的 64 条 rollout,27 成功、37 失败 | 价值模型验证与 checkpoint 选择 |
数据准备:
# 成功示教:用于计算 norm stats
uv run python examples/recap/run.py data prepare --split sft

# 成功和失败的 rollout:用于价值训练、优势标注和 ACP
uv run python examples/recap/run.py data prepare --split train

# 留出 rollout:用于验证价值模型
uv run python examples/recap/run.py data prepare --split eval
数据已经是 LeRobot 格式,为固定 OpenPI 所用的 LeRobot v2.1 元数据布局。如果还不熟悉 LeRobot 的作用、LeRobotDataset 的目录结构,以及 Parquet、MP4 和 meta/*.jsonl 如何共同描述轨迹,先阅读项目内的
LeRobot 中文课程讲义:LeRobotDataset。
统计量计算:
uv run python examples/recap/run.py stats --config-name pi05_recap_sft
统计输出: assets/pi05_recap_sft/local/libero10_fewshot_sft/norm_stats.json。
一切准备就绪,可以开始进行价值函数训练以及 CFG 模型后训练啦!
1. 计算训练集和验证集样本 return
对数据轨迹计算reward,成功轨迹和失败轨迹最后默认为0/-300:
uv run python examples/recap/run.py annotate targets \
  --dataset-root "$HF_LEROBOT_HOME/$RECAP_REPO_ID"
# Annotated 4096 episodes in ...
uv run python examples/recap/run.py annotate targets \
  --dataset-root "$HF_LEROBOT_HOME/$RECAP_EVAL_REPO_ID"
# Annotated 64 episodes in ...
2. 训练价值模型
基于前置准备的 pi05_base 模型训练价值模型:
uv run python examples/recap/run.py train pi05_recap_value \
  --exp-name value --num-train-steps 30000 \
  --batch-size 18 --fsdp-devices 2 \
  --save-interval 10000 --keep-period 10000 --no-wandb-enabled
训练集约 156 万帧;batch size 为 18 时,一个遍历约需 8.7 万步。这里训练到 30k,并比较其中的 10k、20k checkpoint。
对比两个checkpoint在验证集的结果:
for steps in 10000 20000; do
  VALUE_CKPT="$PWD/checkpoints/pi05_recap_value/value/$steps"

  uv run python examples/recap/run.py annotate evaluate \
    --dataset-root "$HF_LEROBOT_HOME/$RECAP_EVAL_REPO_ID" \
    --checkpoint "$VALUE_CKPT" \
    --batch-size 8 \
    --max-frames 10000 \
    --output "data/recap/value_eval/${steps}.json"
done
| Checkpoint | MSE | MAE |
|---|---|---|
| 10k | 0.03620 | 0.11694 |
| 20k | 0.03750 | 0.11565 |
3. 选择 checkpoint,计算优势值
基于 10k checkpoint,计算每个样本动作的优势值,前30%得分的动作认为是 positive 动作:
export CUDA_VISIBLE_DEVICES=0,1,2,3
export HF_LEROBOT_HOME="$PWD/data/lerobot"
export RECAP_REPO_ID="local/libero10_task0_train"
VALUE_CKPT="$PWD/checkpoints/pi05_recap_value/value/10000"

uv run python examples/recap/run.py annotate advantages \
  --dataset-root "$HF_LEROBOT_HOME/$RECAP_REPO_ID" \
  --checkpoint "$VALUE_CKPT" \
  --batch-size 72 \
  --num-workers 8 \
  --n-step 10 \
  --positive-ratio 0.3
这里的 batch size 是推理全局 batch。脚本会把 batch 沿第一维平均分到
CUDA_VISIBLE_DEVICES 中的全部 GPU;上例为四张卡、每卡 18 帧。每个 episode 的双视角视频只打开一次,
再由 8 个 CPU worker 顺序解码、执行 OpenPI transform 和 tokenize,避免按帧反复 seek 同一个 MP4。
batch size 必须能被可见 GPU 数整除;显存允许时可继续提高到
144 或 288,内存、共享内存或文件句柄紧张时把 --num-workers 降到 4 或 2。
4. ACP 微调
等待优势标注输出 Annotated 4096 episodes 后再开始本步骤。ACP 从 pi05_base 初始化。原配方为 45k 步、全局 batch 72;这里使用已运行的 90k 步、全局 batch 36,处理的样本次数相同。四张卡各处理 9 个样本。训练时根据 is_positive 给任务文本添加
Advantage: positive,并以 0.3 的概率去掉该条件。
export CUDA_VISIBLE_DEVICES=0,1,2,3
unset RECAP_INIT_PARAMS

uv run python examples/recap/run.py train pi05_recap_acp \
  --exp-name acp-b36 \
  --num-train-steps 90000 \
  --batch-size 36 \
  --fsdp-devices 4 \
  --lr-schedule.warmup-steps 3000 \
  --lr-schedule.decay-steps 90000 \
  --save-interval 10000 \
  --keep-period 10000 \
  --no-wandb-enabled
60k checkpoint 可用于下面的仿真评估;最终是否优于起始策略,需要在相同初始化状态上跑完整对照。
5. LIBERO 仿真对照评估
准备 LIBERO 源码:
cd openpi
git submodule update --init third_party/libero
配置仿真环境,独立于openpi的环境:
uv venv --python 3.8 examples/libero/.venv
uv pip sync --python examples/libero/.venv/bin/python \
  examples/libero/requirements.txt third_party/libero/requirements.txt \
  --extra-index-url https://download.pytorch.org/whl/cu113 \
  --index-strategy unsafe-best-match

uv pip install --python examples/libero/.venv/bin/python \
  -e packages/openpi-client -e third_party/libero

PYTHONPATH="$PWD/third_party/libero" examples/libero/.venv/bin/python \
  -c "from libero.libero import benchmark; import openpi_client; print('LIBERO ready')"
做好环境的前置准备后,就可以开启我们的评测啦!
启动模型服务:
ACP_CKPT="$PWD/checkpoints/pi05_recap_acp/acp-b36/60000"

uv run python examples/recap/run.py serve \
  --port 8000 \
  policy:checkpoint \
  --policy.config pi05_recap_acp \
  --policy.dir "$ACP_CKPT"
启动 LIBERO 仿真评测进程:
PYTHONPATH="$PWD/third_party/libero" MUJOCO_GL=egl \
examples/libero/.venv/bin/python examples/recap/run.py rollout eval \
  --output data/recap/eval_acp_b36_60k \
  --policy-label "$ACP_CKPT" \
  --num-episodes 20
评测时查看 value 曲线
把更新后的 run.py、rollout.py、新增的 serve_value.py 复制到 OpenPI 的 examples/recap/。价值模型与 ACP 策略分别开一个服务;二者可用不同的空闲 GPU。价值服务在 OpenPI 主环境运行,不能在 Python 3.8 的 LIBERO 仿真环境中加载。
启动模型服务:
CUDA_VISIBLE_DEVICES=6 XLA_PYTHON_CLIENT_PREALLOCATE=false \
uv run python examples/recap/run.py serve --port 8000 \
  policy:checkpoint --policy.config pi05_recap_acp \
  --policy.dir "$PWD/checkpoints/pi05_recap_acp/acp-b36/60000"
启动价值函数的服务:
CUDA_VISIBLE_DEVICES=7 XLA_PYTHON_CLIENT_PREALLOCATE=false \
uv run python examples/recap/run.py serve-value \
  --checkpoint "$PWD/checkpoints/pi05_recap_value/value/10000" --port 8001
评测:
PYTHONPATH="$PWD/third_party/libero" MUJOCO_GL=egl \
examples/libero/.venv/bin/python examples/recap/run.py rollout eval \
  --output data/recap/eval_acp_b36_60k_value \
  --policy-label "$PWD/checkpoints/pi05_recap_acp/acp-b36/60000" \
  --value-port 8001 --num-episodes 20