第 2 章 推理入门
新一代 AI 开发工具,比如 Claude Code、Codex 等。虽然可以接入不同的 LLM API,但实际体验仍存在明显差异。更强的模型通常具有更高的任务完成率、更稳定的推理能力和更好的代码质量,而响应速度、吞吐量和成本同样会影响开发效率。
理解 LLM 的 inference 过程,不仅有助于认识模型如何生成输出,也能进一步分析影响推理质量、速度、吞吐量和成本的关键因素,为推理优化提供基础。
1 本章学习目标
上一章我们梳理了 LLM 的整体架构,而 inference 是决定其可用性、成本与开发体验的核心环节。本章将从 inference 原理切入,逐层拆解链路,并结合真实场景展开。围绕以下问题进行分析:
- 训练与推理在目标、计算模式与资源需求上有何本质区别与联系?
- 一次 token 的完整生命周期是怎样的?
prefill与decode阶段分别承担什么职责,为何会有截然不同的特征?- 哪些因素会影响 LLM 推理能力的表现?
- 如何判断一次推理是
compute-bound还是memory-bound? - 在 Agent 协作、多轮对话等不同场景下,瓶颈分别出现在哪里?
读完本章后,可以理解 inference 的关键两个阶段,使用 Roofline model 分析推理过程中的性能瓶颈,针对具体场景选择合适的优化策略。
2 推理是什么
平时我们使用 LLM 进行对话、写代码,或将其部署到真实场景中完成任务等。模型根据用户输入生成输出结果的过程,就是推理。
一个完整的 LLM 推理过程可简单理解为用户输入先经过 tokenizer 转为 token ids,再通过 embedding 进入 transformer。模型利用自注意力等机制计算当前上下文的表示,预测下一个 token。新生成的 token 作为后续输入继续循环,这是一个自回归过程,直到生成完整输出或触发停止条件。
可以把这个过程类比成制作蛋糕:用户请求是“食材”,LLM 推理是“加工过程”,最终输出的 token 序列就是“蛋糕”。但需注意,LLM 的“加工”并非一次性完成全部内容,而是逐 token 生成。
但是,LLM 的能力并非在推理阶段产生,而是主要在训练阶段通过大量数据计算获得的。推理只是使用已训练好的模型进行前向计算,要理解这一点,需要清楚训练与推理的联系和区别。
3 推理与训练
在 LLM 的工作周期中,训练与推理阶段性分离,计算方式完全不同——训练并行优化参数,推理串行逐步输出。训练决定模型的能力边界,推理在真实场景中反映缺陷(对齐偏差、效率瓶颈...),这些反馈驱动训练侧通过 RLHF、合成数据或蒸馏等方法进行针对性优化。
二者形成闭环:训练塑造能力,推理释放能力,推理也可以指导训练演进。
3.1 推理与训练的差异
在LLM中,训练与推理都涉及模型的前向计算,但它们的目标、计算模式和资源瓶颈存在本质差异。对于自回归推理或并行化训练,假设需要生成第
训练与推理在单步预测的数学形式上相同——都是对词表做概率分布估计。但差别在于前文来源(真实标签 vs 模型生成)以及能否并行化输出。
训练与推理的预测下一个词的依据对比
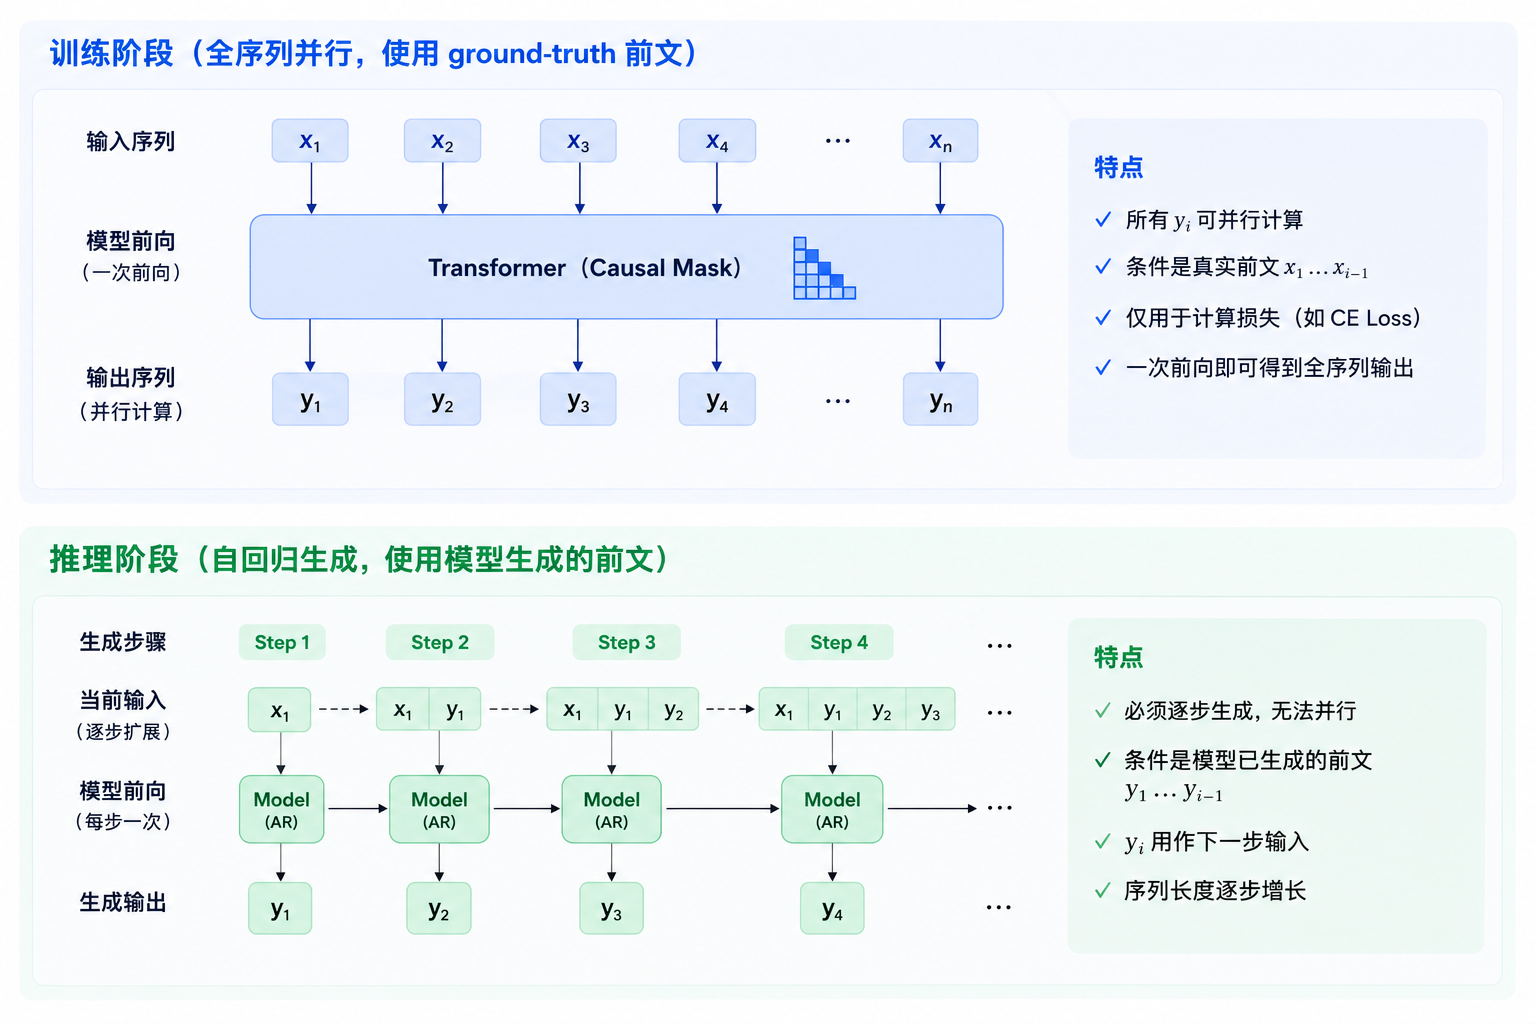
图 1. 训练 vs 推理
| 阶段 | 下一步预测 |
|---|---|
| 训练 | 来自标注数据的真实序列(ground-truth),通过因果掩码在所有位置并行计算损失,每个位置仅依赖其之前的真实 token |
| 推理 | 来自用户输入的 prompt + 模型已生成的 token,每步预测基于完整前文(prompt + 已生成部分),必须串行生成 token |
训练阶段
训练的目标是优化模型参数,需要执行完整的前向与反向传播。对于自回归transformer ,输入完整标注序列并使用 causal mask 保证因果性,使模型在一次前向传播中通过矩阵运算(如 QKV 投影、注意力得分计算)并行处理整个序列,同时得到所有位置的输出,中间激活被保留用于反向传播更新参数。这种序列级并行是 transformer 大模型训练中高效利用硬件算力的关键。
训练阶段通过在大规模数据上迭代优化,模型逐步学习获得能力。
推理阶段
推理阶段的目标是使用固定参数生成输出序列。推理采用自回归生成方式:每生成一个 token,模型需要基于完整前文(用户 prompt + 已生成部分)计算注意力,这要求缓存所有历史 token 在每一层的 Key、Value 。
这类似于写作文时反复回看前文:若每次都重读全部内容,计算量会随长度剧增。KV Cache 缓存历史 Key、Value,避免重复计算、显著降低延迟,但会占用更多显存。在高并发真实服务中,KV Cache是兼顾效率与成本的关键优化。
但是 LLM 的推理阶段每一步内部的计算仍然高度并行——计算新 token 的 KV、注意力权重以及前馈网络时,硬件可以并行处理上下文的矩阵运算。则推理的特点是步间串行、步内并行。
基于对原理分析的理解,我们可以从成本维度进一步量化训练与推理的差异。以 8B 参数的 LLM 为例(
训练一次:
根据Scaling Law定理 ,训练数据量与模型参数量之比约为 20:1 。则对于 8B 参数的模型,所需训练数据量
约为 160B tokens,即 。 每个 token 的训练计算量 =
,则总计算量表示为
假设使用 H100 GPU(峰值约
推理一次(输入 512 tokens prompt,生成 128 tokens):
- 仅前向传播,总计算量 =
- 带入具体数据,总计算量 =
若每天服务 100 万次这样的请求,月度成本达数万美元,年度累计就会超过训练成本。正是这种成本结构差异驱动了推理优化的核心方向——降低单次推理的时延与显存占用,以及提高吞吐量,最终在规模化部署中摊薄边际成本。
明确了训练与推理的本质差异后,下一个问题是:两者如何协作完成从模型训练到服务推理的流程?
3.2 训练与推理的协作
训练与推理在模型生命周期中是深度耦合的协作关系:
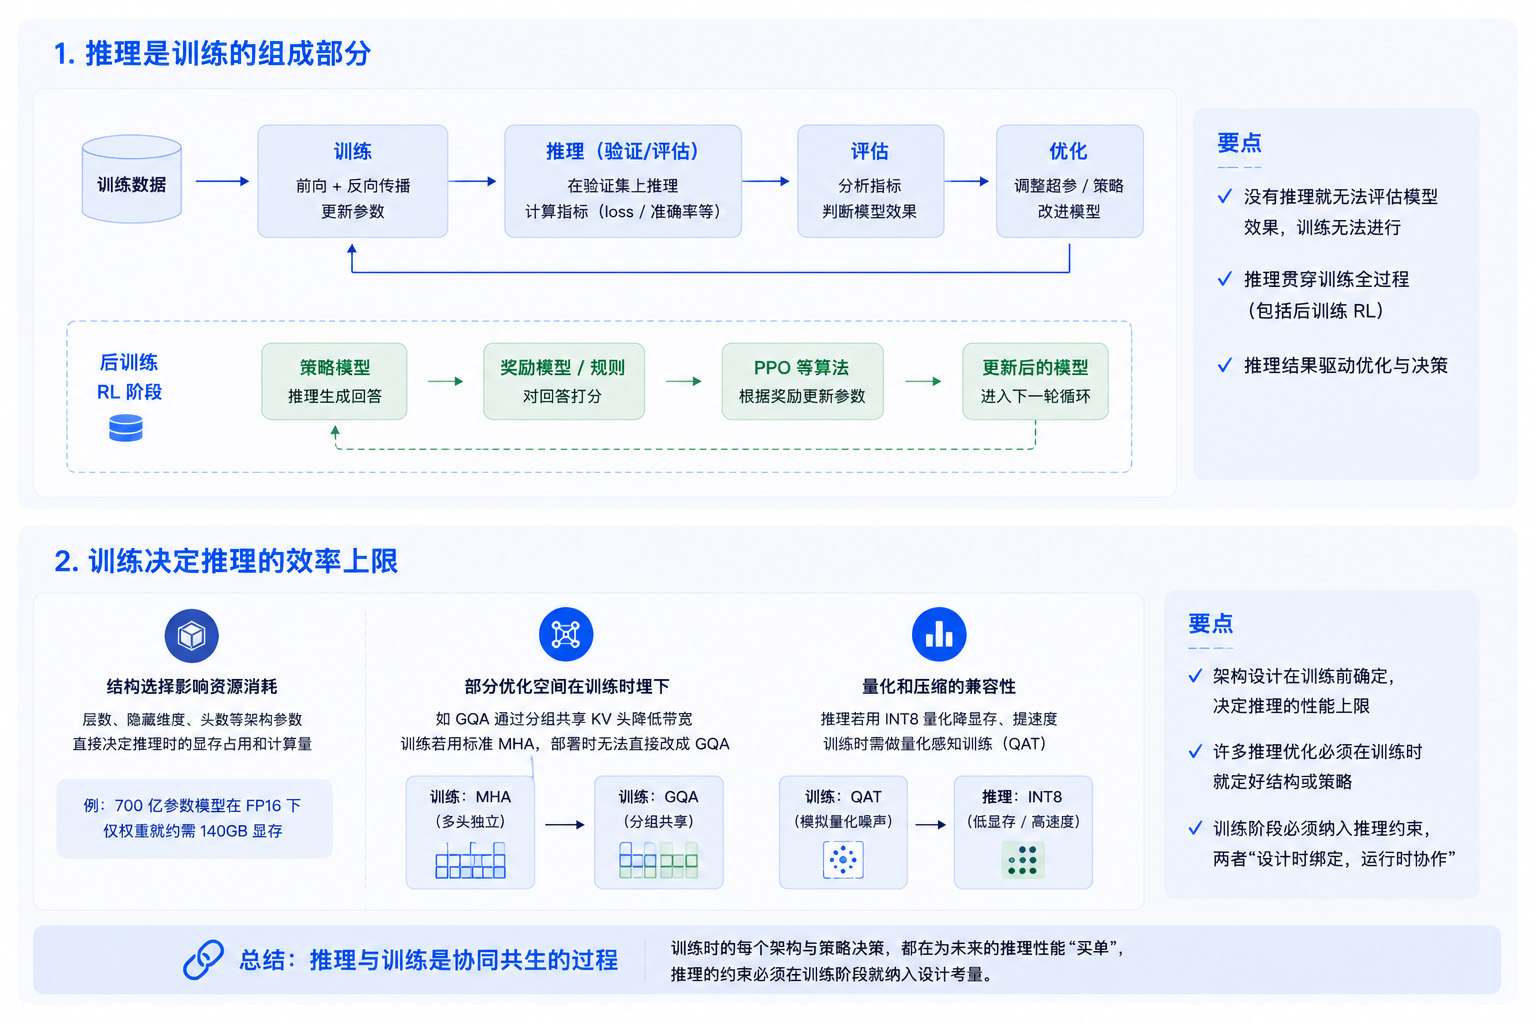
图 2. 训练与推理协作
1.推理是训练的组成部分
训练不是单纯地"喂数据更新参数",而是一个持续的"训练 -> 推理 - > 评估 -> 优化"循环:
- 每个 epoch 训练完成后,模型需要在验证集上推理,计算准确率、loss等指标,得到训练效果;
- 后训练 RL 阶段中,策略模型先推理得到回答,由外部奖励模型或规则对回答打分,然后用PPO等算法根据奖励更新参数。
可以说:没有推理就无法知道模型"学得怎么样",也就无法进行有效训练。
2.训练决定推理的效率上限
模型的架构设计是在训练开始前确定的,比如这些设计直接决定了部署时推理的性能——
- 结构选择影响资源消耗:transformer 层数、隐藏层维度等架构参数,直接决定推理时的显存占用和计算量。例如,700 亿参数模型在 FP16 下仅权重就约需 140GB 显存,这是架构带来的硬约束。
- 部分优化空间在训练时埋下:有的推理优化必须在训练时就定好结构。例如, GQA 通过分组共享 KV 头降低带宽,训练若只用标准 MHA,部署时无法直接改成 GQA 。
- 量化和压缩的兼容性:推理若要用 INT8 量化来降显存、提速度,训练时最好做量化感知训练(QAT)。即我们指定量化位数,然后在前向中模拟量化噪声,让参数适应量化误差。不经过 QAT 就直接量化,精度损失会很影响最后的推理性能。
推理不是"训练完成后的事",而是贯穿全程的协同过程。训练时每个架构决策都在为未来的推理性能"买单",那么推理的约束必须在训练阶段就纳入设计考量。两者是"设计时绑定,运行时协作"的关系。
4 Prefill与Decode
在完成训练的 LLM 推理过程中,从输入 Prompt 到逐步生成输出 token 的关键阶段分为 Prefill 和 Decode。这两个阶段在计算模式上有本质的差异,理解这两个阶段的特性差异,是针对性优化推理性能的前提。
4.1 一个 token 的生命周期
在 LLM 推理中从接收用户请求到输出完整回复的一个基本生命周期,可以概括为以下流程:
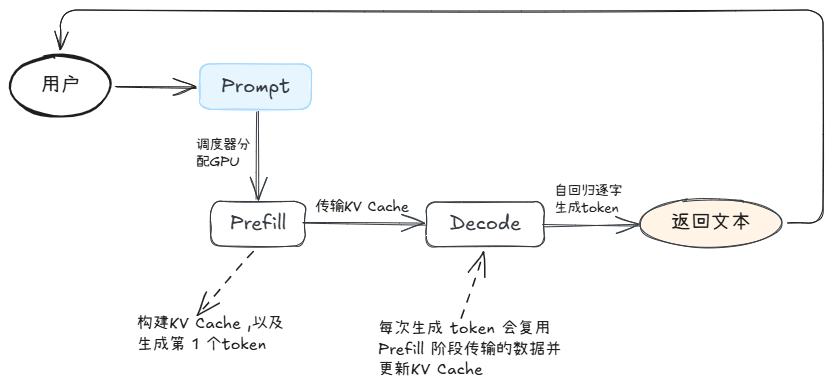
图 3. 一个 token 的生命周期
请求调度:用户输入一段 Prompt,即由多个 token 组成。推理引擎的调度器,比如 SGLang scheduler 等将请求分配到可用的 GPU 或 GPU 组上;
Prefill 阶段:对分配到的整段 Prompt 完成一次计算。模型并行处理所有输入 token,计算出完整的 KV cache,并采样出第一个输出 token。这一阶段计算量大、并行度高;
Decode 阶段:进入自回归生成阶段。每次只输入上一个生成的 token,结合已有的 KV cache 进行前向计算,生成下一个 token,同时将新 token 的 KV 追加到 cache 中。重复此过程,直到遇到结束符(EOS)或达到最大生成长度。这一阶段计算量小,但需要频繁访问不断增长的 KV cache;
输出返回:将生成的 token ID 序列解码为文本,返回给用户。
基于这个流程,我们进一步来理解 Prefill 和 Decode 的底层计算原理。
说明:Prefix Cache 等减少重复计算的方法属于后续优化,并非基本生命周期的必要步骤,因此未放入上述流程中。
4.2 Prefill
Prefill 阶段是对当前调度到的 Prompt(可以是单个请求,也可以是多个请求打包成的 batch)进行一次完整的前向传播。模型会并行处理所有输入 token,构建并写入初始 KV Cache,同时得到第一个 token 的 logits。以 LLaMA-7B 的 Prefill 场景为例:
- 处理 2 个用户请求,合计 N = 3000 个 token
- 模型 config :层数
,隐藏层维度 ,FFN 中间计算维度约 ,注意力机制头数
1.单次完整前向处理 1 个批次的 FLOPs 估算
一次前向传播的主要计算包括:
- QKV + 输出投影 4 个线性层,共
; - FFN 2 个升维 + 1 个降维,共
; - Attention 核心计算
与 score× 共 .
单层总计
- 线性投影 + FFN 主导项:
; - Attention 项(一次输出 N 个token ):
.
32 层总计算量 = 32 × (线性投影 + FFN 项 + Attention 项) ≈ 43.4 TFLOPs,换算成更直观的单位——大约相当于一台 A100 G40(312 TFLOPS 峰值)理论全力计算约 0.14 s 的工作量,但是实际无法达到 100% 使用率。
2. 不同 Prompt 长度的对比
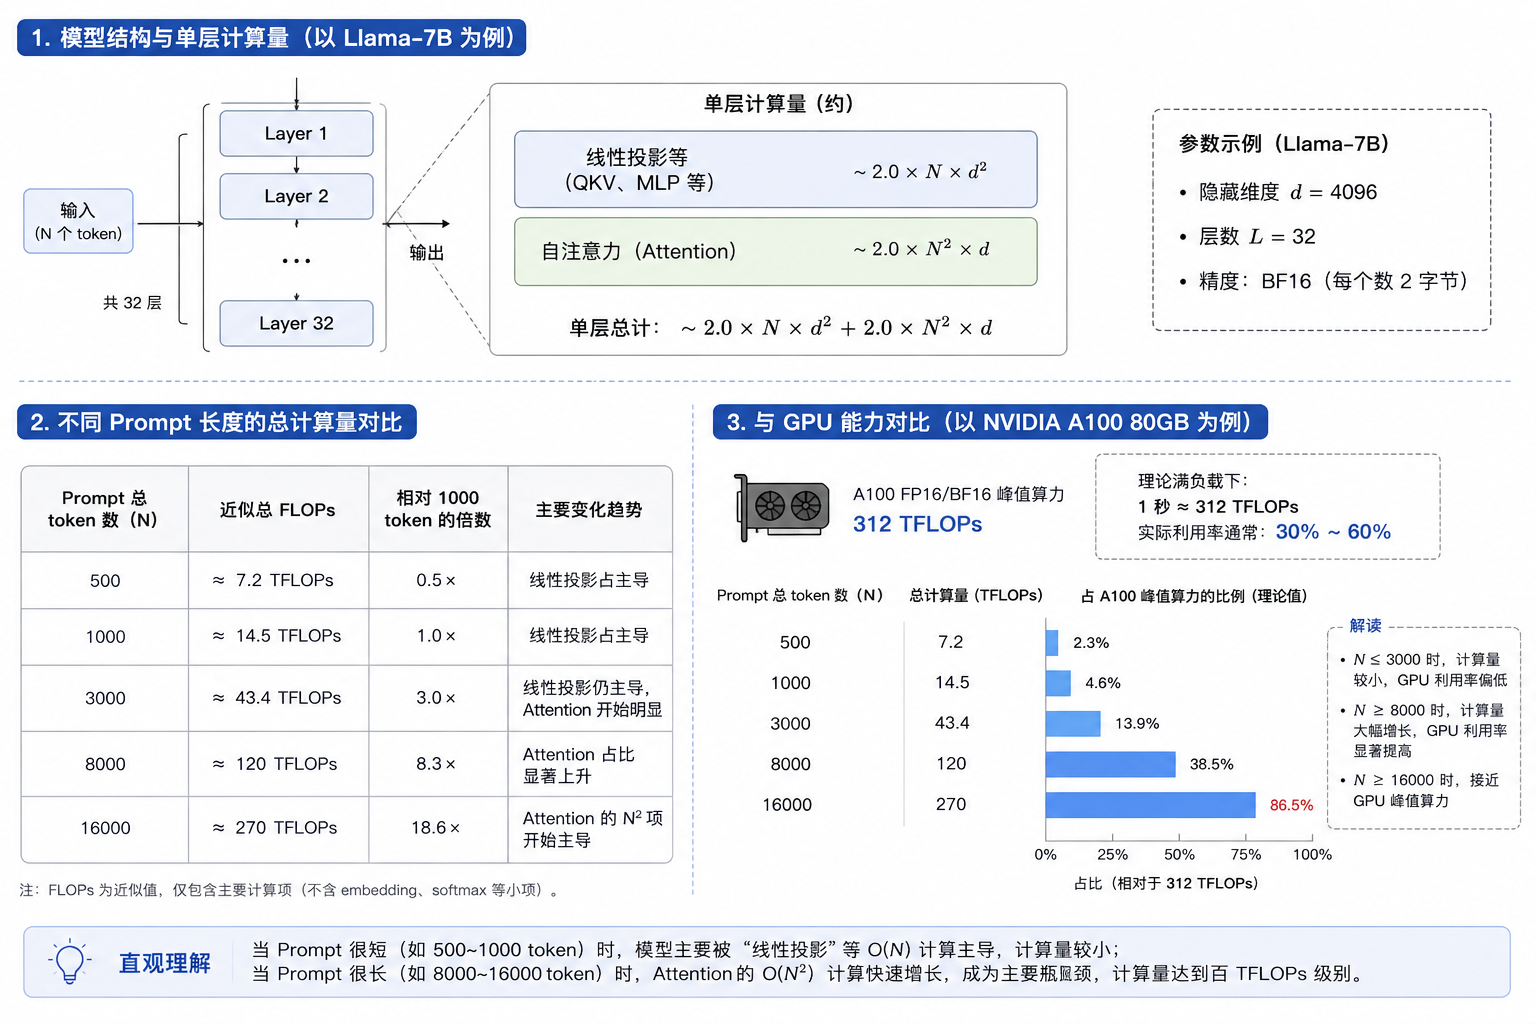
图 4. 不同Prompt的FLOPs对比
在中等长度(几千 token)时,计算量基本随
3. 内存流量
LLaMA-7B 模型权重为 FP16,约占用 14 GB。在 Prefill 阶段,内存流量主要包括:
- 模型权重读取:14 GB
- KV Cache 写入:每个 token(占用空间大小为 2 byte)的 KV cache 大小为
。处理 3000 个输入 token,需写入约 1.5 GB - 激活值:相对较小,可忽略
因此,Prefill 阶段的总内存流量约为 15-16 GB。结合前面计算的 43.4 TFLOPs,这意味着平均每从显存读取 1 字节的数据,会执行数千次浮点运算。
通过以上的数据分析可以感受到:
- Prefill 的计算量很大,且随 Prompt 长度明显增加
- 模型权重只需要加载一次,就可以服务大量 token 的一次前向计算
那么 GPU 的计算单元会被充分使用,算术强度比较高。
4.3 Decode
完成 Prefill 阶段,LLM 进入 Decode 阶段,基于已生成的 KV Cache 逐个生成后续 token。在前面 Prefill 相同的场景为例进行分析,假设输入 Prompt 长度为 3000 token(对应 1.5 GB KV cache):
1.单次完整浮点运算处理 1 个批次的估算
同理可得,Decode 每生成 1 个 token 的 FLOPs 公式为:
其中 S 是当前序列长度(需要 attend 的历史 token 数)。以生成第 1 个输出 token 为例(S = 3000):
- 线性投影 + FFN 项:
; - Attention 项:
.
32 层总计算量 = 线性投影 + FFN 项 + Attention 项 ≈ 14.4 GFLOPs,按照 A100 G40 的巅峰算力值计算,理论计算时间仅约 0.05 ms。但实际耗时远超这个值,不过更大的问题是显存占用。
2.内存流量与瓶颈分析
Decode 阶段每生成 1 个 token 需要:
- 模型权重读取:14 GB(每次前向传播都要读取全部权重)
- KV cache 读取:1.5 GB(S = 3000 时的初始大小)
- 1个新 token 的 KV 写入:约 0.5 MB
- 激活值:相对较小,可忽略
内存流量总计 ≈ 15.5 GB(读写合计,新写入的 0.5 MB 可忽略不计)。同样使用 A100 40GB ,对应的 HBM 带宽大约为 1.6 TB/s,需要在 HBM 与计算单元之间搬运约 15.5 GB 数据的理论最小时间为
3.KV Cache 累积问题
随着 Decode 阶段的回复生成长度的增加,KV cache 持续增长:
- 生成第 1 个 token 后,1.5 GB + 0.5 MB ≈ 1.5 GB
- 生成第 100 个 token 后,1.5 GB + 50 MB ≈ 1.55 GB
- 生成第 2000 个 token 后,1.5 GB + 1000 MB ≈ 2.5 GB
核心问题在于——长时间对话或处理大 batch 的场景中,每生成一个新 token,需要读取的 KV Cache 体积在增大,进一步加重内存流量与带宽压力。这也是 SGLang 等推理引擎引入 KV cache 复用、量化压缩 等优化技术的原因。
Decode 阶段浮点运算远小于同场景中的 Prefill,但每次生成 1 个 token 都需要读取完整模型权重 + 不断增长的 KV Cache,算术强度极低。速度瓶颈主要来自内存带宽,容量瓶颈则来自 KV Cache 的持续累积。
5 识别推理阶段的瓶颈
在 LLM 推理过程中,最核心的 Kernel 部分即模型的计算架构,性能主要受两个关键因素制约:数据搬运效率和计算吞吐能力。前者取决于系统的带宽,每秒能从内存读取或写入多少数据;后者取决于计算单元(如 GPU 的 Tensor Core)算力,即每秒能完成多少次浮点运算。
5.1 Roofline model 原理
为了识别 inference 过程中的性能瓶颈,可以采用 Roofline model 进行初步分析。这个方法通过将硬件的理论性能上限与实际工作负载的特征结合,帮助判断当前 LLM 计算任务究竟受限于 memory-bound 还是 compute-bound 。其中 Roofline model 的坐标轴定义:
- 横轴:算术强度(Arithmetic Intensity, AI),单位 FLOP/Byte ,表示每搬运 1 字节数据可以执行多少次浮点运算次数;
- 纵轴:实际性能(Performance),单位 FLOP/s ,表示每秒实际完成的浮点计算量,这个值始终不会超过硬件的峰值算力。
其中,两个关键的判断指标——拐点、算术强度的计算原理:
1.拐点,compute-bound 与 memory-bound 的分界线
- 物理含义:当算术强度达到这个临界值时,硬件的计算能力和内存带宽恰好达到平衡状态,通过一个示意图来理解 Roofline model 的结构
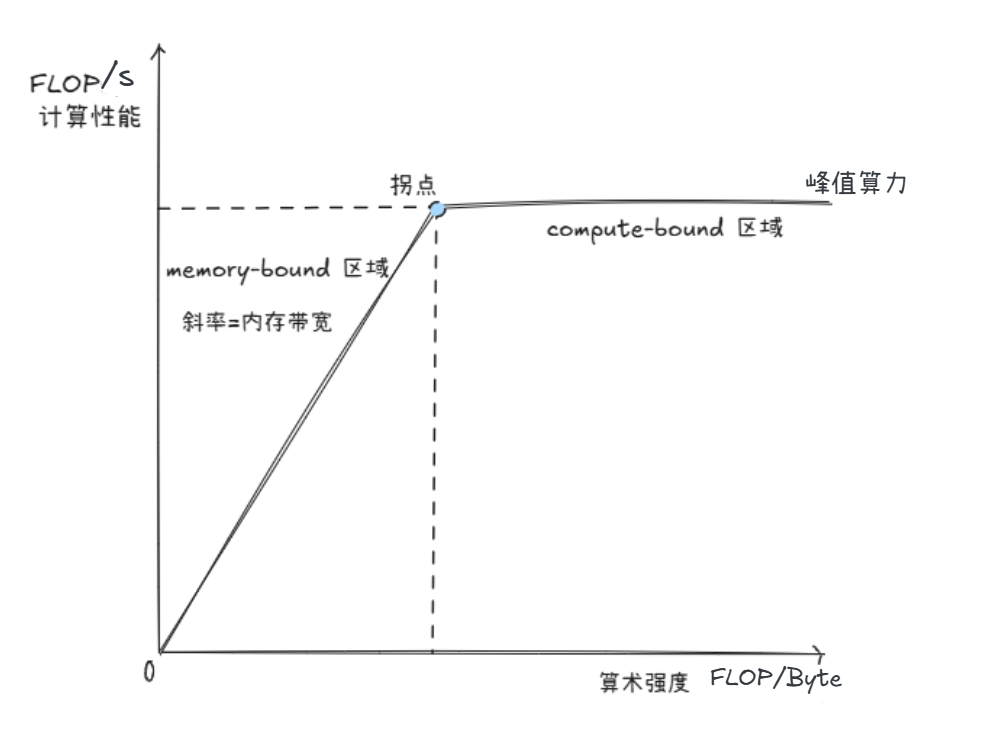
图 5. Roofline model
- 判断依据:这个拐点值将 Roofline 图分为左右两个区域,左侧是 memory-bound ,右侧是 compute-bound。
2.算术强度,衡量计算任务的特征
- 计算:总浮点运算次数,统计完成该任务需要的浮点运算总量,包括乘法、加法等;总内存访问量,从内存读取、写入的数据总量,包括输入、输出、权重、中间结果等
注意:这里的内存访问量指的是实际从 DRAM 搬运的数据量,不包括 Cache 命中的部分。
判断依据:将计算出的 AI 值与拐点进行比较
- AI < 拐点,实际性能 ≈ AI × 内存带宽。特征就是计算单元"等"数据,大量时间消耗在内存读写上;
- AI ≥ 拐点,实际性能 ≈ 峰值算力。特征是内存供给充足,计算单元满负荷运转。
compute-bound 与 Memory-bound :
- compute-bound(计算受限):AI 值足够高。此时计算单元被打满,性能主要由峰值算力决定,内存不再是瓶颈。
- memory-bound(内存受限):AI 值较低。处理器大部分时间在等待数据,性能由内存带宽 × AI 决定,计算单元利用率低。
这正是 LLM 推理中 Prefill 与 Decode 差异的根源。
在初步判断了瓶颈所在后,就可以给出推理瓶颈判断方案。判断流程如下:
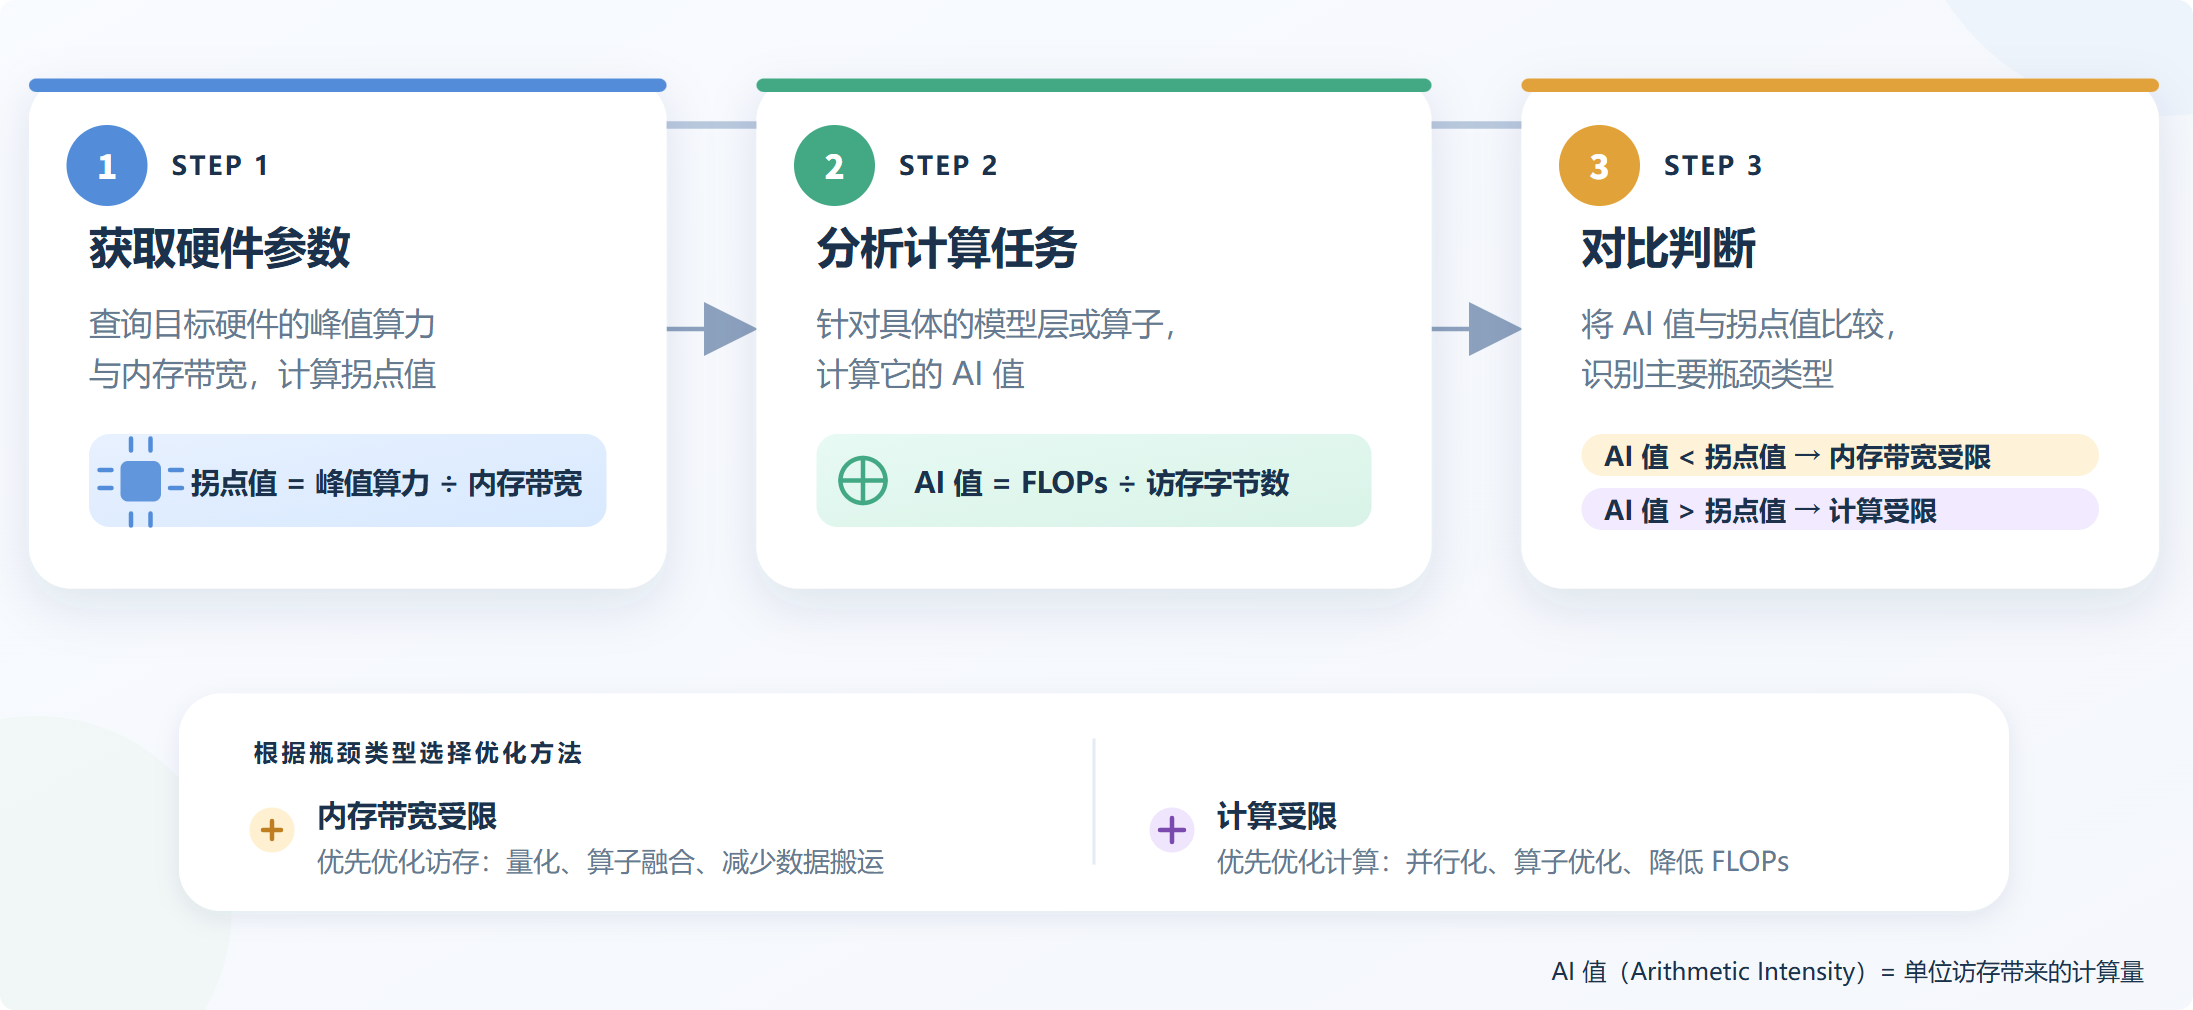
图 6. 借助 Roofline model 定位推理优化的方法
Step1 获取硬件参数:查询目标硬件的峰值算力和内存带宽,计算拐点值;
Step2 分析计算任务:针对具体的模型层或算子,计算其 AI 值;
Step3 对比判断:将 AI 值与拐点比较,然后根据对应的瓶颈类型选择对应优化方法。
下面我们通过具体示例来说明如何使用 Roofline model 分析 LLM 推理的性能瓶颈是 compute-bound 还是 memory-bound。
5.2 Roofline model 实例分析
LLM 推理的核心计算几乎全部落在矩阵乘法(GEMM)上——Attention 的 QKV 投影、注意力得分计算以及 FFN 的线性变换都是如此。为了用 Roofline model 判断性能瓶颈,我们先从最基础的 GEMM 入手,推导其算术强度的计算方法,并观察矩阵规模如何决定计算、访存瓶颈。
分析了这个 GEMM 的 AI 值后,回到2.3中提到的 LLM 推理两个阶段,通过具体计算 Prefill 与 Decode 的 AI 值与拐点值对比,回答两个关键问题:
- Prefill 阶段:为什么 AI 值较高,在合适的 batch size 下可以接近或达到 compute-bound?
- Decode 阶段:为什么 AI 值极低,始终处于 memory-bound 状态?
GEMM 的算术强度分析
假设有两个矩阵 A、B,形状分别为
1.浮点运算
结果矩阵 C 有
注意:不同数据类型的同样场景中对应 FLOPs 是相同的。
2.数据搬运量
搬运内容:
- 读取矩阵 A:
个元素 - 读取矩阵 B:
个元素 - 写入结果 C:
个元素
3.AI 值
AI 值随矩阵规模增大而增大,即矩阵越大搬运的数据复用率越高,更容易达到或超过拐点,变成 compute-bound。
Prefill 与 Decode 的瓶颈分析
对于 2.3 节中 Prefill 和 Decode 的 AI 值差异(前者大、后者小),本节采用之前的符号定义以及相同的模型架构分析这两个阶段的瓶颈类型,考虑处理的批次大小为 1 。
符号定义
:输入序列长度(Prefill 阶段处理的 token 数) :已生成的序列长度(Decode 阶段的 KV Cache 长度) :模型隐藏层维度 :transformer 层数 - 数据类型:bf16
1.数据搬运量分析
计算数据搬运量时,需要考虑的三部分:
①模型权重:每次前向传播都需要从内存读取全部参数(线性层、LayerNorm 等);
②激活数据:输入 token 的 embedding 及各层的中间计算结果;
③KV Cache(仅 Decode 阶段考虑):历史 token 的 KV Cache,用于 Attention 计算。
Prefill 阶段(一次处理 N 个 token):
单层总权重:
QKV 投影 + 输出投影:形状
,需要读取 3 次 + 1 次(输出),共 参数 FFN 层:两个线性层
和 ,共 参数 输入 + 输出:
(输入)+ (输出)=
Decode 阶段(生成 1 个 token):
- 权重搬运:与 Prefill 相同,仍需读取全部权重
- 输入 + 输出:
(输入)+ (输出)= - KV Cache 读取:Attention 需要读取历史
个 token 的 KV,共
2.算术强度
这里只考虑处理 1 个批次的情况。
Prefill 阶段算术强度为
Decode 阶段算术强度为
对比分析可得:
- Prefill 的 AI值 随输入序列长度
线性增长; - Decode 的 AI值 在
增大后趋近于常数 1 与序列长度几乎无关。
3.LLaMA-7B 在 A100 上的瓶颈判断
A100 G40上面跑 LLaMA-7B ,模型 config 还是保持之前的设置,其中数据的类型为 bf16 计算得到
Prefill 阶段 AI值 ,假设输入序列长度
Decode 阶段 AI值 ,假设
分析:
1.Prefill 阶段:虽然仍是 memory-bound,但 AI 值较高,增大 batch size 或序列长度可以推向 compute-bound。
2.Decode 阶段:AI 值极低,严重受限于内存带宽,每次生成 1 个 token 需要读取全部权重(约 14GB ),但只做少量计算。
优化方向:Prefill阶段,批处理、算子融合、Tensor Core 计算优化等;Decode阶段,量化(减少权重搬运)、KV Cache 复用(RadixAttention)等。
6 实际场景中的推理
前面我们从理论角度分析了 Prefill、Decode 的性能特征。实际应用中,不同场景会放大特定阶段的瓶颈,比如最常见的两个场景 Agent 协作、多轮对话 ,下面分别分析这两个典型场景的推理瓶颈。
6.1 Agent 协作
在智能体协作场景中,推理性能面临以下主要挑战:
1.工具调用的开销
Agentic 工作流通常需要多次工具调用循环模型生成 → 工具执行 → 结果返回 → 模型再次推理。每次循环都需要完整的 Prefill 过程处理累积的上下文。
- 重复 Prefill:每次工具调用后,系统提示词、对话历史、工具定义等共享上下文都需要重新进行预填充。
- 上下文膨胀:工具定义和执行结果会快速增加输入长度,使后续的 Prefill 成本持续上升。
2. 跨 Agent 通信成本
在串行执行的分布式多智能体系统中,Agent 间的消息传递和状态同步会引入网络延迟和序列化开销。
- Prefill 阶段影响:Agent 间传递的消息会成为下一个 Agent 的输入上下文的一部分,增加 Prefill 的输入长度。
- Decode 阶段影响:如果 Agent 间需要等待彼此的输出,会导致整体端到端延迟增加。当多个 Decode 请求在同一 GPU 上竞争资源时,网络延迟会进一步放大排队等待时间。
6.2 多轮对话
多轮对话场景的核心特点是:每轮新请求都依赖之前的对话历史,导致输入长度随对话轮次线性增长。
1.Prefill 延迟线性增长
在同一个对话窗口中,每轮对话需要处理完整的历史上下文,导致 TTFT 随轮次增加而线性增长。对于长对话(>10 轮),Prefill 时间可能占据总响应时间的主要部分。假设每轮对话增加 200 tokens,模型 Prefill 速度为 1000 tokens/s:第 1 轮,TTFT ≈ 200ms;第 10 轮,TTFT ≈ 2000ms...随着对话轮次增加,Prefill响应时间明显增加。
2. KV Cache 内存占用
保存完整对话历史的 KV Cache 会消耗大量显存。在长上下文(如 100K tokens)场景下,其可能占用数十 GB 内存,限制了并发请求数。
- 内存访问成为瓶颈:对于长上下文,KV Cache 的读取时间可能超过实际计算时间。
- 批处理效率下降:大量的 KV Cache 减少了可以并发处理的请求数,降低了 GPU 利用率和整体吞吐量。
7 总结与测试题
7.1 课程总结
本章分析了 LLM 推理的核心机制与性能瓶颈。从训练与推理的本质差异出发,探讨了 Prefill 与 Decode 两个关键阶段的计算特征,引入 Roofline model 作为性能分析工具。结合 Agent 协作和多轮对话两个典型场景,了解到部分实际推理系统中面临的挑战。
7.2 测试题
1.训练和推理的区别与联系是什么?
提示:从模型参数是否更新、计算过程、计算与存储成本以及二者关系等角度思考。
2.对比推理阶段的 Prefill 与 Decode 两个阶段的区别与联系,并分析各自的性能瓶颈是什么?
提示:从处理 token 的方式、计算模式、并行特性、算术强度、内存访问模式等维度进行对比。
3.Roofline model 的意义是什么?
提示:说明 Roofline model 的横纵坐标含义、计算平台的峰值算力与内存带宽,以及拐点是什么。
4.如何使用 Roofline model 判断推理过程的性能瓶颈?请选择一个具体场景进行分析。
提示:明确说明硬件参数、计算 AI 值、与拐点对比的完整流程。
5.在 RAG+LLM 的应用场景中,假设需要基于多个金融领域文档作为知识库来分析经济问题,并在同一个对话窗口中进行长时间多轮交互。这种场景的主要性能瓶颈是什么?
提示:提示:从 RAG 检索结果注入导致的上下文增长、多轮对话历史累积、Prefill 计算量增加、KV显存占用等方面进行分析。
参考资料
- SGLang Documentation
- NVIDIA H100 Tensor Core GPU
- Deploying DeepSeek with PD Disaggregation and Large-Scale Expert Parallelism on 96 H100 GPUs
- Inside NVIDIA Groq 3 LPX: The Low-Latency Inference Accelerator for the NVIDIA Vera Rubin Platform
- Tool Observations Are the Hidden Prefill in Local Agent Loops on RDNA4
- Diy-LLM 第九章 缩放定律(Scaling Laws)
- Diy-LLM 第十章 推理
- NVIDIA A100 TENSOR CORE GPU