第 4 章 推理的核心数据结构:KV Cache
对于固定的模型、批大小和数据类型,KV Cache 的显存占用会随当前序列长度线性增长。在 Agent 类长任务,上下文长度常达到 32K,部分任务甚至会扩展到 128K 乃至 1M,以及多请求并发场景下,KV Cache 可能快速占用大量显存,成为限制推理吞吐和延迟的瓶颈。
1 本章学习目标
前面几章已经介绍了 LLM 的基本结构、推理流程以及 GPU 的基本结构。本章在此基础上,聚焦于 KV Cache 回答这样几个问题:
- 从 Attention 公式出发,推导为什么在自回归 Decode 阶段需要 KV Cache,并说明缓存 KV 复用了哪些计算,以及哪些计算仍然需要执行?
- 描述单个请求从 Prefill 到 Decode 的 Cache 生命周期,明确 Cache 何时创建、读取和追加?
- 根据模型的层数、KV 头数、每个头的隐藏维度、当前序列长度、Batch size大小以及数据类型,估算任意时刻的 KV Cache 显存占用是多少?
- 使用真实模型配置,分别计算 Prefill 结束时的显存占用、Decode 单步新增的显存占用,以及达到最大上下文长度时的显存占用?
- 解释多请求场景下,naive Cache 管理为什么会遇到显存碎片、空间浪费等问题?
2 Attention 机制中的 KV Cache
KV Cache 就是 Attention 中的 Key 和 Value,通过缓存避免 Decode 阶段对历史 token 的重复计算,从而显著提升效率。
2.1 KV Cache 的来源
Attention 计算前,token的隐藏状态经线性投影得到 Query(Q)、Key(K)、Value(V):
- Q:当前 token 希望从上下文获取的信息,用于与各 Key 计算匹配程度。
- K:每个 token 的特征表示,用于计算注意力分数,判断应关注哪些历史 token。
- V:每个 token 实际携带的信息,经注意力分数加权后汇总,形成当前 token 的上下文表示。
KV Cache 来源分析:
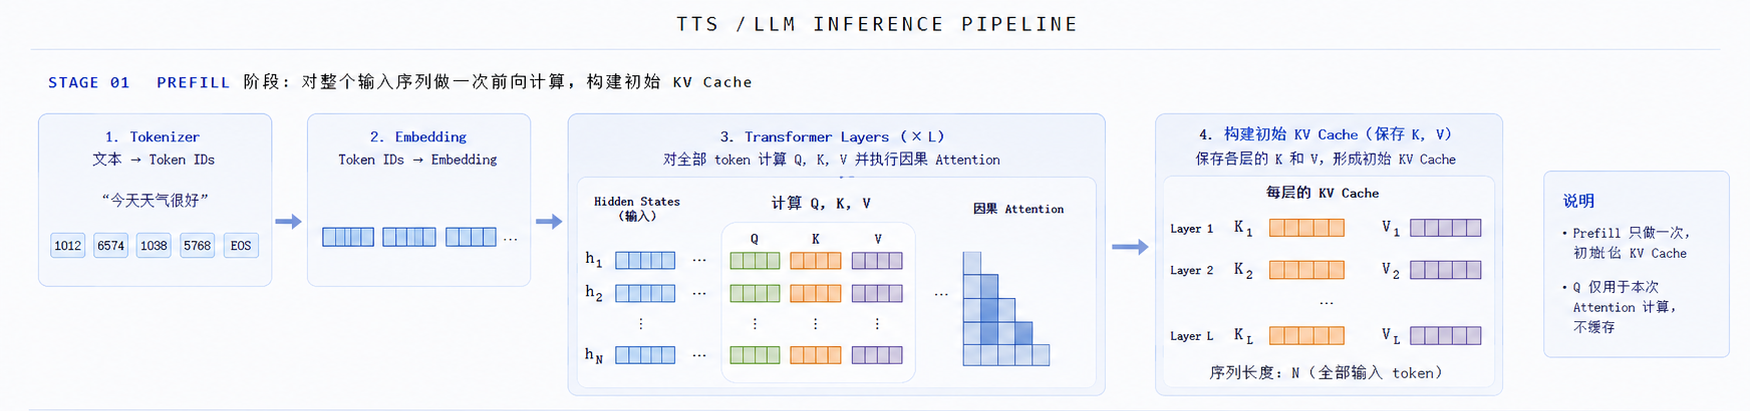
图 1. KV Cache 的创建
1.Prefill 阶段中,对整个输入序列做一次前向计算:文本经 tokenizer 转为 token IDs,再经 embedding 进入 transformer 层。每一层根据隐藏状态计算全部 token 的 Q、K、V 并执行因果 Attention,随后保存各层的 K 和 V,形成初始 KV Cache。其中,Q 无需缓存,因其仅用于当前一次的 Attention 计算,后续 Decode 不会复用。
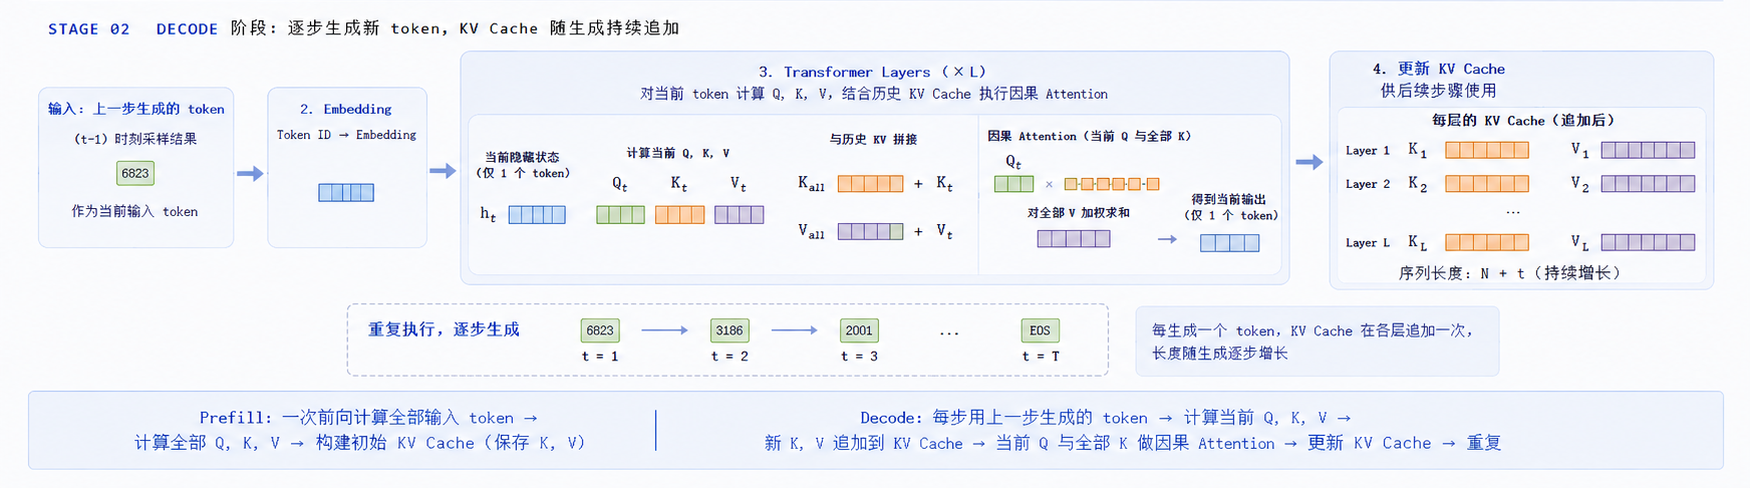
图 2. KV Cache 的追加
2.Decode 阶段中,初始 KV Cache 随新 token 生成而追加。每步将上一步采样得到的 token 作为输入,在每一层计算其 Q、K、V:新 K、V 拼接到对应 transformer layer 的历史 KV Cache 后,新 Q 与全部(历史+当前)K 做因果自注意力,再对全部 V 加权求和,得到当前 token 的注意力输出,并且更新后的 KV 缓存供后续步骤使用,并随生成逐步增长。
概括而言,KV Cache 的来源就是——Prefill 一次性计算并缓存整个输入序列的 K、V;Decode 仅计算新 token 的 Q、K、V 并将新 K、V 追加到缓存。
2.2 KV Cache 如何发挥作用
Decode 阶段通常每次只处理一个新 token。设当前处理位置
其中
其中,
当已处理至位置
随后完成当前 token 的 Attention 计算:
如果不保存 KV Cache,每生成一个新 token 都需要重新通过线性投影计算全部历史 token 的 K、V,造成大量重复计算,就会降低 Attention 的 inference 效率。
每个 transformer layer 完成 Attention 计算之后,对
注意:采样得到的是 token id(词表映射已体现在 logits 的词表索引中),仅在最终输出文本时,才通过 tokenizer 将 token id 解码为自然语言。
那么从一次完整推理请求出发,KV Cache 是如何在 Prefill 与 Decode 阶段中构建、读取与追加?
3 KV Cache 的生命周期
为直观理解 KV Cache 的工作方式,下面用一个极简 LLM 手动模拟一次完整请求中 KV Cache 的构建、读取与追加。该模型词表大小为 10,每个 token 表示为 4 维向量;模型只有 1 层 transformer,并采用单头注意力。
输入 Prompt, 用户输入 “I love AI”,经 tokenizer 、 embedding 后得到 3 个向量:
- Token 1(“I”):
- Token 2(“love”):
- Token 3(“AI”):
计算简化假设:
- 线性投影
(单位矩阵); - 暂时省略位置编码、输出投影、残差连接、RMSNorm 等。
真实模型中这些组件仍然存在,但上述的简化不改变 KV Cache 的核心工作方式,下面按 Prefill -> Decode 展示一次完整生命周期:
3.1 Prefill
Prefill 一次性处理 Prompt 中的全部 token。输入矩阵
经过线性投影
模型将
其中
对每一行做 Softmax,得到注意力权重:
注意力输出
在真实模型中,
| 候选 token | 概率 |
|---|---|
| are | 0.05 |
| great | 0.08 |
| models | 0.12 |
| very | 0.63 |
采用贪心解码时,概率最高的 “very” 成为第一个生成 token,即序列中的第 4 个 token。若改为随机采样,则按该分布抽样,不一定取到最高概率项。
至此,Prefill 完成了两件事:
- 为 Prompt 中全部 token 构建初始 KV Cache;
- 用 Prompt 最后一个位置的隐藏状态,预测第一个新 token。
3.2 Decode
进入 Decode 后,模型把刚刚得到的离散 token “very” 作为下一步输入。送入模型的不是 Prefill 的
在
将新算出的
当前
注意:Decode 单步的 Query 只有一行,不必再额外加掩码。
从逻辑上看,普通自回归 Decode 中的 KV Cache 是随生成逐步追加的。真实系统里,前缀缓存、滑动窗口、推测解码以及 Cache 淘汰等机制可能涉及分页、共享、回滚或回收,那么追加并不总是对应一块连续增长的显存。
3.3 请求结束
当 LLM 生成 EOS、达到最大输出长度,或请求被取消时,本次生成结束。推理引擎会减少该请求所持有的 block/page 的引用计数,降为 0 的归还到 GPU 全局空闲池。
若启用了 Prefix Caching、RadixAttention 等优化方法,缓存结构会继续引用可复用前缀对应的 block(含本请求新写入、可供后续请求命中的 KV);或者这些 block 仍留在 GPU KV 池中,直到按策略淘汰后再归还空闲池。
至此,一次请求中 KV Cache 的生命周期可概括为:
注意:block/page 是 KV Cache 的分页管理单位。
4 Naive KV Cache 显存占用分析
前面分析了 KV Cache 的重要作用及其在整个请求处理过程中的变化。之所以许多推理引擎会重点优化这一部分,关键原因在于它的显存占用。以下给出后续分析所需的符号定义:
:请求数,即 batch size; :每个请求的有效 token 数; :transformer 层数; :KV 头数; :每个头的维度; :每个数据元素占用的字节数; :Decode阶段生成序列长度。
1.Prefill阶段构建的 KV Cache 显存占用
每一层、每一个 token 要保存一份 K 和一份 V,因此其总的显存占用表示为:
如果不同请求的长度为
2.Decode阶段构建的 KV Cache 显存占用
每一层、每一个新生成的 token 要保存一份 K 和一份 V,因此其新增显存占用表示为:
若各请求生成长度不同,更准确为:
Decode 结束后的总 KV Cache 显存占用为:
其中,如果生成的请求序列长度不一致时把
注意:公式中的因子 2 已经表示 K 和 V 两份张量。实际引擎中还会有 Prompt Caching、Prefix Caching 等因素影响两个阶段的显存占用,但这里为方便分析简化,不考虑这些优化,上述均为理论占用。
根据前面的分析,下面以常见的 Qwen3-4B-Thinking-2507 配置为例进行估算。该模型配置为:transformer 层数
1.Prefill 阶段
处理 1 个请求、序列长度(上下文长度)
2.Decode 阶段
在 Prefill 结果基础上逐 token 生成,每生成 1 个新 token即
Decode 1 步后的总占用(Prefill 已有 + 新增)为:
注意:Decode 是逐 token append,总占用随生成长度 l 线性增长。
假设 Decode 阶段最终生成长度为
将上述结果置于不同场景下即设置不同的Prefill长度,可以得到更直观的对比。以下计算均取
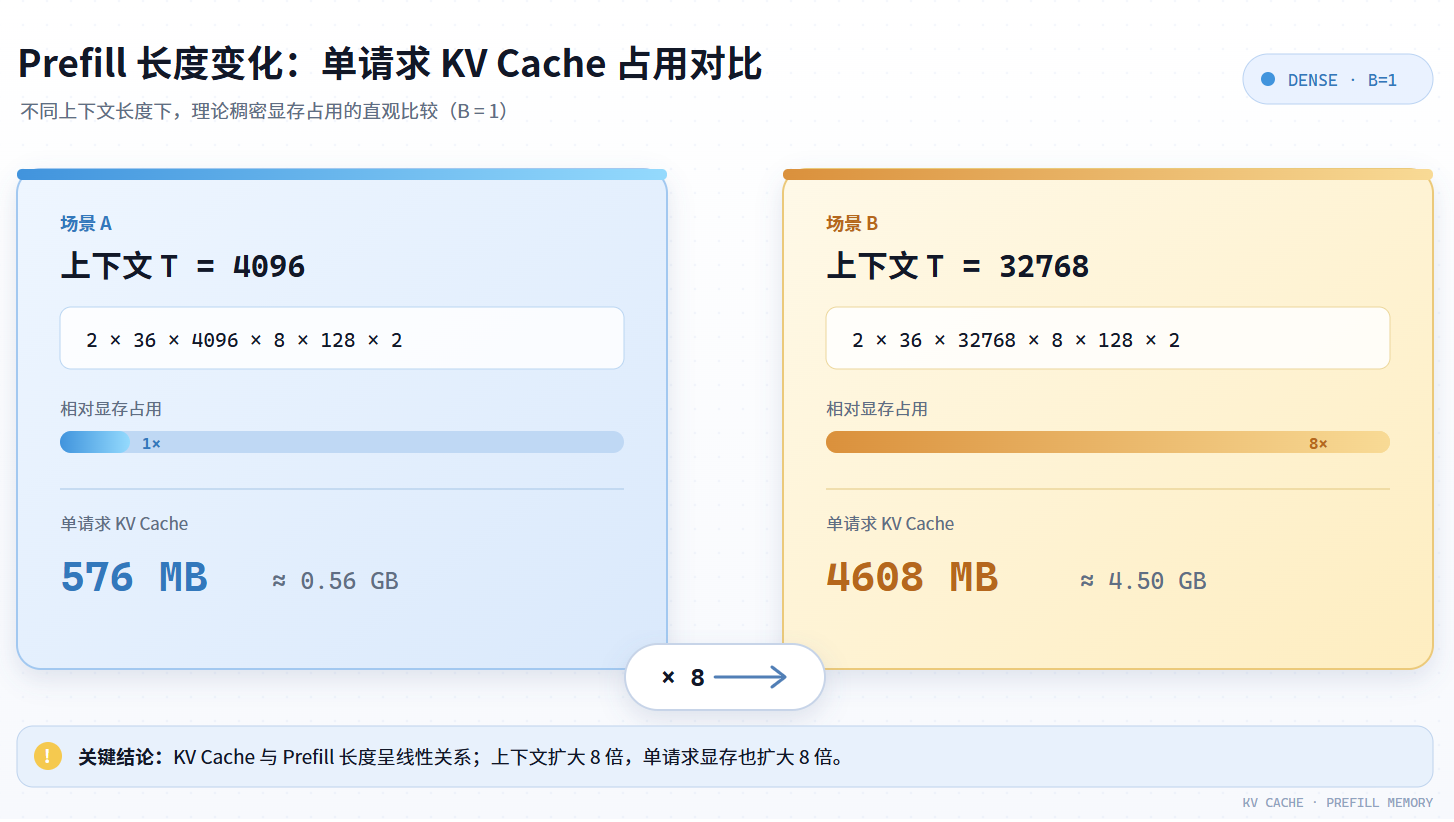
图 3. 单请求不同场景 KV Cache 的占比
单个 Qwen3-4B-Thinking-2507 请求从 4K 增长到 32K 时,理想化 KV Cache 从约
对单条短上下文请求,模型权重仍是主要显存占用;当上下文很长或并发请求较多时,KV Cache 会迅速超过权重,成为显存主导。Decode 阶段的中间激活等临时占用通常相对较小。因此从数据来看,KV Cache 会成为长上下文瓶颈的原因主要有:
推理时的激活值通常是临时的:优化实现中,系统只保留当前层和当前计算所需的中间结果,算完后即可复用或释放。KV Cache 则必须跨 Decode step 持久保存,并且按层、按 token 近似线性增长。
真实的实现中,激活值还会受到 FlashAttention、融合算子、临时 workspace 和 batch 形状的影响,但其规模通常远小于需要长期驻留的 KV Cache。
概括来说就是——激活值更多是当前计算流动、规模较小的临时工作区;KV Cache 是每个请求都要长期占据 GPU 显存的历史状态。
但是真实场景中的 LLM 推理服务通常会持续运行并且会同时处理多个请求,那么 GPU 显存会被模型权重、KV Cache、workspace 和临时激活等长期占用,容易出现 OOM 的情况。接下来我们会一起聚焦于多请求场景下的显存、传统 Cache 管理问题。
5 多请求下的显存与传统 Cache 管理问题
单请求场景下,使用一块连续张量保存该请求的 KV Cache,分配、追加和释放都相对简单。但在多请求场景中,如果仍为每个请求,单独分配一块连续显存,并让这块区域随序列长度增长,传统的连续分配方式会出现以下问题:
- 显存碎片与预留浪费。 请求的长度和生命周期各不相同,动态分配和释放容易留下大小不匹配的空闲区;如果按最大上下文长度预留空间,又会为尚未生成的 token 提前占用显存。若连续区域需要扩容,还可能触发重新分配和数据复制。
- 无法共享重复前缀。 多个请求往往带有相同的 system prompt 或对话前缀。彼此独立的 Cache 会重复保存同一段 K、V,公共前缀越长,重复占用就越明显。
- 调度与回收复杂。 请求的加入、退出、抢占和恢复都需要同步维护显存容量、Cache 位置、优先级与延迟目标;当 Cache 分散或需要扩容时,还会增加回收、搬移和元数据管理的开销。
- 不利于高效支持 Continuous Batching。 Continuous Batching 要求在每轮 Decode 中动态加入新请求并移除已完成请求。连续存储并非不能实现这一机制,但需要额外维护变长请求的地址和长度信息;若批处理内核使用规则的矩形张量,通常还要按最大长度填充,带来无效计算和空间浪费;若为了保持紧凑布局而重新组织请求,则会引入 gather、重排或数据搬移开销。
这些问题说明,KV Cache 管理不能只把每个请求视为一块独立的连续张量,而需要更细粒度的 block/page 分配、回收和调度,并尽可能复用相同的前缀。
6 总结与测试题
6.1 课程总结
本章从 Attention 出发分析 KV Cache 的生命周期与显存占用,并认识到其在长上下文、多请求场景下带来的显存与管理压力,因此 KV Cache 的高效组织与管理会成为推理引擎重点关注的优化方向。
6.2 测试题
1.在 Full Attention 的推理过程中,KV Cache 分别来源于哪些计算,它的作用是什么?
提示:结合 Attention 公式,分 Prefill、Decode 两个阶段说明。
2.描述一个请求从接收到生成结束,KV Cache 经历了怎样的完整生命周期?
提示:可按分配、Prefill 写入、Decode 读取与追加、请求结束这四个阶段展开。
3.显存占用计算,假设处理单个请求,输入上下文长度
- Prefill 结束时的 KV Cache 占用;
- Decode 每生成 1 个 token 新增的占用;
- 生成结束后的总占用。
并简要对比分析这些数值说明了什么。
提示:注意区分 Prefill 总量、Decode 增量与最终总量。
4.在多请求并发场景中,若仍采用为每个请求分配连续显存的 naive 管理方式,会带来哪些主要问题?
提示:从显存碎片与预留浪费、动态加入/退出请求的开销等角度考虑。
5.KV Cache 在请求结束前会随生成长度线性增长,对 GPU 显存构成显著压力。是否可以考虑将部分或全部 KV Cache 放到 CPU 内存,这样做有哪些潜在收益与代价?
提示:考虑显存压力缓解与容量扩展的好处,同时延迟对 Decode 吞吐的影响等。