第 3 章 GPU 入门
欢迎来到 zero-to-sglang 课程,这里是课程的第二部分,上节课我们介绍了大模型的推理具体过程,学习了token的生命历程还有KV Cache 等技术,下面我们要介绍的是GPU的架构以及LLM在GPU的执行流程。GPU作为大模型训练和推理的地基,贯穿整个大模型的生命流程,我们有必要学习GPU相关的知识。下面就让我们开始本节课程的学习。
1 本章学习目标
本章围绕 GPU 硬件架构 与 大模型推理在 GPU 上的执行流程 展开,共分为三个部分:
GPU 架构基础:从 GPU 作为图形处理器的起源讲起,对比 CPU 与 GPU 的设计哲学(低延迟 vs 高吞吐),并以 A100 为例拆解 GPC→TPC→SM→CUDA/Tensor Core。
GPU 的执行模型:讲解 SIMT 执行模型下 Block/Warp/Thread 的三级调度,以及寄存器→共享内存→L2→全局内存的多级内存层次。
LLM 推理在 GPU 上的执行流程:说明为什么 LLM 推理离不开 GPU,并将推理拆解为预处理、计算密集的 Prefill 和内存密集的 Decode 三个阶段。
2 GPU 架构基础
2.1 GPU的起源:图形处理器
在深度学习概念没有火起来之前,GPU在普通人眼中是游戏显卡,即图形处理器。下面用一个例子来说明GPU和CPU的区别。
当我们打开游戏里面的3D模型,可以发现3D模型都是由一个一个小三角形构成,三角形由三根线构成,为了节省存储的空间,我们只存储三角形的三个顶点坐标,构成线的像素点坐标我们不储存,而是实时计算出来。
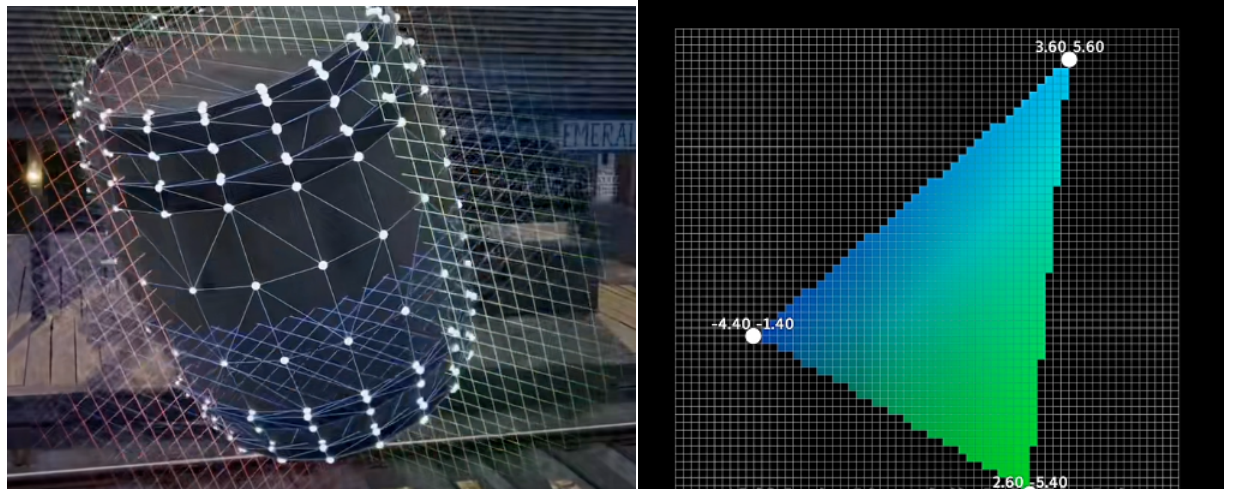
图 1. 3D 模型与三角形的计算
由两个点构成一个直线就可以发现,一根线我们只存储两个端点的信息,中间的像素点再时时计算渲染。我们可以由两个顶点坐标计算斜率和截距,就可以算出两条线中间的点的位置。虽然都是简单计算,只有大量简单的乘法和加法。但是 CPU 天生时执行复杂逻辑的,只能逐个计算,所以计算时间非常长。
人们就想到创造出可以大量并行计算简单的乘法和加法的计算单元,就是GPU。CPU和GPU没有优劣之分,只是用来执行不同功能的单元。GPU的计算单元被称作CUDA核心。
2.1.1 图形显示的萌芽(1980年代前)
没有GPU的时代,电脑显示图形全靠CPU计算,1981年:IBM PC配备的CGA显示卡只能显示16色,像个电子相框,所有计算都由CPU完成,1987年:IBM推出VGA标准,能显示256色,但依然是纯显示功能,没有计算能力。
关键在于1985年ATi公司成立,开始用ASIC技术做图形芯片。1992年ATi的Mach32图形卡首次集成图形加速功能,这是GPU的起始点。
2.1.2 3D加速卡混战(1990年代)
90年代是图形加速器的黄金时代,但还没有GPU这个正式名称。
里程碑事件在1994年3DLabs发布Glint300SX,第一颗PC用3D加速芯片诞生;1996年,3dfx的Voodoo芯片让普通PC能跑3D游戏,开启消费级3D时代;1997年富士通发布个人电脑首款3D几何处理器,三菱推出支持变换和光照(T&L) 的芯片。
但是各家标准混乱,互不兼容;只能处理特定3D任务,功能专一;当时叫3D加速卡,还没GPU概念。
2.1.3 GPU正式诞生:NVIDIA(1999-2006)
1999年,NVIDIA发布GeForce 256,首次提出GPU(图形处理器)的概念。这个名字区分了传统CPU,宣告:显卡的诞生。
GeForce 256具有革命性,硬件T&L技术上,将把3D图形的坐标变换、光照计算从CPU解放出来,变成了GPU专职。实现了单芯片集成,整合三角形构成、裁剪、纹理、渲染功能,并且是实现性能飞跃:让CPU的3D计算负担减轻80%以上。
在2000年市场大洗牌,2000年后,3dfx、Matrox等老厂商逐渐退出,只剩NVIDIA GeForce和ATI Radeon争霸(ATI 2006年被AMD收购)。
2.1.4 可编程时代:(2001-2012)
第一阶段:固定管线 Shader(2001-2006)
2001年,微软DirectX 8引入顶点着色器和像素着色器,GPU可以跑简单程序了。以前GPU是固定流水线上的拧螺丝工人,现在变成了能执行简单指令了。
第二阶段:统一渲染架构(2006-2012)
2006年,NVIDIA发布GeForce 8800 GTX(G80核心),首个统一渲染架构GPU。原来顶点着色器和像素着色器是分开的,现在变成了通用的。计算资源可以动态分配,利用率从50%提升到90%+;同时发布CUDA技术,让GPU能跑C语言程序。
| 架构 年份 | 核心技术 | 代表产品 |
|---|---|---|
| Tesla (2006) | 引入CUDA,开启GPGPU | GTX 280 |
| Fermi (2010) | 支持双精度计算、ECC纠错 | GTX 480 |
| Kepler (2012) | 动态并行、高能效 | GTX 680 |
2.1.5 通用计算时代(2012-2018)
2012年是转折点:AI研究人员用GPU训练深度神经网络,让AlexNet图像识别准确率震惊世界。从此GPU从游戏显卡升级为AI发动机。
英伟达构建了NVIDIA CUDA生态,让程序员轻松调用GPU算力。
2.1.6 CPU(中心处理器)和GPU(图形处理器)的区别
CPU是我们最早接触的执行模型。程序按顺序运行,在单线程中逐步执行指令。要支持这种执行模式需要大型控制单元和快速运行能力,因为存在大量分支和条件控制逻辑。因此CPU会将大量芯片面积用于分支预测(下面这张图),虽然核心数量有限但运行速度极快。相比之下,GPU则拥有海量计算单元(ALU),就是那些绿色小方块。只有极小部分芯片面积用于控制逻辑,用少量控制逻辑来协调海量并行运算的计算单元。从概念上看,这体现了CPU和GPU的不同侧重点。
二者的设计目标截然不同,CPU优化延迟,追求单个任务最快完成。而GPU优化吞吐量,GPU不关心单个任务延迟,只追求所有任务整体最快完成。为此GPU配备大量可快速休眠唤醒的线程,虽然GPU每个任务的延迟较高,但整体完成时间反而领先CPU。这就是它们不同的设计理念和目标。因此,GPU的架构结构不同在于在于GPU会运行大量流式多处理器(SM)。
CPU设计初衷是用来最小化单任务延迟,快速响应复杂逻辑,大部分晶体管用于控制逻辑和缓存,核心数量通常有4-64,可以执行乱序执行、分支预测、推测执行等等任务。
GPU的设计初衷是最大化数据吞吐量,批量处理简单计算,大部分晶体管用于算术逻辑单元(ALU),核心多而简,可以达到数千个(如 A100 有 6912 个 FP32 CUDA 核心)。它优化吞吐量,追求所有任务整体最快完成,为此配备大量可快速切换的线程来隐藏访存延迟,单个任务的延迟并非其优化目标。
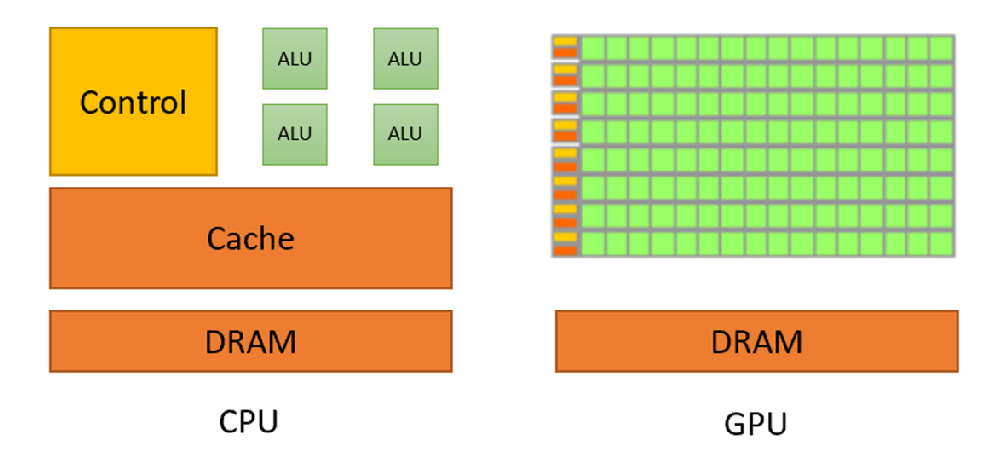
图 2. GPU 和 CPU 的结构对比
上面这幅图可以看到:CPU的计算单元(绿色部分)少,大部分用来控制(Control)和缓存(Cache)这决定了它可以进行复杂的逻辑运算,GPU则不同,他的控制单元少(黄色部分),大部分都是绿色的计算单元,这决定了它可以进行大量并行计算简单的乘法和加法运算,在需要大量分支判断和复杂控制流的场景下,GPU的效率远低于CPU。GPU主要就是优化吞吐量,追求所有任务整体最快完成。控制逻辑仅占芯片面积的极小部分,计算单元(ALU)占绝大多数。所以我们在使用GPU时还要CPU的调度,一个好的GPU要配上好的CPU才能发挥作用。
到了AI时代,深度学习中的矩阵将GPU推上神坛。因为AI时代的核心是神经网络的计算,其中涉及到大量的矩阵运算,矩阵运算的本质是大量的乘法和加法,特别适合GPU来做这种简单又重复的运算,在2010年左右人们就开始利用GPU来进行AI相关的计算。
2.2 A100显卡核心的构成
我们使用A100 来介绍GPU的具体结构
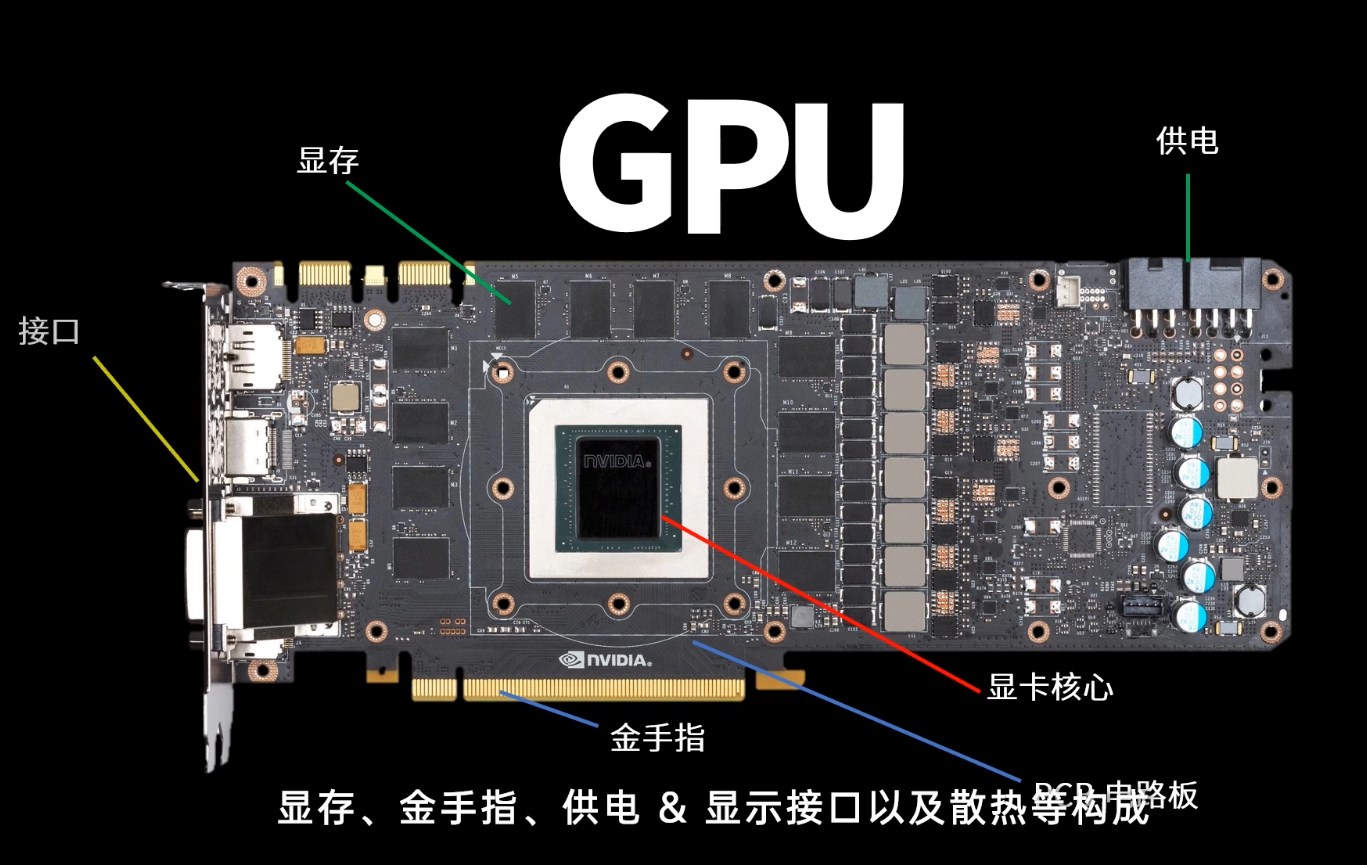
图 3. 显卡(GPU)的整体结构
一张英伟达的的显卡剖面图如图,一张显卡由供电、显卡核心、显存、显示接口和金手指组成。
我们主要介绍显卡核心:显卡核心由cuda core、控制单元和缓存单元等构成。而 CPU 和 GPU 最大的不同就在于,GPU 负责的工作大多是重复性的 3D 建模或者渲染,而流处理器就是负责顶点运算或者像素运算,能动态的分配进行顶点运算和像素运算的流处理器数量,达到资源的高效利用。
A100是NVIDIA为数据中心设计的纯计算GPU,没有图形输出能力。
2.2.1 产品形态
A100 有多种版本形态,这里我们统一介绍PCIe 80GB 版本。
GA100 是完整芯片的物理设计,实际产品会和白皮书中存在差异,核心原因是芯片分拣,制造这种包含542亿个晶体管的庞大芯片时,很难保证100%完美,为了不浪费有微小缺陷的芯片,NVIDIA会屏蔽掉有问题的部分,将其降级为规格稍低的产品出售。因此,A100 PCIe 80GB 版本 就是屏蔽了完整GA100芯片中1个GPC和另外2个TPC后的产物,最终得到 108个SM。
数据出自NVIDIA A100 Tensor Core GPU Architecture
尺寸为双槽全高,长267mm。功耗:300W(80GB版)。散热是被动散热,无风扇(依赖服务器风道)。接口为PCIe 4.0 x16金手指 + NVLink桥接器接口;重量约1.4公斤。
2.2.2 PCB板级组件
GA100 GPU核心芯片
封装:巨型BGA封装,尺寸约55mm×55mm。位置:板卡正中央,焊在PCB上。542亿个晶体管,7nm工艺,面积826mm²。
HBM2e显存堆栈(革命性设计) 不同于消费级GPU的GDDR显存颗粒,A100采用3D堆叠技术:
2.2.3 GA100 GPU核心架构
Ampere架构拓扑如下:
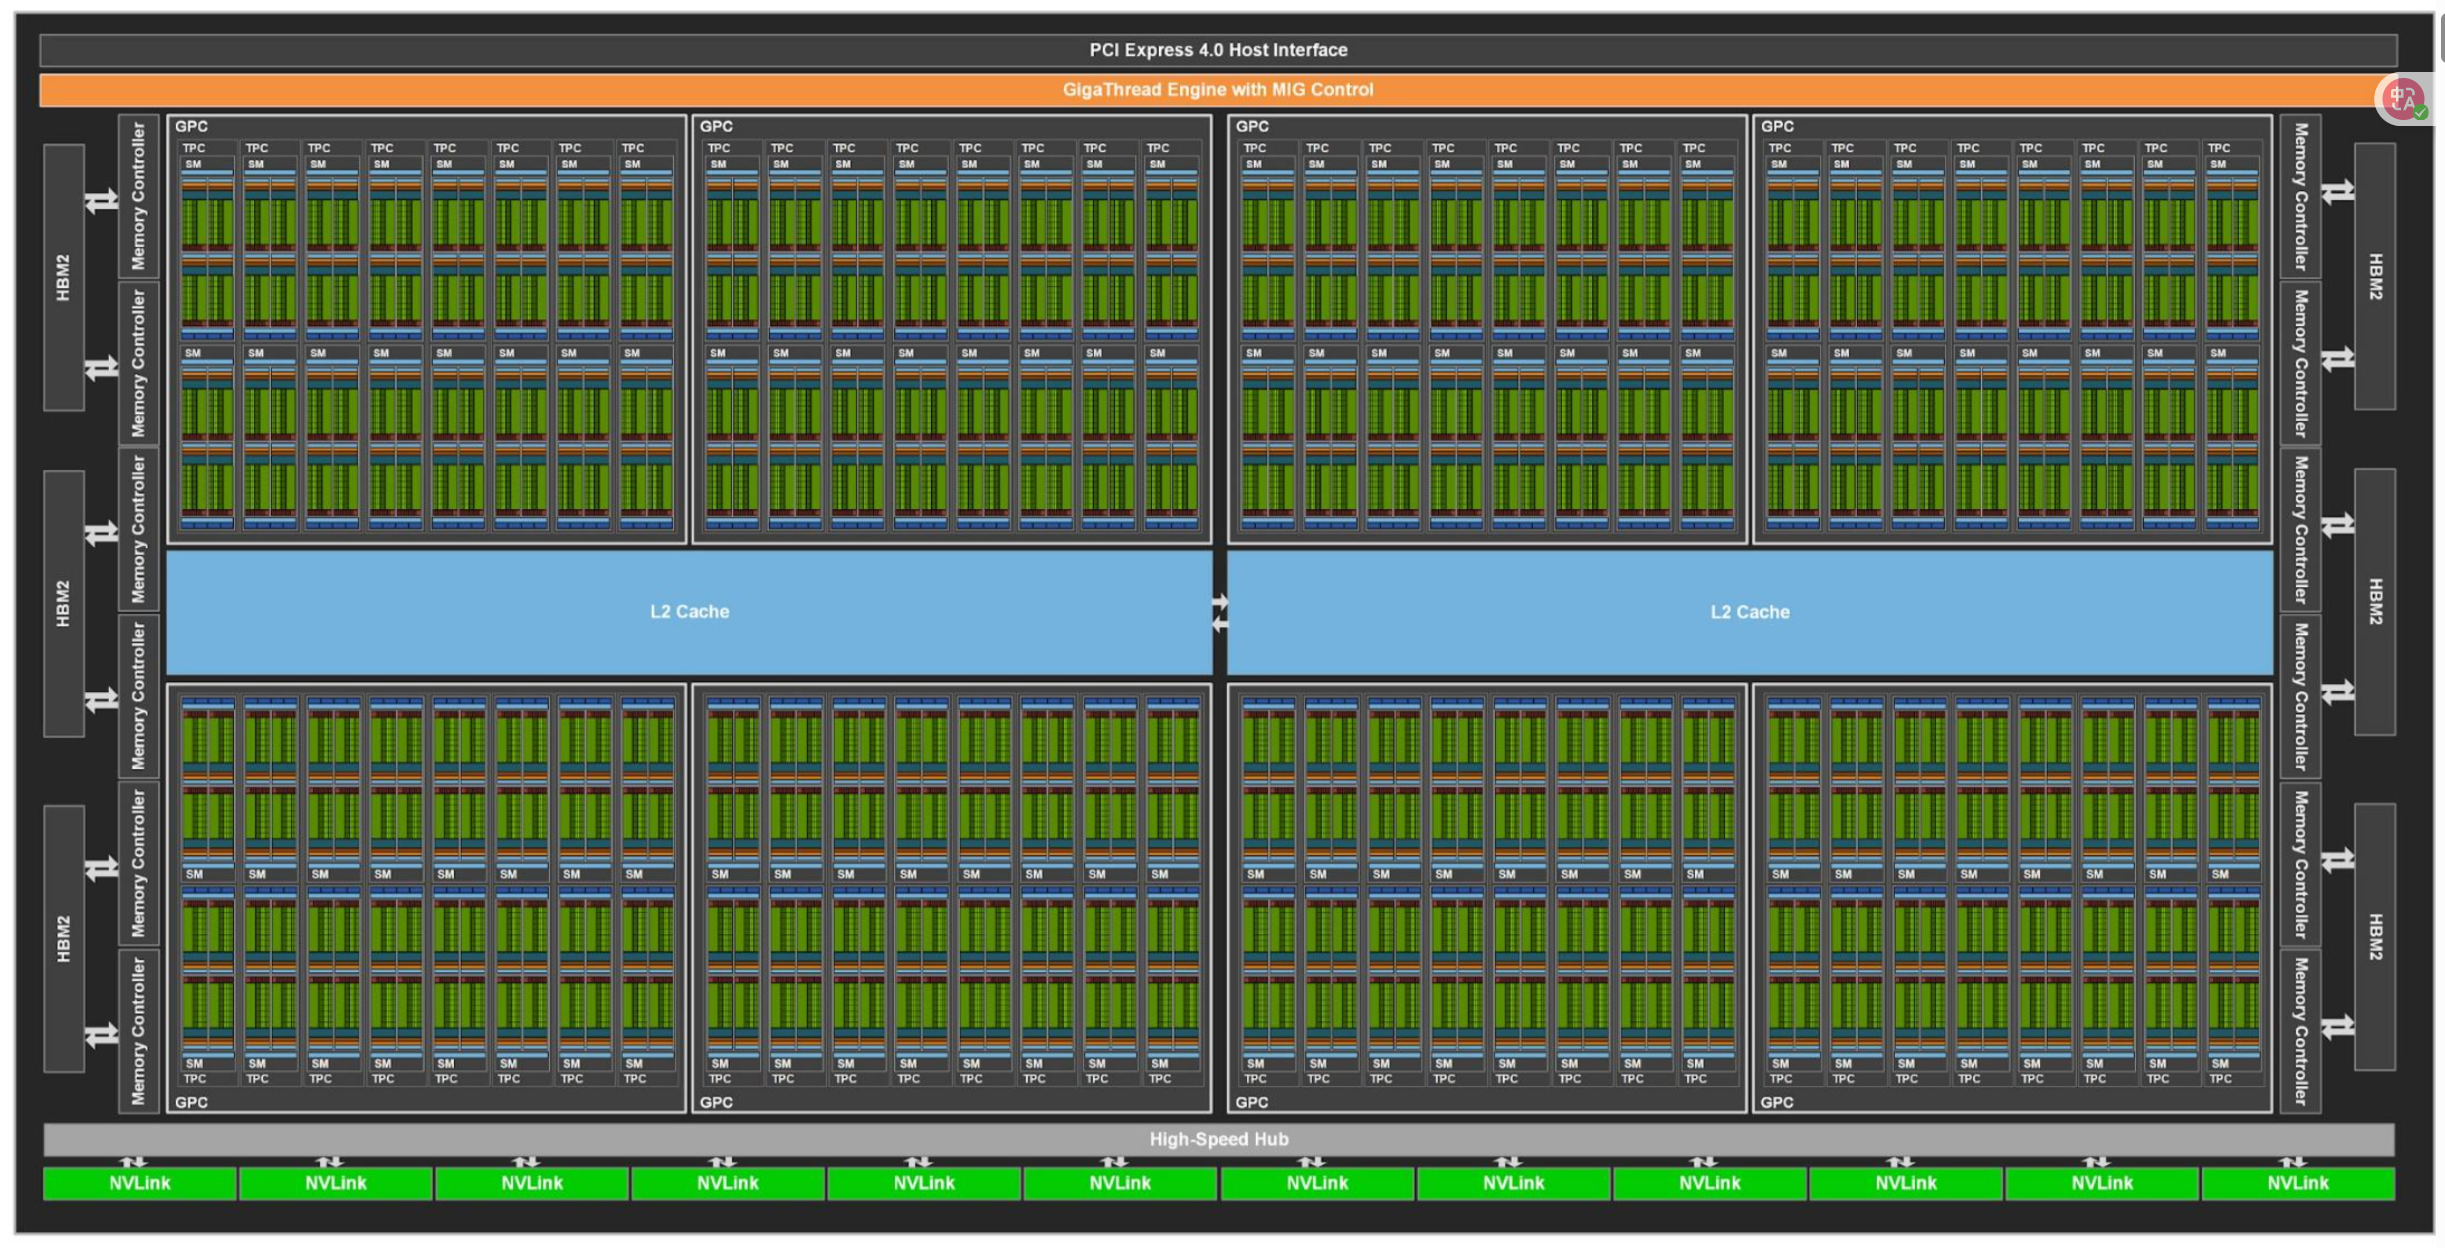
图 4. GPU 核心的架构
NVIDIA Ampere架构是NVIDIA于2020年发布的GPU架构,是其第八代GPU架构。它采用7纳米制程工艺,集成了高达542亿个晶体管,是当时世界上最大的7纳米芯片。该架构主要面向数据中心、人工智能、高性能计算及专业图形等领域
A100有四个层级的架构拓扑,首先是GPC(图形处理簇),一个完整的PCIe 80GB 版本 核心有7个GPC;每GPC 8个TPC(纹理处理簇),共54个TPC;每TPC 2个SM(流式多处理器),共108个;每个SM有64个CUDA核心,一共有108 × 64 = 6,912个FP32 CUDA核心。
然后是Tensor Core,每个SM有4个,实际有108 × 4 = 432个。除此之外还有5 个HBM2 显存堆栈
数据出自
NVIDIA A100 Tensor Core GPU Architecture
https://ar5iv.labs.arxiv.org/html/2405.11425#1
2.2.4 SM(Streaming Multiprocessor,流式多处理器)内部结构
A100的SM是Ampere架构核心,相比消费级GPU有本质增强:
SM是将线程块(Thread Block)映射到物理硬件并完成实际计算的根本单元。当GPU内核(Kernel)启动时,线程块被分配到空闲的SM上,SM负责将其内部的线程束(Warp,32线程)解码并派发至CUDA核心(处理通用运算)或Tensor Core(处理矩阵乘加运算)执行。没有SM的调度,CUDA核心和Tensor Core无法自主运行。
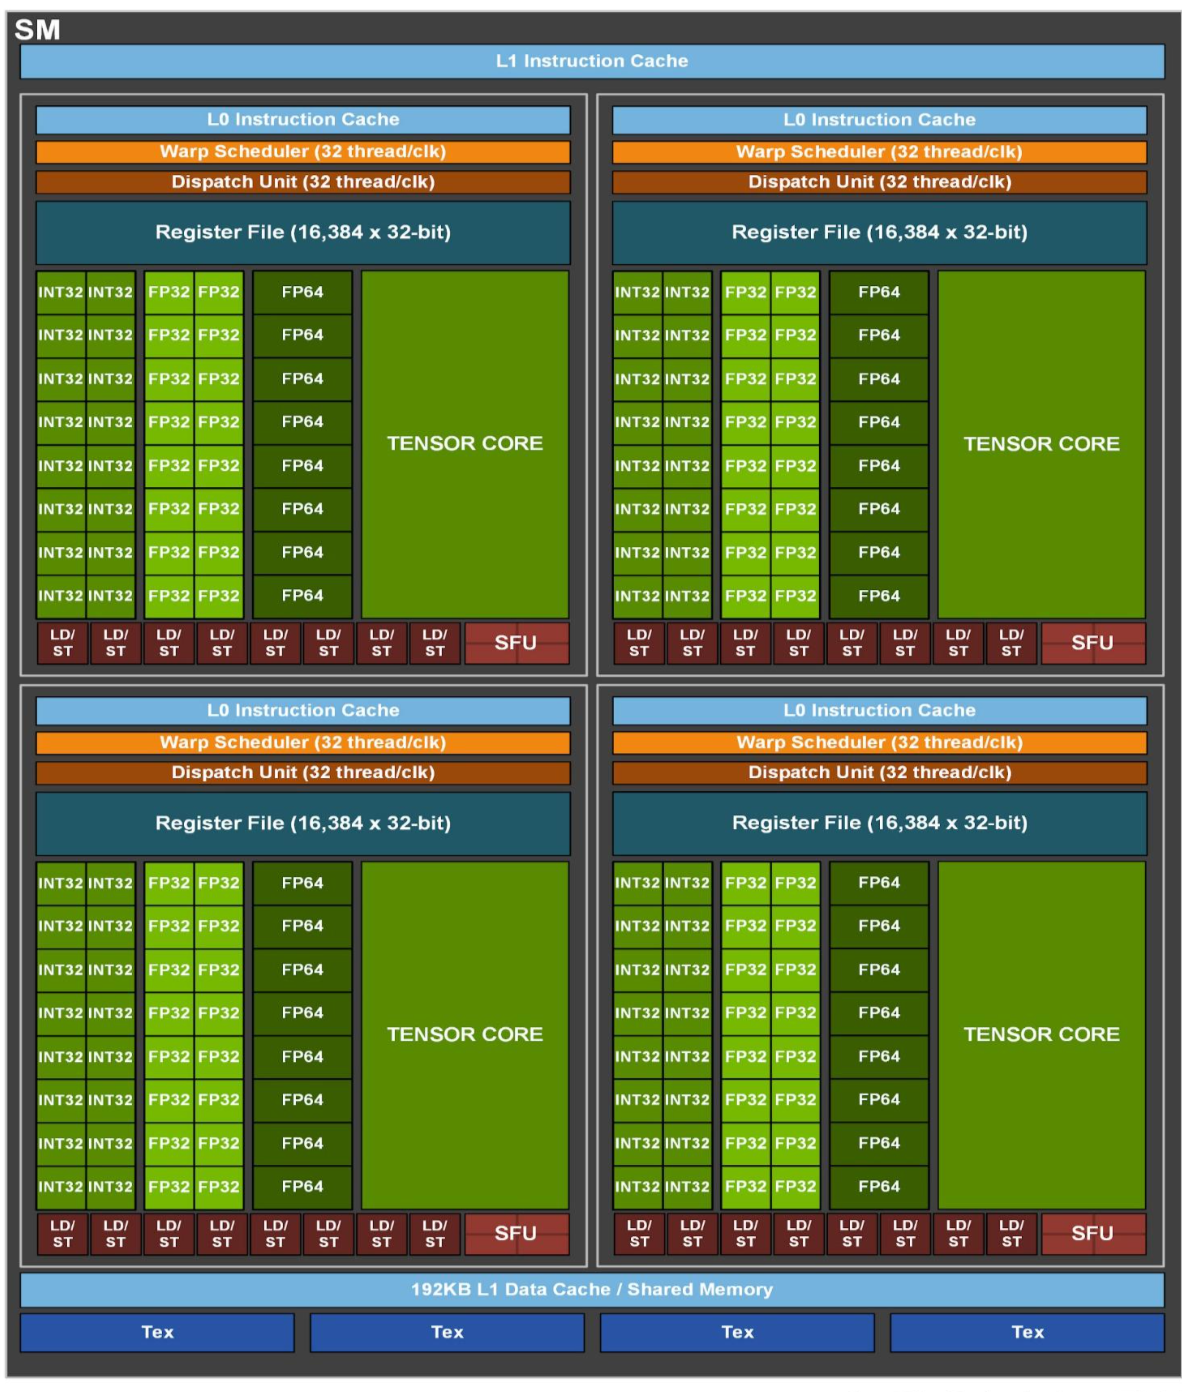
图 5. SM(流式多处理器)的架构
SM的独特之处是在于CUDA核心,64个/组, 实际配置为64个FP32 + 64个INT32,同时还有第三代Tensor Core,支持结构化稀疏,并和支持双精度FP64(消费级GPU没有)
2.2.5 tensor Core
NVIDIA A100 Tensor Core是其第三代Tensor Core技术,是A100 GPU专为加速AI训练、高性能计算(HPC)和数据分析而设计的核心计算单元。它通过专用硬件和全新精度格式,在矩阵乘法等核心运算上实现了数量级的性能飞跃。
Tensor Core是专为执行矩阵乘加运算(FMA) 而设计的硬件单元,在处理深度学习和科学计算中的核心运算时,效率远超通用CUDA核心。A100支持多种数据精度,特别是引入了创新的TensorFloat-32 (TF32) 格式。TF32 使用8位指数和10位尾数,具有 FP32 的数值范围和 FP16 的尾数精度。Tensor Core 使用 TF32 执行乘法,并以 FP32 累加结果。A100的Tensor Core支持结构化稀疏技术。它能利用AI模型中的稀疏性(即大量参数为零),将吞吐量进一步提高。
A100 Tensor Core提供了惊人的计算吞吐量,具体性能如下:
| 精度 | 稠密 Tensor Core 性能 | 说明 |
|---|---|---|
| FP16/BF16 | 312 TFLOPS | 半精度,深度学习的主力精度。 |
| INT8 | 624 TOPS | 8位整数,主要用于AI推理,速度极快。 |
| FP64 | 19.5 TFLOPS | 双精度,满足科学计算等高精度需求。 |
| TF32 | 156 TFLOPS | FP32 数值范围、FP16 尾数精度,FP32 累加。 |
| 精度 | 稀疏 Tensor Core 性能 (2:4) | 说明 |
|---|---|---|
| FP16/BF16 | 624 TFLOPS | 半精度,深度学习的主力精度。 |
| TF32 | 312 TFLOPS | FP32 数值范围、FP16 尾数精度,FP32 累加。 |
| INT8 | 1248 TOPS | 8位整数,主要用于AI推理,速度极快。 |
| FP64 | 不支持稀疏,仍为 19.5 TFLOPS |
数据出自NVIDIA A100 ensor Core GPU
在GPU计算(尤其是A100的Tensor Core)语境下,稠密和稀疏指的是数据处理方式,直接决定了算力能否翻倍。
简单来说 稠密 在计算时,把矩阵里所有的数字(包括0)都拿来参与乘加运算,。稀疏则A100的2:4稀疏是结构化稀疏,权重矩阵每4个连续值中最多保留2个非零值,硬件在加载时只读取非零值和索引,直接跳过零值对应的计算。因为很多0乘以任何数都是0,跳过它们能省下一半计算量,速度自然翻倍。
1. 稠密计算(默认模式)
他其实就是标准的矩阵乘法。例如两个 1024x1024 的矩阵相乘,Tensor Core 需要执行约 10 亿次乘加运算。此时,A100 的 FP16 算力就是 312 TFLOPS(即每秒 312 万亿次)。这是它的基准速度。
2. 稀疏计算(加速模式)
使用结构化的数据,A100 要求将矩阵权重每连续的4个数值中,强制至少有2个是0(即 2:4 稀疏度)。这不是随机的,必须满足这个固定数学模式。因为知道有一半是0,Tensor Core 在读取数据时会自动压缩,只读取那2个非零值和它们的索引位置去计算。计算量直接减半,所以 FP16 算力从 312 TFLOPS 升到 624 TFLOPS。
前面提到过 A100 GPU拥有432个第三代Tensor Core,分布于108个流式多处理器(SM)中。Tensor Core采用Warp-Level的编程模型。一个Warp(32个线程)协同工作,将数据从显存加载到寄存器,再由Tensor Core执行矩阵运算。开发者可以通过CUDA、cuDNN等深度学习库,以及主流的AI框架(如PyTorch、TensorFlow)来调用Tensor Core。
以上内容可以在英伟达技术博客中查看详细描述
3 GPU的执行模型
我们简单介绍了A100 GPU的结构,但是我们还不知道GPU是如何执行计算的,下面我们介绍GPU各个部分的是如何执行计算的。
3.1 SM流式处理器的执行流程
我们可以将流式多处理器视为一个M是GPU中独立调度和执行的基本硬件单元。当使用Triton这类工具编程时,操作层级就对应着block,block会被分配到SM中执行。在每个SM内部,它包含许多流处理器(SP),而每个流处理器会并行执行大量线程。可以这样理解,SM拥有一套控制逻辑,能决定执行内容,比如实现分支判断;而SP则负责将相同指令应用于不同数据片段。这样就能实现海量并行计算。在这种架构下,每个SM是控制粒度的基本单元,而单个SP能独立完成大量计算。以A100为例,它包含108个SM,这远超大多数CPU的核心数量。每个SM内部都集成有大量SP和专用矩阵乘法单元,这就是其计算模型的基本形态。每个SM能操控其专属组件(如张量核心)进行计算。
线程调度与执行
SM同时管理数千个线程,决定哪个线程在何时使用哪个计算单元。它不像CPU那样为每个线程保存大量状态,而是轻量级切换,几乎没有开销。
指令流水线
SM内部有4条独立的指令流水线,每个时钟周期可以同时发射4条不同指令给不同的Warp(线程束)。
数据缓存与共享
SM内置192KB的L1缓存/共享内存,供本SM内所有CUDA核心快速存取数据,延迟比全局显存低。
3.2 执行模型的核心名词详解
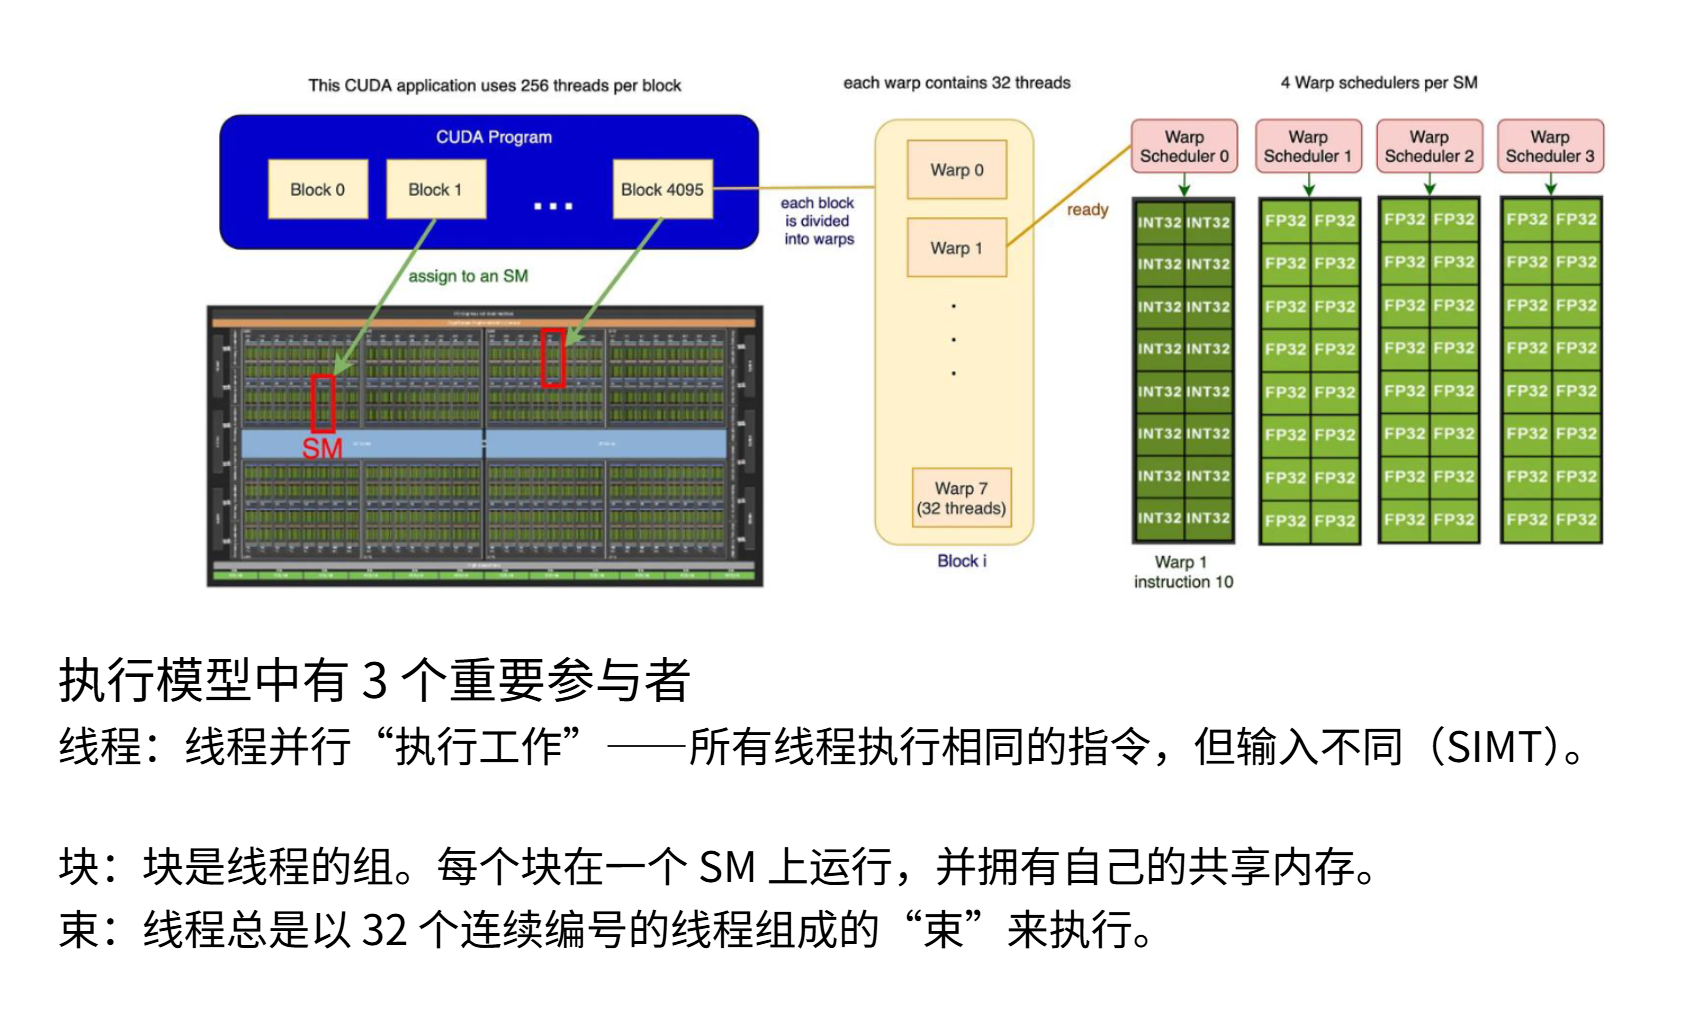
图 6. SM 的执行流程
在GPU运行中,我们划分三个粒度层级来思考:块(block)、线程束(warp)和线程(thread),这是粒度逐级细化的顺序。块是大型线程组,每个块会被分配给一个SM处理。可以把每个SM想象成独立工作的单元,而块就是分配给它的处理单元。在每个块内部包含大量线程,每个线程代表待执行的任务单元。这些线程在执行时会分组运行,这种分组称为线程束。每个线程束由32个连续编号的线程组成,从块中提取出来同步执行。通过这个示意图可以看到:多个块被分配给不同的SM,每个块内包含多个线程束,每个线程束又由大量线程组成。所有这些线程都会在不同数据上执行相同的指令,这就是基本执行模型。
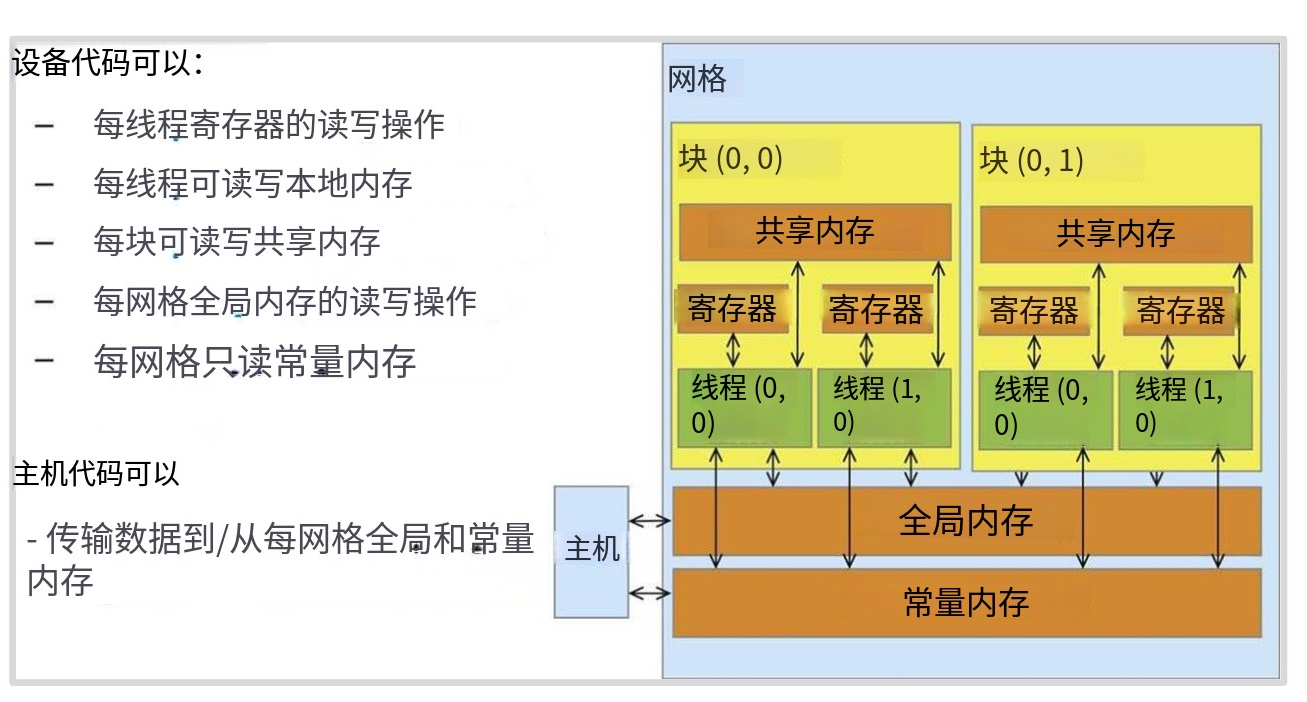
图 7. 执行模型的内存视图
3.2.1 Warp(线程束)
Warp的概念源于其工作机制:所有线程步调一致地执行同一指令,但处理各自不同的数据。在A100中,每个SM(流式多处理器)最多可以同时承载64个活跃的Warp。
一个Warp是32个线程组成的固定小组,是SM调度的最小单元。Warp像"公交车",32个乘客(线程)必须同站同下,执行完全相同的指令。如果某个线程需要走不同分支(if-else),全车人要等它,这叫Warp Divergence(线程束分化)。
SM同时驻留64个Warp,4个Warp调度器每个管理16个Warp;Warp内32线程在SIMD单元上同步执行。Warp由SM的SIMT(单指令多线程)单元负责创建、管理和调度。当一个线程块(Thread Block)被分配给SM后,SM会将其中的线程按照连续的、递增的线程ID进行分组
3.2.2 Block(线程块)
Bock程序员指定的线程组,映射到1个SM上执行。Block必须全部映射到同一个SM上执行,不能拆分到多个SM。 每个Block独占SM的共享内存和寄存器资源;Block内所有线程必须在同一SM内执行(不能跨SM);
3.2.3 Thread(线程)
线程是最细粒度的执行单元,每个线程执行同样的Kernel代码,但操作不同数据。Thread像"流水线上的工人",每人负责一个数据元素(如向量中的一个数)。
每个线程有私有寄存器(每线程最多255个);线程ID:threadIdx.x 决定它处理哪个数据
3.2.4 SIMT(单指令多线程)
GPU执行模型,多个线程(Warp)共享同一条指令,但操作不同数据。SIMT(Single Instruction, Multiple Threads,单指令多线程) 是NVIDIA GPU(包括A100)采用的并行计算执行模型。它由NVIDIA在G80架构中首次引入,是CUDA编程模型能屏蔽硬件细节、让开发者按多线程逻辑编程的理论基础。
SIMT是SM(流式多处理器)执行指令的根本方式。当GPU内核启动后,SM内的Warp调度器以线程束(Warp)为单位(固定32个线程)获取一条指令,然后将该指令广播给Warp内的所有活动线程。每个线程在自己的CUDA核心或Tensor Core上,操作私有寄存器中存放的不同数据,实现“单指令处理多份数据”的并行。
3.2.5 与SIMD(单指令多数据)的本质区别
| 特性 | SIMT(GPU) | SIMD(如CPU的AVX) |
|---|---|---|
| 执行粒度 | 多线程(每个线程有独立指令地址计数器和寄存器状态) | 向量通道(整个向量共享单一指令地址) |
| 分支处理 | 支持线程级分支(if/else、循环),可独立执行不同路径 | 所有通道必须统一执行,分支困难 |
| 硬件实现 | 硬件调度器动态管理线程掩码(Mask) | 编译器将数据打包为向量 |
线程束发散(Warp Divergence)
尽管SIMT支持分支,但存在显著性能约束。当Warp内32个线程遇到条件分支(如if (threadId % 2 == 0))时,部分线程满足条件(活跃),部分不满足(非活跃)。
SM无法让活跃和非活跃线程同时执行不同指令。它只能先执行活跃线程路径,通过掩码(Mask)屏蔽非活跃线程;然后切换执行另一路径,屏蔽上一批活跃线程。
若同一Warp内分支分歧严重,两条路径串行执行,性能损失接近一半(甚至更多)。因此,优化SIMT程序的关键在于尽可能避免同一Warp内的分支分化。
SIMT模型是GPU高吞吐量的底层逻辑,它将硬件上SIMD式的密集计算封装为SPMD式的编程灵活性,使开发者能写出类似CPU的多线程代码,而硬件通过Warp调度、掩码和收敛机制,自动将线程级并行映射为高吞吐量的计算流。这正是A100的SM能高效协同调度CUDA核心与Tensor Core的指令执行基础。
3.3 GPU的内存模型
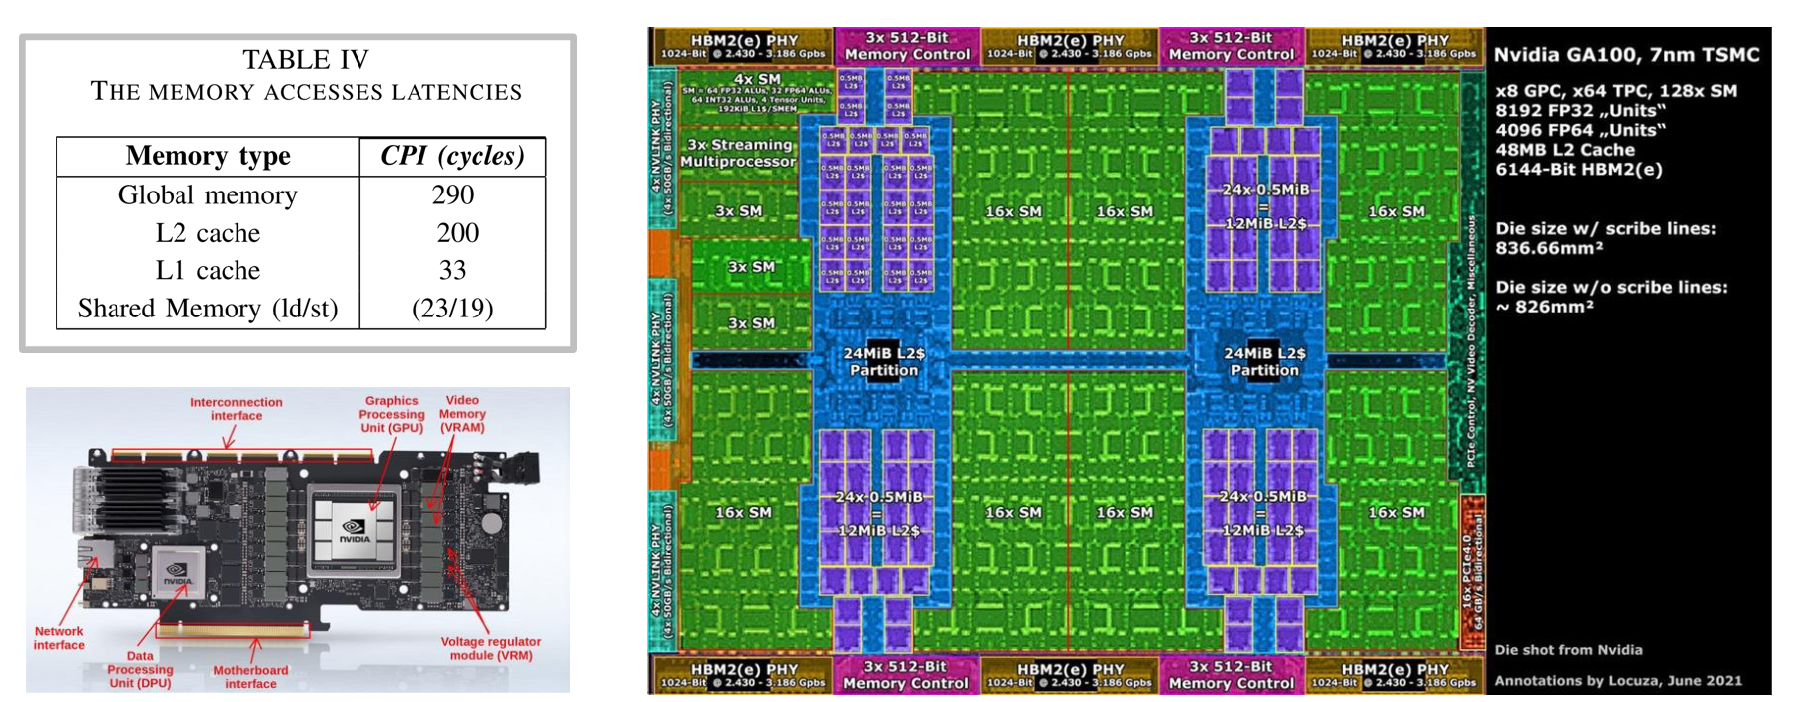
图 8. GPU 的内存层次模型
内存距离SM越近,访问速度越快。因此存在极高速的内存类型(如L1缓存和共享内存),它们位于SM内部,具有极快的读写速度。寄存器文件位于 SM 内部,保存线程私有的变量和计算结果。
如图所示,这些绿色区域是SM集群,而蓝色区域代表紧邻SM的L2缓存,它们虽然不在SM内部,但物理位置仍然很近,速度也相当快(虽然比L1慢一个数量级)。在芯片外部(以这张3090或PCIeA100为例),GPU芯片旁边实际安装了DRAM内存,这意味着数据需要实际离开芯片通过物理连接进行传输。你可以在这张芯片图上看到边缘的这些黄色连接器。这些是HBM连接器,它们连接到实际GPU外部的DRAM芯片。
你可以从上图左侧看到访问这些存储所需的速度,SM内部存储器的访问速度要快很多,大约只需20个时钟周期就能从中获取数据,而访问L2缓存或全局内存则需要200到300个时钟周期。这个差距会对性能造成严重影响。如果某段计算需要访问全局内存,可能意味着你的SM会无工作可做,矩阵乘法全都完成了,任务耗尽,只能空转。这样利用率就不会高。这在某种程度上将成为思考内存架构的核心主题,也是理解GPU工作原理的关键。
首先是寄存器,这是速度极快的存储单元,用于保存单个数值型数据。本地内存、有共享内存、还有全局内存、他们在内存层次结构中逐级递增,速度也越来越慢。
代码可以写入全局内存,也可以写入常量内存(虽然这个不常用)。每个线程都能访问自己的寄存器和共享内存,但跨线程块的信息需要写入全局内存。这意味着当编写执行任务的线程时,理想情况下它们应该操作相同的小批量数据,这样就不用跨线程。我们可以将这小批量数据加载到共享内存中,所有线程都能高效访问共享内存,执行完毕后任务就完成了。这是最理想的执行模式。反之,如果线程需要到处访问数据,就必须访问全局内存,速度会非常非常慢。
3.3.1 第一层:全局内存(Global Memory)
| 特性 | 参数 说明 |
|---|---|
| 物理位置 | GPU芯片外的HBM2e显存堆栈,80GB版为HBM2e |
| 容量 | A100: 80GB |
| 带宽 | ~2T/s (A100 80GB PCIe,HBM2e); |
| 延迟 | 290周期,不同基准测试不同,有多个不同值,这里采信的是斯坦福大学cs336中的数据 |
| 编程控制 | 手动管理 (cudaMalloc) |
| 可见性 | 所有线程可访问 |
全局内存可以存放模型的所有权重、激活值、梯度;训练数据、中间结果、最终输出,将数据持久化;我们通过PCIe从主机内存拷贝数据,是CPU-GPU传输通道。
全局内存提供海量容量(80GB),能容纳大模型的巨大显存;成本相对低(HBM2e虽贵,但比SRAM便宜100倍)是GPU存储的基础。
3.3.2 第二层:L2缓存(二级缓存)
| 特性 | 参数 说明 |
|---|---|
| 物理位置 | GPU芯片内,所有SM共享 |
| 容量 | 40MB (A100) |
| 带宽 | NVIDIA官方指出,A100的40MB L2缓存通过新的架构设计,提供了相比Vello V100高达2.3倍的读取带宽。虽然没有官方公布的精确数值,但业界普遍根据测试和推算,认为其带宽约为 5 TB/s |
| 延迟 | 200周期 |
| 编程控制 | 自动管理 (硬件控制) |
| 可见性 | 所有SM所有线程 |
L2缓存能够为全局数据加速,自动缓存全局内存的热点数据(如频繁访问的模型权重);是数据共享枢纽,SM之间通过L2缓存交换数据;能数据一致性保证,所有SM看到的L2数据一致。
L2缓存还能缓解内存墙瓶颈,这是L2缓存最根本的作用。L2缓存通过缓存频繁访问的数据(如模型权重),避免每次都访问速度慢的显存(HBM),这可以显著降低延迟、提升有效带宽。
并且在NVIDIA架构中,所有GPU单元(包括所有SM)与显存(HBM)之间的数据通信都必须经过L2缓存。可以说,L2是整个GPU的数据总枢纽。与每个SM私有的L1缓存不同,L2缓存是整个GPU所有SM共享的。这意味着不同SM上的线程可以高效地共享数据,实现跨SM的数据通讯
3.3.3 第三层:L1缓存 / 共享内存(Shared Memory)
| 特性 | 参数 说明 |
|---|---|
| 物理位置 | 每个SM内部 |
| 容量 | L1 缓存与共享内存合计192KB/SM,其中共享内存最多可配置164KB/SM |
| 延迟 | 图 8 的测试数据:L1 缓存33周期,共享内存读/写23/19周期 |
| 编程控制 | L1 缓存由硬件自动管理;共享内存由程序显式使用(__shared__) |
| 可见性 | L1 缓存服务本 SM 上的线程;每个 Block 的共享内存供该 Block 内的线程访问 |
L1 缓存由硬件自动管理,缓存线程访问的数据。共享内存由程序显式使用,供同一线程块内的线程交换数据,例如复用矩阵乘法的分块(Tiling)数据。
L1 缓存命中和共享内存中的数据复用,都能减少对下一级内存的访问。
3.3.4 第四层:寄存器文件(Register File)
| 特性 | 参数 说明 |
|---|---|
| 物理位置 | SM内,每个CUDA核心旁 |
| 容量 | 256KB/SM (A100) |
| 编程控制 | 完全自动 (编译器分配) |
| 可见性 | 线程私有 |
寄存器文件能做到零延迟计算,它存储线程的局部变量、临时结果。并且做到极致并行,每个线程255个寄存器,支持深度流水线。
寄存器文件的特点是速度快,但是昂贵,因为寄存器文件的容量少。他的容量限制决定并行度,寄存器用量越少,SM能驻留的Warp越多。
3.3.5 GPU内的内存分这么多层的原因
在物理世界中,速度的上限就是光速,电信号在导线中传播需要时间,物理距离越短,传输延迟自然越低。片上(On-Chip)通信的延迟远低于片外(Off-Chip)通信。
而越靠近GPU的计算核心的内存,速度越快,但是容量很少,这是由于芯片的空间限制。越远离GPU核心,内存容量就越大,但是速度就越低。
并且刚访问的数据很可能再次访问(如循环中的权重),这样放在全局内存的开销就很大。除此之外还有空间局部性,相邻数据很可能一起访问(如矩阵的同行元素)
GPU的解决方案是划分层级:L2缓存利用时间局部性,缓存重复访问的权重;共享内存利用空间局部性,手动加载分块(Tiling)数据;Warp利用常量内存的广播特性,1次读取服务32线程。
3.3.6 GPU内存和CPU内存的本质区别
下面这个表格就说明了GPU和CPU的区别:
| 特性 | GPU (A100) | CPU (Xeon) |
|---|---|---|
| 主存带宽 | 2 TB/s | Xeon6可达数百GB/s |
| 缓存控制 | 共享内存手动控制 | 缓存完全自动 |
| 线程寄存器 | 255个/线程 | x86-64架构通用寄存器 16个/线程 (x86) |
| 延迟容忍 | 通过Warp切换隐藏延迟 | 降低延迟至上 |
| 内存模型 | 共享内存显式同步 | 缓存一致性协议 |
CPU和GPU的本质区别是GPU内存系统是为吞吐量优化,容忍高延迟;CPU内存系统是为延迟优化,降低延迟。这导致GPU需要更多层级和手动控制。
4 LLM 推理在 GPU 上的执行流程
LLM在GPU上的推理,其核心是自回归地逐个生成token,整个过程可清晰地分为 预处理 、Prefill(预填充) 和Decode(解码) 三个阶段。这与之前学习的GPU执行模型紧密相关,且每个阶段对GPU资源的需求截然不同。
4.1 为什么 LLM 推理离不开 GPU
在拆解推理流程之前,我们先回答一个根本问题:为什么大模型推理几乎必须依赖 GPU?答案要回到前两章讲过的 GPU 架构与执行模型。
1. 推理的本质是海量矩阵运算。 Transformer 的每一层都由大规模的矩阵乘法(GEMM/GEMV)构成,注意力的 Q×Kᵀ、注意力加权求和、以及各层的线性投影和 FFN,本质都是大量简单的乘加运算。这正是 GPU 数千个 CUDA 核心和专用 Tensor Core 最擅长的工作,而 CPU 只有几十个重逻辑核心,串行处理这种规模的运算会慢上几个数量级。
2. 大模型需要极高的显存带宽。 一个 70B 模型的 FP16 权重约 140GB,每生成一个 token 都要把相关权重从显存搬运到计算单元。GPU 的 HBM 显存带宽可达约 2TB/s,是远大于CPU 主存。推理速度在很大程度上由每秒能搬多少字节权重决定,这一点 CPU 内存系统根本无法满足。
3. GPU 用吞吐量掩盖延迟的设计恰好契合推理。 推理时成百上千个 token、多个请求可以并行处理,GPU 通过 Warp 切换在等待访存时立刻调度其他就绪线程,把内存延迟通过调度消弭,使昂贵的计算单元和显存带宽持续满载。CPU 追求单任务低延迟,面对这种大批量同质任务反而无法发挥。
4. 软件生态的成熟。 CUDA、cuDNN 以及 PyTorch/TensorFlow 等框架,加上 FlashAttention、PagedAttention 等针对 GPU 内存层次深度优化的算子,使 GPU 成为 LLM 训练与推理事实上的标准平台。
LLM 推理是典型的计算密集 + 访存密集任务,而 GPU 正是为大规模并行计算和高带宽访存而生的硬件,两者高度契合,这就是推理离不开 GPU 的根本原因。
4.2 GPU执行推理的过程
输入的所有token会作为一个巨大的矩阵被并行处理。矩阵乘法(GEMM)等运算占主导,算术强度极高,能有效利用GPU的Tensor Core。
4.2.1 CPU工作:
模型加载时,权重被传入 GPU 显存。请求进入后,CPU 完成分词,准备 token IDs 等输入。
CPU通过内核启动指令通知GPU开始执行计算。这个指令会定义GPU上需要启动的线程网格和线程块的规模。
4.2.2 数据传输
CPU 将 token IDs 等输入通过 A100 的 PCIe 4.0 x16 接口传入 GPU。
GPU 执行嵌入和线性投影,生成 Q、K、V,再完成注意力和前馈网络计算。中间结果在 GPU 上继续参与后续运算,最终生成输出 token。
4.2.3 GPU 并行计算矩阵乘法
这是GPU发挥其并行计算能力的核心环节。
任务分解:GPU的线程调度器会将巨大的矩阵乘法任务(如
Q×K^T)分解成大量更小的、可以并行执行的任务块。分块(Tiling):将输出矩阵C划分为多个块(Tiles),每个块的计算任务分配给一个线程块(Block)。
细粒度分配:在一个线程块内,进一步将任务分配给更小的线程束(Warp),最终每个线程(Thread) 负责计算结果矩阵中的一个或几个元素。
当一个流式多处理器 收到分配给它的任务块后,其内部会发生以下精细的数据流动和计算:
- 加载到共享内存:SM首先将计算所需的数据块从全局内存(HBM) 加载到速度更快的共享内存 中。这样能显著减少对慢速全局内存的重复访问。
- 分配到寄存器:接着,线程 会从共享内存中读取它负责计算的那部分数据,并存入速度最快的寄存器 中。
- 核心计算:最后,CUDA核心或者Tensor Core对寄存器中的数据进行乘加运算。
- 写回结果:计算完成后,结果数据会从寄存器按原路经共享内存,最终写回全局内存。
此过程参考密歇根大学电子工程与计算机科学系文档
4.3 Prefill 和 Decode阶段
Prefill 和 Decode阶段 在第二章就详细讲过,这里不再赘述,只讲解GPU有关的内容。
Prefill阶段:处理整个用户输入,是批量的矩阵乘法(GEMM),计算密集型,主要依赖Tensor Core,会将所有用户输入一次性全部处理。是大规模并行的,此阶段是计算密集型,因为此阶段涉及大量的矩阵乘法(GEMM),能充分利用GPU的Tensor Core,在这个阶段,GPU算力是瓶颈,因此被称为计算密集型 任务。。
Decode(解码)阶段:逐token生成输出,是矩阵-向量乘法(GEMV),访存密集型,主要瓶颈在于从HBM搬运模型权重和KV Cache。它是严格串行的,在生成第一个Token后,模型进入Decode阶段。它的任务是自回归地,根据之前生成的所有Token和KV Cache,预测下一个Token。此阶段每次只处理一个新token的向量。主要的运算是矩阵-向量乘法,计算量远小于Prefill阶段。此时,从显存(HBM)中读取整个模型的权重和庞大的KV Cache成为了性能瓶颈。GPU的计算单元常常因等待数据而空闲。
4.4 总结
| 阶段 | 核心任务 | 计算类型 | GPU瓶颈 | 关键优化 |
|---|---|---|---|---|
| Prefill | 处理输入prompt | 计算密集型 | Tensor Core算力 | 最大化并行度,利用好矩阵乘法 |
| Decode | 逐token生成 | 内存密集型 | 显存带宽 (HBM) | KV Cache、量化、Continuous Batching |
5 总结与测试题
5.1 课程总结
本节课围绕 GPU 硬件架构 与 大语言模型推理在 GPU 上的执行流程 两大主线展开,核心内容可归纳为:
5.1.1 GPU 的诞生与设计哲学:
GPU 从图形处理器演进为 AI 加速器,其本质是以大量简单计算单元(CUDA 核心) 和极少控制逻辑换取极高的数据吞吐量,与 CPU 的“低延迟、复杂逻辑”设计目标形成鲜明对比。
5.1.2 A100 GPU 的层次化架构:
从芯片全局(GPC → TPC → SM)到 SM 内部(CUDA 核心、Tensor Core、共享内存、寄存器文件),理解每个层级的作用和数据流动路径。其中 SM 是执行的基本原子单元,Tensor Core 是加速矩阵乘法的专用电路。
5.1.3 GPU 执行模型:
以 SIMT(单指令多线程) 为核心,线程以 Warp(32 线程) 为调度单元,Block 映射到 SM,Thread 执行具体运算。关键概念包括 Warp Divergence(分支发散)、内存合并访问、Warp 切换隐藏延迟。
5.1.4 GPU 内存层次与瓶颈:
全局内存(HBM)带宽~2TB/s 但延迟高,L2 缓存(40MB)次之,每个 SM 的 L1 缓存与共享内存合计192KB,其中共享内存最多可配置164KB;寄存器文件为256KB/SM,保存线程私有数据。内存带宽增长远落后于算力增长,这构成了“内存墙”,也是 LLM 推理的主要瓶颈。
5.1.5 LLM 推理的两阶段:
Prefill(预填充):处理输入提示,批量矩阵乘法(GEMM),计算密集型,Tensor Core 满载。 Decode(解码):逐 token 生成,矩阵-向量乘法(GEMV),内存密集型,HBM 带宽是瓶颈。
5.2 测试题
LLM 推理的几个阶段分别是什么,各自有什么特点,为什么GPU成为LLM推理的主要工具?
请简述 CPU 与 GPU 在架构设计上的本质区别,并说明为何 GPU 适合深度学习中的矩阵运算。
描述 LLM 推理的 Prefill 和 Decode 两个阶段在计算类型、瓶颈资源以及典型优化手段上的不同。