第 4 章 KV Cache 优化
在上一章中,我们把自回归生成拆成了 Prefill 与 Decode 两个阶段,并看到模型会逐 token 生成文本。本章进一步解释推理系统最基础也最关键的一项优化:KV Cache。它通过保存历史 token 在每层注意力中的 Key 和 Value,避免 Decode 阶段反复计算已经得到的结果,使长序列生成成为可能。
本章先从没有 KV Cache 时的重复计算出发,再说明缓存的对象、读写方式与复杂度收益。
1 本章学习目标
完成本章学习后,你将能够:
解释无 KV Cache 时重复计算的根源:从自回归生成的循环过程出发,说明为什么每一步都需要把完整历史重新送入模型,以及历史 token 的 K/V 为什么会被反复投影和重新参与注意力计算。
描述 KV Cache 的核心思想与缓存对象:说清楚 KV Cache 缓存的是每一层 self-attention 中历史 token 经过 K/V 线性投影后得到的张量,而不是 Query、attention 矩阵、logits 或完整 hidden state。
推导 KV Cache 的复杂度收益:分别从 K/V 投影和注意力矩阵两个口径出发,推导无 Cache 时的
与 ,以及有 Cache 后 K/V 投影降到 、单步注意力从 降到 的过程。 区分 Prefill 与 Decode 两个阶段:说明 Prefill 阶段如何一次性计算并写入 prompt 的全部 K/V,Decode 阶段如何每步只计算一个新 token 的 K/V 并追加到缓存。
2 没有 KV Cache 的 重复计算
在自回归语言模型的生成过程中,模型每次只预测下一个 token,然后把新生成的 token 拼接到输入序列末尾,再预测下一个,如此反复。这个过程中,如果没有 KV Cache,模型会不记得上一步计算过什么,每一次预测都必须把迄今为止的完整历史重新送进网络,从头算一遍。
这意味着,生成第 1 个 token 时,模型处理的是整个 prompt;生成第 2 个 token 时,模型处理的是 prompt 加上第 1 个生成结果;生成第 3 个 token 时,输入又长了一截。每一步的输入都在变长,而模型对其中每一个历史 token 都要重新做投影、重新算注意力。这种重复计算,正是无 KV Cache 时效率低下的根源。
2.1 无 KV Cache 的生成循环
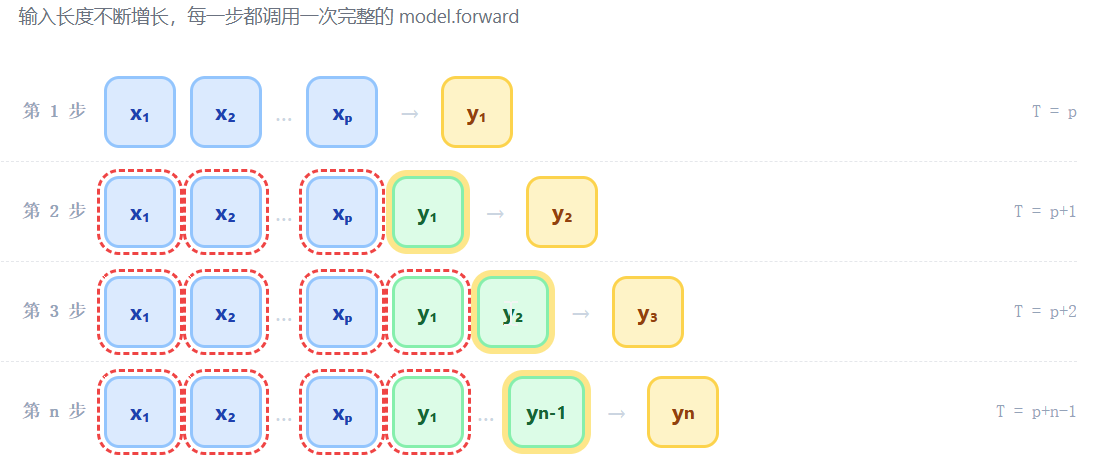
图 1. 无 KV Cache 的生成循环
假设 prompt 是
第一步,把整个 prompt 送入模型,得到第一个新 token
第二步,把 prompt 和
第三步,把 prompt、
模型返回所有位置的 logits,但我们只关心最后一个位置,因为只有它才代表 下一个 token 的预测。取出最后一个位置的 logits,采样或取 argmax,得到新 token,然后把它拼到序列末尾,进入下一轮。
此时输入是整个历史序列,而不是只输入新 token。模型会对所有 token 做前向计算,尽管我们只需要最后一个位置的输出。前面的历史 token 被一遍又一遍地重新计算,它们的 Key 和 Value 明明没有变化,却因为没有被保存下来,每次都要重新算一遍。
2.2 计算浪费在哪里:历史 K/V 被反复投影
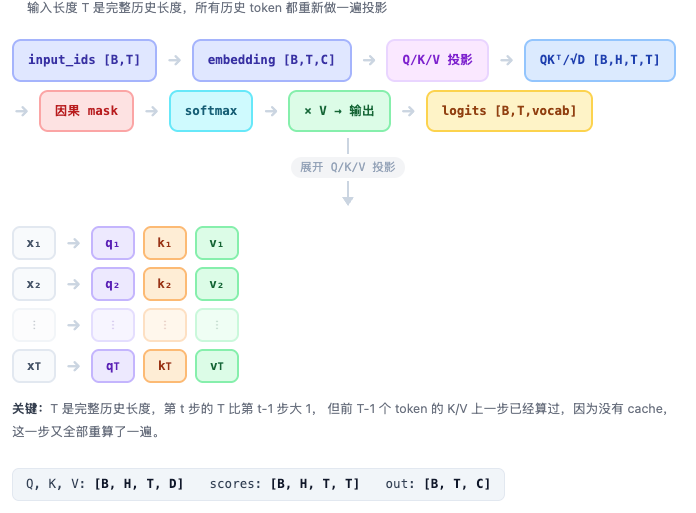
图 2. 历史 K/V 的重复投影
为了看清计算浪费发生在哪里,我们先来看单步内部的计算。假设第
在注意力层里,模型首先对所有
接着计算注意力分数:Query 与 Key 的转置相乘,再除以
整个过程中,
2.3 一个小例子:从 [x₁, x₂] 到 [x₁, x₂, y₁, y₂]
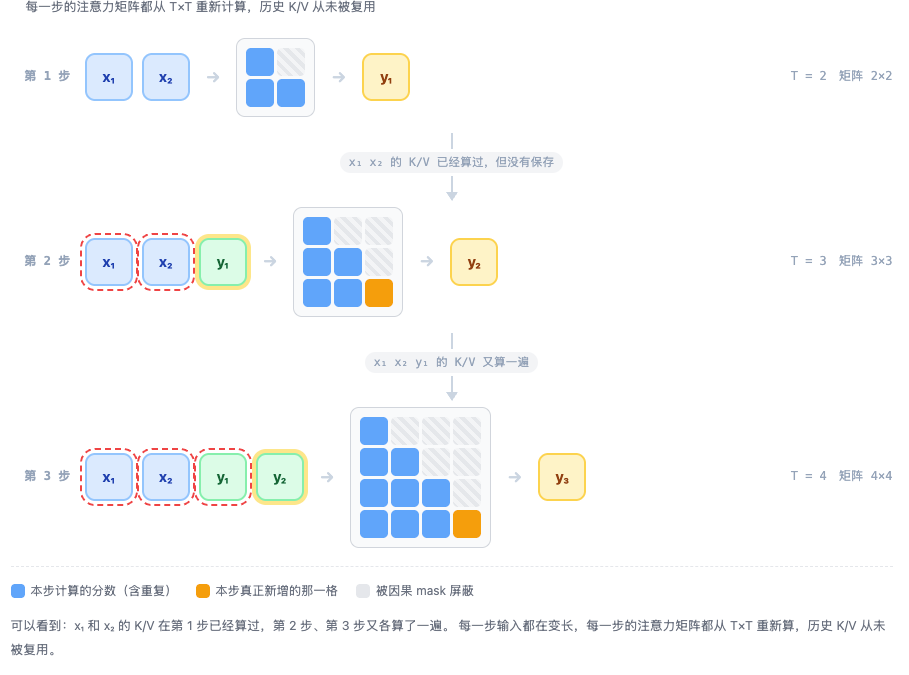
图 3. 无 KV Cache 的生成示例
假设 prompt 只有两个 token:
第一步,输入是
第二步,输入变成
第三步,输入变成
可以看到,
2.4 重复量级:O(n²) 还是 O(n³)?
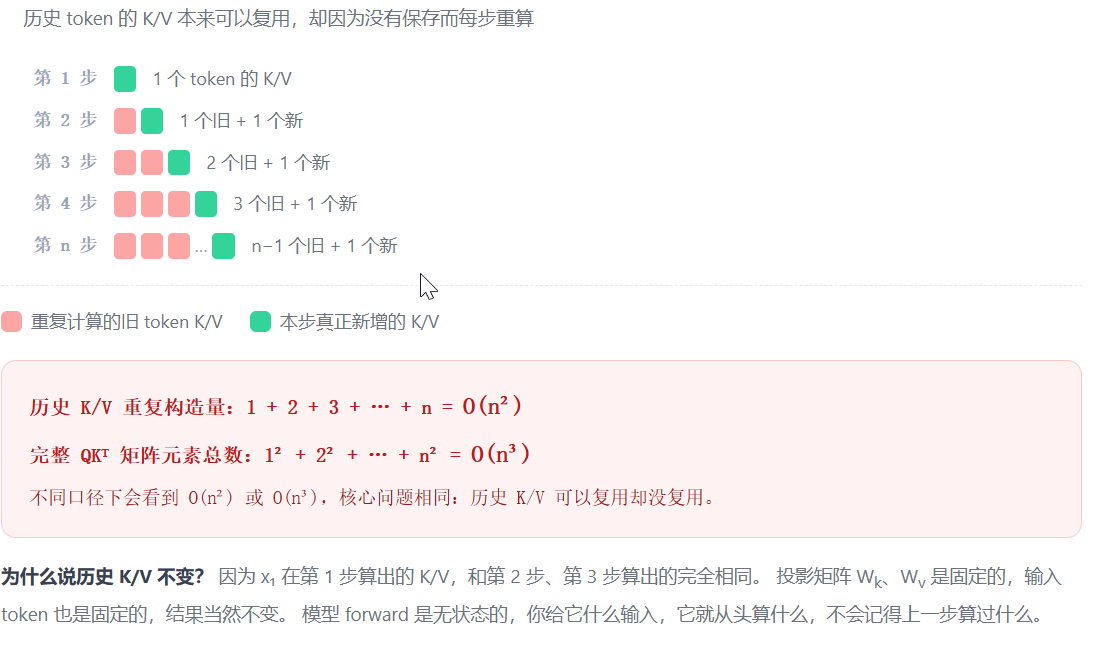
图 4. 重复计算的复杂度
这种重复计算的量是可以量化的。如果只看历史 token 的
这就是很多人说无 KV Cache 是
如果看每一步完整的
所以不同口径下会看到
但无论哪种口径,核心问题都是一样的:历史 token 的
3 KV Cache 到底缓存了什么
本章节的具体内容可以在part 1 第四章 找到详细介绍。
KV Cache 缓存的是在自回归生成过程中每一层 self-attention 里所有历史 token 经过 Key/Value 线性投影后得到的
3.1 常见误解
KV Cache 不是缓存整个序列的 hidden state。它缓存的是每一层注意力内部的 Key 和 Value 投影结果。
KV Cache 不是所有层共享一份。每一层都有自己的 K/V cache。
KV Cache 不是缓存 attention 矩阵。注意力权重是每一步临时算出来的,不会被保存。
KV Cache 不是缓存 logits。logits 只在最后一层产生,并且只用于当前步采样。
KV Cache 不是只缓存最后一层。恰恰相反,每一层 self-attention 都需要自己的 K/V cache。
如果使用 RoPE,Key 通常是在应用旋转位置编码之后被缓存;Query 在当前步应用旋转后使用。Value 一般不做位置旋转。
KV Cache 的本质,是把历史 token 在各层注意力中的 Key 和 Value保存下来,避免每一步重新计算完整历史。这样,模型 forward 虽然仍然是无状态的,但推理系统可以通过外部缓存,把历史计算结果的复用起来。
没有 KV Cache 时,第
4 KV Cache 从 O(n²) 到 O(n)
这一节只关注序列长度带来的复杂度变化。为简化,忽略层数
设 prompt 长度为
为突出主要矛盾,下面假设
4.1 无 KV Cache:历史 K/V 每步重算
没有 KV Cache 时,第
只看 K/V 投影,第
生成
这就是无 KV Cache 是
如果再看注意力分数矩阵,第
累计到
所以从完整注意力矩阵的角度看,无 KV Cache 的总量级是
4.2 有 KV Cache:历史 K/V 只算一次
有 KV Cache 后,生成分为两个阶段。
Prefill 阶段,prompt 一次性送入模型,计算所有 prompt token 的 K/V 并写入缓存。之后进入 Decode 阶段,每一步只输入一个新 token。
第
生成
于是,K/V 投影这部分从无 Cache 的
再看注意力。当前 token 只需要用自己的 Query 去查询历史 Key 缓存,历史长度为
累计
单步注意力则从无 Cache 的
降为
4.3 复杂度对比
| 口径 | 无 KV Cache | 有 KV Cache |
|---|---|---|
| 单步 K/V 投影 | ||
| 单步注意力 | ||
| 缓存显存 |
如果考虑隐藏维度
4.4 从 O(n²) 到 O(n)
这里说的从
这是 KV Cache 最直接的收益。
但要强调,注意力本身仍要与历史交互。当前 token 必须查询所有历史 Key,所以单步是
因此,降到
4.5 包含 Prefill 的总复杂度
若把 prompt 也计入,有 KV Cache 的完整生成过程大致是:
- Prefill:注意力
,K/V 投影与缓存 ; - Decode:注意力
,K/V 投影 。
总注意力约为
总 K/V 投影约为
无 KV Cache 时,总注意力约为
总 K/V 投影约为
所以,KV Cache 的核心复杂度收益可以概括为:
而 decode 逐 token 查询历史所带来的累计注意力成本,仍然是
5 总结与测试题
5.1 课程总结
本章围绕 KV Cache 如何消除自回归生成中的重复计算,建立了以下关键认识:
- 无 Cache 的问题:每生成一个 token,模型都会重新处理完整历史,历史 token 的 K/V 投影累计为
,完整注意力矩阵的累计计算则为 。 - 缓存的对象:KV Cache 按层保存历史 token 经 Key、Value 投影后的结果;Query 只服务于当前步骤,历史 Query 不会被后续 token 使用,因此无需缓存。
- Prefill 与 Decode:Prefill 一次性计算 prompt 的全部 K/V 并写入缓存;Decode 每步只计算新 token 的 K/V、追加到缓存,并用当前 Query 查询历史 K/V。
- 复杂度收益与代价:K/V 投影的累计复杂度从
降到 ,单步注意力从 降到 ;代价是 KV Cache 的显存占用随层数、批大小和序列长度线性增长。
5.2 测试题
- 为什么没有 KV Cache 时,历史 token 的 Key 和 Value 会在每个 decode 步被重复计算?
- KV Cache 为什么只缓存 Key 和 Value,而不缓存 Query、attention 矩阵或 logits?
- 请比较 Prefill 与 Decode 阶段对 KV Cache 的读写方式,以及它们各自的计算特点。
- "KV Cache 将复杂度从
降到 "具体指的是哪部分计算?为什么完整 Decode 过程的累计注意力复杂度仍为 ?