第 8 章 RadixAttention 与前缀缓存
在上一部分中,我们介绍了通过分页高效管理 KV Cache 内存分配、减少碎片的方法。本章进一步聚焦 LLM 在线推理中的实际问题:不同请求之间的 KV Cache 能否跨请求共享复用,以进一步降低显存开销?答案是肯定的,这可通过前缀缓存(Prefix Cache)实现——对具有共同前缀的请求直接复用已计算的 KV 状态。而 RadixAttention 则更进一步,使用 Radix Tree 将 KV Cache 的物理块映射、高效前缀匹配、与调度器的协同以及 LRU 淘汰策略有机整合,形成一套自动化、token粒度的共享机制。
1 本章学习目标
这一章从传统 KV Cache 管理所遗留的问题出发,到 Prefix Cache 的出现,进一步探讨这个方法如何支撑 LLM 推理过程中的 KV Cache 高效管理。读完本章后,我们应该能清楚以下问题:
- 传统管理的 KV Cache 在请求结束后会留下哪些问题?
- 为什么可以直接复用的是前缀,而非任意片段?
- 为什么采用路径压缩的 Radix Tree,比逐 token 的普通 Trie 更适合管理共享前缀?
- 最长前缀匹配、插入、分叉与节点分裂的完整流程是什么,以及能否用一个简单例子从头推导出来?
- Radix Tree 节点中保存了什么信息?逻辑 token 序列与 KV Cache Pool 中物理缓存槽位之间是如何对应的?
- 在完整 RadixAttention 缓存管理的生命周期中,match、schedule、lock、evict 与 free 等关键操作分别扮演什么角色、如何衔接变化?
2 从 KV Cache 到 Prefix Cache
在 PartⅠ 的第 4 章中,我们已经介绍过采用 Full Attention 的 LLM 在推理过程中 KV Cache 的生命周期、显存占用,以及传统 KV Cache 管理方案所面临的问题。接下来,我们先对这些内容进行简单回顾。
2.1 传统 KV Cache 的局限
传统 KV Cache 的核心收益:避免在 Decode 阶段对历史 token 的 Key/Value 进行重复计算,从而大幅降低自回归生成时的计算量。
但是在过去许多基础实现里,KV Cache 的生命周期与单个请求严格绑定——请求到达时分配显存,请求结束时全部释放。
这就会带来一个明显问题,可能出现跨请求重复计算的情况:在线 LLM 推理服务中,大量请求往往共享相同的 system prompt、工具描述(例如每个请求都以“你是一个专家”开头)......若每个请求都独立计算一遍完整的 prefill,就会造成大量冗余计算。
为了解决刚才提到的问题,前缀缓存(Prefix Cache)应运而生。其核心思路是改变 KV Cache 的所有权:不再把缓存绑定到单个请求,而是归属到一段可复用的 KV 前缀序列上。请求结束后,对应的 KV 块可以继续保留在共享缓存池中,由淘汰策略决定何时释放。
这就自然出现一个关键问题:为什么只能复用前缀,而不能复用任意位置的片段?
2.2 Prefix Cache 的核心原理
对于每个 token,其生成所依赖的隐藏状态都只能访问该位置及其左侧的序列信息,这一约束由因果注意力机制保证。
训练时,对整段序列做一次前向,必须加因果掩码位置
这里是带因果掩码的单向自注意力。
推理时:
- Prefill 对整段输入 prompt 并行计算,后面的 prompt token 已经在序列里,因此必须加因果掩码。
- Decode 每次只计算当前新 token,未来 token 尚未生成,因果性由先写入历史 KV、再计算当前 token的过程本身保证,通常不必再显式加三角掩码。
从第一层注意力开始,
注:这里在考虑 Prefix Cache 可行性原理的时候,分别考虑了 Prefill、Decode 两个阶段。但是跨请求前缀匹配通常在进入 Prefill 阶段进行,以跳过重复计算;Decode 阶段不再匹配,仅复用已有 KV 以及追加新的 KV。
举例:
- 请求 A
["天气", "很", "好"] - 请求 B
["心情", "很", "好"]
两者虽然具有相同的后缀 ["很", "好"],且“很”、“好”在序列中的位置相同,但 A 中“很”的左侧上下文是“天气”,B 中则是“心情”。由于 Transformer 的隐藏状态会逐层融合左侧上下文信息,因此随着网络层数增加,进一步会使后续层对应的 K、V 不同,那么就无法直接跨请求复用这段后缀的 KV Cache。
即使不考虑位置编码,后续层的隐藏状态也会因左侧上下文不同而产生差异,因此能够直接复用的仍然是完整一致的前缀。加入 RoPE 等位置机制后,Q/K 还会显式依赖 token 的位置,使相同 token 在不同绝对位置时也不能直接复用。
分析完只能复用前缀的原因后,我们先来认识 RadixAttention。至于如何实现跨请求的 KV Cache 复用,将在后面结合 RadixAttention 的部分机制详细展开。
2.3 RadixAttention 与 Attention
RadixAttention 这个名字容易让人误以为其改动了模型内部的注意力计算,但实际公式与计算流程完全不变,它只是一套高效的 KV Cache 管理与调度机制。即 Attention 计算仍使用原有公式,RadixAttention 的核心在于对 KV Cache 的组织与调度:
- KV Cache Pool:在 GPU 上保存真实的 K、V 张量;
- Radix Tree:将 token 序列映射到 Pool 中的物理索引,支持高效的前缀匹配、加入、节点分裂与淘汰;
- Cache-aware scheduler:根据匹配结果安排请求顺序,使最近使用的共享前缀尽量保留在缓存中,从而提升命中率。
因此,RadixAttention 准确的定位是为注意力计算准备并管理可复用 KV 的缓存与调度层。
3 核心数据结构:Radix Tree
RadixAttention 的核心数据结构是 Radix Tree,即其本身只作为存储结构。它将各请求的 token id 序列组织为压缩前缀树,使相同前缀仅对应一份 KV Cache。这个结构在 Scheduler 中支持高效前缀匹配与策略调度,显著提升缓存命中率并降低显存占用。
3.1 Prefix Cache 对数据结构的要求
如果想要实现一个高效的前缀缓存,需要什么样的数据结构?可以从以下几个角度考虑:
- 快速最长前缀匹配:给定新请求的 token id 序列,能迅速找出与已有缓存共享的最长公共前缀,从而定位可直接复用的 KV;
- 高效动态加入与分裂:新序列到来时,能在尽量少改动现有结构的前提下加入新路径。当新序列只匹配某压缩边的一部分时,必须支持就地节点分裂,把公共前缀与后缀分开;
- 前缀共享、后缀独立:公共前缀对应同一份 KV,分叉后的不同后缀各自独立存储与计算,互不干扰;
- 空间紧凑:尽量减少元数据开销,避免为无分叉的长路径创建大量节点;
考虑到上述的需求,就自然会想到用树结构来管理 KV Cache,以实现 Prefix Cache。按 token id 序列组织的树能天然表达前缀共享关系,但具体形态差异很大:
| 结构 | 边标签 | 长单分支路径 | 前缀场景代价 |
|---|---|---|---|
| 普通树 / 自定义树 | 无统一约束 | 取决于具体实现 | 难以直接保证高效最长前缀匹配查询 |
| 逐 token Trie | 1 个 token | 每个 token 一个节点 | 逻辑简单,但节点与指针开销大 |
| Radix Tree | 一段 token | 压缩为一条边 / 一个节点 | 节点少;仅在真正分裂时需要 split |
虽然普通 Trie 天然支持前缀查询,但每条边通常只对应一个 token。LLM 的 prompt 有可能会达数百到数万 token,若逐 token 建节点,会产生大量的对象、指针和遍历开销;而 Radix Tree 将连续无分裂的 token 序列压缩进单条边,只在真正需要分裂的地方创建结构节点,因此更适合 Prefix Cache 的场景。
3.2 基本的组成
一个 Radix Tree 节点的基本组成包括父节点指针、子节点字典、用于从 key Tensor 中提取子节点索引的 key_fn,以及该节点自身的 _key、_value 张量和长度,其中的结构表示为:
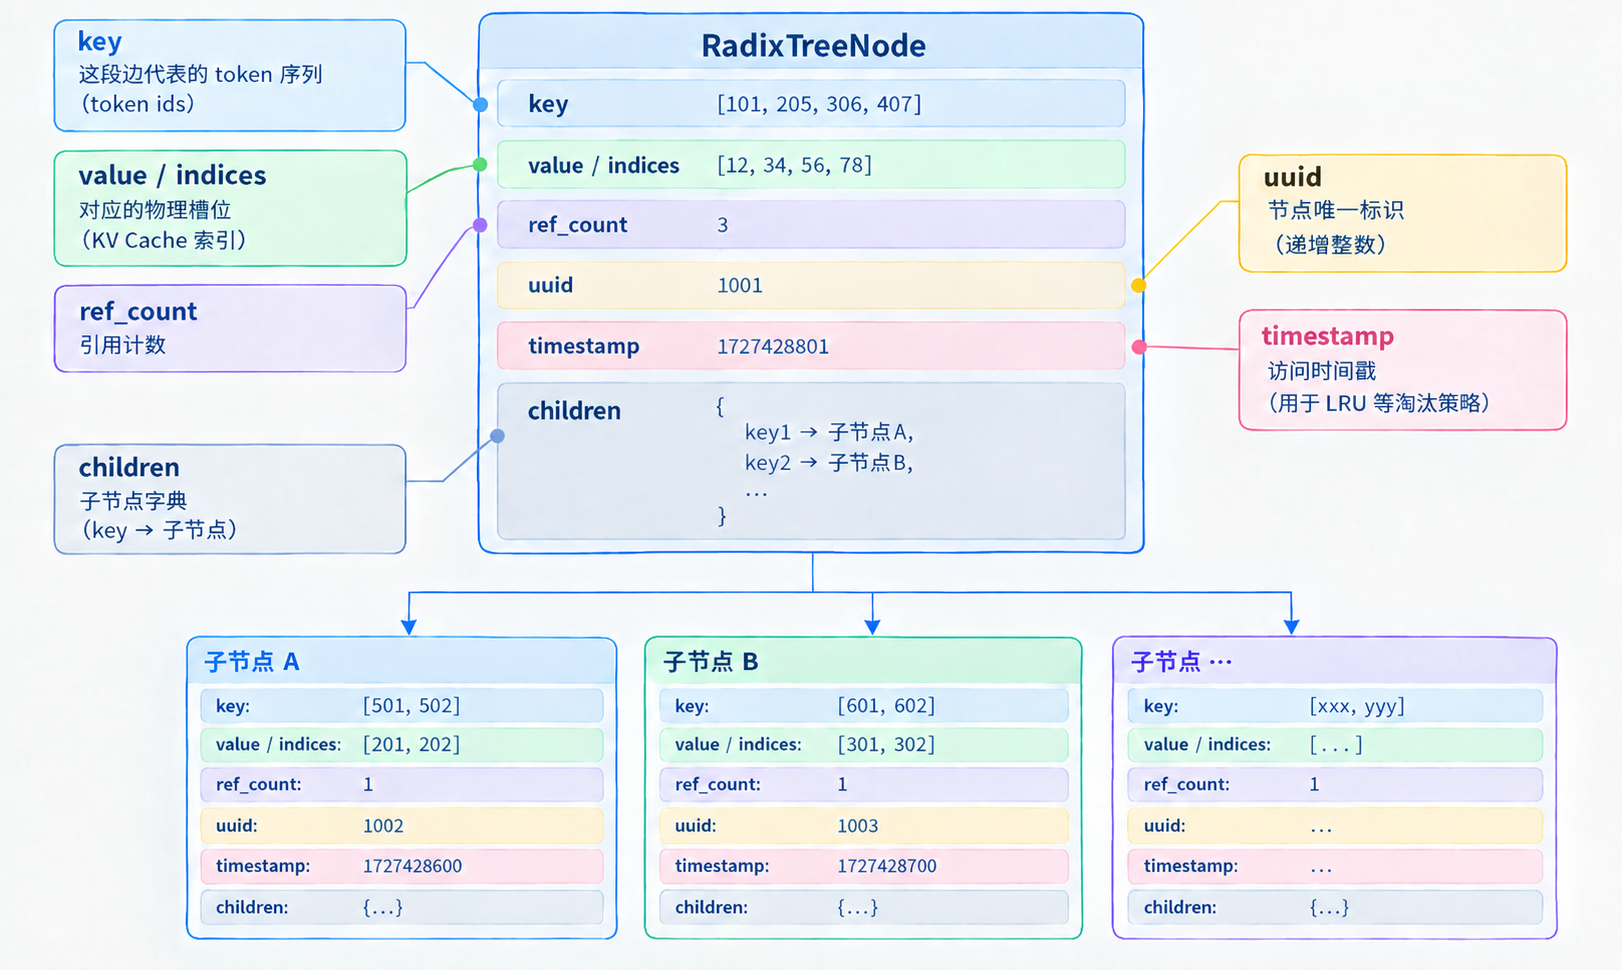
图 1. RadixTreeNode结构示意图
定义表示:
class RadixTreeNode:
    def __init__(self, key_fn: KEY_FN) -> None:
        self._parent = None
        self.children = {}       # 子节点字典
        self.key_fn = key_fn     # 从 key tensor 提取“子节点序列索引”的函数
        self.ref_count = 0       # 引用计数
        self.uuid = counter
        self.timestamp = tic or time.monotonic()  # 节点访问时间戳

        self._key: torch.Tensor
        self._value: torch.Tensor
        self._length: int
需要注意的是:
len(node.key) == len(node.value):每个逻辑 token id 都有对应的物理缓存位置,K/V 一一对应;- 在节点的
__init__中,_key、_value、_length仅做类型注解,不赋实际值,后续通过专门方法赋值,方便在新节点加入或匹配过程中的节点分裂时灵活设置内容; - 根节点为空,不保存任何信息;每个节点则通过简单递增的整数生成唯一的 uuid 来进行区分。
代表的完整 token id 序列是从根到该节点路径上所有 _key 的拼接,对应的物理缓存位置则是同一路径上所有 _value 的拼接。
除了节点本身的基础字段外,还有一些方法用于管理树结构(参考 mini-sglang ):
| 方法 | 作用 |
|---|---|
| set_key_value | 设置节点的 key 和 value |
| set_parent | 设置节点的父节点 |
| length / parent / value | 获取节点长度、父节点、value |
| is_root / is_leaf | 判断是否为根节点或叶节点 |
| get_match_len | 获取与输入的最长公共前缀长度 |
| split_at | 在指定位置进行分裂 |
那么这些组成部分如何共同参与 Prefix Cache 对 KV Cache 的优化管理?
3.3 新节点加入、最长前缀匹配与分裂
当新请求到达时,系统将当前请求的 token id 序列与已有历史 KV Cache 对应的 token id 序列进行最长公共前缀匹配,并根据匹配结果决定后续操作:
- 继续向后匹配:如果新请求的 token id 序列与当前节点的 token id 序列在某一段完全一致,则沿着这条公共前缀路径继续向下匹配,尽可能复用已有的 KV Cache。
- 分裂:如果在匹配过程中出现 token id 不一致,且匹配长度满足 0 < match_len < node.length ,则需要在第一个不相同的位置对当前节点进行分裂。分裂后,公共前缀部分继续共享,分歧后的部分各自独立存储。
在缓存仍然驻留且上下文配置兼容的情况下,每个节点对应的 token id 序列只需计算一次;若对应缓存节点被淘汰,后续请求再次命中该前缀时仍需重新计算。
为更直观地理解 Radix Tree 的构建过程,先把 Prompt 通过 tokenizer 转成 token id 序列。假设有 3 个请求,按 A → B → C 的顺序依次加入:
- 请求 A:“你好,世界!” --tokenizer-->
[101, 11, 12, 21, 22] - 请求 B:“你好,川西~” --tokenizer-->
[101, 11, 12, 31, 32] - 请求 C:“你怎么样?” --tokenizer-->
[101, 11, 99]
假设先处理请求 A,且本例中每个 token id 对应一个物理槽位:
经过线性投影处理得到的 KV 被写入物理槽位[p0, p1, p2, p3, p4]及对应的 value 。树为空,所以这里只有一个压缩节点:
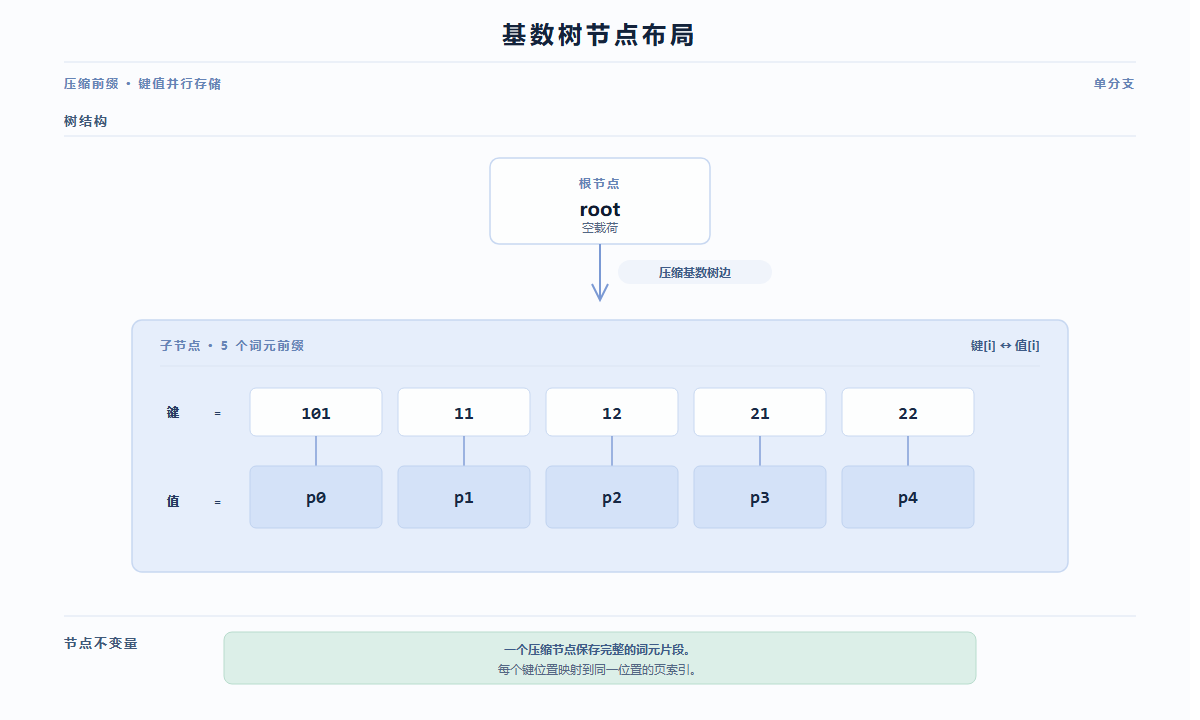
图 2. Radix Tree初始化构建
第二个处理的请求 B 为
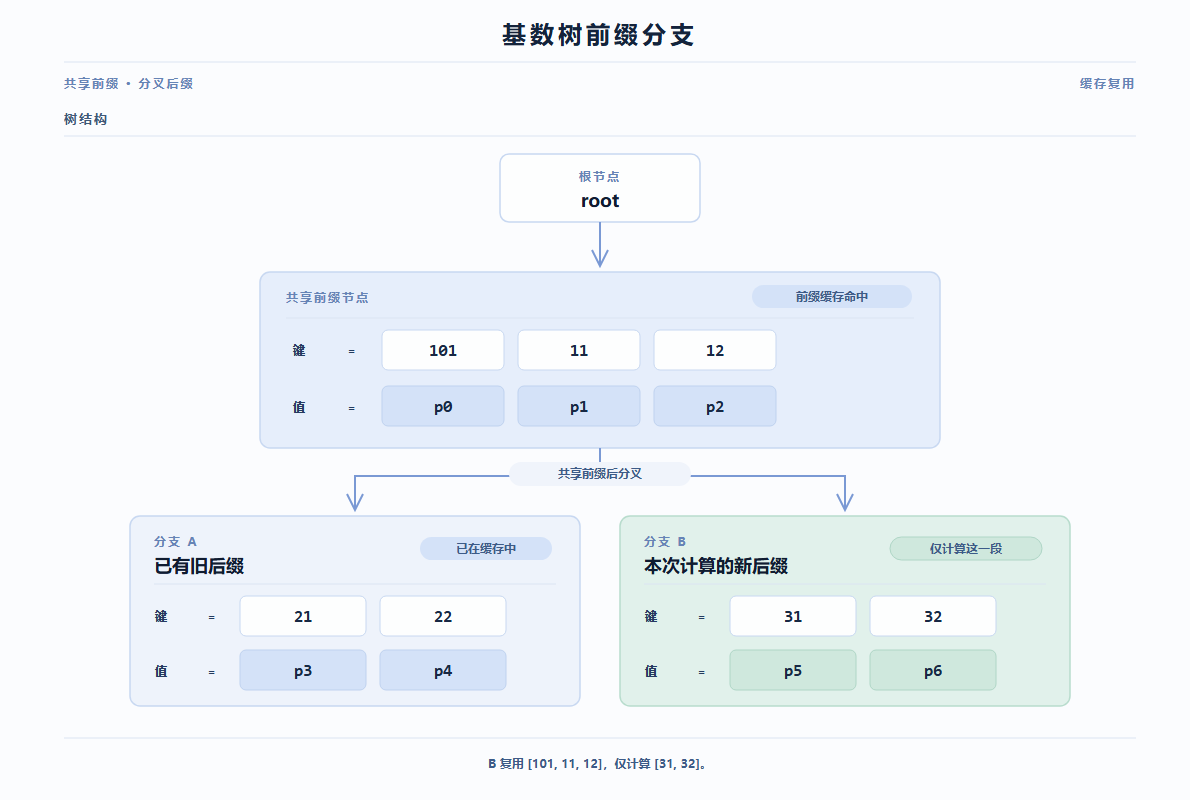
图 3. Radix Tree节点分裂
注:分裂只重组树的元数据。共享前缀仍指向原来的物理槽位 [p0, p1, p2],不需要再复制一次共享前缀部分。
第三个请求 C 为
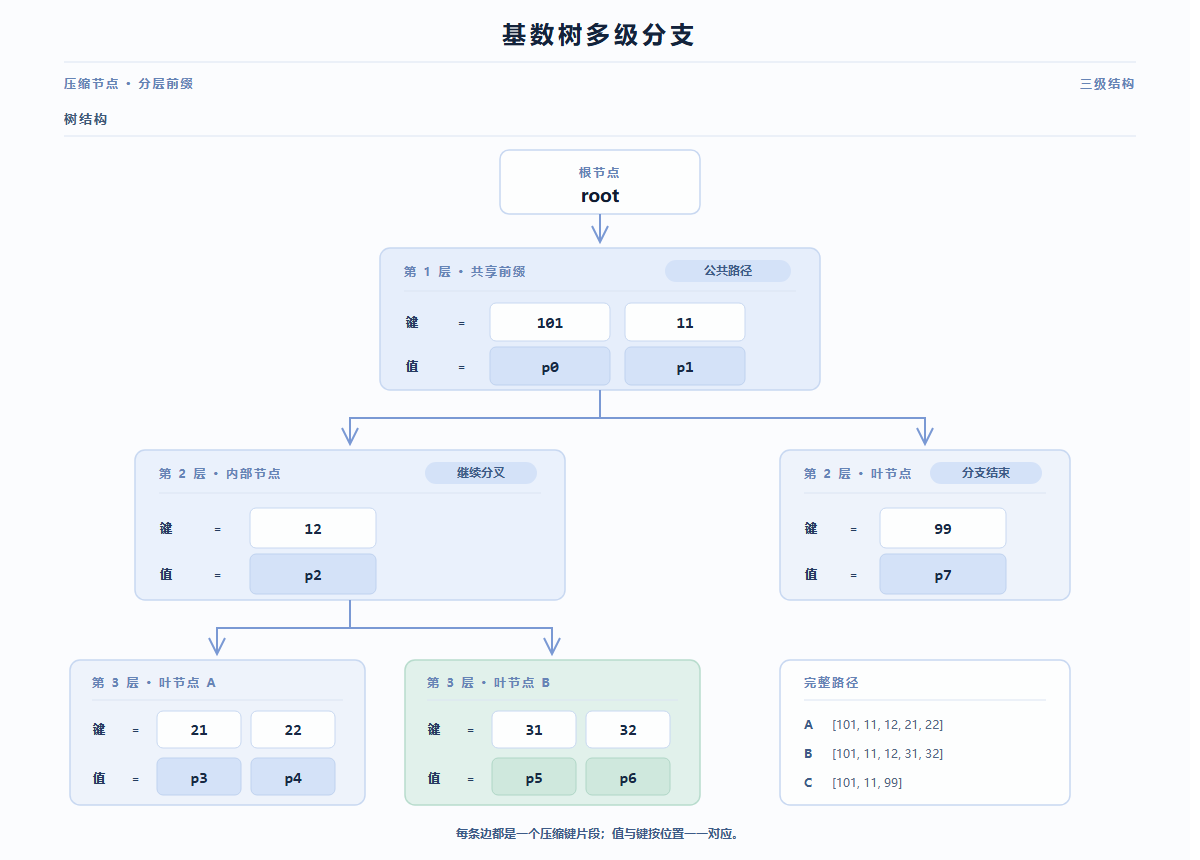
图 4. Radix Tree多级分支
至此,所有的关键操作都出现了:
- 新节点加入:请求都需要添加新的节点和物理槽位,第一个处理的请求会直接添加到根节点后面,而后续处理的节点会先与之前已有节点的 token id 序列进行最长前缀匹配。
- 最长前缀匹配:请求 A、B、C 共享最长前缀
[101,11],那么对应部分的 KV Cache 可以直接复用,不需要重新计算; - 节点分裂:以请求 A 为例,原来的
[101, 11, 12, 21, 22]最后被拆成[101,11]与[12]、[21,22]。
通过前面的例子,我们已经完整走通了构建 Radix Tree 的核心工作流程,这也是 RadixAttention 实现 KV Cache 管理的基础。
相关实现可参考代码分析部分。
4 Radix Tree 如何支撑 Prefix Cache
第 3 节聚焦 Radix Tree 的构建。本节进一步分析其与 KV Cache Pool、调度器及物理内存管理的协同,从而实现缓存的匹配、复用、保护与淘汰。
4.1 Radix Tree 与 KV Cache Pool 的联系
在建立 Radix Tree 与 KV Cache Pool 的联系时,有三类关键数据对象发挥着重要作用:
| 对象 | 保存内容 | 所在位置与作用 |
|---|---|---|
| Radix Tree 的 key | token id 序列 | 逻辑索引,用于判断两个请求是否共享前缀 |
| Radix Tree 的 value | token slot / page indices | 地址索引,指向 KV Cache Pool 中对应的存储位置 |
| KV Cache Pool | 每一层的 K、V 张量 | GPU 上真正参与 Attention 计算的数据 |
注:为了便于管理 KV Cache 的存储,通常会把 K/V 进行分页存储。SGLang 的相关实现正是采用了这种方式。
需要注意的是 Radix Tree 本身并不保存巨大的 K、V 张量,它只维护 token id 序列与物理地址之间的映射关系。
接下来通过一个具体示例,说明 Scheduler 如何借助上述映射关系实现 KV Cache 的高效管理。
4.2 从到达到请求结束的缓存生命周期
前置概念说明:
- page:KV Cache 分配和回收的基本单位;一个 page 通常包含
page_size个 token slot; - token slot:一个 token 在 KV Cache Pool 中对应的物理存储位置或索引;
- page table:记录请求逻辑 token id 位置到物理 page 的映射。具体映射粒度取决于实现;
- free list:保存当前尚未分配、可以用于存储新 KV 的物理 page。不同实现中可能命名为 free_pages、release_pages 或其他名称;
- ref_count:记录活动请求或缓存句柄对某个 Radix Tree 节点的引用数量。加锁和解锁时,通常会沿当前节点向根节点更新引用计数;
- handle:缓存句柄,记录匹配到的 Radix Tree 节点相关信息,后续用于获取对应的物理索引,以及执行 lock/unlock 操作。
在示例中,假设 Radix Tree 结构已稳定,历史请求已在 Radix Tree 中形成共享前缀
的 KV: [p0, p1, p2, p3] 对应的树节点: ref_count = 0,last_access_time较早
当前还需要处理的两个请求为:
| 请求 | Prompt | 匹配结果 | 本次还需计算 |
|---|---|---|---|
| R1 | [900, 10, 11, 12, 31, 32] | cache_hit_len = 4, value = [p0, p1, p2, p3] | [31, 32] |
| R2 | [900, 10, 11, 12, 41, 42, 43] | cache_hit_len = 4, value = [p0, p1, p2, p3] | [41, 42, 43] |
设 KV Cache Pool 当前 free list 中可用槽位有限,下面先让一个请求进入一个运行批次,处理 1 个请求的流程(另一个请求的处理流程同理)如下:
Step1 Match 产生候选信息。R1/R2 的匹配结果包含 cache_hit_len = 4、节点 handle 以及物理索引 [p0, p1, p2, p3]。
此时 R1/R2 尚未对这些页加锁,这些路径理论上仍可能被淘汰,因此“匹配到”不等于“已经安全持有”。
其中,handle 主要保存两样东西:
- 指向的树节点(匹配到的那个 node);
- 当前请求持有的共享前缀长度.
handle 相当于一把“钥匙”:记录“我匹配到了哪个节点、锁定了多长前缀序列”,为后续 page table 写入与 lock/unlock 提供信息。
Step2 Schedule 决定谁先运行。
在 mini-sglang 中,调度按 pending_list 的到达顺序依次尝试添加请求,直到 token budget 或资源不足为止,没有 prefix-aware 的复杂策略。
而在完整 SGLang 中,调度器会比较命中长度、后缀长度与资源需求。SGLang 的调度策略分为两类:
- 前缀感知:lpm、dfs-weight、hrrn、shortest-prefill-first 等,优先长共享前缀、按树 DFS 权重、或让更短未缓存工作先跑;
- 不感知前缀缓存:fcfs(先到先服务)、lof(最长输出优先)、random、routing-key 等。
这里假设采用 shortest-prefill-first,两者共享前缀相同,R1 未命中后缀更短(只需两个新槽位),于是优先选中处理 R1,R2 则是留在等待队列。调度阶段还可能做 in-batch 前缀检查,避免同一 batch 内重复计算相近前缀。
Step3 Lock 把候选变成受保护的引用。R1 进入批次计算前,对匹配节点调用 lock 相关函数:
- 从该节点向根逐级 ref_count += 1 ;
- 对应 token id 序列从
evictable_size移入protected_size,并从可选淘汰叶子集合中更新状态。
共享前缀 [900, 10, 11, 12] 因此受到保护。命中前缀的索引写入请求的 page table,但加锁本身只负责保护,不负责分配新的 page 。
Step4 Allocate 为未命中部分只申请缺口。R1 的未命中后缀长度为 2,于是从 free list 分配 [p6, p7],page table 变为 [p0, p1, p2, p3, p6, p7]。若空闲不足,分配器会先请求 CacheManager ,拿到一定量的释放物理空间后再继续分配。
注:这个过程中不会*重新申请已经命中的 [p0, p1, p2, p3] 物理空间*。
Step5 Insert 把新计算结果变成共享缓存。Prefill 完成后,用 R1 的 token id 序列与 page table 更新树。已有的
这一步写入的是 token id 到物理地址的索引,不会复制
Step6 Unlock 与请求结束处理。完成 R1 的计算后,对匹配路径调用 unlock 的相关函数(ref_count -= 1):
- 若某节点 ref_count 降为 0 ,则它直接变为可淘汰状态(进入 evictable_size);
- 若 ref_count > 0,说明还有其他请求在用,不能被淘汰。
此时,对应的前缀部分引用次数变成 0 ,也不会被立即从共享前缀树中摘除以及释放相应的物理槽位。
Step7 空间不足时的 evict 与请求结束后的 free
evict(空间不足时):当后续请求(如 R2)分配时发现 free 不够,调用
prefix_cache.evict。它只会挑选当前引用次数为 0 的叶子节点,按策略从树中摘除,并把对应 page 索引物理空间归还。(例如此时若 [31,32] 节点已无引用,就可能被选中,[p6, p7]对应就会被释放)free(无策略归还):
- Insert 阶段发现竞争态重复 page 时立即 free;
- 请求真正结束时,只 free 无法再加入树的非共享 token 序列,为了给处理其他请求腾出空间。
成功共享的前缀 page 不会在请求结束时被 free,只会 unlock ,等待后续空间压力触发或者淘汰机制 evict 才会被释放。
注:SGLang 的 evict 会按优先级摘除当前引用次数为 0 的叶子节点,并直接释放其物理空间;而 mini-SGLang 中的 evict 仅负责按策略摘除 ref_count == 0 的叶子节点并返回对应的物理索引 tensor ,实际释放空间则是由调度层完成。
整个过程可以概括为:
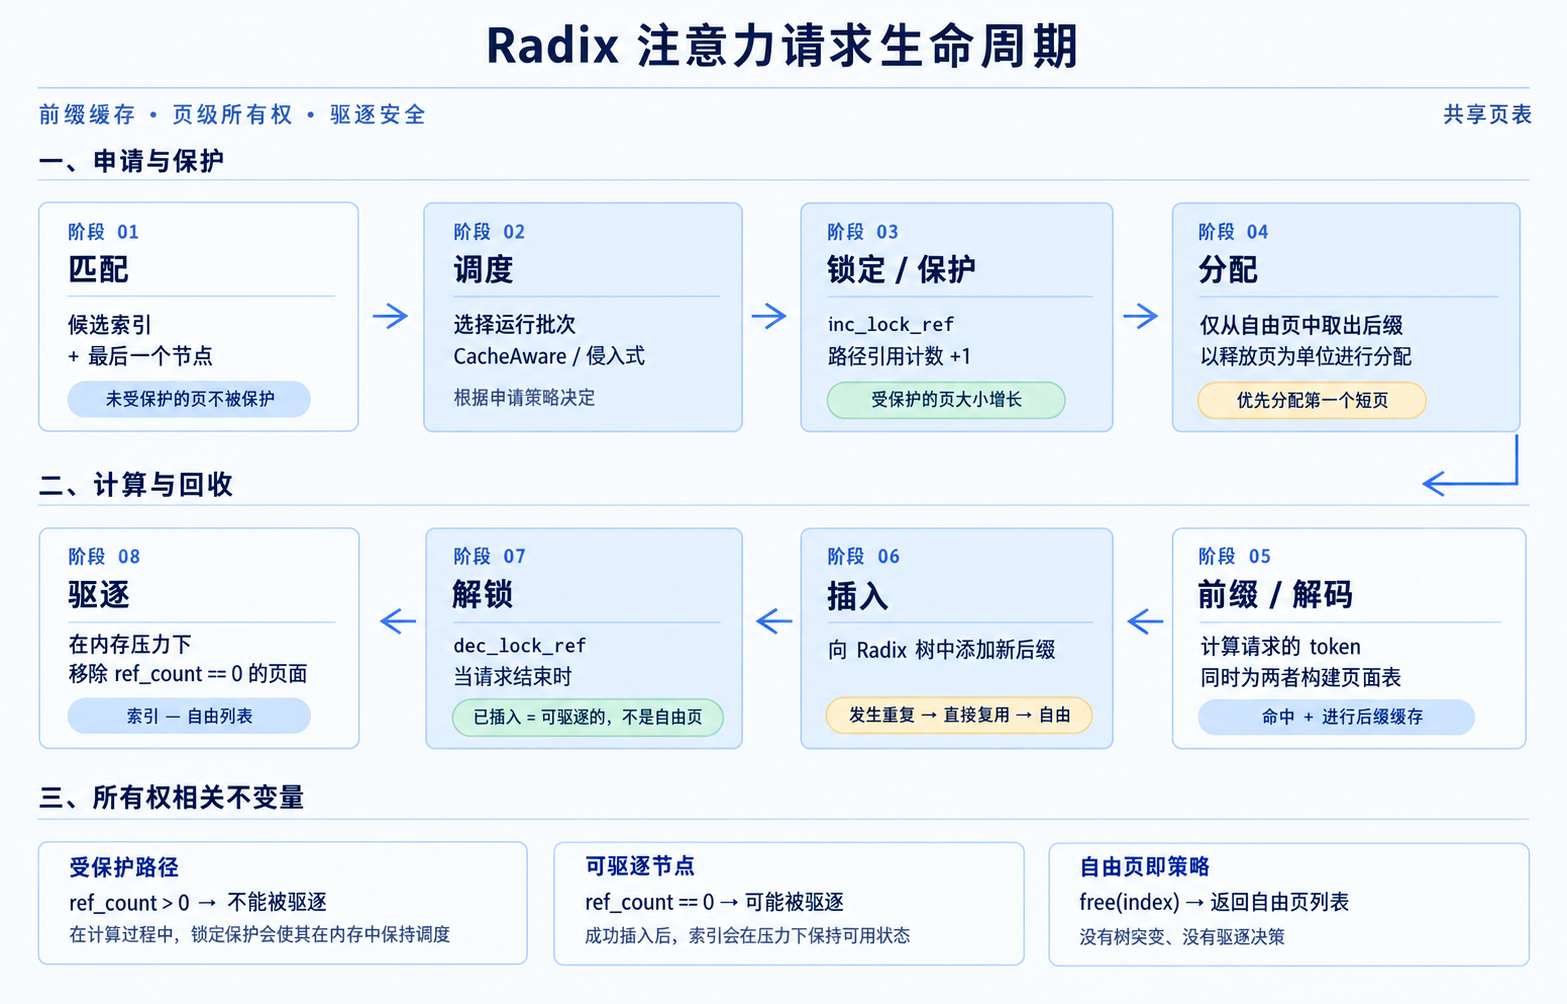
图 5. Radix Cache管理的生命周期
那么整个流程看下来,Prefix Cache 的“命中”只是生命周期的起点,还需要以下步骤:
- Match 负责找到地址;
- Lock 负责保证地址在使用期间有效;
- Insert 负责把新结果加入共享索引,并回收重复占用的 page;
- evict 与 free 决定 page 占用的物理空间是否被释放。
注:Prefill 和 Decode 使用同一张 page table 。默认会把 finished 时的 prompt+output 写入 Radix Tree,并通过 prompt 边界 split 方便后续按需淘汰生成部分,并非“只缓存 prompt、Decode 一律私有直接归还”。
Prefix Cache 管理的实现思路可以参考代码分析。
此外,SGLang 最新的 Unified Radix Cache 进一步优化了 KV Cache 管理(支持混合注意力模型),具体设计思路请参考这篇文章。
5 总结与测试题
5.1 课程总结
本章通过 A、B、C 三个请求的示例,介绍 Radix Tree 的构建过程,然后在树结构已建立的前提下再以 R1、R2 为例,分析从请求匹配、调度、加锁、物理空间分配,到结果加入、解锁和缓存淘汰的完整生命周期。
5.2 测试题
1.为什么 Prefix Cache 选用 Radix Tree(路径压缩),而不选择普通 trie?
提示:对比两种结构在节点数量、查找步数上的差异;结合 LLM 请求里系统提示、多轮对话等长公共前缀很常见的特点思考。
2.为什么在 Radix Cache 中,evict 只能从叶子节点开始,而不能直接淘汰内部节点或根节点?
提示:回顾 Prefix Cache 的核心优化——前缀复用。如果直接淘汰内部节点,会破坏所有以该节点为前缀的后续路径,导致已经计算好的共享 KV 无法再被其他请求命中。
3.调度过程中,evict 和 free 分别在什么场景下使用,二者有何本质区别?
提示:在 SGLang 相关实现中,两者最终都会释放物理 page但作用层次不同——一个是树节点的淘汰,一个是直接归还 page,使用时机也不同。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs
- mini-sglang:radix_cache.py
- mini-sglang:CacheManager
- From Tensor Buffer to Distributed Memory Hierarchy: A Survey of KV Cache Management for LLM Serving
- sglang:radix_cache.py
- sglang:schedule_policy.py
- mini-sglang:cache.py
- sglang:radix_cache.py
- unified radix cache
- mini-sglang:decode.py
- mini-sglang:prefill.py