第 1 章 我们究竟要造什么
本章代码
code/ch01/main.py· 读完约 15 分钟
在开始之前,有的学习者一看到“复刻 WorkBuddy”,就特别激动,以为这门课是把 WorkBuddy 直接拆开研究。其实不是这样。我们不逆向 WorkBuddy 本身,而是用 AgentScope 框架,把它背后的几项核心机制一步步做出来。边做边学,既朝着“复刻”的目标前进,也慢慢弄明白 Agent 是怎么工作的。
准备好了嘛,我们一起扬帆起航吧~~
1.0 先看成品
我们先来看看要“复刻”的原型 WorkBuddy,这是一个国民级的应用,在非AI从业者中具有很高的热度,大家就真的感觉自己用上了ai,这个ai是不一样的,他能够能读文件、写代码、跑命令,甚至能帮你干很多的工作~
我们可以看到界面是非常的简单的,只有一个对话框~
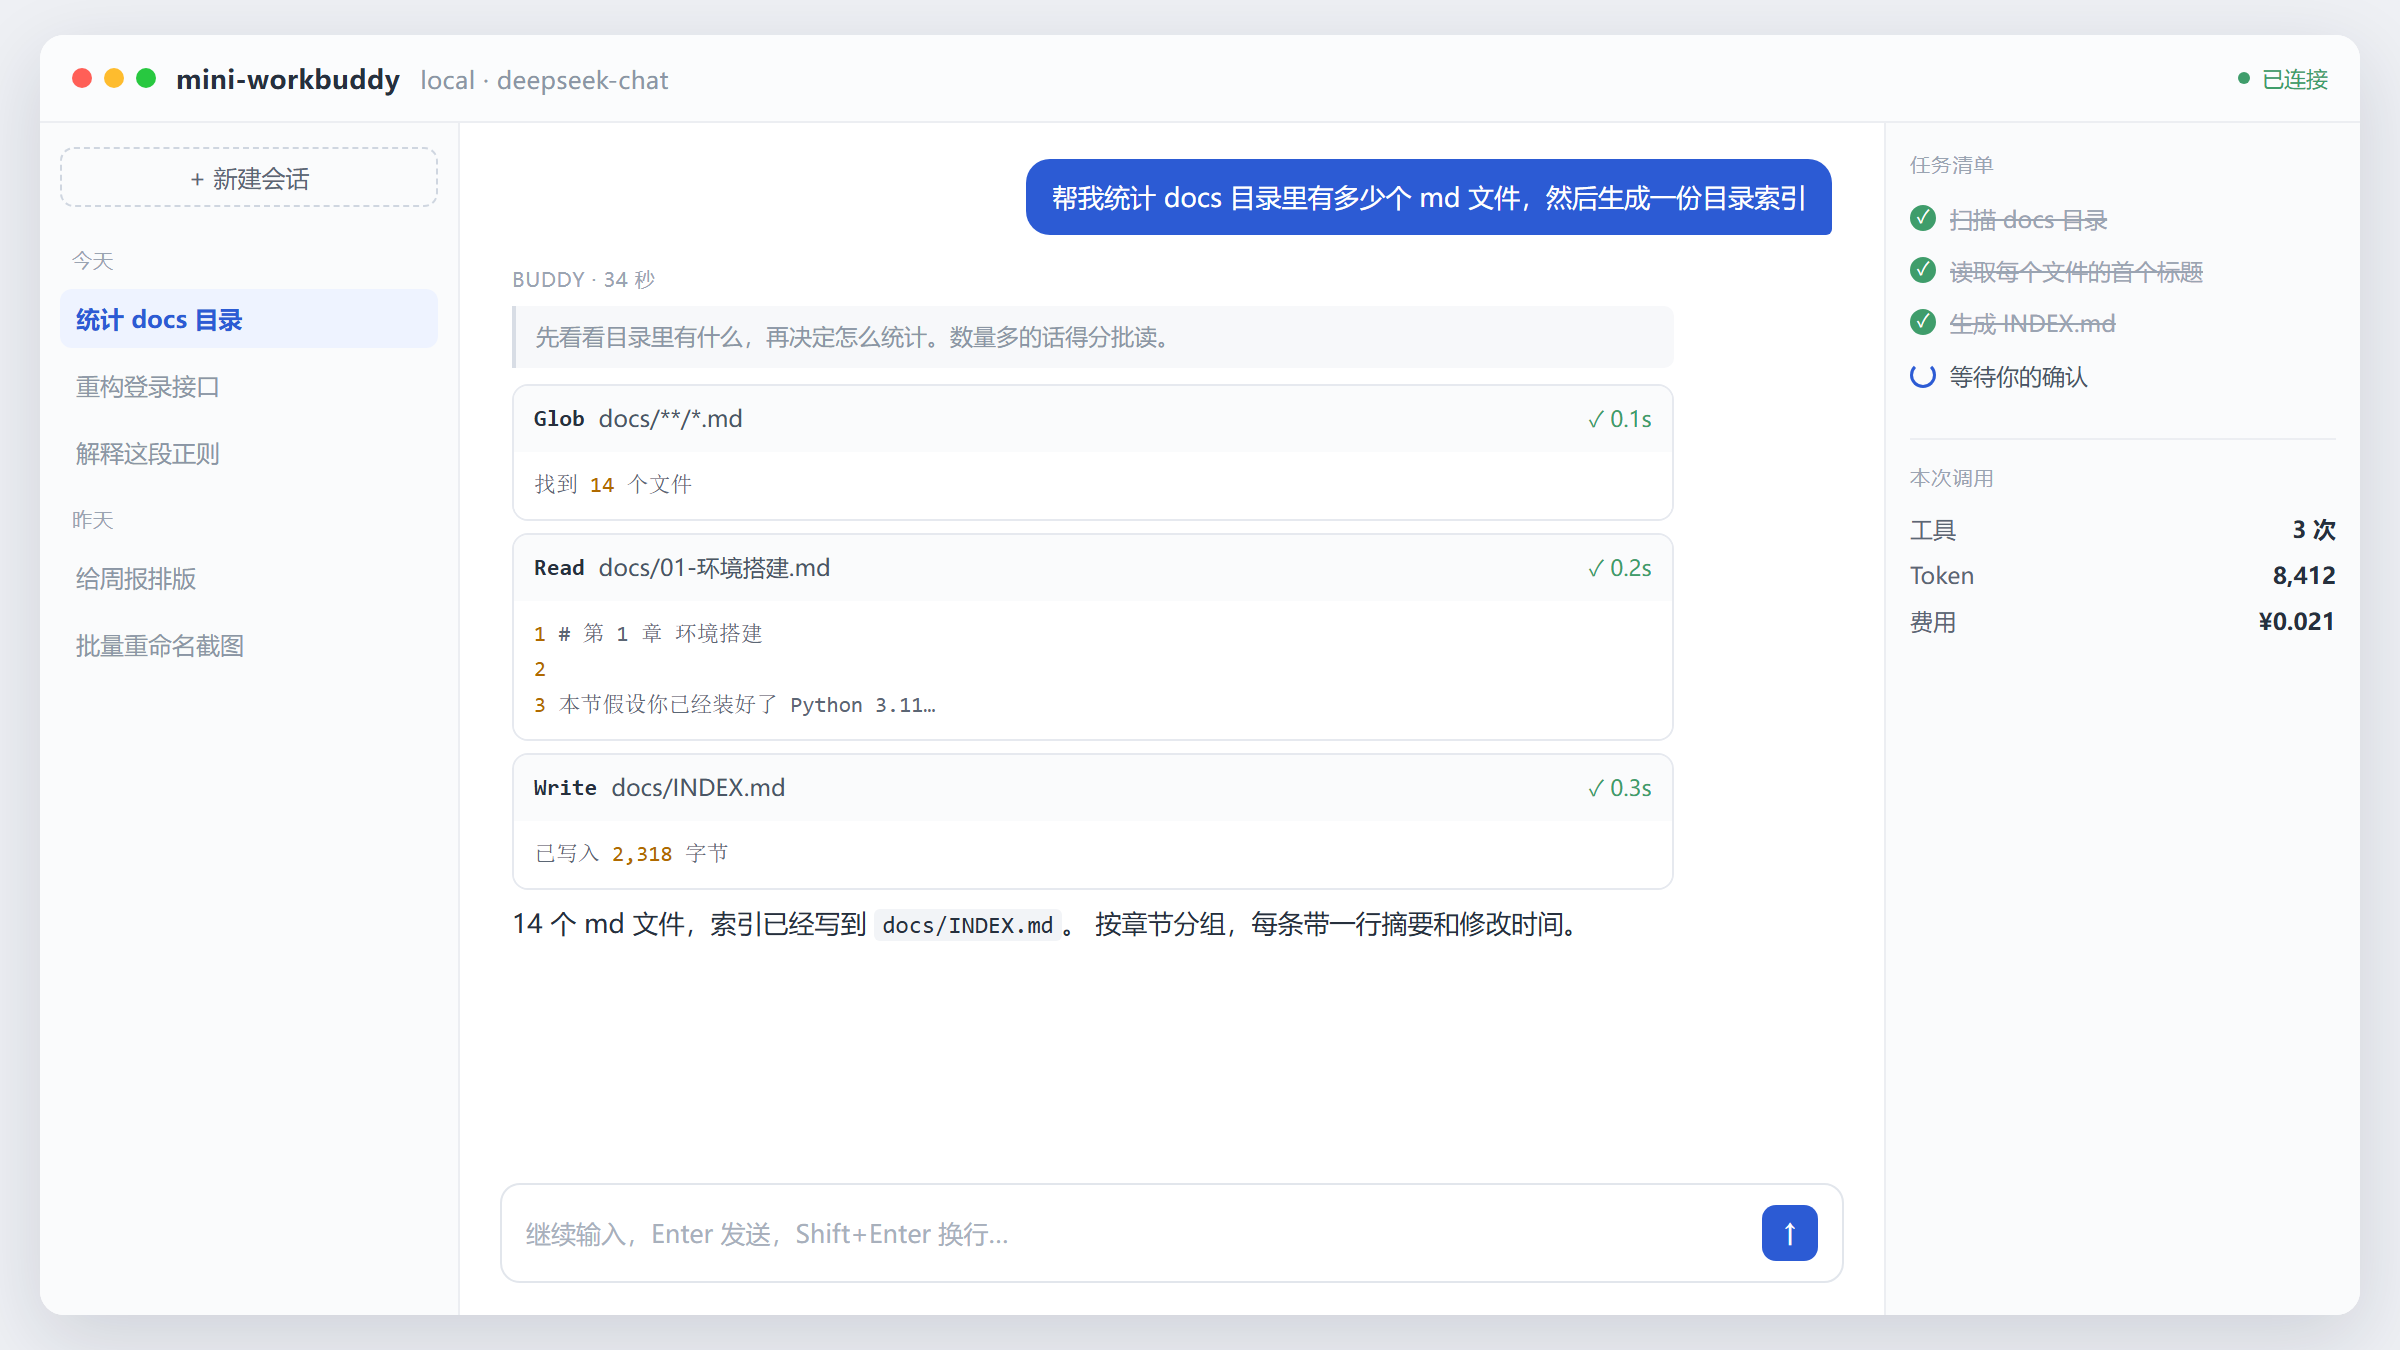
这张是 mini-workbuddy 的预想效果图,哈哈但是它现在还不存在,需要你通过学习最后把这个mini版本手搓出来,它会真实运行在你的浏览器里。左边是会话列表,中间是对话区,右边是任务清单和本次调用的成本统计,能够实现类似workbuddy一样的功能。
复刻workbuddy,了解agent原理,搭上时代快车,然后迎娶白富美/高富帅,走上人生巅峰 。
大家用workbuddy的时候,就会觉得很爽,只需要对话就能指挥ai干活,那是不是意味着这个很复杂很难学呢?
人生巅峰之路突然破灭~~
那么,今天这个项目会告诉你,其实agent并不神秘,如果拆开来看真正核心的只有三样东西:一个模型、一个循环、几样工具。
这本书希望你能了解到的,就是把这些东西逐个拼起来,并弄明白每一部分为什么这样设计。
做这个产品本身不是目的,关键是希望学习者了解agentscope框架,模型怎么接、消息长什么样、工具怎么注册、内部循环替你跑了几轮、权限和上下文在哪一层拦截、状态存在哪、事件怎么流出去。
学完之后,面对新需求你要能判断出"该动哪一层",而不是只会照搬书里的代码。
正如我们README里面说的,框架是学不完的,但是agent的思想是值得探讨的。
1.1 和 ChatGPT/豆包有什么区别?
如果你用过 ChatGPT 网页版,可能会有这样的印象:这不就是一个聊天框加几个按钮吗?
网页版 ChatGPT 确实能查天气、能读网页,但那是 OpenAI 在服务端固定实现的流程。你不知道它内部转了几轮、用了什么参数、失败了怎么处理、能不能换成你自己的数据库。你能用的只有官方开放的那些能力。
我们在这里要做的东西,每一行代码都由你掌握。
你能根据自己的需求去修改agent中的每一个流程,让这个agent更加能适应你的风格。
那么回到一个最初的话题,agent那它到底是什么?我们引用openai给出的一个公式,
Agent = 模型 + 循环 + 工具
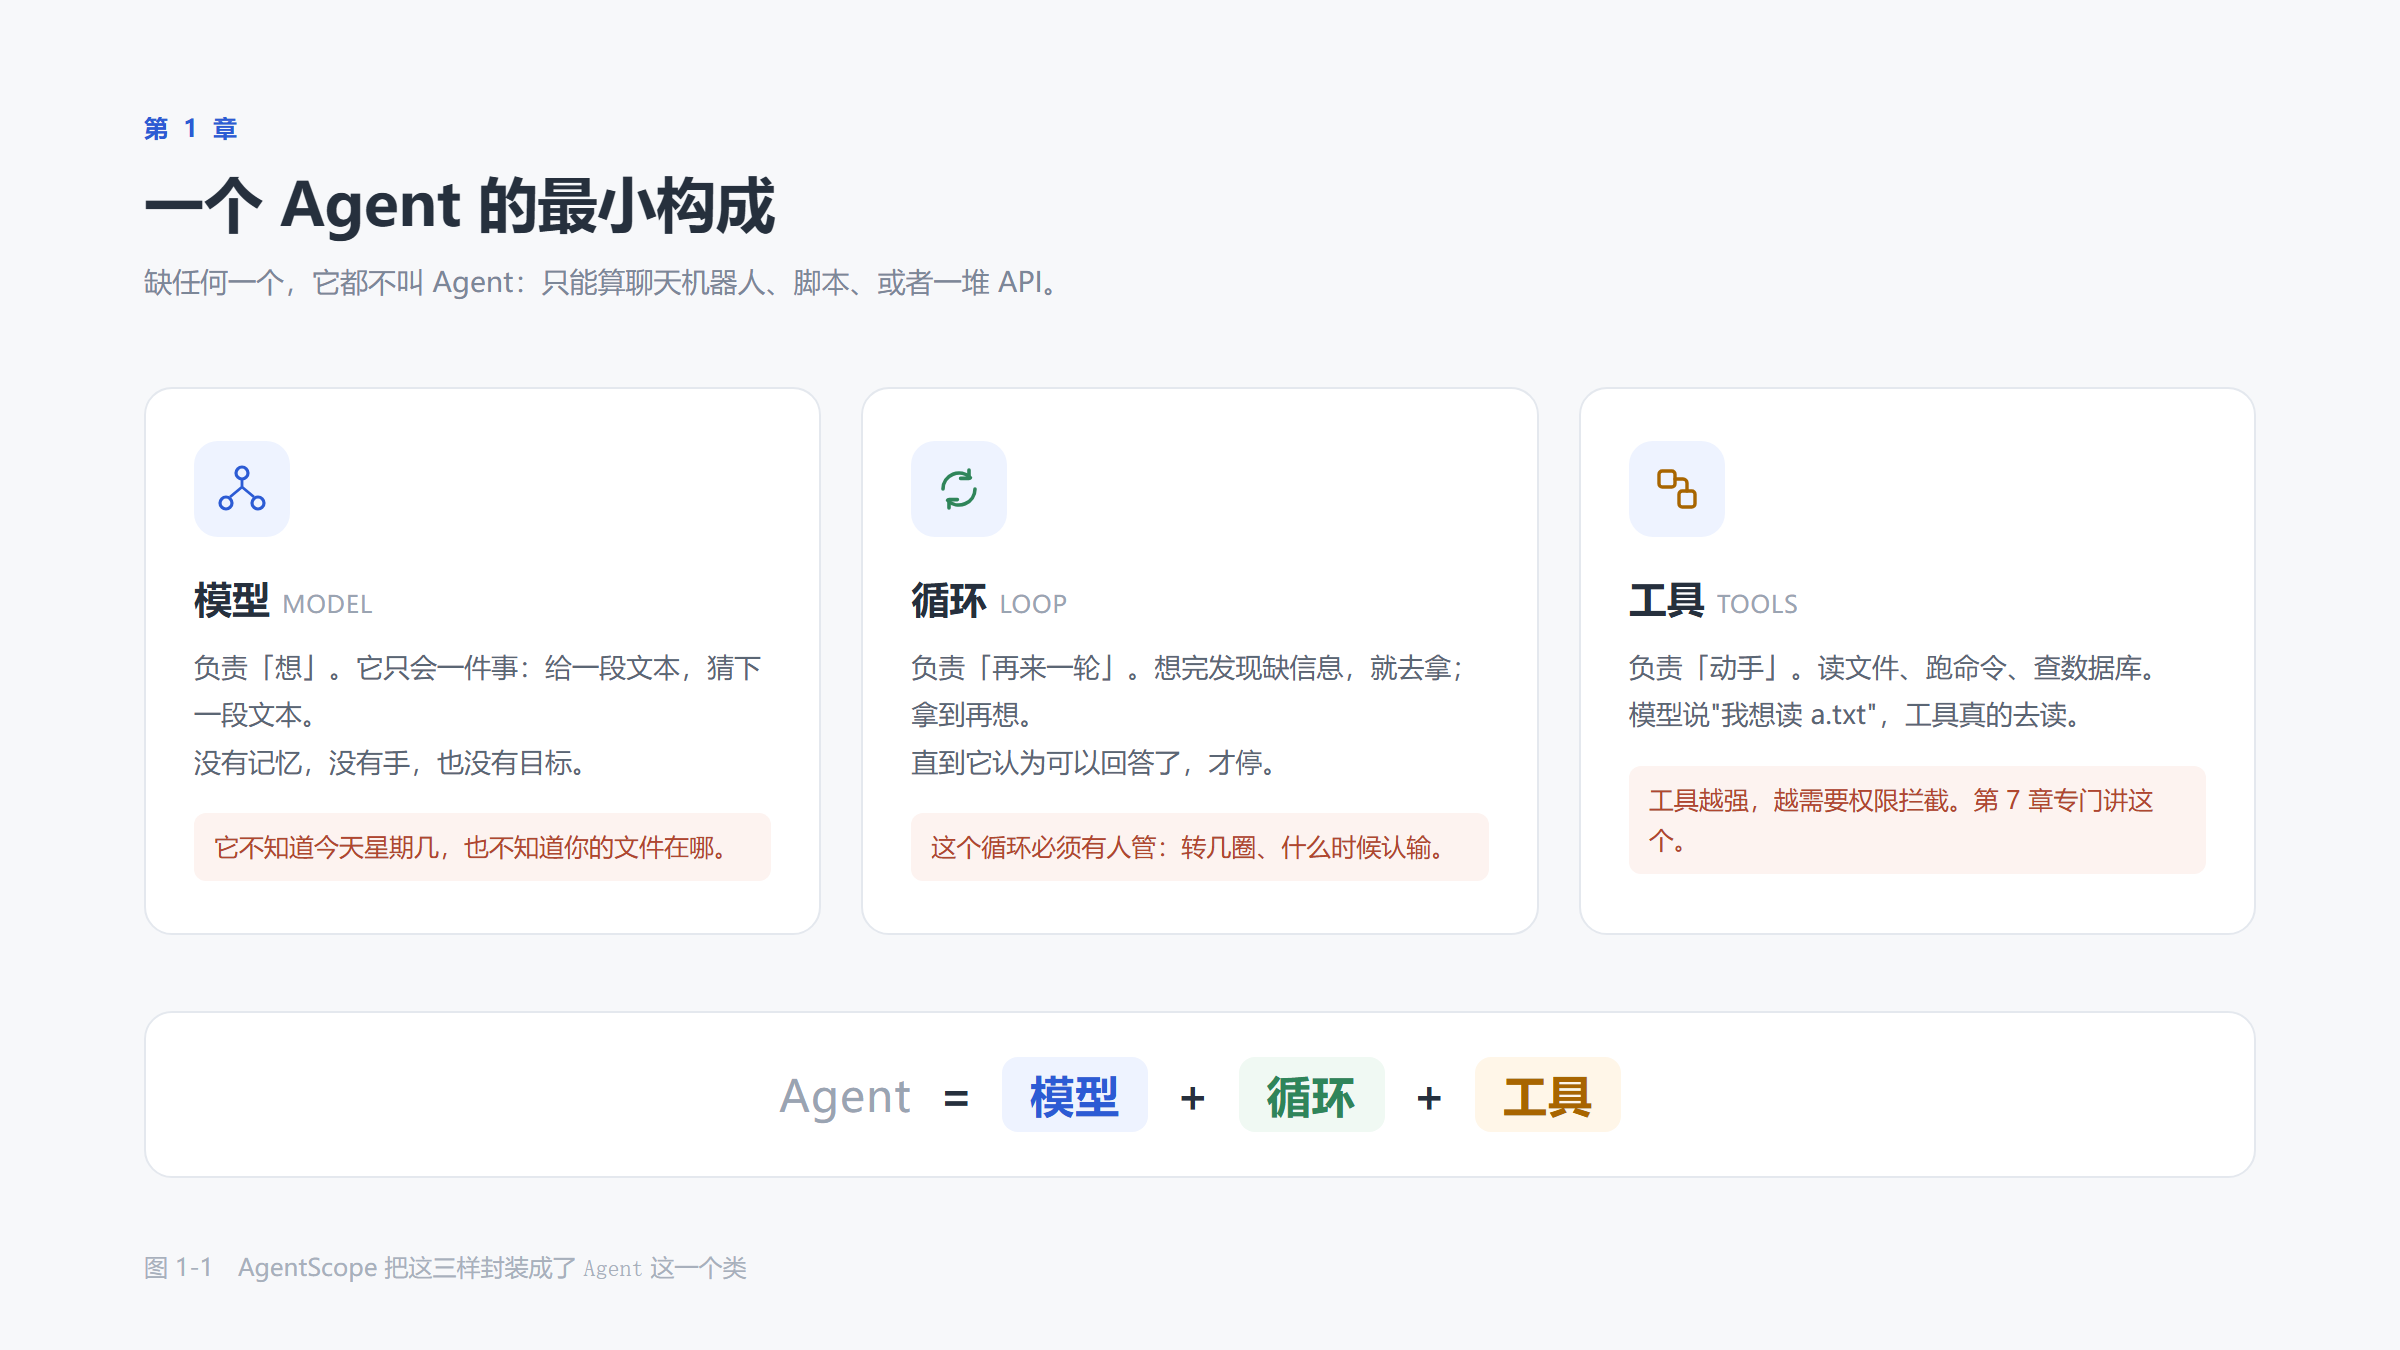
那么,我们来看看这3部分分别是什么?
如果你清楚大语言模型的理论,可以跳过模型部分的介绍,如果你清楚agent的原理,那么你就跳过下面3个部分吧~~
模型(Model) 只做一件事:给定一段文本,预测下一段文本。
你可以把它想象成一位知识渊博、但被隔离在房间里的同事:理论物理、唐诗宋词、Python 语法,随口就能讲。但它不知道今天星期几,不知道你电脑里面那个代码写了什么,也不知道上一轮对话中自己说过什么。
所以模型不等于 Agent,模型是大脑,而大脑本身不会行动。
循环(Loop) 才是 Agent 的骨架。
就像人一样,人在干活的时候是很难一次把工作做好的。
在实际工作中一定是,先了解信息,然后去尝试,然后根据反馈修正尝试,最后得到正确的结论。
了解,然后尝试,然后反馈修正,然后再尝试,其实就像一个循环一样
“干活”-->“观察”-->“思考”-->“再干活”-->“再观察”-->“再思考”,这个不断循环的过程就是 Agent 与聊天机器人的分水岭。
现在不了解也没有关系,本书第四章会详细的介绍agent loop相关的内容~
工具(Tools) 是手和脚。
对于agent来说,干活就需要不断的获取外部的信息,例如读文件、执行命令、查数据库、发请求。这些动作就需要给大模型配置工具,从而让它获取外部的信息。
现在不了解也没有关系,本书第三章和第六章会详细的介绍
上面三要素对于智能体来说缺一不可:
| 缺什么 | 会退化成什么 |
|---|---|
| 缺工具 | 一个只会聊天的机器人 |
| 缺循环 | 一个一次性的 API 调用脚本 |
| 缺模型 | 一个 if-else 写成的自动化脚本(也有用,但不再属于 AI 范畴,更像是程序编码,也可以叫古法编程) |
1.2 准备环境
学习者如果没有合适的大语言模型的话,笔者非常推荐大家去调用deepseek(蓝色大肥鱼),使用deepseek-api 作为agent的大脑。
deepseek-api文档:https://api-docs.deepseek.com/zh-cn/
准备python环境,如果你还不会python的话,那么接下来的课程对你来说可能就比较困难了(这里默认大家都会啦)
python环境推荐大家使用>= 3.11版本,环境安装好以后,需要安装agentscope,具体命令如下:
pip install "agentscope>=2.0,<3" python-dotenv为什么锁定 2.x版本? AgentScope 2.0 与 1.x 是两套完全不同的 API,目前网络上大部分教程仍停留在 1.x(
ServiceToolkit、ReActAgent那一套),照抄会持续报错。2.x版本能力更强,更符合现在agent开发的设计模式。
装完验证一下:
python -c "import agentscope; print(agentscope.__version__)"
# 2.x
推荐阅读:
agentscope官方文档:https://docs.agentscope.io/zh/versions/2.0.11
1.2.1 如何接入模型
本书采用的模型接入模式:兼容 OpenAI 接口的模型
DeepSeek、ChatGPT、kimi、GLM,甚至你在本地电脑上部署的ollama模型都可以支持~~
/code 文件夹下有一个.env.example文件,
你可以新建一个 .env 文件(或者复制 code/.env.example 后改名):
OPENAI_API_KEY=sk-你的key
OPENAI_BASE_URL=https://api.deepseek.com
OPENAI_MODEL=deepseek-chat
base_url 的取值取决于服务商:
| 服务 | OPENAI_BASE_URL |
|---|---|
| DeepSeek | https://api.deepseek.com |
| 阿里百炼(兼容模式) | https://dashscope.aliyuncs.com/compatible-mode/v1 |
| 月之暗面 | https://api.moonshot.cn/v1 |
| 本地 Ollama | http://localhost:11434/v1 |
| vLLM | http://你的服务器:8000/v1 |
这三个值全部通过环境变量传入,不写死在代码里。
这是本书的一个工程点,切换模型属于改配置,不属于改代码。需要经常改的配置,最好是写在环境变量中,这样就可以随时修改啦~~
1.3 让它说第一句话
现在环境配置好啦,我们开始和agent对话吧~~
"""第 1 章:让 mini-workbuddy 开口说第一句话。

这一章只做一件事:创建一个 Agent,然后和它聊几轮。
比上一章多了什么:没有上一章,这是起点。
"""

# asyncio:标准库的异步框架。Agent 的 reply() 是异步方法,必须放在事件循环里跑
import asyncio
# os:用来读取环境变量(API key、base_url、模型名都放这里)
import os

# load_dotenv:把项目根目录 .env 文件里的键值对加载进 os.environ
from dotenv import load_dotenv

# Agent:框架里的智能体主体,负责维护对话历史、调用模型
from agentscope.agent import Agent
# OpenAICredential:模型的凭证对象(api_key + 可选 base_url)
from agentscope.credential import OpenAICredential
# UserMsg:用户消息的数据结构,用来把一行文本包装成「用户说的话」
from agentscope.message import UserMsg
# OpenAIChatModel:OpenAI 兼容协议的聊天模型实现
from agentscope.model import OpenAIChatModel

# override=True:.env 里的值优先于系统已有环境变量,改配置后立即生效
load_dotenv(override=True)

# 配置:全部从环境变量读,别写死在代码里。换模型只改 .env,代码一行不动。
API_KEY = os.getenv("OPENAI_API_KEY", "")  # 密钥;第二个参数是取不到时的默认值
BASE_URL = os.getenv("OPENAI_BASE_URL", "")  # 留空则走 OpenAI 官方地址
MODEL_NAME = os.getenv("OPENAI_MODEL", "gpt-4o-mini")  # 模型名,缺省 gpt-4o-mini

PROMPT = "> "  # 输入提示符
# 一组退出指令,大小写不敏感(比较时统一转小写)
EXIT_WORDS = {"/exit", "/quit", "exit", "quit", "q"}


def build_model() -> OpenAIChatModel:
    """造一个模型实例。后面每一章都复用它。"""
    return OpenAIChatModel(
        # 凭证:key 必填;base_url 为空时传 None,让 SDK 用官方默认地址
        credential=OpenAICredential(
            api_key=API_KEY,
            base_url=BASE_URL or None,  # 空字符串是假值,这里顺便转成 None
        ),
        model=MODEL_NAME,  # 指定要调用的模型
    )


async def chat_loop(agent: Agent) -> None:
    """读一行 -> 问一句 -> 打一句,直到你说退出。

    这个 while 循环是本文件唯一"多余"的东西,但它换来两件事:
    1. 你可以连着问,像真的在用一个助手,而不是跑一次脚本看一行输出;
    2. 你会亲眼看到"对话是有记忆的"——历史存在 Agent 对象里,
       每次 reply() 都会把之前几轮一起带进模型,所以第二句里的"它"它听得懂。
    """
    while True:  # 死循环:靠下面的 return 退出
        # Ctrl+C 和 Ctrl+D(管道结束)都当作"我要走了",而不是抛一堆堆栈
        try:
            # input() 是阻塞式读取一行;strip() 去掉首尾空白(含换行)
            text = input(PROMPT).strip()
        # KeyboardInterrupt:Ctrl+C;EOFError:输入流结束(Ctrl+D 或管道关闭)
        except (KeyboardInterrupt, EOFError):
            print("\n(已退出)")
            return  # 结束整个对话循环

        if not text:  # 空行直接跳过,不浪费一次模型调用
            continue
        if text.lower() in EXIT_WORDS:  # 命中退出词就收工
            print("(已退出)")
            return

        try:
            # reply 内部会跑完整个「推理-行动」循环,返回最终消息
            # 把用户输入包装成 UserMsg 交给 Agent,Agent 自己维护历史
            reply = await agent.reply(UserMsg(name="user", content=text))
            # get_text_content() 取出消息里的纯文本部分并打印
            print(reply.get_text_content())
        except Exception as exc:  # noqa: BLE001
            # 网络抖动、key 过期、额度用光——都只影响这一轮,不该把整个会话打死。
            # 第 13 章会把这里换成框架自带的错误对象。
            # type(exc).__name__ 打出异常类名,便于快速定位是哪类问题
            print(f"[出错] {type(exc).__name__}: {exc}")
            print("  先查 .env 里的 BASE_URL 与 MODEL 是否配对,常见错误见 1.5 节。")


async def main() -> None:
    # 创建 Agent 实例:名字、人设、模型三样齐了就能聊
    agent = Agent(
        name="Buddy",  # 它自己的名字,会出现在消息的 name 字段里
        system_prompt=(  # 系统提示 = 人设与行为约束,每轮都会带给模型
            "你叫 Buddy,是一个住在命令行里的工作助手。"
            "说话直接、简短,不超过两句话。"
        ),
        model=build_model(),  # 复用上面造的模型
    )

    print("Buddy 已就位(第 1 章版本:还没有工具,只能聊天。输入 /exit 退出)")
    await chat_loop(agent)  # 进入对话循环,直到用户退出


if __name__ == "__main__":  # 只有直接运行本文件时才执行,被 import 时不执行
    # except Exception 抓不到 KeyboardInterrupt(它是 BaseException),
    # 所以"模型正在输出时按 Ctrl+C"要在这里接住,否则会弹一堆堆栈。
    try:
        asyncio.run(main())  # 启动事件循环,运行 main() 协程
    except KeyboardInterrupt:
        print("\n(已中断)")
运行:
python main.pyBuddy 已就位(第 1 章版本:还没有任何工具,只能聊天。输入 /exit 退出)
-> 你是谁?
我是 Buddy,你的命令行工作助手。有什么需要帮忙的?
-> 你能做什么?
我能帮你跑命令、查文件、写代码和解答技术问题。需要我做什么?
-> 今天天气怎样?
我没法直接查天气,也不知道你在哪个城市。告诉我地点,我可以帮你查或写个查询脚本。
-> /exit
(已退出)如果看到的是报错,请直接翻到 1.5 节。
我们来一起看一下代码吧~
1.3.1 build_model()
def build_model() -> OpenAIChatModel:
    """造一个模型实例。后面每一章都复用它。"""
    return OpenAIChatModel(
        # 凭证:key 必填;base_url 为空时传 None,让 SDK 用官方默认地址
        credential=OpenAICredential(
            api_key=API_KEY,
            base_url=BASE_URL or None,  # 空字符串是假值,这里顺便转成 None
        ),
        model=MODEL_NAME,  # 指定要调用的模型
    )
OpenAICredential 保存身份凭证:api_key 必填,base_url 可选(不填就走 OpenAI 官方地址)。OpenAIChatModel 指定具体模型,model 传模型名字符串,比如 .env 里配的 deepseek-chat。
如果不好理解,可以简单理解为大模型访问的"身份证":拿着这张证,才能调用模型。
为什么要分成两层? 凭证回答"是哪家服务",模型回答"是这家的哪一个"。一张凭证下往往挂着几十个模型,换模型名时凭证完全不用动。
为什么要把模型访问凭证单独抽成一个函数? 因为后续每一章都会原样带上这一段。将来要改大模型配置——换 key、换服务地址、换模型名、调上下文长度——只改 build_model() 这一处,所有引用它的地方就都生效了。
这是本书的一个工程点:配置只留一个出口。
具体到换服务商,要分两种情况:
- 仍在 OpenAI 兼容协议内(DeepSeek、阿里百炼兼容模式、本地 Ollama、内网 GPUStack 等):只改
build_model()里的值,代码结构一行不动。- 换成非兼容协议(如 Anthropic、Gemini 原生接口):
base_url解决不了,得把OpenAICredential/OpenAIChatModel换成对应厂商的类。第 10 章的
build_model()会多出一行context_size=32_768,那就是"只改这一处"第一次派上用场。
1.3.2 Agent(...)
async def main() -> None:
    # 创建 Agent 实例:名字、人设、模型三样齐了就能聊
    agent = Agent(
        name="Buddy",  # 它自己的名字,会出现在消息的 name 字段里
        system_prompt=(  # 系统提示 = 人设与行为约束,每轮都会带给模型
            "你叫 Buddy,是一个住在命令行里的工作助手。"
            "说话直接、简短,不超过两句话。"
        ),
        model=build_model(),  # 复用上面造的模型
    )

    print("Buddy 已就位(第 1 章版本:还没有工具,只能聊天。输入 /exit 退出)")
await chat_loop(agent) # 进入对话循环,直到用户退出name="Buddy":它自己的名字。会出现在消息的name字段中,多 Agent 协作时用来区分发言者。system_prompt=...:行为准则。model=...:大脑。
注意现在的agent是没有调用工具的能力的,现在只能让大模型一问一答,就会和网页版本的ChatGPT、豆包、deepseek一样~~
关于
system_prompt这段文字决定了它的行为风格。写得太笼统,回答就会泛泛而谈,什么都能说两句、什么忙都帮不上;写得具体("不超过两句话""直接"),它才像一个称职的助手。
1.3.3 UserMsg(name="user", content="...") —— 消息带有角色
reply = await agent.reply(UserMsg(name="user", content=text))注意这行代码里我们只写了两个参数:
content=text:你刚才输进去的那句话,比如"你是谁?"。name="user":谁说的。这里固定填"user",好让模型知道这句来自用户。
UserMsg 是一个工厂函数,里面带有很多的信息,在后面章节我们会慢慢的拆解~~
1.3.4 await agent.reply(msg) —— 循环结束后返回结果
reply = await agent.reply(UserMsg(name="user", content=text))reply 会跑完整个"推理—行动"循环,然后返回最终消息。中间转了几轮、调用了几个工具,你都看不到——这些过程被 reply() 内部消费掉了。
现在没有工具,所以它只转了一轮。从第 3 章开始,这个函数的内部就会产生大量事件。
最后一句 print(reply.get_text_content()) 值得单独说:这个方法把 content 里所有 TextBlock 的文本拼起来返回,如果一个文本块都没有,它返回 None。也就是说,屏幕上打出一个 None 并不是程序坏了,而是这一轮确实没产出文字——比如被中断,或者只调了工具还没开口。这时候该看的是 reply.finished_reason,它记录了结束原因(error / interrupted / exceed_max_iters),第 13 章会把这个字段正式用起来。
以上是核心代码的详细讲解,如果感觉自己还是有很多地方没有看懂,不妨咨询一下AI,看看是哪一步没有懂,新的时代下,定一个目标,然后让AI教自己学习是一个很不错的学习方法~~
1.4 现在workbuddy还有多远
那么可能会有学习者好奇,现在这个版本距离workbuddy还有多远,是不是马上就能复刻啦~
想啥呢?腾讯的国民级产品,你用几十行代码就实现啦~~
就像爆火的短剧一样,全世界代码水平下降一万倍,只有我不变,哈哈~~轻松时刻
现在我来盘一下还差什么吧?
| 能力 | 现状 | 在哪一章补上 |
|---|---|---|
| 能读文件、执行命令 | ✗ | 第 3、5 章 |
| 能观察工具调用的全过程 | ✗ | 第 2、4 章 |
| 执行危险操作前会询问 | ✗ | 第 7 章 |
| 长对话不失忆、成本可控 | ✗ | 第 8 章 |
| 关闭程序后仍保留状态 | ✗ | 第 9 章 |
| 有界面,同事可以直接使用 | ✗ | 第 11–14 章 |
这六行就是全书的路线图。每一章解决其中一项,最终拼成开头那复刻的效果~~
1.5 三个常见错误
错误 1:RuntimeError: asyncio.run() cannot be called from a running event loop
出现在 Jupyter Notebook 中。Notebook 自身已经运行着一个事件循环,不能再嵌套调用。改为:
await main() # Notebook 中直接 await错误 2:openai.AuthenticationError: 401
九成是 base_url 写错了,最常见的是漏写 /v1——有些服务商要求带,有些带了反而报错。判断方法很简单:把 base_url 拼上 /chat/completions,用 curl 或浏览器请求一次,通不通立刻就能看出来。
错误 3:NotFoundError: model not found
OPENAI_MODEL 与 OPENAI_BASE_URL 不匹配。例如 base_url 指向 DeepSeek,模型名却填了 qwen-plus。模型名必须与端点对应,框架不会替你推断。
1.6 小结
- Agent = 模型 + 循环 + 工具,缺一项就会退化成其他形态
- 接入模型只需要三个环境变量:
OPENAI_API_KEY/OPENAI_BASE_URL/OPENAI_MODEL reply()会消费掉全部中间过程,只返回最终一条消息- 历史存在
Agent对象里,所以对话有记忆;但进程一退,记忆就没了
下一章要解决的问题:既然中间过程被消费掉了,我们怎么知道它究竟做了什么?
答案就在你刚才 print 掉的那个 reply 对象里——它承载的信息比这个 print 呈现出的丰富得多。