第 3 章 给它一双手:工具与 Toolkit
本章代码
code/ch03/main.py、code/ch03/list_tools.py、code/ch03/schema_demo.py· 读完约 15 分钟
3.0 上一章留下的问题
前面我们完成了两个章节,第 1 章那个 Agent 有一个致命缺陷:它只能凭记忆回答一切问题。
你可以试试问它:"现在几点?"
它会给你一个格式完全正确的时间,语气非常自信,而这个时间没有任何参考价值。原因在 1.1 节已经说过——它不知道今天星期几,也不知道此刻是几点。模型的知识停留在训练数据截止的那一天,之后就断了。
那它为什么还要回答?因为它被训练成"尽量给出有用的回答"。没有信息时,它会用最像答案的内容填补空白。这个行为有个不太好听的名字:幻觉。
这一章要解决的,就是让它在不知道的时候,有地方去查。
3.1 工具到底是什么
先看一个具体场景。你问 Agent:"现在几点?"
模型内部没有任何时钟。它唯一会做的事,是接着你的话往下写文本。
如果没人拦着,它会写出一句"现在是下午 3 点 20 分"——格式完美,内容纯属编造。
工具要解决的,就是让它在写这句话之前,先"伸手"去拿真实数据。
但这里有个初学者最容易误解的点:以为 Agent 会直接去查时间。实际情况并不完全是这样。
我们打个比方来帮助理解:
把模型想象成一个被关在隔音玻璃后面的顾问。你能递纸条进去,它只能递纸条出来。它看不见你的电脑,摸不到你的文件,也没有时钟。
所以"调用工具"这件事,从头到尾是这样发生的:
- 你把问题递进去,同时附上一张清单:"我这边有这些工具,各自需要什么参数"
- 顾问递出来一张纸条,上面写着:
{"name": "get_current_time", "arguments": {}} - 你(框架)看到这张纸条,由你去执行,拿到"2026-10-30 15:20:33,星期五"
- 你把结果抄成新纸条递回去
- 顾问这才写出最终回答:"现在是 15:20,星期五。"
顾问从头到尾没碰过时钟。它只是写了一张申请单,真正干活的是玻璃外面的你。
3.1.1 换成代码里的说法
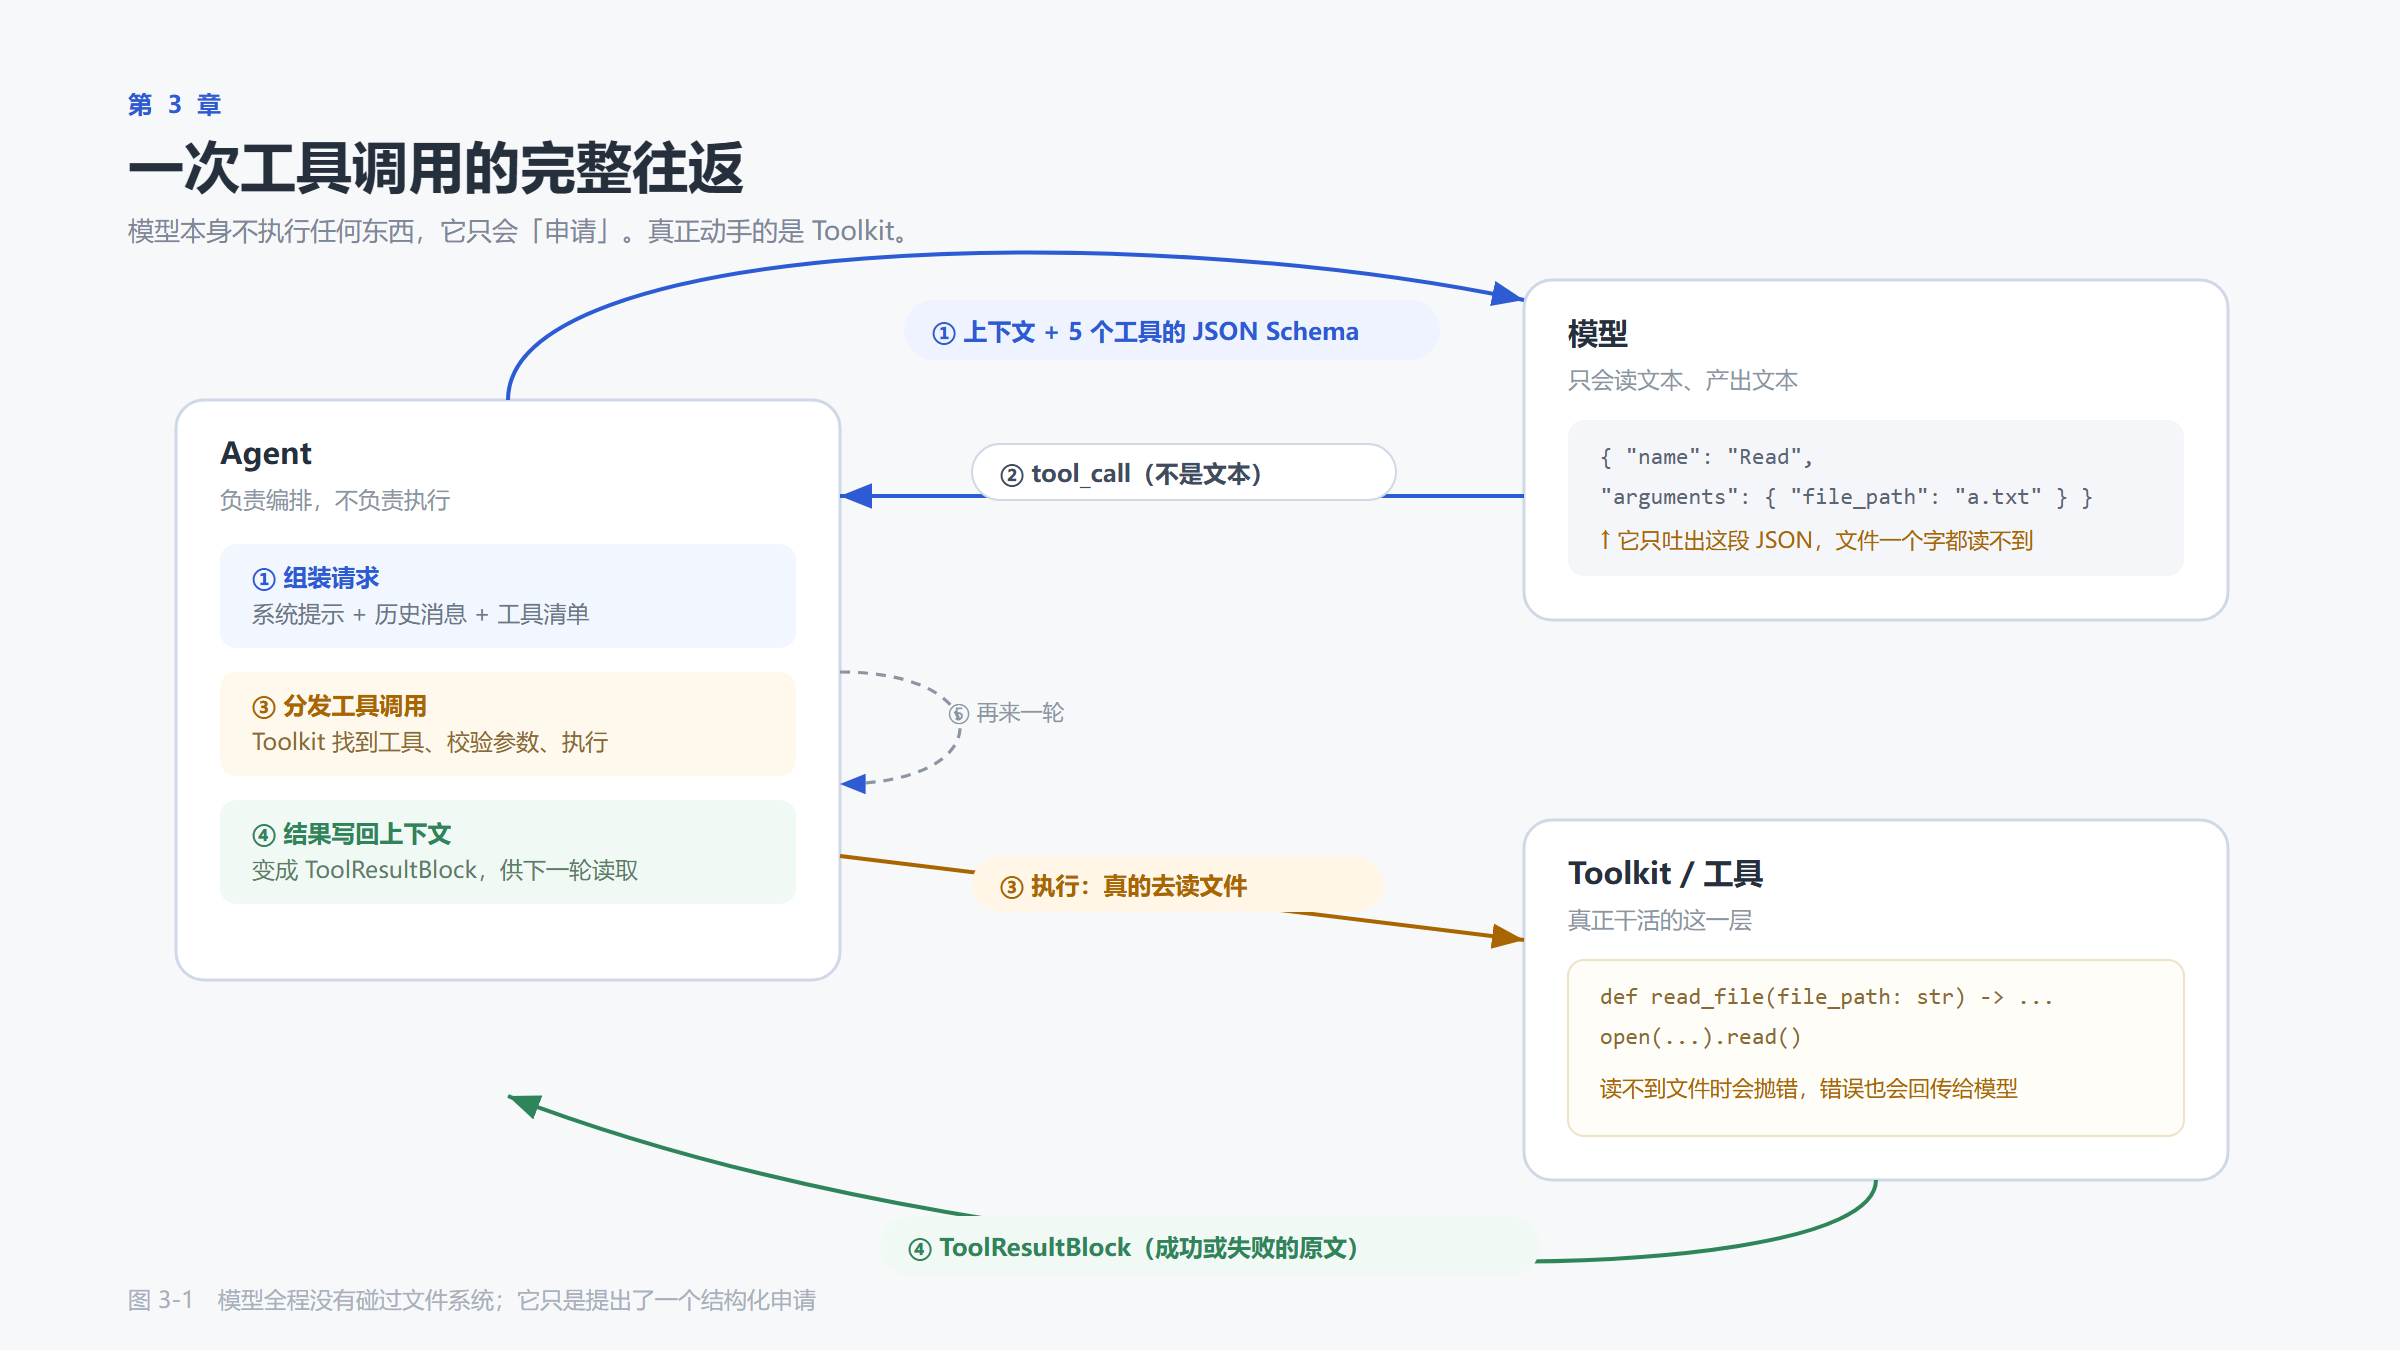
| 步骤 | 谁做的 | 发生了什么 |
|---|---|---|
| ① | Agent | 组装请求:系统提示 + 历史消息 + 工具清单(JSON Schema),一起发给模型 |
| ② | 模型 | 只吐出一段文本 tool_call:工具名 + 参数 JSON,不是自然语言 |
| ③ | Toolkit | 找到对应工具,校验参数,真正执行 |
| ④ | Agent | 把结果包装成 ToolResultBlock 写回上下文 |
| ⑤ | Agent | 带着新上下文再问一次模型;模型若还要调工具,就回到第 ② 步 |
模型在第 ② 步输出的东西长这样:
{
  "name": "Read",
  "arguments": { "file_path": "a.txt" }
}
它没有读到 a.txt,一个字都没有。它只是说了一句"请帮我读 a.txt"。真正打开文件的是第 ③ 步的 Read 工具。
注意第 ② 步和第 ③ 步的分界:模型只负责"说要做什么",框架负责"真的去做"。模型输出 tool_call 时,世界没有任何变化;直到第 ③ 步执行完,文件才被打开、命令才被跑起来。
理解这一点之后,很多事情就顺了:为什么工具描述写得不好会导致调用失败(模型在第 ② 步选错了工具)、为什么工具执行报错不会让程序崩溃(错误在第 ④ 步作为结果回传,让它自己想办法)、为什么权限拦截可以发生在第 ② 步和第 ③ 步之间(申请已发出,但还没执行)。
3.2 模型怎么知道有哪些工具
靠一份结构化说明书,也就是上一节第 ① 步里那份 JSON Schema。
你不需要手写 JSON。AgentScope 提供了一个适配器 FunctionTool:给它一个普通的 Python 函数,它自动完成转换。
下面这段代码可以直接复制运行,不需要 API Key,也不会调用模型——它只做一件事:把函数翻译成 JSON Schema 并打印出来。
import asyncio
import json

from agentscope.tool import FunctionTool, Toolkit


def count_text(text: str) -> str:
    """统计一段文本的字符数、中文字数与行数。

    Args:
        text: 需要统计的文本内容。
    """
    if not text:
        return "文本为空。"
    chinese = sum(1 for ch in text if "\u4e00" <= ch <= "\u9fff")
    lines = text.count("\n") + 1
    return f"总字符数 {len(text)},其中中文 {chinese} 个字,共 {lines} 行。"


async def main() -> None:
    toolkit = Toolkit(tools=[FunctionTool(count_text)])
    schemas = await toolkit.get_tool_schemas()
    print(json.dumps(schemas, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    asyncio.run(main())
运行结果(真实输出):
[
  {
    "type": "function",
    "function": {
      "name": "count_text",
      "description": "统计一段文本的字符数、中文字数与行数。",
      "parameters": {
        "properties": {
          "text": {
            "description": "需要统计的文本内容。",
            "type": "string"
          }
        },
        "required": [
          "text"
        ],
        "type": "object"
      }
    }
  }
]
对照着看,你写的 Python 和模型看到的 JSON 是这样一一对应的:
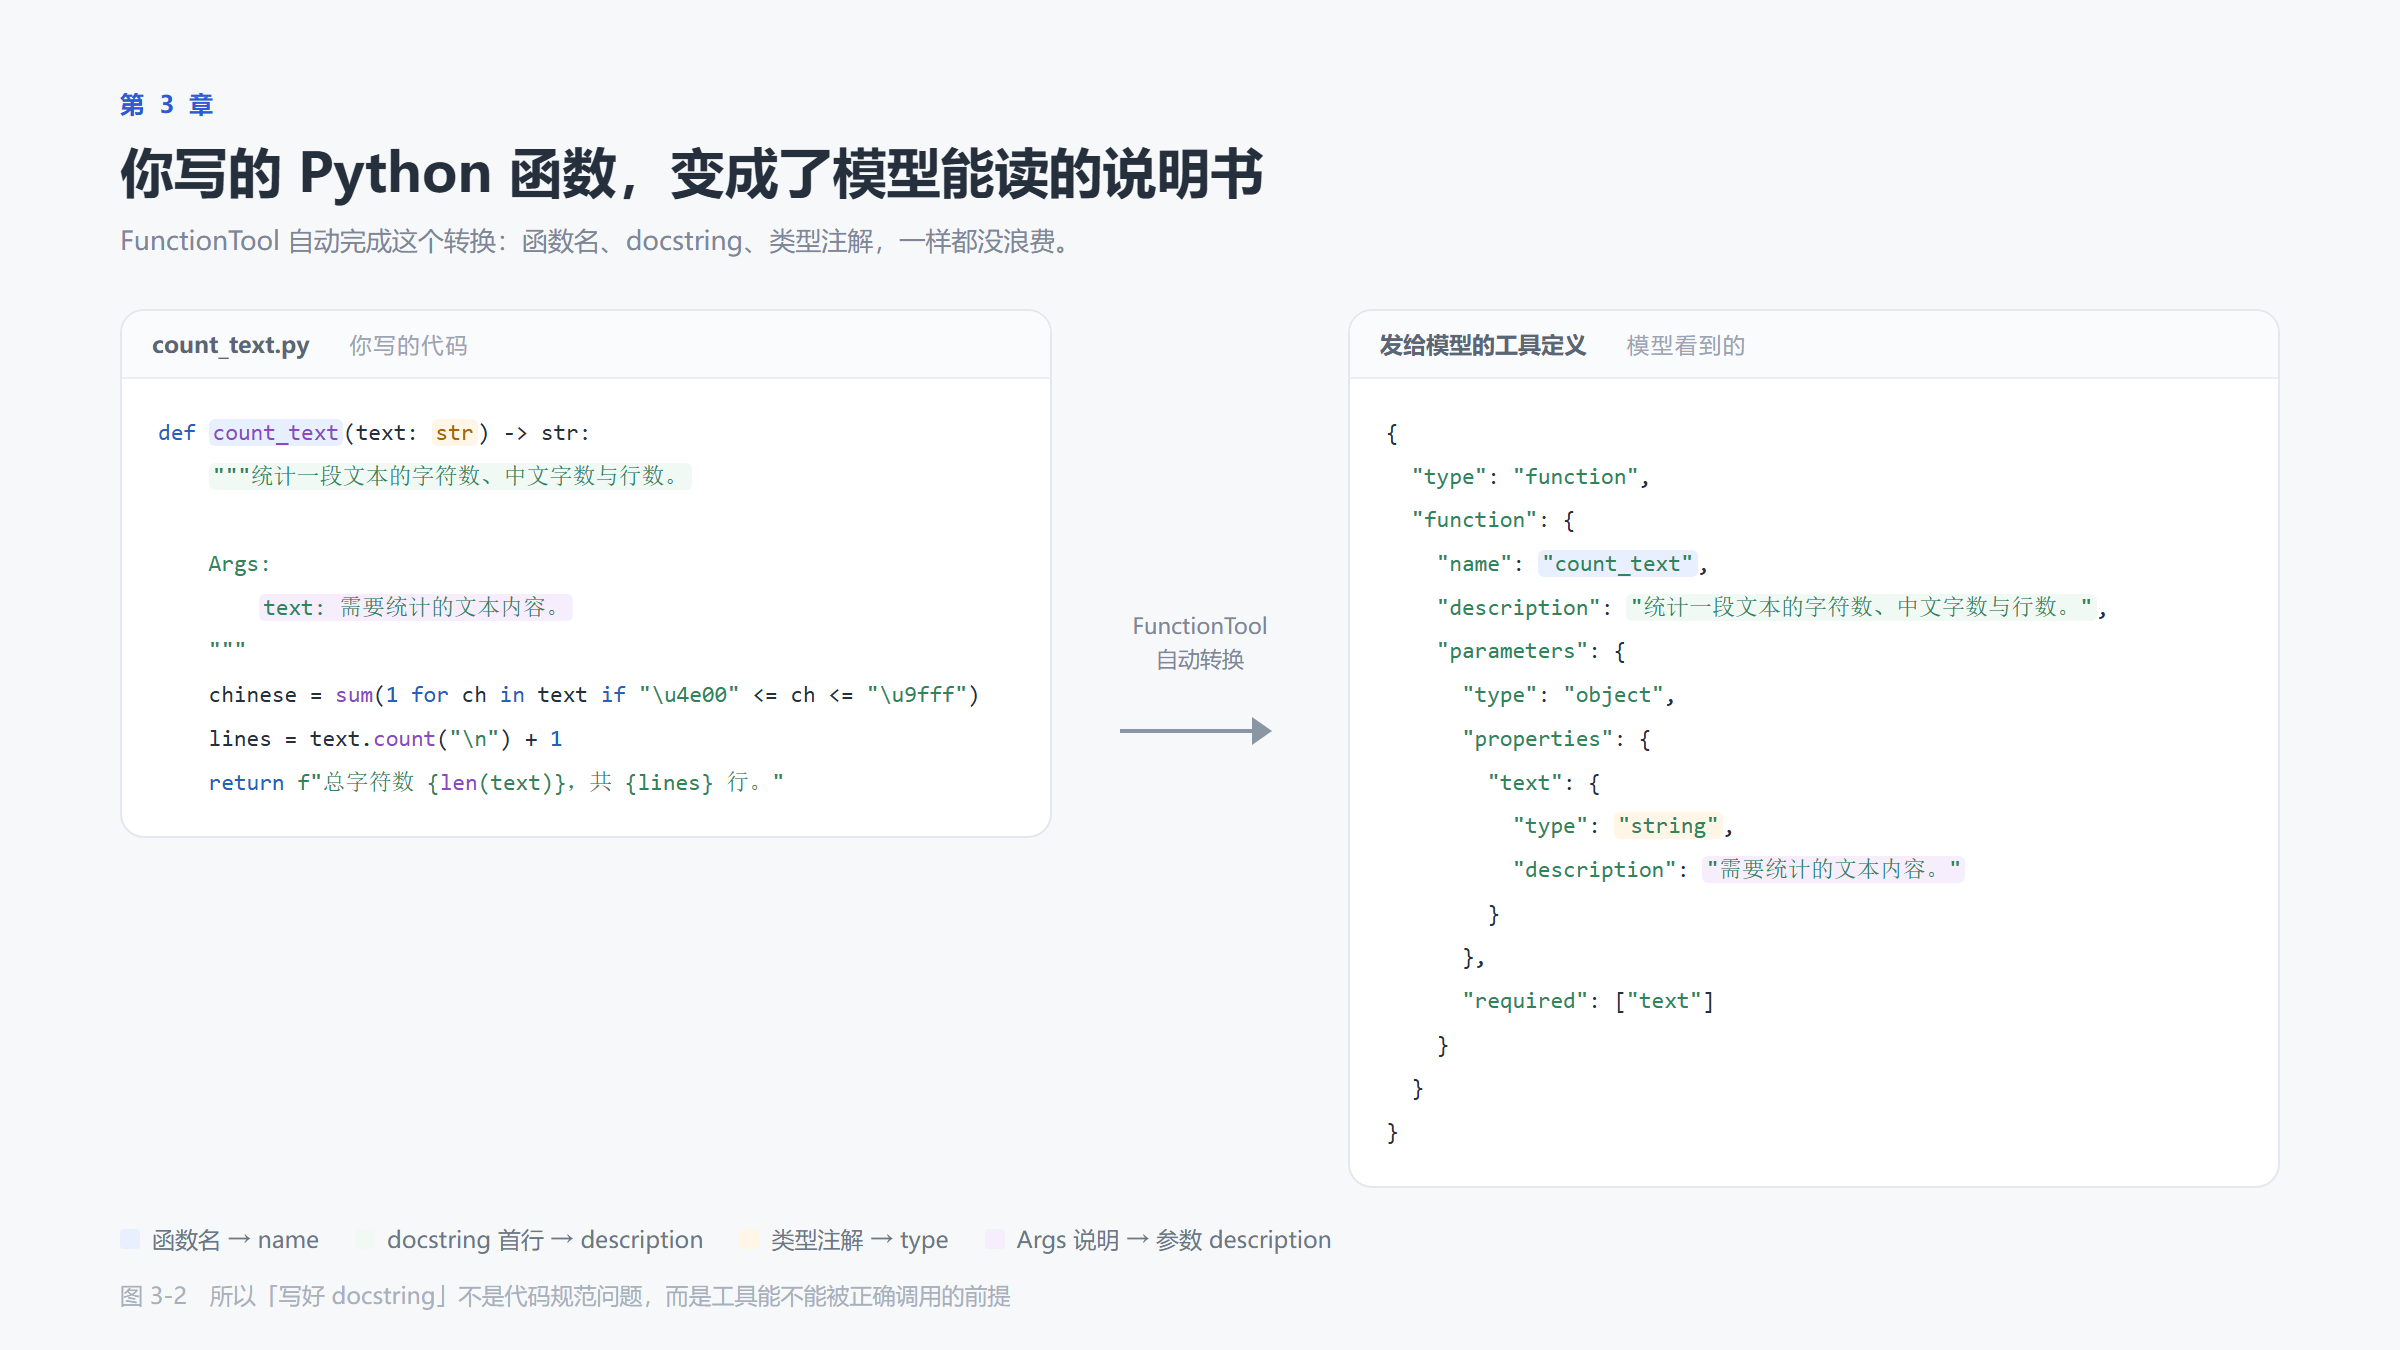
完整可运行版本在
code/ch03/schema_demo.py,python schema_demo.py即可。除了上面这段,它还多跑两个反例:少了类型注解、docstring 写得太敷衍时,schema 会缺成什么样——正好对应 3.6 节的错误 1 和错误 2。
四样东西被完整地用上了:
| 你写的 | 变成了 | 模型怎么用 |
|---|---|---|
函数名 count_text | name | 调用时指名道姓 |
| docstring 全文 | description | 判断什么时候该用这个工具 |
类型注解 text: str | parameters.properties.text.type | 构造合法参数 |
Args: 下的说明 | 参数的 description | 理解每个参数该填什么 |
这张图解释了一个常见现象:同一个模型,面对两个功能相同的工具,一个调得好、一个却出问题。差别也许不在代码逻辑,而在于 docstring 写得够不够清楚。
写工具描述的标准 不是"这个函数做了什么",而是"什么情况下应该用它"。 对比这两句:
计算两个数的和—— 模型得自己判断什么时候该算加法执行精确的算术运算。当需要计算、核对数字时必须使用本工具,不要心算—— 模型知道该在什么时候伸手 后者并不更长,但它给出了触发条件。
3.3 装配工具
有了函数,还要把它们登记到一个地方。这个登记处叫 Toolkit。
def build_toolkit() -> Toolkit:
    return Toolkit(
        tools=[
            FunctionTool(get_current_time),
            FunctionTool(count_text),
            Read(),    # 内置:读文件
            Write(),   # 内置:写文件
            Bash(),    # 内置:执行 shell 命令
        ],
    )
Toolkit 在整本书里扮演三个角色:
- 注册表:记住有哪些工具
- 出票员:把每个工具转成 JSON Schema,每次请求模型时附上
- 调度员:模型说要调
Read,它负责找到那个Read实例并执行
前两个角色你现在就能验证。Toolkit 有一个 get_tool_schemas() 方法(注意它是异步的),可以直接打印出"模型看到的世界"。
完整脚本在 code/ch03/list_tools.py,python list_tools.py 即可运行,同样不需要 API Key、不调用模型。核心就这几行:
async def print_tool_schemas(toolkit: Toolkit) -> None:
    for schema in await toolkit.get_tool_schemas():
        fn = schema.get("function", schema)
        params = fn.get("parameters", {}).get("properties", {})
        desc = (fn.get("description") or "").splitlines()[0]
        print(f"· {fn.get('name')}")
        print(f"  描述:{desc}")
        print(f"  参数:{list(params.keys()) or '无'}")
运行结果(真实输出):
==================================================================
模型能看到的工具清单
==================================================================
· get_current_time
  描述:获取当前的日期和时间。
  参数:无
· count_text
  描述:统计一段文本的字符数、中文字数与行数。
  参数:['text']
· Read
  描述:Reads a file from the local filesystem. You can access any file directly by using this tool.
  参数:['file_path', 'offset', 'limit', 'pages']
· Write
  描述:Writes a file to the local filesystem.
  参数:['file_path', 'content']
· Bash
  描述:Executes a bash command and returns its output.
  参数:['command', 'description', 'timeout']
这就是模型在第 ① 步收到的全部信息。它没有看过你的代码,只看了这五个工具的摘要。
脚本还会额外打印第一个工具的原始 JSON,让你看到摘要背后真正发出去的东西:
{
  "type": "function",
  "function": {
    "name": "get_current_time",
    "description": "获取当前的日期和时间。\n当用户询问\"现在几点\"\"今天几号\"\"星期几\"这类问题时使用本工具。\n你无法感知真实时间,遇到时间问题必须调用本工具,不要凭记忆回答。",
    "parameters": {
      "properties": {},
      "type": "object"
    }
  }
}
注意 description 是整段 docstring,不只是第一行。上面那个摘要为了好读只截了首行,模型实际看到的是全文——所以 docstring 里那句"遇到时间问题必须调用本工具"是真的会被模型读到的。
一个立刻能做的观察 五个工具,模型的"选择空间"是 5。等你加到 30 个工具,它挑错的概率会明显上升。这就是第 6 章要讲工具组、第 8 章要讲上下文管理的原因——工具不是越多越好,而是越清晰越好。
从这里开始,难度要往上爬一格了。
3.4 内置工具
AgentScope 自带一批覆盖常见操作的实现,直接实例化就能用:
| 工具 | 作用 | 只读 |
|---|---|---|
Bash | 执行 shell 命令 | 否 |
PowerShell | Windows 上执行 PowerShell | 否 |
Read | 按行号读取文件,返回带行号的文本 | 是 |
Write | 创建或覆盖文件 | 否 |
Edit | 在文件中做精确字符串替换 | 否 |
Glob | 按文件名模式查找 | 是 |
Grep | 按内容搜索(基于 ripgrep) | 是 |
TaskCreate / TaskList / TaskUpdate | 维护任务清单 | 否 / 是 / 否 |
AskUser | 向用户提出选择题(需 2.0.9+) | 是 |
"能执行代码"就是
Bash看到这里可能会想知道:这 Agent 到底能不能跑代码?能——但它没有叫run_code的工具,实际上用的是Bash。 甚至你可以把 Python 脚本封装成工具,让 Agent 直接调用,用代码去完成对话做不到的复杂任务。
这张表里最重要的不是工具名,而是最后一列。它标注的是"这个工具会不会改变世界"——第 7 章的权限系统完全建立在这一列上:只读工具可以放行,会写东西的工具必须拦住。
Write 还有一条容易被忽略的规则:先读后写。如果目标文件已经存在而你从未读过它,Write 会直接失败。这个设计是为了避免模型在没有看到原文的情况下盲目覆盖。
你现在可能觉得这条规则碍事。等到第 5 章它替你保住一份重要配置时,你会改变看法。
3.5 完整代码
到这里,我们的基础已经打好~
- 3.1 讲清了机制——模型只写申请单,框架才真正执行
- 3.2 讲了怎么把一个普通函数变成模型能读懂的说明书
- 3.3 讲了用
Toolkit把工具登记起来 - 3.4 讲了可以直接拿来用的内置工具
但前面每一段都是拆开讲的:count_text 单独出现过,Toolkit 单独出现过,Read/Write/Bash 只在表格里露了个脸。它们凑在一起能不能跑起来、跑起来是什么样,还没验证过。
这一节就把它们拼成一个完整的 Agent。脚本结构和前两章一样,只是多了工具这一层:
| 部分 | 作用 | 对应小节 |
|---|---|---|
build_model() | 连上模型 | 第 1 章 |
get_current_time() / count_text() | 两个自定义工具 | 3.2 |
build_toolkit() | 把 5 个工具装进注册表 | 3.3 |
print_tool_schemas() | 打印模型看到的世界 | 3.3 |
main() | 建 Agent,依次问三个问题 | 本节 |
运行前确认 .env 里配好了 OPENAI_API_KEY(第 1 章已经配过),然后 python main.py。
"""第 3 章:给它一双手。

比上一章多了什么:
  1. Toolkit —— 工具注册表
  2. 两个自定义工具(用 FunctionTool 把普通函数变成工具)
  3. 三个内置工具(Read / Write / Bash)
"""

import asyncio
import os
import sys
from datetime import datetime
from pathlib import Path

from dotenv import load_dotenv

from agentscope.agent import Agent
from agentscope.credential import OpenAICredential
from agentscope.message import UserMsg
from agentscope.model import OpenAIChatModel
from agentscope.permission import PermissionMode
from agentscope.tool import Bash, FunctionTool, Read, Toolkit, Write

load_dotenv(override=True)

API_KEY = os.getenv("OPENAI_API_KEY", "")
BASE_URL = os.getenv("OPENAI_BASE_URL", "")
MODEL_NAME = os.getenv("OPENAI_MODEL", "gpt-4o-mini")

def build_model() -> OpenAIChatModel:
    return OpenAIChatModel(
        credential=OpenAICredential(api_key=API_KEY, base_url=BASE_URL or None),
        model=MODEL_NAME,
    )

def get_current_time() -> str:
    """获取当前的日期和时间。

    当用户询问"现在几点""今天几号""星期几"这类问题时使用本工具。
    你无法感知真实时间,遇到时间问题必须调用本工具,不要凭记忆回答。
    """
    now = datetime.now()
    week = "一二三四五六日"[now.weekday()]
    return now.strftime("%Y-%m-%d %H:%M:%S") + f",星期{week}"

def count_text(text: str) -> str:
    """统计一段文本的字符数、中文字数与行数。

    Args:
        text: 需要统计的文本内容。
    """
    if not text:
        return "文本为空。"
    chinese = sum(1 for ch in text if "\u4e00" <= ch <= "\u9fff")
    lines = text.count("\n") + 1
    return f"总字符数 {len(text)},其中中文 {chinese} 个字,共 {lines} 行。"

def build_toolkit() -> Toolkit:
    """把工具装配成一个 Toolkit。"""
    return Toolkit(
        tools=[
            FunctionTool(get_current_time),
            FunctionTool(count_text),
            Read(),
            Write(),
            Bash(),
        ],
    )

async def print_tool_schemas(toolkit: Toolkit) -> None:
    """打印工具清单——这就是模型在每次推理前看到的东西。"""
    print("=" * 66)
    print("模型能看到的工具清单")
    print("=" * 66)
    for schema in await toolkit.get_tool_schemas():
        fn = schema.get("function", schema)
        params = fn.get("parameters", {}).get("properties", {})
        desc = (fn.get("description") or "").splitlines()[0]
        print(f"· {fn.get('name')}")
        print(f"  描述:{desc}")
        print(f"  参数:{list(params.keys()) or '无'}")
    print()

async def main() -> None:
    # 把工作目录切到本章脚本所在目录,这样模型写出的 fizz.py 会落在 code/ch03/,
    # 后面 `python fizz.py` 也能直接找到它。
    os.chdir(Path(__file__).resolve().parent)

    toolkit = build_toolkit()
    await print_tool_schemas(toolkit)

    agent = Agent(
        name="Buddy",
        system_prompt=(
            "你叫 Buddy,是一个住在命令行里的工作助手。"
            "需要用工具获取信息时必须调用工具,不要凭记忆猜测。短答即可。"
        ),
        model=build_model(),
        toolkit=toolkit,
    )

    # 这一章的脚本没有确认界面。Bash 这类工具默认会"停下来等人点头",
    # 在这个没有界面的场景里就会卡住,后面再发消息还会报错。
    # 先整体放行,把注意力放在"工具能不能用起来";第 7 章专门讲怎么管住它。
    agent.state.permission_context.mode = PermissionMode.BYPASS

    # 让 shell 里的 python 一定是当前这个解释器。原因见 3.5.1。
    os.environ["PATH"] = os.path.dirname(sys.executable) + os.pathsep + os.environ.get("PATH", "")

    questions = [
        "现在几点?今天星期几?",
        "帮我数一下这句话有多少字:今天天气不错,适合写代码。",
        # 第三问故意让它"写 + 跑":一次触发 Write、Bash 两个工具。
        "把 1 到 20 的 FizzBuzz 写成 fizz.py,"
        "然后用 python fizz.py 跑一遍,把标准输出原样贴给我。",
    ]

    for question in questions:
        print(f">>> 你:{question}")
        reply = await agent.reply(UserMsg(name="user", content=question))
        print(f"<<< Buddy:{reply.get_text_content()}")
        print()

if __name__ == "__main__":
    asyncio.run(main())
跑起来后,屏幕上会先出现 3.3 节那份工具清单,然后是三问三答。前两问很短,模型各调一次工具就收工:
>>> 你:现在几点?今天星期几?
<<< Buddy:现在是 2026-10-30 15:20:33,星期五。

>>> 你:帮我数一下这句话有多少字:今天天气不错,适合写代码。
<<< Buddy:总字符数 13,其中中文 11 个字,共 1 行。
这两句里的时间、字数都不是模型算出来的,是 get_current_time 和 count_text 的返回值被回传进上下文后,它照着念的。相比前两章,Agent 到这里才第一次真正"知道"了外部世界的事。
前两问都只是"查一下",答完就结束。第三问不一样:Agent 会在你的电脑上生成脚本文件,并且真的调起解释器把它跑一遍。
>>> 你:把 1 到 20 的 FizzBuzz 写成 fizz.py,然后用 python fizz.py 跑一遍,把标准输出原样贴给我。
<<< Buddy:`fizz.py` 已创建在 `code/ch03/`,运行 `python fizz.py` 的标准输出:

1
2
Fizz
4
Buzz
Fizz
7
8
Fizz
Buzz
11
Fizz
13
14
FizzBuzz
16
17
Fizz
19
Buzz
这一问里,3.1 节那个循环转了两圈:
- 第一圈,模型输出
Write的申请单,框架把fizz.py写到磁盘 - 第二圈,模型输出
Bash的申请单,框架执行python fizz.py
那 20 行输出不是模型"写"出来的。它只知道"我请框架跑了一条命令",输出是第 ④ 步回传进上下文的。它和你几乎同时看到这些数字。
顺带回答一个被反复问到的问题:"能执行代码"不是一项独立能力。 这里没有 run_code 工具,python fizz.py 走的就是 3.4 表里第一行那个 Bash。pytest、npm run build、git commit 全是同一条路。把 Bash 从 Toolkit 里删掉,本章的 Agent 立刻退回"只会读写文件"。
3.5.1 代码里的三个细节
上面这段代码能跑通,靠的是三处不那么显眼的写法。它们不是随手写的,值得逐个说明。
细节 1:system_prompt 里那句"必须调用工具"。
system_prompt=(
    "你叫 Buddy,是一个住在命令行里的工作助手。"
    "需要用工具获取信息时必须调用工具,不要凭记忆猜测。短答即可。"
),这句话不是装饰。模型有很强烈的"直接回答"倾向,尤其面对简单问题时。明确要求它在信息不足时调用工具,能显著降低幻觉率。这是提示词工程里最实用的技巧之一:给模型一条撤退路线,它才不会硬编。
细节 2:PermissionMode.BYPASS —— 先放行,第 7 章再管。
agent.state.permission_context.mode = PermissionMode.BYPASS给了 Agent Bash,就意味着它能直接操控你的电脑执行命令。这相当危险——理论上它可以删掉你硬盘里的文件。如果你用过 WorkBuddy,会发现它经常停下来问你"是否允许执行",那正是权限系统在工作。
本章脚本没有确认界面,Bash 默认会"停下来等人点头",不处理就会卡死。所以这里先整体放行,把注意力放在"工具能不能用起来"。PermissionMode 具体是什么现在不用深究,第 7 章会专门讲怎么把它管住——那时你会把这行删掉。
这也是本章三个问题写死在代码里、而不是做成
input()循环的原因:固定问题能保证每次跑出来都一样,也避免学习者随手输入一句"帮我清理下磁盘",然后 AI 真的去删文件。
细节 3:AI 是怎么知道 Python 解释器在哪里的
细心的读者可能会发现:Agent 执行脚本,本质上是在终端里跑了一句 python xxx.py。
那么问题来了:AI 是怎么知道我电脑上的解释器在哪里的?
哈哈,这里笔者使用了一个小技巧,便于大家去学习~~
模型在第 ② 步输出的申请单,内容就是一句 python fizz.py。它不知道你的 Python 装在 E:\anaconda 还是 C:\Python312,它只是照着"人类一般这么敲"写了一句命令。
真正把 python 变成"某个具体的 exe"的,是第 ③ 步执行命令的那个 shell。shell 拿到 python 后,会去环境变量 PATH 里列出的目录中按顺序挨个找,找到第一个 python.exe 就用它。
那代码里这行是干什么的?
os.environ["PATH"] = os.path.dirname(sys.executable) + os.pathsep + os.environ.get("PATH", "")sys.executable 是当前正在运行 main.py 的那个解释器的完整路径。这行把它所在的目录插到 PATH 最前面,于是 shell 找 python 时第一个就撞上它。
为什么非要这么做?因为 Python 装在哪里因人而异,与其把解释器路径写死进提示词,不如直接复用"正在跑脚本的这一个"——它一定存在,也一定是能跑通本章代码的那个版本。
当然,你也可以把解释器的绝对路径直接写进上下文,让模型在命令里带上完整路径。两种做法都行:前者省事、不用改代码;后者更明确,适合一台机器上装了多个 Python 版本的场景。
有读者会卡在这里:解释器到底是什么?其实很简单——你在本地执行
python xxx.py时,命令里那个python本身就是电脑上的一个可执行文件,在 Windows 上叫python.exe。是它把你的代码读进去、一行行执行,所以叫"解释器"(interpreter)。真正干活的是这个可执行文件,xxx.py只是它的输入。于是也可以让 AI 自己写代码、写完让解释器跑一遍。这一步要在你的机器上成立,前提是机器上得有 Python。
但 WorkBuddy 不需要这个前提:它自带一份托管的 Python 运行时。所以哪怕你的电脑从没装过 Python,也能让它直接跑 Python 脚本——它用的是自带的那份解释器,而不是你系统里的。这不是什么魔法,只是把运行时一起打包了。
3.5.2 模型写错了代码,会怎样
有的读者可能就会问:万一 AI 把代码写错了怎么办?
AI 再厉害,也不能保证每次都一次写对。
那假设它生成的 fizz.py 里少了个冒号:
for i in range(1, 21)
    print(i)
接下来发生的事,正好是 3.1 节那个循环在起作用:
- 模型输出
Write的申请单,框架把这份有 bug 的代码写到磁盘——这一步不会报错,Write只负责写,不负责检查语法 - 模型输出
Bash的申请单,框架执行python fizz.py - Python 解释器报错,
Bash把 stderr 原样作为工具结果返回 - 模型在下一轮上下文里看到
SyntaxError: invalid syntax,自己补上冒号,重新Write+Bash
关键在于第 3 步:Bash 的错误信息不会被框架吞掉,它会作为工具结果原样进上下文,这样模型"看得见"自己错在哪。
于是它就能自己改掉代码里的错误,再写、再跑、再看——写代码、运行代码、修改代码,这个循环一旦转起来,一个不知疲倦的打工人就诞生了。
3.6 三个常见错误
错误 1:函数没有类型注解
def count_text(text):        # 少了 : str
    ...
生成的 schema 里 required 照样列着 text,但它的定义塌成了一个空对象 {}——没有 type,也没有参数说明。模型知道有个叫 text 的参数,却不知道它该填字符串还是数字。表现是工具确实被调用了,参数却常常填得不对。
错误 2:docstring 只写了函数名
def count_text(text: str) -> str:
    """统计文本。"""
"统计文本"这四个字,模型无法判断该在什么时候用:统计字数?统计词频?统计行数?结果就是它该用的时候不用,不该用的时候乱用。
写 docstring 的时候,把自己当成在跟一个刚入职的同事交代工作:什么情况用、输入是什么、输出是什么。
错误 3:工具返回了非字符串
def get_stats(text: str) -> dict:      # 返回 dict
    return {"chars": len(text)}
工具的执行结果最终要作为文本进入模型的上下文。返回 dict 在简单场景下可能被自动序列化,但复杂对象、None、异常对象都可能出问题。统一返回字符串,需要结构化数据时自己 json.dumps(..., ensure_ascii=False)。
3.7 小结
- 工具的实质是模型输出一段结构化申请,框架代它执行
FunctionTool把函数名、docstring、类型注解转成模型能读的 JSON Schema- docstring 要写"什么情况下用它",而不是"它做了什么"
Toolkit是注册表、出票员、调度员的合体- 执行代码没有专用工具:
Bash/PowerShell就是。写代码 → 跑起来 → 看报错,是检验工具链最短的一条路
下一章要解决的问题:3.1.1 那张图里,第 ⑤ 步写着"再问一次模型,若还要调工具就回到第 ② 步"。这一轮到底转了几次、什么时候停、停不下来怎么办——这就是 ReAct 循环,也是整套框架真正的心脏。