第 8 章 长任务不迷路
本章代码
code/ch08/main.py、code/ch08/context_lab.py· 读完约 20 分钟
8.0 上一章留下的问题
第 7 章的 Buddy 会干活、会守边界,也知道什么时候该问人。可任务一长,它就露出两个毛病,而且这两个毛病根子上是同一个。
让它整理工作区里 20 个文件,做到第 7 个它可能忘了还剩哪些,也可能把第 3 个重做一遍。这跟聪明不聪明没关系,它的记忆就是一串不断往后追加的消息,走到第 30 步的时候,第 2 步在任务描述里写下的那三条要求,早被埋在几千 token 之前了。
另一个毛病更硬。每来一次工具结果就往上下文里追加一段,读 20 个文件就是 20 份原文。窗口一满只剩两条路,要么调用直接报错,要么悄悄把最早的消息扔掉。而最早那条,往往正好是原始要求。
这两件事得分开治。一件事靠给模型配本外部笔记,另一件靠给上下文装道闸门。本章先动闸门,因为它能跑出数字。任务清单留到 8.5,等你亲眼看见压缩扔掉的是什么,也就明白那本笔记为什么省不掉了。
先别急着改配置,跑一遍看看 token 是怎么涨的~~
8.1 先跑六轮检索,看 token 怎么涨
code/ch08/context_lab.py 用假模型跑同一份工作负载,不花 API 费用,也不需要 key。直接跑。
python code/ch08/context_lab.py工作负载是六轮检索,每轮工具结果约 1500 token。两组配置只改窗口大小。第一组给到 100 万,大到六轮跑完也碰不到触发线,压缩一次都没发生。第二组给 4000,触发线 0.8 就是 3200 token,压缩会在六轮内发生。4000 是实验参数,不是推荐值,它足够小,能让该发生的都发生。真实模型要按自己的实际窗口设置。
输出是这样。
=== 关闭压缩(大窗口) ===
每次模型调用时的输入 token 数:
  144 -> 1652 -> 3160 -> 4668 -> 6176 -> 7684 -> 9192
峰值 9192 末值 9192
上下文消息数 2 摘要长度 0

=== 开启压缩(4k 窗口,触发线 3200) ===
每次模型调用时的输入 token 数:
  144 -> 1652 -> 3160 -> 4936 -> 258 -> 1766 -> 3542 -> 258 -> 1766
峰值 4936 末值 1766
上下文消息数 1 摘要长度 293
摘要: <system-info>Here is a summary of your previous work # Task Overview 用户要求分 6 批检索资料,最后汇总成一份结果。…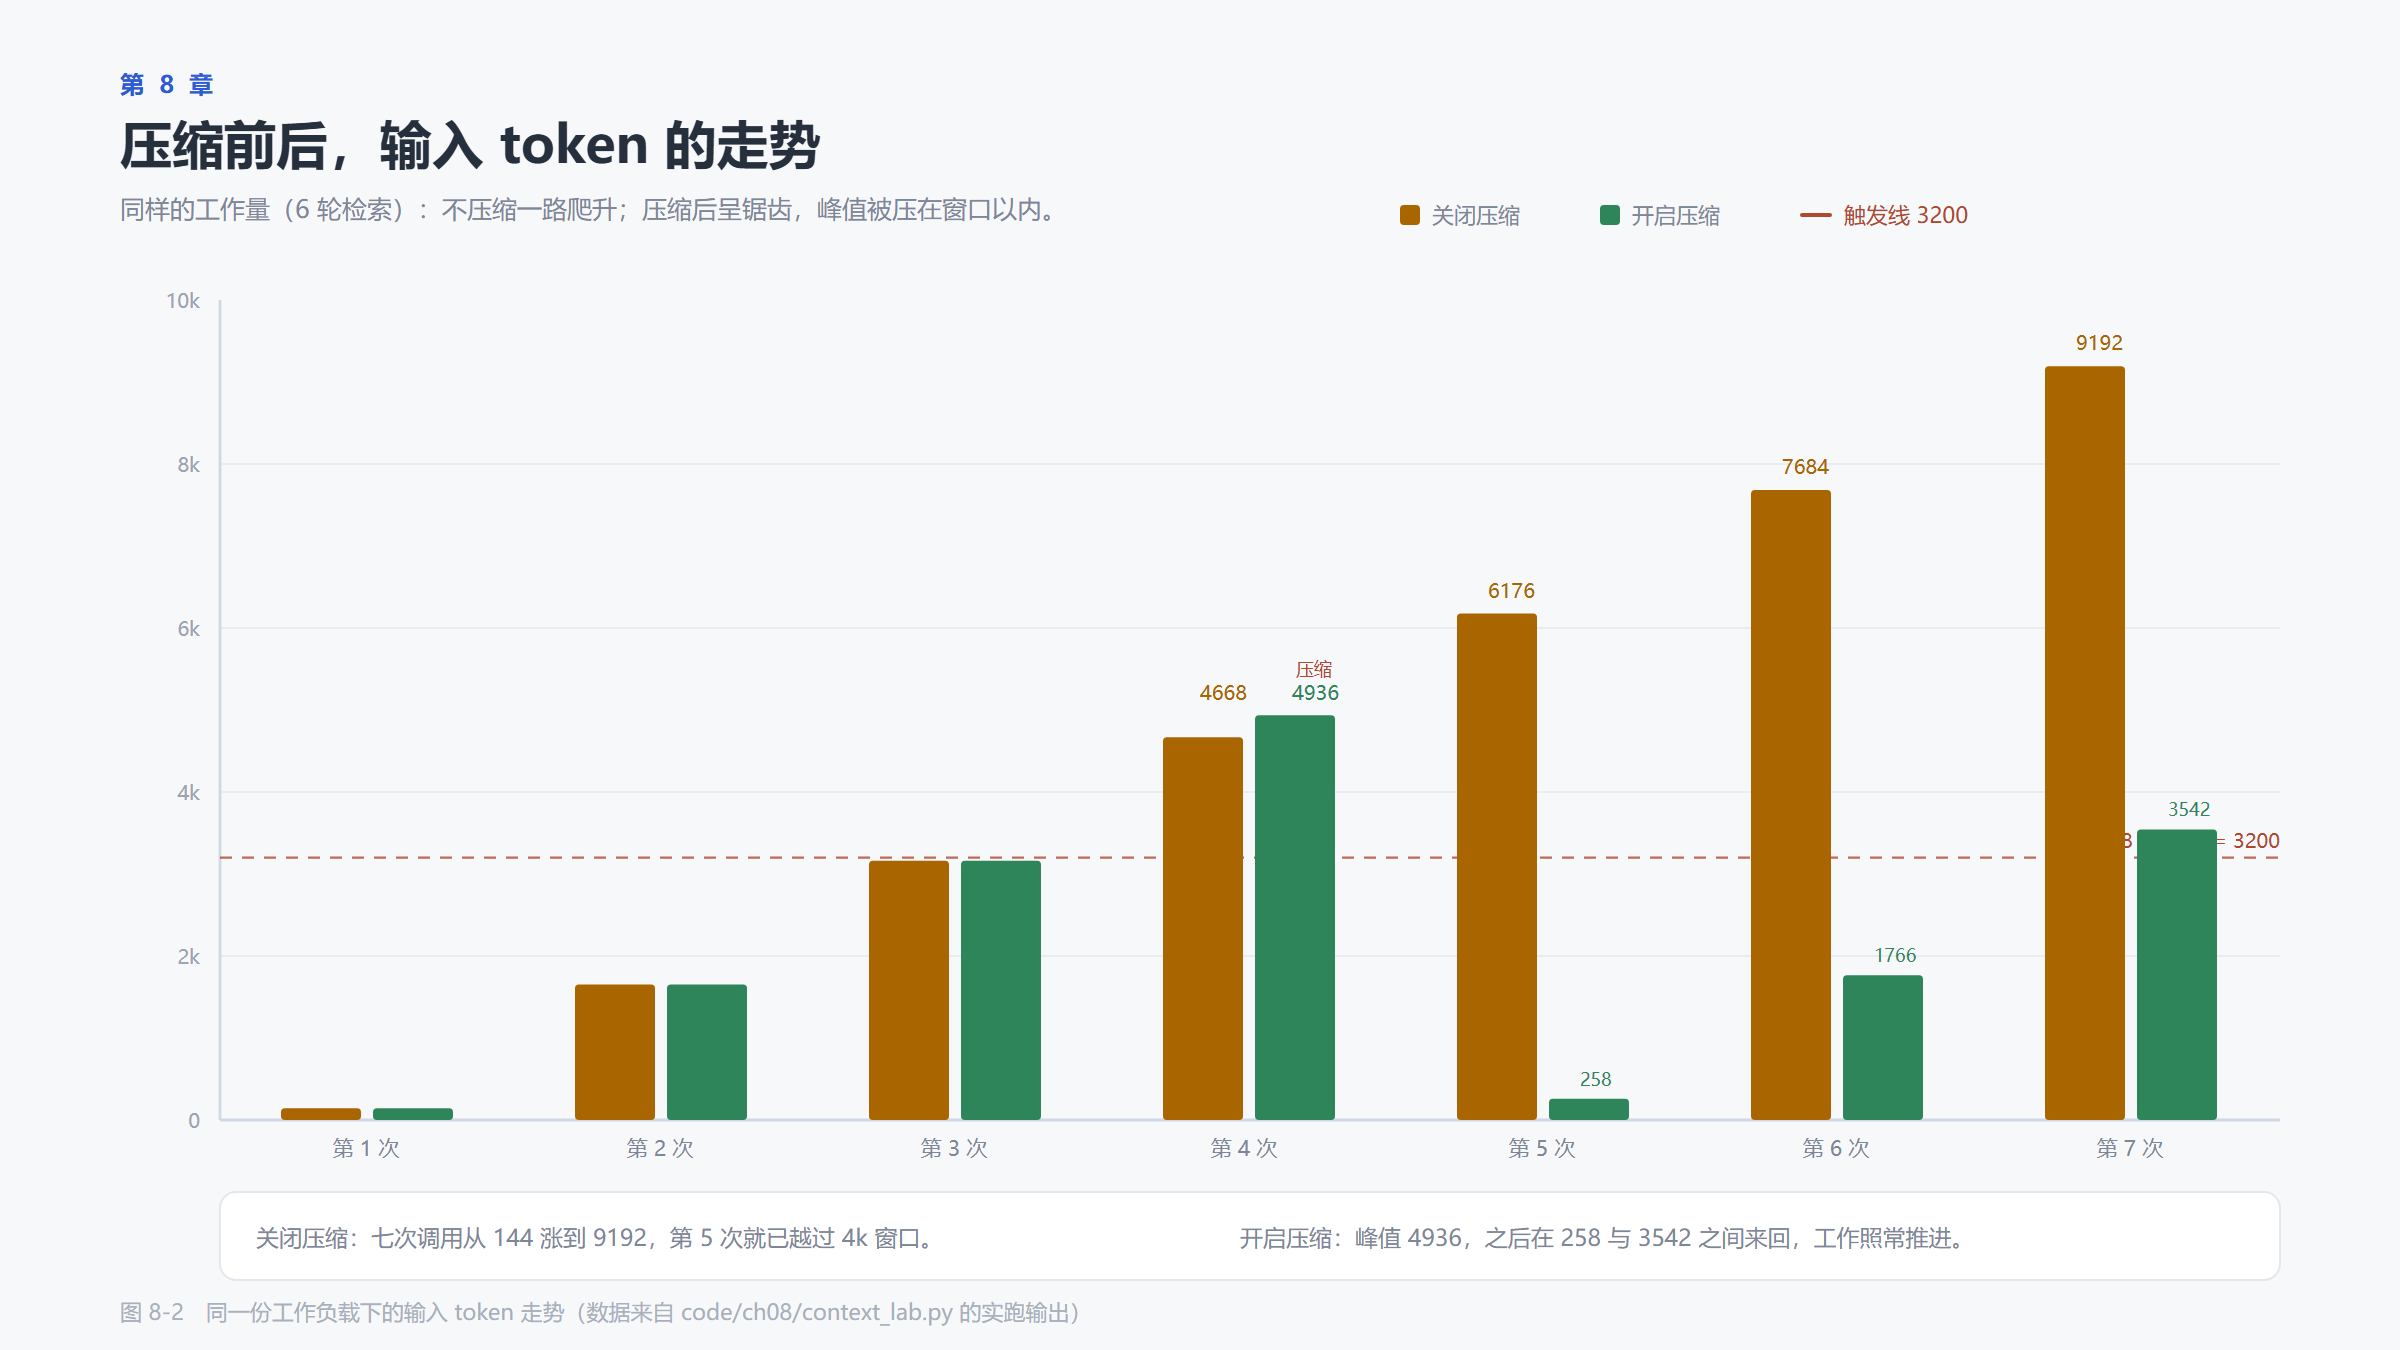
图 8-1 同一份工作负载下的输入 token 走势,数据来自 code/ch08/context_lab.py 的实跑输出
先别被那串数字绕晕,它混了两种调用,正常推理的序列是下面这串。
144 -> 1652 -> 3160 -> 258 -> 1766 -> 258 -> 1766多出来的 4936 和 3542 是压缩摘要请求的输入,不是对话上下文。所以 峰值 4936 也不是上下文峰值,只是所有调用里的最大值。
三条结论,每一条都值得停一下。
第一,不压缩时上下文随工具结果线性增长。 每轮加 1500 token 左右,六轮后每次调用都要带 9192 token。按这个斜率,二十轮就过了三万。
第二,压缩后正常上下文是锯齿。 3160 之后压到 258,再涨到 1766,第二次压缩又回到 258。摘要只有 293 字,起点很低,但之后照样继续累积。
第三,压缩不是免费的。 4936 和 3542 这两次尖峰是压缩摘要本身的开销,框架要额外发一次模型请求,把旧上下文总结成摘要。窗口设成 4000 时,第一次压缩前上下文已经到 4668,超过窗口本身。脚本跑到这一步,stderr 会打一条 WARNING,去掉每行都会变的时间戳,原文是这样。
WARNING | _agent:_compress_context_impl:622 - The current context length exceeds the model's context length (4000 tokens), the compression maybe failed due to insufficient reserved context for compression.压缩请求自己也要吃上下文,窗口卡得太死就转不开身。8.3 会把 trigger_ratio 和 context_size 这两个余量怎么留讲清楚。
同一台机器,同一个假模型,只是窗口不同,末值从 9192 掉到 1766。差别不在提示词,在框架替你动了一次上下文。要弄明白它动了哪一块、没动哪一块,得先看上下文里到底装了什么。
8.2 上下文的三个抽屉
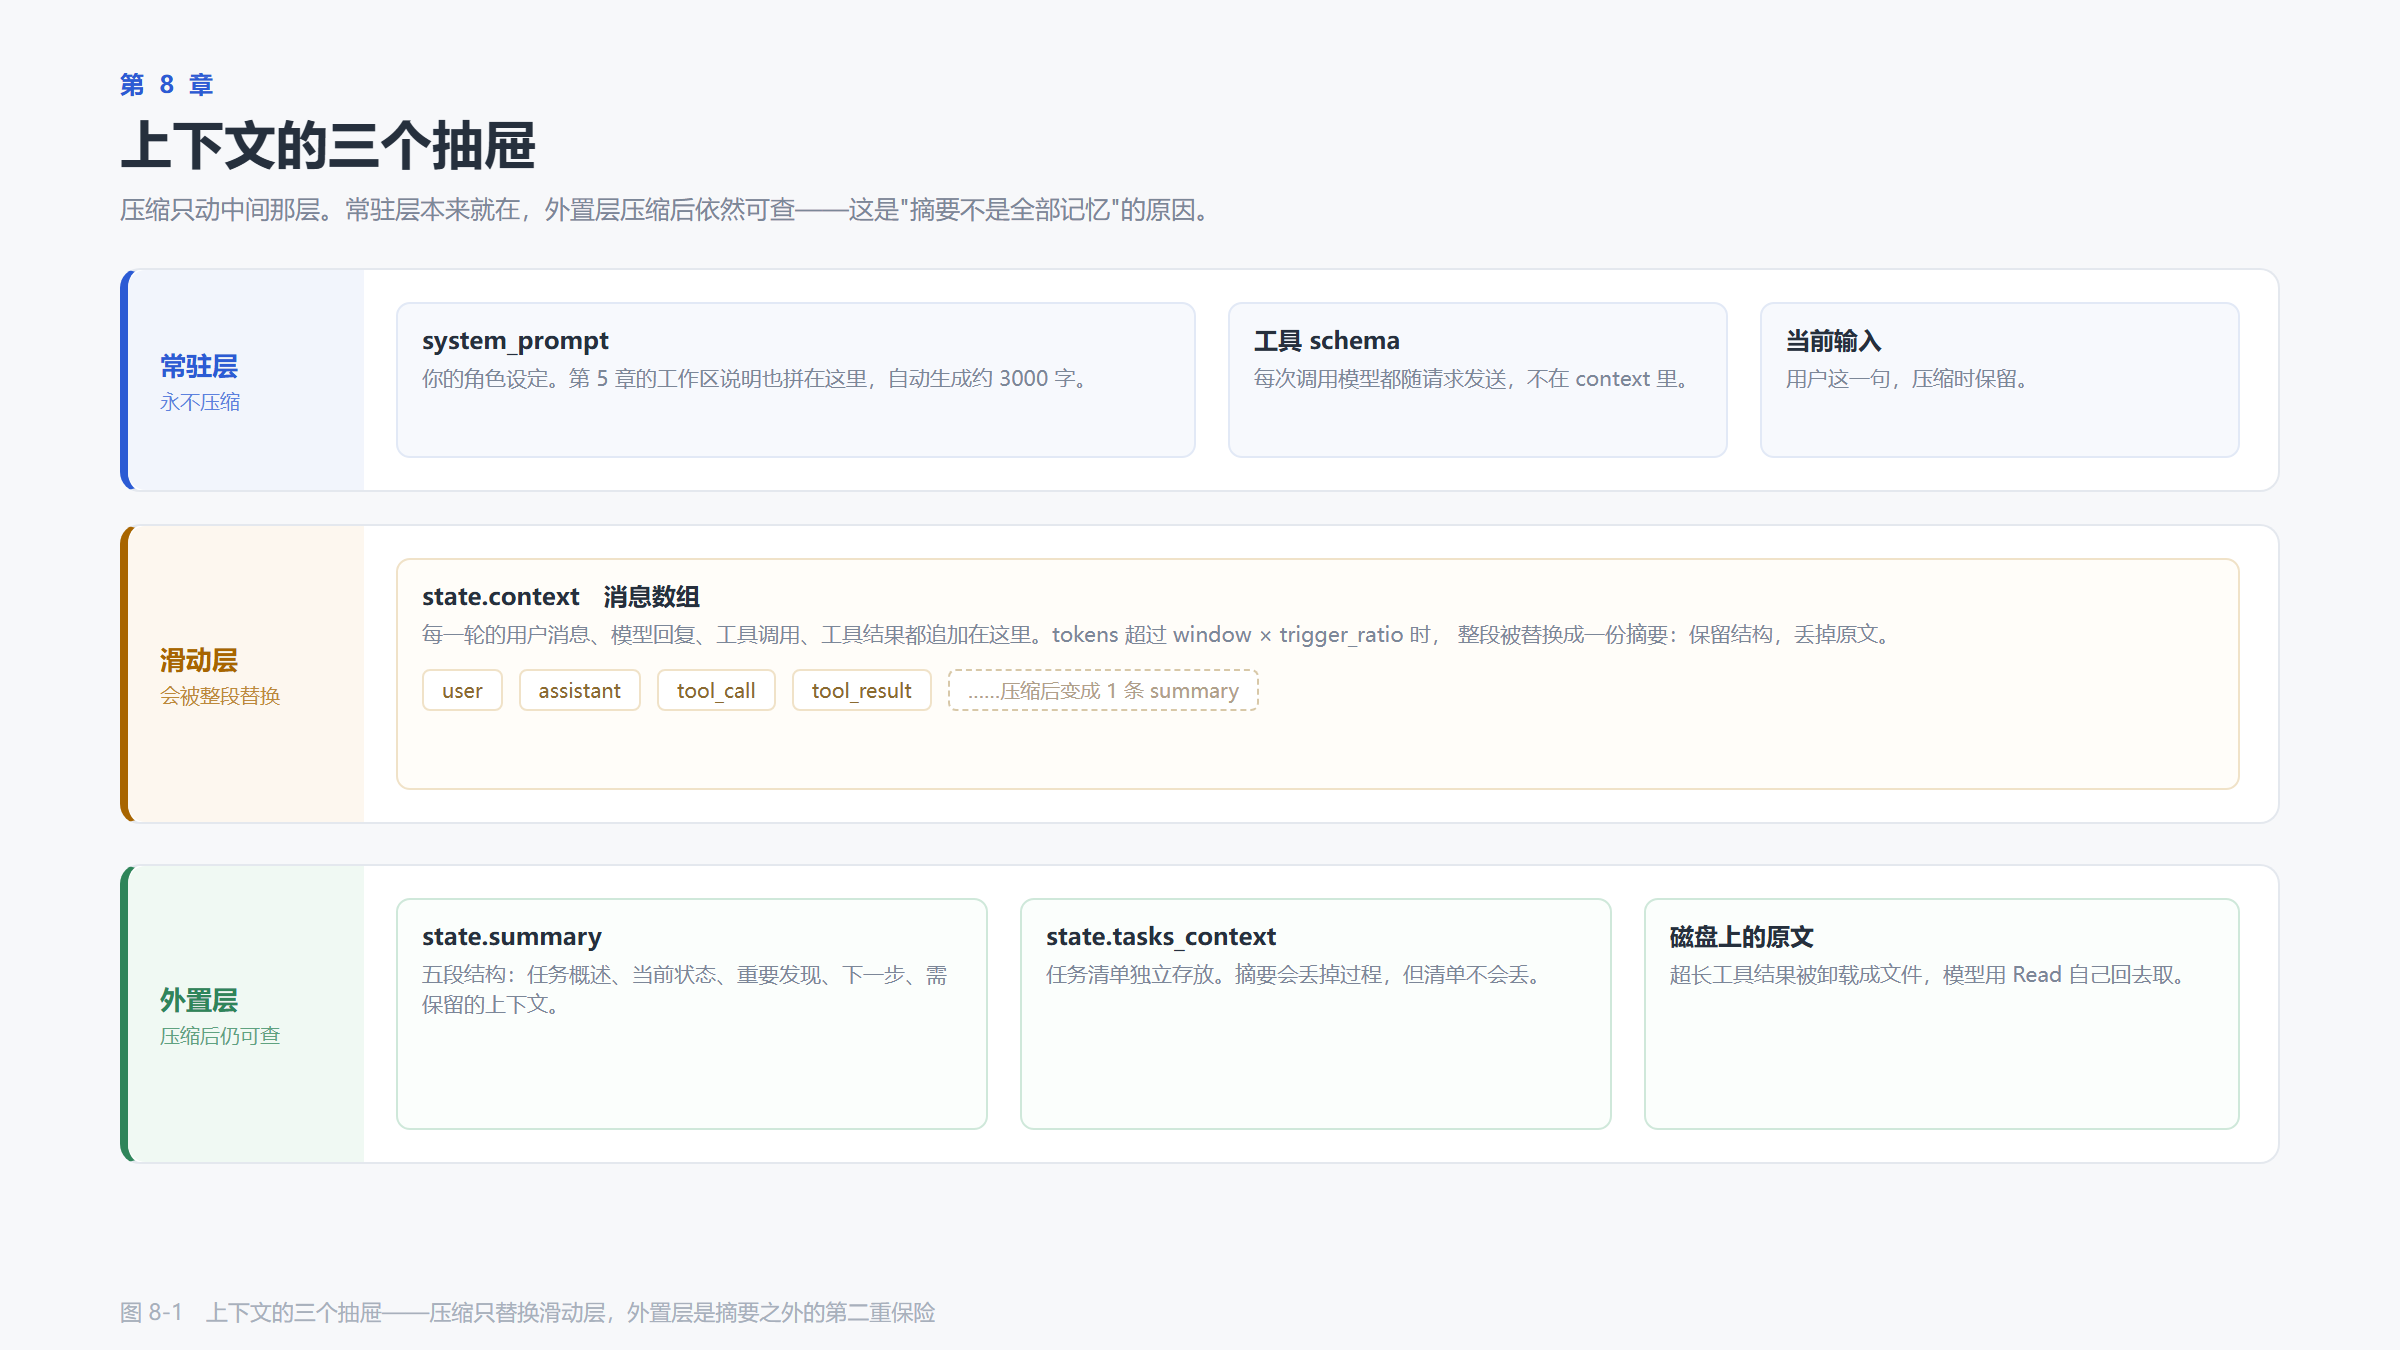
图 8-2 上下文的三个抽屉,压缩只替换滑动层,外置层是摘要之外的第二重保险
三层分开看。
常驻层是 system_prompt 和工具 schema。前者每次调用都完整发送,后者不在消息数组里,作为请求的独立字段。这一层不参与压缩,它是"你是谁",压掉就没法干活了。
滑动层是 state.context,一个消息数组。用户的每句话、模型的每次回复、每次工具调用与结果,都追加在这里。三层里只有这一层会被压缩。
外置层有三样东西,都独立于消息数组。
state.summary,压缩产生的摘要state.tasks_context,任务清单,压缩不影响- 磁盘上的文件,超长的工具结果被卸载成文件,模型需要时用
Read自己回去取
这个分层回答了一个常见的疑问。摘要会不会把重要信息弄丢?会丢细节,但不丢线索。摘要保留的是"什么文件、第几步、遇到什么错",原文如果需要,还在磁盘上。8.1 里输入掉到 258 token 之后还能接着跑,靠的就是这段摘要加这三层。
顺带说一句,任务清单也在外置层。8.5 会讲它为什么非得放在这儿,现在先记住压缩碰不到它。
8.3 四个数字决定生死
Agent 的构造参数里有一个 context_config。
agent = Agent(
    ...,
    context_config=ContextConfig(
        trigger_ratio=0.8,
        reserve_ratio=0.1,
        tool_result_limit=50_000,
    ),
)
这段配置给 Agent 装上上下文闸门。上下文用到窗口 80% 时触发压缩,压缩后保留 10% 空间,单条工具结果超过 5 万 token 就把超出部分交给 offloader 落盘。
字段的默认值来自 ContextConfig 的定义。
表 8-1 ContextConfig 的关键字段
| 字段 | 默认值 | 含义 |
|---|---|---|
trigger_ratio | 0.8 | 用量达到窗口的多少比例时触发压缩。取值必须 >0 且 <=0.9 |
reserve_ratio | 0.1 | 压缩后为目标保留多少空间 |
context_buffer_ratio | 0.2 | 触发前的预警带宽度,进入这条带就会收到"即将压缩"的提示 |
tool_result_limit | 50000 | 单条工具结果的 token 上限,超出部分交给 offloader 卸载 |
compression_fallback_to_truncation | True | 摘要生成失败时,退化为截断最早的消息 |
compression_tool_enabled | False | 是否额外提供一个"主动压缩"工具给模型 |
max_image_num | 5 | 上下文里最多保留几张图片 |
触发线的算法是乘法,写在源码里。
# 触发压缩的 token 阈值 = 上下文窗口大小 × 触发比例
threshold = context_config.trigger_ratio * model.context_size
所以 context_size 是个关键量。它来自模型对象,OpenAIChatModel 自己的默认值是 128000,32768 是更底层的 ModelBase 默认值,不同 2.x 小版本之间也可能调整过,别指望记准。用第三方兼容接口时这个值可能就是错的。你的模型其实只有 32k,它以为有 128k,压缩迟迟不触发,最后 API 直接回 400。显式传一次最稳妥。
OpenAIChatModel(credential=..., model=..., context_size=32_768)trigger_ratio 为什么限制在 0.9 以下?压缩自己也要消耗上下文,它得把整段历史连同"请写一份摘要"的指令一起发给模型。留不出这 10%,压缩请求本身就会超限。8.1 那条 WARNING 就是余量没留够的样子。
8.4 压缩发生时到底做了什么
压缩按六步走。
- 每次模型推理前检查。ReAct 循环每次进入
Reasoning前都会调用compress_context(),另外cur_iter == 0时还会额外注入一条"上下文快满了"的提示 - 用
model.count_tokens()估算当前输入大小。基类实现很简单,字节数除以 4 - 超过
trigger_ratio × context_size就进入压缩 - 先试摘要。把历史消息加上
compression_prompt发给模型,要求按summary_schema输出五个字段 - 失败则截断。
compression_fallback_to_truncation=True时删掉最早的消息,把 summary 写成一句<system-info>Some earlier messages were truncated for limited context.</system-info> - 用
summary_template把五个字段渲染成一段<system-info>文本,替换掉整段历史
摘要的五个字段值得单独看一遍,它其实是一份好的交接文档该有的结构。
| 字段 | 要求 |
|---|---|
task_overview | 用户的核心请求与成功标准,含澄清与约束 |
current_state | 已完成什么,产出在哪个路径 |
important_discoveries | 技术约束、做过的决策与理由、踩过的错 |
next_steps | 具体待办、阻塞项、优先级 |
context_to_preserve | 用户偏好、承诺、不明显但重要的领域细节 |
框架给的 compression_prompt 里还有一条硬要求,容易被忽略。摘要里的一切引用必须自包含。相对时间要换成绝对日期,"那个文件"要换成完整路径,"那三个失败的用例"要换成用例名。原因是这份摘要将来可能被再压缩一次,两次之后,任何需要回看原文才能理解的表述都会失效。
8.1 输出里那句以 Here is a summary of your previous work 开头的 293 字,就是第 6 步渲染出来的。它替换了整段历史,任务清单和磁盘文件都还在原地。
8.5 压缩会丢过程,清单不会
现在回头看 8.0 的第一个毛病。摘要再完整,也是一段被压扁的文字,它记不住"20 个文件里还有 7 个没写摘要"。要治这个,得把进度放到上下文之外。
先做一个思想实验。同一个任务,两种提示方式。
方式 A:帮我整理这 20 个文件,为每个写一行摘要。
方式 B:帮我整理这 20 个文件。先用 TaskCreate 建 20 条任务,
        每做一条就标记 in_progress,做完标记 completed。
差别不在措辞,在于状态被外置了。
方式 A 里,"还剩哪些没做"是一个需要模型自己维护的隐式状态。走到第 15 步,它得从上下文里翻出最初那句话,再减去自己已经做过的事。这是推理负担,而且会随步数增加越来越不可靠。
方式 B 里,这个状态变成了一条 TaskList 调用。模型不需要记住任何东西,动手前查一次就行。查清单是一次工具调用,不是一次回忆。
这就是外部笔记本的全部含义。它顺便还带来两个好处,你能从外面看见进度,中断之后可以照单接着做。
AgentScope 把这本笔记本放在 agent.state.tasks_context 里,与上下文消息数组平行存放。8.2 说过这一层不参与压缩,所以上下文被压到只剩一段摘要之后,清单还是完整的。
四个开箱可用的工具,加进 Toolkit 即可。
from agentscope.tool import TaskCreate, TaskGet, TaskList, TaskUpdate

toolkit = Toolkit(tools=[
    *workspace_tools,
    TaskCreate(), TaskList(), TaskUpdate(), TaskGet(),
])
构造参数为空。它们怎么拿到 Agent 的状态?框架在分发调用时自动注入了一个参数 _agent_state。
async def call(self, _agent_state: AgentState, subject: str, description: str, ...)这一点在写自定义工具时值得记住。参数名以下划线开头,模型看不到它,框架会替你填。你自己写工具时也可以用它拿到状态。
任务对象 Task 的字段如下,来自 agentscope.state。
| 字段 | 类型 | 说明 |
|---|---|---|
id | str | 创建时自增得到,从 "1" 开始 |
subject | str | 一句话标题 |
description | str | 详细说明 |
state | "pending" / "in_progress" / "completed" | 注意字段名是 state,不是 status |
owner | str | None | 归属,多人协作时用 |
blocks / blocked_by | list[str] | 依赖关系,存的是任务 id |
metadata / created_at | — | 附加信息与创建时间 |
有个名字不一致的地方要留意。TaskUpdate 的 status 参数有四个取值,前三个 pending / in_progress / completed 才是真正的任务状态,会写进 Task.state。第四个 deleted 不是状态,是一条删除命令。TaskUpdate.call() 里对它单独处理,直接把任务从 tasks_context.tasks 里 pop() 掉然后返回,后面的 task.state = status 根本不会执行。任务对象都没了,自然不会有 state="deleted"。同一个 status 字段兼了改状态和删任务两个职责。
不接模型也能验证这套工具。下面直接调用 call(),手工把状态传进去。代码节选了两次建任务,输出里还含一次状态变更和一次清单查询。
from agentscope.state import AgentState

state = AgentState()

await TaskCreate().call(_agent_state=state, subject="清点沙箱目录", description="列出 sandbox 下所有文件")
await TaskCreate().call(_agent_state=state, subject="生成目录摘要", description="写一份 notes.md")
真实输出如下。
[create] Task (id=1) created successfully: 清点沙箱目录
[create] Task (id=2) created successfully: 生成目录摘要
state.tasks: [('1', '清点沙箱目录', 'pending'), ('2', '生成目录摘要', 'pending')]

[update] Update task (id=1) status.
state.tasks: [('1', '清点沙箱目录', 'in_progress'), ('2', '生成目录摘要', 'pending')]

[list] 1 [in_progress] 清点沙箱目录
       2 [pending] 生成目录摘要
TaskList 的返回值就是模型看到的东西,两行文本,带状态。它足够短,短到每次重新读一遍都不心疼。
到这里两条线接上了。压缩会丢掉过程,清单不会丢。上下文被压到只剩一段摘要之后,模型第一件事应该是 TaskList,而不是重新规划一遍。
8.6 注入:把易变信息从 system prompt 里拿出来
有一类信息会变,但又不该写进 system prompt。现在几点、还有几个任务没做完、上下文快到顶了、某个工具连续失败三次了。
写进 system prompt 是错的,system prompt 每轮原样重发,改它相当于改人设。全塞进用户消息也是错的,那会干扰用户的原话。
AgentScope 的做法是在每轮开始前拼一条 HintBlock,追加到上下文末尾。缓存的键是注入内容的类别。
| 注入项 | 触发条件 | 内容 |
|---|---|---|
current-time / timezone | 距上次注入超过 time_interval(默认 0.5 小时) | 当前时间与所在时区 |
tasks | 存在未完成任务,且模型尚未感知到 | "你有 N 个进行中、M 个待办任务" |
context-length | 用量进入预警带 | "当前 N token,到 M 时会压缩" |
tool-error | 同一工具、同样参数连续失败达到 tool_retries_limit(默认 3) | 见下方提示模板 |
时间注入有个节流细节。不是每轮都注入,而是距上次注入超过半小时才再注入一次。一轮快速连续的调用里时间几乎没变,重复注入纯属浪费 token。
工具重复失败的提示模板是现成的。
The last {count} calls to '{tool_name}' with the same arguments all failed.
Stop retrying the same call as-is, check the error message and try a different approach.
这句话解决了一个很常见的死循环。模型不信邪,把同一个调用原样重试五遍,注入之后它才知道要换个方法。
配置入口是 injection_config。
injection_config=InjectionConfig(
    timezone="Asia/Shanghai",     # 默认 UTC,国内项目一定要改
    time_format="%Y-%m-%d %H:%M",
    time_interval=0.5,
)
time_format 必须带日期。只写 %H:%M:%S 的话,解析出来的时间会落到 1900 年,节流跟着失效,每轮都重新注入。
emit_hint_event 默认是 True,不用显式写。它让 HintBlock 也出现在事件流里,第 12 章的前端要画一个调试抽屉,把这些注入显示出来。本章的 render() 已经在处理 HINT_BLOCK 事件,运行时能直接打出下面这行。
[注入] <system-reminder>Treat the following as the ground truth at this point8.7 完整代码
code/ch08/main.py 把三件事拼在一起,任务工具、上下文闸门、注入配置。
toolkit = Toolkit(tools=[
    *workspace_tools,
    TaskCreate(), TaskList(), TaskUpdate(), TaskGet(),
])

agent = Agent(
    name="Buddy",
    system_prompt=(
        "你叫 Buddy,做事之前先列计划。"
        "任务超过三步时,用 TaskCreate 建清单,"
        "开始做时用 TaskUpdate 标记 in_progress,做完标记 completed。"
        "\n\n" + instructions
    ),
    model=build_model(),
    toolkit=toolkit,
    offloader=workspace,
    context_config=ContextConfig(
        trigger_ratio=0.8,
        reserve_ratio=0.1,
        tool_result_limit=50_000,
    ),
    injection_config=InjectionConfig(
        timezone="Asia/Shanghai",
        time_format="%Y-%m-%d %H:%M",
        time_interval=0.5,
    ),
)
system prompt 里那三句话不是装饰。任务工具不会自动被使用,你得告诉模型什么时候用它。写成"任务超过三步时"比"你可以用 TaskCreate"有效得多,前者给了判断标准,后者只给了权限。
结尾的 describe_state() 把平时看不见的东西打出来。下面这份省掉了分隔线和 docstring,完整文件在 code/ch08/main.py。
def describe_state(agent: Agent) -> None:
    tasks = agent.state.tasks_context.tasks
    print(f"任务清单({len(tasks)} 条)")
    for task in tasks:
        print(f"  {task.id:<3} [{task.state:<11}] {task.subject}")

    print(f"上下文消息数:{len(agent.state.context)} "
          f"摘要长度:{len(agent.state.summary or '')} 字")
跑一次长任务,你会看到上下文消息数从十几条突然掉到个位数,摘要长度从 0 跳到几百。那就是压缩发生的时刻。
8.8 三个常见错误
错误 1:把 trigger_ratio 设为 1.0
ContextConfig(trigger_ratio=1.0)直接抛校验错误,字段定义是 gt=0, le=0.9。即便放宽也不该这么做。压缩请求本身要占用上下文,压到 100% 再去压缩,请求自己就超限,最后只剩截断一条路。8.1 那条 WARNING 是余量不够时的样子,那一回 4000 的窗口还压得动,再紧一点就压不动了。
错误 2:第三方接口沿用默认 context_size
接一个只有 32k 窗口的模型,却让 context_size 停在 128000。表现为跑到第十几轮时 API 突然返回 400,错误信息里写着 context length exceeded,而你的 ContextConfig 看起来一点问题没有。压缩压根没触发过,因为它算出来的触发线是 102400。
错误 3:以为任务清单也会被压缩
# 想靠压缩清理任务,结果什么都没发生
agent.state.context.clear()
任务在 state.tasks_context,不在 state.context。清消息数组不会清任务,压缩也不会。要清任务得显式操作 tasks_context.tasks,或者用 TaskUpdate(status="deleted")。8.5 已经讲过这层为什么独立,这里只是最容易写错的那个动作。
8.9 小结
- 先跑
context_lab.py能看见压缩的形状。不压缩是线性增长,压缩后是锯齿,压缩摘要请求本身还有尖峰 - 触发线 =
trigger_ratio × model.context_size,压缩请求要吃上下文,所以trigger_ratio上限 0.9、窗口要留余量 - 上下文分三层,常驻层不压缩,滑动层整段替换,外置层(摘要 / 任务 / 磁盘)压缩后仍可查
- 压缩优先走摘要,失败退化为截断;摘要五段结构就是一份交接文档,引用必须自包含
- 任务清单把状态外置,查清单是工具调用,不是回忆;
Task.state与工具的status参数名不一致 - 压缩会丢掉过程,清单不会丢,压完之后第一件事应该是
TaskList - 易变信息用
HintBlock注入,不要改 system prompt timezone默认 UTC,国内项目必须改;time_format必须带日期,否则节流失效
到这里,Buddy 能干活、能守边界、能问人、能做长任务。但它的一切都在内存里。关掉终端,全没了。
下一章要解决的问题:Agent 到底是有状态还是无状态?把 agent.state 存成 JSON 再读回来,哪些东西会坏?