第 14 章 打磨:日志、成本与可观测
本章代码
code/ch14/(telemetry.py/main.py/ 前端三件套) · 读完约 22 分钟
14.0 上一章留下的问题
到第 13 章为止,这个助手该有的都有了:会调工具、会问人、能被打断、刷新页面还能接着聊。它能用,但你不敢把它交给别人用。
原因不在功能,在于你答不上来三个问题。
| 问题 | 现在唯一的回答方式 | 差什么 |
|---|---|---|
| 这一轮花了多少钱? | 去服务商后台看日账单 | 一次调用和一次回复的对应关系丢了 |
| 慢在哪一步? | 看着界面猜 | 模型调用、工具执行各自的耗时没有留下 |
| 昨天下午那次出错是什么情况? | 翻终端,已经被刷掉了 | 没有持久化的记录 |
第一个问题尤其要紧。第 9 章之后,每一轮对话都带着完整上下文发出去,输入 token 随轮次线性增长;工具调用的结果又原样塞回上下文,再下一轮重新计费。巅峰期的成本能是最初的十几倍,而这个增长在界面上完全看不出来——你不知道哪一次问答贵。
这一章补三样东西:一份账(谁、花了多少、多久)、一个面板(现在就能看)、一条清单(上线前逐项确认)。
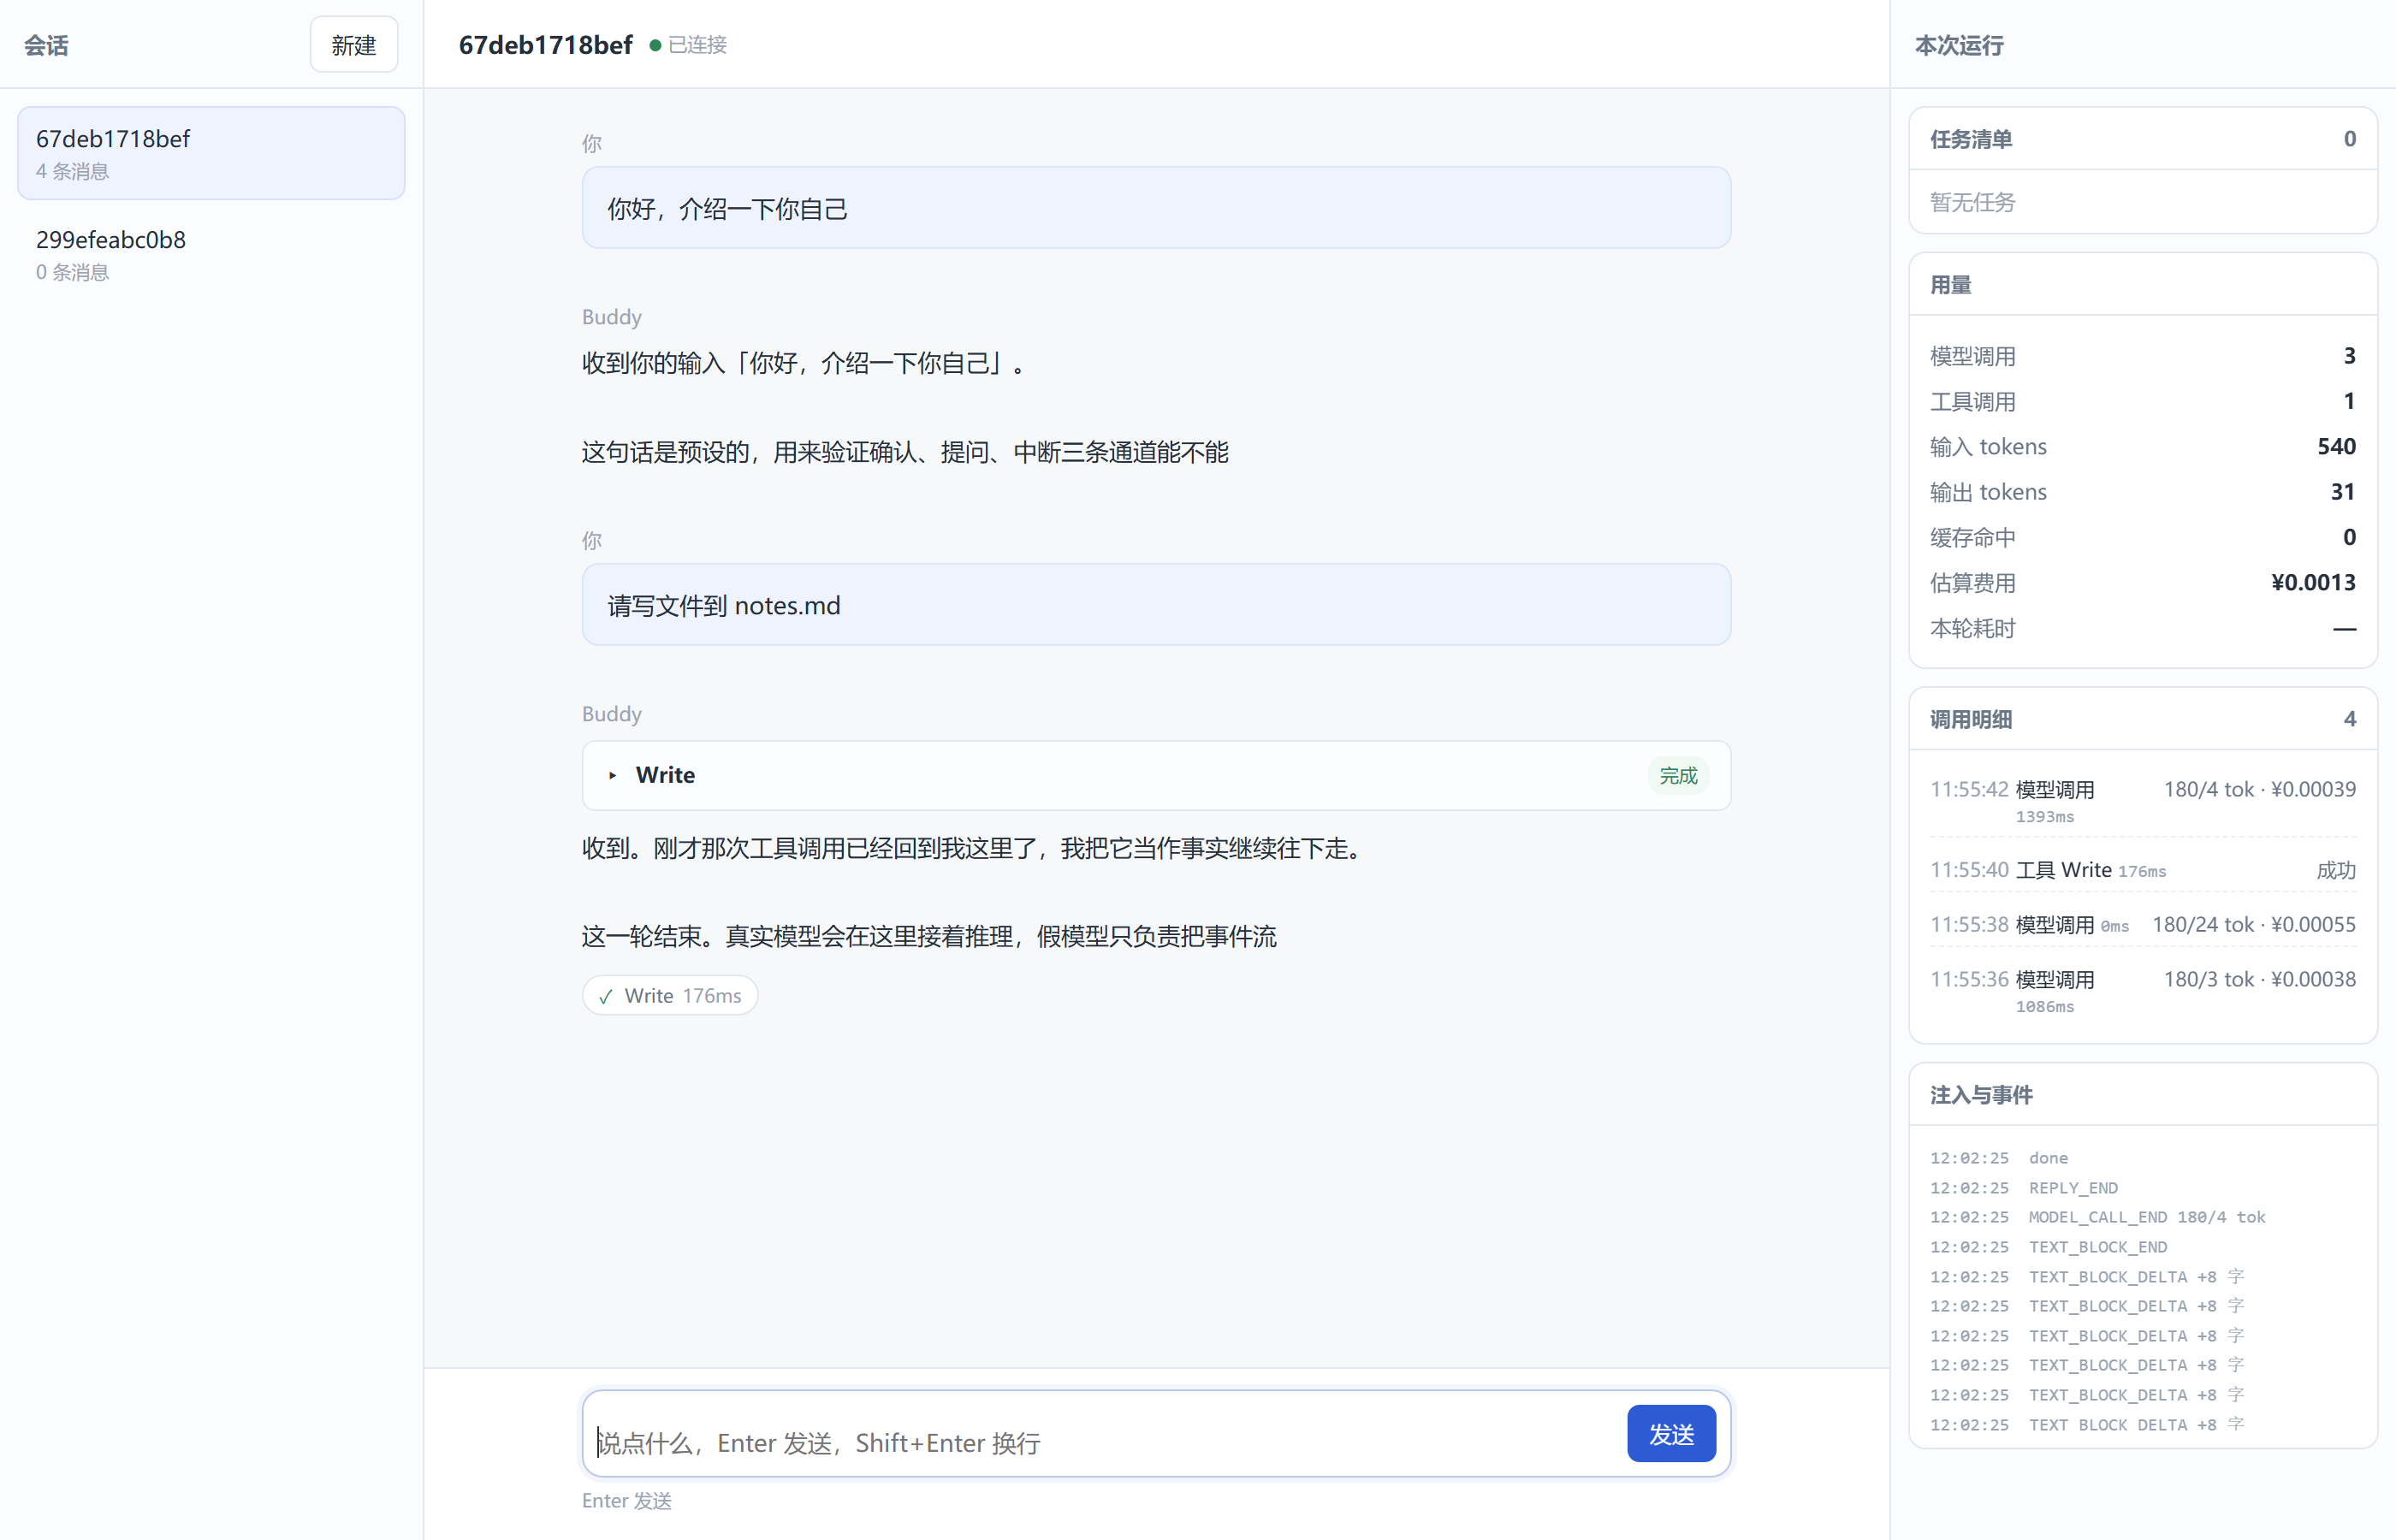
图里右栏那三块就是本章的全部产出。中间的主对话区和第 13 章一模一样——这是有意的:可观测性应该是旁挂的,不是长在业务逻辑里的。
14.1 token 用量藏在哪一层
先解决最硬的一块:去哪里拿到 input_tokens 和 output_tokens。
写出这个问题的时候,脑子里通常有三个候选位置,而且第一个候选看起来最"正统"。
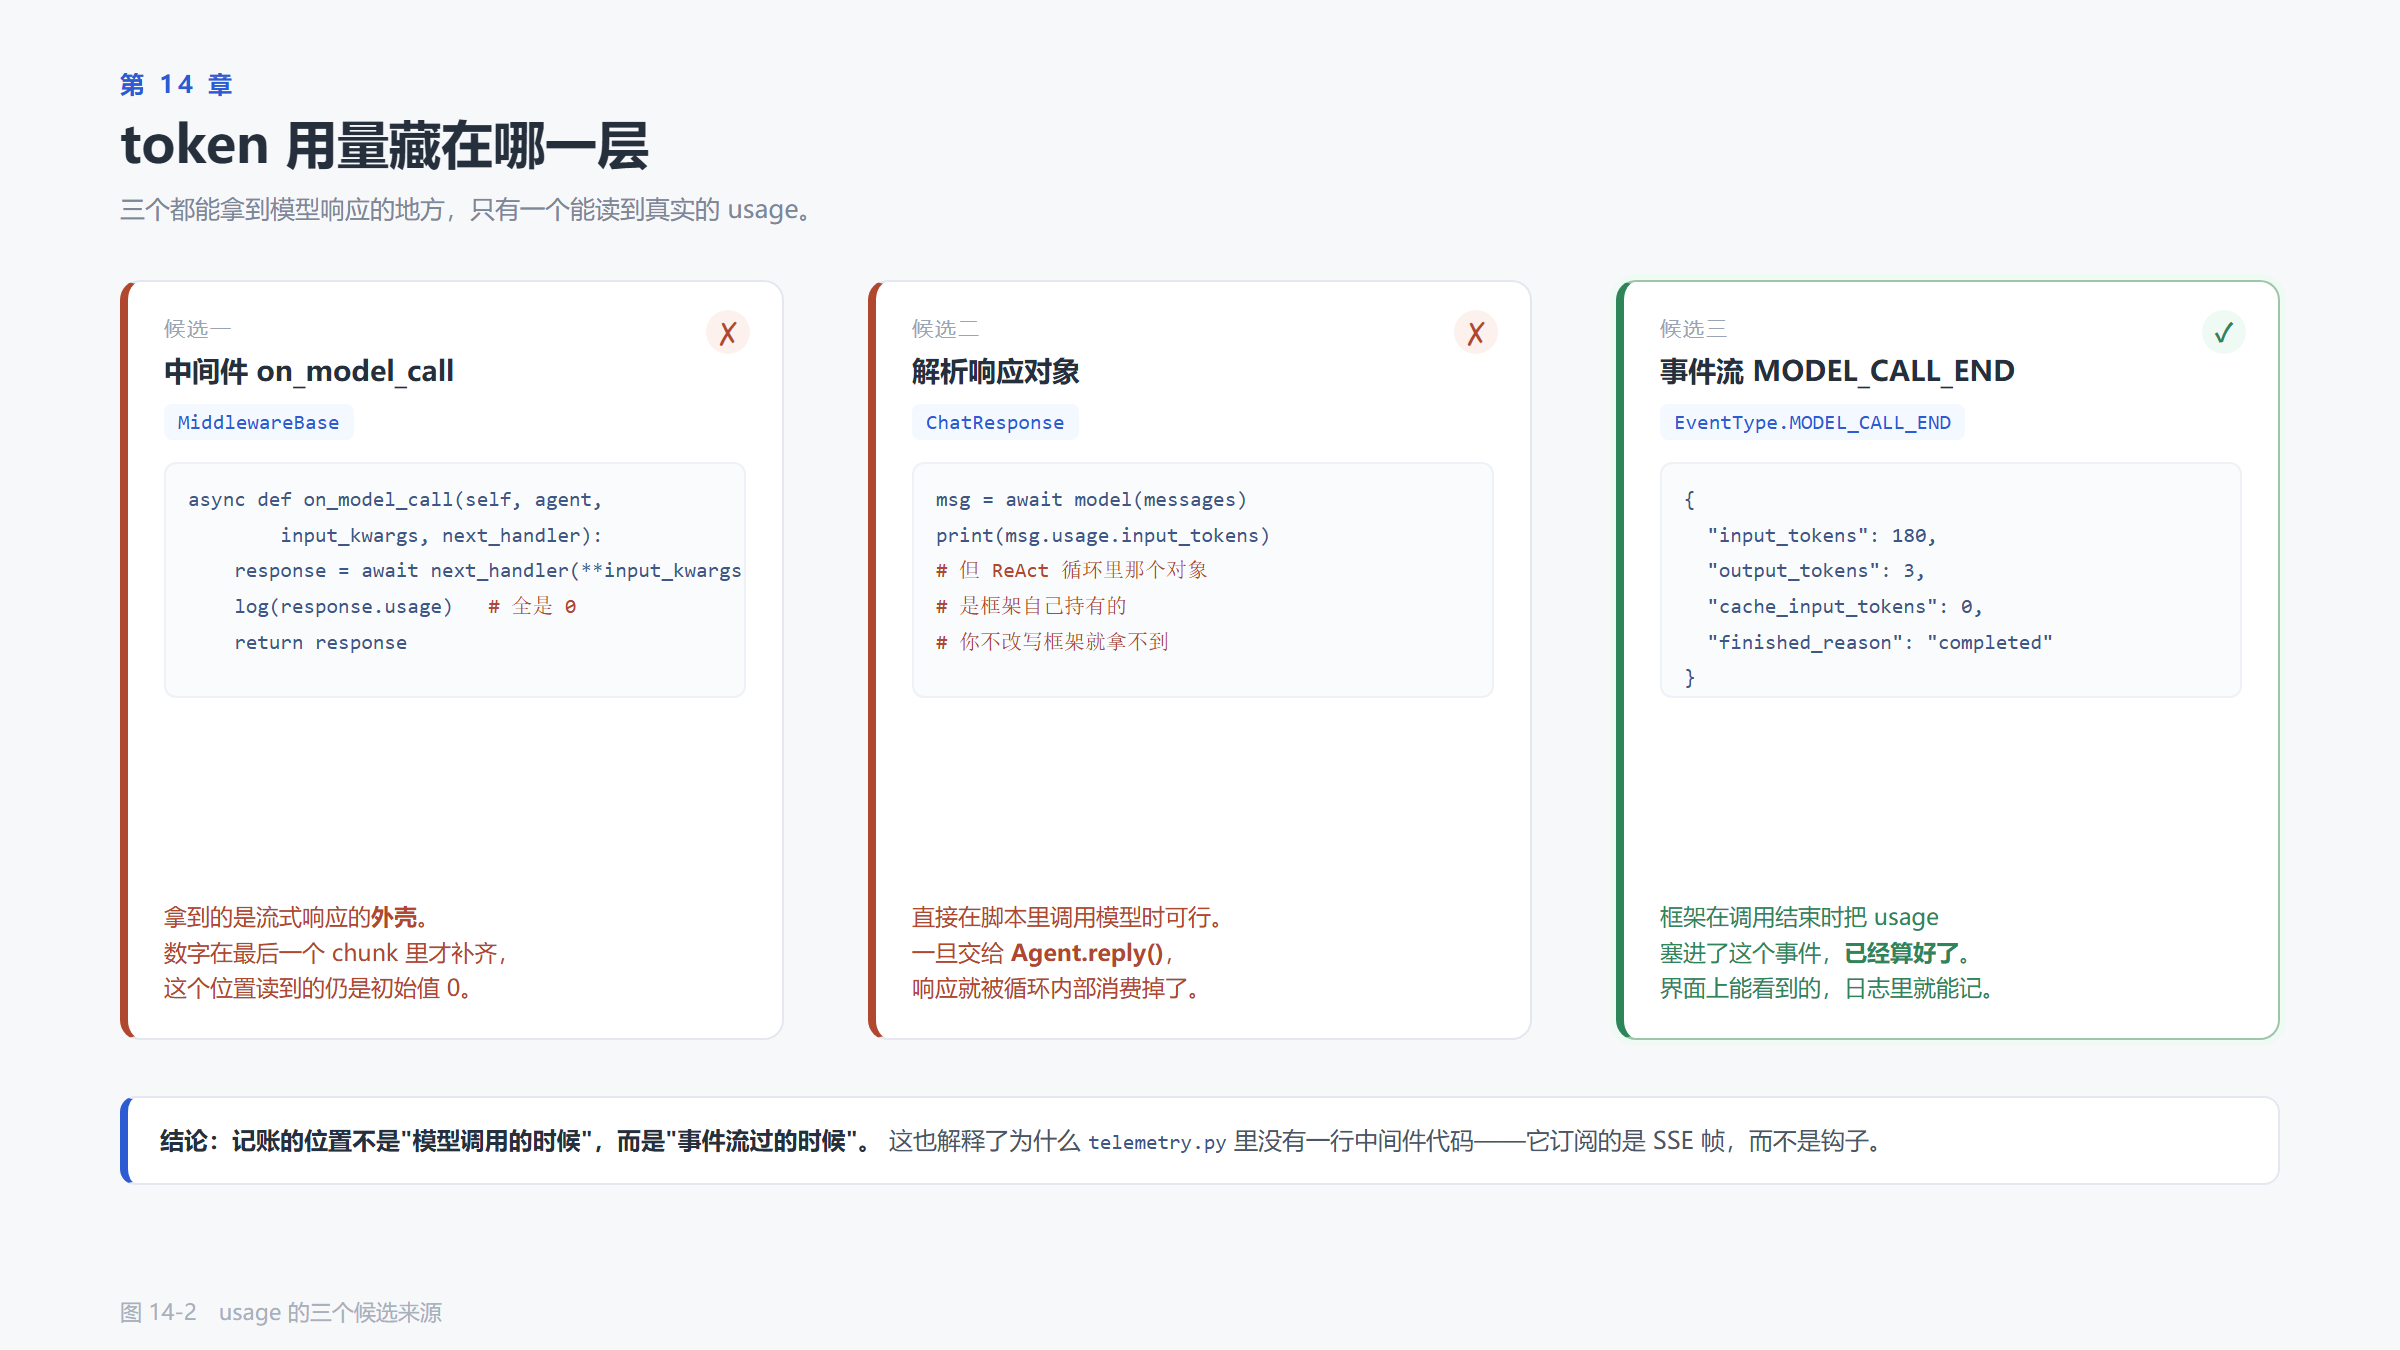
候选一:中间件。 第 10 章刚学过中间件,on_model_call 看着就是为这件事准备的——它包住了模型调用,前后都能插手。写下这样的代码完全顺理成章:
async def on_model_call(self, agent, input_kwargs, next_handler):
    response = await next_handler()
    print(response.usage.input_tokens)      # 期望看到 180
    return response
实测第一行就抛 AttributeError: 'async_generator' object has no attribute 'usage'。改成 getattr(response, "usage", None) 不抛了,但打印出来是 None。
原因在流式响应本身。next_handler 返回的不是一个"已经完成"的结果,而是一个还在吐数据的异步生成器。此刻一个分片都没产生,自然没有用量;真实数字挂在最后一个分片上,is_last=True 的那一片。
这条路不是走不通,第 10 章的 tap_usage 就把它走通了:返回一个包装生成器,分片原样往下传,最后一个分片经过时记账。代价是每一次模型调用都要多包一层,而这一层必须写对——顺序写反会把内容吞掉,usage 读早了会拿到 None,两种错都不会报异常,只是账面是空的。
候选二:直接读响应对象。 写个独立脚本调用模型时,这个办法是可行的:
msg = await model(messages)
print(msg.usage.input_tokens)     # 这里是对的
一旦把模型交给 Agent.reply(),这个对象就被 ReAct 循环内部消费掉了,你不改写框架的代码就拿不到它。为一个统计功能去 fork 框架,不划算。
候选三:事件流。 MODEL_CALL_END 事件带着完整的用量:
| 字段 | 含义 |
|---|---|
input_tokens | 本次调用发出的 token 数 |
output_tokens | 本次调用生成的 token 数 |
cache_input_tokens | 命中服务商上下文缓存的输入 token 数,计费更低 |
cache_creation_input_tokens | 写入缓存的 token 数,部分服务商单独计费 |
finished_reason | 正常结束还是被截断 |
这条路能走通,值得停一下想想为什么:框架在调用结束的那一刻已经算好了 usage,并且选择把它放进事件里。 它放进去的理由,和"前端要显示 token 数"是同一个理由。而前端能看到的东西,日志里当然也能记——这个观察是本章所有设计的地基。
14.1.1 顺带一个坑:模型名在 START 里,不在 END 里
MODEL_CALL_END 有五个字段,偏偏没有 model_name。它在配对的 MODEL_CALL_START 上。
这意味着记账程序必须有状态:见到 START 时把模型名存下来,见到 END 时取出来用。想省这一步,账目里所有记录的名字都会变成 unknown——而且不会报错,只是不好查。
14.2 一行一个 JSON
账存哪里?不引数据库,用一个只追加的文本文件,一行一条 JSON:
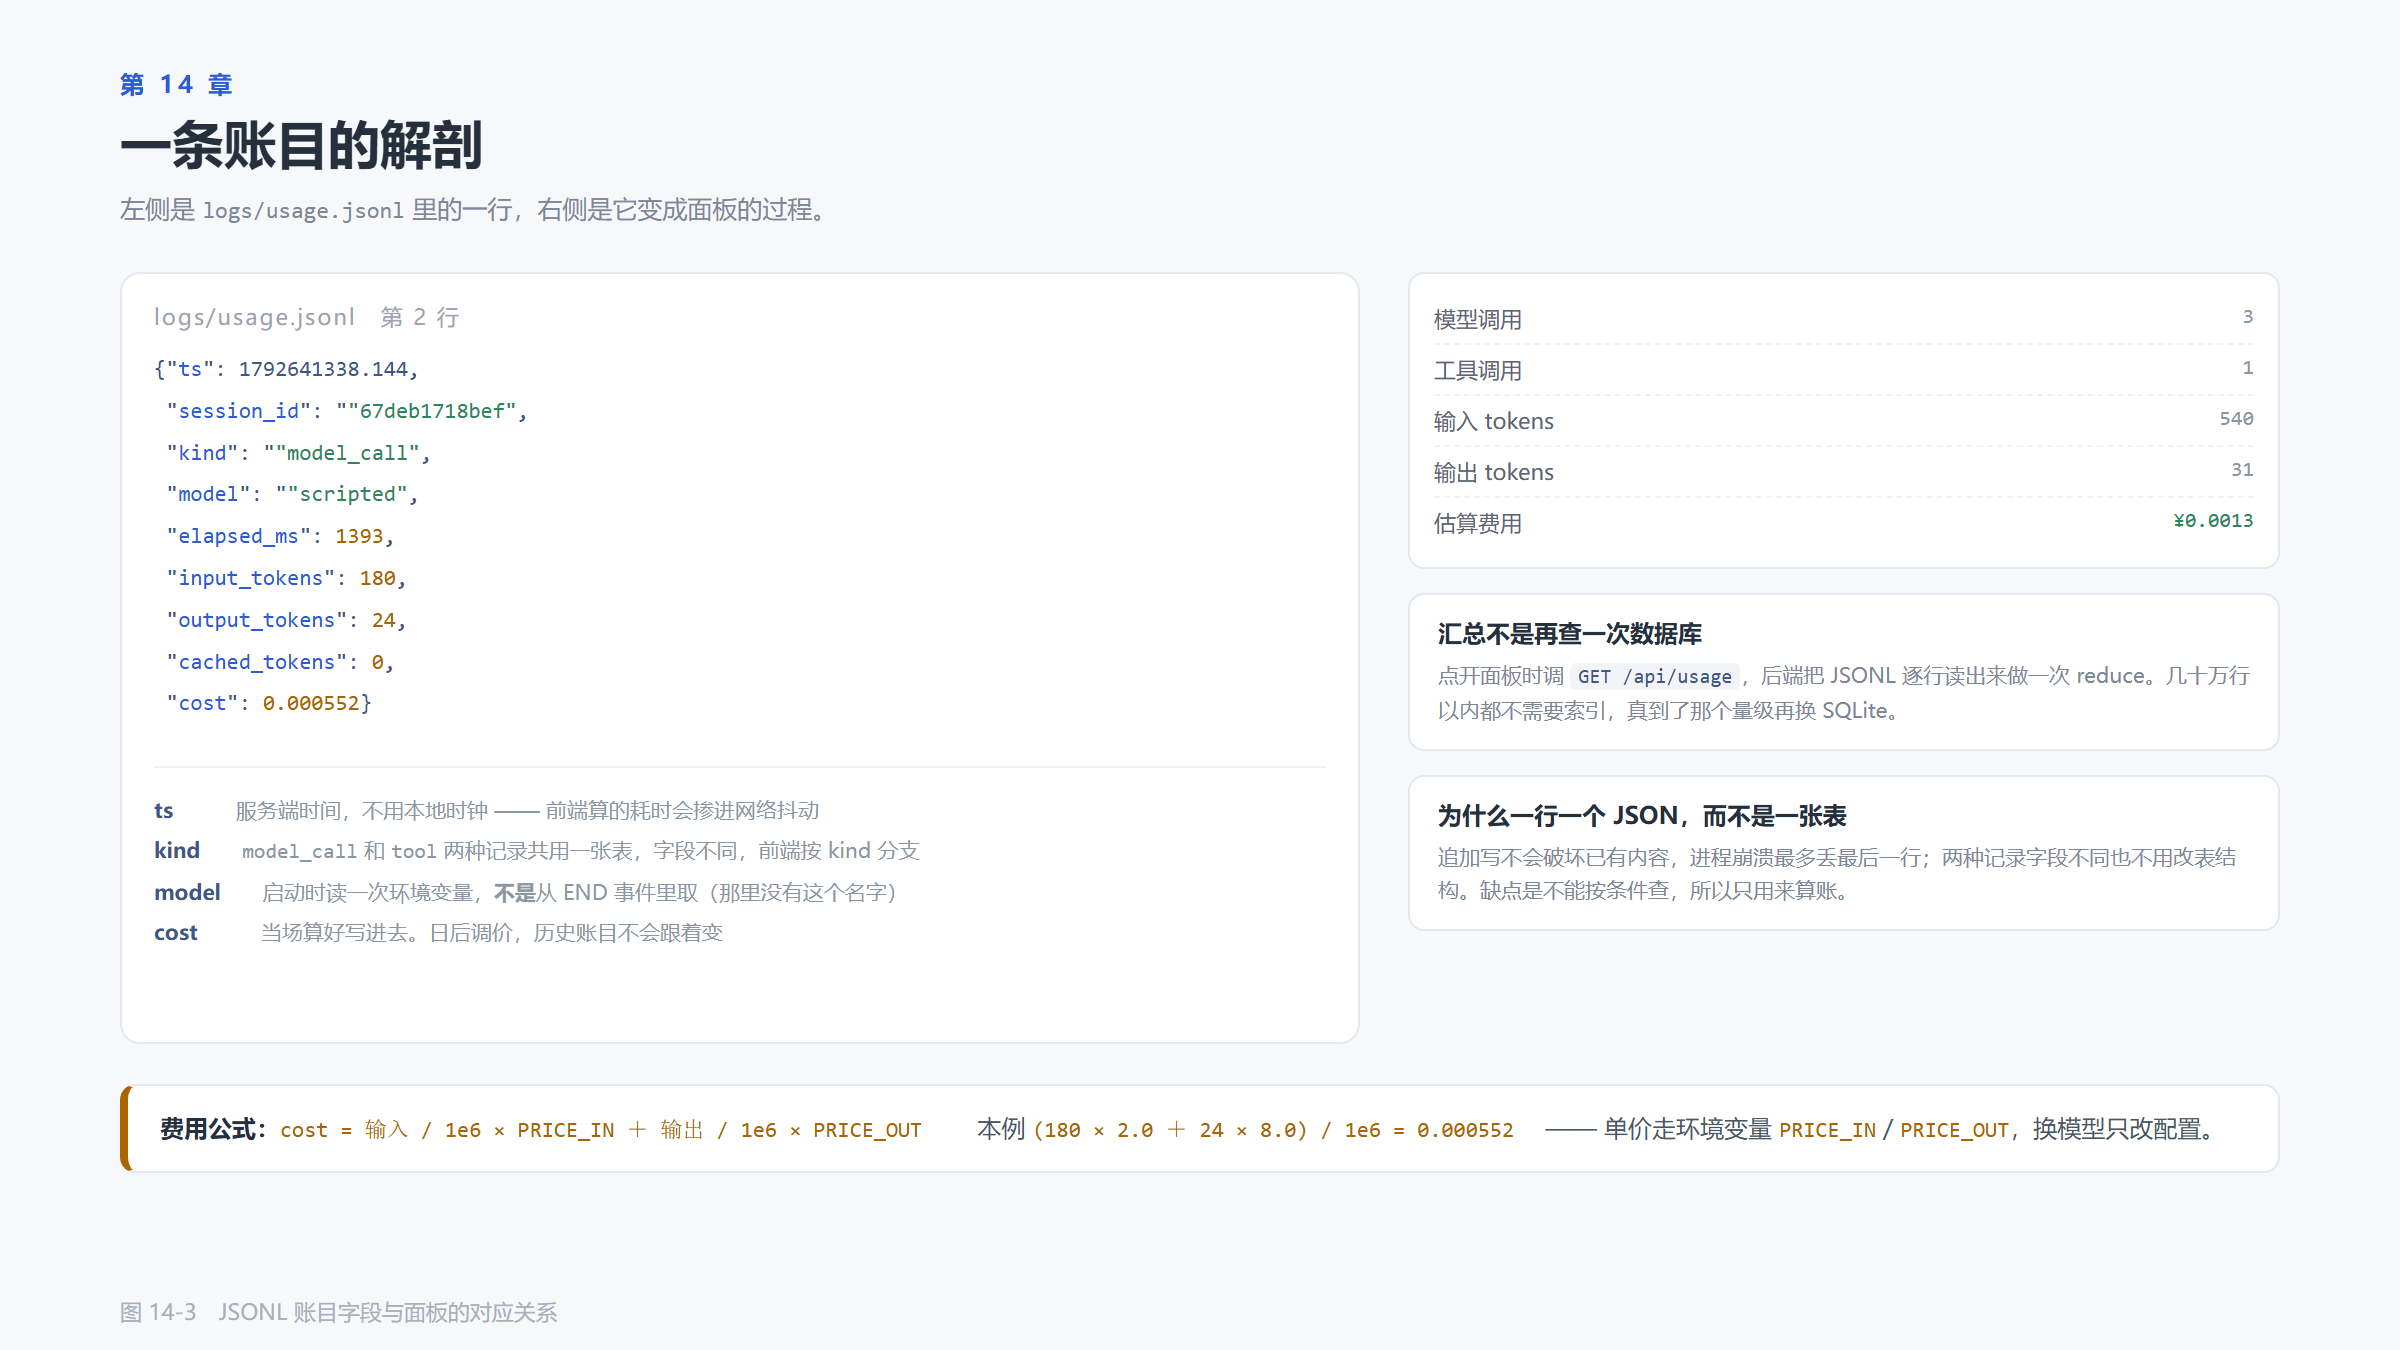
{"ts": 1792641338.144, "session_id": "67deb1718bef", "kind": "model_call", "model": "scripted", "elapsed_ms": 1393, "input_tokens": 180, "output_tokens": 24, "cached_tokens": 0, "cost": 0.000552}
{"ts": 1792641340.857, "session_id": "67deb1718bef", "kind": "tool", "tool": "Write", "elapsed_ms": 176, "state": "success"}
这种格式叫 JSONL(JSON Lines),规矩只有一条:一行必须是完整的一条 JSON,不能为了好看折成多行。换来三个好处:
- 追加是安全的。 进程崩在写第 500 行的一半,前 499 行完好无损,第 500 行是一段残缺文本,读的时候跳过即可。换成 JSON 数组,整个文件就废了
- 两种记录可以共用一张表。 模型调用和工具调用的字段不一样,JSONL 不需要统一表结构
- 命令行能直接用。
tail -5看最近的,grep '"state": "error"'找失败的,不需要任何工具
代价也很明确:不能按条件快速查询。所以这个文件只用来算账,不做检索;量级真上来了再换 SQLite,接口形状不用改。
class UsageLog:
    def __init__(self, path):
        self.path = Path(path)
        self.path.parent.mkdir(parents=True, exist_ok=True)

    def append(self, record):
        with self.path.open("a", encoding="utf-8") as fp:
            fp.write(json.dumps(record, ensure_ascii=False) + "\n")

    def read(self, limit=500):
        if not self.path.exists():
            return []
        with self.path.open("r", encoding="utf-8") as fp:
            lines = fp.readlines()[-limit:]
        rows = []
        for line in lines:
            line = line.strip()
            if not line:
                continue
            try:
                rows.append(json.loads(line))
            except json.JSONDecodeError:
                continue            # 写到一半断电会留下半行,跳过即可
        return rows
read() 里那个 try 不是防御式编程的洁癖。追加写加崩溃,产生半行是必然事件,不是意外。读的时候把整批数据一起 json.loads 会因为这半行全盘失败——那才是真正难查的故障:文件看着好好的,接口一直 500。
summary() 在 read() 的结果上做一次 reduce,按会话过滤后分别汇总 kind == "model_call" 和 kind == "tool" 两组。几十万行以内,这个做法都够快。
14.3 Recorder:把事件翻译成账目
有了仓库,还需要一个搬运工。它订阅事件,遇到成对的开始和结束就写一行。
class Recorder:
    def __init__(self, log):
        self.log = log
        self._model_t0 = None
        self._model_name = "unknown"
        self._tool_t0 = {}
        self._tool_name = {}

    def observe(self, event_type, data, session_id):
        now = float(data.get("ts") or time.time())
        base = {"ts": round(now, 3), "session_id": session_id}

        if event_type == "MODEL_CALL_START":
            self._model_t0 = now
            # 模型名只在 START 里有,END 里没有,所以要提前存下来
            self._model_name = data.get("model_name") or self._model_name

        elif event_type == "MODEL_CALL_END":
            in_tok = int(data.get("input_tokens") or 0)
            out_tok = int(data.get("output_tokens") or 0)
            self.log.append({
                **base,
                "kind": "model_call",
                "model": self._model_name,
                "elapsed_ms": round((now - self._model_t0) * 1000) if self._model_t0 else 0,
                "input_tokens": in_tok,
                "output_tokens": out_tok,
                "cached_tokens": int(data.get("cache_input_tokens") or 0),
                "cost": cost_of(in_tok, out_tok),
            })
它只盯两对事件:
MODEL_CALL_START → MODEL_CALL_END     拿到用量与耗时
TOOL_CALL_START  → TOOL_RESULT_END    拿到工具耗时与成败
工具那一对有一个必须处理的例外。第 13 章讲过,确认之后"续跑"时,事件流里不会再发 TOOL_CALL_START,直接从 TOOL_RESULT_START 开始。如果只认第一对,那么所有需要确认的工具调用都会被记成"没有开始时间、名字叫 ?"。
elif event_type == "TOOL_RESULT_START":
    # 续跑的那次调用不会再发 TOOL_CALL_START,
    # 名字只能从 RESULT_START 里补,开始时间也一起补上。
    cid = str(data.get("tool_call_id") or "")
    self._tool_t0.setdefault(cid, now)
    if data.get("tool_call_name"):
        self._tool_name[cid] = data["tool_call_name"]
用 setdefault 而不是直接赋值:正常路径下 _tool_t0 里已经有开始时间了,这里不能覆盖成更晚的时刻,否则耗时会被算成 0。
14.3.1 费用
PRICE_IN = float(os.getenv("PRICE_IN", "2.0"))     # 元 / 百万 token
PRICE_OUT = float(os.getenv("PRICE_OUT", "8.0"))

def cost_of(input_tokens, output_tokens):
    return round(
        input_tokens / 1_000_000 * PRICE_IN
        + output_tokens / 1_000_000 * PRICE_OUT,
        6,
)单价走环境变量,两个理由。一是换模型只改配置,不用改代码;二是费用在写账时就算好并落盘,日后服务商调价,历史账目不会被重新解释一遍。这两者看起来是同一个决定,其实是两件事,都重要。
14.4 挂上去:改一个方法,不动路由
最难的部分已经过去了。剩下的问题是:怎么让记账发生在每一轮对话里,同时不破坏第 13 章那套已经调通的路由。
第 13 章的会话类有一个 _emit,所有推给前端的事件都从这里出去。覆盖它就行:
class UsageSession(ch13.InteractiveSession):
    def _emit(self, event_type, data):
        super()._emit(event_type, data)          # 先照常推给前端
        try:
            recorder.observe(event_type, data, self.session_id)
        except Exception as error:
            # 记账失败不该把这一轮对话搞挂
            print(f"[telemetry] 记账失败 {event_type}: {error}")
选择在 _emit 上挂钩子,而不是再写一个中间件,原因是采信来源只能有一个。前端在 MODEL_CALL_END 里看到的 token 数,和账本里记的必须是同一份数据。多一个来源,就多一处对不上的可能,而对不上的时候你无法判断哪边是对的。
那个 try 也是必需的。记账是旁路,旁路出故障不能影响主路——磁盘满了应该少几条记录,而不是让用户发不出消息。
剩下两件事是把新会话类装上:
class UsageRegistry(ch13.InteractiveRegistry):
    def create(self, agent_factory):
        session = UsageSession(uuid.uuid4().hex[:12], agent_factory())
        self.sessions[session.session_id] = session
        return session

ch13.registry = UsageRegistry()
app = ch13.app
最后那行赋值能生效,是因为第 13 章的路由里写的是 registry.create(...)——它读的是模块属性,不是编译期绑定的名字。这是一个 Python 层面的事实,利用它可以让上一章的代码原样保留。
14.4.1 两个路由和一次静态目录更换
# 静态目录是兜底路由,必须排在最后。新增接口要插在它前面。
app.router.routes = [r for r in app.router.routes if not isinstance(r, Mount)]

@app.get("/api/usage")
async def usage(session_id: str | None = Query(default=None)):
    return {
        "summary": usage_log.summary(session_id),
        "price": {"in": PRICE_IN, "out": PRICE_OUT},
    }

@app.get("/api/usage/log")
async def usage_detail(session_id: str | None = Query(default=None),
                       limit: int = Query(default=30, le=200)):
    rows = [r for r in usage_log.read(200)
            if session_id is None or r.get("session_id") == session_id]
    return {"items": rows[::-1][:limit]}

app.mount("/", StaticFiles(directory=str(HERE), html=True), name="ui")
把挂载点摘掉再挂新的,是因为第 13 章挂的是 ch13/ 目录。这一章的页面多了一块成本面板,要从 ch14/ 提供。Mount 在 Starlette 里是兜底匹配,一旦它排在前面,后面加的 /api/usage 永远进不来——症状是接口 404,而代码看着毫无问题。
14.5 面板:把账读出来
前端多的是三块内容,都挂在右栏。
用量卡显示本轮会话的模型调用次数、工具调用次数、输入输出 token、缓存命中量和估算费用。数字来自 GET /api/usage?session_id=...。
调用明细卡是最近若干条记录,新的在上,一行一次调用:时间、类型、耗时、token、费用,工具行显示工具名和成败。
注入与事件卡是第 12 章那个事件日志,这一章原样保留。它的价值在出问题时——事件序列是最接近真相的证据,比任何一层封装过的日志都可靠。
case "done": {
  state.streaming = false;
  refreshUsage();          // 一轮结束时对一次账
  closeConfirm();
  unlockInput();
  ...
}
刷新时机选在 done,而不是每次 MODEL_CALL_END。一轮回复里可能有三次模型调用(工具前、工具后、可能还有第三次),每一次都去请求一次汇总接口是浪费;而用户真正关心的"这一轮多少钱"要等这一轮结束才有意义。
缓存命中量单独列一行,是因为它的价格差别大。多数服务商的缓存输入按正常输入的一到两成计价,命中率高的时候账单能差出数倍。这个数字在明细里能直接看出规律:同一个会话连着聊,第二轮开始缓存命中就会上去;换个话题重新开头,命中率掉下来。 这种观察靠看总费用是看不出来的。
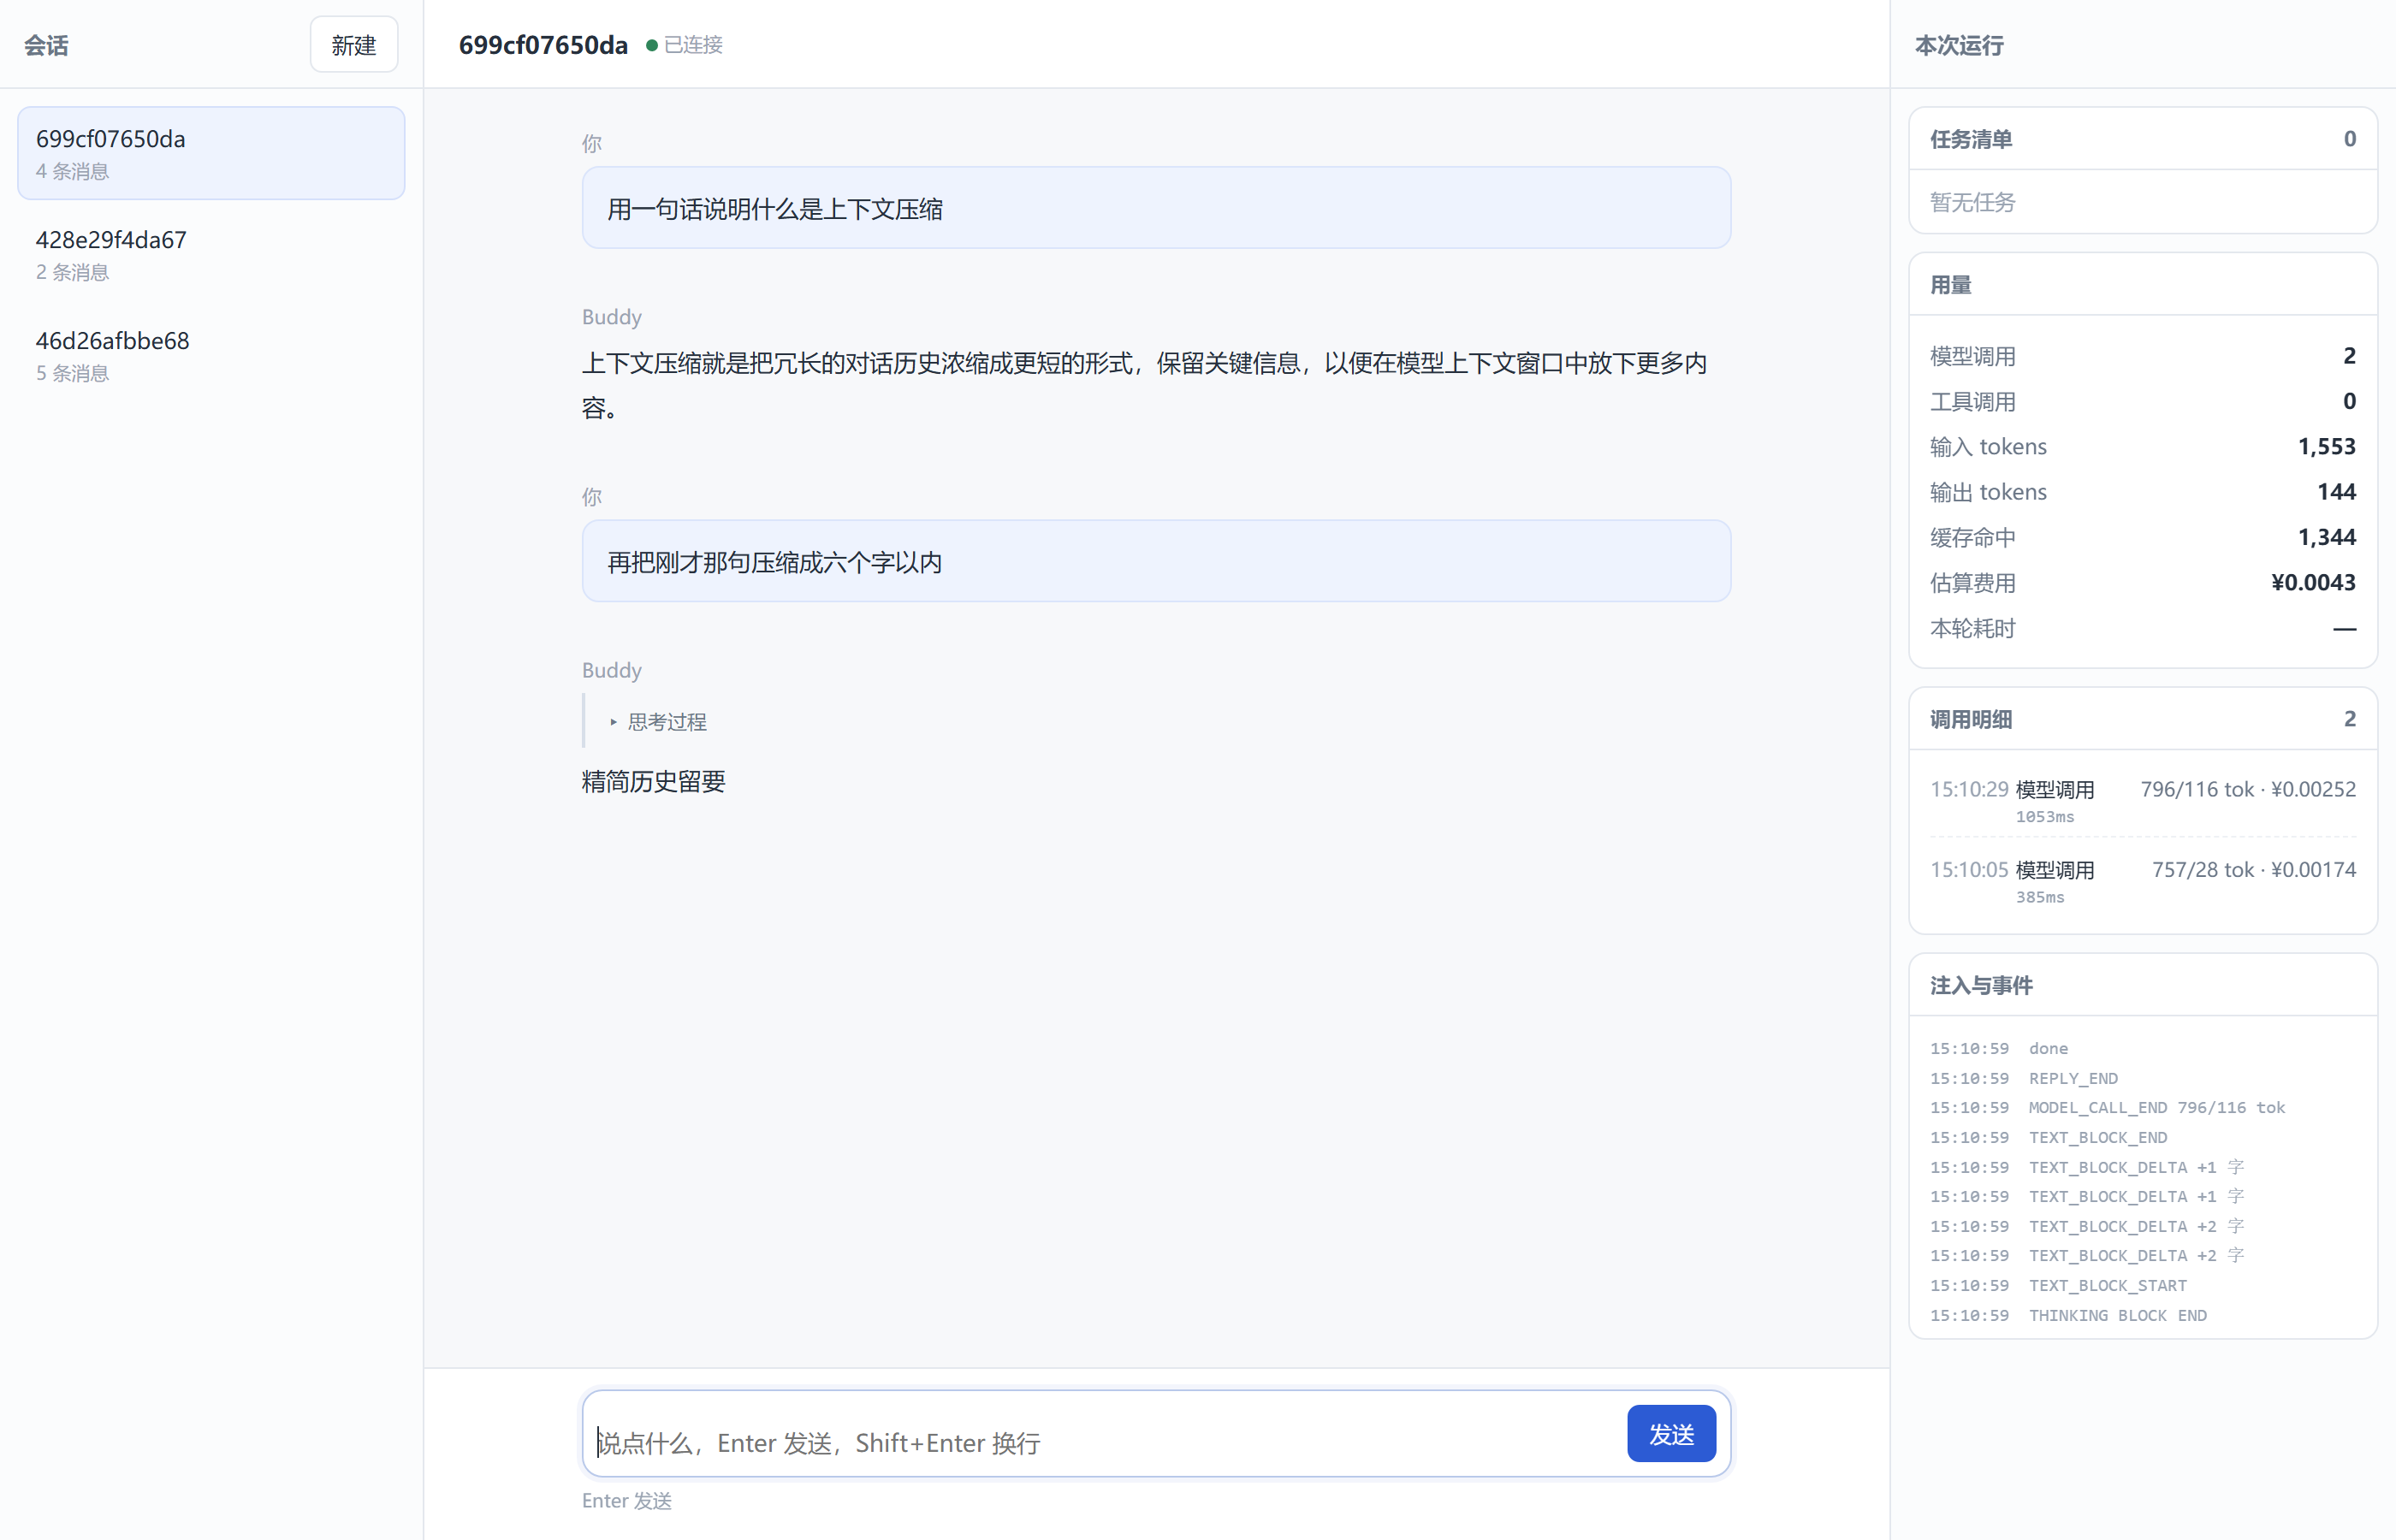
上面这张是接真模型跑出来的,两轮对话:第一轮输入 757 token、缓存命中 0;第二轮输入 796 token、其中 704 命中缓存。第二轮几乎整段上下文都命中了缓存。
注意面板上的费用是偏高的:cost_of() 只按输入、输出两档计价,没有为缓存的 704 个 token 打折。真实账单会比它低。这是估算值该有的样子——宁可高估,不要低报,同时也提醒你:面板上那个数字是用来比较趋势的,不是用来对账的。要对账,去看服务商的账单明细。
14.6 时间去哪了
明细里每一行都有 elapsed_ms。单看一个数字没意义,把一轮回复的三行连起来看才有:
1  MODEL_CALL_START → END     180/3 tok    1086ms
2  TOOL_CALL_START → END      Write         176ms
3  MODEL_CALL_START → END     180/24 tok   1393ms
三段加起来 2.6 秒,而用户在界面上感知到的等待往往更长。差额来自那些没有被记为"调用"的时间:排队、确认弹窗等待用户点击、前端渲染。这也是为什么面板上"本轮耗时"和明细各行之和对不上是正常的——记账记的是模型和工具的时间,不是用户的等待时间,两者不该混在一个数字里。
第一次模型调用只生成了 3 个 token,因为它是那个工具调用本身(Write(...) 的 JSON 参数);第二次生成了 24 个,是看到工具结果之后的正文。这个结构一眼就能看出"这一轮为什么调了两次模型"。
14.7 上线前自检清单
功能跑通不等于能交出去。下面十二条,每一条都是这一路上真实遇到过的问题,逐项确认一遍再上线。
| # | 检查项 | 不做的后果 |
|---|---|---|
| 1 | .env 里没有硬编码的 key,.gitignore 已包含它 | 密钥进了仓库 |
| 2 | 监听地址是 127.0.0.1 或内网,不是 0.0.0.0 | 服务直接暴露在公网 |
| 3 | 确认模式默认是 default,不是 bypass | 所有危险操作静默放行 |
| 4 | 工具的工作目录被限制在沙箱内 | 模型能读写任意路径 |
| 5 | ToolResultEndEvent 的 state 为 error 时有可见提示 | 工具失败了用户以为成功了 |
| 6 | 事件缓冲区有上限,且满了会丢最旧的 | 长会话吃光内存 |
| 7 | 会话可以被显式关闭,关闭时取消进行中的任务 | 后台任务越积越多 |
| 8 | 记账文件有轮转或截断策略 | 磁盘被日志写满 |
| 9 | 前端对 error 帧有处理,不只是 done | 出错时输入框永久锁死 |
| 10 | 中断在两种卡点下都能生效(运行中 / 等待确认) | 用户只能关标签页 |
| 11 | 单价配置与实际使用的模型一致 | 成本面板给出误导性数字 |
| 12 | 日志里不落用户原文,或落了明确的数据保留期限 | 隐私与合规风险 |
第 12 条经常被忽略。明细里现在只记 token 数和工具名,不记正文,这是一个刻意的选择:账本回答"花了多少",不回答"聊了什么"。要看聊了什么,去看会话状态,那里本来就有,也不用再复制一份。
14.8 三个常见错误
错误 1:用中间件记 token,记出来是空的。
现象:on_model_call 里读 response.usage,按"有值但全是 0"的思路去排查,越查越糊涂。真实现象分两种:直接写 response.usage 报 'async_generator' object has no attribute 'usage';用 getattr 兜住则是 None。
原因:流式调用下 next_handler() 交回来的是生成器,用量挂在最后一个分片上,中间件返回的那一刻还没产生任何分片。
对策:要么按第 10 章的 tap_usage 包一层生成器,要么记账挂在事件流上读 MODEL_CALL_END。本章选后者,判断标准很朴素——如果某个数字在界面上显示得出来,那它一定在事件里,不必绕到框架内部去找。
错误 2:从 MODEL_CALL_END 里取 model_name。
现象:账本里每一条的 model 都是 unknown。
原因:这个字段只在配对的 MODEL_CALL_START 上。END 事件有 tokens、有耗时、有结束原因,就是没有模型名。
对策:在处理 START 时把它存进 Recorder 的实例状态。整个记账程序因此变成有状态的——这不优雅,但事件流本身就是有状态的,接收方跟着有状态是合理的。
错误 3:记账抛异常把整轮对话带崩。
现象:磁盘满、目录没权限、或者某一帧的字段缺失时,用户点发送没有任何反应,后端日志里是一串跟踪栈。
原因:记账代码和推流代码写在同一个函数里,异常一起往上冒。
对策:observe() 外面包 try/except,失败只打日志。旁路的故障要能被自己吞掉——这一条对日志、监控、埋点全都适用,不是本章特有的。
14.9 小结
这一章没有引入新概念,它做的是把前面十一章里已经存在的信息捡起来、存好、摆到台面上。
- 记账的位置在事件流上,不在模型调用处。
MODEL_CALL_END带着真实用量;中间件那条路要额外包一层生成器才走得通,本章不重复造这条管线 - JSONL 足够用。追加安全、能直接 grep、两种记录共用一张表;代价是不能按条件查
- 事件流是有状态的,接收方也得有状态。模型名在 START 里、工具的第二个入口在
TOOL_RESULT_START,这两处不处理,账目就会缺字段 - 可观测性是旁路。覆盖一个
_emit就挂上了,路由一行没改;旁路的异常必须自己吞掉
到这里,这个助手已经能干活、能对话、能被打断、能算账。下一章是最后一章:把它拆开重组,看看从"能跑"到"能给别人用"还差哪几步。