第 9 章 会话要活下去
本章代码
code/ch09/store.py、code/ch09/probe_state.py、code/ch09/main.py· 读完约 18 分钟
9.0 上一章留下的问题
第 8 章的结尾是一句话,关掉终端,全没了。
那不是修辞。任务清单在内存里,上下文在内存里,你昨天跟它说过的"周报固定分三段"也在内存里。服务一断,三样一起消失。
这件事跟模型好坏没有任何关系。对于模型来说它是无状态,它不记得上一轮聊过什么,每次调用都是一次全新的问答。
你看到的"它记得",是框架在发请求之前把整段历史重新拼进去。
所以会话能不能活下去,关键在于那份历史有没有落到磁盘上。
9.1 先跑一遍,看它怎么活下来
我们先跑一个脚本来看一下。code/ch09/probe_state.py 全程测试 AgentState,不造 Agent,也不调模型,所以不需要 API key。
四段输出,一段对应后面一节的结论。
--- 1. 同一个进程里两个 state,各记各的
  state a:1 条消息 id f03352da…
  state b:0 条消息 id 9439cd58…
  往 a 塞了一句话,b 里照样是 0 条

--- 2. 存下来之后,磁盘上是这个形状
  mu/buddy/f03352dace074e7ba2f78ea4fbfe9bff.json 1866 B
  mu/buddy/f03352dace074e7ba2f78ea4fbfe9bff.meta.json 236 B

--- 3. 把内存里的 state 删掉,再从文件读回来
  del 掉了,进程里已经没有这个对象
  读回一条:我的周报固定分三段:进度、问题、下周计划
  任务:['写进度', '写问题']
  消息 1 条 session_id 是不是同一个:True

--- 4. 存进去之前的残留,读回来变成什么样
  存盘时:structured_schema 有值 cur_iter=3 activated_groups=['reporting']
  读回后:structured_schema=None cur_iter=0 activated_groups=['reporting']
  前两个被 load() 清掉了,工具组原样留着
我们来看一下代码的运行结果,是这一章我们要讲的东西。
第一段,同一个进程里两个 state,各记各的。 往 a 里塞了一句话,b 还是 0 条。这说明记忆没挂在"进程"或者"程序"上,挂在 state 上。那 Agent 对象算不算,9.2 说。
第二段,磁盘上只多了两个文件,躺在 mu/buddy/ 下面。 大的那个是完整状态,小的那个是列表用的元信息,1.8 KB 对 236 B。路径里的 mu 和 buddy 就是 user_id 和 agent_id,加上文件名里的 session_id,三个键凑齐,9.3 展开。
第三段最说明问题。 内存里那个对象已经被 del 掉了,进程里找不到了,可消息、任务、session_id 一样不少地回来。这就是"会话活下来"的字面意思,也是 Ctrl+C 之后还能接着聊的全部原理。9.4 讲这两行代码。
第四段是三个残留的对照。 存盘时 structured_schema 有值、cur_iter=3、activated_groups=['reporting'],读回来前两个变成 None 和 0,最后一个原样保留。这不是 pydantic 干的,是 store.load() 里手写的三行。9.5 讲为什么必须清两个、留一个。
这一步不花 token,随时可以重跑。把消息改长一点、任务多建两条,看文件大小怎么变,比看结论直观。
9.2 Agent 本身不保存记忆
"我的助手记得我们聊过什么"。更准确的说法是,记忆不在 Agent 对象里,在 AgentState 里。Agent 每次都可以重新构造,只要把同一份 state 喂给它。
看 Agent 的构造签名,其中有一个 state 参数。
Agent(name=..., system_prompt=..., model=..., toolkit=...,
state: AgentState | None = None, ...)不传,框架造一个空的;传了,它就直接用你这份。Agent 对象只保存配置,名称、模型、工具、各种 config,再加一个指向 state 的引用,自己不留第二份对话记忆。
一句话,Agent 是壳,state 才是内存条。
再换一个角度看这件事。服务端每来一轮对话,都可以临时造一个 Agent,用完就扔。真正留下来的只有那份 state,下一轮再把它交给新造的 Agent。你感觉到的"它记得",就是每次重新交接。
AgentState 有八个字段。判断一个东西要不要放进 state,只问一句,进程重启之后下一轮还要不要用它。
表 9-1 AgentState 的八个字段
| 字段 | 内容 | 丢了会怎样 |
|---|---|---|
session_id | 会话标识 | 会话无法被找回 |
summary | 压缩后的摘要 | 长任务的来龙去脉断了 |
context | 消息数组 | 全部对话历史消失 |
reply_context | 当前回复的进度(reply_id、cur_iter、结构化输出要求) | 断点续跑失效 |
permission_context | 权限模式与规则 | 用户刚点的"始终允许"忘了 |
tool_context | 读文件缓存、已激活的工具组 | 工具组要重新激活 |
tasks_context | 任务清单 | 计划全丢 |
middle_context | 你自己写的中间件塞进去的状态 | 自定义逻辑失忆 |
9.3 三个键定一条会话
9.1 第二段那两个文件,为什么正好躺在 mu/buddy/ 这两层下面,答案在这三个键。
单靠 session_id 不够。同一个应用里会有多个用户、多个智能体,它们的 session_id 可能撞车,尤其用短 id 的时候。定位一条会话需要三个键。
user_id  →  谁在聊
agent_id →  跟哪个智能体聊
session_id → 聊的哪一段
对应到文件系统,就是三层目录。
.sessions/<user_id>/<agent_id>/<session_id>.json       完整状态
.sessions/<user_id>/<agent_id>/<session_id>.meta.json  列表用的元信息
把元信息单独存一份,是个很实际的优化。会话列表页面只需要"标题、更新时间、消息条数",不需要把每条会话的完整 JSON 都读出来解析一遍。二十条会话可能只有几百 KB,一千条就是几十 MB,为一个列表页付这个代价不划算。
session_id 从哪来?AgentState 会自己生成一个 32 位的十六进制串。
b075a2a2a1934f46a76bc5dff28db63c用它的好处是够随机。当然,你也可以自己指定,业务上需要用"群聊 + 日期"这种可读 id 就直接赋值。
state = AgentState()
state.session_id = "project-weekly-2026-10"
9.4 存与取,两行代码
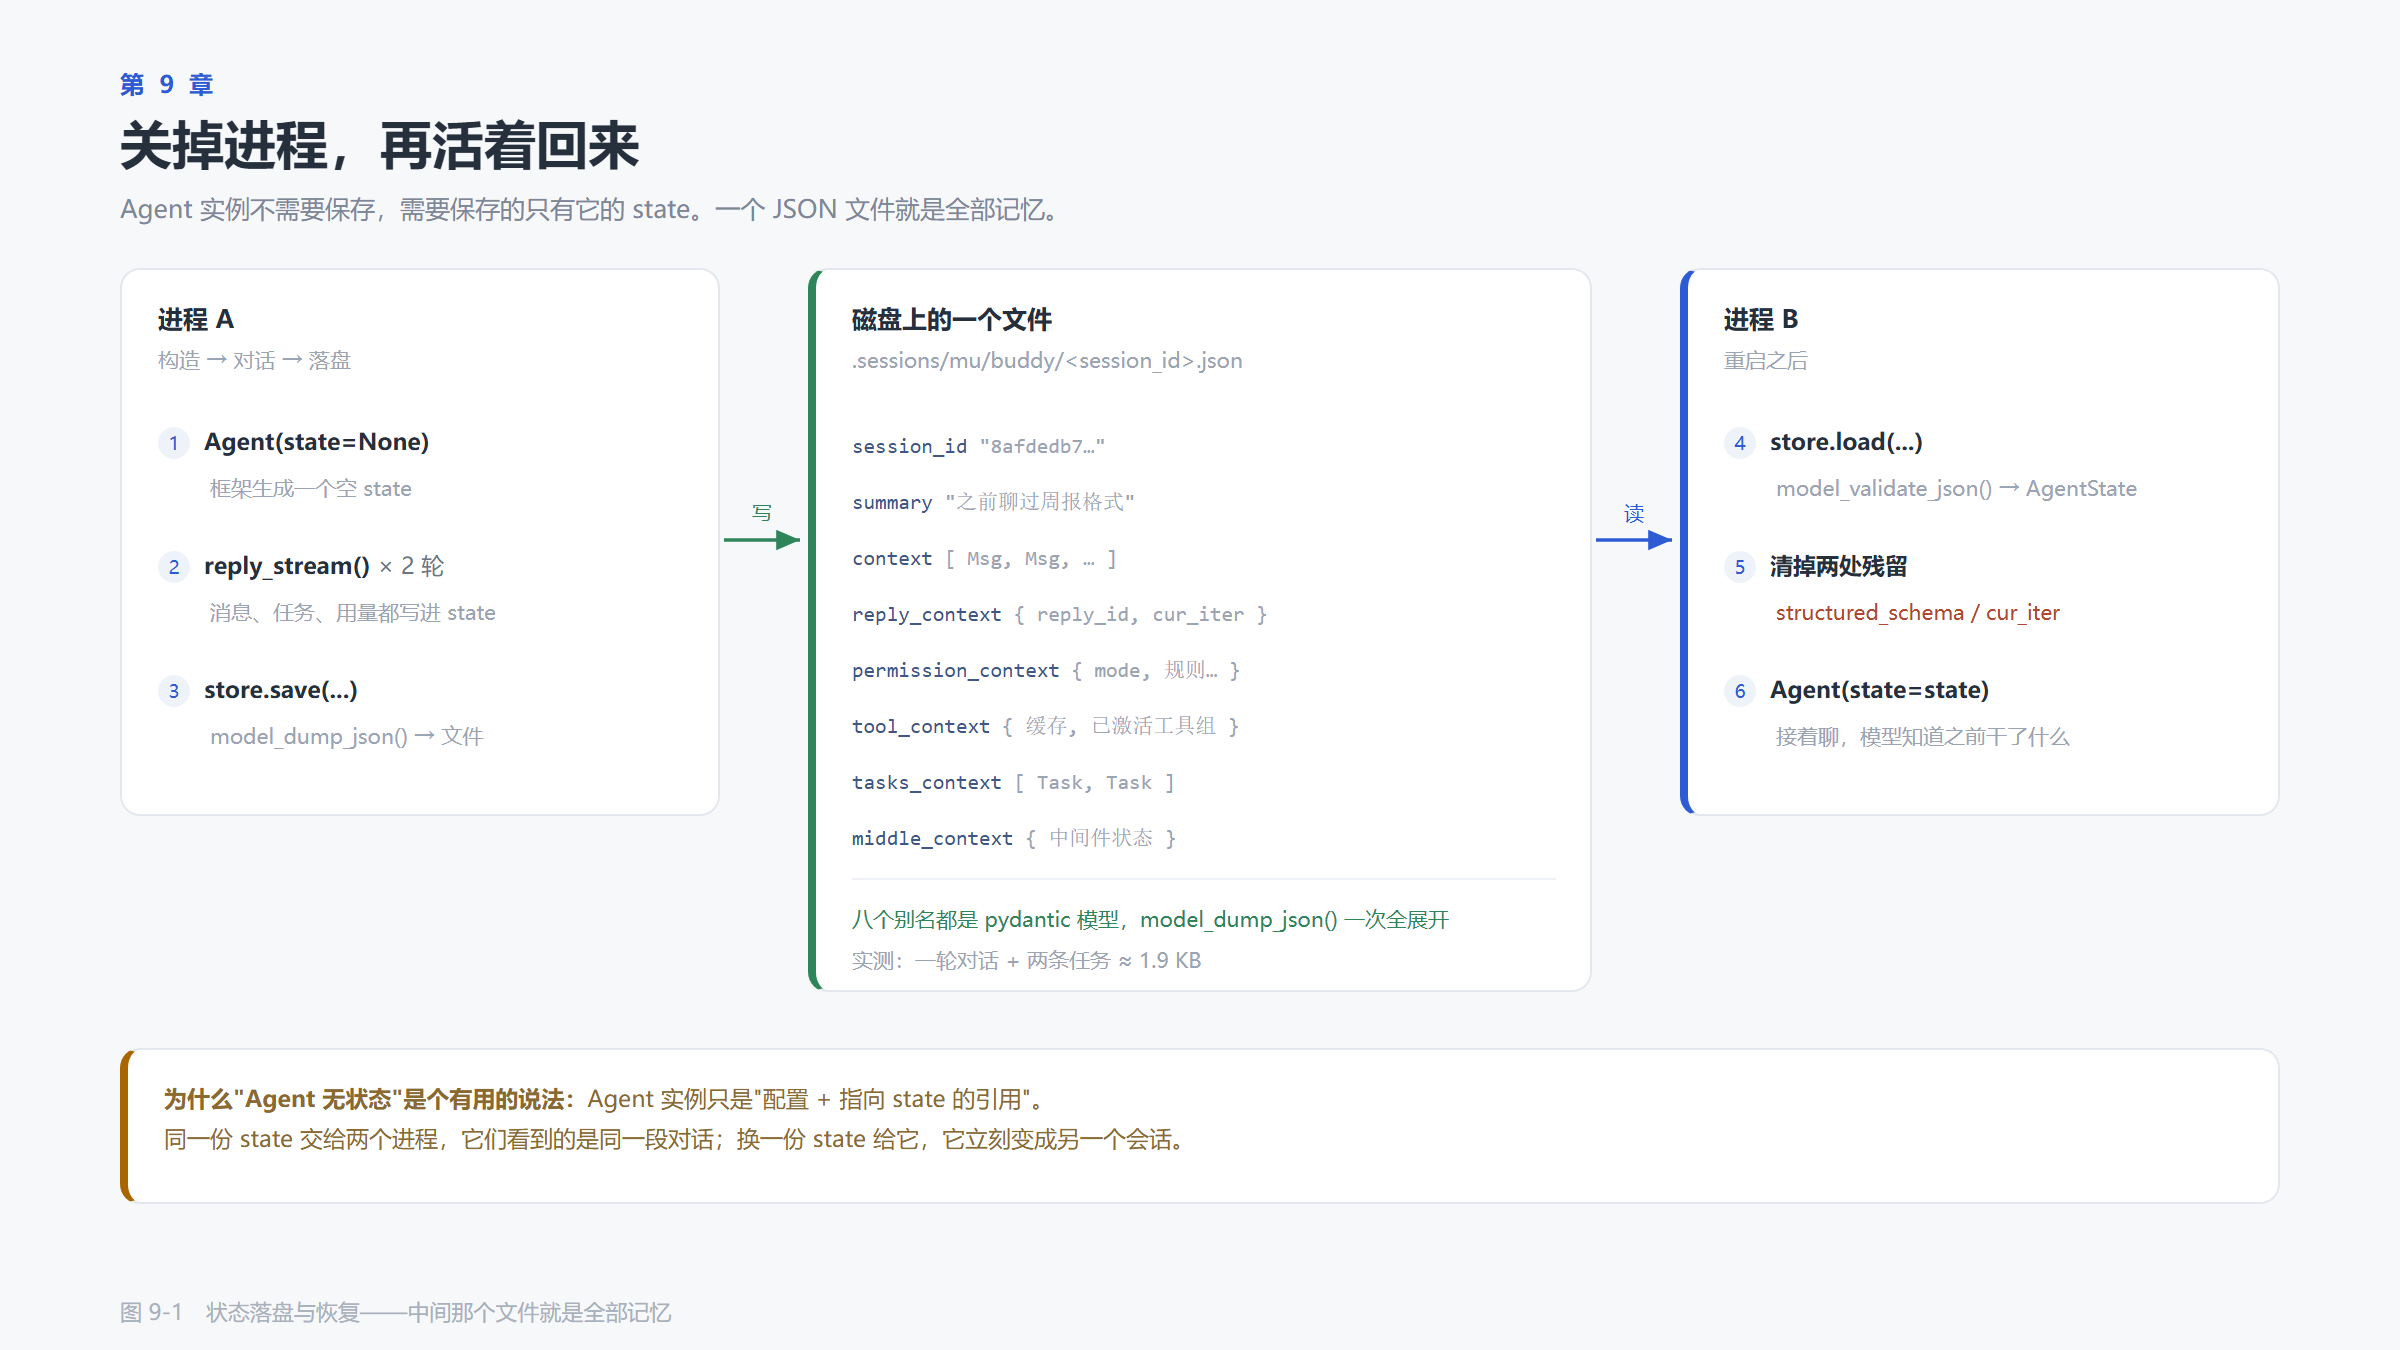
图 9-1 状态落盘与恢复,中间那个文件就是全部记忆
AgentState 是 pydantic 模型,它那八个字段也都是 pydantic 模型。而且真实的数据是嵌套的,context 是一串 Msg,每个 Msg 里是一串 ContentBlock,tasks_context.tasks 里是一串 Task。
层数一多,"存下来"本来是件挺麻烦的事。换成普通 dataclass,你就得为每一层写一个 to_dict(),Msg 一个、ContentBlock 一个、Task 一个,再手工把它们串起来。以后加一个字段要改好几处,漏掉一处就是悄悄丢数据,还不报错。
pydantic 把这活接走了。每个字段是什么类型,定义模型的时候已经写清楚了,model_dump_json() 顺着类型声明往下走,遇到模型就继续展开,遇到列表就逐个展开,遇到 None 就写 null。整条会话存下来是一行调用,不是三十行拼装。
所以在 store.py 里,你找不到一个手写的转换函数。
# 存
state.model_dump_json(indent=2)

# 取
AgentState.model_validate_json(text)读回来走的是同一套类型声明。model_validate_json() 把 JSON 还原成能调方法的对象,msg.get_text_content()、task.subject 读回来照样能用。要是当初存成了普通 dict,回来的只是一堆键值对,取一句话得写 data["context"][0]["content"][0]["text"],一处拼错就报 KeyError。
存出来的文件长这样(真实输出,截取前半段)。Msg、ContentBlock、Task、PermissionRule 都在里面,一层不少。
{
  "session_id": "8afdedb7b46d431dbe67be1dd71b74ef",
  "summary": "之前聊过周报格式",
  "context": [
    {
      "name": "user",
      "content": [
        {
          "type": "text",
          "text": "你好",
          "id": "37fcf37322e545f88240f2cb84583fa3",
          "created_at": "2026-10-22T10:42:13.977472",
          "finished_at": null
        }
      ],
      "role": "user",
      "id": "46770ac7339546598c6a6f95e154491e",
      "created_at": "2026-10-22T10:42:13.977467",
      "usage": null,
      "finished_at": null,
      "finished_reason": null
    }
  ],
  "reply_context": { "reply_id": "...", "cur_iter": 0, "structured_schema": null },
  "permission_context": { "mode": "default", "allow_rules": {}, "deny_rules": {}, "ask_rules": {} },
  "tool_context": { "max_cache_files": 100, "max_cache_bytes": 25000, "read_file_cache": [], "activated_groups": [] },
  "tasks_context": { "tasks": [] },
  "middle_context": {}
}
上面这份还带着一个空的 structured_schema,比 9.1 第 2 段那两个文件多几行,1895 字节。可以看到这个文件不大,中小规模应用完全够用。真到了几千并发再换数据库,接口形状不用变。
读回来这件事,9.1 第 3 段已经演过一遍了。消息回来了,任务回来了,session_id 还是原来那个。标题不用单独存,它由 _guess_title() 从第一条用户消息里取,9.6 会讲。
但有一处得盯住。9.1 第 4 段里 structured_schema 读回来是 None,那不是序列化自己变的,是 store.load() 里手动清的。这是本章最值得记下来的一条。
9.5 恢复时必须处理的三个残留
序列化是无损的,可惜无损不等于正确。有些状态在上一轮里是对的,在新的一轮里是错的。
9.1 第四段那三个字段,就是这一节的全部内容。下面把"为什么要这么处理"讲清楚。
9.5.1 残留一,reply_context.structured_schema
上一轮如果用了结构化输出要一份 JSON,structured_schema 就会留在 state 里。恢复之后,Agent 在开始新一轮回复时会做这件事(源码 _agent.py 约 1109 行)。
if self.state.reply_context.structured_schema:
    await self.toolkit.add_tool(
        _GenerateStructuredOutput(schema=self.state.reply_context.structured_schema),
    )
后果是,你的用户只是想问一句"今天几号",模型却被迫按上次那个 schema 输出 JSON;如果它不输出,框架还会追加一次收尾调用逼它输出。
正确做法是加载后立刻清空。
state.reply_context.structured_schema = None
state.reply_context.structured_output = None
9.5.2 残留二,reply_context.cur_iter
cur_iter 是"当前这一轮已经迭代到第几步"。正常结束时它会被重置;如果上一轮是被强制中断的,进程被杀或者抛了 CancelledError,它可能停在一个非零值上。
恢复一个 cur_iter != 0 的状态,等于让 Agent 以为"这一轮还没结束",它会跳过一些只在轮次开始时做的事,包括上下文压缩检查和时间注入。症状很隐蔽,压缩永远不触发、时间一直是旧的,两件事都不报错。
保守做法是恢复时把它归零。真正的断点续跑需求(第 13 章的中断)另有一套机制,不靠这个字段。
9.5.3 残留三,tool_context.activated_groups
第 6 章讲过工具组,模型用 reset_tools 按需激活,激活列表存在 tool_context 里。
这个字段应该保留,不要清。清掉的后果是,模型记得自己刚才激活过 reporting 组,但实际上工具已经不在 toolkit 里了,下一次调用直接报"未知工具"。它会更困惑,然后重新激活一遍,多花两个来回。
也就是说,这三个残留要区别对待。
表 9-2 三个残留,三种处理
| 字段 | 恢复时 | 理由 |
|---|---|---|
structured_schema / structured_output | 清空 | 上一轮的要求不该延续到新一轮 |
cur_iter | 归零 | 否则跳过轮次开始时的检查 |
activated_groups | 保留 | 工具组的状态必须和 toolkit 一致 |
这三个里最容易漏的是第一个,因为它不报错。第一次遇到"新会话第一句回复变成一段 JSON",多数人会先怀疑模型坏了,或者怀疑自己的提示词写歪了。
9.6 会话列表,别读全量状态
第 12 章的前端要画一个会话列表,这里顺手把数据结构做出来。
list_sessions() 读的是 .meta.json,按更新时间倒序。
def list_sessions(self, user_id, agent_id) -> list[dict]:
    directory = self._dir(user_id, agent_id)
    if not os.path.isdir(directory):
        return []
    sessions = []
    for name in os.listdir(directory):
        if name.endswith(".meta.json"):
            with open(os.path.join(directory, name), encoding="utf-8") as f:
                sessions.append(json.load(f))
    sessions.sort(key=lambda m: m["updated_at"], reverse=True)
    return sessions
元信息有六个字段。
{
  "session_id": "8afdedb7b46d431dbe67be1dd71b74ef",
  "title": "记住:我的周报固定分三段",
  "updated_at": "2026-10-22 10:43:06",
  "message_count": 1,
  "task_count": 2,
  "summary_len": 0
}
标题的处理值得说一下。让模型生成标题效果最好,但要多一次调用,也多一次失败的可能。教学版用了个更省的办法,取第一条用户消息的前 24 个字。
@staticmethod
def _guess_title(state: AgentState, limit: int = 24) -> str:
    for msg in state.context:
        if getattr(msg, "role", "") == "user":
            text = (msg.get_text_content() or "").strip().replace("\n", " ")
            if text:
                return text[:limit]
    return "新会话"
效果出乎意料地好,因为用户的第一句话通常就是任务描述。等到第 14 章我们有了用量统计,可以再加一条规则,对话超过 6 轮时用一次廉价调用重写标题。又省又准,两头都占。
9.7 完整代码走读
code/ch09/main.py 的主线只有四步。
第一步,看有没有指定会话。
session_id = sys.argv[1] if len(sys.argv) > 1 else None
state = store.load(USER_ID, AGENT_ID, session_id) if session_id else None
第二步,造 Agent。 注意 state=state,None 时框架自己造。
agent = await build_agent(workspace, state)第三步,聊,每轮之后存一次。
await chat_once(agent, "记住:我的周报固定分三段,进度、问题、下周计划。")
store.save(USER_ID, AGENT_ID, agent.state)
每轮存一次而不是退出时存一次,是因为"退出时"这个时机不可靠,进程可能被 kill,异常可能直接终止。在状态发生变化的地方立刻落盘,是这章最实用的一条工程习惯。
脚本里有一行 agent.state.permission_context.mode = PermissionMode.BYPASS,放在这儿是有意为之。这是个一口气跑完的命令行 demo,没人坐在终端前点允许。第 7 章说过 BYPASS 只该用在容器或完全信任的场合,这里的信任来自那个 demo 专用的 sandbox 目录。换成有人盯着的交互场景,把它撤掉。
第四步,打印会话列表。
----------------------------------------------------------------------
会话列表:
  8afdedb7…  2026-10-22 10:43:06  消息 2  任务 3  记住:我的周报固定分三段
----------------------------------------------------------------------
想验证恢复,就把这个 id 传回去。
python main.py 8afdedb7b46d431dbe67be1dd71b74ef启动时会看到。
======================================================================
恢复会话 8afdedb7b46d431dbe67be1dd71b74ef
  历史消息 2 条 摘要 0 字
  任务 3 条
======================================================================
然后问一句"我的周报分几段",它答得出来,因为那段话就在 context 里。
9.8 三个常见错误
错误 1:用 json.dump(state) 代替 model_dump_json()
json.dump(agent.state, f) # TypeError: Object of type AgentState is not JSON serializableAgentState 是 pydantic 模型,不是 dataclass。要用它自己的 model_dump_json();想先转成 dict 再处理,用 model_dump(mode="json")。
错误 2:恢复后忘了清 structured_schema
症状是"新会话的第一句回复变成了一段 JSON"。第一次遇到会怀疑模型坏了,其实是上一轮的要求被带过来了。加载后立刻清空,别指望它自己归零。
错误 3:把整个 Agent 对象 pickle 下来
pickle.dump(agent, f) # 大概率失败模型对象里握着 HTTP 客户端,工具对象里握着文件句柄,这些都不可序列化。要存的永远只是 state,Agent 是按需重新构造的。存状态不存对象,这条不管用哪个框架都成立。
9.9 小结
- 先跑
probe_state.py:两个 state 各记各的、磁盘上多出两个文件、del掉对象还能读回来、三个残留一去两留 - Agent 是无状态的,记忆全在
AgentState里;恢复会话就是读文件、造 Agent、传 state 三步 - 三个键定位一条会话,
user_id/agent_id/session_id model_dump_json()/model_validate_json()两行完成往返,不需要手写序列化- 恢复时要清
structured_schema和cur_iter,但必须保留activated_groups - 在状态变化处立刻落盘,别等进程退出
- 元信息单独存一份,会话列表不必读全量状态
到这里,Buddy 能干活、会守边界、会问人、做长任务,关掉终端再打开还记得上次聊到哪。
剩下的事情都在框架内部。怎么在关键节点插手,怎么让它必须按你要的格式回答。
下一章要解决的问题:工具调用前后想加日志、想脱敏、想改参数,除了改工具本身还有别的办法吗?怎么强制模型输出一段符合 schema 的 JSON?