第 4 章 解剖 ReAct 循环
本章代码
code/ch04/bare_loop.py、code/ch04/main.py· 读完约 20 分钟
4.0 上一章留下的问题
第 3 章那张工具往返图,第 ⑤ 步写的是"模型若还要调工具,就回到第 ② 步"。
当时一句话就带过了,因为它的答案得留到这一章。现在回头,把它正面拆开:
- 这一轮到底转几次?
- 什么时候停?
- 如果它停不下来呢?
这三个问题的答案,构成了 Agent 的机芯。理解了它,后面几章全都是在给这块机芯装表壳、上表盘、配日历窗——权限、上下文、持久化、前端,还有 4.2 里那几个暂时无解的老问题。
准备好了吗?我们把后盖拧开,看看里面到底有几个齿轮~~
4.1 先手写:不用框架,看清循环
在搬出框架之前,我们先挽起袖子手写一遍。注意这段代码里没有 import agentscope——它直接用 OpenAI SDK,把上一章那张往返图跑起来。
就像学开车先摸手动挡——离合什么时候踩、挡什么时候换,脚上有了感觉,再开自动挡才知道变速箱在替你干什么。
async def bare_loop(question: str, max_iters: int = 5) -> str:
    messages = [
        {"role": "system", "content": "你叫 Buddy,需要用工具获取信息时必须调用工具。"},
        {"role": "user", "content": question},
    ]

    for i in range(1, max_iters + 1):
        resp = await client.chat.completions.create(
            model=MODEL_NAME,
            messages=messages,
            tools=TOOLS,
        )
        choice = resp.choices[0].message
        print(f"  [第 {i} 轮] 模型返回 tool_calls={len(choice.tool_calls or [])}")

        # 没有工具调用,说明它准备直接回答,循环结束
        if not choice.tool_calls:
            return choice.content or ""

        # 有工具调用:把这次 assistant 消息原样存回历史
        messages.append({
            "role": "assistant",
            "content": choice.content,
            "tool_calls": [tc.model_dump() for tc in choice.tool_calls],
        })

        # 逐个执行,把结果作为 tool 消息追加
        for tc in choice.tool_calls:
            name = tc.function.name
            try:
                if name not in REGISTRY:      # 模型偶尔会编出不存在的工具名
                    raise LookupError(
                        f"没有名为 {name} 的工具。可用工具:{', '.join(REGISTRY)}",
                    )
                args = json.loads(tc.function.arguments or "{}")
                print(f"           → 调用 {name}({args})")
                result = REGISTRY[name](**args)
            except Exception as exc:          # 解析失败、工具炸了,都只影响这一条
                result = f"工具执行失败:{exc}"
            messages.append({
                "role": "tool",
                "tool_call_id": tc.id,
                "content": str(result),
            })
        # 回到循环开头,再问一次模型

    return (
        f"(循环转满 {max_iters} 轮仍未收敛,任务没有完成。"
        f"可以把 max_iters 调大后重试)"
    )
为了看清主干,上面删掉了部分注释和换行;完整文件在 code/ch04/bare_loop.py,加上工具定义和参数表一共 153 行,其中循环本体(bare_loop 这个函数)60 行。
直接 python bare_loop.py 就能跑,它会打印每一轮模型返回了几个 tool_calls——这个数字就是机芯的节拍。
>>> 现在几点?顺便数一下这句话有多少字:手写循环其实不复杂。

  [第 1 轮] 模型返回 tool_calls=2
           → 调用 get_current_time({})
           → 调用 count_text({'text': '手写循环其实不复杂。'})
  [第 2 轮] 模型返回 tool_calls=0
两行 [第 N 轮],就是循环转了两圈。第一圈模型要了两个工具,第二圈它不再要工具,if not choice.tool_calls 命中,return 结束。
回到 4.0 的第一个问题,这一轮到底转几次。答案是圈数不固定,等于模型递申请单的次数加一,最后那一圈它是来交答案的。这个任务要了两个工具,但两个工具落在同一圈里,所以总共两圈。要是模型先查时间、看了结果再决定数字符,那就得三圈。
整个"智能",就藏在这两圈里。听着挺玄,写完你大概会想,就这?
模型最后那段话的措辞每次都会变,但
[第 1 轮] tool_calls=2→[第 2 轮] tool_calls=0这个骨架不会变。看输出时盯骨架,别盯大模型说了啥。骨架看清楚了,不过这段代码真正容易写错的地方,不在"转圈"本身,而在圈里的四件小事——凭什么停(4.1.1)、模型提出过的申请为什么要存回去(4.1.2)、工具结果怎么配对(4.1.3)、工具炸了怎么办(4.1.4)。
那我们就继续出发吧~
4.1.1 循环什么时候停
先说第一件,也是大家最容易忽略的一件。循环凭什么停?
很多人以为,循环会一直转到"任务做完"为止——做完了,它自然就停。
这话大体没错,但"做没做完"只有模型自己知道,你手上能看见的信号只有一个,就是这次响应里有没有 tool_calls。没有,说明模型觉得手头的信息够用了,愿意直接开口回答;只要还有 tool_calls,它就还想要更多。
这条判断能成立,前提是模型愿意主动伸手要工具。它什么时候愿意?多半看工具描述写得清不清楚——描述到位,它一眼就能对上"这个问题该用哪个工具",于是发起调用;描述含糊,它宁可凭记忆硬答,也不愿去调一个自己都看不懂的函数。这又回到第 3 章那个话题。
不过这只是正常情况。还有三种情况会让循环停下,比如撞上 max_iters、用户中断、错误没接住直接把进程带崩。那时候循环也会退出,只是退出的方式不一样(4.5 节讲上限,第 13 章讲中断)。
还有个坑,藏得比较深。
模型的输出是有长度上限的(请求里的 max_tokens,或者模型自身的能力上限)。一旦撞上那个上限,话就说到一半被掐断,响应里的 finish_reason 会变成 length——而不是 stop,意思很直白:"我没说完。"
掐在哪儿,后果不一样:
- 掐在正文中间——一个
tool_calls都没有,循环按"正常结束"处理,return choice.content交出去的是一句半截话,比如"现在的北京时间是 2026-10-30 07:5"。它不报错,这句话就这么显示给用户了。 - 掐在工具参数里——模型正在写
{"text": "手写循环其实不复,参数 JSON 还没闭合就被掐断。这时tool_calls是有的,但json.loads拿到的是半截字符串,直接抛JSONDecodeError——这正是 4.1.4 那个try要连解析一起包住的原因。
所以只盯 tool_calls 还不够,finish_reason 也得扫一眼,stop 是正常说完,tool_calls 是要调工具,length 是被截断,content_filter 是被安全策略拦下。前两种放心往下走,后两种得当异常处理。
上面那段代码里没有这个检查,只留了 if not choice.tool_calls 这一道判断。不是它不需要,是想让主干别被岔开。你自己补的话,大概长这样:
if resp.choices[0].finish_reason == "length":
    return "(回答被截断,可以把 max_tokens 调大后重试)"
框架里这件事由它自己盯着,不用你写。
4.1.2 每次工具调用都要原样存回历史
4.1.1 说的是"循环什么时候结束",这一节说的是"每一圈里留下了什么"。
先明确一下,"历史"指的就是 messages 这个列表。每次调用模型,你都把它整个发过去——模型之所以"记得"前几轮聊过什么,不是它自带记忆,而是你每次都把这份记录重新递了一遍。
现在看模型这一轮的回复。它不只有一句话,还可能附带一张"工具申请单",也就是 tool_calls,写明要调哪几个函数、参数填什么。这张单子必须和它的文字一起,作为一条 assistant 消息存进 messages:
messages.append({
    "role": "assistant",
    "content": choice.content,                                     # 它说的话
    "tool_calls": [tc.model_dump() for tc in choice.tool_calls],    # 它开的申请单
})
tc.model_dump()只是把 SDK 的对象转成普通 dict,方便原样塞回请求。想手写也行,但id、type、function里的name和arguments一个都不能丢——下一小节配对,靠的就是id。
这一步很多人会漏。漏了会怎样?把 messages 打印出来看最直观。
存对了,历史长这样——一条申请单,紧跟一条处理结果:
[
  {"role": "user", "content": "现在几点?"},
  {
    "role": "assistant",
    "content": "",
    "tool_calls": [
      {
        "id": "call_abc",
        "type": "function",
        "function": {"name": "get_current_time", "arguments": "{}"}
      }
    ]
  },
  {"role": "tool", "tool_call_id": "call_abc", "content": "2026-10-30 15:57:21"}
]
漏了那条 assistant 呢?它变成这样:
[
  {"role": "user", "content": "现在几点?"},
  {"role": "tool", "tool_call_id": "call_abc", "content": "2026-10-30 15:57:21"}
]
第二份记录里,那条 tool 消息在说"call_abc 这事儿办完了",可整段历史里根本找不到 call_abc 这张单子。API 校验时就卡在这儿,直接返回 400,报错信息大概是 messages with role 'tool' must be a response to a preceding message with 'tool_calls'。
这就是为什么申请单必须留着——它不只是给模型看的上下文,还是那条 tool 消息的"出身证明"。(tool 消息的写法下一小节细说,这里先看结构。)
4.1.3 工具结果要配对回填
申请单存好了,结果也回来了,现在把结果写回历史——关键是让每条结果都带上"我回答的是哪张单子"。这个编号就是申请单里的 tc.id,填进 tool_call_id:
# tc 就是当前这张申请单,tc.id 就是它的编号
messages.append({
    "role": "tool",
    "tool_call_id": tc.id,     # 回答的是哪一张单子
    "content": str(result),    # 办完的结果;API 只收字符串,所以要转一下
})
对照 4.1.2 那份历史,assistant 里的 "id": "call_abc",和 tool 里的 "tool_call_id": "call_abc" 是同一个值。这就是"配对"的全部含义——API 靠这个编号把结果认领回具体的某张单子,而不是靠它排在第几个。
所以有一条申请单,就必须回一条结果。模型一次要调三个工具,你就得回三条 tool 消息,各自带好自己的 tool_call_id;少一条,API 就报错(大意是"每个 tool_calls 都要有对应的 tool 消息")。
顺序上建议照着申请单的次序来。大多数服务是按 tool_call_id 匹配的,按顺序排不会吃亏,打乱了却可能在别的实现上出问题——没必要冒这个险。
编号是从哪来的,要是记不清了,翻回第 2 章看一眼
assemble_msg.py跑出来的东西——那份例子里id="call_1"出现了两次,一次在调用上,一次在结果上~
4.1.4 异常必须变成结果
前面三节,默认的都是"工具能顺利跑完"。可现实里还有另一半——它跑不完。参数是坏的,工具名是编的,真跑起来还会炸(文件不在、网络断了、没权限)。
这些要是接不住,Agent 就成了一次性的,模型错一次,会话就报废。所以这一节干的,是把失败也变成一条能继续往下传的消息。
try:
    if name not in REGISTRY:
        raise LookupError(
            f"没有名为 {name} 的工具。可用工具:{', '.join(REGISTRY)}",
        )
    args = json.loads(tc.function.arguments or "{}")
    result = REGISTRY[name](**args)
except Exception as exc:
    result = f"工具执行失败:{exc}"
这段 try 同时管着解析参数和执行工具两件事。我当初只包了后一件。
看着挺合理,跑十几次也都正常,直到某天模型给的参数少了个引号:
{"text": "手写循环其实不复杂。}json.loads 当场抛 JSONDecodeError,它在 try 外面,没人接,程序直接退出——前面聊的十几轮一起没了。把解析那句挪进来就好了。异常被接住,回填给模型的是"工具执行失败:Unterminated string starting at...",它下一轮看到这句,会自己把参数补齐重写一遍,接着往下干。
第二个坑更冤。模型说要调 read_file,可你的 REGISTRY 里只有 get_current_time 和 count_text,REGISTRY["read_file"] 直接抛 KeyError,一样能把程序带崩。所以前面才有那句 if name not in REGISTRY——先拦下来,回一句"没有名为 read_file 的工具。可用工具:get_current_time, count_text"。别小看后半句,模型全靠它才知道该改成什么。
这两个坑踩完,再看这段代码就顺了,异常不是要处理掉的麻烦,它是下一轮的输入。
4.2 手写版漏了七件事
上面那 60 行能跑通,甚至能跑得不错。但它是一个"演示级"的循环,演示的时候什么都不缺,真干起活来问题就全冒出来了。
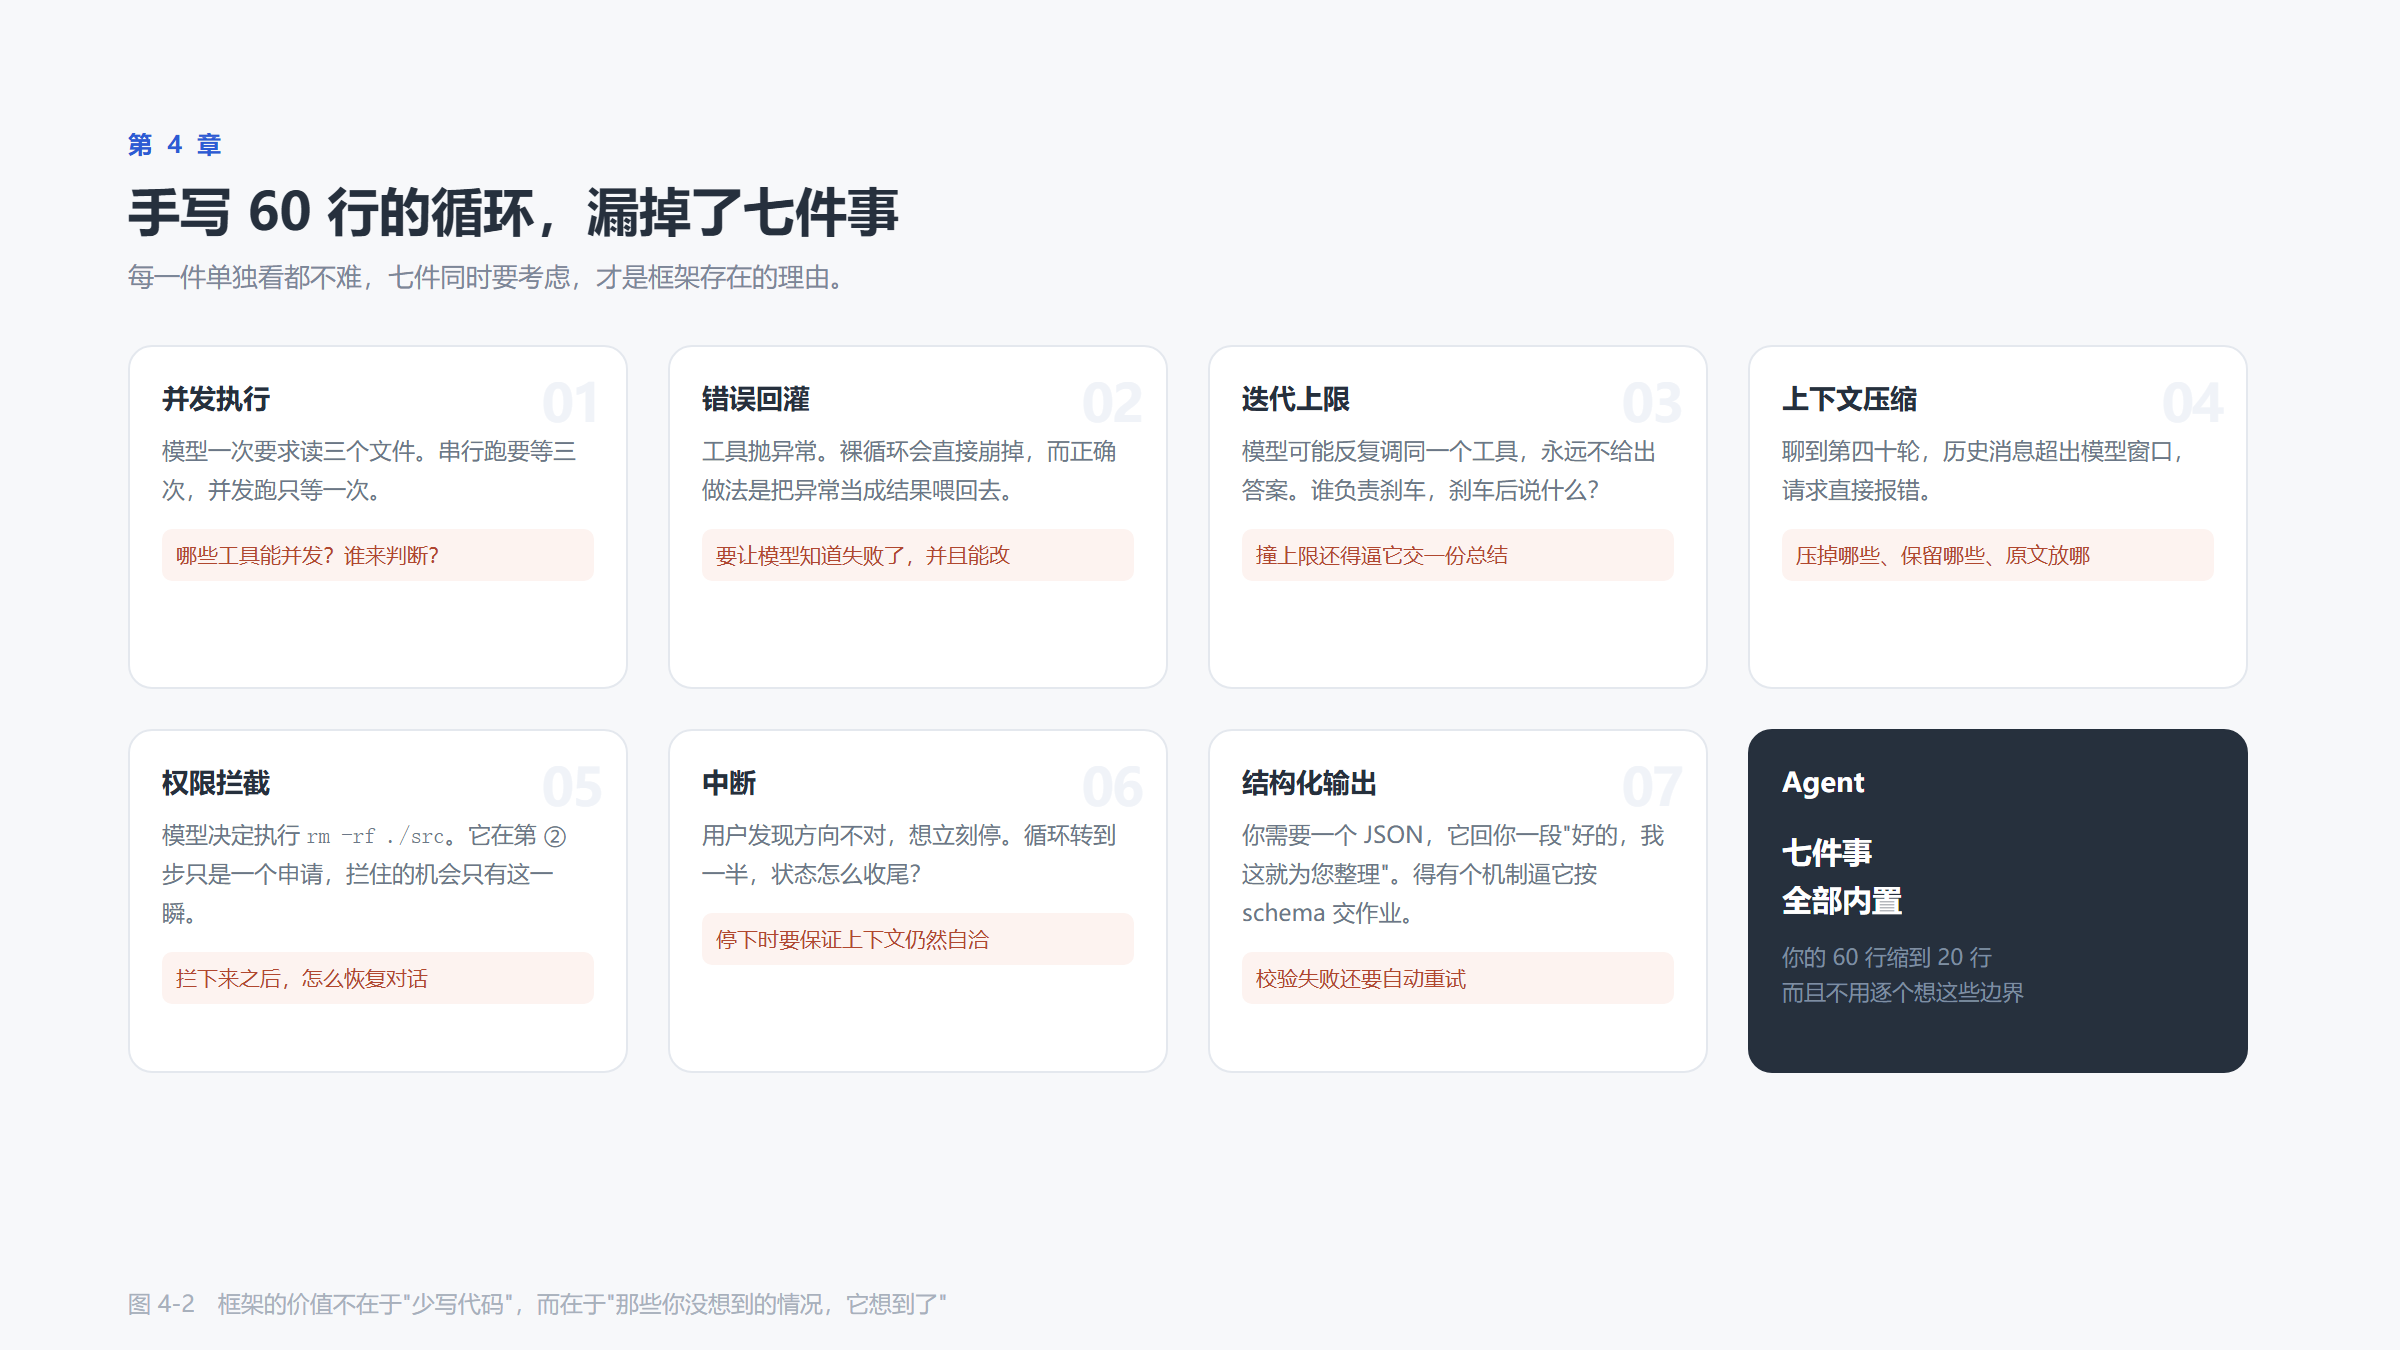
我们一个一个地来看。
先说并发执行。模型一次要求读三个文件,手写版是一个 for 循环串下去的,读一个等一个。三个文件本来能同时读,硬生生拖成三倍等待——省掉的那三分之二时间,就这么扔了。当然前提是判断得出"这三个工具互不依赖",读三个不同文件算是最典型的情况。
再说错误回灌。上面我们做了 try/except,但只做了最粗的一层,也就是接住、转成字符串、塞回去。工具超时怎么办?返回值几十兆怎么办?错误信息太长要不要截断?这些手写版一概不管,而真实工具恰恰总在这上面出问题。
迭代上限也有讲究。手写版撞上 max_iters,只是丢回一句"任务没完成",用户在界面上看见这句,完全不知道发生了什么。框架不这么干——撞上限之后它还会再催一次,注入提示让模型把查到的东西总结成文字,实在不交才收场(4.5 节细说)。
上下文压缩就更别提了。Agent 一直调工具,messages 只会越来越长,手写版一点压缩都没有。聊到第四十轮,它超出模型窗口,请求直接报 400。
还有权限拦截。手写版是模型说要调什么就调什么,哪次它心血来潮要跑 rm -rf ./src,你连插手的机会都没有。
这一条值得停一下,它是七件里唯一一件光靠提示词解决不了的,而且经常被写成一句话糊过去。它其实挤着两件事,得拆开看。
第一件是边界,也就是工具能不能做到。 Read 收到 ~/Desktop/工资条.xlsx 会照读不误,Write 收到一个绝对路径会照写不误。它没有"我该待在哪"这个概念——路径对它就是个字符串,open() 传什么它开什么。
这件事提示词解决不了。你在 system_prompt 里写十遍"不要访问工作区以外的文件",它依然可能某次推理里顺手看一眼。不是因为它想造反,是因为它根本不知道边界在哪。这个坐标系对它不存在,它没法自检。更糟的是这股劲儿是写进工具描述里的,框架自带的 Read 第一句就是 You can access any file directly by using this tool,还要求参数必须是绝对路径——它压根没有"相对"这个概念,chdir 都管不着它。
工程上的正解叫路径收敛,工具拿到的每个路径都先拼回根目录再校验,落在根目录外面的直接拒。
ROOT = Path("./workspace").resolve()

def safe_path(p: str) -> Path:
    target = (ROOT / Path(p).expanduser()).resolve()   # ~ 、.. 、软链接全展开
    if not target.is_relative_to(ROOT):                # 绝对路径会顶掉 ROOT,靠这行拦
        raise PermissionError(f"{p} 不在工作区内")
    return target
ROOT / "/etc/passwd" 的结果就是 /etc/passwd——右边是绝对路径时,它直接覆盖左边。所以那行校验不是"防御性冗余",是唯一的拦截点。这一层管得住读写,管不住 Bash——它收的是一个字符串,cd / 一句话就出去了,只能换执行环境(容器、bubblewrap 那一类)。第 5 章讲工作区,第 7 章讲沙箱。
第二件才是审批,也就是要不要做。 模型申请删三个文件,你不一定都同意;同一个写操作落在 ./tmp 和落在 ./src,风险也不是一回事。这是 PermissionMode 管的事,也在第 7 章。
两件都得有,因为它们拦的不是同一样东西。边界拦能力,审批拦意图。缺边界,一次误判就是既成事实,连补救的机会都没有;缺审批,边界之内那些"合法但不该做"的操作照样会发生。
中断是另一回事。用户想停,手写版没有入口。循环跑到一半被 Ctrl+C 打断,messages 就停在一个"有调用没结果"的非法状态,下次恢复还得先修它。
最后是结构化输出。你需要一个 JSON,它回你一段"好的,我这就为您整理"。总得有个机制逼它按 schema 交作业,还要在格式不对时自动重试。
上面这些问题,就是后面几章的主线。先不要急,我们才刚把后盖拧开,里面还有好几层。
现在你已经看见机芯长什么样了~~
4.3 换成 Agent:同样的任务
刚才那 60 行露出了七个缺口,不过这些先放着,后面几章一个个补。这一节我们换个写法,同一个任务,交给 AgentScope 的 Agent,看框架接管以后,代码长什么样。
agent = Agent(
    name="Buddy",
    system_prompt=(
        "你叫 Buddy,是一个住在命令行里的工作助手。"
        "需要用工具获取信息时必须调用工具。回答简短。"
    ),
    model=build_model(),
    toolkit=build_toolkit(),
    react_config=ReActConfig(max_iters=10),
)

# 命令行脚本没有确认界面。工具默认会"停下来等人点头",
# 在这里就会卡在 REQUIRE_USER_CONFIRM 上。先整体放行,第 7 章再管住它。
agent.state.permission_context.mode = PermissionMode.BYPASS

async for event in agent.reply_stream(UserMsg(name="user", content=question)):
    ...
build_model() 和 build_toolkit() 直接复用第 3 章的写法,这里不重复解释。
需要留意的只有一处,工具是从哪来的。main.py 开头那句 from bare_loop import count_text, get_current_time 不是随手写的,build_toolkit() 里注册的就是手写版那两个函数本身,没另写一份。同一份实现、同一套行为,两边跑出来的结果才有法比较。
代码里还冒出三样新面孔,这里先打个照面,细节都在后面:
ReActConfig(max_iters=10),就是手写版那个max_iters参数,搬进了一个配置对象,4.5 节细讲。手写版给 5,这里写 10,只是留点余量;PermissionMode.BYPASS,命令行没有界面,工具默认会停下来"等人点头",这里先整体放行,第 7 章换成真正的确认流程;reply_stream(...),第 2 章见过的流式接口,这次用它把循环的每一拍吐成事件。
把两段代码并排看一眼,最先注意到的是 for i in range(...) 那行没了。
原来那几十行里干的事,数圈数、往 messages 里追加、判断要不要再问一次,现在一行都不剩,全被 Agent 收进去了。你既看不到圈数,也看不到 messages.append(...),连现在转到第几轮都得自己数。
不过循环也没真的躲起来,只是换了个地方,就在你写的那行 async for 里。
手写版的 for 是用来数圈数的,转一次问一次模型。这里的 for 改成收事件了。模型每问一次、每调一个工具、每说一句话,Agent 都会往外扔一个事件,你在循环体里接住就行。MODEL_CALL_START 表示又去问模型了,TOOL_CALL_START 表示模型点名要某个工具,REPLY_END 表示这一轮说完了。
接下来要做的,就是把这些事件按时间排开,看清一轮对话里到底发生了多少件事。4.4 节那张时间线,就是从这儿来的。
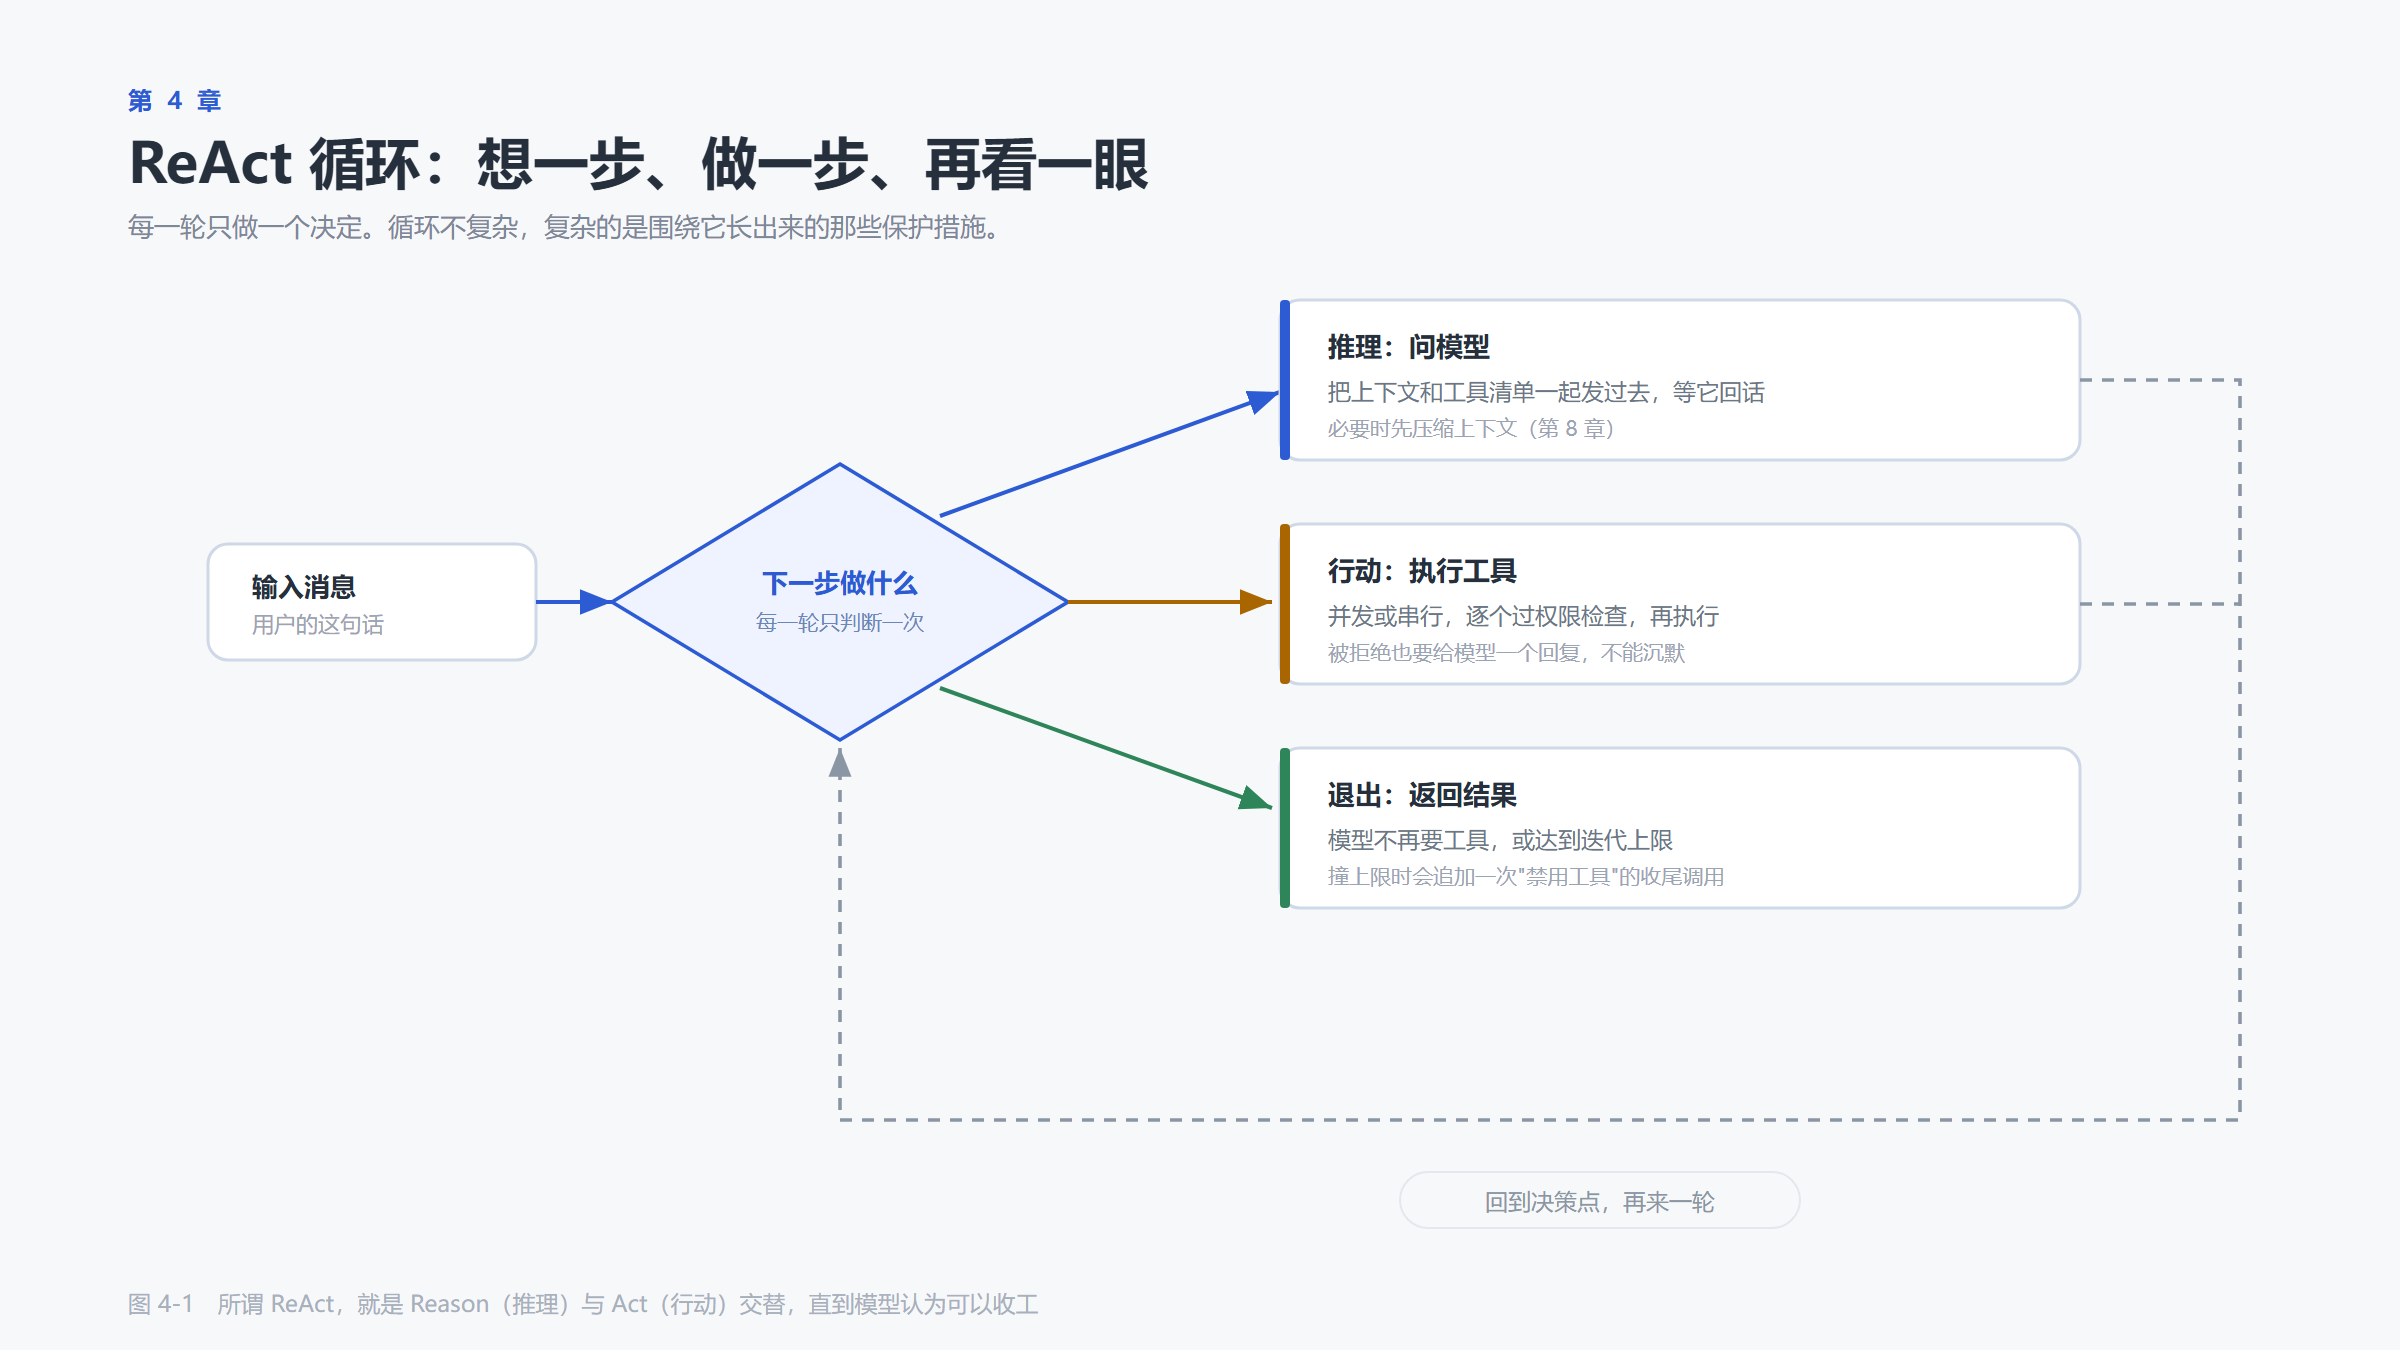
每一轮,Agent 在一个统一的决策点检查当前状态,然后选一条路走:
| 分支 | 触发条件 | 产出 |
|---|---|---|
| 推理 | 需要问模型 | MODEL_CALL_START 及后续内容块事件 |
| 行动 | 模型要求调用工具 | TOOL_CALL_* / TOOL_RESULT_* |
| 宽限 | 撞上 max_iters | 注入 HINT_BLOCK,工具关掉或换成结构化输出工具,逼模型交结果 |
| 退出 | 模型不再要工具,或收尾那轮也没交出结果 | REPLY_END |
看到这儿,回头再看第 2 章那张事件表,很多名字就都有因果解释了。要是已经忘了那张表长什么样,这里再列一遍,省得来回翻。
| 分组 | 事件 | 什么时候出现 |
|---|---|---|
| 一轮回复 | REPLY_START / REPLY_END | 整轮开始和结束,像一对括号 |
| 调用模型 | MODEL_CALL_START / MODEL_CALL_END | 每次向模型发请求;一轮里可能调用多次 |
| 文本 | TEXT_BLOCK_START / _DELTA / _END | 模型开始说话、逐字吐字、说完 |
| 思考 | THINKING_BLOCK_START / _DELTA / _END | 同上,只是内容是推理过程 |
| 工具调用 | TOOL_CALL_START / _DELTA / _END | 模型决定调工具,参数一点点拼出来 |
| 工具结果 | TOOL_RESULT_START / _DELTA / _END | 工具执行,结果一点点回传 |
| 提示 | HINT_BLOCK | 框架自己塞进去的提示 |
| 人机交互 | REQUIRE_USER_CONFIRM / USER_CONFIRM_RESULT | 等用户点头(第 7 章) |
| 异常 | EXCEED_MAX_ITERS | 迭代次数超限,被强制终止 |
表里只留了跟循环有关的几组,完整 28 种还在第 2 章 2.4 节。
对着表看,MODEL_CALL_START 为什么会出现第二次、第三次,就说得通了——循环转了不止一圈,每转一圈就要问一次模型。同理,TOOL_CALL_START 之所以能连着出现两三次,是因为模型一次就递了两三张申请单,工具那边得一张一张接着办。
4.4 事件时间线:把循环的每一拍摊开
code/ch04/main.py 里有一个打印器,把事件流按"层级 + 耗时"排成时间线。看懂它要抓住三件事:哪些事件上屏,缩进从哪来,每行右边那截文字从哪来。
# 事件名 -> 缩进层级。只列会出现在时间线上的事件,无载荷的见 IGNORE_EVENTS
DEPTH = {
    "REPLY_START": 0,
    "REPLY_END": 0,
    "MODEL_CALL_START": 1,
    "MODEL_CALL_END": 1,
    "REQUIRE_USER_CONFIRM": 1,  # 第 7 章才有确认环节,本章走 BYPASS 不会触发
    "TOOL_CALL_START": 2,
    "TOOL_RESULT_END": 2,
}

# 不展示的事件:无载荷的过渡事件,以及框架注入的提示
IGNORE_EVENTS = {
    "TOOL_CALL_END", "TOOL_RESULT_START",
    "TEXT_BLOCK_START", "TEXT_BLOCK_END",
    "THINKING_BLOCK_START", "THINKING_BLOCK_END",
    "HINT_BLOCK",
}

async def run_with_trace(agent: Agent, question: str) -> None:
    start = time.perf_counter()
    async for event in agent.reply_stream(UserMsg(name="user", content=question)):
        kind = event.type.value
        elapsed = (time.perf_counter() - start) * 1000

        # 逐字增量与无载荷事件都不进时间线
        if kind.endswith("_DELTA") or kind in IGNORE_EVENTS:
            continue

        indent = "  " * DEPTH.get(kind, 1)
        print(f"{elapsed:8.0f}ms  {indent}{kind:<22} {payload(event)}")
代码贴完了,下面把这三样东西分别说一下。
DEPTH 管缩进。REPLY_START 记的是 0,MODEL_CALL_START 是 1,TOOL_CALL_START 是 2," " * DEPTH.get(kind, 1) 一乘,层级就出来了。表里没写的事件默认按 1 层处理,不至于因为漏登记就挤到最左边。
IGNORE_EVENTS 管过滤。TOOL_CALL_END、TEXT_BLOCK_START 这类事件只表示"某件事开始/结束了",本身没有内容可看,留在时间线上就是噪音。滤掉之后,同一个工具名出现两次就是实实在在调了两次,中间不会夹着没用的行。逐字增量 *_DELTA 也在这一行被跳过,不然光打字就能刷满一屏。
payload(event) 管挑字段。一个事件带着一堆属性,屏幕上放不下也不该全放,于是工具调用只取工具名,模型调用只取 in= / out= 的 token 数,一轮结束只取结束原因。这个函数是四五个 if,按事件名取对应字段,没贴进正文,看 code/ch04/main.py 一眼就清楚。
这三样东西刚好也是第 12 章前端要的全部素材。把 print 换成创建一个 DOM 节点," " * DEPTH 换成 CSS 的 padding-left,payload(event) 换成往节点里填文本,命令行里这张时间线就变成了网页上的对话记录。
上面为了看清主干,一共省掉了三处。payload() 是一处;另外两处一是累计 MODEL_CALL_START / TOOL_CALL_START 的个数和 token、用来打最后那行汇总,二是把 TEXT_BLOCK_DELTA 攒起来、到 MODEL_CALL_END 时整段印出模型这一轮说的话。完整版都在 code/ch04/main.py,跑起来就能看到它们的效果。
直接 python main.py,实测输出:
>>> 你:现在几点?顺便数一下这句话有多少字:手写循环其实不复杂。
------------------------------------------------------------------------
       0ms  REPLY_START
       4ms    MODEL_CALL_START
    1445ms      TOOL_CALL_START       get_current_time
    1632ms      TOOL_CALL_START       count_text
    1817ms    MODEL_CALL_END         in=422 out=132
    1980ms      TOOL_RESULT_END       success
    1980ms      TOOL_RESULT_END       success
    1987ms    MODEL_CALL_START
    3715ms    MODEL_CALL_END         in=524 out=141

- 现在:2026-10-30 07:57 UTC(星期五;工具返回的本地时间为 15:57)
- 「手写循环其实不复杂。」:共 10 个字符,其中中文 9 个字(含句号)

    3715ms  REPLY_END              completed
------------------------------------------------------------------------
模型调用 2 次|工具调用 2 次|token in=946 out=273|总耗时 3715ms
拿 4.1 手写版的输出对一下,两边的骨架一模一样,都是问两次模型、调两次工具。差别在手写版只肯打两行 [第 N 轮],这里改成了事件流。
耗时和 token 数跟模型、网络都有关系,别照着数字背,盯结构就行。打印器也做了取舍,TEXT_BLOCK_START、TOOL_CALL_END 这种只表示开始和结束、本身没有内容的事件,还有 HINT_BLOCK 这种框架自己塞进去的提示,都没让它们上时间线。
有个地方第一次看容易卡住,MODEL_CALL_END 居然排在 TOOL_RESULT_END 前面。原因是模型一边生成一边就把"要调哪两个工具"说出来了,TOOL_CALL_START 在流里陆续发出,直到这段生成彻底写完,才发 MODEL_CALL_END;工具要等参数齐了才开始跑,结果自然落在后面。
顺带说一句缩进。TOOL_RESULT_END 缩了两级,和 TOOL_CALL_START 平级,可它实际发生在 MODEL_CALL_END 之后。DEPTH 这张表记的是"这条事件属于哪一轮决策",不是"它在时间上嵌在谁里面"。读的时候当成归类,别当成括号,按行号看时间、按缩进看归属,两下分开就不会晕。
这张图最直接的信息是时间花在哪。两次模型调用加起来 3.5 秒,总耗时 3.7 秒,工具执行一共 163 毫秒。慢的是等模型写字,不是干活。第 8 章要花整整一章讲上下文压缩,原因也在这儿,上下文越长,这一趟回得越慢,token 也越贵。
第二件事有点扫兴,这张图证明不了两个工具是不是并发跑的。有人会说两个 TOOL_CALL_START 挨得那么近,肯定是并发,可 get_current_time 和 count_text 都是瞬时返回的东西,串行跑撑死差一两毫秒,早被网络抖动盖过去了。两条 TOOL_RESULT_END 都停在 1980ms,既可能是并发,也可能只是都太快。
真想弄明白,改个变量试试。给两个工具各加一句 await asyncio.sleep(0.5),再跑一遍,两条结果还落在同一毫秒就是真并发,差了半秒就是排队。这种改一点、看输出怎么变的习惯,比记住别人给的结论管用。
最后一行 REPLY_END 后面跟着 completed,说明这轮是真走完了。这个字段换了值就有事,exceed_max_iters 是转晕了被拦住,error 是中间某步炸了,interrupted 是用户按了停止。前端照着它给不同的说法,用户才不至于对着一个转圈动画干等。
前面说过这个打印器其实就是第 12 章前端的原型。前端干的事,无非是把这张时间线挪到网页上,MODEL_CALL_START 显示成正在输入,TOOL_CALL_START 变成一张工具卡片,TEXT_BLOCK_DELTA 接着一个字一个字往外蹦。
4.5 控制循环:ReActConfig
手写版里圈数是你自己数的,for i in range(max_iters) 写几就转几。现在这个数字挪到了配置对象上,ReActConfig(max_iters=10) 的第一个参数管的还是同一件事。
不一样的只有撞限之后怎么办。手写版是 break 出来,丢一句"没完成"就完事,框架后面还有动作,本节末尾细说。
from agentscope.agent import ReActConfig

react_config = ReActConfig(
    max_iters=10,                        # 最多转 10 轮
    structured_output_grace_iters=5,     # 结构化输出的宽限轮数,默认也是 5
)
ReActConfig 一共五个字段,本章真正用得上的是前两个,剩下三个先摆在这儿,知道有这么回事就行。stop_on_reject 得等第 7 章的权限机制到位才有意义,最后两个跟中断有关,第 13 章再说。
| 参数 | 默认值 | 作用 |
|---|---|---|
max_iters | 50 | 最多多少轮推理-行动迭代 |
structured_output_grace_iters | 5 | 超过 max_iters 后额外允许的轮数,专门用来产出结构化输出 |
stop_on_reject | False | 工具调用被拒绝时,是否立刻终止回复 |
interruption_message | 'I notice the interruption. How can I help you?' | 被中断时补的那句话 |
interruption_raise_cancelled_error | False | 中断时是否抛 CancelledError,而不是正常结束 |
max_iters 默认 50,这个值比大多数人的直觉大得多。为什么?因为复杂任务确实需要转很多圈,读十个文件、改五处代码、跑三次测试,五十轮并不夸张。
但它同时也是一个成本开关。每一次循环都是一次 API 调用,50 轮意味着最坏情况下 50 次请求。示例里把它压到 10,不是因为这个任务需要 10 圈,其实两圈就完了,写多少都碰不到上限。压小的用意是让你记住一件事,这个数字直接对应着你会收到多少账单。
撞上
max_iters之后会发生什么不会立刻停。
cur_iter走到 10 那一步,框架先给你一次收尾的机会。它往对话里塞一条<system-reminder>,大意是"轮数用完了,把已经查到的整理成文字交出来,别再调工具",同时把tool_choice设成"none",工具全关。这一次调用是硬的,只给一次。但要留意,这一次也算轮数。它跑完,
cur_iter就从 10 变成 11。如果你的任务要的是结构化输出,也就是给 agent 设了
structured_schema,那情况不一样。多给的就不是一次,而是structured_output_grace_iters那么多轮,默认 5。这几轮里工具不关,而是换成那个专门产出结构化结果的工具,逼模型按格式交。收尾那次也没交出文字,比如它还在要工具,这才真收场。此时发出
EXCEED_MAX_ITERS事件,finished_reason记成exceed_max_iters。这个事件在 2.x 里已经标了 deprecated,只为了兼容老代码才留着,别拿它当主信号。还有个坑得单独说。只要那次收尾调用跑过,
cur_iter就大于max_iters,走文字收尾这条路时finished_reason会记成exceed_max_iters,哪怕模型已经把整段答复写完了。换句话说,这个字段只回答"轮数用超没有",不回答"东西交出来没有"。想知道后者,去看get_text_content()返回的内容是不是空的。
4.6 三个常见错误
错误 1:以为 reply() 只调用一次模型
reply = await agent.reply(msg) # 这一行背后,可能是 2 次模型调用,也可能是 20 次如果按"一次 reply = 一次 API 调用"来估算成本,会低估得很离谱。就拿本章这个只有两个工具的小任务来说,它已经调了 2 次。正确做法是读 reply.usage,里面的 input_tokens 和 output_tokens 是一次 reply 里所有模型调用累加出来的,调了几次它自己记着;也可以数 MODEL_CALL_END 事件的个数,两种对得上。
错误 2:把 TOOL_CALL_START 当成"工具已经执行完了"
TOOL_CALL_START 只表示模型提出了申请。工具可能还在执行(TOOL_RESULT_START),可能被权限拦下了(REQUIRE_USER_CONFIRM),也可能失败了(TOOL_RESULT_END 且 state="error")。界面上应该在这三个时刻显示不同状态。
错误 3:在 system_prompt 里写"最多使用三个工具"
模型对这类数量约束的执行力很弱,而 max_iters 是硬约束。能用配置解决的,不要用提示词解决。
4.7 小结
- 一般情况下,循环在模型不再请求工具时结束,而不是"任务完成";撞上限、中断、错误没接住,是另外三条终止路径
- 手写循环 60 行就能跑,但漏了七件事,分别是并发、错误回灌、上限、压缩、权限、中断、结构化输出
Agent把循环藏了起来,用事件流暴露过程- 事件时间线是前端界面的原型——
MODEL_CALL_START变成"正在输入",TOOL_CALL_START变成工具卡片 ReActConfig.max_iters默认 50,是成本开关,也是安全阀
下一章要解决的问题:4.2 那个 safe_path 能管住读写,但管不住 Bash——命令是个字符串,cd / 就出去了;而且每个工具都得自己套一层,漏一个就白搭。下一章换个装法,先划一块地,再把地里的工具发出去,让边界从"代码里的检查"变成"环境自带"。顺便说清一件事——LocalWorkspace 的 workdir 是锚点不是笼子,真笼子在容器那类工作区里。