第 11 章 后端:把事件流出去
本章代码
code/ch11/(main.py/runtime.py/mock_model.py) · 读完约 24 分钟
11.0 上一章留下的问题
前十章,Buddy 的能力都在一个 asyncio.run() 里。它跑在终端,输出是 print。
要变成产品,需要跨过一道沟:浏览器的请求是短的、有超时的,而 Agent 的工作是长的、会停顿的。
ChatGPT 时代最典型的错误做法,是让 POST /chat 一直挂着等结果。三层问题:
- 中间任何代理(Nginx、云负载均衡)默认 60 秒超时,长任务必被掐断
- 用户在等待期间看不到任何进展,不知道它是在思考还是已经死了
- 一轮对话可能触发 20 次工具调用,总时长以分钟计,但用户只想知道"它现在在干什么"
正解是:把"做事"和"看进度"分开。 发问用一个短请求,进度用一条长连接推过来。
这一章搭这个后端。第 12 章再管界面。
11.1 为什么是 SSE,不是 WebSocket
先把这个选择说清楚,因为它会影响后面所有代码的形状。
| 维度 | SSE | WebSocket |
|---|---|---|
| 方向 | 服务端 → 客户端单向 | 双向 |
| 协议 | 普通 HTTP,text/event-stream | 需要 Upgrade 握手,独立的帧协议 |
| 断线重连 | 浏览器内置,自动带 Last-Event-ID | 要自己写重连和重放 |
| 调试 | curl -N 就能看 | 要装工具 |
| 代理穿透 | 与普通 HTTP 一致 | 部分代理需要额外配置 |
| 一条连接上的并发 | 浏览器限制同域 6 条 | 较多 |
我们真的需要双向吗? 不需要。上行的动作只有三件:发消息、批准或拒绝、中断。这三件都是离散事件,用普通 POST 足够。真正的下行才是高频的——一段段文字增量、一次次工具调用。
所以这里选 SSE,客户端动作走普通 POST。看起来比 WebSocket 少了"双向",其实更省心:一条线只负责服务端往下播报,另一头只负责客户端发请求。 服务端拿着会话状态,客户端每做一个动作就发一个明确请求,两边不容易搅成一团。
11.2 一次提问,三条请求线
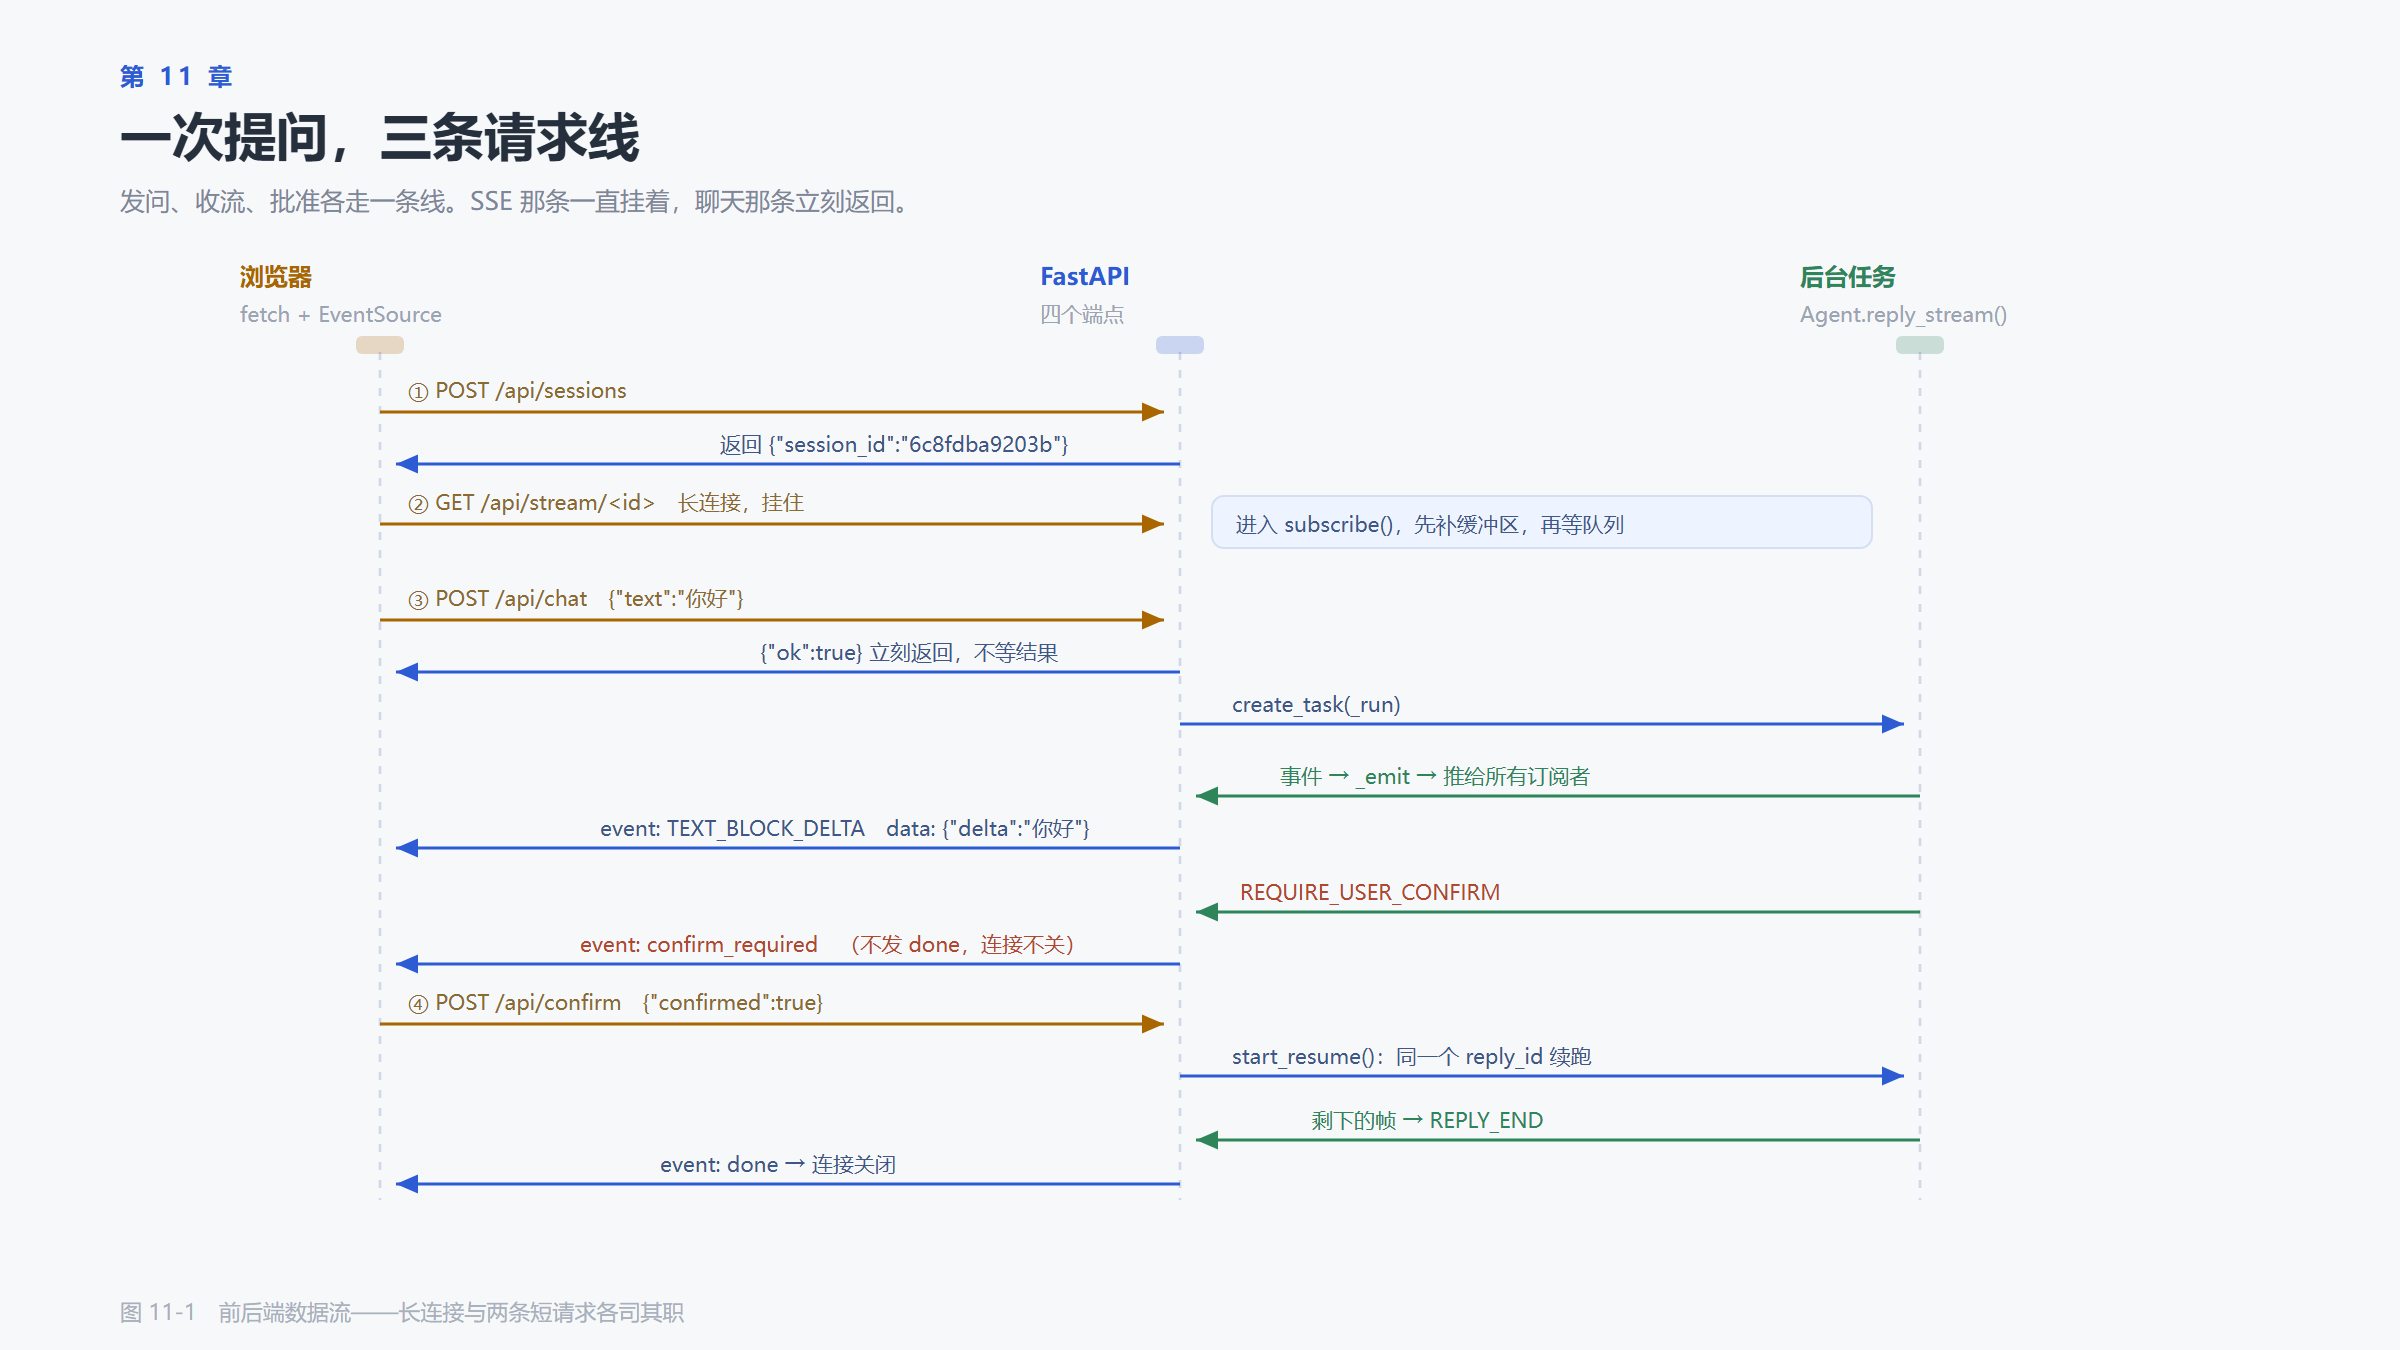
图 11-1 前后端数据流——长连接与两条短请求各司其职
第一条线:GET /api/stream/<id>,一个长连接。它建立之后一直挂着,服务端有事件就写一帧,没有就等。客户端浏览器断线会自动重连。
第二条线:POST /api/chat,立刻返回 {"ok": true}。返回的时候模型还没开始回答——它只是启动了一个后台任务。前端拿到这个响应就可以解锁输入框之外的东西,接着等第一条线推内容。
第三条线:POST /api/confirm,只在需要批准时出现。它把用户的决定送回那个暂停的会话,让后台任务接着跑。
这三条线的分工可以用一句话概括:长连接只负责"说给你听",短请求负责"让我做什么"。
11.3 一帧 SSE 长什么样
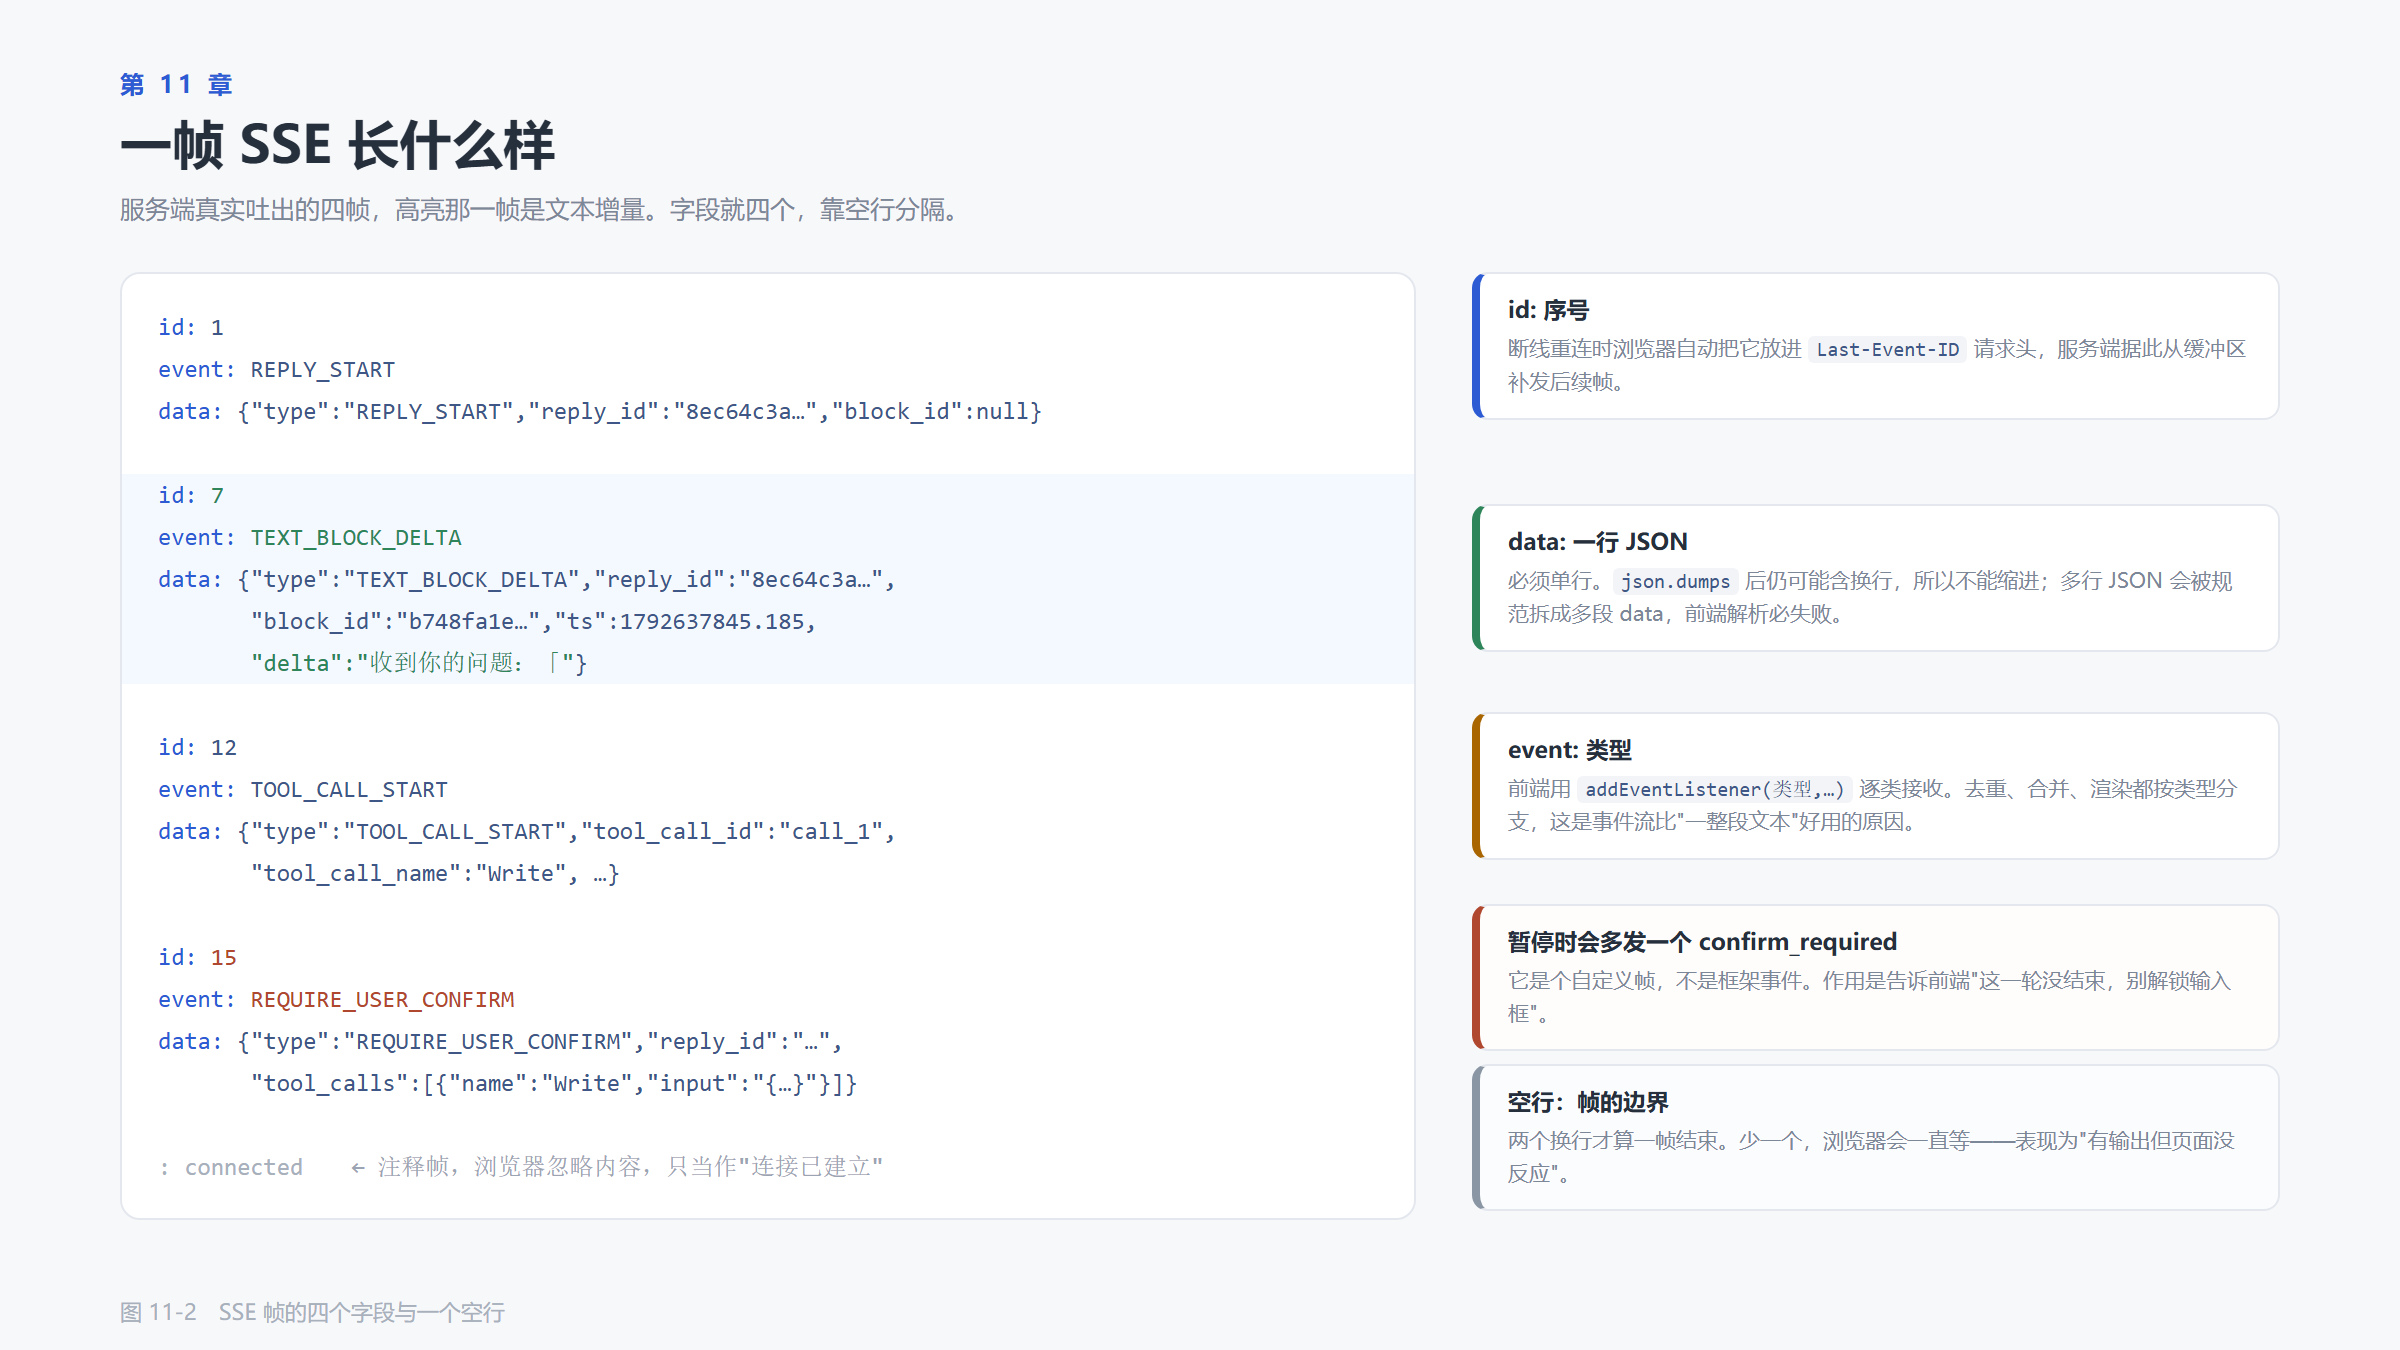
图 11-2 SSE 帧的四个字段与一个空行
编码逻辑只有四行,code/ch11/runtime.py:
def sse_frame(seq: int, event_type: str, data: dict[str, Any]) -> str:
    payload = json.dumps(data, ensure_ascii=False, default=str)
    return f"id: {seq}\nevent: {event_type}\ndata: {payload}\n\n"
四个细节,每个都能单独坑人一次:
data 必须单行。 json.dumps 默认不带换行,但如果你加了 indent=2,多行 JSON 会被 SSE 规范拆成多个 data 段,浏览器那边拼出来的字符串少了换行,JSON.parse 直接失败。永远不要对 data 做美化输出。
ensure_ascii=False 不是可选项。 默认会转成 \u4f60\u597d,中文在浏览器里能还原,但你用 curl 排查时看到的全是转义序列,等于放弃了 SSE 最大的好处。
结尾必须是两个换行。 少一个,浏览器会一直等下一段数据。症状是"服务端日志显示已经发了,页面毫无反应"——这个坑很好认,用 curl -N 一看就明白。
default=str 是保险。 事件对象里偶尔会有 datetime 之类不可序列化的值,没有它就会在一次偶发事件上抛 TypeError,把整条流打断。
11.4 事件 → 帧:白名单而不是全量转发
框架有 28 种事件(第 2 章那张表),全部转发给浏览器是错的——TOOL_CALL_DELTA 每几个字符就来一次,前端根本用不上。
做法是一张白名单:
FORWARD = {
    EventType.REPLY_START, EventType.REPLY_END,
    EventType.MODEL_CALL_START, EventType.MODEL_CALL_END,
    EventType.TEXT_BLOCK_START, EventType.TEXT_BLOCK_DELTA, EventType.TEXT_BLOCK_END,
    EventType.THINKING_BLOCK_START, EventType.THINKING_BLOCK_DELTA, EventType.THINKING_BLOCK_END,
    EventType.TOOL_CALL_START, EventType.TOOL_CALL_END,
    EventType.TOOL_RESULT_START, EventType.TOOL_RESULT_END,
    EventType.HINT_BLOCK,
    EventType.REQUIRE_USER_CONFIRM,
    EventType.EXCEED_MAX_ITERS,
}白名单之外,还要做一次扁平化。框架的事件对象字段很多,前端不需要知道 block_id 之外的结构;ToolCallBlock 和 RequireUserConfirmEvent 里的 tool_calls 还得展开成普通 dict。
def event_to_dict(event) -> dict:
    data = {
        "type": event.type.value,
        "reply_id": getattr(event, "reply_id", None),
        "block_id": getattr(event, "block_id", None),
        "ts": time.time(),
    }
    for field in ("delta", "tool_call_id", "tool_call_name", "state",
                  "input_tokens", "output_tokens", "finished_reason", "hint"):
        value = getattr(event, field, None)
        if value is not None:
            data[field] = value.value if hasattr(value, "value") else value

    block = getattr(event, "tool_call", None)
    if block is not None:
        data["tool_call"] = {"id": block.id, "name": block.name, "input": block.input}

    blocks = getattr(event, "tool_calls", None)
    if blocks:
        data["tool_calls"] = [
            {"id": b.id, "name": b.name, "input": b.input} for b in blocks
        ]
    return data
那个 hasattr(value, "value") 是为了处理枚举。finished_reason 是 FinishedReason.COMPLETED,state 是 ToolResultState.SUCCESS,json.dumps 处理不了枚举对象——不转成 .value 就会在运行时炸。
前端按 type 分支,按 reply_id / block_id 归位。 这是第 2 章那条规则的延续:一次 reply 是一个消息气泡,一个 block_id 是一段内容。帧的到达顺序不可靠(并行工具调用会交错),但 id 是可靠的。
11.4.1 一个自定义帧:confirm_required
框架的 REQUIRE_USER_CONFIRM 之后,事件流就结束了。如果你按"事件流结束 = 这轮结束"来设计,前端会立刻解锁输入框,用户以为任务完了,其实还在等你批。
所以 runtime.py 在收尾时做了一个区分:
finally:
    self.running = False
    if self.confirm_pending is not None:
        self._emit("confirm_required", {...})     # 不发 done
    else:
        self._emit("done", {...})                 # 才算真的结束
done 和 confirm_required 都是后端自定义的,不是框架事件。这条边界值得记住:框架告诉你"这一轮停了",但不告诉你"为什么停"。为什么停,是你自己的协议要表达的事。
11.5 广播、缓冲与重连
三个问题,一个结构解决。
问题一:两个标签页打开同一个会话,会不会互相抢消息?
会,如果你用一个共享队列。所以每个订阅者一个独立队列:
def _emit(self, event_type, data):
    frame = sse_frame(self.seq, event_type, data)
    self.buffer.append(frame)
    for queue in list(self.subscribers):
        queue.put_nowait(frame)
实测:开两个 curl 订阅同一会话,事件的 id 序列完全一致(diff 无输出)。
问题二:刷新页面后,前面的内容还在不在?
在。因为每一帧都进了 buffer。订阅时先补发,再跟随:
async def subscribe(self, from_seq: int = 0):
    queue = asyncio.Queue()
    self.subscribers.append(queue)
    try:
        for frame in self.buffer:                       # 先补历史
            seq = int(frame.split("\n", 1)[0].removeprefix("id: "))
            if seq > from_seq:
                yield frame
        while True:                                     # 再跟着实时
            frame = await queue.get()
            if frame is None:
                return
            yield frame
    finally:
        if queue in self.subscribers:
            self.subscribers.remove(queue)              # 断开就清理,别泄漏
from_seq 来自查询参数 ?last_event_id=N。原生 EventSource 会在重连时自动带 Last-Event-ID 请求头;这样刷新之后,前端只补它没见过的部分,不会重复渲染。
问题三:客户端断开,后台任务要不要取消?
不要。这是整套设计里最重要的一条:任务的生死和连接的生死必须解耦。
用户切到别的标签页、网络闪断、手机锁屏——这些都不该让一个跑了三分钟的任务作废。任务继续跑,事件继续进 buffer;用户回来,从查询参数 last_event_id 续上。前端体验上就是"它一直在跑,我回来就看到了结果"。
代价是 buffer 会占内存,所以要限长(本章保留最近 2000 帧)。真要长期保存,往第 9 章的存储层里落。
11.5.1 心跳
长时间没有事件,中间代理会掐断连接。解决办法是定期发一个注释帧:
agen = session.subscribe(from_seq=last_event_id)
while True:
    try:
        frame = await asyncio.wait_for(agen.__anext__(), timeout=HEARTBEAT)
    except asyncio.TimeoutError:
        yield ": ping\n\n"        # 注释帧,浏览器忽略内容
        continue
    except StopAsyncIteration:
        return
    yield frame
HEARTBEAT 默认 15 秒。实测(把间隔调成 2 秒):
: connected

: ping

: ping
注释帧以冒号开头,浏览器不会派发事件,但 TCP 上有数据流动,代理就不会判定空闲。
11.6 五个端点
@app.post("/api/sessions")            # 新建会话,返回 session_id
@app.get("/api/sessions")             # 会话列表
@app.post("/api/chat")                # 发起一轮回复,立刻返回
@app.get("/api/stream/{session_id}")  # SSE 事件流
@app.post("/api/confirm")             # 回复一次确认
/api/chat 的关键在于它不等结果:
@app.post("/api/chat")
async def chat(body: ChatRequest):
    session = _get(body.session_id)
    if session.running:
        raise HTTPException(status_code=409, detail="上一条回复还在进行中")
    await session.start_reply(body.text)      # 内部是 create_task
    return {"ok": True}
start_reply 里是 asyncio.create_task(self._run(...))。这个 create_task 就是"做事"和"看进度"分离的实现点。
/api/confirm 用第 7 章那套暂停续跑:
await session.start_resume(
    UserConfirmResultEvent(reply_id=pending.reply_id, confirm_results=results),
)
注意 start_resume 会再启一个后台任务——同一条 SSE 连接上的订阅者会继续收到后续帧,因为它们监听的是会话,不是某一次任务。
11.7 实测
启动。 没有 key 也能跑,MOCK=1 会切到假模型:
MOCK=1 python main.py[启动] 没有检测到 OPENAI_API_KEY,使用 MockModel(回复是预设的)
INFO: Uvicorn running on http://127.0.0.1:8848 (Press Ctrl+C to quit)这个假模型不是玩具,它是联调工具:前后端对接的时候,你不该被一个失效的 key 卡住。
建会话、开流、发问。
SID=$(curl -s -X POST localhost:8848/api/sessions | jq -r .session_id)
curl -N "localhost:8848/api/stream/$SID" &
curl -s -X POST localhost:8848/api/chat \
  -H "Content-Type: application/json" \
  -d "{\"session_id\":\"$SID\",\"text\":\"你好\"}"
真实输出(截取):
: connected

id: 1
event: REPLY_START
data: {"type": "REPLY_START", "reply_id": "8ec64c3a…", "block_id": null}

id: 2
event: HINT_BLOCK
data: {…"hint": "<system-reminder>…<current-time>2026-10-22T02:55:47</current-time>…"}

id: 4
event: TEXT_BLOCK_DELTA
data: {"type": "TEXT_BLOCK_DELTA", "reply_id": "8ec64c3a…",
       "block_id": "b748fa1e…", "delta": "收到你的问题:「"}

…

id: 17
event: REPLY_END
data: {…, "finished_reason": "completed"}

id: 18
event: done
data: {"session_id": "6c8fdba9203b"}
一次回复一共 10 帧 TEXT_BLOCK_DELTA,全部挂在同一个 block_id 上——前端拿这个 id 找到同一个气泡,追加文字。
重连续传。
curl -N "localhost:8848/api/stream/$SID?last_event_id=15"id: 16
event: MODEL_CALL_END
data: {… "input_tokens": 120, "output_tokens": 8 …}
id: 17
event: REPLY_END只补了 16 之后的两帧,前面的没有重发。
确认流程。 让假模型发起一次 Write:
event: REPLY_START
event: HINT_BLOCK
event: MODEL_CALL_START
event: MODEL_CALL_END
event: REQUIRE_USER_CONFIRM
event: confirm_required          ← 停在这里,等 POST /confirm
event: TOOL_RESULT_START
event: TOOL_RESULT_END
event: MODEL_CALL_START
event: TEXT_BLOCK_DELTA   × 11
event: TEXT_BLOCK_END
event: MODEL_CALL_END
event: REPLY_END
event: done
文件确实写出来了:
$ cat sandbox/note.md
这是假模型写进去的一行。
注意 REQUIRE_USER_CONFIRM 之后没有 done——这正是前面那个自定义帧的作用。
11.8 两条安全底线
把 Agent 暴露成 HTTP 服务,比在终端里跑危险得多。终端里只有你自己,HTTP 上任何人都是潜在调用者。
底线一:工作目录白名单。
WORKDIR = "./sandbox" # 所有文件操作都限制在这里不要用 WORKDIR = "."(进程当前目录),那等于把整个后端源码目录暴露给模型。第 5 章讲过,工作区边界是硬约束——在服务里这条约束更不能松。
底线二:绝不对外暴露 BYPASS 模式。
本章的默认是 PermissionMode.DEFAULT,理由很直接:BYPASS 会跳过所有安全询问,包括 rm -rf /。第 7 章那张表已经写清楚,它适用于"一次性容器或者你完全信任行为的场合"——对外的 HTTP 服务两条都不满足。
如果业务确实需要无人值守地跑(比如定时任务),用 DONT_ASK,它把本该询问的操作变成拒绝,而不是放行。
顺带一条工程建议:权限模式不要做成前端可传的参数。 一旦 mode 来自请求体,攻击者第一件事就是传 bypass。模式应该由服务端配置决定,前端最多只能选"这次允许还是拒绝"。
11.9 三个常见错误
错误 1:json.dumps(data, indent=2) 塞进 data:
多行 JSON 会被 SSE 规范拆成多个 data 段,前端 JSON.parse 报 Unexpected token。data 必须单行,缩进只能出现在日志里。
错误 2:在 /api/chat 里 await agent.reply(...) 再返回
@app.post("/api/chat")
async def chat(body: ChatRequest):
    msg = await agent.reply(UserMsg(...))     # 阻塞整个请求
    return {"text": msg.get_text_content()}
三重问题:长任务被代理超时掐断、用户全程看不到进度、并发一个会话时第二个请求会排在后面。正确做法是 create_task 后立刻返回。
错误 3:用共享队列做多订阅者
self.queue = asyncio.Queue() # 所有订阅者抢同一个队列两个标签页各拿到一半的事件,谁都拼不出完整回复。每个订阅者一个队列,_emit 时广播。
11.10 小结
- SSE 单向足够,断线重连免费,
curl -N就能调试 - 做事和看进度分离:
POST发问,SSE 收流,create_task是那个分离点 - 帧格式四个字段一个空行;
data必须单行、中文不转义、default=str兜底 - 事件转发用白名单,枚举字段要转
.value - 每个订阅者一个队列,帧进缓冲区支持
last_event_id查询参数续传 - 任务生死与连接生死解耦:断开不取消,回来能续上
- 心跳靠注释帧,15 秒一次
- 权限模式由服务端决定,绝不接受前端传
BYPASS
后端能跑了,但只有一个丑陋的验证页。第 12 章把它变成真正能用的界面:三栏布局、按 block 渲染、工具调用时间线、失败状态。
下一章要解决的问题:前端怎么可靠地"拼"一条消息?并行工具调用交错到达时怎么不乱?用户滚上去看历史的时候,新内容还在往下流,怎么不打断他?