
I2:向量数据库与 RAG
Easy Data x AI 课程 · 产业应用篇 · 第 2 节
本节定位
本节聚焦向量数据库与 RAG 的原理、工程选择和评测方法。D2 已带你完成切分、向量化和混合搜索,D3 已展示 Agentic RAG 的完整代码;本节回答这些实践背后的“为什么”。
学习目标
完成本节后,你将能够:
- 解释 Embedding 如何把非结构化内容转换为可比较的向量;
- 根据数据与模型特征选择余弦相似度、点积或欧氏距离;
- 说明 KNN、ANN、HNSW、IVF 和量化索引的核心权衡;
- 设计包含正文、向量、来源、权限和业务字段的 RAG 数据模型;
- 区分向量召回、关键词召回、标量过滤、融合与重排的职责;
- 使用 Recall@K、MRR、nDCG、延迟和成本评估检索系统;
- 判断场景更适合专用向量数据库,还是在现有数据库中扩展向量能力。
1. 从“不可比较”到“可计算”
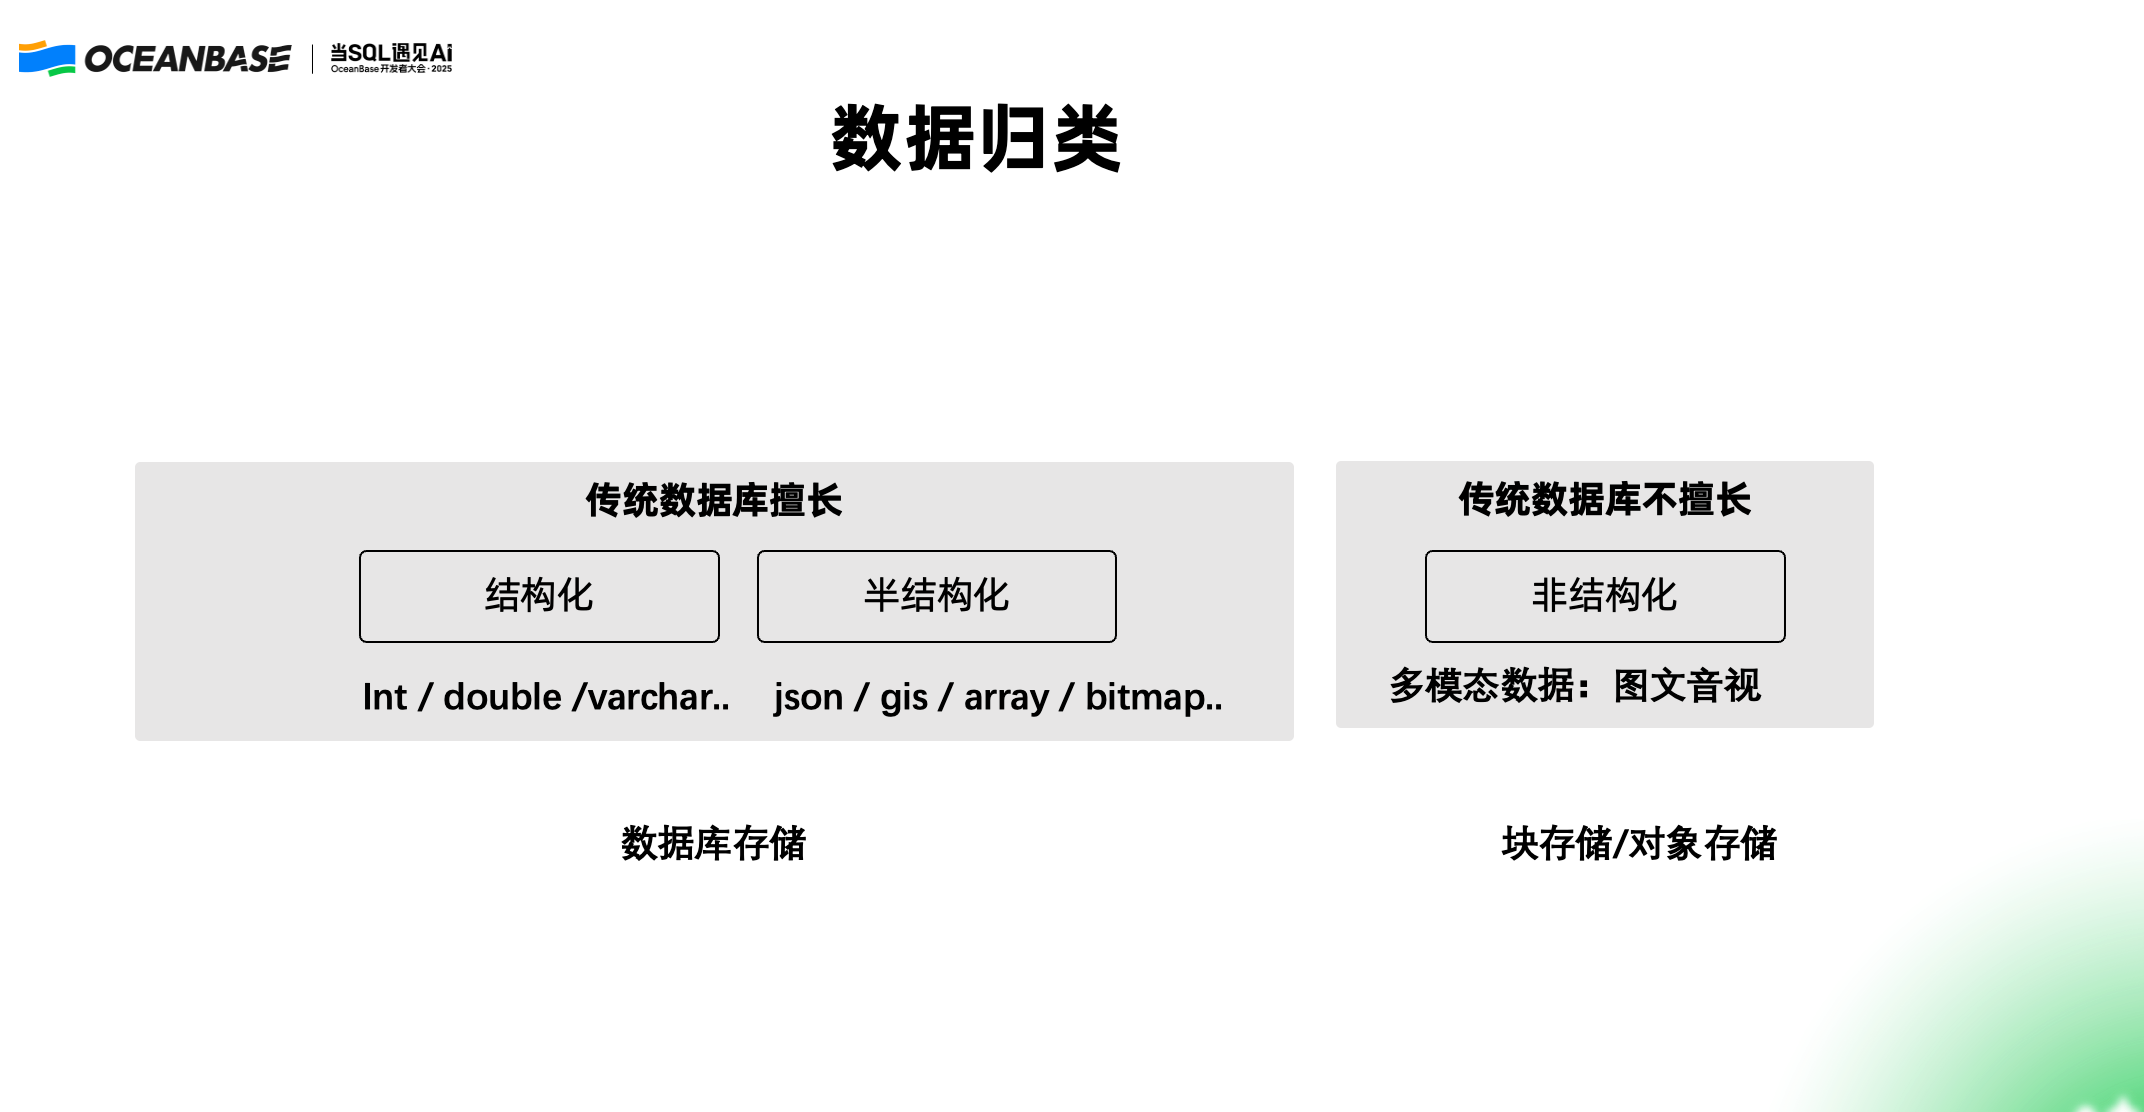
传统数据库擅长处理有明确类型和结构的数据。数字可以比较大小,日期可以计算区间,字符串可以精确匹配,关系表可以连接与聚合。
但图片、音频、视频和自然语言文档本身没有天然的“相似度运算”:
- 两张图片的二进制差异很大,不代表画面内容不相似;
- “如何重置数据库密码”和“忘记口令后怎样恢复访问”几乎没有共同词,却可能表达同一个意图;
- 一段音频即使经过压缩或改变采样率,人仍然可能认为它们内容相同。
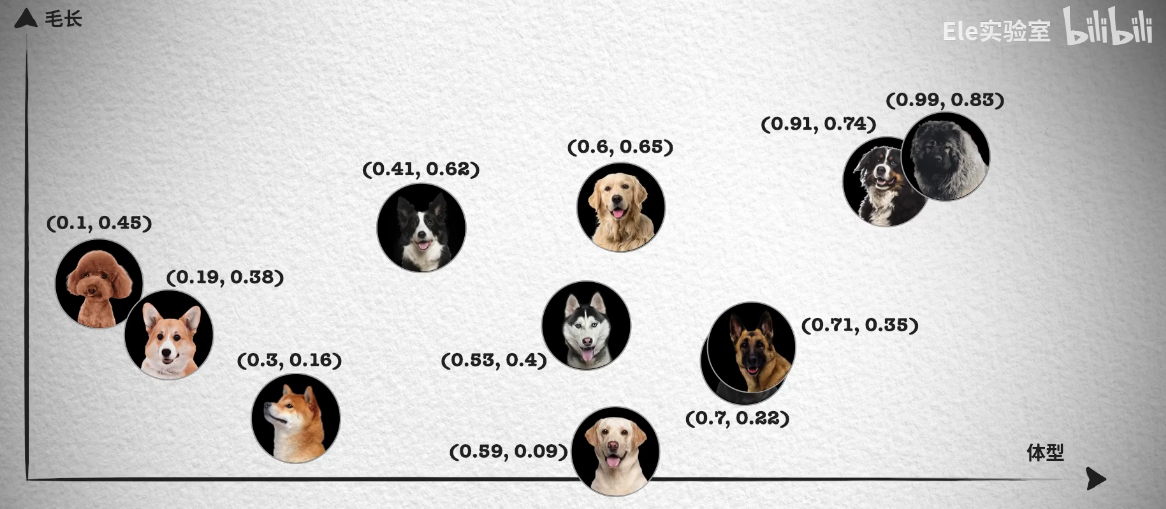
Embedding 模型改变了这一点。它把文本、图片、音频等对象转换为固定维度的数值向量,使“内容是否相似”近似转化为“向量在高维空间中是否接近”。
原始内容 → Embedding 模型 → 高维向量 → 距离/相似度计算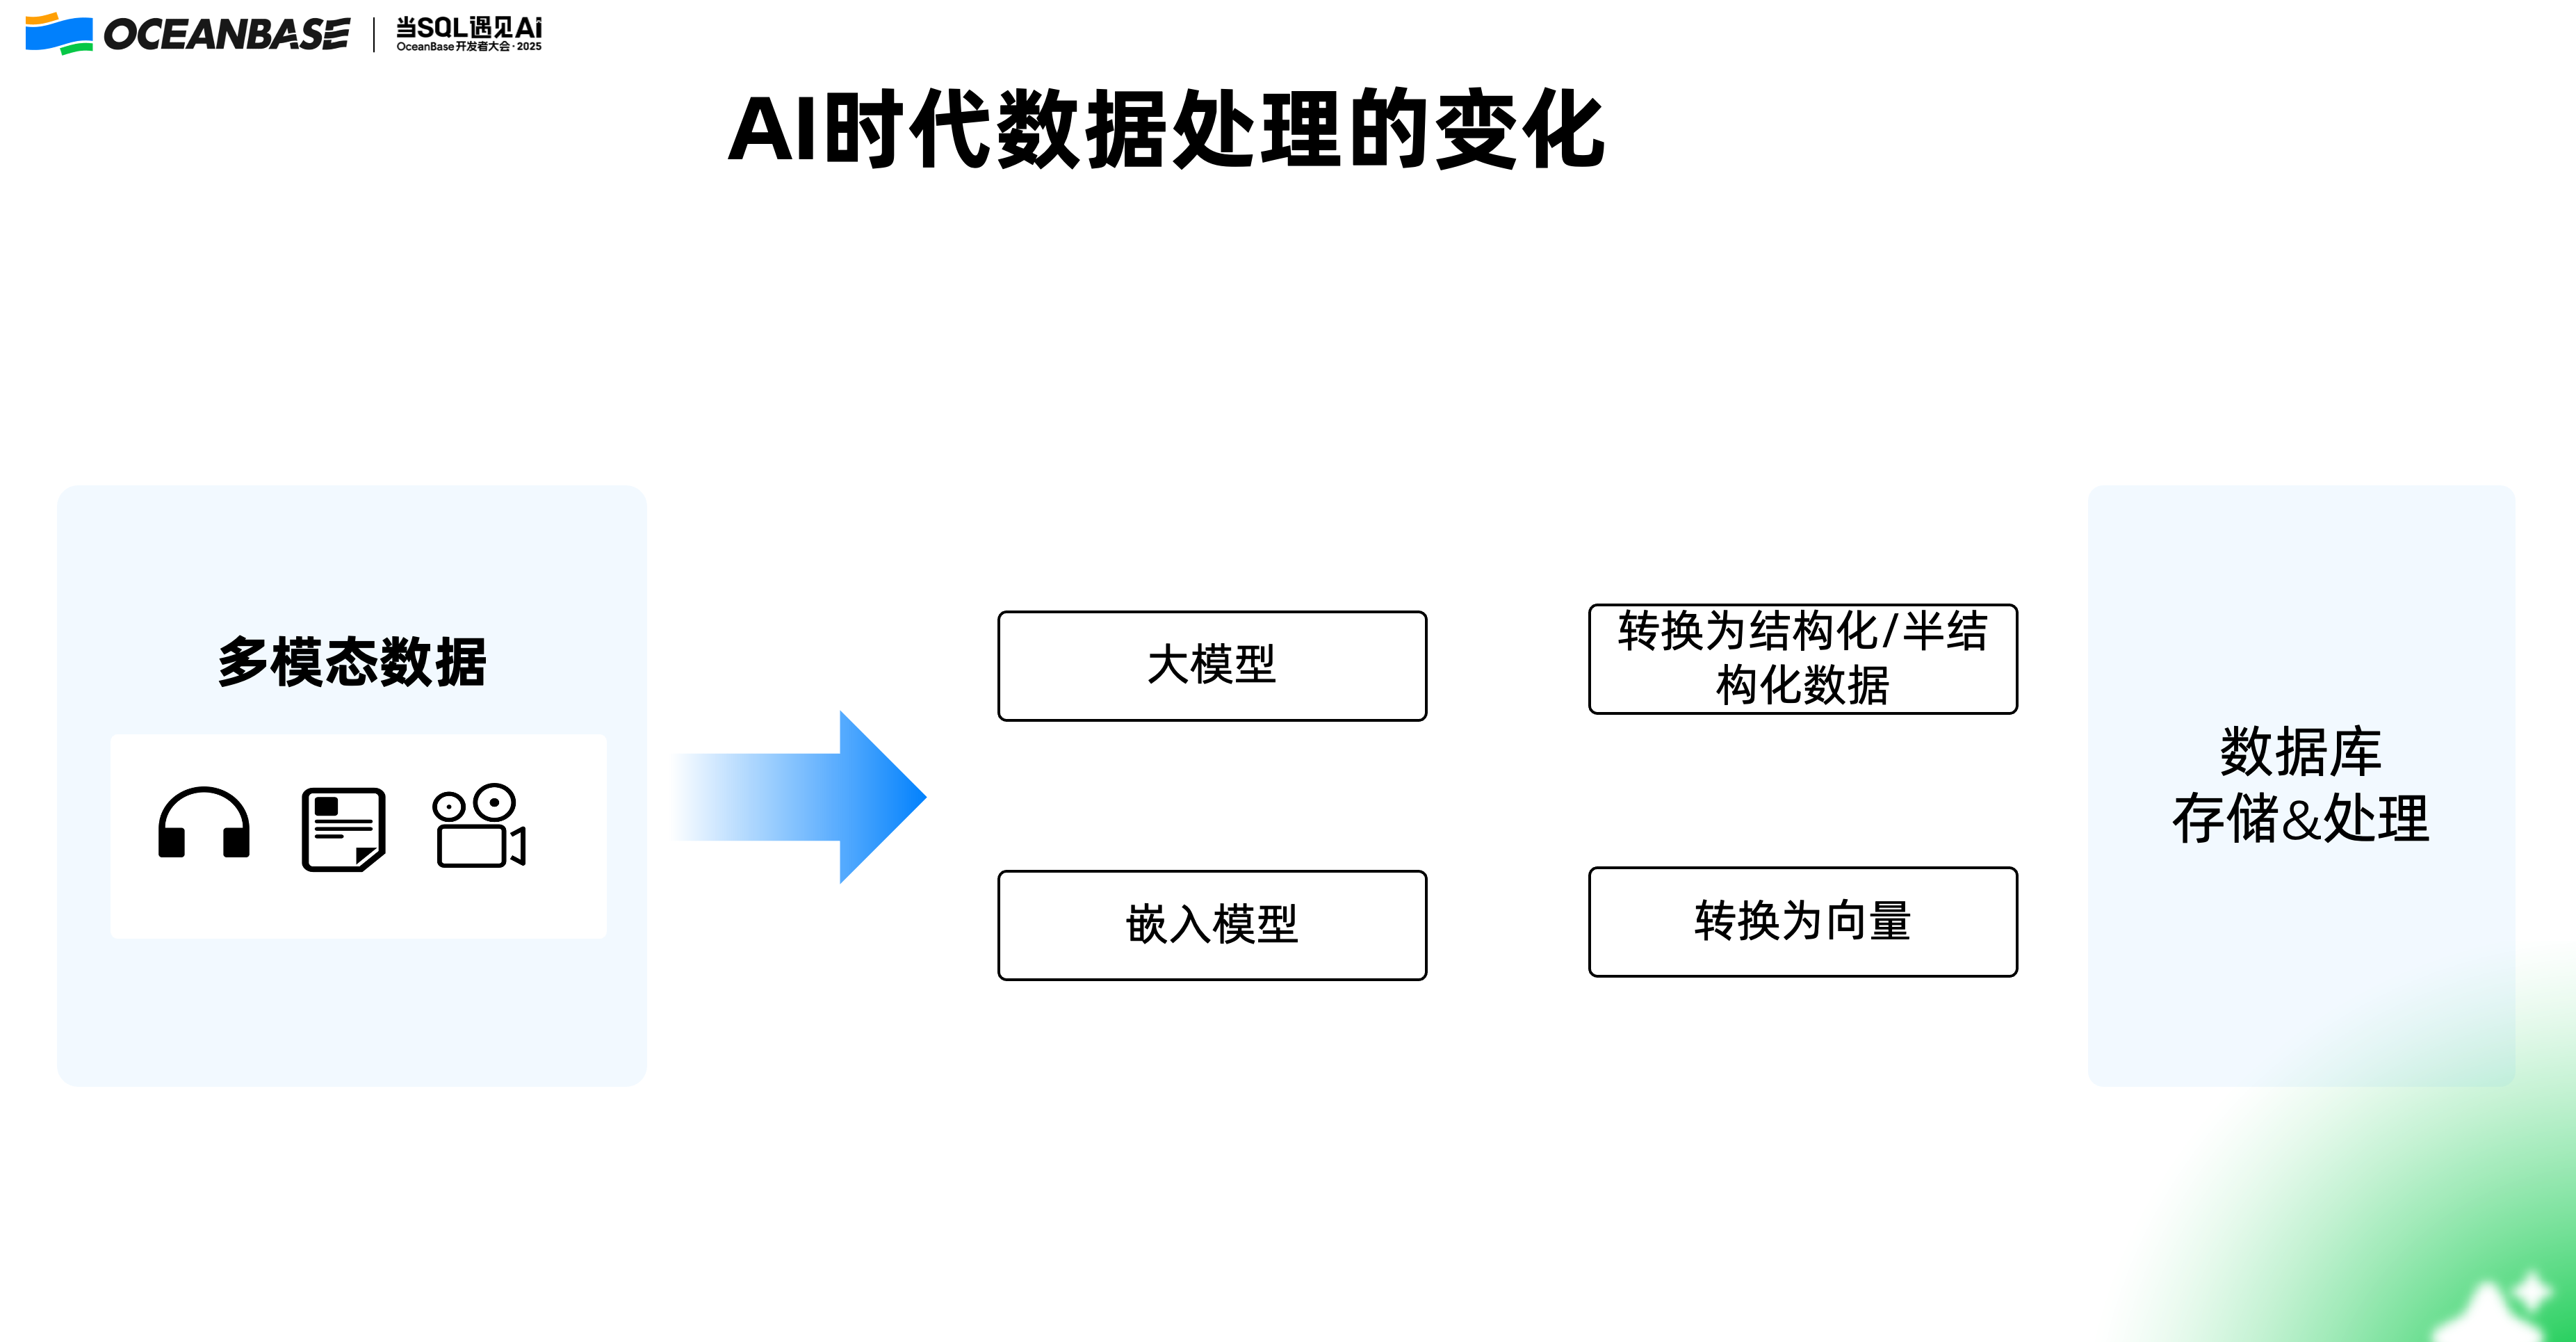
这并不意味着向量理解了内容的全部含义。更准确地说,向量是模型依据训练目标提取的一组潜在特征表示。
2. Embedding:语义的数值表示
一个 4 维向量可以写作:
生产中的文本向量通常有数百到数千个维度。每个维度一般没有稳定、可供人类直接解释的名称,但整个向量共同编码了模型认为重要的特征。
2.1 同一空间是比较的前提
只有由兼容模型、相同版本和相同编码方式生成的向量,距离才通常具有可比性。以下做法会破坏检索:
- 文档使用模型 A,查询使用模型 B;
- 模型升级后只重算新数据,没有重算历史数据;
- 模型要求区分 query 与 document 输入,却对两者使用同一种提示格式;
- 文本预处理、截断或归一化规则在写入与查询阶段不一致;
- 向量维度与索引定义不匹配。
因此,向量旁边至少应记录:
| 字段 | 作用 |
|---|---|
| embedding_model | 标识模型或逻辑模型名 |
| embedding_version | 支持升级、回滚和重建 |
| embedding_dim | 防止维度不一致 |
| content_hash | 判断原文是否变化、是否需要重算 |
| embedded_at | 追踪生成时间和数据新鲜度 |
2.2 向量不是事实本身
向量适合做候选召回,却不适合作为唯一证据:
- 它不可直接还原为完整原文;
- 距离分数不是事实正确性的概率;
- 相似内容可能已经过期或无权访问;
- 模型可能没有学习到业务中的关键区分。
因此,RAG 应同时保存原文、来源、版本、权限和结构化元数据。向量负责“找到候选”,原文负责“提供证据”。
3. 距离与相似度:到底在比较什么?
选择距离函数不能只看数据库支持什么,还要与 Embedding 模型的训练方式匹配。常见的三种度量是欧氏距离、余弦相似度和点积。
3.1 欧氏距离(L2)
L2 衡量两个点的绝对空间距离,值越小越相似。它既受方向影响,也受向量长度影响,适合关注绝对数值差异,或模型明确以 L2 距离训练和评测的场景。
3.2 余弦相似度
余弦相似度关注方向,弱化向量长度。结果通常位于
3.3 点积(Inner Product)
点积同时受方向和模长影响,值越大通常表示越相似。若向量已经做 L2 归一化,则点积与余弦相似度等价:
3.4 如何选择?
| 情况 | 优先选择 |
|---|---|
| 模型文档明确指定距离函数 | 严格跟随模型说明 |
| 向量已归一化,关注方向 | 余弦相似度或点积 |
| 向量模长本身含有信息 | 点积或 L2,结合模型定义 |
| 比较二值特征 | 汉明距离或 Jaccard 距离 |
| 不确定 | 用标注查询集对不同度量做离线评测 |
分数阈值不能跨模型照搬
“相似度大于 0.8 就算相关”不是通用规律。分数分布会随模型、语料、语言、距离函数和是否归一化而变化,阈值必须用当前业务数据校准。
4. 最近邻搜索:从精确到近似
给定查询向量,在数据集中寻找最相似的 K 个向量,称为 K 近邻搜索(KNN)。
4.1 精确 KNN
最直接的方法是计算查询与每条向量的距离,再取 Top-K:
for vector in dataset:
    score = distance(query, vector)
sort scores
return top_k
它结果精确、逻辑简单,但时间开销随数据量和维度增长。对小数据集、严格精确查询或索引尚未建立的场景,暴力扫描仍然是重要基线。
4.2 近似最近邻(ANN)
ANN 索引不再检查所有向量,而是利用图、聚类或量化结构缩小搜索空间,用少量召回损失换取明显的延迟和吞吐收益。
这带来向量检索最核心的三角权衡:
| 目标 | 含义 |
|---|---|
| 召回率 | 近似结果覆盖精确 Top-K 的比例 |
| 延迟/吞吐 | 单次查询耗时与单位时间查询量 |
| 资源成本 | 内存、磁盘、索引构建与维护成本 |
不存在在所有数据规模和负载下都最优的索引。选择索引,本质是在业务约束下选择可接受的近似程度。
5. 常见向量索引
5.1 HNSW:在多层小世界图上导航
HNSW(Hierarchical Navigable Small World)把向量组织成多层邻接图:
- 上层节点少,用于快速跳到大致区域;
- 搜索逐层下降,不断靠近查询向量;
- 底层更稠密,用于寻找最终候选。
常见参数及影响:
| 参数 | 增大后的典型影响 |
|---|---|
| M | 图连接更多,召回可能提高,但内存和构建成本增加 |
| ef_construction | 建图搜索更充分,索引质量提高,但构建更慢 |
| ef_search | 查询候选更多,召回提高,但查询更慢 |
HNSW 通常适合低延迟、高召回的内存型检索,但图结构会带来明显内存开销,持续写入和删除也需要评估维护成本。
5.2 IVF:先找分区,再搜分区
IVF(Inverted File Index)先把向量聚成若干中心:
- 建索引时将向量分配到最近的聚类中心;
- 查询时先找到最接近的若干中心;
- 只在对应分区中搜索候选。
nlist 表示聚类中心或分区数量,nprobe 表示查询时探测的分区数量。nprobe 越大,扫描范围越广,召回通常越高,延迟也越大。
IVF 适合较大规模、批量构建和内存受限场景,但数据分布变化后可能需要重新训练或重建索引。
5.3 量化:用精度换空间
量化通过更紧凑的表示减少存储和计算开销:
- 标量量化(SQ):降低每个向量元素的精度;
- 乘积量化(PQ):把向量切成子空间,用码本近似表示;
- 二值量化(BQ):将向量压缩为二值表示。
量化适合大规模和内存敏感场景,但会引入额外近似误差。常见做法是用量化索引召回候选,再用原始向量精确重算候选分数。
5.4 索引选择速查
| 场景 | 可优先评估 |
|---|---|
| 小数据集、要求精确 | 暴力扫描 / 精确 KNN |
| 中等规模、低延迟、高召回 | HNSW |
| 大规模、可批量训练、内存受限 | IVF |
| 超大规模、存储成本敏感 | IVF + PQ 或其他量化方案 |
| 持续高频写入 | 重点评估增量维护、写入放大和索引可见性 |
索引名称相同也不代表实现、参数和性能相同。最终仍需在目标硬件与真实数据分布上测试。
6. 向量数据库到底存什么?
一个可用于生产 RAG 的数据对象不应只有 ID 和向量。更合理的数据模型包含四类信息:
| 类型 | 示例 | 用途 |
|---|---|---|
| 原始证据 | content、title、source_url | 生成答案和展示引用 |
| 向量 | embedding | 语义召回 |
| 业务元数据 | tenant_id、department、status | 权限与业务过滤 |
| 数据治理信息 | doc_version、chunk_no、content_hash | 更新、追踪、去重和重建 |
示意表结构如下,具体类型和索引语法以实际数据库为准:
CREATE TABLE knowledge_chunks (
  chunk_id          BIGINT PRIMARY KEY,
  document_id       BIGINT NOT NULL,
  tenant_id         BIGINT NOT NULL,
  title             VARCHAR(512),
  content           TEXT NOT NULL,
  source_url        VARCHAR(2048),
  status            VARCHAR(32),
  document_version  VARCHAR(64),
  chunk_no          INT,
  content_hash      VARCHAR(128),
  embedding_model   VARCHAR(128),
  embedding_version VARCHAR(64),
  embedding         VECTOR(1024),
  updated_at        TIMESTAMP
);
查询也往往不是“全库找相似”,而是在业务条件内找相似:
SELECT chunk_id, document_id, title, content,
       cosine_distance(embedding, :query_vector) AS distance
FROM knowledge_chunks
WHERE tenant_id = :tenant_id
  AND status = 'published'
ORDER BY distance APPROXIMATE
LIMIT 20;
向量回答“哪些内容与问题接近”,标量字段回答“哪些内容属于当前业务范围且允许访问”。
7. RAG:检索增强生成
RAG(Retrieval-Augmented Generation)在生成答案前,从外部知识库检索证据并放入模型上下文。它主要缓解三类问题:
- 模型训练数据不包含企业私域知识;
- 模型知识存在时间截止点,无法自动获取最新事实;
- 仅依靠模型参数生成,答案难以追踪来源。
RAG 不是简单的“向量数据库 + 大模型”,而是两条相互关联的数据流水线。
7.1 离线入库流水线
数据源
  → 解析与清洗
  → 文档切分
  → 元数据与权限补全
  → Embedding
  → 写入正文、向量和索引
  → 质量检查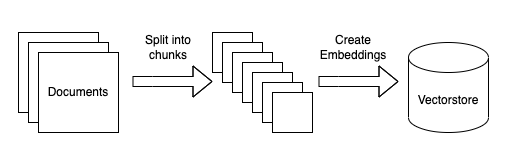
离线流水线需要保证幂等性。相同文档重复处理时,不应产生无法追踪的重复块;文档删除、更新、权限变化和模型升级都应有对应的数据维护策略。
7.2 在线查询流水线
用户问题
  → 查询理解或改写
  → 查询向量化
  → 多路候选召回
  → 权限与业务过滤
  → 融合与重排
  → 上下文组装
  → LLM 生成
  → 引用与答案验证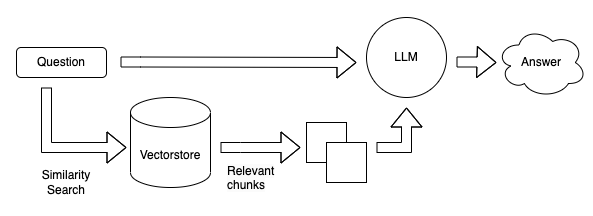
如果最终答案错误,需要沿这条链路定位问题,而不是笼统地归因于“大模型效果不好”。
8. Chunking:切分决定可检索的最小单元
长文档不能直接无限量放入模型上下文,也不适合只生成一个覆盖全文的向量。RAG 通常先将文档切成 Chunk。
8.1 Chunk 太大或太小会怎样?
| 情况 | 主要问题 |
|---|---|
| 太小 | 语义不完整、上下文断裂、召回结果碎片化 |
| 太大 | 向量主题混杂、相关信息被稀释、占用更多上下文 |
| 重叠过少 | 关键语义可能被切在边界两侧 |
| 重叠过多 | 索引膨胀、重复召回、上下文浪费 |
常见策略包括:
- 按固定 Token 数切分并设置 overlap;
- 按标题、段落、列表、代码块等文档结构切分;
- 根据句子间语义变化寻找边界;
- 使用父子 Chunk:小块负责召回,大块负责返回上下文。
8.2 保留文档结构
Chunk 入库时应保留:
- 文档与父 Chunk 的标识;
- 标题路径和章节层级;
- 页码、段落号或代码行位置;
- 原始来源与版本;
- 权限和生效时间;
- 前后邻接关系。
这样检索命中一个小块后,系统可以扩展相邻内容、恢复父级上下文,并生成可定位的引用。
与 D2 的边界
D2 提供固定切分、语义切分、动态 overlap 和父子 Chunk 的代码示例。本节强调这些策略如何影响召回、上下文质量与数据维护。
9. 纯向量检索为什么不够?
向量检索擅长语义近似,但真实业务还包含它不稳定处理的信号:
- 错误码、订单号、型号和专有名词;
- 必须严格满足的租户、权限、时间和状态条件;
- 用户明确输入的关键词;
- 最新版本优先、官方来源优先等业务规则。
因此,生产 RAG 通常会组合三类检索:
- 向量检索:寻找语义相近内容;
- 全文检索:捕捉关键词、短语和稀有词项;
- 标量过滤:执行权限、租户、状态、时间等硬约束。
9.1 标量过滤与向量检索的执行顺序
过滤条件的选择率会影响最佳执行方式:
| 策略 | 过程 | 适用情况 | 风险 |
|---|---|---|---|
| 过滤后精确计算 | 先过滤,再对剩余向量全量算分 | 过滤后数据很少 | 条件不够严格时延迟高 |
| 向量优先再过滤 | 先召回较多候选,再做标量过滤 | 过滤选择率高 | 过滤后可能不足 K 条 |
| 过滤下推 ANN | 将允许集合下推到向量索引 | 多种选择率与复杂权限 | 实现和优化器更复杂 |
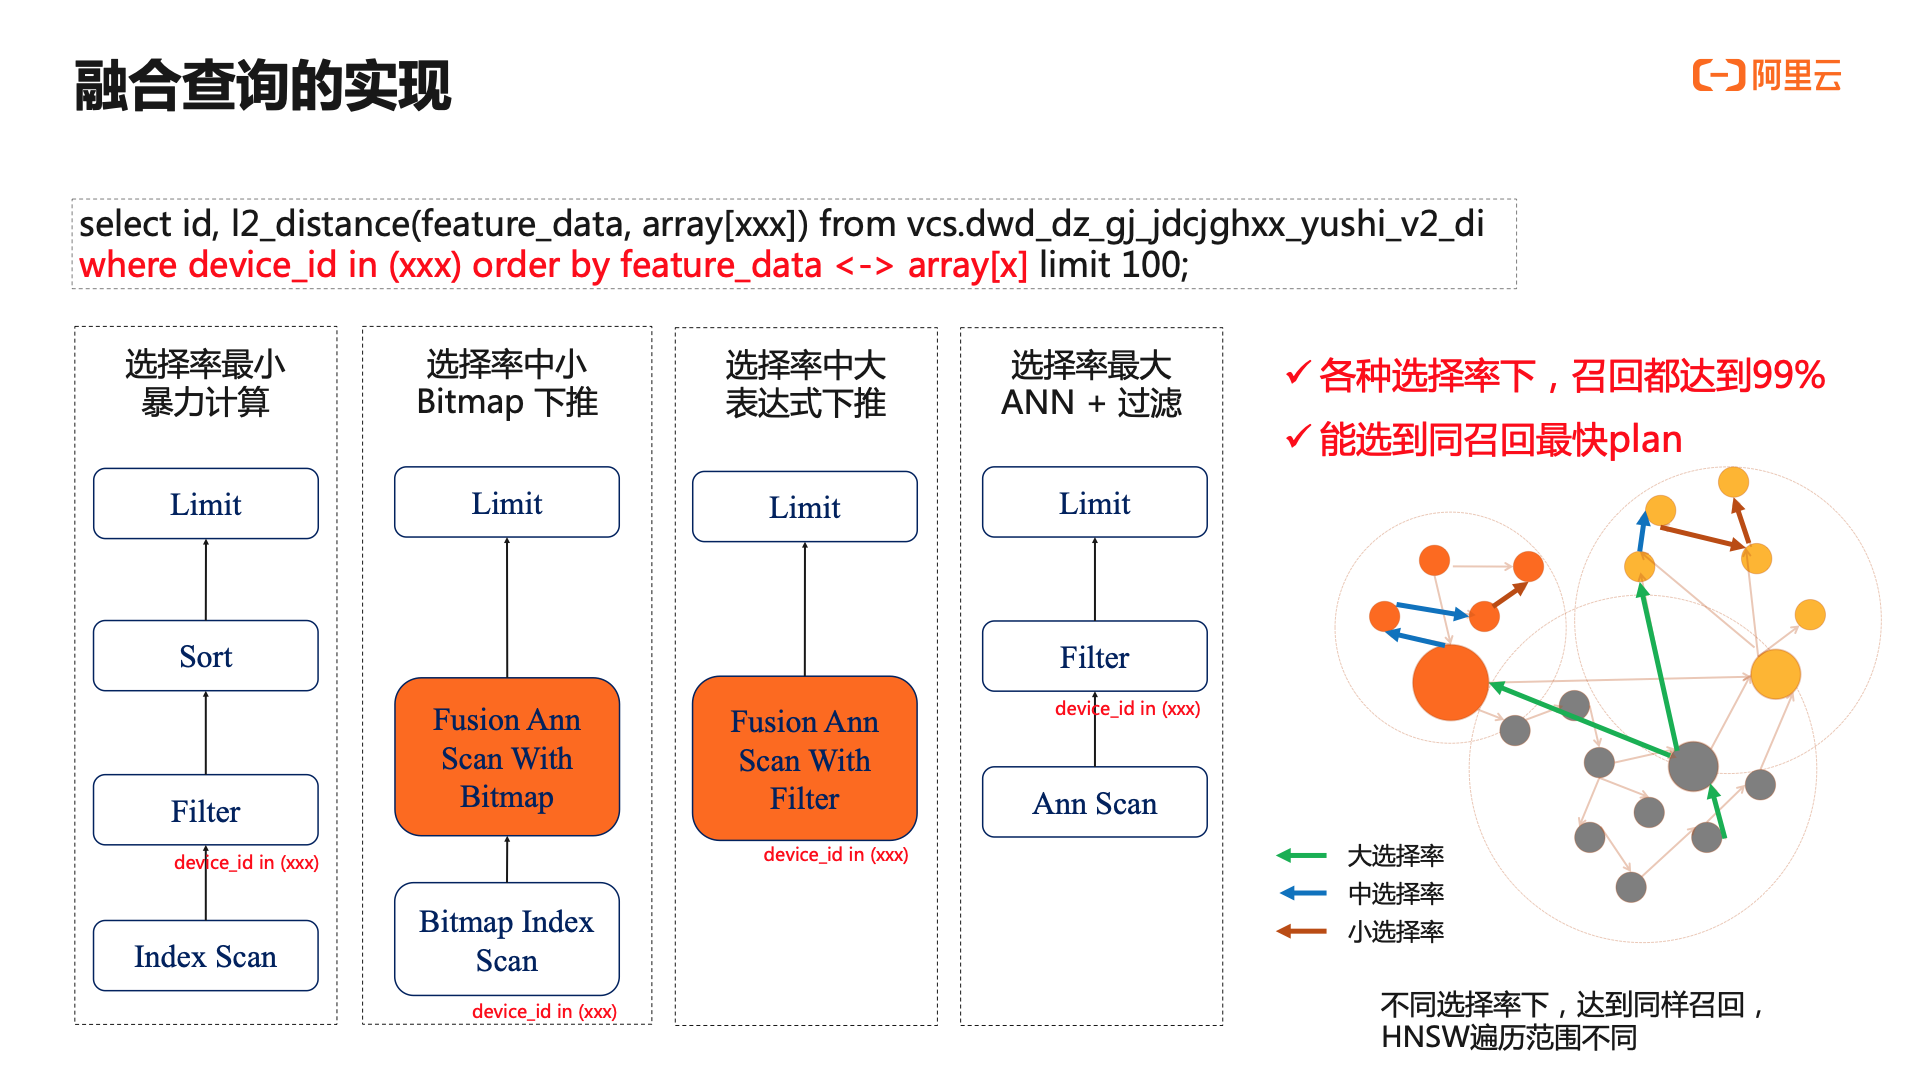
“先向量 Top-10,再过滤权限”尤其危险:不仅可能不足 10 条,还可能让无权限数据进入中间处理或日志。安全边界应尽可能在检索阶段生效。
9.2 全文与向量结果如何融合?
不同召回器分数的量纲不同,不能轻易直接相加。RRF(Reciprocal Rank Fusion)使用名次进行融合:
其中
若使用加权分数融合,应先校准或归一化各路分数,并通过验证集确定权重。
10. 重排与上下文组装
召回阶段追求“不要漏掉”,重排阶段追求“把真正相关的放到前面”。
10.1 为什么采用两阶段检索?
双编码 Embedding 模型可以分别计算查询和文档向量,文档向量可提前离线生成,因此适合从海量数据中快速召回。
Cross-Encoder 或重排模型通常让查询和候选共同参与计算,判断更细致,却无法为任意查询提前算好结果,成本更高。因此常见做法是:
海量数据
  → 低成本召回 50~200 条
  → 重排模型精排
  → 选取 5~20 条进入上下文
候选数量不是越多越好。它会同时影响召回率、重排成本、延迟和最终上下文噪声。
10.2 上下文组装不只是拼接
进入 LLM 前还应处理:
- 相同文档或相邻 Chunk 去重;
- 命中子块后扩展父块或邻接块;
- 按文档、章节或时间恢复合理顺序;
- 控制每个来源占用的 Token;
- 保留来源、版本与定位信息;
- 避免把检索到的文档指令当作系统指令执行。
最后一点属于 Prompt Injection 防护:知识库中的文本是不可信数据,不应拥有改变系统规则或调用工具的权限。
11. 如何评测向量检索与 RAG?
“随机问几个问题看起来不错”不能支撑生产发布。评测至少分为检索层、生成层和系统层。
11.1 构建评测集
每条评测数据可包含:
{
  "query": "如何恢复忘记的数据库密码?",
  "relevant_chunk_ids": ["doc-17#chunk-3", "doc-17#chunk-4"],
  "expected_answer": "……",
  "required_sources": ["doc-17"],
  "tenant_id": "tenant-a",
  "tags": ["权限", "改写问题", "版本敏感"]
}
评测集应覆盖高频问题、长尾问题、专有名词、错误码、跨段信息、无答案问题、权限隔离、时间敏感内容和对抗输入。
11.2 检索指标
Recall@K:所有相关文档中,有多少出现在前 K 条结果:
Precision@K:前 K 条结果中,有多少是真正相关:
MRR:关注第一个相关结果出现的位置:
若相关性有“高度相关、部分相关、不相关”等等级,可以使用 nDCG@K 衡量排序质量。
11.3 生成指标
RAG 的最终答案还应评估:
- 忠实度:结论是否由检索证据支持;
- 答案相关性:是否直接回答用户问题;
- 引用准确性:引用是否真的支持对应陈述;
- 完整性:关键要点是否遗漏;
- 拒答能力:没有证据时能否明确说明不知道。
11.4 系统指标
生产系统还需观察:
- P50、P95、P99 延迟;
- 查询吞吐和并发稳定性;
- Embedding 与重排调用成本;
- 索引构建时间和资源占用;
- 写入后索引可见延迟;
- 超时率、降级率与缓存命中率;
- 不同租户和权限条件下的正确隔离。
性能数字必须带完整上下文
比较产品时至少记录数据集、向量维度、距离函数、索引参数、Recall 目标、并发、读写比例、硬件和数据是否在内存中。脱离这些条件的单个 QPS 或延迟数字没有可比性。
12. 专用向量数据库,还是数据库向量扩展?
业界大致有两条路线:
- 专用向量数据库:围绕向量存储、ANN 索引和分布式检索设计;
- 在现有数据库中扩展向量能力:把向量检索与原有事务、SQL、全文和标量查询结合。
12.1 选型维度
| 维度 | 需要回答的问题 |
|---|---|
| 数据规模 | 向量数量、维度和增长速度是多少? |
| 查询负载 | QPS、并发、Top-K、延迟和 Recall 目标是什么? |
| 写入负载 | 批量导入还是持续更新?删除和更新是否频繁? |
| 混合查询 | 是否强依赖 SQL、全文、Join 和复杂过滤? |
| 一致性 | 写入后是否必须立即通过向量索引查询到? |
| 多租户安全 | 权限能否在检索阶段可靠下推? |
| 部署 | 云服务、专有云、本地、边缘还是嵌入式? |
| 团队成本 | 能否承担新增系统的同步、备份和运维? |
12.2 什么时候优先评估专用系统?
- 向量检索本身是核心负载,规模与吞吐非常高;
- 需要某种专用索引、异构计算或成熟的向量生态;
- 数据同步和权限治理已有可靠平台承接;
- 团队能够独立运维额外的分布式系统。
12.3 什么时候优先评估统一数据库?
- 业务数据与向量、全文和权限过滤紧密耦合;
- 希望使用 SQL、事务、Join 和既有驱动生态;
- 数据规模中等,更关注开发与运维复杂度;
- 需要减少跨系统复制和一致性窗口;
- 应用希望在嵌入式与服务器形态间迁移。
选择系统之前,先明确工作负载和验收指标;不要先选产品,再为产品寻找场景。
13. 贯穿案例:构建可评测的产品文档助手
假设我们为一个数据库产品构建文档助手,要求:
- 回答安装、配置、错误码和版本兼容问题;
- 只返回当前租户有权访问的内容;
- 优先使用最新发布版本;
- 答案必须带原文引用;
- 新文档发布后能够在约定时间内被检索到。
13.1 入库设计
- 解析 Markdown、PDF 和网页,保留标题层级与来源位置;
- 按章节结构切分,代码块和步骤列表尽量保持完整;
- 为 Chunk 补充产品、版本、语言、状态和权限字段;
- 使用指定版本的 Embedding 模型生成向量;
- 幂等写入原文、向量、元数据与全文索引;
- 执行空内容、重复内容、维度和权限字段检查。
13.2 查询设计
面对“4.3 版本报错 OB-1234 怎么办?”:
- 保留 OB-1234 作为全文检索的精确词项;
- 将完整问题编码为查询向量;
- 下推租户权限、产品和版本过滤;
- 并行获得全文与向量候选;
- 使用 RRF 融合,再由重排模型精排;
- 扩展相邻步骤或父级章节;
- 将有限证据交给 LLM,并要求逐条引用来源;
- 若没有足够证据,返回明确拒答而不是猜测。
13.3 评测设计
为该场景建立至少四组对比:
| 实验 | 目的 |
|---|---|
| 纯向量 vs 纯全文 vs 混合检索 | 验证不同信号的互补性 |
| 不同 Chunk 大小与 overlap | 观察召回和上下文完整性 |
| 不同 HNSW ef_search | 观察 Recall 与延迟曲线 |
| 无重排 vs 有重排 | 衡量质量收益是否覆盖成本 |
发布门槛不能只写“效果更好”,应写成可验证条件,例如:
- Recall@10 不低于既有版本;
- 权限测试零越权;
- P95 检索延迟在预算内;
- 引用准确率达到目标;
- 新文档在约定索引可见时间内可检索。
14. 常见误区
误区一:向量数据库保存的是原始图片和文档
向量数据库的核心对象是向量及其元数据。原始大文件常保存在对象存储或文件系统中,数据库保存可检索表示、定位信息和必要正文。
误区二:相似度最高的内容就是正确答案
相似只表示模型空间中的接近程度,不代表内容权威、最新、有权限或能支持答案。
误区三:ANN 越快越好
只看延迟可能以牺牲召回为代价。必须在相同 Recall 目标下比较性能。
误区四:Top-K 越大,RAG 效果越好
过多候选会增加重排成本和上下文噪声,还可能让真正证据被淹没。Top-K 应通过评测确定。
误区五:更换 Embedding 模型只改一行配置
模型变化可能导致维度、向量空间和分数分布变化,通常需要版本化、全量重算、索引重建与回归评测。
误区六:RAG 可以彻底消除幻觉
RAG 提供外部证据,但检索可能漏召回,模型也可能误读或忽略证据。仍需引用、验证、拒答和持续评测。
15. 本节小结
本节可以浓缩为六句话:
- Embedding 把非结构化内容变成可进行相似度计算的向量;
- 距离函数必须与模型训练方式和向量归一化策略一致;
- ANN 用一定召回损失换取可扩展的检索性能;
- 生产 RAG 需要向量、全文、标量过滤、融合和重排共同工作;
- 检索质量、生成质量、延迟、成本和安全必须分别评测;
- 向量数据库选型应由真实工作负载决定,而不是由产品标签决定。
课后行动
选择一个不少于 30 篇文档的小型知识库,完成以下实验:
- 建立 20 条带相关文档标注的查询集;
- 分别运行纯向量、纯全文和混合检索;
- 统计 Recall@5、Recall@10 和 MRR;
- 调整一次 Chunk 大小和一次 ANN 查询参数;
- 记录质量、P95 延迟与候选数量的变化;
- 增加租户或版本过滤,验证结果中没有越权和过期内容;
- 输出一页实验结论,说明你会选择的检索链路及理由。
思考题
- 为什么同一批向量换一种距离函数后,排序可能完全不同?
- 精确 KNN 为什么仍然是 ANN 评测的重要基线?
- “先向量检索再做权限过滤”会产生哪些正确性和安全问题?
- 为什么 Embedding 模型升级通常需要重建历史向量?
- 检索 Recall 提升后,最终答案质量为什么可能没有同步提升?
- 你的场景中,专用向量数据库的收益是否足以覆盖新增系统成本?
与其他课程的关系
- I1《AI 原生数据库基础》:建立统一数据、混合检索和事务能力的全景;
- D2《AI 应用的数据层》:提供切分、Embedding 和混合搜索代码;
- D3《Agentic RAG 实战》:将检索能力封装为 Agent 工具并完成评测;
- I3《SQL × AI》:继续讨论 Embedding、重排和生成函数如何进入 SQL;
- I8《案例场景和测评构建》:扩展产业案例与系统化测评方法。
参考资料
共建说明
欢迎在课程共建 Issue #91 中补充案例、实验、图示和评测方法。