
I4:File SQL for AI Agent
Easy Data x AI 课程 · 产业应用篇 · 第 4 节
本节定位
本节讨论 AI Agent 如何直接用 SQL 发现、理解、查询和导出本地文件。重点不是记住几个文件函数,而是理解“文件成为临时关系”之后,Schema 推断、SQL 执行、安全隔离与一致性保障如何协同工作。
版本提示
本文依据 2026 年 8 月的训练营材料与 File as SQL 设计文档整理。材料中的 DuckDB 风格公开接口仍处于设计和迁移阶段;不同版本的函数名、参数、格式支持与启用方式可能不同。示例用于讲解目标接口,实践前请以目标版本文档和实测结果为准。
学习目标
完成本节后,你将能够:
- 解释 File SQL 为什么适合 AI Agent 的一次性文件分析;
- 区分数据导入、外表与语句级文件关系三条技术路线;
- 使用 glob、DESCRIBE、read_csv、read_json、read_parquet 和 COPY TO 组织文件分析流程;
- 说明动态 Schema、类型推断和文件指纹在编译与执行中的作用;
- 理解 File Reader 与数据库 SQL 引擎的职责边界;
- 设计路径白名单、符号链接防护、资源限制等安全措施;
- 为 Agent 设计可验证、可观测、失败即停止的文件工具协议。
1. Agent 为什么需要 File SQL?
AI Agent 经常面对临时文件:用户上传的订单 CSV、日志 JSONL、分析系统导出的 Parquet,或者工作目录里的一组实验结果。传统做法通常要经历:
识别格式 → 推断 Schema → 创建表 → 导入数据 → 执行查询 → 清理临时表这条链路适合长期管理的数据,却不适合只查询一次的文件。每增加一个步骤,Agent 就多一次工具调用、多一个失败点和一份需要清理的数据副本。
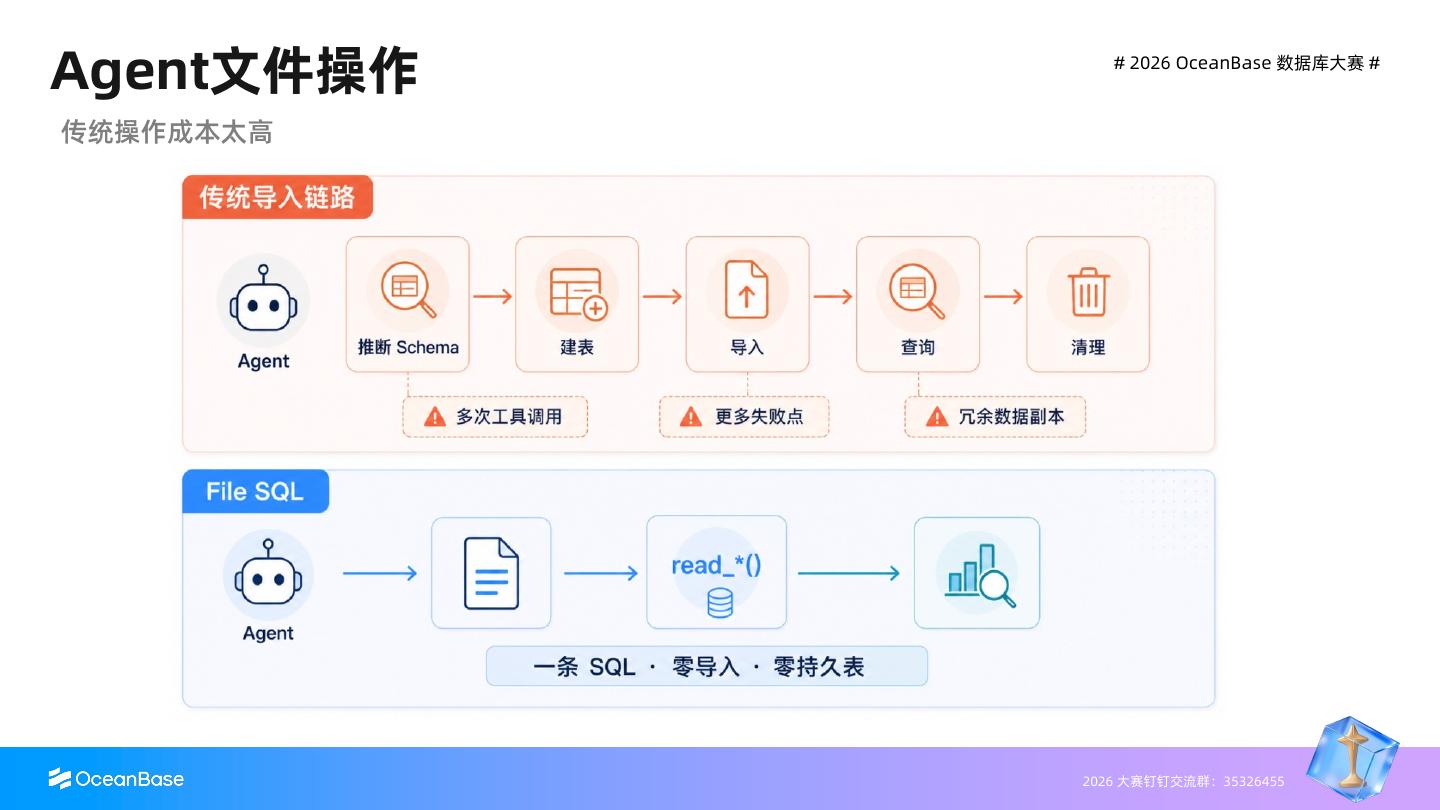
File SQL 把文件直接解释为一张语句级临时关系:
SELECT customer_id, SUM(amount) AS total_amount
FROM read_csv('/workspace/orders.csv')
GROUP BY customer_id;
这里没有 CREATE TABLE,也没有 LOAD DATA。查询结束后,不会在系统目录中留下持久表。
当文件只需要被读取、关联或聚合时,让 Agent 用一条受控 SQL 完成分析,而不是先制造一套临时数据工程。
2. 文件如何成为关系?
| 路线 | 典型操作 | 优点 | 代价 | 适用场景 |
|---|---|---|---|---|
| 导入为普通表 | 建表、导入、查询 | 完整事务与索引能力 | 步骤多、产生副本、需要清理 | 长期保存、反复查询 |
| 注册外表 | 创建外表后查询 | 不复制文件,可重复访问 | 仍需 DDL 与元数据治理 | 稳定数据源、共享访问 |
| 语句级文件关系 | read_csv(...) | 零建表、即时查询 | 只读、能力边界更窄 | Agent 临时分析 |
本节关注第三条路线。read_csv(...) 看起来像表函数,但它必须在 SQL 编译期暴露列名与类型,才能像普通表一样参与投影、过滤、连接和聚合。
因此,File SQL 不是“在字符串函数里偷偷执行查询”,而是把文件扫描接入数据库的关系模型与执行计划。
3. 一次完整的 File SQL 体验
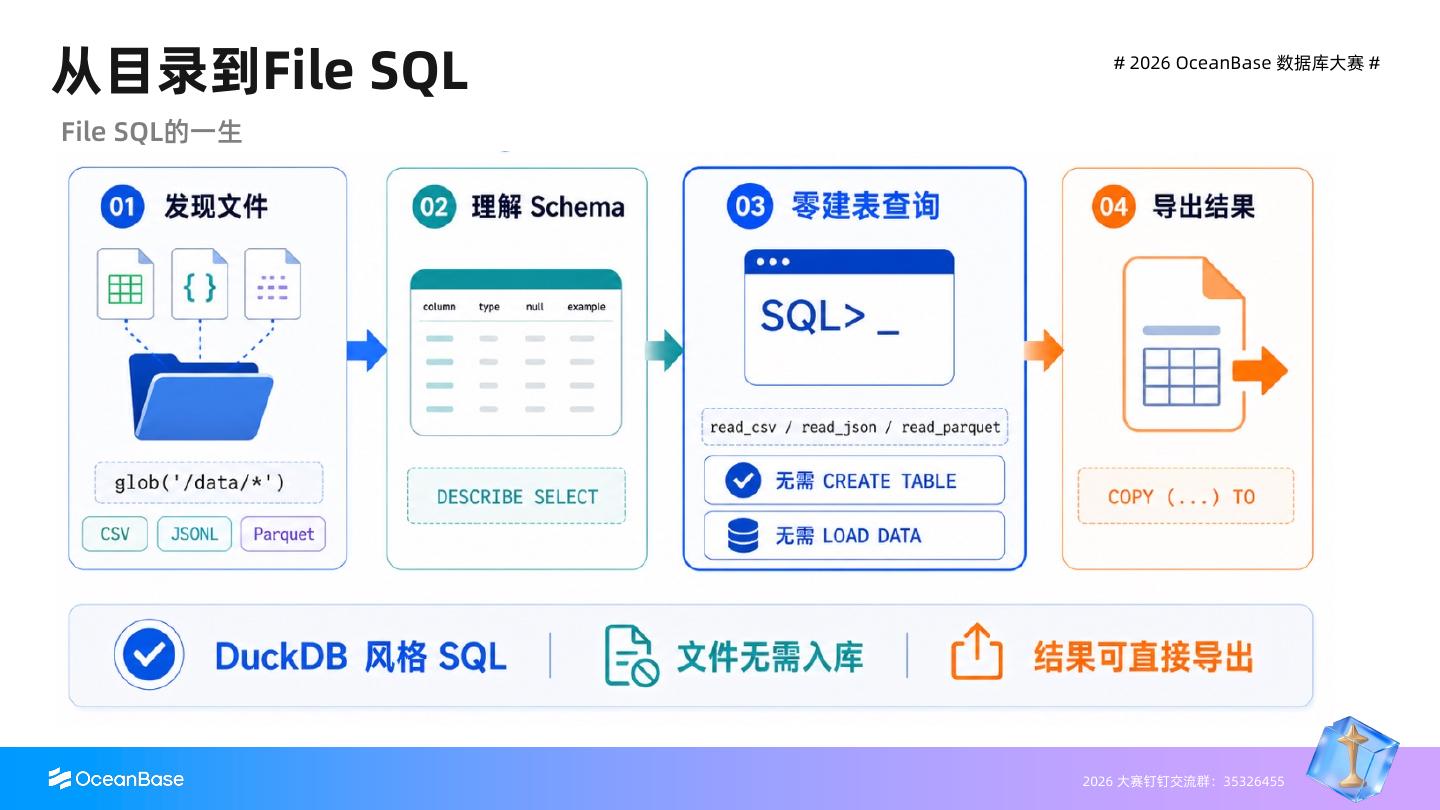
3.1 发现文件
SELECT file
FROM glob('/workspace/*');
glob 只负责在允许目录内发现路径,不读取文件内容。Agent 应先查看候选文件,再决定下一步操作,避免凭空猜测文件名。
3.2 理解 Schema
DESCRIBE SELECT *
FROM read_csv('/workspace/orders.csv');
DESCRIBE 回答“有哪些列、各是什么类型”;EXPLAIN 则回答“数据库准备如何执行”。两者不要混用。
3.3 查询单个文件
SELECT customer_id,
       COUNT(*) AS order_count,
       SUM(amount) AS total_amount
FROM read_csv('/workspace/orders.csv')
WHERE status = 'paid'
GROUP BY customer_id
HAVING SUM(amount) > 1000
ORDER BY total_amount DESC
LIMIT 20;
3.4 连接不同格式
SELECT o.order_id, o.customer_id, c.level
FROM read_csv('/workspace/orders.csv') AS o
LEFT JOIN read_parquet('/workspace/customers.parquet') AS c
  USING (customer_id);
Reader 负责把两种文件转换为类型化数据批次,JOIN 仍由数据库 SQL 引擎完成。
3.5 导出结果
COPY (
  SELECT customer_id, SUM(amount) AS total_amount
  FROM read_csv('/workspace/orders.csv')
  GROUP BY customer_id
)
TO '/workspace/export.csv'
(FORMAT CSV, HEADER);
这五步构成 Agent 的最小闭环:发现 → 描述 → 查询 → 关联 → 导出。
4. 能做什么,暂时不做什么?
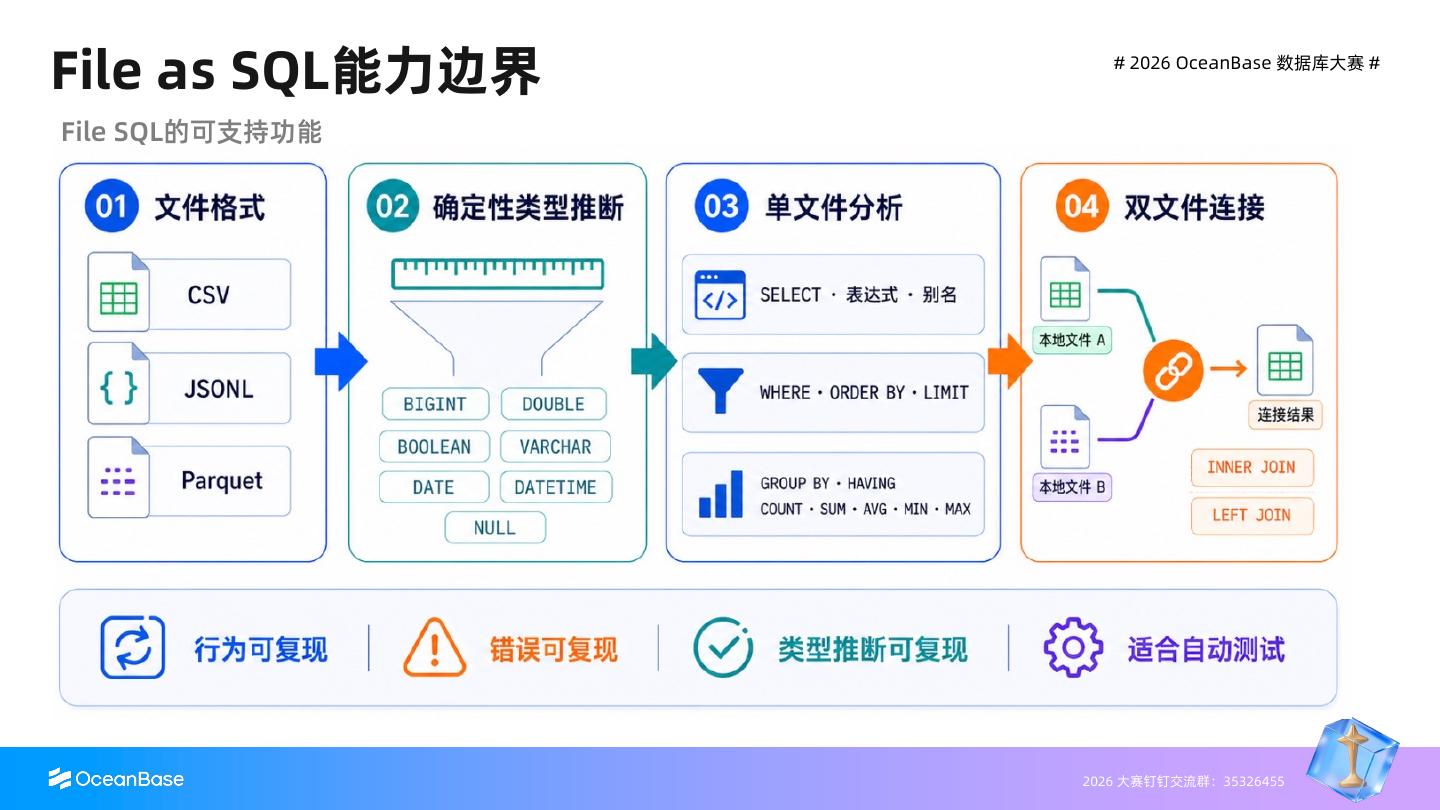
4.1 目标能力
| 类别 | 能力 |
|---|---|
| 文件发现 | 在受控目录内使用 glob 枚举文件 |
| 文件格式 | CSV、JSONL、Parquet |
| Schema | 确定性的列名与类型推断,DESCRIBE 查看结果 |
| 单文件查询 | SELECT、表达式、WHERE、ORDER BY、LIMIT |
| 分析 | GROUP BY、HAVING、COUNT、SUM、AVG、MIN、MAX |
| 多文件关系 | 两个本地文件的 INNER JOIN、LEFT JOIN,可跨格式 |
| 结果输出 | COPY 查询结果 TO CSV |
4.2 第一阶段的非目标
- 不对文件关系执行 INSERT、UPDATE、DELETE 或 FOR UPDATE;
- 不原地修改输入文件,也不支持 COPY FROM;
- 不读取 XLS/XLSX、ORC、Avro、压缩包或远程对象存储;
- 不自动合并 glob 结果中的多个文件;
- 不展开嵌套 JSON 的 List、Struct 等复杂结构;
- 不提供分布式多节点文件扫描;
- 不为文件建立持久索引、统计信息或物化缓存;
- 不提供目录监听与文件变化订阅。
边界越清楚,Agent 越能判断何时继续、何时转换格式、何时把数据导入正式表。
5. 三种格式的读取语义
5.1 CSV:方言与脏数据是核心问题
SELECT *
FROM read_csv(
  '/workspace/orders.csv',
  header = true,
  delim = ',',
  nullstr = '',
  all_varchar = false
);
CSV 并不只有“逗号分隔”这么简单。实现还要处理表头、引号、转义、字段内换行、空字符串和 NULL 的区别。自动探测是便利功能,而不是永远正确的猜测;不符合业务语义时,应显式指定参数,或者先把全部字段按 VARCHAR 读取后再转换。
5.2 JSONL:一行一个扁平对象
SELECT event_type, COUNT(*)
FROM read_ndjson('/workspace/events.jsonl')
GROUP BY event_type;
read_ndjson 可以理解为 read_json(..., format = 'newline_delimited') 的别名。第一阶段以扁平 JSON 对象为主:不同记录出现的字段组成联合 Schema,缺失字段按 NULL 处理;嵌套数组和对象不应被默默展平。
5.3 Parquet:Schema 来自 Footer
SELECT customer_id, amount
FROM read_parquet('/workspace/orders.parquet')
WHERE amount > 100;
Parquet 自带 Schema 和列式元数据,不需要像 CSV、JSONL 那样扫描文本推断结构。实现可以利用列裁剪和 Row Group 组织减少 I/O,但嵌套类型、高精度 Decimal 等高级类型仍需逐版本确认。
6. 动态 Schema 如何产生?
SQL 客户端在接收第一行数据前就需要知道结果列。因此,文件关系的 Schema 必须在编译阶段确定。
6.1 推断过程
规范化路径
  → 打开并识别文件格式
  → 读取表头与记录
  → 为每列累积候选类型
  → 合并为最终类型
  → 构造语句级表定义
  → 进入优化与执行
设计基线以完整扫描换取确定性:编译期只保存每列的推断状态,而不保存全部数据;执行期再流式扫描一次。Parquet 则可直接从 Footer 获取 Schema。
6.2 类型合并
基础类型包括 NULL、BOOLEAN、BIGINT、DOUBLE、DATE、DATETIME、VARCHAR。一个可复现的合并规则示例为:
NULL + BIGINT       → BIGINT
BIGINT + DOUBLE     → DOUBLE
DATE + DATETIME     → DATETIME
数字 + 普通字符串   → VARCHAR
任意类型 + VARCHAR  → VARCHAR
关键不是“尽量猜得聪明”,而是同一文件在相同配置下始终得到相同结果与相同错误。
6.3 列名与 Schema 缓存
表头还要经过 BOM 清理、首尾空白处理和重名消解,例如 id,id,,amount 可确定性地变成 id,id_2,column3,amount。
重复扫描大文件成本较高。缓存键可以包含规范化路径、device、inode、文件大小、纳秒级修改时间、格式、推断选项和算法版本。缓存只保存 Schema 元数据,并采用有界 LRU;它不是文件内容缓存,也不能替代执行时的一致性检查。
7. 从 SQL 到执行计划
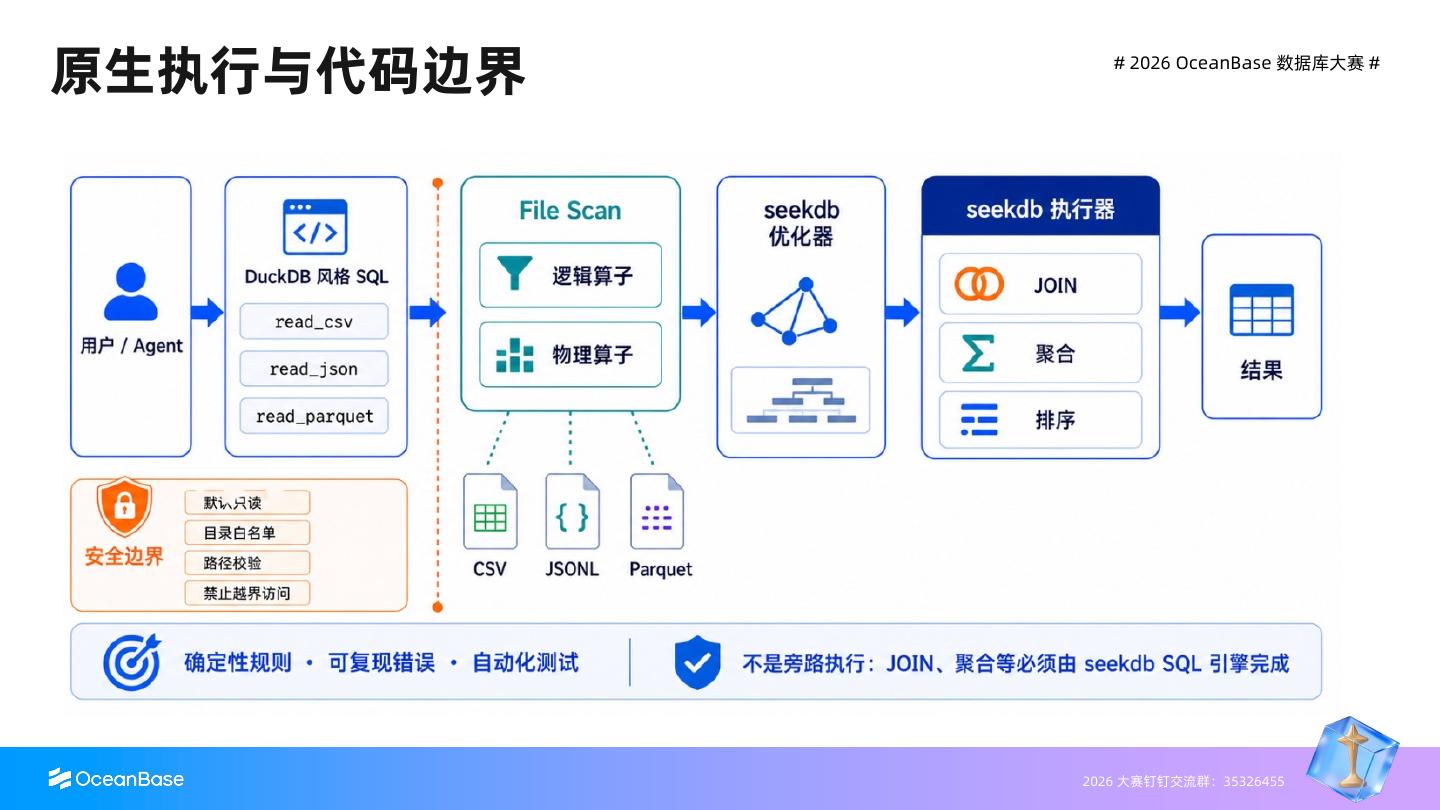
Parser
  → File Table Resolver
  → Path Guard + Schema Inferencer
  → Optimizer
  → Logical File Scan
  → Physical File Scan
  → CSV / JSONL / Parquet Reader
  → 类型化数据批次
  → Filter / Join / Aggregate / Sort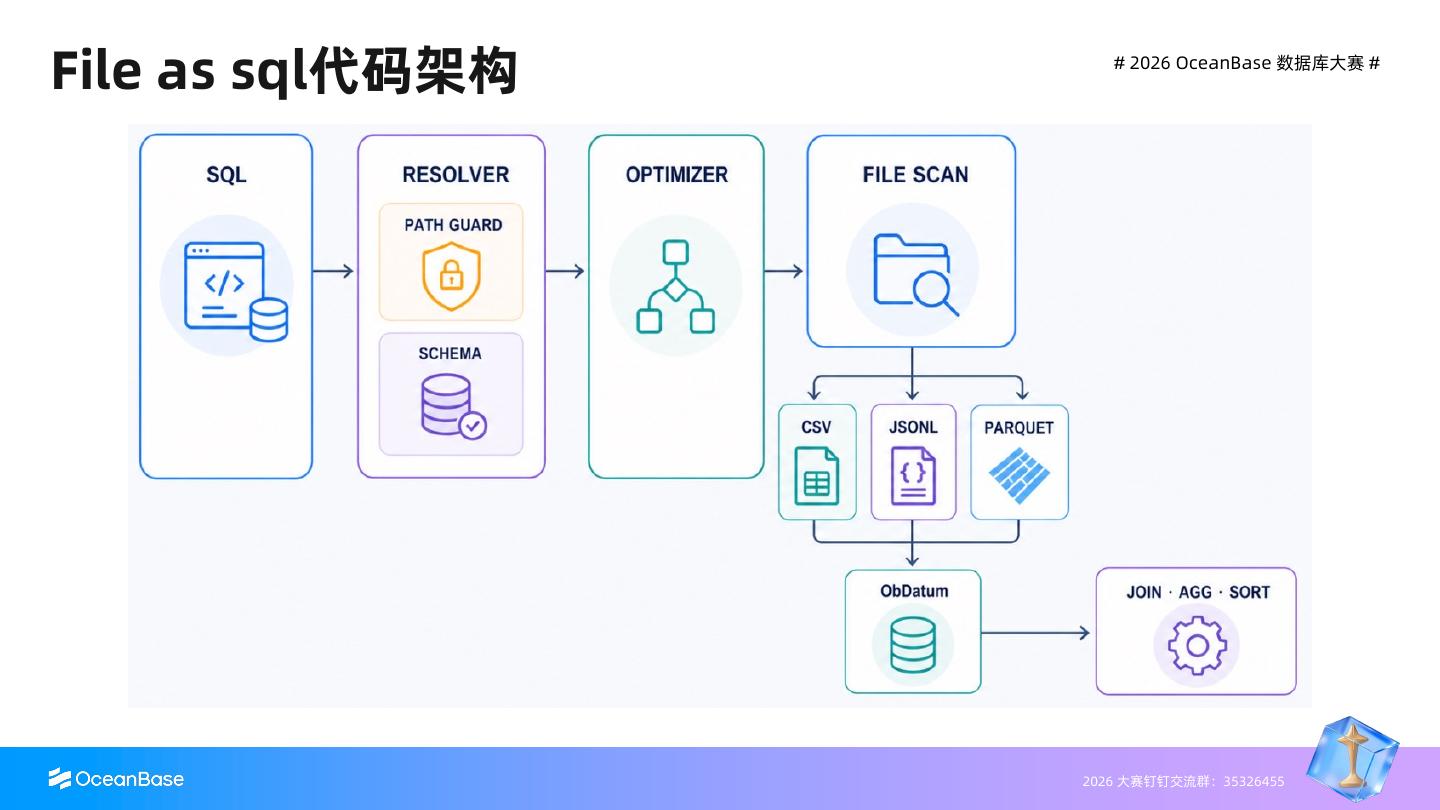
Resolver 将 read_csv(...) 解析成带动态列定义的临时关系;优化器生成文件扫描算子;执行器再以批次方式把数据交给普通关系算子。
判断实现边界时,应关注两点:
- EXPLAIN 中应看到文件扫描叶子以及原生 JOIN、AGG、SORT 等节点;
- 不应把完整 SQL 旁路交给 DuckDB、SQLite、Polars 等外部查询引擎执行。
公开语法可以参考 DuckDB 风格,但关系语义与查询执行仍属于 seekdb / OceanBase SQL 引擎。
8. Reader 与 SQL 引擎的边界
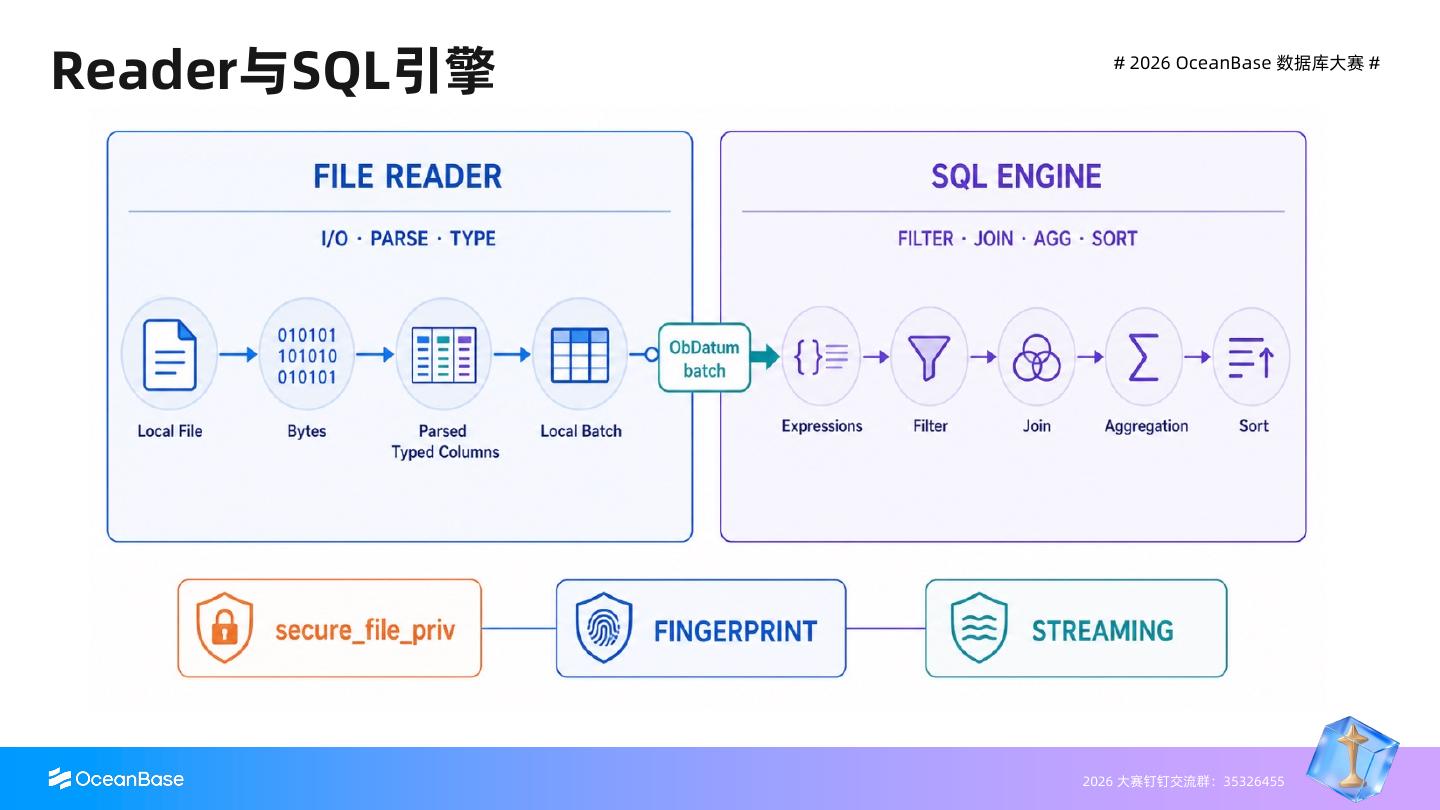
| File Reader 负责 | SQL 引擎负责 |
|---|---|
| 文件 I/O | 表达式求值 |
| CSV、JSONL、Parquet 解析 | WHERE 过滤 |
| 字段到 SQL 类型的转换 | JOIN |
| 安全的列裁剪 | GROUP BY 与聚合 |
| 产出类型化数据批次 | ORDER BY、LIMIT |
Reader 不应理解业务 SQL,更不应在内部另建一套 JOIN 或聚合实现。清晰分工让文件格式扩展无需复制 SQL 能力,查询语义也能与普通表保持一致。
执行内存应与批次大小、投影列宽和算子状态相关,而不是与整个文件大小线性增长。若先把全文件物化为内存表,再交给 SQL 引擎,就失去了流式扫描的意义。
9. 文件没有 MVCC:一致性怎么办?
普通数据库表可以依赖事务快照;本地文件没有 MVCC。查询期间若另一个进程覆盖、追加或替换文件,结果可能混合两个版本。
9.1 文件指纹
编译期记录文件指纹,打开文件和扫描结束时再次核对:
device + inode + size + mtime_ns任何关键字段变化都应触发 FILE_CHANGED 类错误,并让整条 SQL 失败。即使客户端已收到部分流式结果,也应把本次结果视为无效。
9.2 TOCTOU 与能力边界
安全实现应先打开文件,再对文件描述符执行 fstat,后续始终读取同一个描述符,减少路径检查完成后目标被替换的风险。
文件指纹只能提供变化检测,不等于数据库快照:文件查询不宜进入普通 Plan Cache;Prepared Statement 遇到结构变化应重新准备;需要强快照与可重复读时,应先把数据导入正式表。
10. 路径安全是第一等能力
让 SQL 读取服务器文件会扩大攻击面。File SQL 必须默认关闭,并要求管理员配置唯一受控根目录,例如 secure_file_priv。
10.1 Path Guard 检查链
功能是否启用
  → secure_file_priv 是否配置
  → 路径规范化与 realpath
  → 是否位于允许根目录
  → 是否为普通文件
  → 以只读、安全标志打开
  → 对文件描述符再次校验
必须拒绝:
- 使用 .. 逃逸根目录;
- 利用相同字符串前缀绕过目录边界;
- 通过符号链接跳到白名单外;
- 读取目录、FIFO、Socket、块设备或字符设备;
- 从数据库服务器读取客户端电脑上的同名路径。
SQL 中的路径属于 Observer / 数据库进程所在机器,而不是发起查询的客户端机器。单机 seekdb / OceanBase Lite 是第一阶段更清晰的部署边界;分布式环境下“本地路径”在哪个节点存在并没有稳定语义。
还应限制单文件大小、列数、字段长度、行长度和 JSON Key 数量。日志和 EXPLAIN 可以显示白名单内相对路径,但不应记录文件正文。glob、DESCRIBE、read_* 与 COPY TO 必须复用同一套 Path Guard。
11. COPY TO 如何安全导出?
COPY TO 写查询结果,但不改变输入文件关系。安全实现至少应满足:
- 输出路径也位于允许根目录;
- 默认不覆盖已存在文件;
- 先写同目录临时文件,成功后再原子发布;
- SQL 失败、磁盘写满或取消时清理临时文件;
- 表头、分隔符、引号、转义、NULL 与编码规则可复现;
- 禁止把输出指向输入文件本身。
Agent 在导出后还应验证目标文件存在、行数或摘要符合预期,再把路径交给用户。
12. 为 AI Agent 设计工具协议
Agent 不应获得一个无限制的 run_sql 工具后自由试错。更稳妥的工具协议可以拆为:
list_allowed_files(pattern)
  → describe_file(path, format_options)
  → preview_file(path, limit)
  → query_files(sql)
  → export_query(sql, target)
  → verify_export(target)
12.1 Agent 的操作准则
- 先发现再读取,不猜测路径;
- 先 DESCRIBE 再写 SQL,不猜测列名与类型;
- 先小样本再全量,预览必须 LIMIT;
- 明确选择列,避免不必要的 SELECT *;
- 全量聚合前估算文件大小和资源预算;
- 文件变化、格式或权限错误时立即停止,不自动放宽配置;
- 导出使用新文件名,并在返回前验证结果;
- 将 SQL、输入指纹、Schema 和输出路径写入审计记录。
12.2 一个分析任务模板
用户提出:“统计已支付订单的客户消费额,关联客户等级,并导出前 100 名。”
-- 1. 找到候选文件
SELECT file FROM glob('/workspace/*');

-- 2. 确认结构
DESCRIBE SELECT * FROM read_csv('/workspace/orders.csv');
DESCRIBE SELECT * FROM read_parquet('/workspace/customers.parquet');

-- 3. 小样本验证 Join Key
SELECT o.order_id, o.customer_id, o.amount, c.level
FROM read_csv('/workspace/orders.csv') o
LEFT JOIN read_parquet('/workspace/customers.parquet') c
  USING (customer_id)
LIMIT 20;

-- 4. 执行并导出
COPY (
  SELECT o.customer_id, c.level, SUM(o.amount) AS total_amount
  FROM read_csv('/workspace/orders.csv') o
  LEFT JOIN read_parquet('/workspace/customers.parquet') c
    USING (customer_id)
  WHERE o.status = 'paid'
  GROUP BY o.customer_id, c.level
  ORDER BY total_amount DESC
  LIMIT 100
)
TO '/workspace/top_customers.csv'
(FORMAT CSV, HEADER);
这套流程把“理解数据”和“执行动作”分开,让每一步都可检查、可审计。
13. 错误与可观测性
| 错误类别 | 示例 | Agent 应对 |
|---|---|---|
| 功能未启用 | FILE_SQL_DISABLED | 停止并提示管理员配置 |
| 路径被拒绝 | ACCESS_DENIED | 不尝试换路径绕过 |
| 格式不支持 | FORMAT_NOT_SUPPORTED | 转换格式或导入正式表 |
| Schema 推断失败 | SCHEMA_INFERENCE_FAILED | 检查方言、表头和参数 |
| 非法记录 | INVALID_RECORD | 定位行号并修复源文件 |
| 嵌套值不支持 | UNSUPPORTED_NESTED_VALUE | 预处理 JSON |
| Parquet 类型不支持 | UNSUPPORTED_PARQUET_TYPE | 转换列类型或格式 |
| 查询期间文件变化 | FILE_CHANGED | 丢弃结果,待文件稳定后重试 |
诊断可以包含相对路径、行号、列名、预期类型和实际值摘要,但不应泄露白名单外绝对路径或完整敏感记录。
建议观测扫描次数、读取行数与字节数、解析错误数、Schema 推断耗时、缓存命中率、过滤后行数、COPY 输出字节数以及 FILE SQL READ 等等待事件。
14. 如何测试 File SQL?
14.1 正确性测试
- 用内容等价的 CSV、JSONL、Parquet 验证查询结果;
- 覆盖投影、过滤、排序、聚合、HAVING 与 LIMIT;
- 覆盖同格式和跨格式 INNER / LEFT JOIN;
- 验证 NULL、空字符串、日期、布尔和数值边界;
- 验证 DESCRIBE 与实际返回列一致;
- COPY TO 后重新读取并比对原查询。
14.2 鲁棒性与安全测试
- CSV 引号、转义、字段内换行和不完整记录;
- JSONL 缺失字段、非法 JSON 与嵌套对象;
- Parquet 不支持类型和损坏 Footer;
- ..、符号链接、前缀碰撞和特殊文件;
- 编译后、执行前及执行中修改文件;
- COPY 目标已存在、磁盘写满、查询失败和取消;
- 超大字段、超多列、长行与大量 JSON Key。
14.3 架构边界测试
EXPLAIN 应证明 File Scan 是叶子算子,JOIN、AGG、SORT 由原生执行器承担。内存测试应证明扫描占用与批次和投影宽度相关,而不是随文件总大小线性增长。
15. 何时使用,何时不要使用?
| 场景 | 建议 |
|---|---|
| Agent 临时查看用户上传的 CSV | 使用 File SQL |
| 连接两份本地中小型文件做一次分析 | 使用 File SQL |
| 将查询结果安全导出为 CSV | 使用 COPY TO |
| 数据需要长期复用、索引和事务 | 导入正式表 |
| 文件持续变化且要求强快照 | 先固化版本或导入表 |
| 扫描对象存储或跨节点文件 | 使用专门的外表/湖仓方案 |
| 复杂嵌套 JSON、Excel 工作簿 | 先用专用解析工具预处理 |
| 需要修改原文件 | 使用受控文件工具 |
File SQL 是“即时关系化”的工具,而不是持久数据库、数据湖连接器和通用文件系统 API 的替代品。
16. 常见误区
误区一:File SQL 等于自动导入
文件关系是语句级对象,不创建持久表,也不产生可长期复用的数据副本。
误区二:语法像 DuckDB,就由 DuckDB 执行
公开接口可以采用相似风格,但 Reader 只产出数据批次,关系运算由本地 SQL 引擎执行。
误区三:自动推断一定符合业务含义
邮编、证件号和带前导零的编码可能被误判为数字。业务语义不明确时应显式读取为 VARCHAR。
误区四:路径在用户电脑上
路径属于数据库服务器进程。客户端路径即使同名,也不代表服务器上存在同一文件。
误区五:指纹等于事务快照
指纹只能检测变化并让查询失败,不能提供文件旧版本的可重复读。
误区六:只读就没有安全风险
任意文件读取足以泄露密钥、配置和系统信息。白名单、realpath、文件类型检查与资源限制缺一不可。
17. 本节小结
File SQL 把本地文件转换为无需建表的临时关系,让 AI Agent 可以通过一套 SQL 完成发现、理解、查询、连接和导出。
真正决定它能否用于生产的,不只是 read_csv 语法,而是:
- 编译期动态 Schema 与确定性类型推断;
- Reader 和 SQL 引擎的清晰分工;
- 批量、流式、原生的关系执行;
- 文件指纹与变化即失败的一致性策略;
- 默认关闭、目录白名单和统一 Path Guard;
- 安全发布的 COPY TO;
- 结构化错误、指标、审计与系统化测试。
先发现,后描述;先验证,后全量;最小权限读取,确定结果再导出。
思考题
- 为什么 read_csv(...) 的 Schema 必须在 SQL 执行前确定?
- 如果只抽样前 1000 行推断类型,可能出现哪些不稳定结果?
- 文件在查询过程中变化时,为什么“继续返回尽可能多的结果”不适合 Agent?
- Reader 内部执行 JOIN 会破坏哪些架构边界?
- 如何设计一个既方便 Agent 使用、又不能越过 secure_file_priv 的文件发现工具?