
I5:AI 列 —— 模型驱动派生数据的自动维护
Easy Data x AI 课程 · 产业应用篇 · 第 5 节
本节定位
本节讨论如何将异步模型调用下沉到数据库,把语言、标签、摘要、评分和向量等模型输出声明为 AI 列,并在源数据变化后自动维护。重点是用户可见的数据契约,而不是某一种任务表、线程池或调度器实现。
版本提示
本文依据 2026 年 9 月的 seekdb / oceanbase-lite AI 列实现与配套资料整理。AI 列仍在演进,模型 Provider、端点参数、DDL 语法和可观测字段应以目标版本文档与实测结果为准。
学习目标
完成本节后,你将能够:
- 解释 AI 列与普通生成列、应用层异步任务的差异;
- 使用 SQL 注册逻辑模型和服务端点;
- 使用
AI_COMPLETE、AI_EMBED和AI COLUMN声明模型派生数据; - 说明 AI 列在
INSERT、UPDATE、DELETE和ALTER TABLE后的维护行为; - 正确理解异步读取、严格读取和同组结果整体发布;
- 使用行级重试恢复任意选定的数据集合;
- 分析事务回滚、版本乱序、并发更新和服务退出等边界情况;
- 让有效 AI 结果安全地参与普通、全文、JSON 和向量索引;
- 按模型厂商的实际 Token 计费规则评估并优化费用。
1. 为什么需要 AI 列?
业务数据中经常存在可以由模型计算、又需要长期查询的派生属性:
| 原始数据 | AI 派生数据 | 后续用途 |
|---|---|---|
| 评论、工单、邮件 | 语言、情感、分类、标签 | 过滤、统计和路由 |
| 文档、商品说明 | 摘要、结构化 JSON、评分 | 展示、分析和审核 |
| 文本、图片描述 | 固定维度向量 | 相似度查询和语义检索 |
传统应用通常完成下面的流程:
读取数据库
  → 组装 Prompt
  → 调用模型 SDK 或 HTTP 接口
  → 校验返回值
  → 写回数据库
  → 维护重试、版本和索引
真正困难的并不是生成第一版结果,而是源数据变化以后,模型派生数据是否仍然可信。应用还要处理模型失败、请求延迟、乱序返回、事务回滚、服务重启和索引更新。
AI 列把这条维护链路表达成数据库中的数据定义:
content VARCHAR(8192),

language VARCHAR(32) AI COLUMN (
  AI_COMPLETE(
    'doc_complete_model',
    CONCAT('Return only the language name. Content: ', content)
  )
) WITH (sync_mode='async', max_retries=3)
用户维护 content,数据库维护 language。AI 请求不会阻塞原始业务事务;生成完成并通过校验以后,结果才对查询可见。
1.1 与普通生成列的差异
| 维度 | 普通生成列 | AI 列 |
|---|---|---|
| 计算位置 | 数据库进程内 | 外部模型服务 |
| 延迟 | 通常很短 | 可能为数十毫秒到数秒 |
| 确定性 | 相同输入通常相同输出 | 可能受模型版本与采样影响 |
| 失败类型 | 表达式或类型错误 | 还包括网络、限流、超时和协议错误 |
| 可见时间 | 通常随业务语句完成 | 异步生成完成后发布 |
| 外部费用 | 数据库计算资源 | 还包括 Token 或请求费用 |
因此,AI 列不能只被理解为“多了一个 AI 函数”。它是一类需要异步可见性、版本控制、失败恢复和索引一致性的新数据对象。
2. AI 列的生命周期
一次源数据变化可以拆成三个阶段:
业务事务 T1
  写入源数据
  → 使旧 AI 结果失效
  → 记录待生成工作
  → COMMIT

异步执行
  读取已经提交的输入
  → 调用模型
  → 校验返回类型和版本

结果事务 T2
  再次确认源数据版本
  → 发布同组 AI 结果
  → 更新对应索引
  → COMMIT
T1 不等待模型调用。T2 是独立的数据库事务,不是 T1 的延长,也不与远程 HTTP 组成分布式事务。
这个模型带来两个重要结论:
- 模型接口可能被重复调用,但重复或迟到的结果不能污染最终数据;
- 请求完成不等于结果已经可见,只有结果事务成功提交后,用户才能读到新值。
3. 注册逻辑模型和服务端点
AI 列引用逻辑模型名。实际 URL、访问凭据和厂商模型名由服务端点提供。
3.1 注册 Completion 模型
CALL DBMS_AI_SERVICE.CREATE_AI_MODEL(
  'doc_complete_model',
  '{
    "type":"completion",
    "model_name":"vendor-chat-model"
  }'
);
CREATE_AI_MODEL(model_name, config) 在数据库中注册逻辑模型:
- 第一个参数是后续 SQL 使用的逻辑名称;
type表示模型能力,例如completion或dense_embedding;- 配置中的
model_name表示声明的模型名称。
3.2 注册服务端点
CALL DBMS_AI_SERVICE.CREATE_AI_MODEL_ENDPOINT(
  'doc_complete_endpoint',
  '{
    "ai_model_name":"doc_complete_model",
    "url":"https://vendor.example/v1/chat/completions",
    "access_key":"<API_KEY>",
    "provider":"openai",
    "request_model_name":"vendor-chat-model",
    "max_concurrency":4
  }'
);| 参数 | 含义 |
|---|---|
ai_model_name | 端点绑定的逻辑模型 |
url | 完整的模型请求地址 |
access_key | 模型服务访问凭据 |
provider | 请求和响应协议类型;OpenAI 兼容接口使用 openai |
request_model_name | 写入 HTTP 请求体的实际厂商模型名 |
max_concurrency | 该 URL 的最大并发请求数 |
不要泄露 API Key
示例中的 <API_KEY> 必须替换为安全注入的凭据。不要把真实 Key 写入课程代码、日志、截图或 Git 仓库。
Embedding 模型使用 dense_embedding 类型,并注册与之匹配的 Embedding URL:
CALL DBMS_AI_SERVICE.CREATE_AI_MODEL(
  'doc_embed_model',
  '{
    "type":"dense_embedding",
    "model_name":"vendor-embedding-model"
  }'
);
逻辑模型和端点分离以后,业务表只依赖稳定的逻辑名称,运维可以独立管理 URL 和凭据。但切换实际模型仍可能改变结果分布,应当经过回归评测。
4. 用 DDL 定义 AI 列
下面的表同时包含字符串、JSON 和向量三类 AI 列:
CREATE TABLE docs (
  id       BIGINT PRIMARY KEY,
  title    VARCHAR(255),
  content  VARCHAR(8192),
  category VARCHAR(64),

  language VARCHAR(32) AI COLUMN (
    AI_COMPLETE(
      'doc_complete_model',
      CONCAT('Return only the language name. Content: ', content)
    )
  ) WITH (sync_mode='async', max_retries=3),

  tags JSON AI COLUMN (
    AI_COMPLETE(
      'doc_complete_model',
      CONCAT('Return a JSON array of tags. Content: ', content)
    )
  ) WITH (sync_mode='async', max_retries=3),

  emb VECTOR(1024) AI COLUMN (
    AI_EMBED('doc_embed_model', content, 1024)
  ) WITH (sync_mode='async', max_retries=3)
);
AI 列定义包含四部分:
- 结果 SQL 类型:例如
VARCHAR(32)、JSON或VECTOR(1024); - AI 表达式:使用哪个模型、函数和 Prompt;
- 依赖列:表达式实际引用的普通列,例如
content; - 异步选项:当前使用
sync_mode='async',并通过max_retries设置自动重试上限。
4.1 结果必须满足 SQL 类型契约
模型返回值只有通过目标列类型校验后才能发布:
VARCHAR(N)必须满足字符集和长度限制;JSON必须是合法 JSON;- 整数、日期和时间列必须能够解析为相应 SQL 类型;
VECTOR(N)必须由有限数值组成,返回维度必须与列定义一致。
下面的声明应在 DDL 阶段被拒绝,因为列定义和函数声明维度不一致:
ALTER TABLE docs ADD COLUMN bad_emb VECTOR(1024) AI COLUMN (
  AI_EMBED('doc_embed_model', content, 768)
);
4.2 为已有表增加 AI 列
ALTER TABLE docs ADD COLUMN summary VARCHAR(2048) AI COLUMN (
  AI_COMPLETE(
    'doc_complete_model',
    CONCAT('Summarize in one paragraph. Content: ', content)
  )
) WITH (sync_mode='async', max_retries=3);
对于已有数据,DDL 返回表示 AI 列定义和生成工作已经建立,不表示所有存量行都已生成完成。
SHOW AI COLUMNS FROM docs;不再需要某个 AI 列时,可以使用普通 ALTER TABLE ... DROP COLUMN 删除;本例保留 summary,供后文演示全文索引。
5. DML 如何触发自动维护?
用户只维护普通业务列,AI 列由数据库根据依赖关系自动维护。
5.1 INSERT:为新行建立生成工作
INSERT INTO docs(id, title, content, category) VALUES
  (1, 'Database', 'OceanBase is a distributed relational database.', 'tech'),
  (2, 'Sports', 'A basketball team won the championship.', 'news');
INSERT 提交时,新行的 AI 结果尚未完成,随后由异步执行过程生成。用户不能直接指定 AI 列结果:
-- 必须拒绝:language 由数据库维护
INSERT INTO docs(id, content, language)
VALUES (3, 'Bonjour', 'French');
5.2 UPDATE:只在依赖发生变化时重算
修改 content 会使旧结果失效,并为依赖它的 AI 列重新生成:
UPDATE docs
SET content = 'The source text has changed.'
WHERE id = 1;
只修改无关列不应产生不必要的模型调用:
UPDATE docs
SET title = 'Renamed document'
WHERE id = 1;
如果主键发生变化,AI 结果必须归属于新的行标识:
UPDATE docs SET id = 20 WHERE id = 2;5.3 DELETE:迟到结果不能复活已删除数据
DELETE FROM docs WHERE id = 20;即使删除前发出的模型请求稍后才返回,也不能重新写回或重新建立索引项。
6. 异步读取与整体可见性
AI 列采用异步生成。业务事务提交后,模型调用仍可能处于等待、执行、校验或结果提交阶段。
6.1 非严格读取
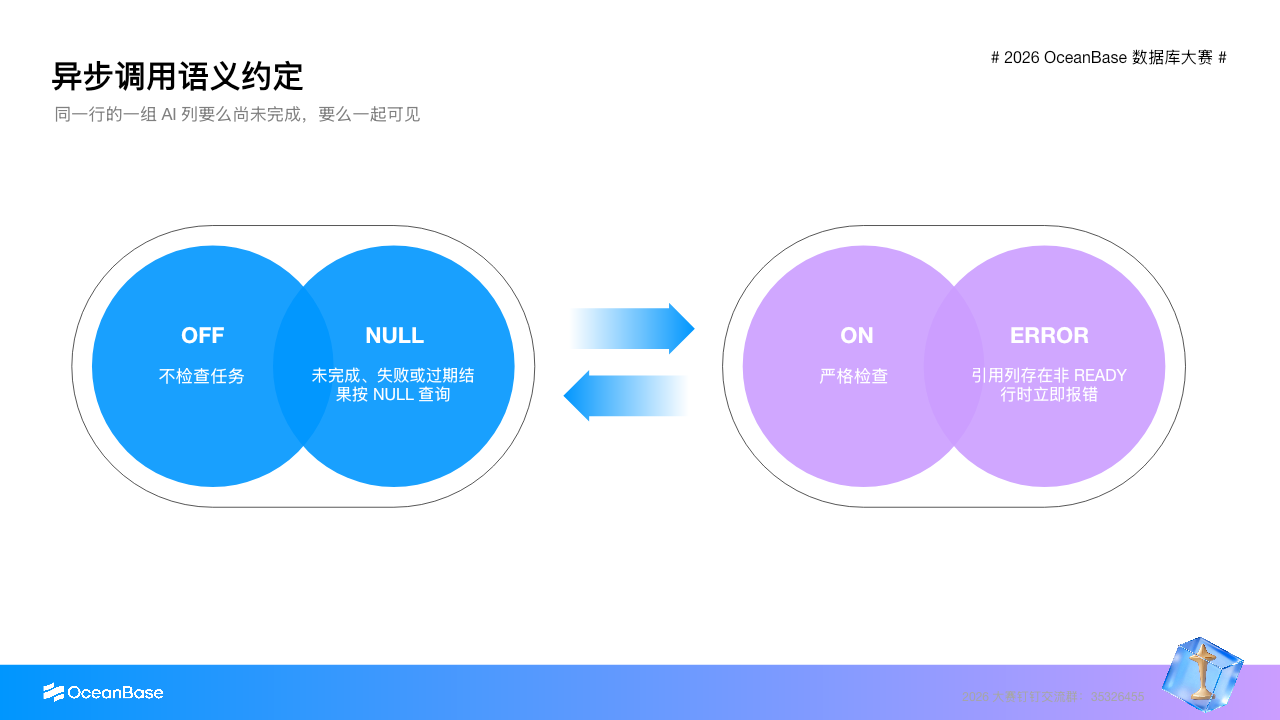
非严格模式不检查完成状态。未完成、失败或已被新版本淘汰的结果按 NULL 参与查询:
SET SESSION ai_column_strict_read = OFF;

SELECT id, language, tags, emb
FROM docs
WHERE id = 1;
6.2 严格读取
严格模式下,只要语句实际引用的 AI 列存在未完成或失败行,语句立即报错,而不是等待模型完成:
SET SESSION ai_column_strict_read = ON;

SELECT language, tags
FROM docs
WHERE id = 1;
严格检查覆盖投影、过滤条件和子查询,也覆盖在条件中引用 AI 列的 UPDATE 与 DELETE。只读取普通列时不应触发检查:
SELECT id, title, content
FROM docs
WHERE id = 1;
6.3 同组结果整体发布
如果同一行的一次数据变化需要生成 language、tags 和 emb,这组结果不能逐列暴露:
生成过程中:language = NULL, tags = NULL, emb = NULL
全部成功后:language、tags、emb 一起成为有效值
这样,用户不会读到“语言属于新内容,但标签或向量仍属于旧内容”的混合状态。
SHOW AI COLUMNS FROM docs 用于查看 AI 列定义和判断完成状态所需的信息。它与严格读取解决不同问题:前者观察生成进度,后者保护当前 SQL。
7. 行级重试
自动重试耗尽、模型配置修复或业务规则变化后,用户需要重新生成指定行。重试语法为:
ALTER TABLE <表名>
  RETRY [FAILED] AI COLUMN <AI列名>
  [WHERE <行选择条件>];
不带 FAILED 时,对 WHERE 选中的任意业务行重新生成;带 FAILED 时,只重试其中尚未成功的行。省略 WHERE 时覆盖相应全部行。
ALTER TABLE docs RETRY AI COLUMN language
WHERE id BETWEEN 100 AND 200;

ALTER TABLE docs RETRY FAILED AI COLUMN tags
WHERE category = 'news';

ALTER TABLE docs RETRY FAILED AI COLUMN emb;
重试仍然遵循版本校验和整体发布规则。重试期间产生的旧请求不能覆盖其后更新的数据。
8. 事务性:数据库保证什么?
远程 HTTP 无法加入数据库本地事务。数据库不保证模型接口只调用一次,也无法在 ROLLBACK 时撤销已经发生的推理和计费。
数据库需要保证的是:无论接口重复执行、乱序返回还是延迟返回,最终可见的数据仍满足 ACID,不会被旧结果或重复结果污染。
| 属性 | AI 列需要满足的外部行为 |
|---|---|
| 原子性 | 源数据变化、旧结果失效和新生成工作一起提交或一起回滚;同组结果整体发布 |
| 一致性 | 只有通过类型校验且对应当前源数据的结果,才能可见并进入索引 |
| 隔离性 | 并发事务彼此隔离,旧版本迟到结果不能覆盖新版本 |
| 持久性 | 已提交的数据变化和未完成工作在服务重启后不能丢失 |
下面用四个具体 Corner Case 检查这些保证。
8.1 事务回滚
DELETE FROM docs WHERE id = 301;
INSERT INTO docs(id, content)
VALUES (301, '这是一段中文。');

-- 等待生成完成,预期 language = Chinese
SELECT content, language FROM docs WHERE id = 301;

START TRANSACTION;
UPDATE docs
SET content = 'This is English.'
WHERE id = 301;
ROLLBACK;

SELECT content, language FROM docs WHERE id = 301;
-- 预期:这是一段中文。 | Chinese
失败表现包括:英文源数据变为可见、AI 列出现 English,或回滚后迟到结果把原有 Chinese 改写。
8.2 版本维护:旧请求晚于新请求返回
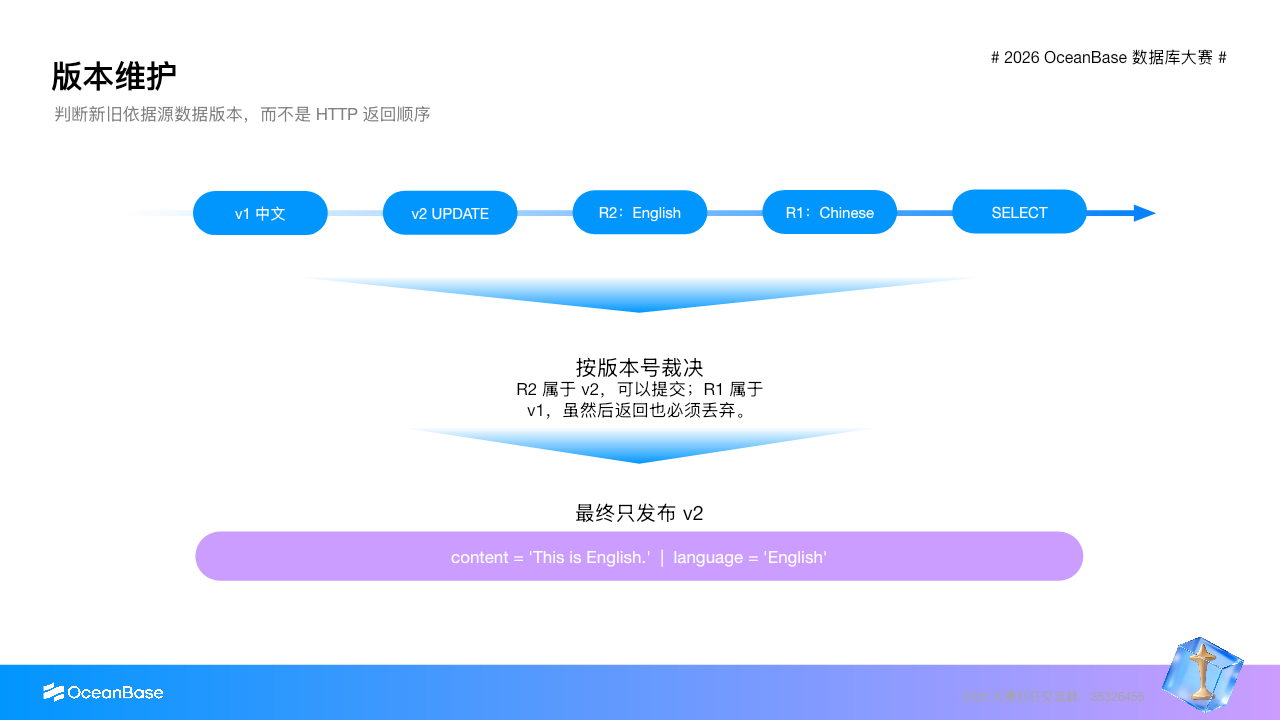
DELETE FROM docs WHERE id = 302;

-- 旧版本提交,请求 R1 尚未返回
INSERT INTO docs(id, content)
VALUES (302, '这是一段中文。');

-- R1 返回前提交新版本,请求 R2 先完成
UPDATE docs
SET content = 'This is English.'
WHERE id = 302;

SELECT content, language FROM docs WHERE id = 302;
-- R2 完成后:This is English. | English

-- R1 随后返回,结果仍不能被覆盖
SELECT content, language FROM docs WHERE id = 302;
-- This is English. | English
结果的新旧必须由源数据版本决定,不能由 HTTP 返回顺序决定。
8.3 事务并发:两个会话更新同一行
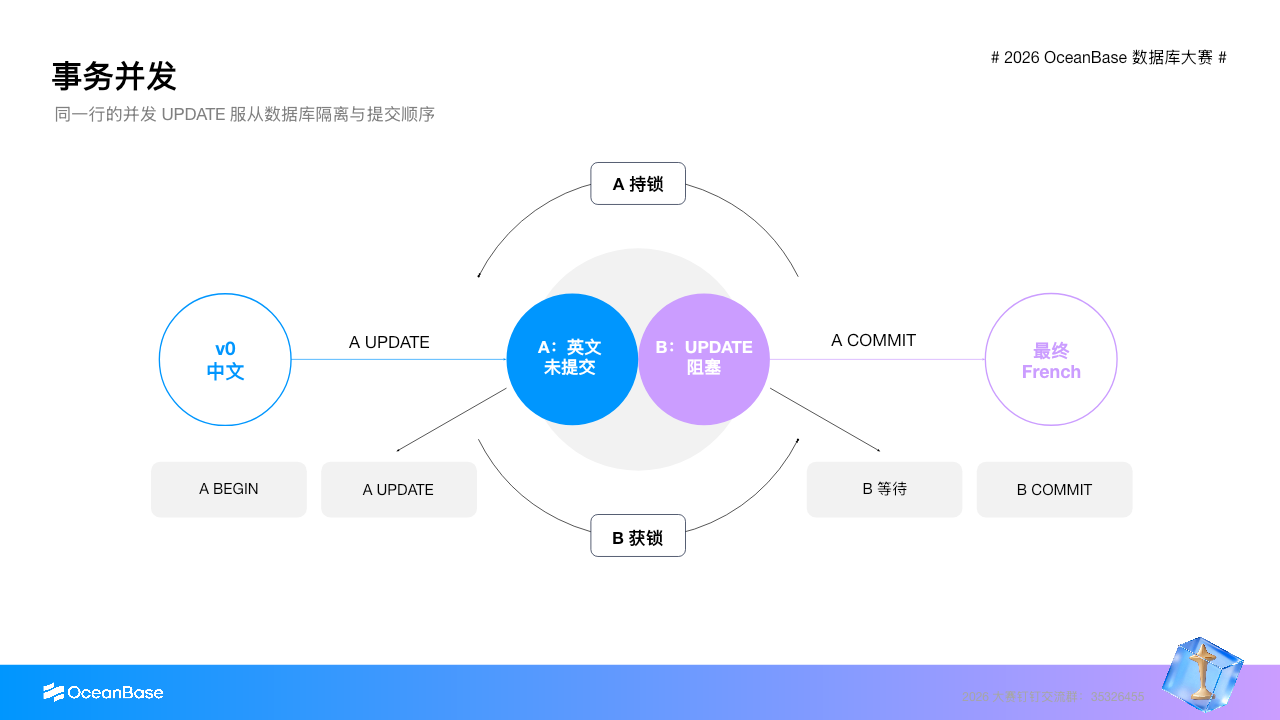
先准备初始行并等待生成完成:
DELETE FROM docs WHERE id = 303;
INSERT INTO docs(id, content)
VALUES (303, '这是一段中文。');
会话 A:
START TRANSACTION;
UPDATE docs
SET content = 'This is English.'
WHERE id = 303;
-- 暂不提交
会话 B:
START TRANSACTION;
UPDATE docs
SET content = 'Ceci est français.'
WHERE id = 303;
-- 等待会话 A
随后会话 A、B 依次提交:
-- 会话 A
COMMIT;

-- 会话 B:UPDATE 返回后
COMMIT;

SELECT content, language FROM docs WHERE id = 303;
-- 最终:Ceci est français. | French
A 未提交时,其他会话不能看到英文版本;B 提交以后,最终法文源数据不能与旧的 Chinese 或 English 结果同时可见。
8.4 事务中崩溃
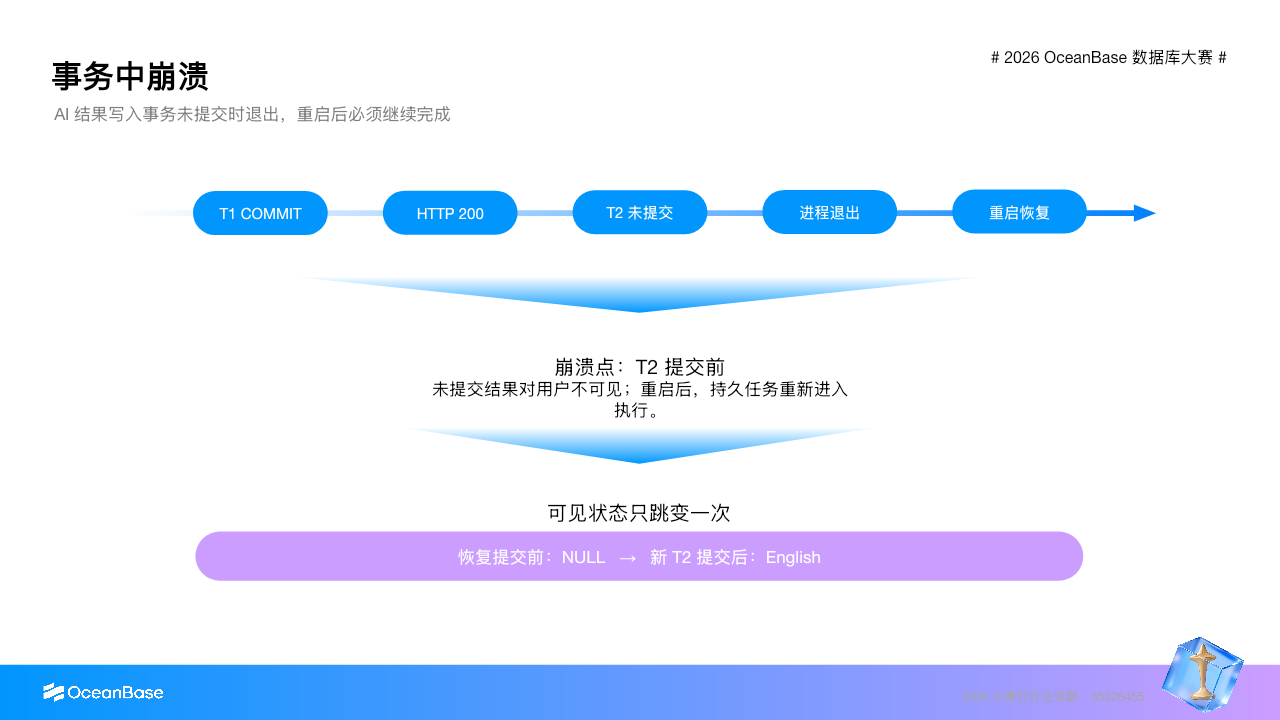
SET SESSION ai_column_strict_read = OFF;

DELETE FROM docs WHERE id = 304;
INSERT INTO docs(id, content)
VALUES (304, 'This is English.');

-- 在 AI 结果写入事务 COMMIT 前终止服务,随后重启
SELECT content, language FROM docs WHERE id = 304;
-- 恢复完成前:This is English. | NULL

SHOW AI COLUMNS FROM docs;

SELECT content, language FROM docs WHERE id = 304;
-- 恢复完成后:This is English. | English
重启后模型请求可能再次执行。允许外部调用大于一次,但不允许未提交结果提前可见、任务永久丢失或重复结果污染最终值。
9. 索引一致性
AI 列结果完成后,可以参与普通索引、JSON 多值索引、全文索引和 VSAG HNSW 向量索引。
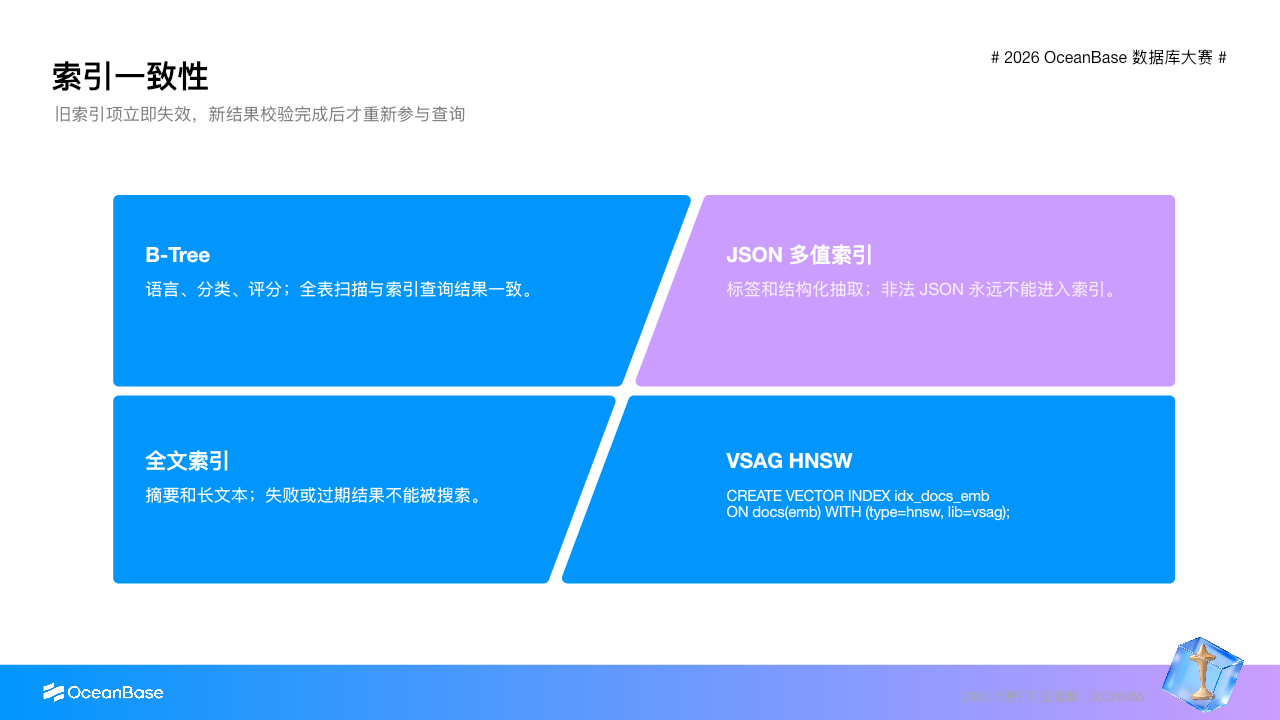
CREATE INDEX idx_docs_language ON docs(language);

CREATE INDEX idx_docs_tags
ON docs((CAST(tags->'$[*]' AS CHAR(64) ARRAY)));

CREATE FULLTEXT INDEX idx_docs_summary ON docs(summary);

CREATE VECTOR INDEX idx_docs_emb
ON docs(emb) WITH (
  distance=l2,
  type=hnsw,
  lib=vsag,
  m=10,
  ef_construction=12,
  ef_search=40
);
向量近似查询继续使用 SQL:
SELECT id, title,
       L2_DISTANCE(emb, :query_vector) AS distance
FROM docs
ORDER BY distance APPROXIMATE
LIMIT 10;
索引一致性的底线包括:
- 源数据变化后,旧 AI 值及其索引项立即失效;
- 新结果完成类型与版本校验后,才能重新参与查询;
- 用户事务回滚后,原结果与原索引行为保持不变;
- 未完成、生成失败或对应旧源数据的结果,不能通过任何索引被搜索出来;
- 全表扫描、普通索引、全文索引和向量索引对结果有效性的判断必须一致。
新向量完成后应自动进入 VSAG HNSW 索引,不要求用户执行人工刷新。
10. 费用优化:评估真实模型成本
模型调用的成本不能只按 SQL 条数或请求数计算。应汇总实际发出的全部模型调用,包括失败重试和重复调用,再按厂商真实规则分别计算缓存命中输入、缓存未命中输入和输出 Token。
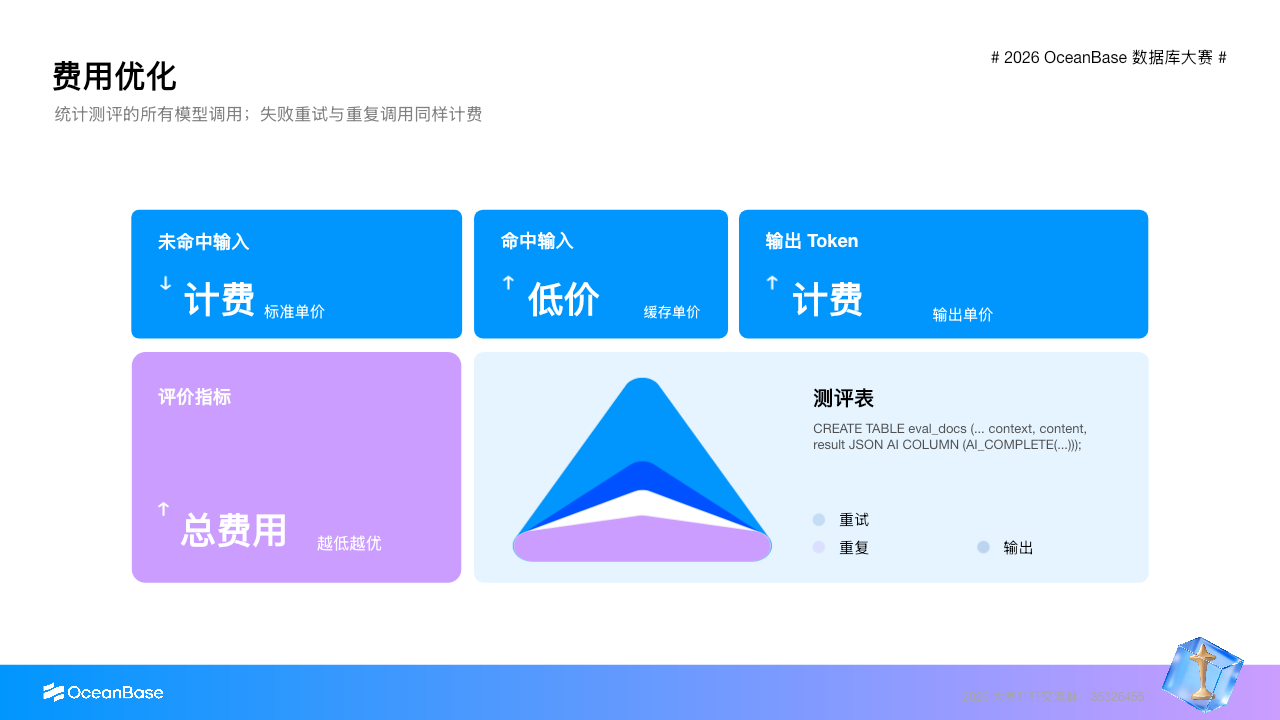
总费用 =
  未命中输入 Token × 未命中输入单价
  + 命中输入 Token × 命中输入单价
  + 输出 Token × 输出单价
这里的缓存是模型厂商提供的 Prompt 前缀缓存,不是数据库保存历史请求结果后直接复用答案。
10.1 参考优化策略
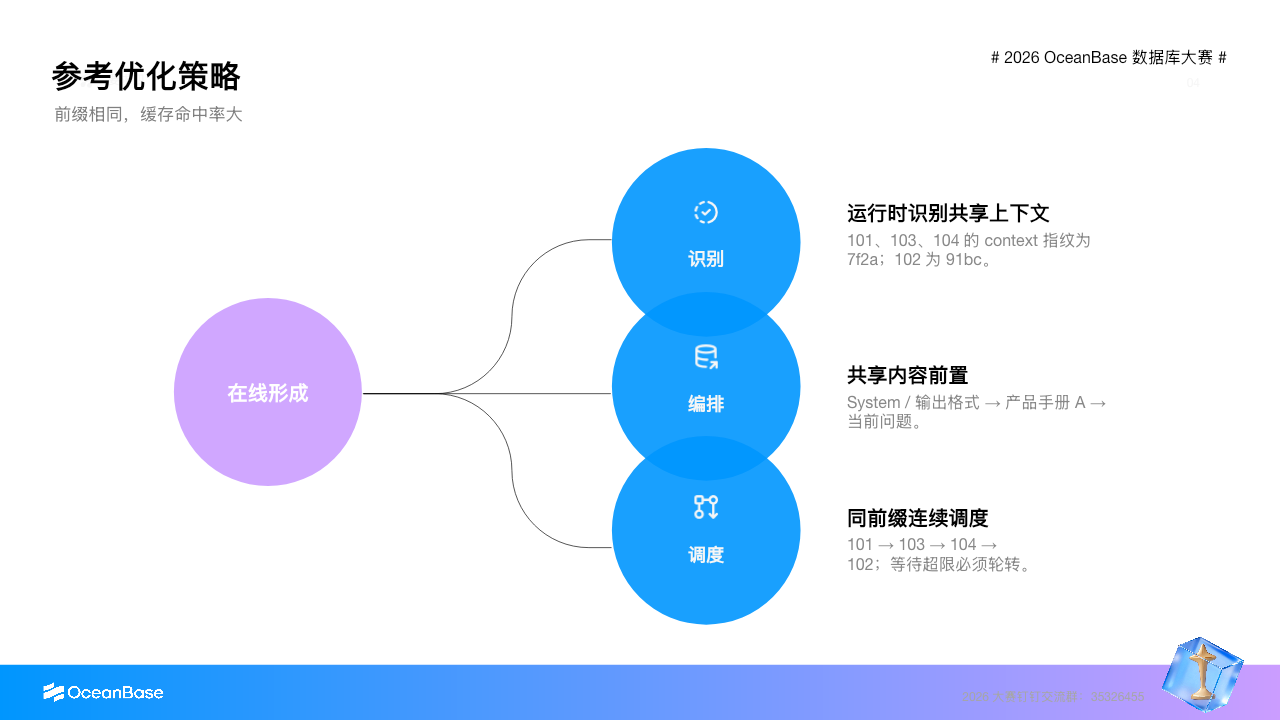
假设运行时出现以下数据:
CREATE TABLE eval_docs (
  id      BIGINT PRIMARY KEY,
  context VARCHAR(4096),
  content VARCHAR(8192),
  result  JSON AI COLUMN (
    AI_COMPLETE(
      'eval_model',
      CONCAT(
        '根据上下文回答,只输出 JSON。\nContext:\n',
        context,
        '\nInput:\n',
        content
      )
    )
  ) WITH (sync_mode='async', max_retries=3)
);

INSERT INTO eval_docs(id, context, content) VALUES
  (101, '产品手册A:电池续航20小时,支持USB-C快充……(约2000 Token)',
        '充满电能使用多久?'),
  (102, '退货政策B:签收后7天内可退货……(约1800 Token)',
        '第5天可以退货吗?'),
  (103, '产品手册A:电池续航20小时,支持USB-C快充……(约2000 Token)',
        '是否支持USB-C充电?'),
  (104, '产品手册A:电池续航20小时,支持USB-C快充……(约2000 Token)',
        '是否支持快速充电?');
可以在线探索三类优化:
- 运行时识别共享上下文:数据到达后计算上下文指纹,识别 101、103、104 具有相同长前缀;
- 共享内容前置、行数据后置:将稳定的 System Prompt、输出格式和共享上下文放在前面,把每行不同的问题放在末尾;
- 同前缀请求连续调度:将到达顺序
101 → 102 → 103 → 104在等待上限内调整为101 → 103 → 104 → 102,同时避免 102 饥饿。
Prompt 可以重新编排,但必须保持任务语义、输出格式和结果正确性。四行数据仍然分别调用模型,不应为了费用而合并成语义不同的一次请求。
11. 一套最小验收流程
完成 AI 列实现或部署后,可以按下面的顺序验证外部行为:
- 注册逻辑模型和端点,确认测试 Key 不会写入仓库;
- 创建包含字符串、JSON 和向量结果的 AI 列;
- 插入多行数据,确认业务事务不等待模型调用;
- 分别在严格和非严格模式下查询未完成结果;
- 修改依赖列,确认旧结果立即失效并重新生成;
- 修改无关列,确认不会产生额外模型调用;
- 测试任意行重试和
RETRY FAILED; - 复现事务回滚、版本乱序、并发更新和结果事务崩溃;
- 分别通过全表扫描、普通索引、全文索引和向量索引查询;
- 汇总厂商返回的 Token 用量与费用,检查重试和调度带来的额外成本。
建议为每项测试同时保存输入 SQL、模型请求日志、预期结果、实际结果、请求次数、Token 数、错误信息和执行时间。
12. 能力边界
当前课程不把以下能力作为使用 AI 列的前提:
- 在用户事务中同步调用模型;
- AI 列依赖另一个 AI 列;
- 跨行或跨表自动推理;
- 模型接口具备“恰好一次”调用语义;
- AI 列作为主键、分区键、外键或唯一约束;
- 数据库保存并直接复用历史模型答案;
- 指定某一种内部任务表、队列或调度器实现。
需要多轮对话、Tool Calling、多模态输入、流式生成或复杂 Agent 编排时,应用层 SDK 仍然更合适。AI 列适合输入属于数据库行、结果需要持久维护,并且后续会被 SQL 查询或索引使用的场景。
13. 清理示例对象
删除模型前,应先删除引用它的 AI 列或业务表,并先删除端点:
DROP TABLE docs;

CALL DBMS_AI_SERVICE.DROP_AI_MODEL_ENDPOINT(
  'doc_complete_endpoint'
);

CALL DBMS_AI_SERVICE.DROP_AI_MODEL(
  'doc_complete_model'
);
如果逻辑模型仍被端点或 AI 列引用,删除操作应被拒绝。
参考资料
本节小结
AI 列将模型输出从应用层的临时结果变成数据库中的可维护数据:
- 使用 SQL 注册模型、声明列并操作业务数据;
- 使用异步生成避免远程延迟阻塞业务事务;
- 使用版本校验、整体发布和行级重试保证结果可信;
- 使用严格读取保护依赖完整结果的查询;
- 使用一致的索引维护让 AI 结果安全参与检索;
- 使用真实 Token 计费而不是单一命中率评价优化效果。
模型负责生成,数据库负责让每一次可见结果都值得信任。