外观
第2章 GPU 体系结构(上):编程模型与 wavefront 执行
本章导读
第 1 章里,我们已经让 GPU 算出了数组加法。先不急着读那些陌生的函数和编号:一次计算究竟由谁发起?只写一份加法规则,为什么会有很多线程?线程又为什么要分组?这一章先用工作单和动画把这些关系连起来,再回到代码,让每个线程找到自己负责的数据。
你只需要知道数组是一排有顺序的数据,以及“把对应位置的两个数相加”是什么意思。读到 2.3 节时,我们才会用到从 0 开始的下标和简单的条件判断;不需要提前掌握 HIP 语法。
本章沿着 2.1 的计算流程 → 2.2 的线程分组 → 2.3 的数据索引 → 2.4 的硬件执行 展开。文中的小数组与分组数量用于手算,先把这些关系弄清,再到后续章节学习线程协作与性能优化。
2.1 GPU 计算的基本流程
我们要做的事很简单:把两排数对应相加,得到一排结果。第一对是 1 和 10,得到 11;第二对是 2 和 20,得到 22。算第二对时,不需要等待第一对的答案,因此可以把这些互不依赖的工作分开。
2.1.1 CPU 与 GPU 的任务分工
先回看第 1 章程序的全程。程序从 CPU 上开始运行:准备输入,把数据放到 GPU 可以访问的位置,然后请 GPU 完成这一批加法。GPU 算完后,CPU 再取回结果,检查答案。
我们写给 GPU 的计算规则放在一个函数里,这个函数叫核函数(Kernel)。CPU 提交这次 GPU 计算的动作,叫启动(Launch)。一次启动可以让许多线程(Thread)执行这个函数;先把每个线程理解成这份规则的一次具体执行,下一小节就把它打开来看。
图 2.1 一次数组加法的程序流程。准备数据、启动计算和取回结果,由 CPU 端程序组织。
图 2.1 中,启动只负责提交工作;CPU 要使用结果,还需要确认 GPU 已经算完。我们在第 1 章见过的“等待计算完成”,就在这个位置。CPU 端常叫主机端(Host),GPU 端常叫设备端(Device),它们就是这里的两方。HIP:主机端与设备端分工
2.1.2 核函数与线程
把 kernel 想成一张共同的工作单,内容是:“找到自己负责的一对数,取出来,相加,把结果写回。”规则只写一份,执行时却可以让许多线程各做一遍。
图 2.2 Kernel 描述共同的操作;线程是它的一次执行。每个线程都完成取数、相加、写回,只是处理的数据不同。
沿着 图 2.2 的任意一列往下看,一个线程会完成整套操作:拿到两个数,算出和,再写回。换一列看,另一个线程也做相同的事,但手里的数可以不同。我们写一份函数,GPU 上有许多线程执行这份函数。 CPU 不需要为每个元素单独调用一次 kernel。
本例安排“一对数交给一个线程”,是因为各对数据可以独立相加。其他程序也可以让一个线程处理多个元素。具体怎样分工,由我们写的程序决定;GPU 不会仅凭看到“加法”就自动替我们分好数组。
线程也不是显卡上专属于它的一颗小处理器。我们可以提交很多线程工作,GPU 再利用有限的硬件资源安排执行。提交了多少份工作,和某一时刻有多少份工作正在执行,是两回事。
到这里,我们已经有了编程模型的起点:程序规定做什么、安排多少份线程工作,以及每份工作处理什么数据。接下来先看这些线程怎样组织起来。
2.2 线程的组织与执行
假设现在有一批线程要执行同一个 kernel。我们从“许多份工作”往外看,先把线程组织成块,再看整个任务;然后打开一个块,观察 GPU 执行时更小的分组。
2.2.1 线程块与网格
HIP 把一组线程称为线程块(Block)。启动 kernel 时,我们指定“每块多少个线程”和“一共多少块”。同一次启动的全部线程块,合在一起叫网格(Grid)。
分块有什么用?一方面,硬件可以把不同块安排到可用的资源上,不必等整个任务的所有线程都能同时执行。另一方面,同一块内的线程可以在需要时交换数据、一起等待某个步骤完成。例如,把一批数合成一个和时,块内线程就可能要协作。当前的数组加法暂时不需要这类配合,第 3 章会继续展开。HIP:线程层级
因此,Block 是组织一组线程工作的单位,Grid 是这次启动的全部工作集合。这个关系与数组形状无关;这里名字里的“块”和“网格”,都在描述线程的组织。
2.2.2 线程块内的 wavefront
先看一个手算配置:2 个 Block,每块 64 个线程。动画默认不显示线程编号,只观察一件事:大框里有哪些小组,小组里有哪些线程。点击播放,跟着蓝框中的同一个线程往里看。
手算示例 · 2 个线程块,每块 64 个线程 · 每组 32 个线程从整次任务,看到一组线程的执行
一次启动,许多份工作外框包含本次启动的全部线程,叫 Grid。里面有两个线程块,各有 64 个线程。每个小方格代表一个线程,蓝框让我们持续跟踪其中一份工作。
分组关系与一条加法指令的示意;展开顺序不表示调度顺序,动画速度不表示 GPU 耗时。
图 2.3 先看全部线程,再放大一个 Block,观察块内执行小组,最后看其中一组共同做加法。蓝框始终指向同一份线程工作。
在 图 2.3 的第三步,一个 Block 的 64 个线程被分成两个 32 线程的小组。这样一组共同执行指令的线程,叫波前(Wavefront,也简称 wave)。本动画采用每组 32 个位置的 wave32 配置,所以一个块里有两个 wavefront。
为什么还要有这一层?GPU 可以让同一 wavefront 中当前参与执行的线程,共同执行一条指令,各自使用自己的数据。看动画最后一步:大家都做加法,有的算 1 加 10,有的算 2 加 20,于是分别得到 11、22。这样,一份指令就能带动一组线程做同一种运算。这里单独示意加法,完整工作还包括前面的取数和后面的写回。
分块和组成 wavefront 也有不同的作用:Block 规定哪些线程归在一起、可以协作;wavefront 则把块内线程组织成共同执行指令的小组。 一个 Block 里的多个 wavefront 不必同时开始或结束。
我们启动 kernel 时指定块数和每块线程数;GPU 按这个 kernel 采用的 wave 大小组织执行,不需要再单独指定“启动几个 wavefront”。不同 Block 的线程不会拼成同一个 wavefront。
2.2.3 线程组织的层级关系
可以借用“营 → 连 → 排 → 单兵”记住这些名字:
| 类比 | GPU 中的名字 | 本例中的关系 |
|---|---|---|
| 营 | Grid,本次启动的全部线程块 | 包含 2 个 Block |
| 连 | Block,一组线程 | 含 64 个线程,组成 2 个 wavefront |
| 排 | Wavefront,共同执行指令的小组 | 本例每组有 32 个线程 |
| 单兵 | Thread,kernel 的一次执行 | 处理分配给自己的数据 |
这份类比只借用包含关系:Grid 包含 Block,Block 内的线程组成 wavefront,wavefront 由线程组成。 Kernel 是这些线程执行的共同程序,不是包含关系中再加的一层。
观察 wavefront 时,每个线程在组内占据一个位置,这个位置叫通道(Lane)。类比中的单兵对应 Thread,他在排内的位置对应 lane。先记住位置的含义,具体怎么编号,等下一节认识线程编号后再看。
这里的 32 是演示采用的 wave 大小。gfx1201 支持 wave32 和 wave64,具体要看 kernel 采用哪一种,不能把 32 当作所有 AMD GPU 程序的固定值。ROCm GPU specifications
先停一下:同一个 kernel 启动出许多线程,它们是各执行工作单的一步,还是各执行一遍工作单?一个 Block 有多个 wavefront,是否说明多出了新线程?
用自己的话说完,再看答案
每个线程都执行一遍 kernel,根据自己的数据和条件完成相应操作;当前数组加法里,每个有效线程都要取数、相加、写回。wavefront 是原有线程的执行分组,没有增加线程。
2.3 线程编号与数据索引
前面已经知道:一次启动带来许多线程,每个线程执行同一份 kernel。现在还有一个问题没有落实:大家怎样读到不同的数据?
如果每个线程都读取同一对数、写入同一个位置,增加线程也没有把任务分开。我们需要让每个线程知道“我是谁”,再按一条共同的规则,算出“我负责哪里”。线程编号提供身份,索引代码安排数据分工。
2.3.1 线程块与块内线程的编号
为了在一页里看清所有位置,接下来换成一个更小的手算配置:3 个 Block,每块 4 个线程。本节只用它练习编号和数组分工。
图 2.4 每组都有 0 号线程;识别一个线程,需要同时知道组号和组内编号。
在 图 2.4 中,三个组里都有一个 0 号,所以只说“0 号线程”还不够。说成“第 1 组里的 0 号线程”,才能指出具体是哪一个。
这里的一组就是前面认识的 Block。启动时,CPU 端代码指定多少块、每块多少线程;HIP 让每个线程读取自己的块号和块内编号,不需要我们逐个给线程填写编号。
到这一步,线程知道了自己属于哪一块、在块内编号多少。接下来还需要一条规则,告诉它访问哪个数组位置。
2.3.2 数组下标的计算
本例选择一种简单的分工:每块负责连续的 4 个数组位置,块内的 0~3 号线程分别处理这四个位置。 第 0 块负责下标 0~3,第 1 块负责下标 4~7,后面的块依次接上。我们先跟着第 1 块里的 2 号线程,看它怎样找到自己的位置。
图 2.5 按本例的分工,第 1 块从数组下标 4 开始;块内的 2 号线程再偏移两个位置,得到下标 6。
沿着 图 2.5 的蓝色箭头看:第 1 块负责的这一段从下标 4 开始,块内的 2 号线程再偏移两个位置,因此负责下标 4 + 2 = 6。这里的起点 4,又可以写成“块号 1 × 每块 4 个线程”。
把同一条分工规则写给所有线程,就是:
本例的数组下标 = 块号 × 每块线程数 + 块内线程编号。
HIP 为刚才用到的三个量提供了对应的名字:
| 代码里的名字 | 含义 | 选中线程读到的值 |
|---|---|---|
blockIdx.x | 我属于第几块 | 1 |
blockDim.x | 每块有多少个线程 | 4 |
threadIdx.x | 我在本块里是第几个线程 | 2 |
现在才把这条分工规则写成代码。它位于 kernel 内部,每个线程都会用自己的编号执行一次:
cpp
int idx = blockIdx.x * blockDim.x + threadIdx.x;选中的线程算出 1 × 4 + 2 = 6。idx 是我们用代码计算出来的数组下标;后面用它访问 a[idx]、b[idx] 和 c[idx],才确定这个线程实际读写哪里。名字后面的 .x 表示取 x 这一维,本章只处理一维数组。
块内的 0 号线程能不能处理下标 6?按本例的公式和每块 4 个线程的配置,各块的 0 号分别算出 0、4、8,因此下标 6 由第 1 块的 2 号线程处理。其他程序可以另外编写索引规则,让 0 号线程处理下标 6,但需要保证分工没有遗漏、重复写入或越界。
这些编号也不表示执行先后。第 1 块不需要等第 0 块算完,才能计算自己的下标;GPU 的调度先后不会改变这条公式的结果。
2.3.3 数组边界检查
现在把数组长度设为 10,有效下标是 0~9。每块仍安排 4 个线程,两个块只能覆盖 8 个位置,因此需要第三块。一共启动 12 个线程,多出来的两个该怎么办?我们只看最后一块。
图 2.6 数组在下标 9 处结束;算出 10、11 的两个线程仍然存在,但不能用这些下标读写数组。
在 图 2.6 中,块内的 0、1 号线程算出下标 8、9,正好处理最后两个元素。块内的 2、3 号线程算出 10、11,已经超出数组范围。我们用 if (idx < n) 检查下标:只有条件成立时,才执行数组读写。
把“算下标、查边界、做加法”连起来,就回到了第 1 章的 Vector Add 源码;第 4 章也会继续使用它:
cpp
__global__ void vector_add(const float* a, const float* b, float* c, int n) {
  int idx = blockIdx.x * blockDim.x + threadIdx.x;
  if (idx < n) {
    c[idx] = a[idx] + b[idx];
  }
}
__global__ 标记这是由 CPU 发起、在 GPU 上运行的 kernel;a、b、c 指向 GPU 上的数组,n 是要处理的元素个数。读函数体时,始终站在一个线程的角度:我先算出自己负责的位置,检查没有越界,再读取两个数,把和写回。其他线程执行的是同一个函数,只是代入的编号和读取的数据不同。
因此,“启动了几个线程”和“数组有几个元素”可以不同。我们需要保证有效位置都有人处理,同时让多余的线程安全地跳过数组读写。
先试着判断:手算配置仍为每块 4 个线程。block 2 中组内编号为 1 的线程负责哪里?组内编号为 3 的线程能执行加法吗?
展开看答案
前者的下标是 2 × 4 + 1 = 9,小于数组长度 10,可以执行加法。后者的下标是 2 × 4 + 3 = 11,已经越界,必须跳过。
2.3.4 线程编号与 lane 编号
现在可以回到 图 2.3,打开“查看线程编号和 lane”。动画仍采用每块 64 个线程、wave32 的配置:块内线程 0~31 属于第一个 wavefront,32~63 属于第二个;各小组里的位置编号都从 0 开始。
选中块内线程 35:第二个小组从线程 32 开始,所以它的组内位置是 35 − 32 = 3,也就是 lane 3。线程 35 和 lane 3 描述的是同一份工作,以及它在小组里的位置。 这两个编号都不直接指定数组地址,数据位置仍由 kernel 中的索引规则计算。
继续核对:31、32、35、63 分别位于哪里
| 块内线程号 | 块内 wavefront 编号 | wavefront 内的 lane 编号 |
|---|---|---|
| 31 | 0 | 31 |
| 32 | 1 | 0 |
| 35 | 1 | 3 |
| 63 | 1 | 31 |
拖动动画里的线程号从 31 到 32,就能看到 lane 从 31 重新回到 0。在这个一维 wave32 示例中,块内线程号除以 32,整数商是 wavefront 编号,余数是 lane 编号。切换到另一个 Block 后,相同的局部编号代表另一份线程工作。
编号练习:每块 256 个线程、采用 wave32
如果一个 kernel 每块安排 256 个线程、采用 wave32,一个 Block 就包含 256 ÷ 32 = 8 个 wavefront:
| wavefront 在块内的编号 | 包含的块内线程号 | wavefront 内的 lane 编号 |
|---|---|---|
| 0 | 0~31 | 0~31 |
| 1 | 32~63 | 0~31 |
| … | … | … |
| 7 | 224~255 | 0~31 |
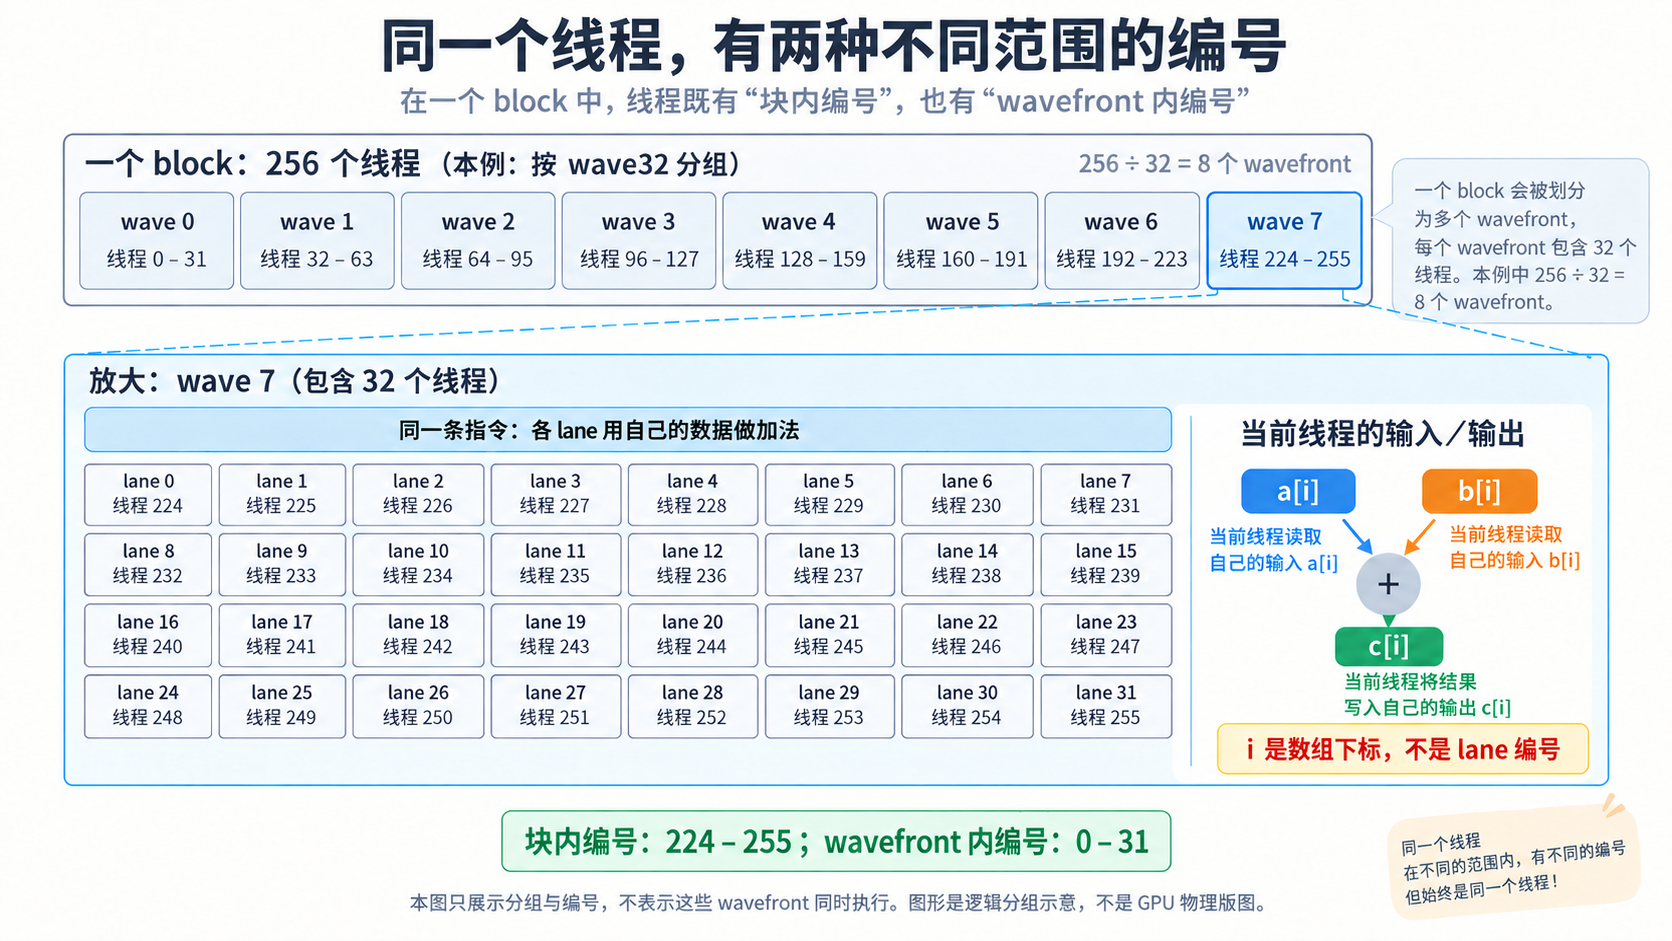
图 2.7 每块 256 个线程、采用 wave32 时,块内线程 224~255 位于 wavefront 7,对应 lane 0~31。
例如,图 2.7 中的块内线程 224,对应 lane 0;不能把它叫作 lane 224。回看本节每块只有 4 个线程的手算配置,它在 wave32 下只占用一个 wavefront 中的 4 个位置,不会把 wavefront 大小改成 4,也不会跨 Block 补满。
2.4 线程分组与硬件执行单元
这一节把已经理解的工作分组,放到真实硬件上看。
前面沿着 Grid → Block → Wavefront → Thread 看清了工作怎样组织,以及每个线程怎样找到自己负责的数据。接下来要看承接这些工作的硬件。这里先把分组与设备分开:一个 Block 或 wavefront 是一组线程工作,并不表示显卡上为它单独准备了一块同名硬件。
在 AMD RDNA 的语境里,先区分下面几个名字:
| 名字 | 本章先掌握的含义 |
|---|---|
| 单指令多数据执行单元(Single Instruction, Multiple Data,SIMD) | 用一条向量指令处理一组 lane 的数据;这里的“多数据”对应各 lane 不同的输入 |
| 计算单元(Compute Unit,CU) | 包含执行单元及相关资源的一层硬件组织 |
| 工作组处理器(Workgroup Processor,WGP) | RDNA 中包含 CU 的更外层组织,也与同一工作组的放置范围有关 |
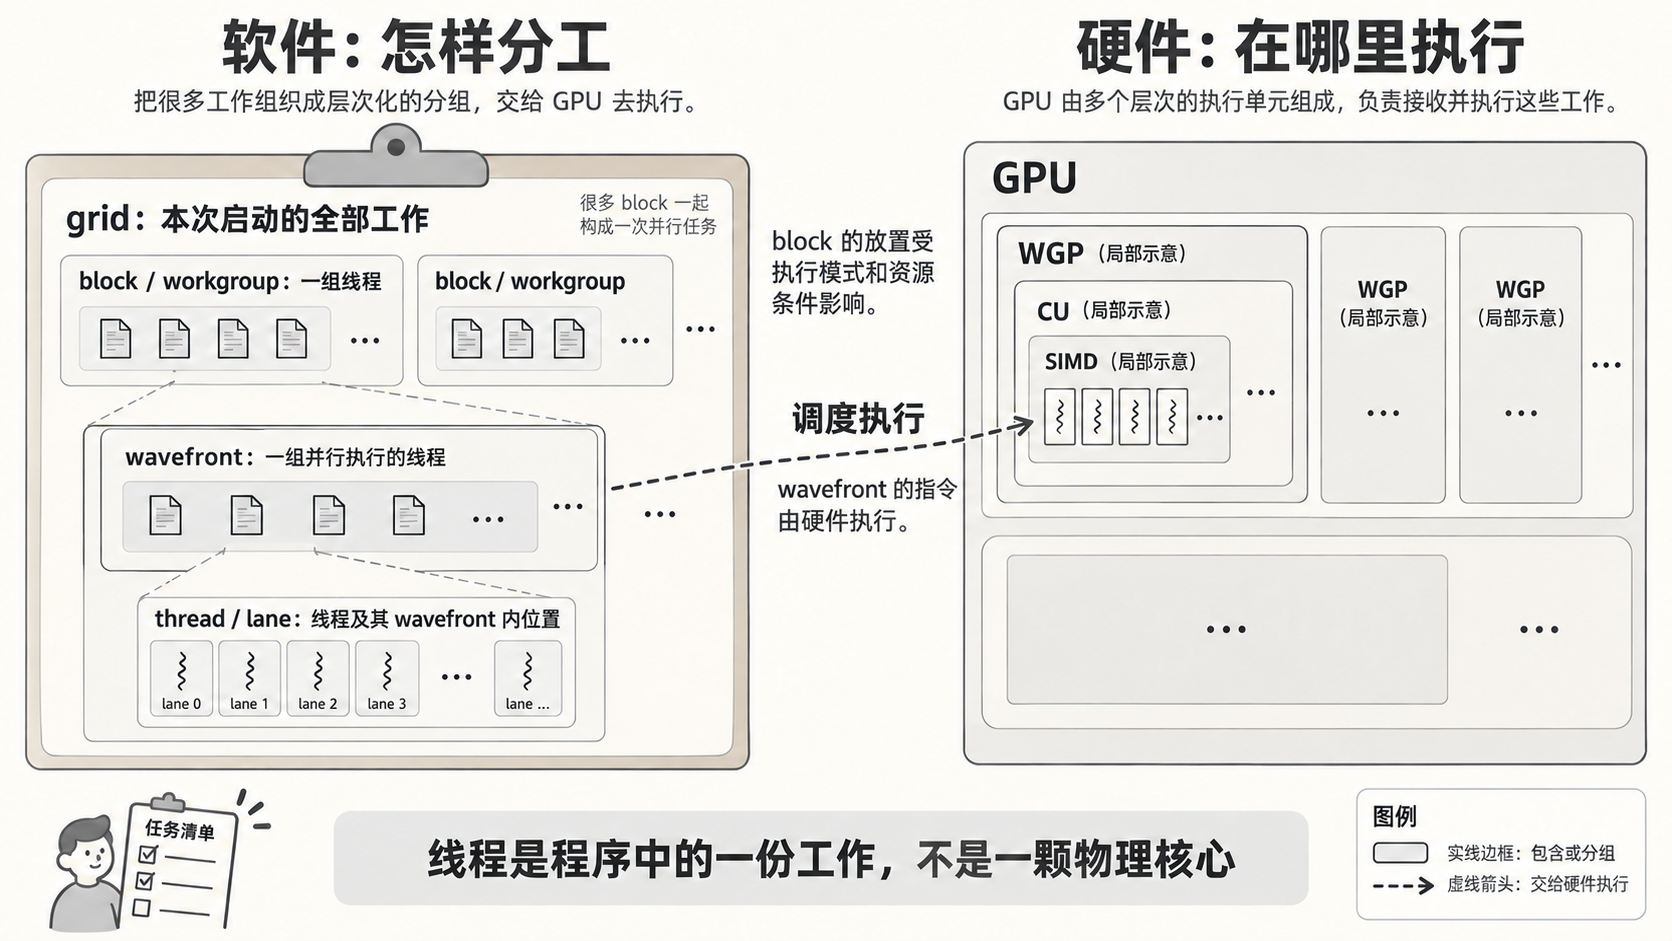
图 2.8 工作分组与硬件单元的关系示意。图没有规定单元数量或某次运行的调度顺序,也不表示一个 block 独占一个硬件单元。
如 图 2.8 所示,软件上的一组工作需要落到硬件资源上执行。LLVM 的 AMDGPU 文档对工作组给出了放置约束:同一工作组的 wavefront 在同一 WGP 中执行;更细的执行范围还与 CU/WGP 模式有关。LLVM AMDGPU 执行模型
初学时,最有用的认识是:逻辑上有多少线程,与物理上此刻能执行多少工作,是两个问题。 把 block 调大,并不会凭空增加计算设备。第 3 章将进一步解释,为什么寄存器、共享存储和数据等待也会影响可执行的工作。
进阶:CU/WGP 模式与设备字段
在 LLVM 描述的 CU 模式下,一个工作组的 wavefront 在同一 CU 的 SIMD 上执行;WGP 模式允许使用同一 WGP 中不同 CU 的 SIMD。具体模式要看目标与编译产物,不能仅从 block 大小反推。
RX 9070 XT 的 AMD 产品规格列出 64 个物理 CU;本章既有环境记录中,HIP 的 hipDeviceProp_t::multiProcessorCount 读到的是 32。后者保留字段名解读,不改称“物理 CU 数”。两种信息的统计口径不同,查硬件时应同时看字段含义和目标平台。AMD RX 9070 XT 产品规格
已有 CUDA 基础:名称对照
| HIP / CUDA 常见名称 | 本章 AMD 语境中的称呼 |
|---|---|
| thread | 线程;底层也称 work-item |
| block / thread block | 工作组 workgroup |
| warp | wavefront;大小按当前目标与 kernel 确认 |
| grid | 一次启动中的全部线程块 |
shared memory / __shared__ | 工作组共享的 LDS,第 3 章展开 |
名称能对应,不代表两个厂商的硬件数量、wavefront 大小或性能结果相同。
本章小结
- CPU 端程序准备数据、启动 kernel,并在使用结果前确认 GPU 已经完成计算。
- Kernel 是共同的计算规则,Thread 是这份规则的一次执行。本例让每个有效线程处理一对数,每个线程都完成取数、相加和写回。
- 启动时指定块数和每块线程数,全部块组成 Grid;块内线程按 wave 大小组成执行小组。Lane 表示线程在 wavefront 内的位置。
- 理解分工后,编号才派上用场:HIP 提供线程身份,kernel 中的索引规则决定数据位置,边界检查保证读写有效。
- Block 和 wavefront 是线程的分组,CU、WGP 和 SIMD 是承接这些工作的硬件。提交的线程总数不等于某一时刻正在执行的线程数。
下一章继续跟着数组加法,看看数据存在哪里,以及 GPU 怎样减少等数据的时间。到第 9 章的归约例子,我们会进一步观察同一 wavefront 中只有部分线程需要计算时,执行过程会发生什么。
自我检验
先不展开答案,试着完成下面三个任务:
- CPU 启动一次数组加法 kernel,里面有许多线程。Kernel 和 Thread 分别指什么?每个线程都要取数、相加、写回吗?
- 用“营 → 连 → 排 → 单兵”说出 Grid、Block、Wavefront、Thread 的包含关系。Lane 表示什么?哪些分组数量由启动代码指定?
- 按本例连续分工、每块 4 个线程处理 10 个元素,第 1 块的线程 3 负责哪里?第 2 块的线程 3 为什么要跳过?
参考答案
- Kernel 是共同执行的函数,Thread 是该函数的一次执行。本例每个有效线程都要取出自己负责的一对数,相加并写回;越界的线程通过条件判断跳过数组读写。
- Grid 包含本次启动的所有 Block;每个 Block 内的线程组成 wavefront,wavefront 由线程组成。Lane 表示线程在 wavefront 内的位置。启动代码指定块数和每块线程数,GPU 按 kernel 采用的 wave 大小组织执行小组。
- 第 1 块的线程 3 计算
1 × 4 + 3 = 7,读取a[7]和b[7],写入c[7]。第 2 块的线程 3 算出下标 11,超出了有效范围 0~9,不能读写。
延伸阅读
- HIP 编程模型:回看主机端与设备端的分工,再查线程层级与执行方式。
- LLVM AMDGPU Usage Guide:进阶查阅工作组、wavefront 与硬件执行单元的对应关系;第一次阅读不必通读整份手册。
- ROCm GPU specifications:核对具体目标支持的 wavefront 大小。
- 第 3 章:数据存储与访问:继续追踪线程计算时使用的数据。