serial:一个线程处理一行
每加完一项,再处理下一项。
- 初值0
- 加入 99
- 加入 1625
- 加入 934
- 加入 1650
给一行数据乘上同一个系数,是第 8 章的逐元素计算。如果这个系数必须先从整行数据算出来,就多了一层依赖:先归约,再把结果用于每一个位置。
RMSNorm 把这两件事连在一起。本章用它综合前面的方法:先确定数据依赖和正确答案,再建立性能基线,提出一个能用实验回答的问题。HIP 比较同一行分给多少个线程;Triton 先比较 warps,再针对短行检查一个 program 能否处理多行。
| 路线 | 本章要回答的问题 |
|---|---|
| 共同语义 | 一行的统计量怎样影响每个输出,权重在哪里参与计算? |
| HIP | block=256 建立协作基线后,64 或 128 个线程是否更合适? |
| Triton | 4/8 warps 怎样比较;短行时,把 2/4 行交给同一个 program 是否值得? |
代码位于 code/part2-kernels/chapter13/。本章环境为 Radeon RX 9070 XT(gfx1201)+ ROCm SDK 10.0 + 原生 Ubuntu 24.04,主形状为 4096×1024。短行实验采用 4096×128,单独建立同形状基线。
先看一行 x=[3,4]、权重 w=[1,1]。平方和为 25,除以列数 2 得到 12.5,再加上一个小正数 epsilon=1e-5。平方根的倒数约为 0.2828,两个输入都乘这个系数,输出约为 [0.8485,1.1314]。
这就是 RMSNorm 的主要计算。RMS 是 root mean square,即“均方根”;我们把均方根的倒数记为
图 13.1 将例子扩成四列,权重也不再全为 1。先看平方和怎样确定整行尺度,再停在“输出”核对每列自己的权重。
先保留输入和列权重输入 x=[3,4,−3,−4],权重 w=[1,0.5,2,1]。权重稍后才参与输出,不参与平方和。
算法过程示意 · 数字定位到该步完成状态,可拖动进度或播放;动画速度不代表 GPU 耗时。
图 13.1 输入 [3,4,−3,−4],权重 [1,0.5,2,1],epsilon=1e−5。动画展示公式数值,播放速度不代表 GPU 时间。
平方和为 9+16+9+16=50,平方均值仍为 12.5。输出约为 [0.8485,0.5657,−1.6971,−1.1314]。第三列(下标2)的权重为2,放大了该列输出,但没有改变行统计量
推广到多行时,每行独立求 cols 的权重向量。输入与输出是 [rows,cols],权重是 [cols],不能把权重也按二维矩阵寻址。
把公式沿数据依赖展开,可以找到四种已经学过的操作:
| 阶段 | 依赖什么 | 本篇对应的方法 |
|---|---|---|
| 平方 | 当前输入 | 逐元素计算 |
| 平方和 | 当前行的全部列 | 局部累加与归约 |
| 行尺度 | 平方和、有效列数和 epsilon | 标量计算 |
| 输出 | 当前输入、行尺度、对应权重 | 广播后的逐元素计算 |
平方和算出来以后,同一行的所有输出才能使用最终的
本章的 HIP serial、HIP block 和 Triton 版本都已经融合为一个 kernel。 serial 用于把公式翻译成程序,block 和 Triton 用于建立各自的性能基线。后面比较的是分工与执行配置,不能把它们之间的时间差解释成“多个 kernel 融合为一个”的收益。
融合也不表示输入只读一次。HIP 先读取 x 求平方和,输出时再读取 x;Triton 在源码中保留 values 供输出使用。实际流量与寄存器使用仍要看编译和采集结果。
两条路线使用相同的确定性输入和权重。普通输入含有正负值,权重也有正有负;同一 seed 在 HIP 和 Python 中产生相同数组。
| 项目 | 本章约定 |
|---|---|
| 数据类型 | 输入、权重和输出均为 FP32 |
| 正确性参考 | CPU FP64 完成平方和、尺度和乘权重,最后转为 FP32 |
| 验收条件 | 全部输出有限,且逐元素满足 abs(actual-ref) <= 2e-5 + 2e-5 * abs(ref) |
| epsilon | 默认 1e-5,实际 FP32 值是 9.999999747378752e-06;两条路线按这个值计算参考 |
| 主 seed | 20260920 |
| HIP 性能基线 | 一 block 一行,block=256 |
| Triton 性能基线 | 一 program 一行,B=next_power_of_2(cols),4 warps |
| 计时范围 | X、weight 已在 GPU 上,到完整 Y 写回 GPU;不含分配、主机拷贝、参考计算或校验 |
输出在预检前填为 NaN,确认 kernel 写出全部结果;预检通过才计时,最后再次检查完整输出。NaN、无穷值会先被拒绝,不会因为最大误差更新方式而漏过。参考结果来自 CPU,不是另一条 GPU 性能路线。
两条路线预先创建 event。每个样本按“起点 event → 一次 kernel → 终点 event”计时,等待该终点完成后再开始下一轮。Profiler 单独运行,不把采集时的耗时纳入主图。
每配置运行三个独立进程,每进程预热10次、采样50次,配置顺序轮换。主形状六项、短行三项、两组附形状各五项,共 19个配置/形状组合、57个进程、2850个样本。主输入和短行候选随后分别独立确认,合计21个进程、1050个样本。
每个进程先取自己的中位数,再汇总这些进程中位数;图中范围线表示它们的最小值和最大值,不是置信区间。不同 shape 的图分别建立基线,不跨图比较柱子的长度。
环境与结果目录。 以下命令在 GPU 机器的仓库根目录开始执行,后续保持在 code/part2-kernels/。沿用本篇 uv.lock,不要删除锁文件:
cd code/part2-kernels &&
uv sync --locked &&
source ./activate-rocm.sh
为本章新建一个独立结果目录,保存打印出来的路径:
mkdir -p chapter13/results &&
RUN=$(mktemp -d chapter13/results/walkthrough-XXXXXX) &&
mkdir "$RUN/build" &&
printf '本轮结果目录:%s\n' "$RUN"
换终端后,重新执行环境准备,再恢复之前打印的目录;提示处只粘贴路径,不含 RUN=:
read -r -p '粘贴上次输出的结果目录:' RUN &&
test -n "$RUN" && test -d "$RUN/build" &&
printf '继续使用结果目录:%s\n' "$RUN"
需要重测或改动源码时,新建 RUN,重新编译 HIP;恢复旧目录只用于继续未修改的实验。后续命令会拒绝写入已有样本。
每条命令先校验,再完成一个进程的 10 次预热与 50 次计时;折叠输出对应第 1 个进程。图使用三个独立进程的统计,不是一次终端输出。 手工复测时同时把样本名 p1 与 --process 1 改为 p2/2、p3/3,每遍覆盖同组候选并轮换起始项。章末批量入口会自动完成这一步、汇总并画本轮图,不要求先运行 profiler。
若保护命令发现同名样本已存在,这一次不会运行或覆盖它;需要重测时新建结果目录。先看正确性和完整时间,只有当结果留下具体疑问时再采集 trace。
// Chapter 13: row-wise FP32 RMSNorm, serial bridge and block LDS reduction.
#include <hip/hip_runtime.h>

#include <algorithm>
#include <cmath>
#include <cstddef>
#include <cstdint>
#include <cstdlib>
#include <fstream>
#include <iomanip>
#include <iostream>
#include <limits>
#include <sstream>
#include <string>
#include <utility>
#include <vector>

#define HIP_CHECK(call)                                                        \
    do {                                                                      \
        const hipError_t error = (call);                                       \
        if (error != hipSuccess) {                                             \
            std::cerr << "HIP error: " << hipGetErrorString(error) << '\n';    \
            std::exit(1);                                                     \
        }                                                                     \
    } while (0)

constexpr double kAtol = 2.0e-5;
constexpr double kRtol = 2.0e-5;

__global__ void rmsnorm_serial_kernel(const float* input, const float* weight,
                                      float* output, int rows, int cols,
                                      float epsilon) {
    const std::size_t row =
        static_cast<std::size_t>(blockIdx.x) * blockDim.x + threadIdx.x;
    if (row >= static_cast<std::size_t>(rows)) return;
    const std::size_t base = row * cols;
    float square_sum = 0.0f;
    for (int col = 0; col < cols; ++col) {
        const float value = input[base + col];
        square_sum += value * value;
    }
    const float inverse_rms = rsqrtf(square_sum / cols + epsilon);
    for (int col = 0; col < cols; ++col)
        output[base + col] = input[base + col] * inverse_rms * weight[col];
}

__global__ void rmsnorm_block_kernel(const float* input, const float* weight,
                                     float* output, int rows, int cols,
                                     float epsilon) {
    extern __shared__ float shared[];
    const std::size_t row = blockIdx.x;
    if (row >= static_cast<std::size_t>(rows)) return;
    const std::size_t base = row * cols;
    const int tid = threadIdx.x;
    float square_sum = 0.0f;
    for (int col = tid; col < cols; col += blockDim.x) {
        const float value = input[base + col];
        square_sum += value * value;
    }
    shared[tid] = square_sum;
    __syncthreads();
    for (int stride = blockDim.x / 2; stride > 0; stride >>= 1) {
        if (tid < stride) shared[tid] += shared[tid + stride];
        __syncthreads();
    }
    const float inverse_rms = rsqrtf(shared[0] / cols + epsilon);
    for (int col = tid; col < cols; col += blockDim.x)
        output[base + col] = input[base + col] * inverse_rms * weight[col];
}

struct Options {
    std::string version = "all";
    int rows = 1024;
    int cols = 4096;
    int block = 256;
    int warmup = 5;
    int repeat = 20;
    std::uint64_t seed = 20260920;
    float epsilon = 1e-5f;
    std::string input_mode = "normal";
    std::string samples;
    std::string config_id;
    int process_id = 1;
};

struct Validation {
    bool correct;
    double max_absolute_error;
    double max_relative_error;
};

struct Timing {
    double minimum_ms;
    double median_ms;
    double mean_ms;
    std::vector<double> samples;
};

[[noreturn]] void usage_error(const std::string& message) {
    std::cerr << message << '\n'
              << "Usage: rmsnorm_hip --version all|serial|block [--rows N] [--cols N] "
              << "[--block N] [--epsilon F] [--input normal|zero|zero-weight|signed-weight] "
              << "[--seed N] [--warmup N] [--repeat N] [--samples CSV] "
              << "[--config-id ID] [--process-id N]\n";
    std::exit(2);
}

std::uint64_t unsigned_value(const std::string& value) {
    if (value.empty() || value.find_first_not_of("0123456789") != std::string::npos)
        usage_error("expected a non-negative integer: " + value);
    return std::stoull(value);
}

int int_value(const std::string& value) {
    const auto parsed = unsigned_value(value);
    if (parsed > static_cast<std::uint64_t>(std::numeric_limits<int>::max()))
        usage_error("integer is too large: " + value);
    return static_cast<int>(parsed);
}

Options parse_options(int argc, char** argv) {
    Options options;
    for (int index = 1; index < argc; ++index) {
        const std::string name = argv[index];
        if (index + 1 >= argc) usage_error("missing value for " + name);
        const std::string value = argv[++index];
        try {
            if (name == "--version") options.version = value;
            else if (name == "--rows") options.rows = int_value(value);
            else if (name == "--cols") options.cols = int_value(value);
            else if (name == "--block") options.block = int_value(value);
            else if (name == "--warmup") options.warmup = int_value(value);
            else if (name == "--repeat") options.repeat = int_value(value);
            else if (name == "--seed") options.seed = unsigned_value(value);
            else if (name == "--epsilon") {
                std::size_t end = 0;
                options.epsilon = std::stof(value, &end);
                if (end != value.size()) usage_error("invalid epsilon");
            } else if (name == "--input") options.input_mode = value;
            else if (name == "--samples") options.samples = value;
            else if (name == "--config-id") options.config_id = value;
            else if (name == "--process-id" || name == "--process")
                options.process_id = int_value(value);
            else usage_error("unknown option: " + name);
        } catch (const std::exception&) {
            usage_error("invalid value for " + name);
        }
    }
    const bool valid_version = options.version == "all" ||
        options.version == "serial" || options.version == "block";
    const bool power_of_two = options.block > 0 &&
        (options.block & (options.block - 1)) == 0;
    const bool valid_input = options.input_mode == "normal" ||
        options.input_mode == "zero" || options.input_mode == "zero-weight" ||
        options.input_mode == "signed-weight";
    if (!valid_version || !valid_input || options.rows <= 0 || options.cols <= 0 ||
        options.cols > 65536 || !power_of_two || options.block > 1024 ||
        options.repeat <= 0 || options.process_id <= 0 ||
        !std::isfinite(options.epsilon) || options.epsilon <= 0.0f)
        usage_error("invalid shape, configuration, input, epsilon, or repeat");
    if (!options.samples.empty() && options.version == "all")
        usage_error("--samples requires a single --version");
    if (options.config_id.find_first_not_of(
            "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789-_.") != std::string::npos)
        usage_error("config-id must contain only letters, digits, '-', '_' or '.'");
    const std::size_t rows = options.rows;
    if (rows > std::numeric_limits<std::size_t>::max() / options.cols / sizeof(float))
        usage_error("matrix byte size overflows size_t");
    return options;
}

void make_inputs(std::vector<float>& input, std::vector<float>& weight,
                 const Options& options) {
    for (std::size_t index = 0; index < input.size(); ++index) {
        const long long value = static_cast<long long>(
            (17ULL * (index % 257ULL) + options.seed % 257ULL) % 257ULL) - 128;
        input[index] = options.input_mode == "zero" ? 0.0f : value / 128.0f;
    }
    for (std::size_t col = 0; col < weight.size(); ++col) {
        const long long value = static_cast<long long>(
            (29ULL * (col % 251ULL) + 3ULL * (options.seed % 251ULL)) % 251ULL) - 125;
        weight[col] = value / 128.0f;
        if (options.input_mode == "zero-weight") weight[col] = 0.0f;
        if (options.input_mode == "signed-weight")
            weight[col] = (col % 2 == 0 ? -1.0f : 1.0f) *
                          (0.5f + static_cast<float>(col % 9) / 16.0f);
    }
}

std::vector<float> reference_rmsnorm(const std::vector<float>& input,
                                     const std::vector<float>& weight,
                                     int rows, int cols, float epsilon) {
    std::vector<float> output(input.size());
    for (int row = 0; row < rows; ++row) {
        const std::size_t base = static_cast<std::size_t>(row) * cols;
        double square_sum = 0.0;
        for (int col = 0; col < cols; ++col) {
            const double value = input[base + col];
            square_sum += value * value;
        }
        const double inverse_rms =
            1.0 / std::sqrt(square_sum / cols + static_cast<double>(epsilon));
        for (int col = 0; col < cols; ++col)
            output[base + col] = static_cast<float>(
                static_cast<double>(input[base + col]) * inverse_rms *
                static_cast<double>(weight[col]));
    }
    return output;
}

Validation validate(const std::vector<float>& actual,
                    const std::vector<float>& reference) {
    bool correct = true;
    double max_absolute = 0.0, max_relative = 0.0;
    for (std::size_t index = 0; index < reference.size(); ++index) {
        const double value = actual[index], expected = reference[index];
        if (!std::isfinite(value) || !std::isfinite(expected)) {
            correct = false;
            max_absolute = max_relative = std::numeric_limits<double>::infinity();
            continue;
        }
        const double error = std::abs(value - expected);
        if (error > kAtol + kRtol * std::abs(expected)) correct = false;
        max_absolute = std::max(max_absolute, error);
        max_relative = std::max(max_relative, error / std::max(std::abs(expected), 1e-6));
    }
    return {correct, max_absolute, max_relative};
}

unsigned int grid_size(const std::string& version, const Options& options) {
    return version == "serial"
        ? options.rows / options.block + (options.rows % options.block != 0)
        : options.rows;
}

void launch(const std::string& version, const Options& options,
            const float* input, const float* weight, float* output) {
    if (version == "serial")
        hipLaunchKernelGGL(rmsnorm_serial_kernel, dim3(grid_size(version, options)),
                          dim3(options.block), 0, 0, input, weight, output,
                          options.rows, options.cols, options.epsilon);
    else
        hipLaunchKernelGGL(rmsnorm_block_kernel, dim3(options.rows),
                          dim3(options.block), options.block * sizeof(float), 0,
                          input, weight, output, options.rows, options.cols, options.epsilon);
    HIP_CHECK(hipGetLastError());
}

Timing benchmark(const std::string& version, const Options& options,
                 const float* input, const float* weight, float* output) {
    for (int i = 0; i < options.warmup; ++i) launch(version, options, input, weight, output);
    HIP_CHECK(hipDeviceSynchronize());
    std::vector<hipEvent_t> starts(options.repeat), stops(options.repeat);
    for (int i = 0; i < options.repeat; ++i) {
        HIP_CHECK(hipEventCreate(&starts[i]));
        HIP_CHECK(hipEventCreate(&stops[i]));
    }
    std::vector<double> samples(options.repeat);
    for (int i = 0; i < options.repeat; ++i) {
        HIP_CHECK(hipEventRecord(starts[i]));
        launch(version, options, input, weight, output);
        HIP_CHECK(hipEventRecord(stops[i]));
        HIP_CHECK(hipEventSynchronize(stops[i]));
        float elapsed = 0.0f;
        HIP_CHECK(hipEventElapsedTime(&elapsed, starts[i], stops[i]));
        samples[i] = elapsed;
    }
    for (int i = 0; i < options.repeat; ++i) {
        HIP_CHECK(hipEventDestroy(starts[i]));
        HIP_CHECK(hipEventDestroy(stops[i]));
    }
    auto sorted = samples;
    std::sort(sorted.begin(), sorted.end());
    double sum = 0.0;
    for (const double sample : samples) sum += sample;
    const auto mid = sorted.size() / 2;
    const double median = sorted.size() % 2
        ? sorted[mid] : (sorted[mid - 1] + sorted[mid]) / 2.0;
    return {sorted.front(), median, sum / samples.size(), samples};
}

template <typename T> std::string number(T value) {
    std::ostringstream stream;
    stream << std::setprecision(17) << value;
    return stream.str();
}

using Record = std::vector<std::pair<std::string, std::string>>;

Record metadata(const std::string& version, const Options& options) {
    return {
        {"config_id", options.config_id.empty()
            ? "hip-" + version + "-b" + number(options.block) : options.config_id},
        {"implementation", "hip-" + version}, {"runtime", "hip"},
        {"shape", number(options.rows) + "x" + number(options.cols)},
        {"dtype", "float32"}, {"rows", number(options.rows)}, {"cols", number(options.cols)},
        {"epsilon", number(options.epsilon)}, {"block", number(options.block)},
        {"block_threads", number(options.block)}, {"block_size", "NA"},
        {"rows_per_program", "NA"}, {"num_warps", "NA"},
        {"grid", number(grid_size(version, options))}, {"launches", "1"},
        {"input", "rmsnorm-dyadic-v1"}, {"input_mode", options.input_mode},
        {"input_precision", "fp32"}, {"reference", "cpu-fp64-to-fp32"},
        {"atol", number(kAtol)}, {"rtol", number(kRtol)}, {"seed", number(options.seed)},
        {"warmup", number(options.warmup)}, {"repeat", number(options.repeat)},
        {"process", number(options.process_id)}, {"process_id", number(options.process_id)},
        {"scope", "gpu-event-full-operator"},
    };
}

void print_result(const std::string& version, const Options& options,
                  const Validation& validation, const Timing* timing,
                  const char* precheck, const char* postcheck) {
    std::cout << "RESULT operator=rmsnorm";
    for (const auto& field : metadata(version, options))
        std::cout << ' ' << field.first << '=' << field.second;
    std::cout << " timed=" << (timing != nullptr)
              << " correct=" << (validation.correct ? "OK" : "FAIL")
              << " precheck=" << precheck << " postcheck=" << postcheck
              << " min_ms=" << (timing ? number(timing->minimum_ms) : "NA")
              << " median_ms=" << (timing ? number(timing->median_ms) : "NA")
              << " mean_ms=" << (timing ? number(timing->mean_ms) : "NA")
              << " max_abs_error=" << number(validation.max_absolute_error)
              << " max_rel_error=" << number(validation.max_relative_error) << '\n';
}

void save_samples(const std::string& version, const Options& options, const Timing& timing) {
    if (options.samples.empty()) return;
    std::ofstream file(options.samples);
    if (!file) usage_error("cannot open sample file");
    const auto record = metadata(version, options);
    for (const auto& field : record) file << field.first << ',';
    file << "sample,ms\n";
    for (std::size_t index = 0; index < timing.samples.size(); ++index) {
        for (const auto& field : record) file << field.second << ',';
        file << index << ',' << number(timing.samples[index]) << '\n';
    }
    if (!file) usage_error("failed writing sample file");
}

int main(int argc, char** argv) {
    const Options options = parse_options(argc, argv);
    int device = 0;
    hipDeviceProp_t properties{};
    HIP_CHECK(hipGetDevice(&device));
    HIP_CHECK(hipGetDeviceProperties(&properties, device));
    if (options.block > properties.maxThreadsPerBlock || options.block > properties.maxThreadsDim[0])
        usage_error("block exceeds device limits");
    std::cout << "ENV runtime=hip gpu=\"" << properties.name << "\" architecture="
              << properties.gcnArchName << " input=rmsnorm-dyadic-v1"
              << " reference=cpu-fp64-to-fp32 timing=per-sample-event-sync\n";
    const std::size_t elements = static_cast<std::size_t>(options.rows) * options.cols;
    const std::size_t bytes = elements * sizeof(float);
    const std::size_t weight_bytes = static_cast<std::size_t>(options.cols) * sizeof(float);
    std::vector<float> input(elements), weight(options.cols);
    make_inputs(input, weight, options);
    const auto reference = reference_rmsnorm(input, weight, options.rows, options.cols, options.epsilon);
    std::vector<float> actual(elements), nan_output(elements, std::numeric_limits<float>::quiet_NaN());
    float *d_input = nullptr, *d_weight = nullptr, *d_output = nullptr;
    HIP_CHECK(hipMalloc(&d_input, bytes));
    HIP_CHECK(hipMalloc(&d_weight, weight_bytes));
    HIP_CHECK(hipMalloc(&d_output, bytes));
    HIP_CHECK(hipMemcpy(d_input, input.data(), bytes, hipMemcpyHostToDevice));
    HIP_CHECK(hipMemcpy(d_weight, weight.data(), weight_bytes, hipMemcpyHostToDevice));
    bool all_correct = true;
    for (const std::string version : {"serial", "block"}) {
        if (options.version != "all" && options.version != version) continue;
        HIP_CHECK(hipMemcpy(d_output, nan_output.data(), bytes, hipMemcpyHostToDevice));
        launch(version, options, d_input, d_weight, d_output);
        HIP_CHECK(hipDeviceSynchronize());
        HIP_CHECK(hipMemcpy(actual.data(), d_output, bytes, hipMemcpyDeviceToHost));
        const auto precheck = validate(actual, reference);
        if (!precheck.correct) {
            print_result(version, options, precheck, nullptr, "FAIL", "NA");
            all_correct = false;
            continue;
        }
        const auto timing = benchmark(version, options, d_input, d_weight, d_output);
        HIP_CHECK(hipMemcpy(actual.data(), d_output, bytes, hipMemcpyDeviceToHost));
        const auto postcheck = validate(actual, reference);
        print_result(version, options, postcheck, &timing, "OK", postcheck.correct ? "OK" : "FAIL");
        if (postcheck.correct) save_samples(version, options, timing);
        all_correct = postcheck.correct && all_correct;
    }
    HIP_CHECK(hipFree(d_input));
    HIP_CHECK(hipFree(d_weight));
    HIP_CHECK(hipFree(d_output));
    return all_correct ? 0 : 1;
}
这份文件包含本路线的输入准备、kernel、启动、校验与计时;后续配置共用它,按函数和运行参数定位改动。
先编译一次。未修改源码时可复用本轮可执行文件;修改源码后请新建结果目录再编译:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
if [[ ! -x "$RUN/build/rmsnorm_hip" ]]; then
  hipcc --offload-arch=gfx1201 -O3 -std=c++17 \
    chapter13/rmsnorm_hip.hip -o "$RUN/build/rmsnorm_hip"
fi
先读 serial:一个线程处理一行,先沿列顺序求平方和,再沿列写输出。它的核心与公式一一对应:
float square_sum = 0.0f;
for (int col = 0; col < cols; ++col) {
    const float value = input[base + col];
    square_sum += value * value;
}
const float inverse_rms = rsqrtf(square_sum / cols + epsilon);
for (int col = 0; col < cols; ++col)
    output[base + col] = input[base + col] * inverse_rms * weight[col];
先运行公式版本,确认完整输出符合参考。主形状显式指定为 4096×1024:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
test ! -e "$RUN/n4096x1024-hip-serial-b256-p1.csv" && \
"$RUN/build/rmsnorm_hip" \
  --block 256 --version serial --rows 4096 \
  --cols 1024 --warmup 10 --repeat 50 \
  --seed 20260920 --epsilon 9.999999747378752e-06 --input normal \
--config-id hip-serial-b256 --samples "$RUN/n4096x1024-hip-serial-b256-p1.csv" --process 1ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-serial-b256 implementation=hip-serial runtime=hip shape=4096x1024 dtype=float32 rows=4096 cols=1024 epsilon=9.9999997473787516e-06 block=256 block_threads=256 block_size=NA rows_per_program=NA num_warps=NA grid=16 launches=1 input=rmsnorm-dyadic-v1 input_mode=normal input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=10 repeat=50 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.6339229941368103 median_ms=0.67068350315093994 mean_ms=0.6723724019527435 max_abs_error=2.384185791015625e-07 max_rel_error=2.1531675085731057e-07correct=OK 表示预检和计时后检查通过,median_ms 是本进程的中位数。这里 base=row*cols,不同的行可以并行;同一行的平方和仍是一条顺序累加链。为了让一行也能协作,把 blockIdx.x 对应到行,线程 tid 处理 tid、tid+blockDim.x、… 这些列。
每加完一项,再处理下一项。
每轮完成写入并同步,再读下一轮。
淡色格仍保留原值;只更新本轮参与的位置。
四个位置仅用于手算。实际协作基线为 block=256;依赖链长短不能代替 benchmark。
图 13.2 点选三个阶段,对照同一行的依赖与写回:serial 保留顺序累加链;block 通过 LDS 归约后,各线程读取平方和、各自求尺度。四个位置是教学缩略,主实验为 block=256。
图 13.2 中,各线程先把局部平方和放进 LDS,再合并成整行平方和:
float square_sum = 0.0f;
for (int col = tid; col < cols; col += blockDim.x) {
    const float value = input[base + col];
    square_sum += value * value;
}
shared[tid] = square_sum;
__syncthreads();
for (int stride = blockDim.x / 2; stride > 0; stride >>= 1) {
    if (tid < stride) shared[tid] += shared[tid + stride];
    __syncthreads();
}
没有有效列的线程让局部和保持 0,照常参加屏障。每轮不做加法的线程也不能跳过屏障。最终 shared[0] 给出整行平方和,仍除以有效列数 cols,然后线程按原分工写输出。
这里读取 shared[0] 后,不再覆盖这块 LDS。与第 10 章复用同一片共享空间的情况不同,不需要为了后续覆盖再加一道读后屏障。
同一份源码选择 --version block --block 256,检查行内协作是否缩短完整时间:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
test ! -e "$RUN/n4096x1024-hip-block-b256-p1.csv" && \
"$RUN/build/rmsnorm_hip" \
  --block 256 --version block --rows 4096 \
  --cols 1024 --warmup 10 --repeat 50 \
  --seed 20260920 --epsilon 9.999999747378752e-06 --input normal \
--config-id hip-block-b256 --samples "$RUN/n4096x1024-hip-block-b256-p1.csv" --process 1ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-block-b256 implementation=hip-block runtime=hip shape=4096x1024 dtype=float32 rows=4096 cols=1024 epsilon=9.9999997473787516e-06 block=256 block_threads=256 block_size=NA rows_per_program=NA num_warps=NA grid=4096 launches=1 input=rmsnorm-dyadic-v1 input_mode=normal input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=10 repeat=50 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.074680998921394348 median_ms=0.076079998165369034 mean_ms=0.088772539645433426 max_abs_error=2.384185791015625e-07 max_rel_error=2.1531675085731057e-07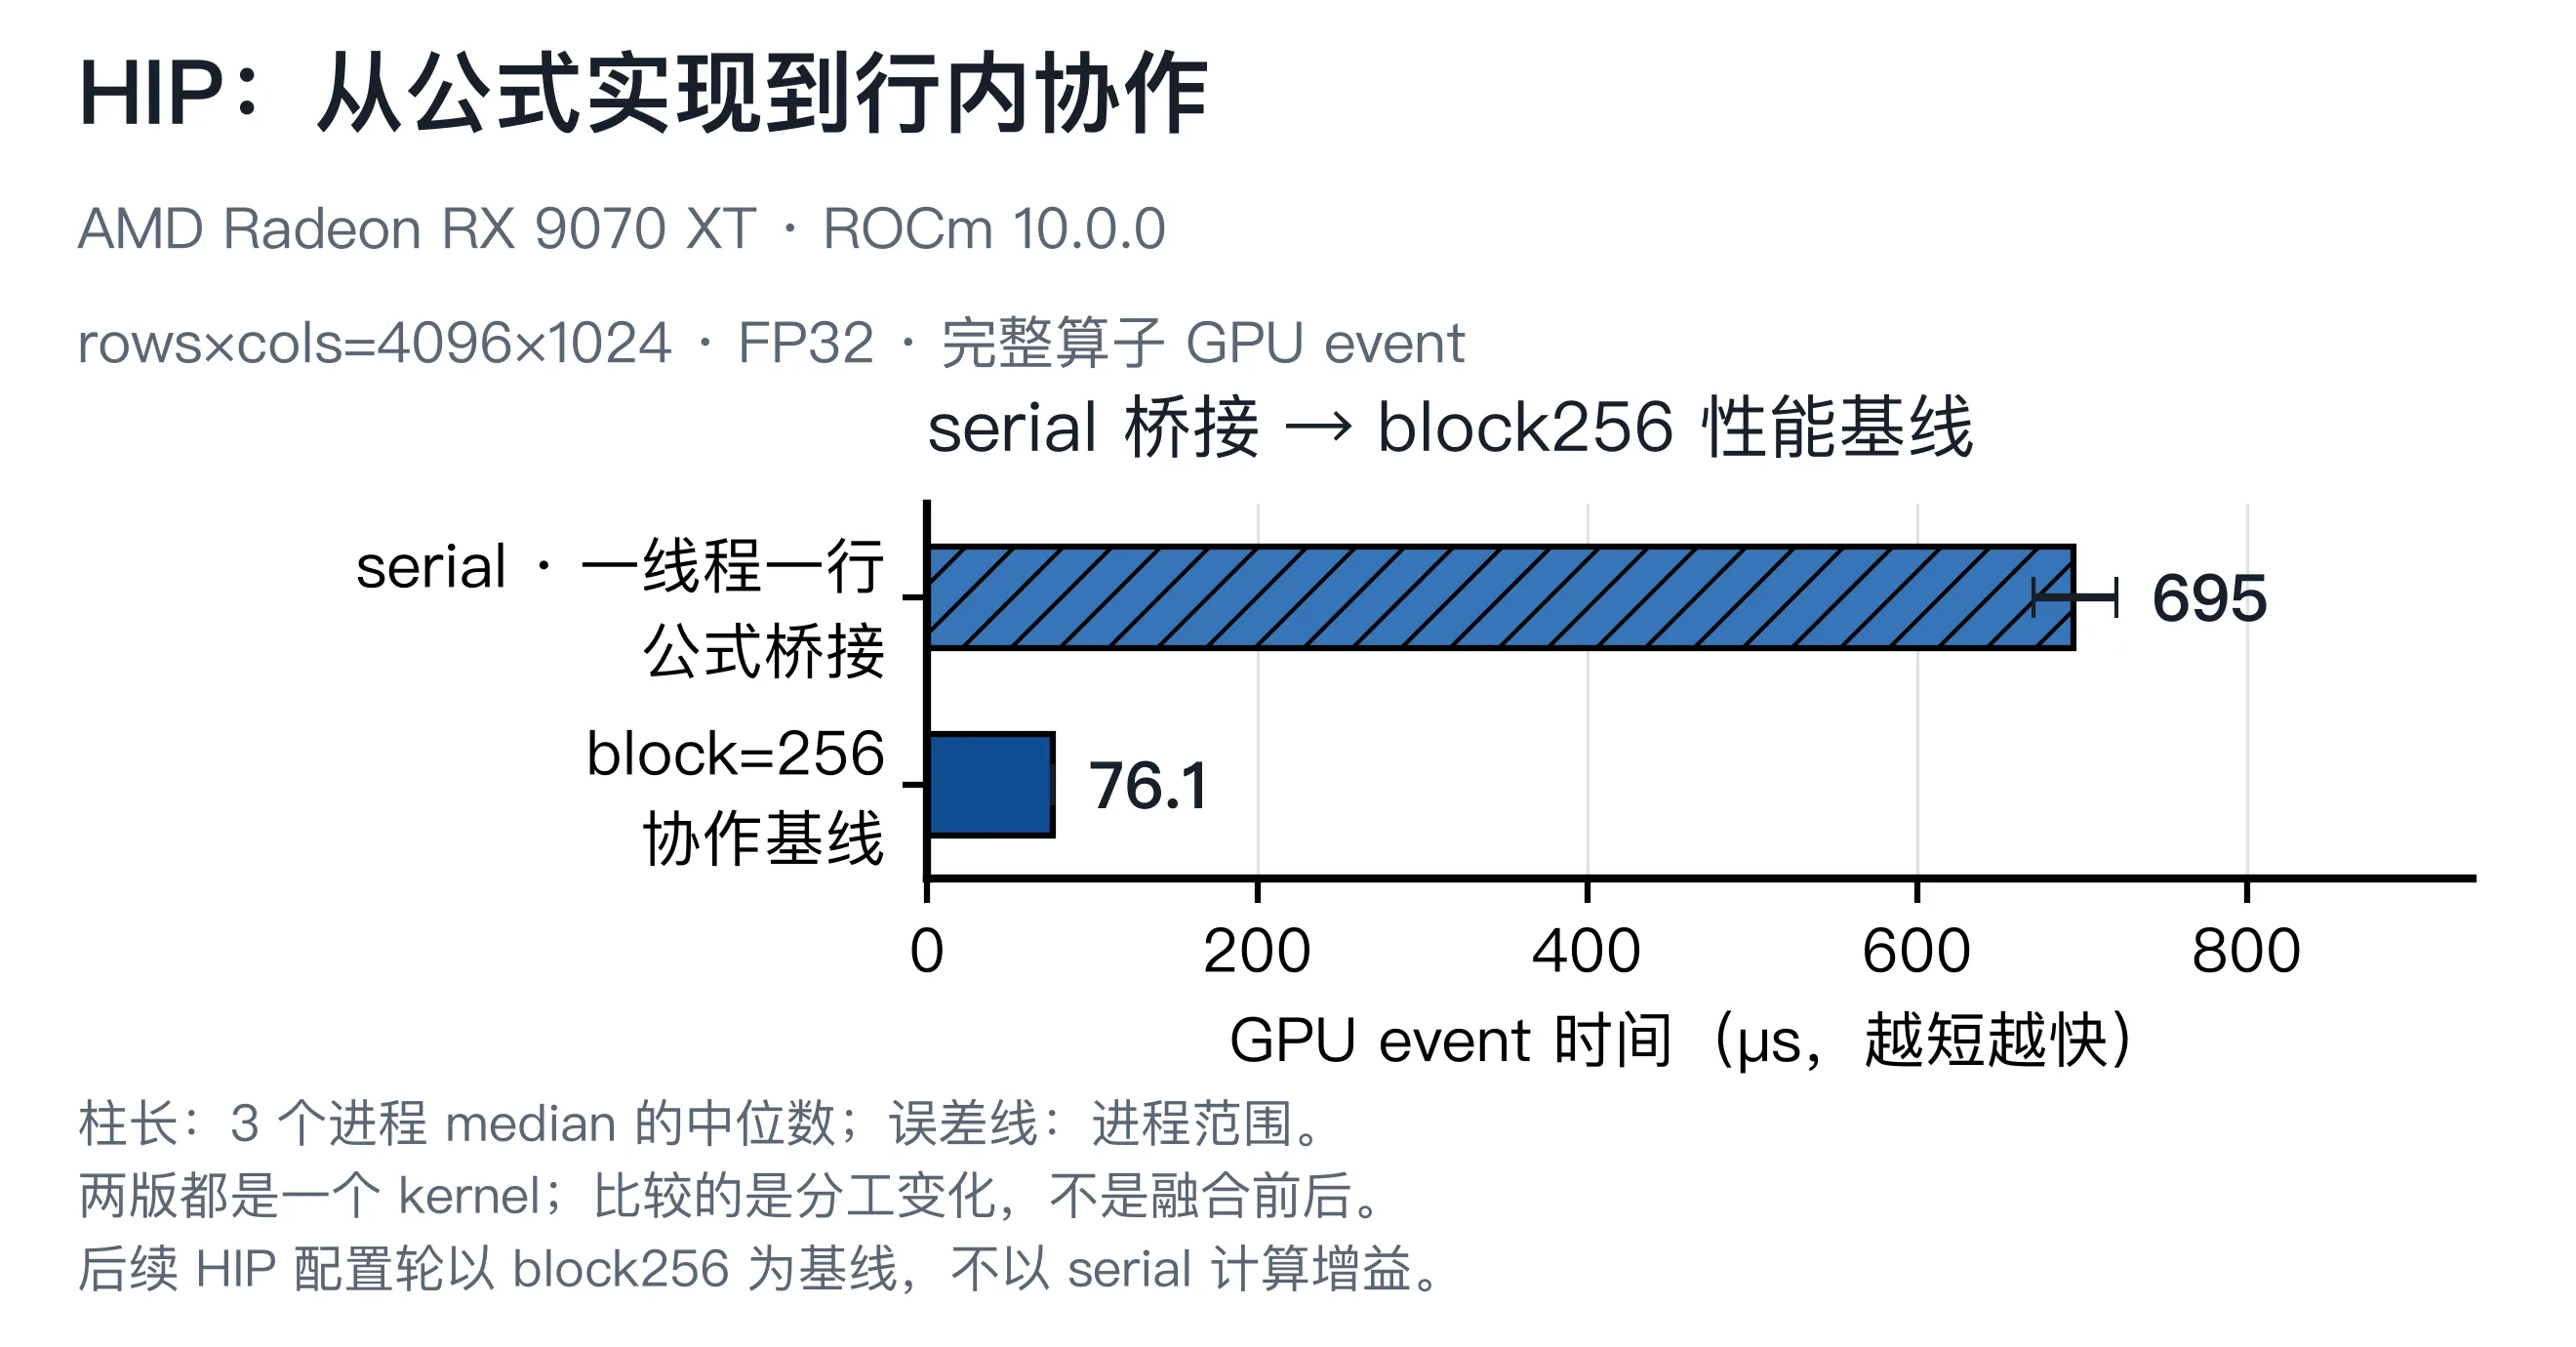
图 13.3 公式实现到协作实现的桥接。两者都是单个 kernel;后续 HIP 配置实验以 block256 为性能基线。
公式版本为 694.605 μs(670.684–720.645),block256 为 76.080 μs(75.661–76.201)。行内协作的整体改动显著缩短了完整时间;它同时改变了访存分工、归约组织和可调度的工作,不能把比值全部归给树的深度。
启动代码让每个 block 负责一行,主形状因此安排 4096 个 block,每组 256 线程。接下来保持这项映射,研究 256 线程是否适合 1024 列的工作。后续图都以 block256 为 HIP 性能基线。
有了 block=256 的协作基线,下一问是:每行 1024 列,需要这么多线程吗?线程少一些,每个线程会多算几项,但树归约更短、LDS 需求也更少。
本轮保持同一个 kernel、相同输入和归约算法,只比较 block=64、128、256:
| block | 主形状每线程累加的列数 | LDS 字节数 | 树归约轮数 |
|---|---|---|---|
| 64 | 16 | 256 | 6 |
| 128 | 8 | 512 | 7 |
| 256 | 4 | 1024 | 8 |
这些是源码可计算的工作量。线程数变化也会改变 wave 数与执行安排,因此不能把时间差只归给少了一轮屏障。先提出局部工作量与协作成本的取舍,再看完整时间。
block256 的记录已经得到,继续运行同一 kernel 的两个候选;不必为这一轮重复运行原基线:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
test ! -e "$RUN/n4096x1024-hip-block-b128-p1.csv" && \
"$RUN/build/rmsnorm_hip" \
  --block 128 --version block --rows 4096 \
  --cols 1024 --warmup 10 --repeat 50 \
  --seed 20260920 --epsilon 9.999999747378752e-06 --input normal \
--config-id hip-block-b128 --samples "$RUN/n4096x1024-hip-block-b128-p1.csv" --process 1ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-block-b128 implementation=hip-block runtime=hip shape=4096x1024 dtype=float32 rows=4096 cols=1024 epsilon=9.9999997473787516e-06 block=128 block_threads=128 block_size=NA rows_per_program=NA num_warps=NA grid=4096 launches=1 input=rmsnorm-dyadic-v1 input_mode=normal input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=10 repeat=50 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.068520002067089081 median_ms=0.069100499153137207 mean_ms=0.072493299841880798 max_abs_error=2.384185791015625e-07 max_rel_error=2.1531675085731057e-07test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
test ! -e "$RUN/n4096x1024-hip-block-b64-p1.csv" && \
"$RUN/build/rmsnorm_hip" \
--block 64 --version block --rows 4096 \
--cols 1024 --warmup 10 --repeat 50 \
--seed 20260920 --epsilon 9.999999747378752e-06 --input normal \
--config-id hip-block-b64 --samples "$RUN/n4096x1024-hip-block-b64-p1.csv" --process 1ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-block-b64 implementation=hip-block runtime=hip shape=4096x1024 dtype=float32 rows=4096 cols=1024 epsilon=9.9999997473787516e-06 block=64 block_threads=64 block_size=NA rows_per_program=NA num_warps=NA grid=4096 launches=1 input=rmsnorm-dyadic-v1 input_mode=normal input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=10 repeat=50 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.058559998869895935 median_ms=0.059759998694062233 mean_ms=0.063157099783420559 max_abs_error=2.384185791015625e-07 max_rel_error=2.1531675085731057e-07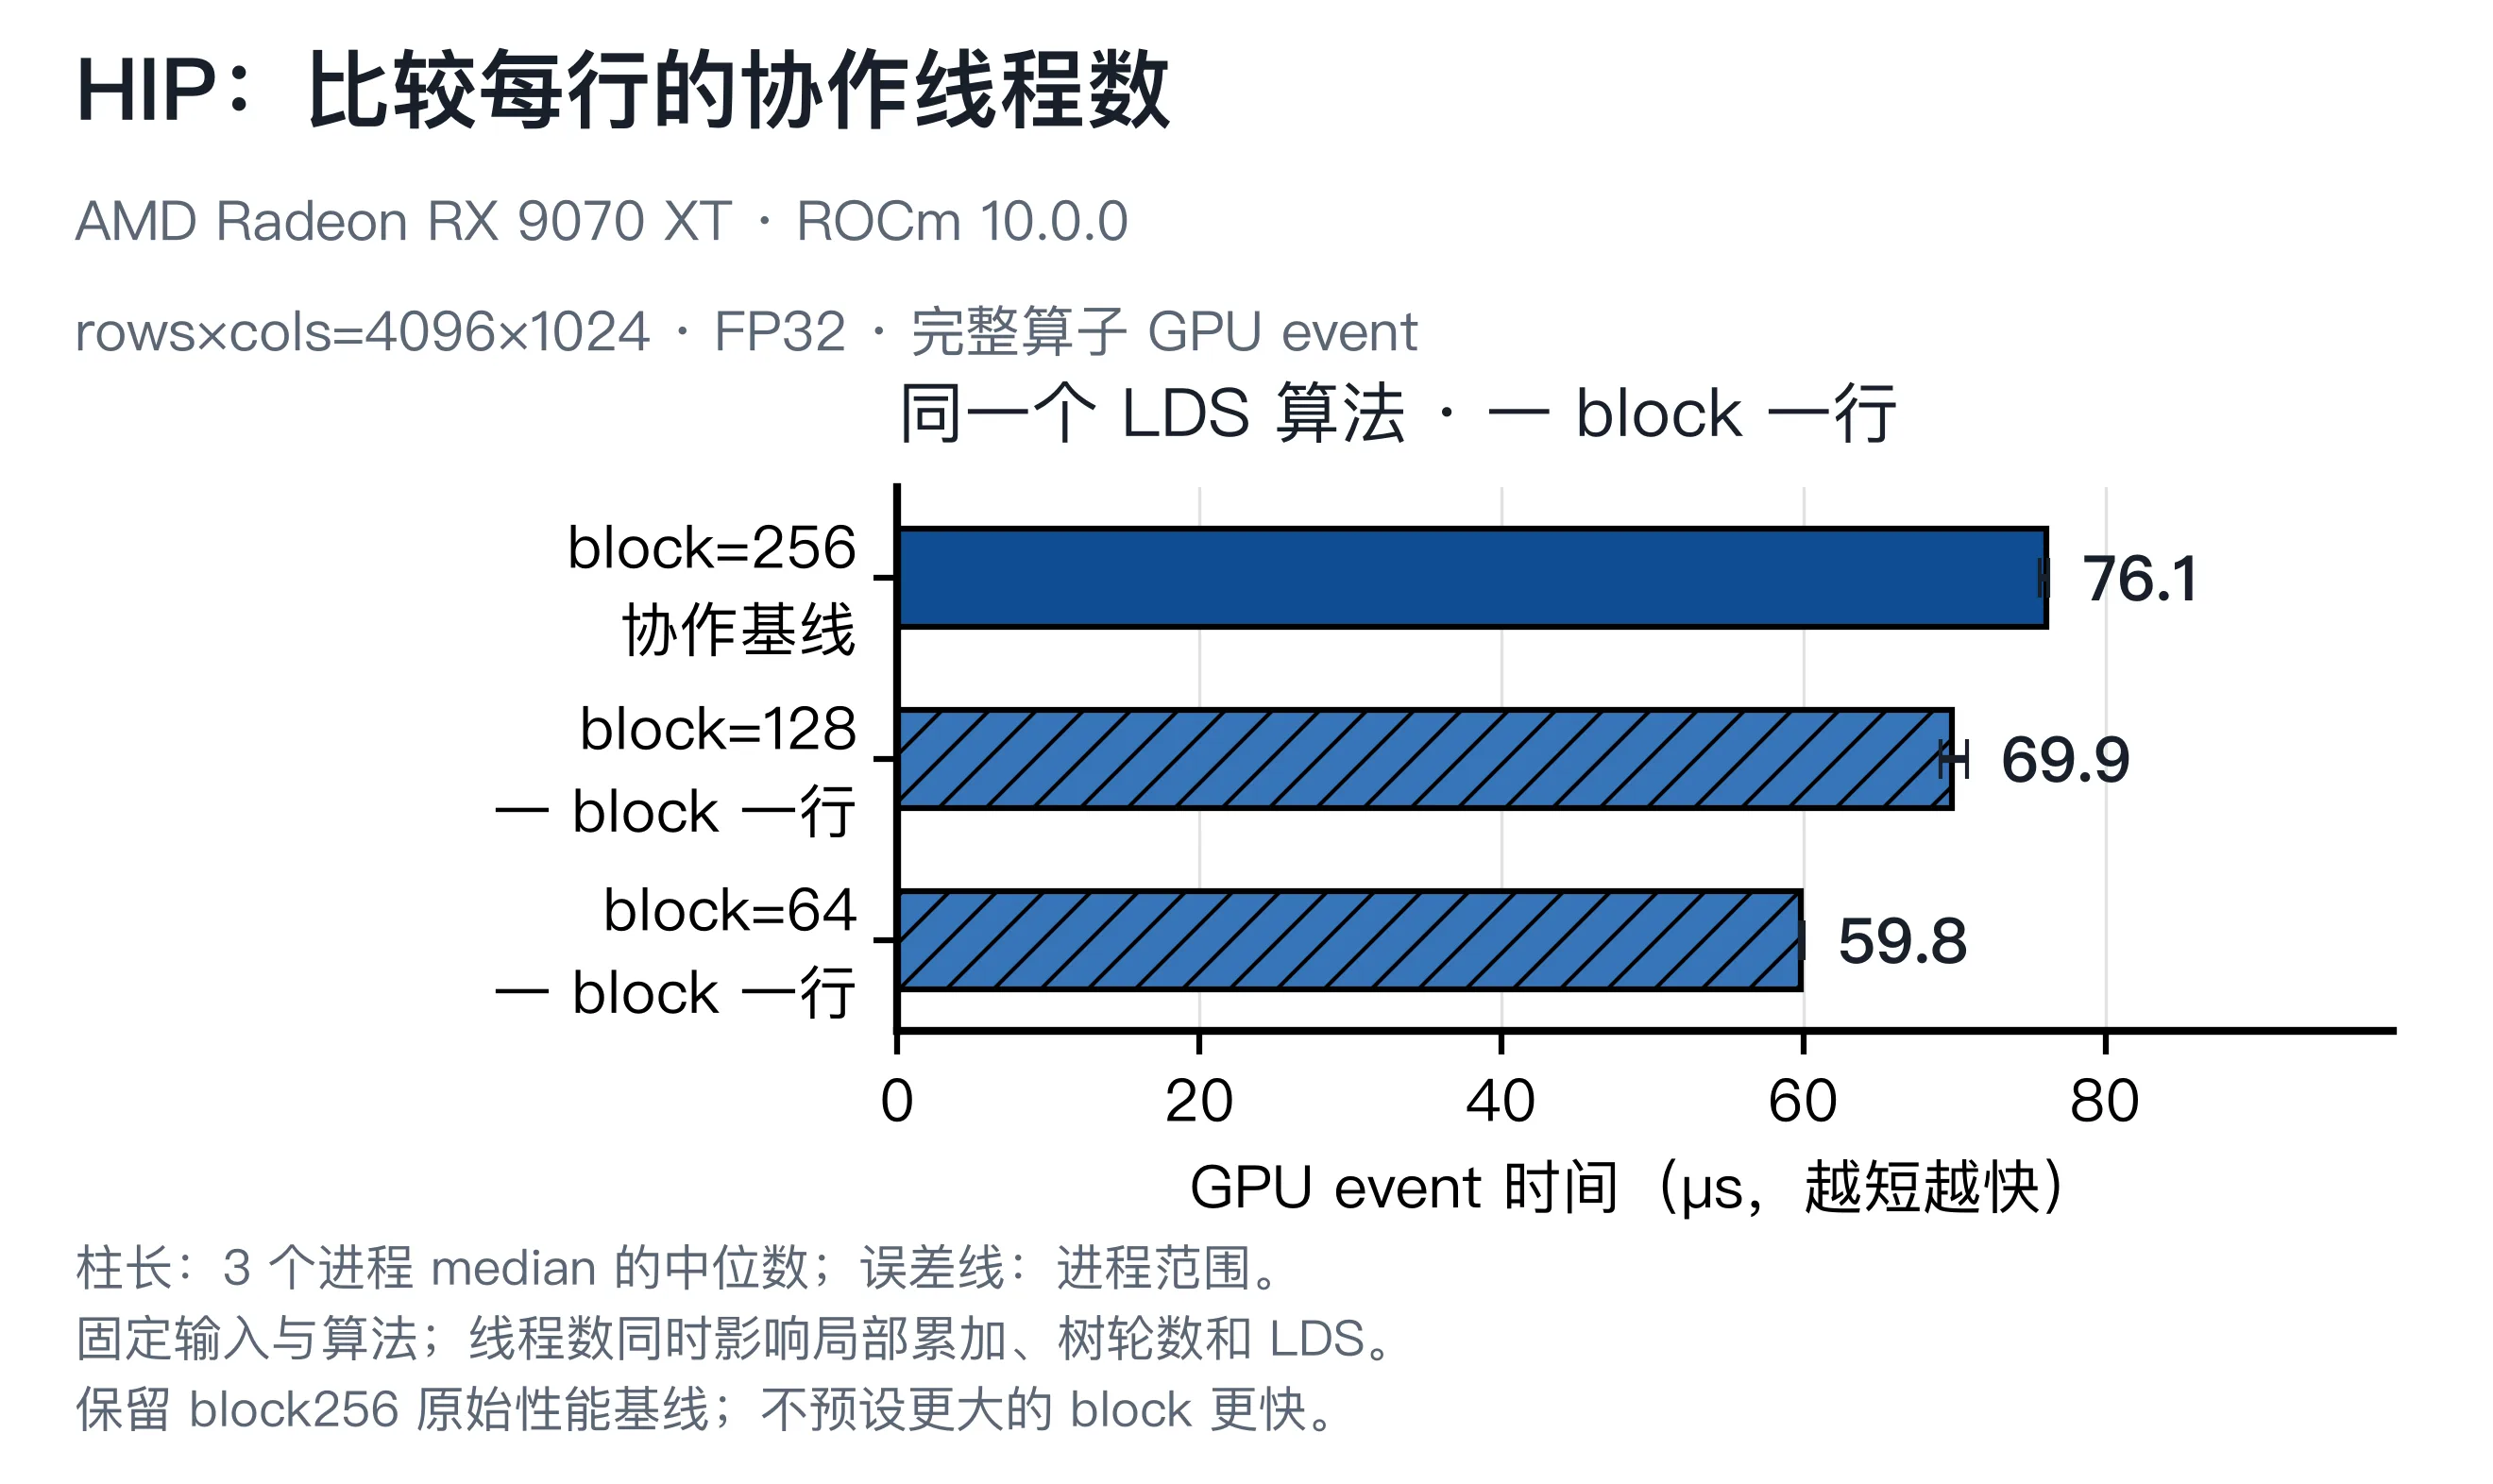
图 13.4 HIP 配置实验:block256 是原始性能基线,64 和 128 是当前候选。所有版本仍是一 block 一行。
block256、128、64 的完整时间分别是 76.080、69.860、59.820 μs。64线程相对路线基线约快 1.27倍;独立确认中,256为 75.920 μs(75.860–76.201),64为 59.841 μs(59.521–61.681),两组范围分离。因此主形状采用 block64。
随后减少行数,或把列数改成不能整除 block 的值,检查选择是否仍然合适。性能上的优选配置需要范围,不能从一次主形状比较推成通用线程数。
边界检查要同时覆盖公式和寻址。本章保留普通正负输入,另外加入三种容易判断的输入模式:
--input | 改变的内容 | 应检查什么 |
|---|---|---|
normal | 确定性的正负 x 与正负列权重 | 常规结果与两条路线的共同参考 |
zero | x 全为 0,权重保持普通输入 | epsilon 保证分母有效,输出为 0 |
zero-weight | 列权重全为 0,x 保持普通输入 | 最终输出为 0,权重确实参与计算 |
signed-weight | 权重交替正负,幅值也有变化 | 权重按列应用,不能误用单个行权重或绝对值 |
下面从已有检查中选四个例子;按已阅读的路线运行,HIP 需先完成本路线编译。它们使用 warmup=0,repeat=1,用于阅读正确性结果;不拿这一轮时间作性能比较。章末主入口会自动完成全部 128 项,已经运行批量入口时无需再逐项重跑。
先检查 HIP 的零输入与零权重:即使行尺度不同,最终输出都应为 0。
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
"$RUN/build/rmsnorm_hip" \
  --block 64 --version block --rows 33 \
  --cols 1 --warmup 0 --repeat 1 \
  --seed 20260920 --epsilon 9.999999747378752e-06 --input zero \
--config-id hip-block-b64ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-block-b64 implementation=hip-block runtime=hip shape=33x1 dtype=float32 rows=33 cols=1 epsilon=9.9999997473787516e-06 block=64 block_threads=64 block_size=NA rows_per_program=NA num_warps=NA grid=33 launches=1 input=rmsnorm-dyadic-v1 input_mode=zero input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=0 repeat=1 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.012199999764561653 median_ms=0.012199999764561653 mean_ms=0.012199999764561653 max_abs_error=0 max_rel_error=0test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
"$RUN/build/rmsnorm_hip" \
--block 64 --version block --rows 33 \
--cols 257 --warmup 0 --repeat 1 \
--seed 20260920 --epsilon 9.999999747378752e-06 --input zero-weight \
--config-id hip-block-b64ENV runtime=hip gpu="AMD Radeon RX 9070 XT" architecture=gfx1201 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=hip-block-b64 implementation=hip-block runtime=hip shape=33x257 dtype=float32 rows=33 cols=257 epsilon=9.9999997473787516e-06 block=64 block_threads=64 block_size=NA rows_per_program=NA num_warps=NA grid=33 launches=1 input=rmsnorm-dyadic-v1 input_mode=zero-weight input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2.0000000000000002e-05 rtol=2.0000000000000002e-05 seed=20260920 warmup=0 repeat=1 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.014680000022053719 median_ms=0.014680000022053719 mean_ms=0.014680000022053719 max_abs_error=0 max_rel_error=0再让 Triton 两行版本处理正负交替、幅值不同的列权重,检查每一列是否乘上了自己的权重:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
python chapter13/rmsnorm_triton.py \
  --rows-per-program 2 --num-warps 4 --version configured \
  --rows 33 --cols 129 --warmup 0 \
  --repeat 1 --seed 20260920 --epsilon 9.999999747378752e-06 \
--input signed-weight --config-id triton-r2-w4ENV runtime=triton gpu="AMD Radeon RX 9070 XT" torch=2.13.0+rocm10.0.0 torch_hip=7.15.26333 triton=3.8.0 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=triton-r2-w4 implementation=triton-configured runtime=triton shape=33x129 dtype=float32 rows=33 cols=129 epsilon=9.999999747378752e-06 block=NA block_threads=NA block_size=256 rows_per_program=2 num_warps=4 grid=17 launches=1 input=rmsnorm-dyadic-v1 input_mode=signed-weight input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2e-05 rtol=2e-05 seed=20260920 warmup=0 repeat=1 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.093730002641677856 median_ms=0.093730002641677856 mean_ms=0.093730002641677856 max_abs_error=2.38418579e-07 max_rel_error=1.61546139e-07单列时公式仍要成立;129、257、4097 列分别让逻辑宽度跨过二次幂边界。多行 program 还需要检查最后一个 program 不满 R 行的情况。
例如 rows=33, cols=129, R=4:最后一个 program 的行编号为 32、33、34、35,仅第 32 行有效;B=256,只有列 0 到 128 有效。行 mask 和列 mask 要同时保护输入与输出,权重加载只按列边界判断。
用同一个 33 行、129 列输入检查 R=4 的行列尾部:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
python chapter13/rmsnorm_triton.py \
  --rows-per-program 4 --num-warps 4 --version configured \
  --rows 33 --cols 129 --warmup 0 \
  --repeat 1 --seed 20260920 --epsilon 9.999999747378752e-06 \
--input normal --config-id triton-r4-w4ENV runtime=triton gpu="AMD Radeon RX 9070 XT" torch=2.13.0+rocm10.0.0 torch_hip=7.15.26333 triton=3.8.0 input=rmsnorm-dyadic-v1 reference=cpu-fp64-to-fp32 timing=per-sample-event-sync
RESULT operator=rmsnorm config_id=triton-r4-w4 implementation=triton-configured runtime=triton shape=33x129 dtype=float32 rows=33 cols=129 epsilon=9.999999747378752e-06 block=NA block_threads=NA block_size=256 rows_per_program=4 num_warps=4 grid=9 launches=1 input=rmsnorm-dyadic-v1 input_mode=normal input_precision=fp32 reference=cpu-fp64-to-fp32 atol=2e-05 rtol=2e-05 seed=20260920 warmup=0 repeat=1 process=1 process_id=1 scope=gpu-event-full-operator timed=1 correct=OK precheck=OK postcheck=OK min_ms=0.090499997138977051 median_ms=0.090499997138977051 mean_ms=0.090499997138977051 max_abs_error=1.1920929e-07 max_rel_error=1.61546139e-07本轮实际检查 33×1、33×129、33×257、33×4097,每个形状分别使用四种输入和八个实现配置,共 128项通过。两行和四行program也参加这些检查,因而同时覆盖列尾与不满一组的行尾。
性能迁移另选两种形状,它们各自回答不同的问题:
| 形状 | 与主形状相比 | 本轮关注点 |
|---|---|---|
128×1024 | 列数相同、行数减少 | 可并行的行变少,原 block/warps 选择是否仍合适? |
4096×1025 | 每行多一列 | HIP 增加尾部工作;Triton B 从 1024 变为 2048,排序是否变化? |
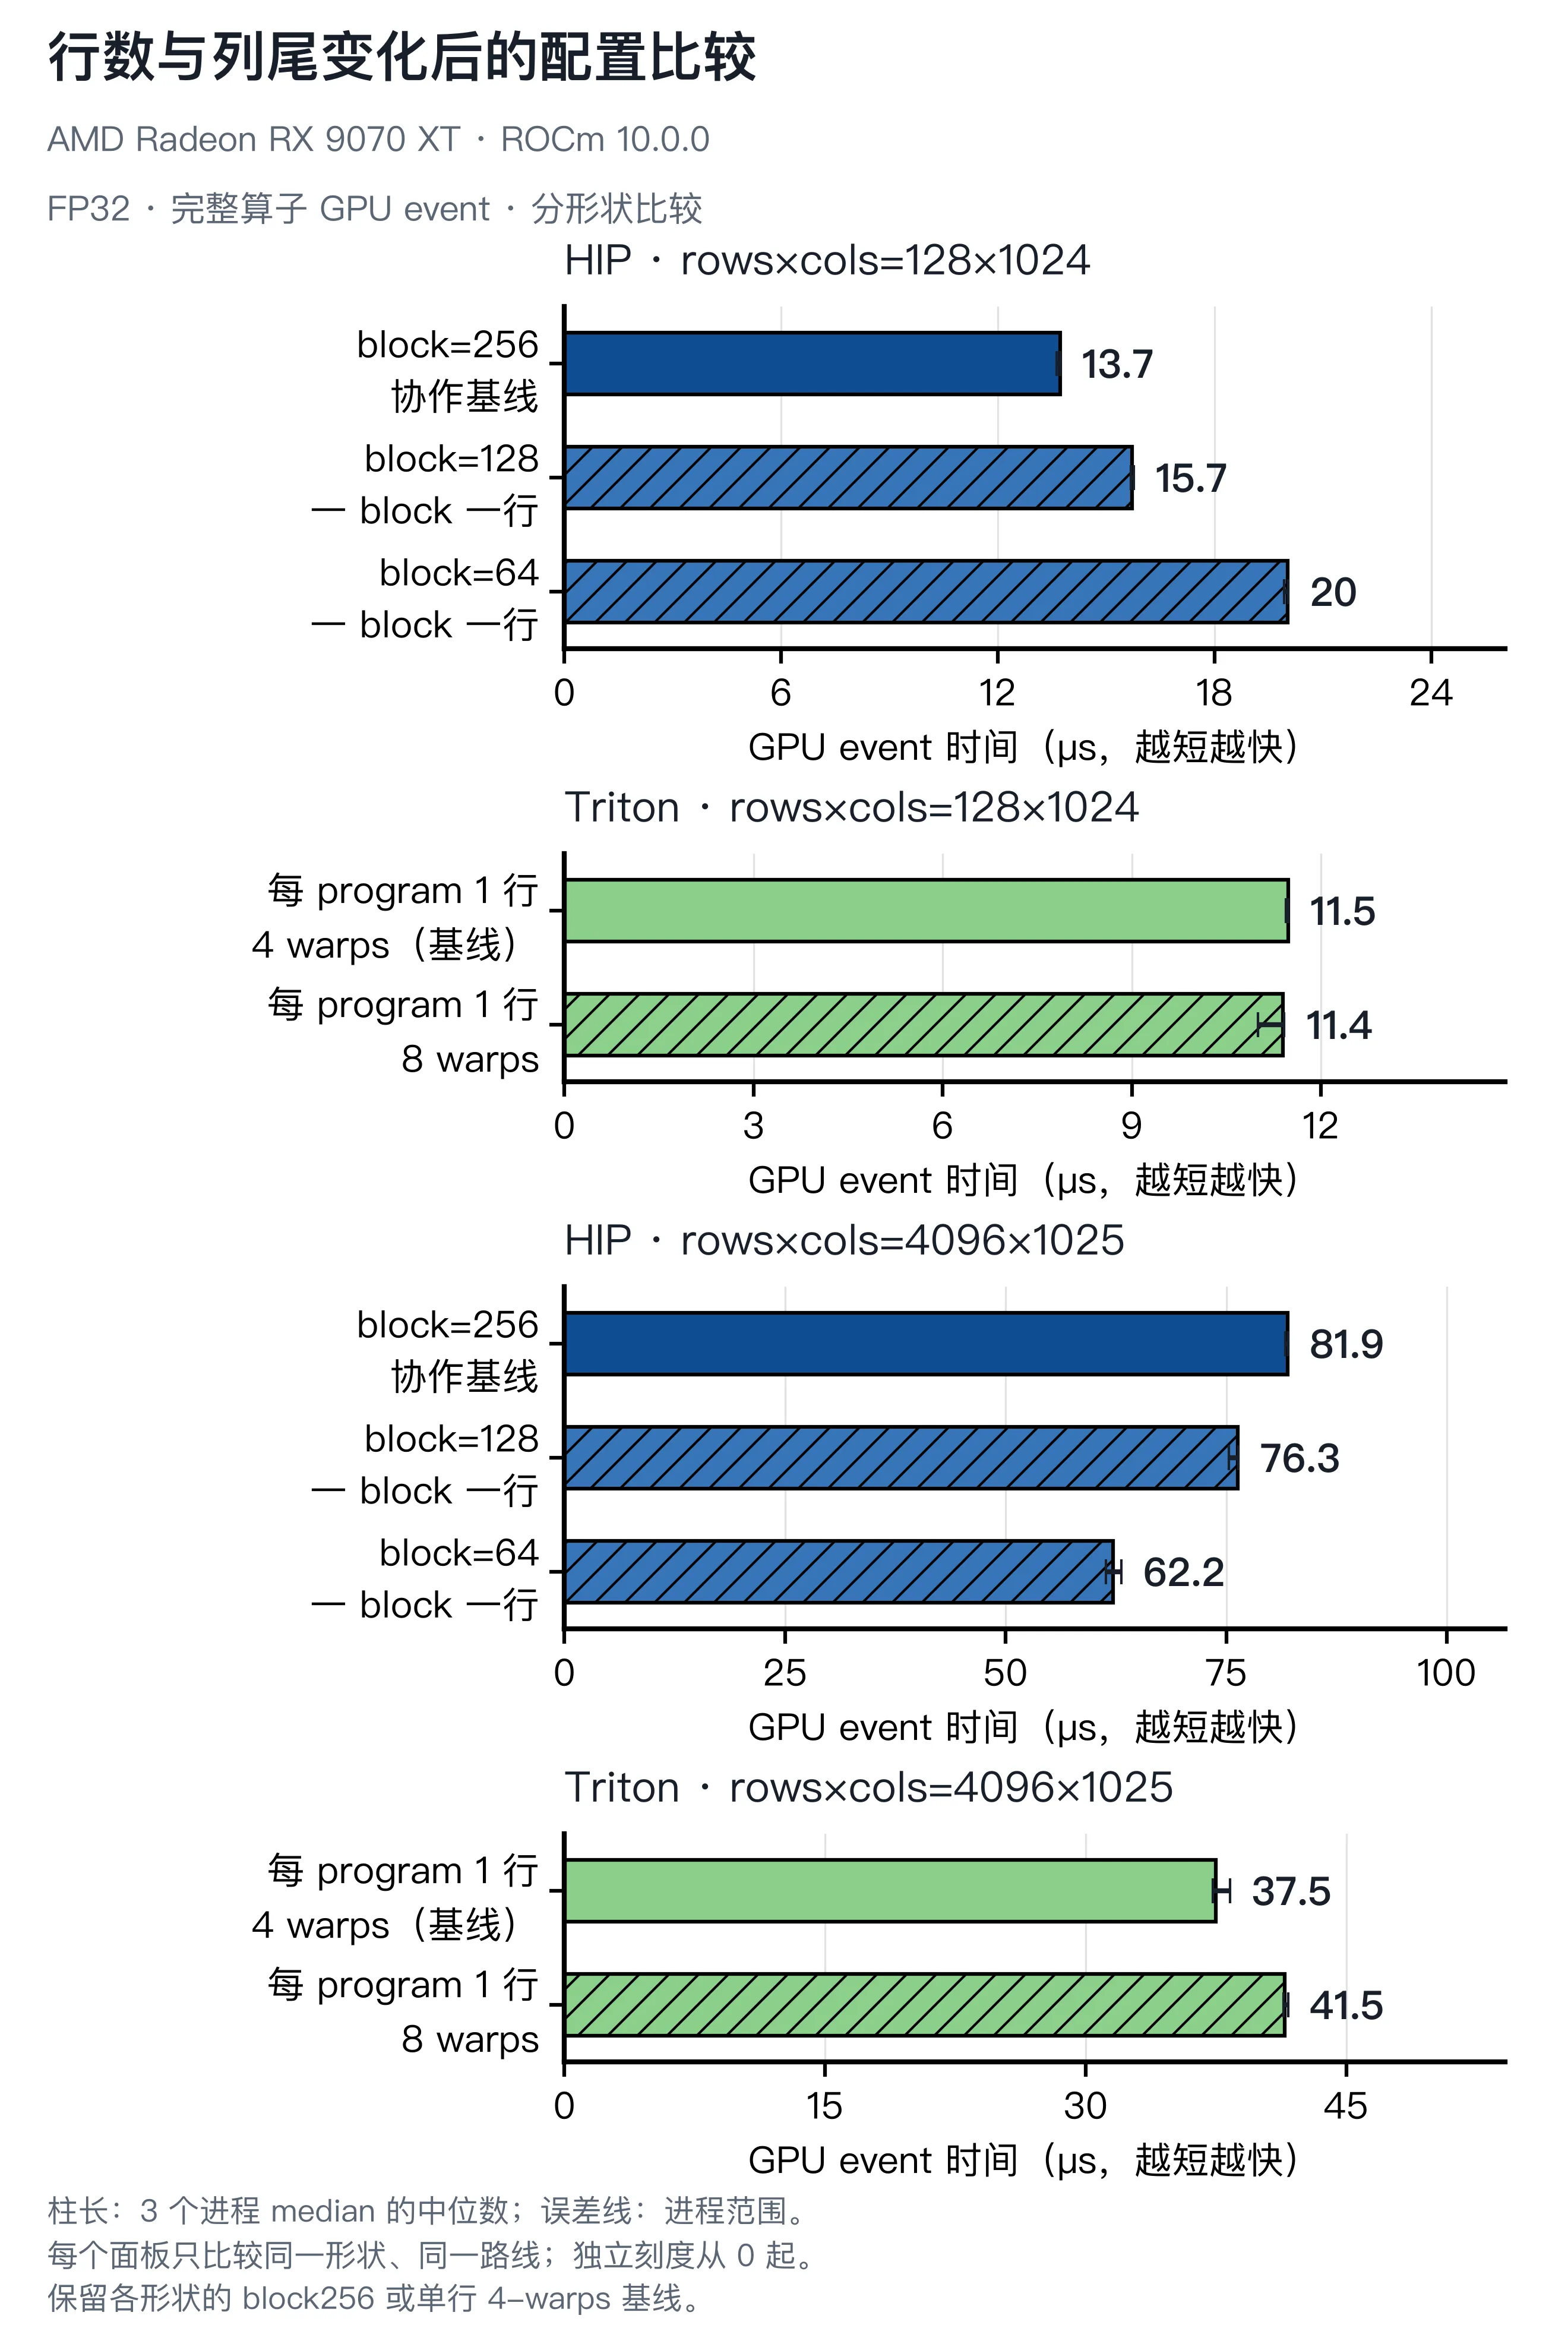
图 13.8 两组形状都比较HIP block64/128/256与Triton单行4/8 warps,各保留本形状的路线基线。各面板刻度独立;短行多行program另见前一轮图。
| 形状 | 配置 | 完整 event 中位数 μs | 三个进程中位数范围 μs |
|---|---|---|---|
128x1024 | hip-block-b256 | 13.720 | 13.620–13.721 |
128x1024 | hip-block-b128 | 15.720 | 15.680–15.760 |
128x1024 | hip-block-b64 | 20.020 | 19.920–20.040 |
128x1024 | triton-r1-w4 | 11.480 | 11.440–11.480 |
128x1024 | triton-r1-w8 | 11.400 | 11.000–11.420 |
4096x1025 | hip-block-b256 | 81.940 | 81.661–82.020 |
4096x1025 | hip-block-b128 | 76.320 | 75.320–76.380 |
4096x1025 | hip-block-b64 | 62.161 | 61.361–63.141 |
4096x1025 | triton-r1-w4 | 37.480 | 37.321–38.300 |
4096x1025 | triton-r1-w8 | 41.460 | 41.381–41.660 |
128×1024 上,HIP block256 为 13.720 μs,block64 为 20.020 μs,主形状的排序反转。行内分工并未变成通用选择:当独立的行只有128个时,需要重新考虑每组工作与整体并行安排。这里的时间只能说明当前配置结果,尚未隔离每项硬件成本。
4096×1025 上,HIP block64 仍较快:62.161 μs 对block256的 81.940 μs;Triton却是4 warps的 37.480 μs 快于8 warps的 41.460 μs。列宽改变后需要重新核对逻辑块和执行配置,不能只沿用1024列的选择。
两组附形状目前是各三个进程的配置扫描,尚未另开确认组。它们用于发现不能直接迁移的选择,不作为已经确认的全形状参数表。
epsilon 也属于算子输入。把 x 放大两倍,并不会在正 epsilon 下让输出严格不变;可以直接代入公式理解其影响。当前数值检查覆盖的是记录中的输入模式与范围,不替任意极大输入或其他数据类型作保证。
本章不需要一个包办所有形状的配置。主形状、短行和较少行数的输入,各自依据对应的基线作决定:
| 问题 | 基线 | 复测后的结论 |
|---|---|---|
| 主形状 HIP block 配置 | block=256 | 采用block64,完整时间的收益在独立确认中保持 |
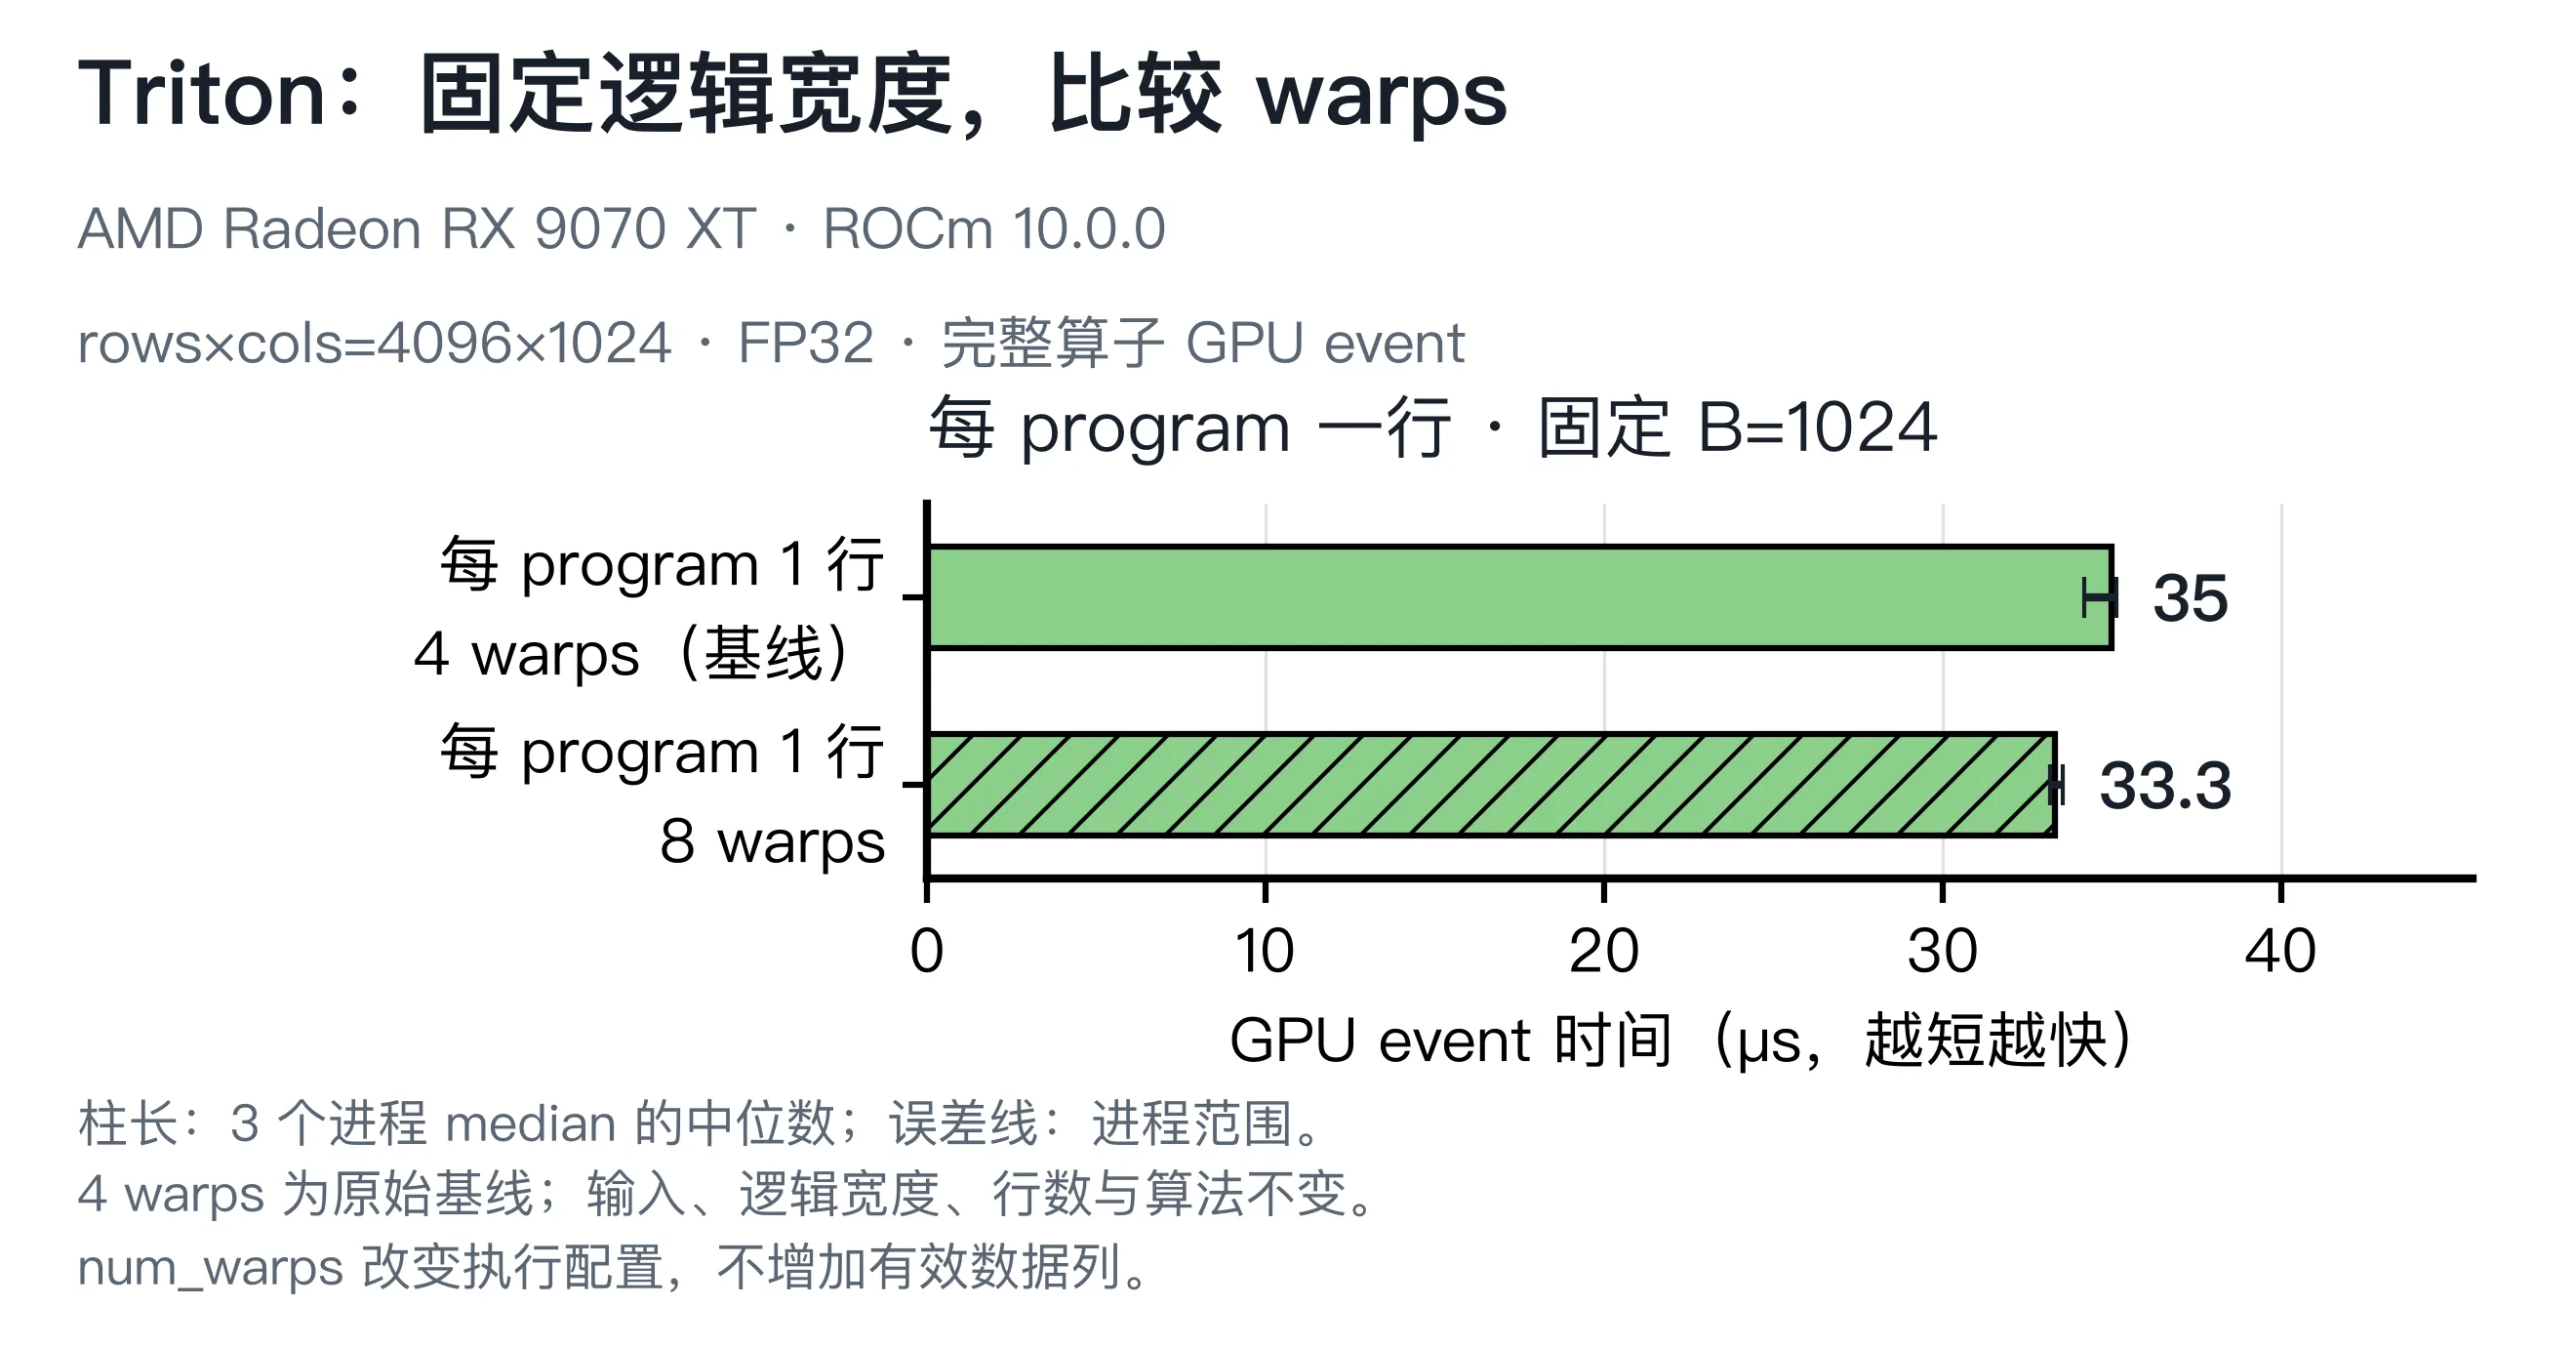
| 主形状 Triton warps | 一行/B1024/4 warps | 主形状采用8 warps;换行数或列宽后重新比较 |
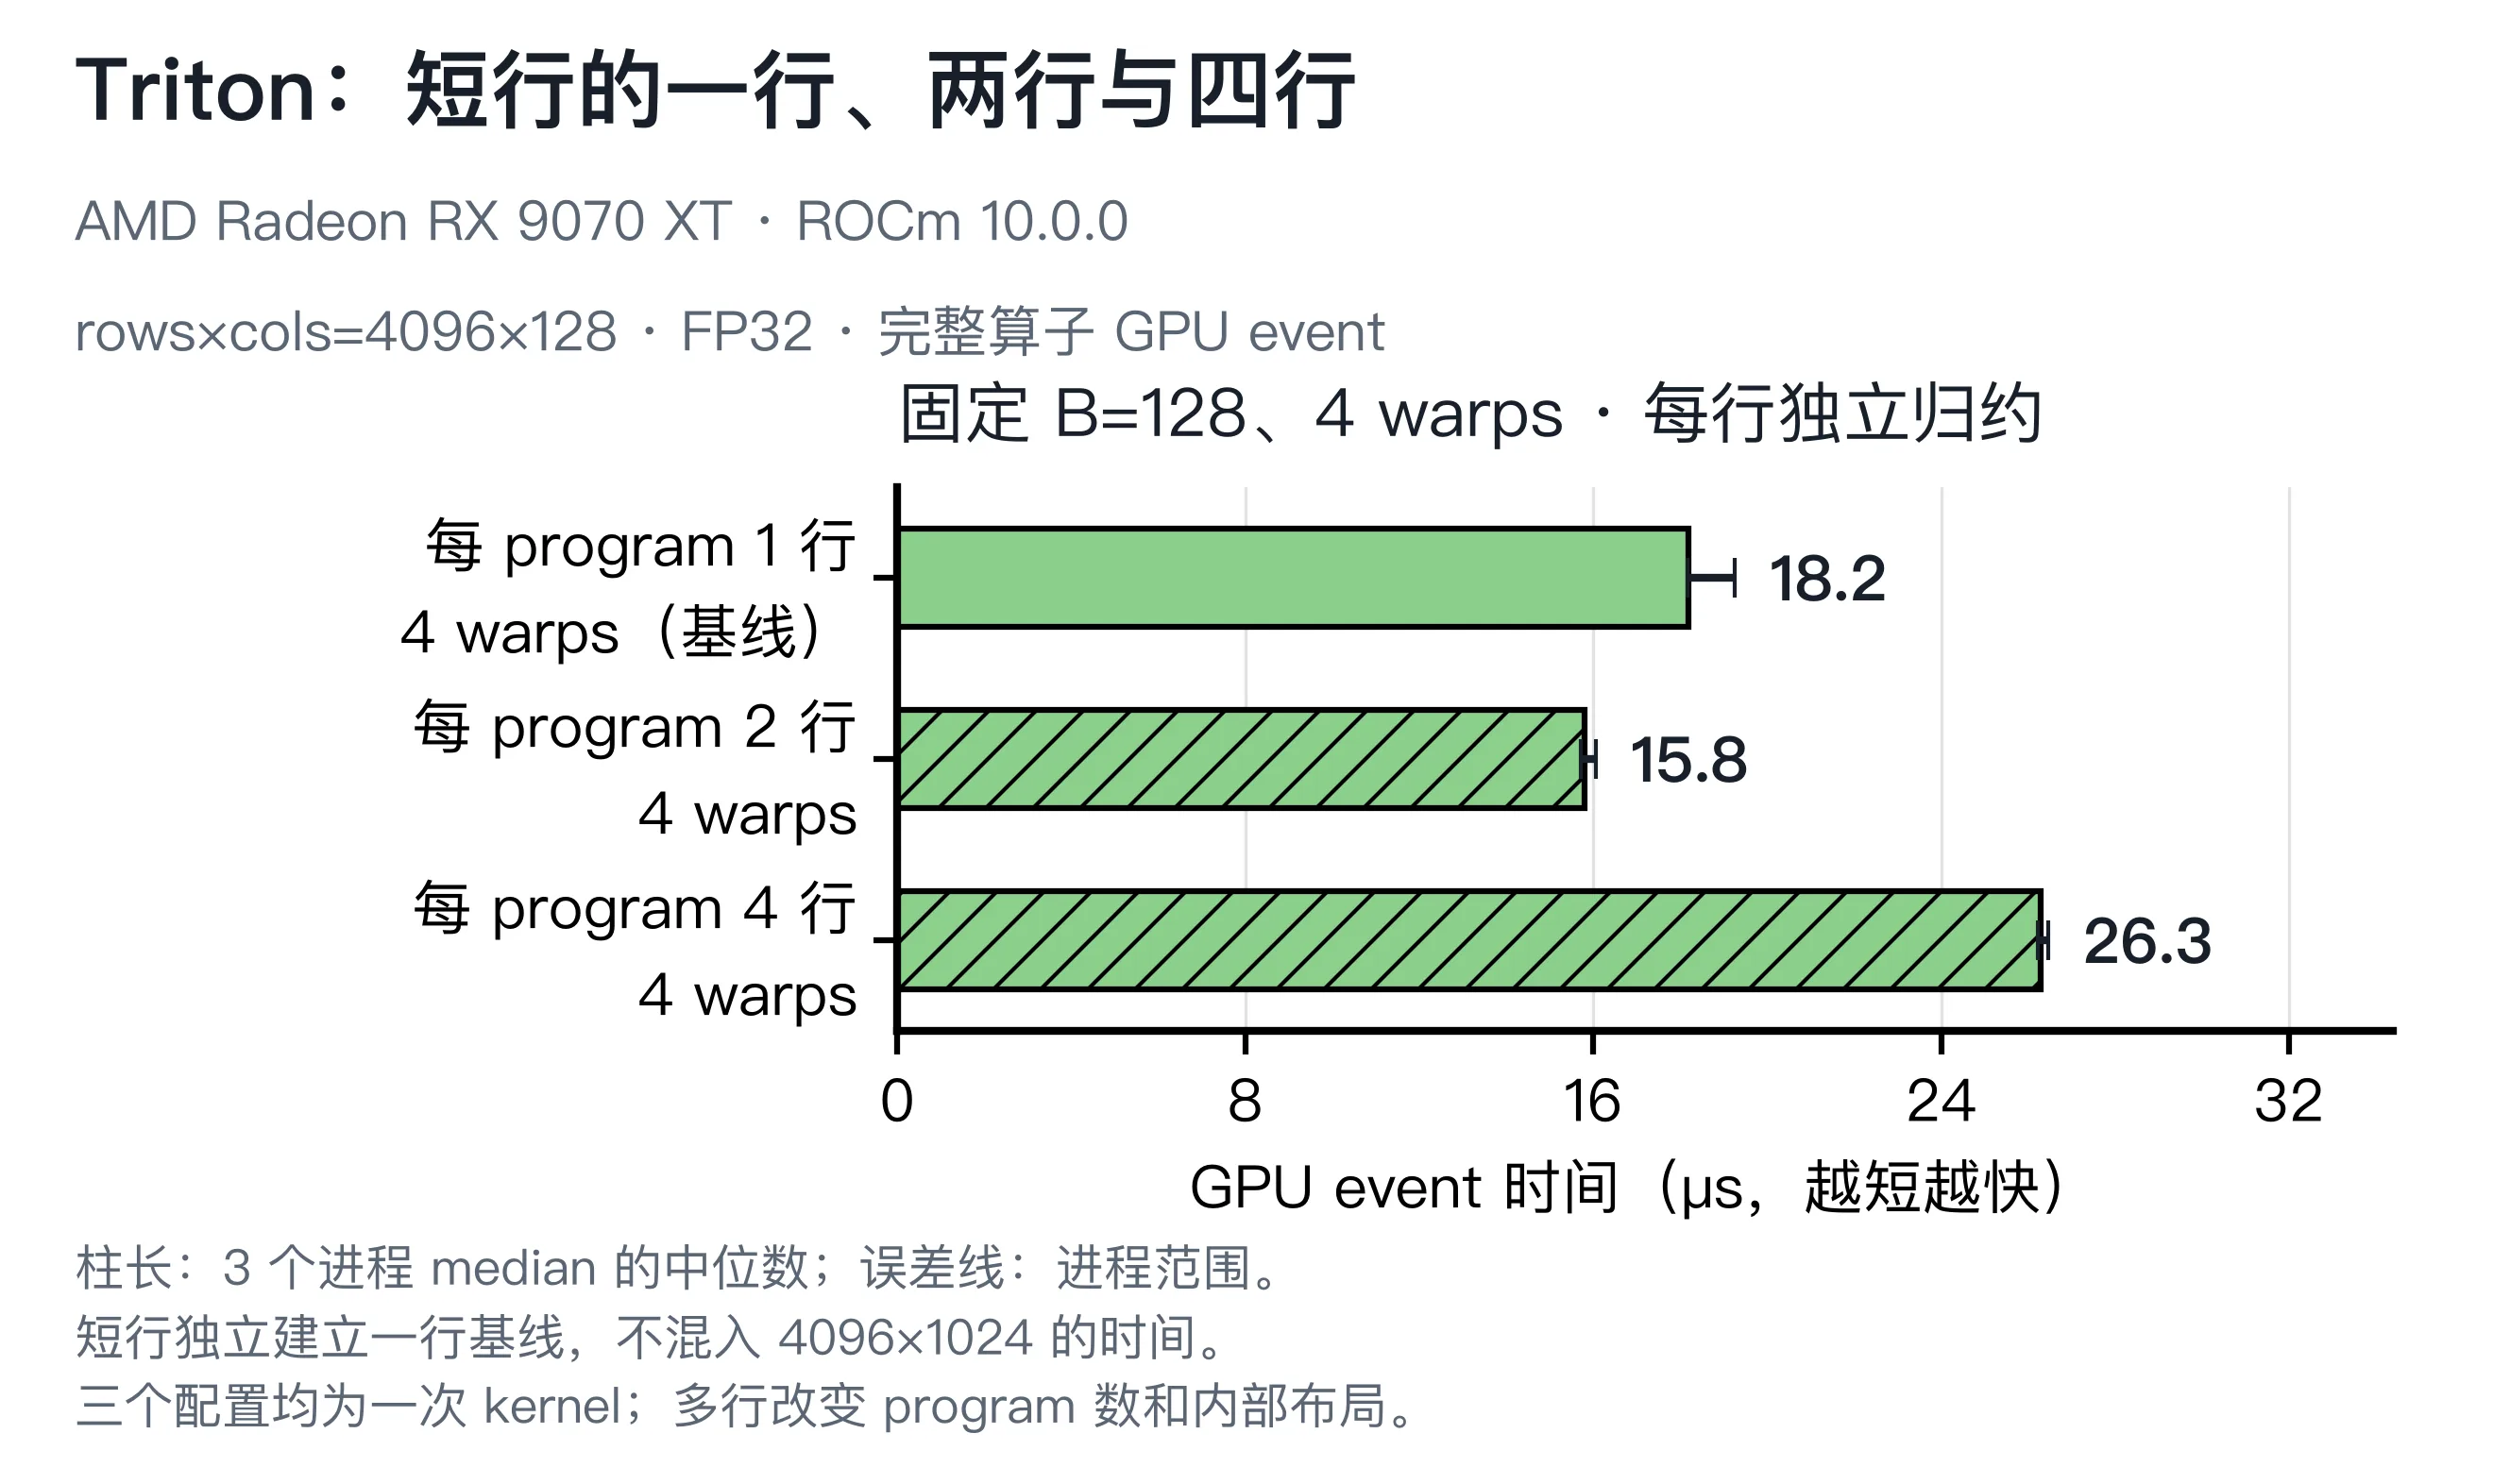
| 短行 Triton 多行配置 | 一行/B128/4 warps | 采用2行/program;4行的完整event退步,设备trace未显示相同排序 |
| 附形状是否沿用配置 | 各 shape 自己的基线 | 不能直接迁移:少行输入HIP排序反转,1025列时Triton warps排序反转 |
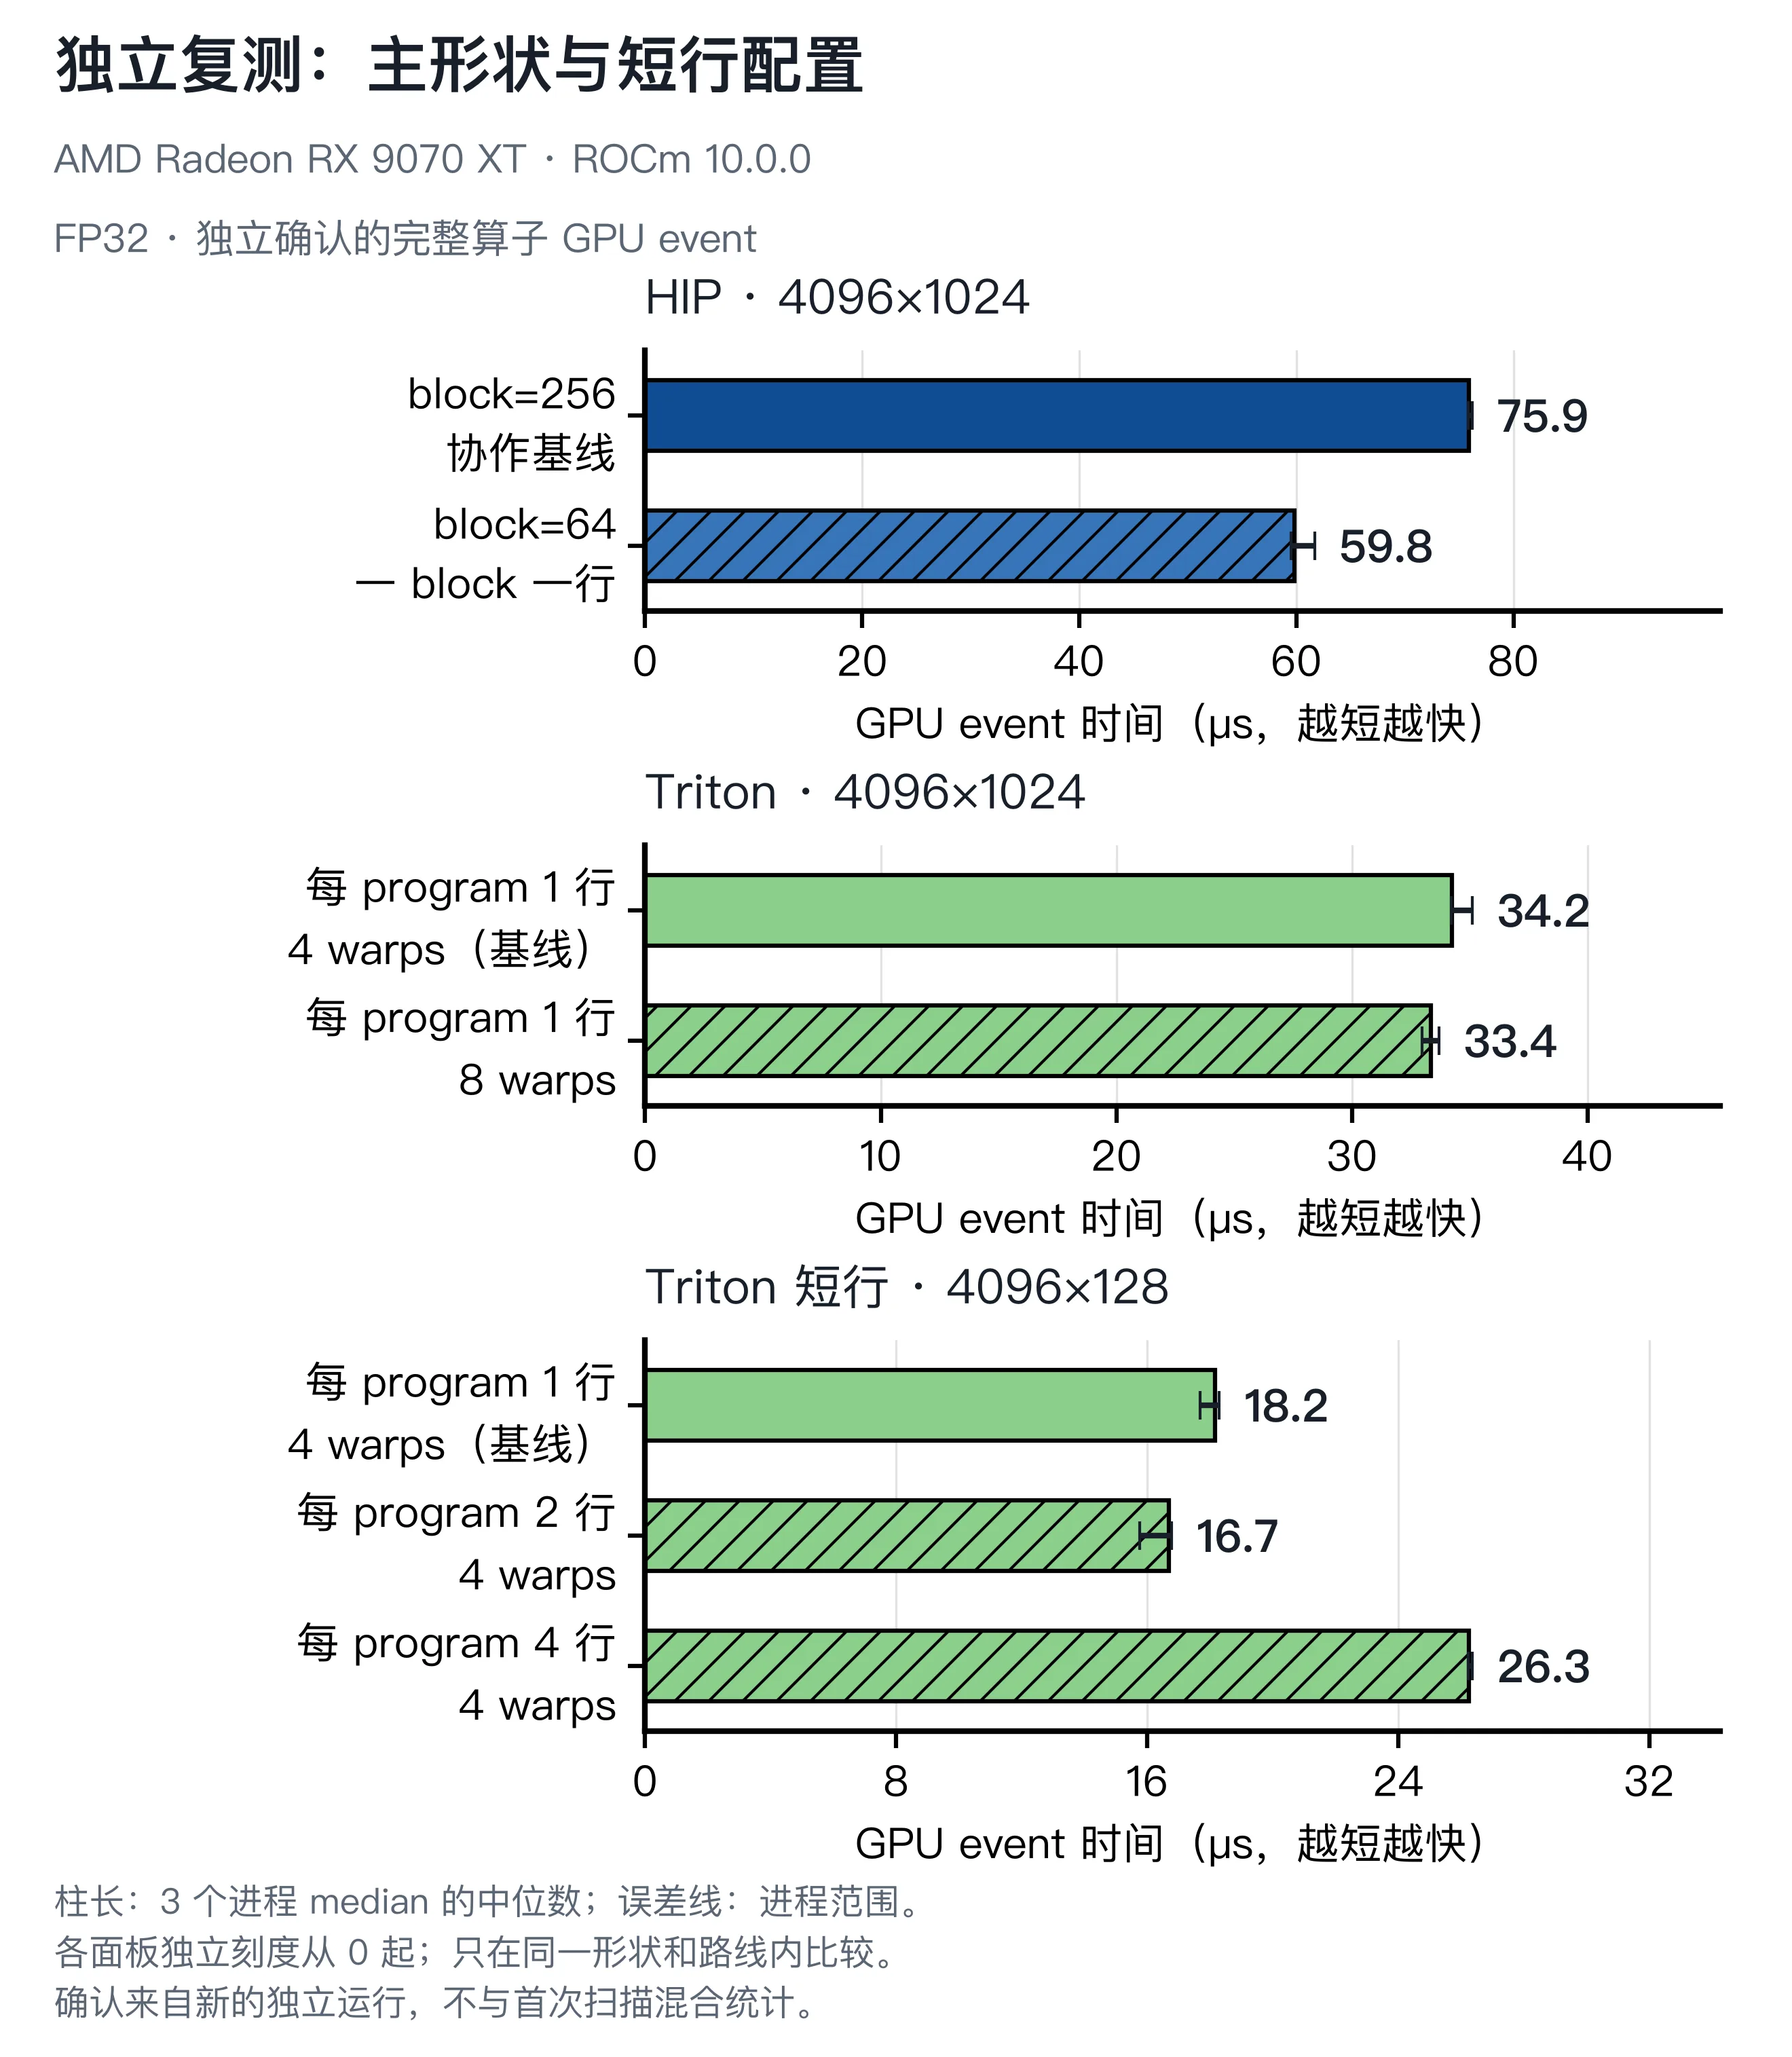
图 13.9 主形状确认HIP block256/64、Triton单行4/8 warps;短行确认1/2/4行program。各项三个新进程,合计21个进程、1050个样本,各面板标明形状与独立刻度。
确认结果支持本章做出的三项配置决策,但没有将其合并回主扫描数据集,也没有将短行完整 event 的相对排序直接等同为底层 kernel trace 的硬件执行时间排序。两种口径保留不同信息,恰好提示下一轮要控制和检查什么。
本章不必给每个候选都追加一次 profiler。block 和 warps 的选择先由完整算子时间与独立确认判断;短行结果留下了计时口径的疑问,才使用三份 trace 继续检查。尚未分离的原因继续作为假设,不用相同资源字段替它作解释。
如果希望一次完成主形状的三进程采样和比较图,使用批量入口。仍在已经激活环境的 code/part2-kernels/ 中,沿用前面准备的 $RUN。批量入口使用尚不存在的 $RUN/rounds 子目录;它会自行冻结源码、编译,并保存新采集的原始样本:
test -d "${RUN:?请先准备本章环境与结果目录}/build" && \
python chapter13/run_rounds.py --output "$RUN/rounds" --phase main && \
python chapter13/plot_rounds.py \
  --evidence "$RUN/rounds/summary" --out-dir "$RUN/figures/main" \
  --round cooperative --round block --round warps
main 显式使用 rows=4096,cols=1024,先完成 128 项边界检查,再测 HIP 公式版本、三个 block 配置和 Triton 单行 4/8 warps。每项三个独立进程,预热 10 次、采样 50 次;它会轮换候选顺序。上述三张图只读取本次主阶段的六组结果,不要求预先运行 validation 或 profiler。
想检查短行分组和另外两种形状时,再对同一轮运行 validation:
python chapter13/run_rounds.py --output "$RUN/rounds" --phase validation && \
python chapter13/plot_rounds.py \
  --evidence "$RUN/rounds/summary" --out-dir "$RUN/figures/validation" \
  --round rows --round shapes
这一步增加 4096×128 的三种行分组,以及 128×1024、4096×1025 各五种候选。它使用原冻结源码和配置,在运行前检查身份与环境。两条绘图命令都显式使用本轮 summary,不会用仓库里发布的旧测量替缺失项目补值。
需要验证某次选择是否稳定,再创建独立确认组。主形状默认保留 HIP block256 基线、最快 block 及距最快不超过 5% 的候选,再加入 Triton 单行 4/8 warps,重复项只运行一次:
python chapter13/verify_rounds.py \
  --frozen-run "$RUN/rounds" --output "$RUN/confirmation-main"
短行确认须先完成对应的 validation,才能选择父实验中实际测过的三种配置:
python chapter13/verify_rounds.py \
  --frozen-run "$RUN/rounds" --output "$RUN/confirmation-short" \
  --shape 4096x128 --configs triton-r1-w4 triton-r2-w4 triton-r4-w4
确认结果分别保存在各自目录的 summary/summary.csv、summary/process-summary.csv 和 confirmation.json。先在同一形状内比较新旧进程范围,判断选择是否保留。确认数据不会自动写入父目录的 summary,因此前面的绘图命令只画扫描结果;不要把仓库中的确认 JSON 复制进新目录来补图。
短行的按需 trace 命令已经放在 Triton 路线 的退步案例后。批量 --phase profile 还会采主形状六项和短行三项,只有需要完整 trace 矩阵时再使用它,不是完成主实验的前提。
每一轮的 samples/ 保存逐次时间,logs/ 保存检查和终端输出,source/ 保存本轮源码,profiles/ 保存 trace,commands.jsonl 保存实际命令。summary.csv 汇总配置,process-summary.csv 保留独立进程范围;计时和检查失败时不会用已有发布成绩代替。
本章图表均来自 RX 9070 XT(gfx1201)、ROCm SDK10.0.0、HIP7.15.26333、原生 Ubuntu24.04.5、PyTorch2.13.0+rocm10.0.0、Triton3.8.0 的实测。GPU 非独占、不锁频,每轮重用数组、不主动刷缓存。正文折叠输出是对应配置第 1 个进程的原始终端记录;图和独立确认的来源见 chapter13/evidence/rounds/,短行 CSV 与阅读报告见 chapter13/evidence/walkthrough/。
可以按以下顺序完成练习:
w[2] 从 2 改为 1,说明为什么该行尺度不变。rows=33, cols=129, R=4,画出最后一个 program 的行列 mask;指出 tl.sum 必须沿哪个轴归约。RMSNorm 把逐元素计算、归约、广播和融合放进了同一条数据流。实现之后,还需要为工作量选择分工:一行由多少线程合作,一个 program 处理多少行。先建立可检查的基线,再逐轮保留有证据支持的改动,这套方法可以带到下一种算子。