外观
第3章补充:执行资源与访存实验
理解读取、共享与同步后,可以结合具体程序进一步研究资源限制和访问模式。建议先完成第 4 章的完整程序,并学习第 5 章的计时方法,再阅读本页的实验。
资源概念用于解释程序行为,性能表则各自注明采集时的环境。历史结果保留原版本,不能视为当前 ROCm 10.0 环境的复测结果。
执行资源与占用率
一个 wavefront 发出了读取请求,下一步需要的数据却可能尚未返回。如果计算指令必须使用这个值,它就需要等待。此时,硬件不一定只能空闲:若另一个 wavefront 已准备好执行,就可以先安排它的指令。
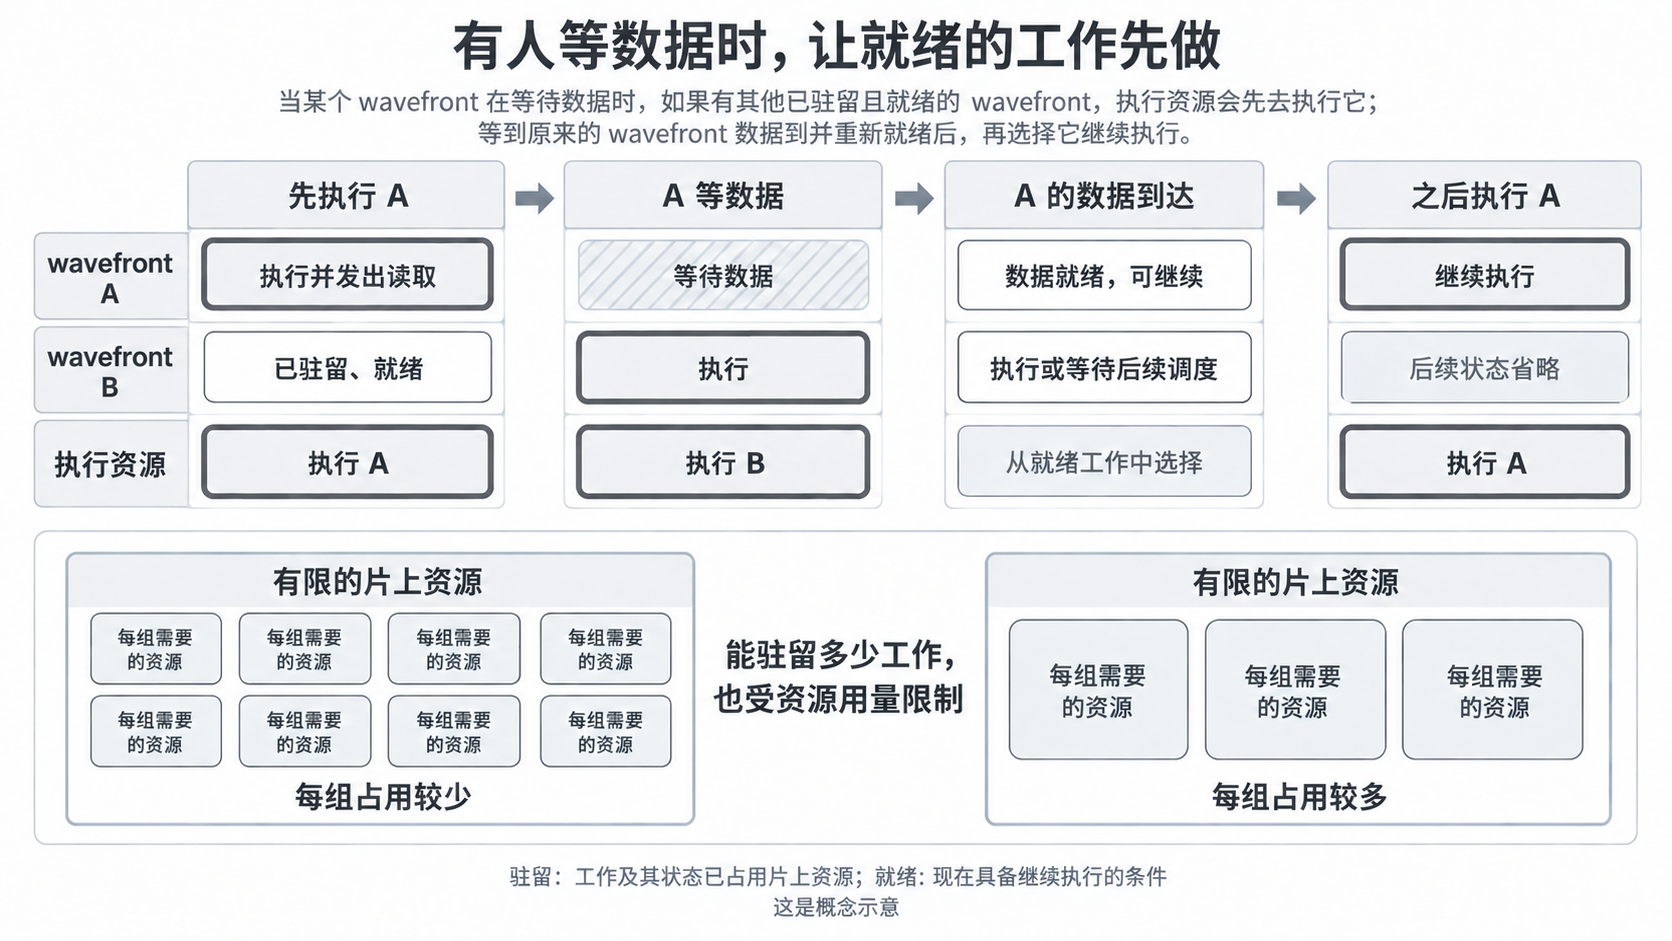
图 3.1 A 等待数据时,其他已就绪的工作可以获得执行机会。图中的步骤不等长,也不保证每次等待时都有其他 wavefront 可执行。
图 3.1 中,A 取数据的时间没有消失,但计算资源在这段时间里用于 B 的工作。这叫延迟隐藏(Latency Hiding);如果没有其他就绪工作,执行资源仍可能空闲。AMD GPUOpen:Occupancy explained
这时再区分三种状态,就容易理解“保留着一份工作”和“正在执行它”之间的差别:
| 状态 | 可以怎样理解 |
|---|---|
| 驻留(Resident) | 工作已经获得相应片上资源,状态保留在硬件中 |
| 就绪(Ready / Eligible) | 满足继续执行所需的条件,可以被选择 |
| 执行(Executing) | 当前获得了执行机会,正在发射或执行相应指令 |
一个 wavefront 可以已经驻留,却仍在等待数据;就绪的 wavefront 也要等待调度机会。因此,提交了很多线程或保留了很多 wavefront,不等于每一刻都有同样多的工作在有效计算。
保留一份工作,就要保留它的临时值和执行状态。寄存器与 LDS 都在 GPU 芯片内部,是有限的片上资源(On-Chip Resources)。当每份工作需要的资源变多,同时能够容纳的工作就可能减少。真实硬件还受分配粒度、工作组大小和槽位上限等因素限制,不能用总容量简单相除,就当成某个 kernel 的精确并发度。
占用率(Occupancy)描述驻留 wavefront 占可用 wavefront 槽位的程度,具体统计时要说明目标硬件、范围以及理论值或运行时测量口径。它关心能驻留多少工作,与计算单元有多少时间正在执行指令是不同的指标。
占用率较高,可能提供更多可选择的工作,但不保证程序更快。如果所有 wavefront 都在等同一类受限资源,增加驻留也未必有帮助。反过来,在寄存器中多保留一些可复用数据,虽然可能减少驻留数量,却也可能减少重复读取。收益需要用实际耗时判断。
寄存器与存储使用范围
上一章说过,同一 wavefront 的 lane 可以读取不同输入。因此,硬件需要为各 lane 保存不同的临时值,这与向量通用寄存器(Vector General-Purpose Register,VGPR)有关。这里的“向量”可以理解成:同一寄存器编号下,包含分别对应不同 lane 的分量,而不是所有 lane 被迫使用同一个数。
也有一些信息可以由整个 wavefront 共同使用,例如某个数组的共同基址。保存这类标量状态的,是标量通用寄存器(Scalar General-Purpose Register,SGPR)。基址就是“数组从哪个地址开始”,各线程再结合自己的下标找到对应元素。
用工作台来比,VGPR 对应各 lane 手边不同的临时材料,SGPR 对应同一 wavefront 共同使用的一份信息。这里的“共用”描述硬件状态,不是让程序随意把一个线程的局部变量交给另一个线程读取。
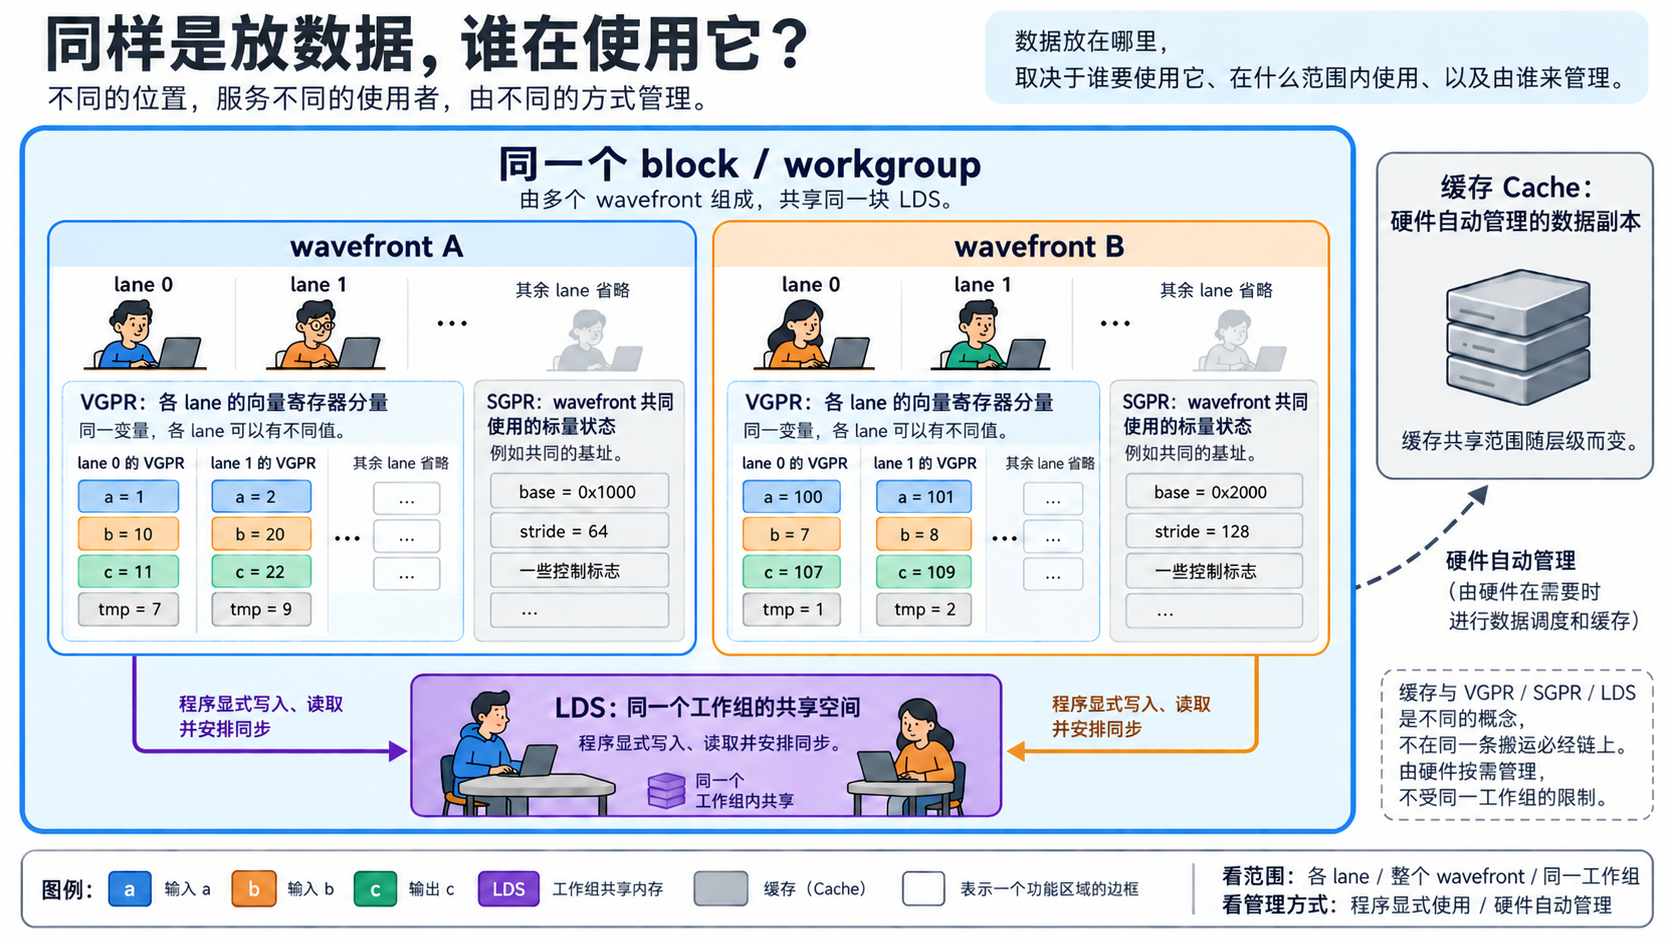
图 3.2 本例展示同一工作组中的两个 wavefront,比较各 lane、wavefront 和工作组的存储使用范围。各区域不是依次经过的站点,LDS 也不是全局内存访问必经的一层缓存。
观察 图 3.2 时,分别看哪些信息属于 lane、wavefront 和 block。图中的位置是用途与范围的示意,不能据此把全局数组的每次访问串成一条必经所有区域的路径。
查 gfx1201 规格时,你会遇到向量/标量 L0、L2、Infinity Cache 等名字。先知道它们属于不同层级即可;本章不要求记住每一级容量。寄存器驻留、LDS 访问和全局访存,也不能串成一条统一的“寄存器→LDS→缓存→显存”链。
读取硬件容量表时,要连同统计范围一起读:整卡、WGP、CU、SIMD 或每个工作组的上限不是同一个口径。容量不直接等于带宽,也不能用一串容量数字推算某次访问的延迟。ROCm GPU specifications
当某些临时值无法继续放在寄存器中时,编译器可能安排额外的存取,这类情况称为寄存器溢出(Spill);相关私有存储常通过 scratch 路径访问。它可能增加访存,具体是否发生、增加多少,需要看编译资源报告与指令。
在 RDNA 的占用率说明中,SGPR 有其固定分配特点,不能把它与 VGPR、LDS 画成完全对称、可简单按用量推算的三种限制。初学时先关注每组工作占用的 VGPR、LDS、硬件槽位及工作组大小;准确约束仍需按目标核对。AMD GPUOpen 占用率说明
全局地址排列实验
本节保留 Radeon RX 9070 XT + ROCm 7.13 + 原生 Ubuntu 24.04 的历史实验汇总;当前安装基线为 ROCm 10.0,以下记录不代表在新环境下重新测得的结果。
接下来用一个比加法更简单的任务做对照:从输入数组读一个元素,再写到输出数组。写入位置保持为连续的 output[tid],只改变读取的下标排列。这样可以比较不同读取排列的表现。不同步长也会改变输出元素的排列,代码按各自的排列校验;它不是保持同一输出不变的等价优化。
以下是 global_memory_access.hip 中的核心代码:
cpp
template <unsigned Stride>
__global__ void gather_copy(
    const float* input, float* output, std::size_t n
) {
    std::size_t tid = blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < n) {
        std::size_t source = (tid * Stride) & (n - 1);
        output[tid] = input[source];
    }
}
你已经认识 tid 和边界判断。新出现的 Stride 是读取步长:Stride=1 对应相邻下标,17 或 257 会让同一 wavefront 内的读地址更分散。末尾的 & (n - 1) 用来把下标绕回数组范围;这里要求 n 是 2 的幂,回绕下标的前提在命令后解释。
输入有 16,777,216 个 FP32 元素,预热 10 次、计时 50 次,数据来自 3 个独立进程:
| 读取步长 | 时间中位数(ms) | 逻辑有效带宽(GB/s) |
|---|---|---|
| 1 | 0.235 | 571 |
| 17 | 0.772 | 174 |
| 257 | 1.89 | 71.1 |
先看时间列:这次实验中,分散读取更慢。再看最后一列,它描述的是程序每秒完成了多少有用的读写工作。本实验每个元素读一次、写一次,所以逻辑有效带宽按 2 × N × sizeof(float) / 时间 计算。
逻辑有效带宽不是物理显存流量。 缓存可能提供一部分数据,底层也可能为了取出所需元素而搬运更多字节。表格支持“这组访问模式的性能不同”,没有直接测出到底发生了多少条物理事务。后面学习 Element-Wise 时,我们会继续用这种区分分析真实算子。
在原生 Ubuntu 实验机按第 1 章同步并激活本篇环境后,从仓库工作目录进入实验目录:
bash
cd code/part0-intro/chapter3
hipcc --offload-arch=gfx1201 -O3 -std=c++17 global_memory_access.hip -o global_memory_access
# --implementation all 会依次跑 stride-1 / stride-17 / stride-257
./global_memory_access --implementation all --size 16777216 --warmup 10 --repeat 50
--size 是元素数量,--warmup 是预热次数,--repeat 是正式测量次数。命令执行一次会在一个进程中比较三种模式,正文则汇总了三个独立进程。
当 n 是 2 的幂、下标是非负整数时,保留最低若干位的 & (n - 1) 可以实现对 n 取模。程序会检查这一前提。本实验选用的步长为奇数,配合 2 的幂长度可以遍历整个输入;不要把这种写法不加检查地套到任意数组长度。
三种模式的进程中位数范围分别为 0.232~0.238 ms、0.770~0.772 ms、1.88~1.92 ms。未取整的数据在 summary.csv,源码版本与测量记录摘要在 manifest.json。
现存证据保留三进程的统计汇总、来源提交与日志哈希,未包含原始逐次日志。这里按已有汇总解释结果,不据此新增物理流量、缓存命中率或事务数量的结论。
LDS 访问模式实验
本节保留 Radeon RX 9070 XT + ROCm 7.13 + 原生 Ubuntu 24.04 的历史实验汇总;当前安装基线为 ROCm 10.0,以下记录不代表在新环境下重新测得的结果。
LDS 解决了共享位置的问题,但不同地址在硬件上如何分配,也会影响访问表现。
LDS 内部把存储划分为可以并行服务访问的存储体(Bank)。可以把它想成多个服务入口:请求分散到不同入口时,有机会同时处理;同一批请求若访问映射到同一 bank 的不同地址,就可能发生竞争。这类访问冲突叫 bank 冲突(Bank Conflict)。AMD RDNA 性能指南
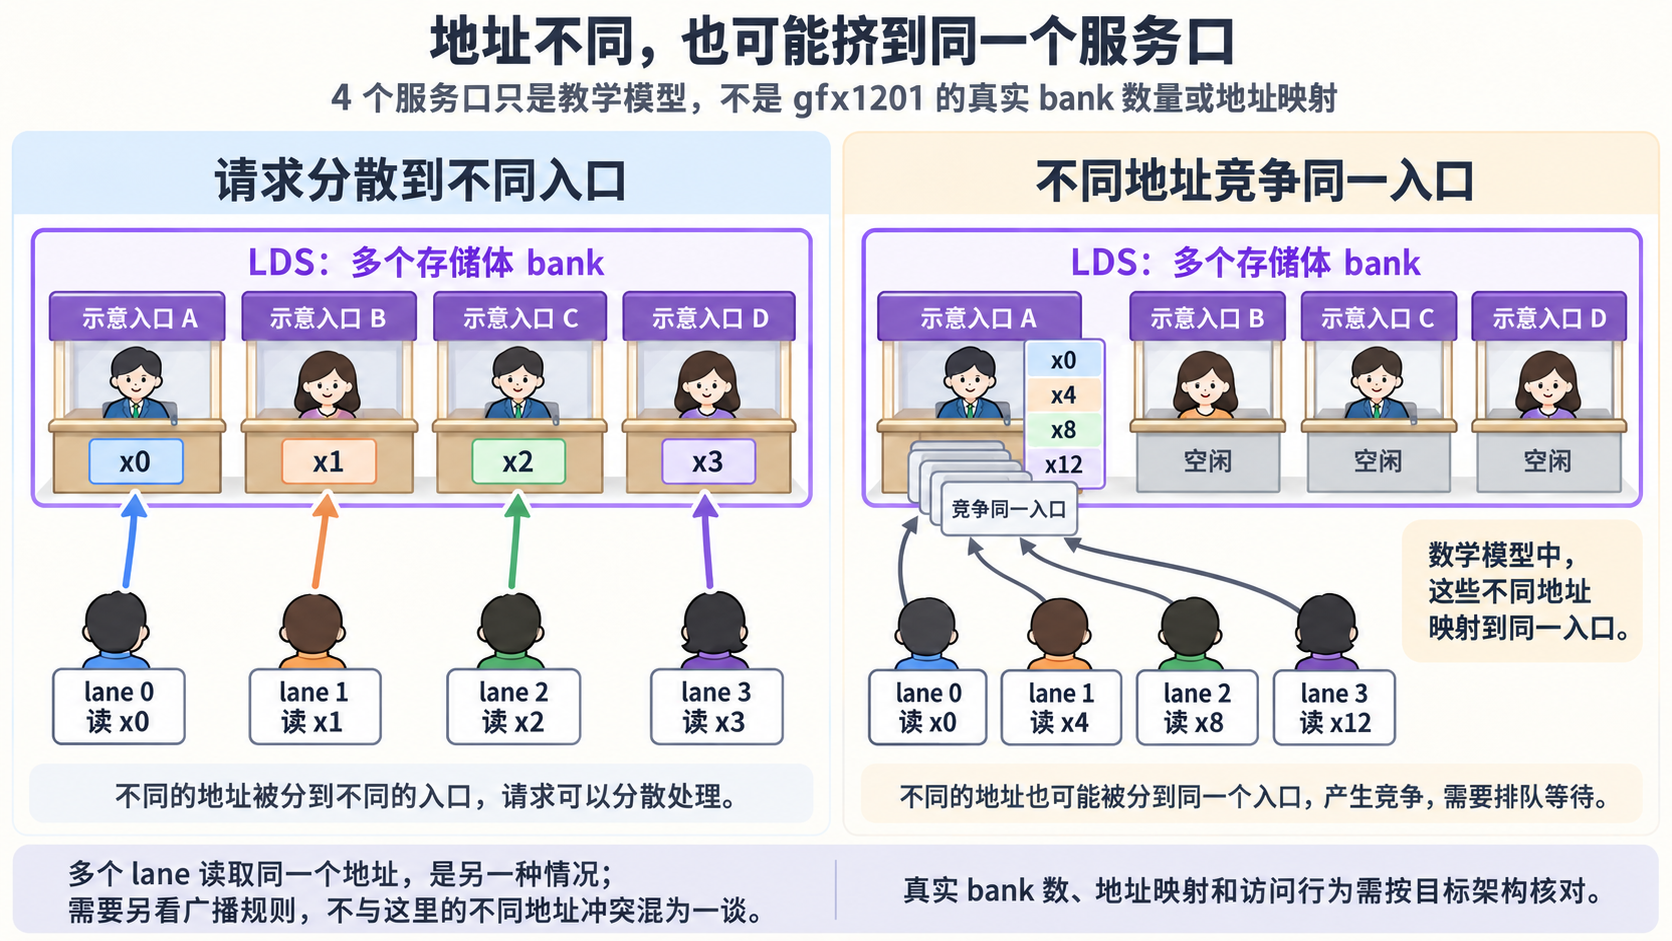
图 3.3 bank 冲突的服务入口类比。这里没有规定 gfx1201 的 bank 数、地址取模公式或每周期服务能力。
图 3.3 说的是不同地址竞争同一 bank。多个 lane 恰好读取同一个地址,是需要另外看广播规则的情况,不能一律画成“所有人排队读一次”。
它与第 3 章 3.2 节的合并访存也不同:合并访存先看全局地址请求是否集中,bank 冲突看的是 LDS 内部的地址映射。两者都提醒我们关注同一 wavefront 的地址排列,但不是同一层机制。
看本章已有的 lds_bank_conflict.hip,写入共享数组的部分如下:
cpp
    for (unsigned int offset = threadIdx.x; offset < kSharedElements;
         offset += kBlockSize) {
        shared[offset] = shared_value(offset);
    }
    __syncthreads();
每个线程从自己的块内编号开始,间隔 kBlockSize 填写后续位置。比如前一个线程负责一组下标,后一个线程负责错开一位的下标,合起来覆盖共享数组。这里用 shared_value(offset) 生成确定数据来测试 LDS 访问,与第 3 章 3.3 节的局部和交接属于不同任务。随后所有线程到达同步点,再进入读取阶段。
写这类代码时,不能让一部分组内线程绕过一个其他线程需要到达的屏障。原实验把同步放在后面的越界退出之前,也是先让组内线程完成共享数组初始化。屏障不负责修复越界、覆盖写入等其他错误,数组位置仍要分配正确。
本章现有实验保持共享数组和读取循环不变,比较不同的索引步长。汇总条件为每块 256 个线程,每线程 256 次 LDS 读取,输入有 16,777,216 个 FP32 元素,预热 10 次、计时 50 次,汇总 3 个独立进程。
| LDS 读取步长 | 时间中位数(ms) | 这次对照的结果 |
|---|---|---|
| 1 | 8.08 | 基线 |
| 32 | 42.2 | 约为基线时间的 5.23 倍 |
| 33 | 8.09 | 中位数接近基线,进程范围更宽 |
计时围住的是整个 kernel:每块先初始化 33 KiB LDS 并经过屏障,随后各线程执行 256 次 volatile LDS 读取与有依赖关系的累加,最后写回。它不是只测一次 LDS 读取的延迟,时间差也不能全部解释为 bank 冲突。现存 profiling 汇总只有 dispatch 等记录,没有直接给出 bank 冲突或缓存行为的测量。
先读出这个有限结论:索引排布可以明显影响本实验的 LDS 访问表现。 这份时间表没有直接测出 bank 映射,不能把它改写成“gfx1201 一定有多少个 bank,所以必然慢几倍”。
在已激活本篇环境的原生 Ubuntu 实验机上,从仓库工作目录执行以下原有命令:
bash
cd code/part0-intro/chapter3
hipcc --offload-arch=gfx1201 -O3 -std=c++17 lds_bank_conflict.hip -o lds_bank_conflict
# --implementation all 会依次跑 stride-1 / stride-32 / stride-33
./lds_bank_conflict --implementation all --size 16777216 --warmup 10 --repeat 50
各步长的进程中位数范围分别为 8.07~8.10 ms、41.3~52.0 ms、6.57~8.10 ms。完整索引与循环在 lds_bank_conflict.hip,原始精度的汇总见 summary.csv。这些结果来自同一组三进程记录,单次执行以上命令不等于完成了这组统计。
WMMA 矩阵块实验
本节保留 Radeon RX 9070 XT + ROCm 7.13 + 原生 Ubuntu 24.04 的历史实验汇总;当前安装基线为 ROCm 10.0,以下记录不代表在新环境下重新测得的结果。
这部分为后面的矩阵乘章节建立入口,可以学完矩阵乘再回看。
数组加法让各线程分别完成独立元素。矩阵乘则不同:一个输出元素需要把输入矩阵对应的一行与一列逐项相乘,再加起来;整块输出中又会反复使用输入数据。
除了普通的向量算术指令,RDNA 4 还提供wavefront 矩阵乘加(Wave Matrix Multiply-Accumulate,WMMA)指令。它把一小块矩阵运算交给整个 wavefront 协作完成,输入和输出分布在参与 lane 的寄存器中。理解它时,要从整个 wavefront 共同处理的矩阵块来看,而不能只盯着一个线程。
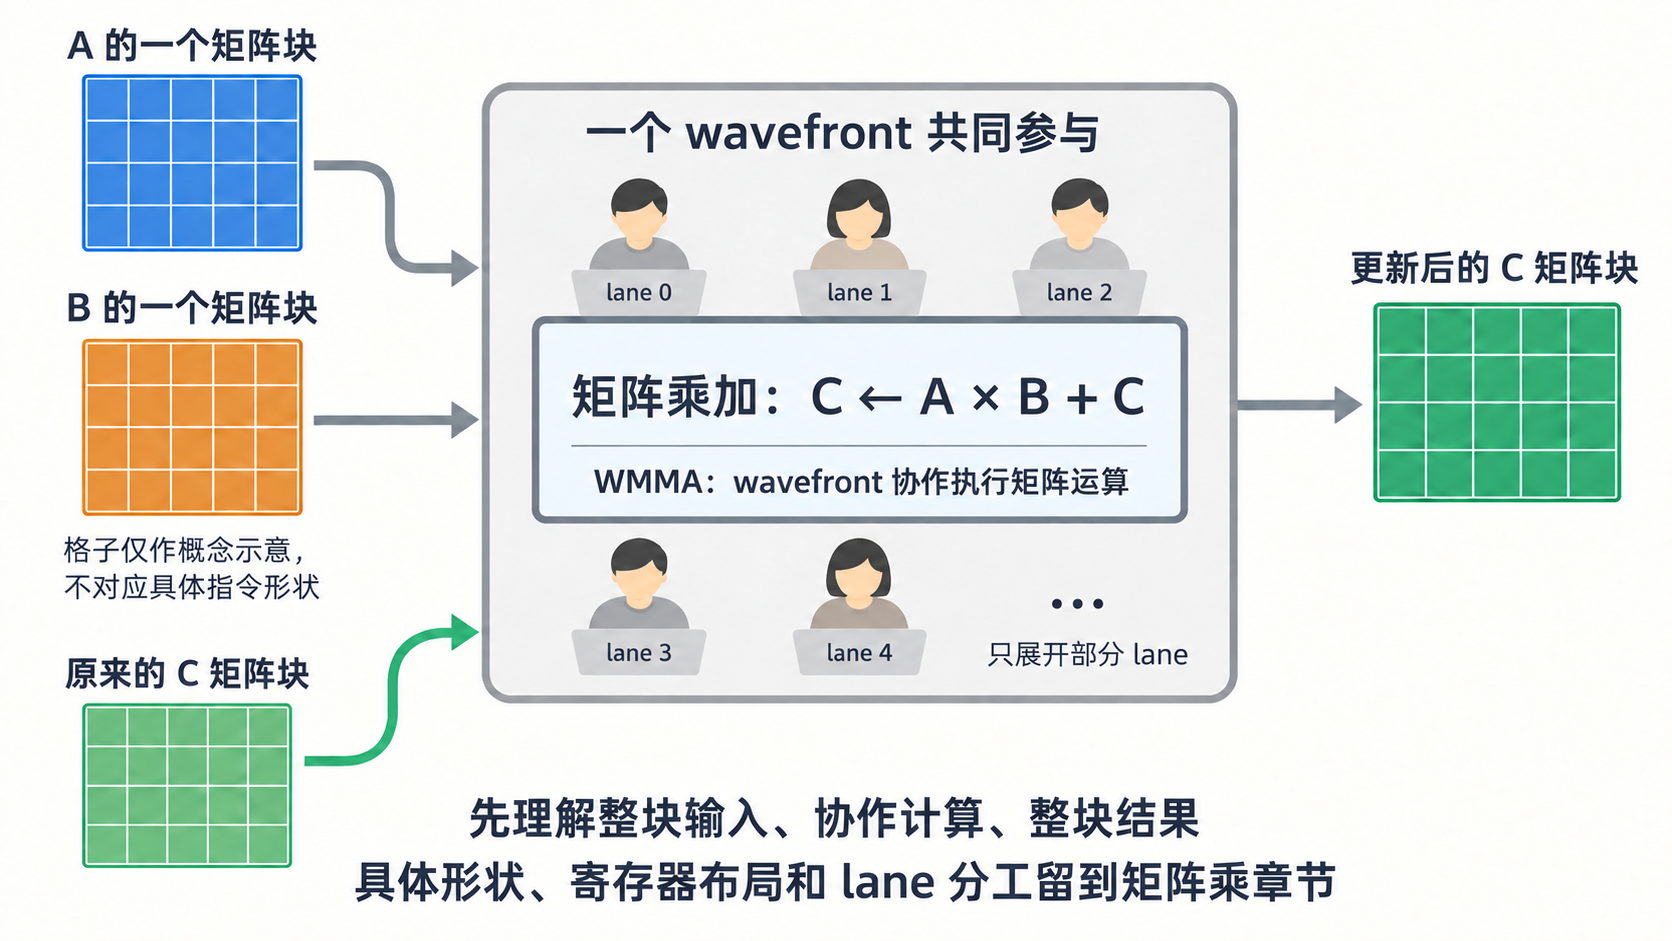
图 3.4 WMMA 的整块数据视角。图没有规定某个 lane 持有哪几个元素,具体布局取决于所选指令。
图 3.4 先回答“共同计算什么”。至于矩阵块多大、各 lane 怎样提供输入、怎样存回结果,要服从具体指令的约定。这些细节需要建立矩阵乘和数据布局基础后再展开。GPUOpen:RDNA 4 矩阵指令
本章 rdna4_wmma.hip 比较一批独立的 16×16×16 小矩阵乘。普通向量算术路径(VALU)每块有 256 个线程,每个线程计算一个输出元素;WMMA 路径每块有 32 个线程,由一个 wave32 协作。这个“一线程一输出”只是当前基线的写法,不是 VALU 的普遍限制。
汇总条件为批数 4,096,FP16 输入、FP32 累加与输出,预热 10 次、计时 50 次,汇总 3 个进程:
| 路径 | 时间中位数(ms) | 进程中位数范围(ms) |
|---|---|---|
| VALU | 0.0372 | 0.0361~0.0383 |
| WMMA | 0.0162 | 0.0161~0.0162 |
按未取整结果计算,本次 WMMA 路径的吞吐约为基线的 2.30 倍。两版的线程数、数据布局和执行方式都不同,因此只能说明两个完整教学实现的差异,不能当成只替换一条指令的对照,也不是生产矩阵乘库的成绩或这张卡的理论峰值。
复跑沿用以下命令,在原生 Ubuntu 实验机激活本篇环境后,从仓库工作目录执行:
bash
cd code/part0-intro/chapter3
hipcc --offload-arch=gfx1201 -O3 -std=c++17 rdna4_wmma.hip -o rdna4_wmma
# --implementation all 会依次跑 valu 和 wmma 两条路径;--size 是矩阵批数
./rdna4_wmma --implementation all --size 4096 --warmup 10 --repeat 50
这里的 --size 是独立小矩阵乘的批次数,不是矩阵边长。具体使用的 gfx12 intrinsic、各 lane 的输入输出布局和 CPU 参考校验都在源码里;完整汇总在 summary.csv。初次阅读先留到 GEMM-Like 再看即可。