⚡ DeepSeek-V4-Flash - Strix Halo 原生 HIP 部署

本节介绍如何在 AMD Ryzen AI MAX+ 395(Radeon 8060S,gfx1151)+ 128 GB 统一内存 上,用 Luce-Org/lucebox 的 dflash_server 部署 DeepSeek-V4-Flash(下文称 DS4),并提供 OpenAI 兼容接口。
前置条件:已完成 ROCm 基础环境安装。本教程实测环境为 Ubuntu 24.04 + ROCm 7.1.0,GPU 性能档
high(sclk 2900 MHz)。
这不是 vLLM / 官方 llama.cpp / LM Studio 教程。DS4 的 ROCmFPX 权重和 sparse prefill 需要 lucebox 的 HIP 后端。
模型简介
DeepSeek-V4-Flash 是 DeepSeek 的 MoE 推理模型(43 层、MLA、256 路由专家)。在 Strix Halo 上常用的是 Lucebox 的 ROCmFPX MIX-STRIX 量化:稠密部分 Q4_0_ROCMFP4,专家 Q2/Q3 自适应,整包约 91.5 GiB,再加可选的 DSpark 草稿约 10 GiB。
| 项 | 值 |
|---|---|
| 权重 | Lucebox/DeepSeek-V4-Flash-0731-ROCmFP3 的 DeepSeek-V4-Flash-0731-ROCMFPX-MIX-STRIX.gguf |
| 草稿(可选) | Lucebox/DeepSeek-V4-Flash-0731-DSpark-GGUF |
| 运行时 | lucebox dflash_server,HIP / gfx1151,不要设 HSA_OVERRIDE_GFX_VERSION |
| 上下文 | 可开到 262144;本机实测 8K→256K decode 几乎不变 |
| 官方参考 | DeepSeek V4 Flash on Strix Halo |
内存门槛: 统一内存建议 ≥ 120 GiB。常驻约 97–103 GiB。它和下一篇 Qwen3.8-Flash-CIRU 不能同时开。
一、确认硬件与 ROCm
amd-smi
rocminfo | grep -A2 -E 'Name:|Marketing Name|gfx1151'应能看到类似:
MARKET_NAME: Radeon 8060S Graphics
TARGET_GRAPHICS_VERSION: gfx1151可选锁频(需要 sudo;官方 32 tok/s 配方的条件之一):
echo performance | sudo tee /sys/firmware/acpi/platform_profile
sudo rocm-smi -d 0 --setperflevel high确认 /opt/rocm/lib/llvm/bin/clang++ 存在,并且 没有 设置 HSA_OVERRIDE_GFX_VERSION(覆盖成 11.0.0 会走错 Tensile,sparse / DSpark 容易 abort)。
二、编译 dflash_server
mkdir -p ~/rocm-llm && cd ~/rocm-llm
sudo apt-get install -y cmake ninja-build git
# 若不想用 apt:python3 -m pip install --user ninja

git clone --depth 1 --recurse-submodules https://github.com/Luce-Org/lucebox.git
cd lucebox

export ROCM_PATH=/opt/rocm
export HIP_PATH=/opt/rocm
export PATH="/opt/rocm/bin:$PATH"
# 避开 conda 里的预览版 hipcc
unset HSA_OVERRIDE_GFX_VERSION

cmake -S server -B server/build-hip -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_HIP_COMPILER=/opt/rocm/lib/llvm/bin/clang++ \
  -DDFLASH27B_GPU_BACKEND=hip \
  -DDFLASH27B_HIP_ARCHITECTURES=gfx1151 \
  -DDFLASH27B_HIP_SM80_EQUIV=ON \
  -DCMAKE_HIP_FLAGS=-DDFLASH_WAVE_SIZE=32 \
  -DGGML_HIP_MMQ_MFMA=ON \
  -DGGML_HIP_NO_VMM=ON \
  -DGGML_HIP_GRAPHS=OFF

cmake --build server/build-hip --target dflash_server -j"$(nproc)"
./server/build-hip/dflash_server --help | grep -E 'ds4-prefill|ds4-fused-decode|ds4-expert'编译完成后应能看到 --ds4-prefill、--ds4-fused-decode、--ds4-expert-top-k。
三、下载权重
MIX-STRIX 主权重约 91.5 GiB,草稿约 10 GiB。国内可用 Hugging Face 镜像:
mkdir -p ~/models/ds4-flash/draft
export HF_ENDPOINT=https://hf-mirror.com
python3 -m pip install -q "huggingface_hub>=0.26"

python3 - <<'PY'
import os
from huggingface_hub import hf_hub_download

home = os.path.expanduser("~")
print(hf_hub_download(
    repo_id="Lucebox/DeepSeek-V4-Flash-0731-ROCmFP3",
    filename="DeepSeek-V4-Flash-0731-ROCMFPX-MIX-STRIX.gguf",
    local_dir=f"{home}/models/ds4-flash",
))
print(hf_hub_download(
    repo_id="Lucebox/DeepSeek-V4-Flash-0731-DSpark-GGUF",
    filename="DeepSeek-V4-Flash-0731-DSpark-draft-Q4RMFP4-denseF16.gguf",
    local_dir=f"{home}/models/ds4-flash/draft",
))
PY四、启动服务
日常建议:开 sparse prefill、expert top-4、关 DSpark。短回复 / 工具调用上投机解码的 verify 开销往往大于收益。
export ROCM_PATH=/opt/rocm
export HIP_PATH=/opt/rocm
export LD_LIBRARY_PATH=/opt/rocm/lib:/opt/rocm/lib64:${LD_LIBRARY_PATH:-}
export HIP_VISIBLE_DEVICES=0
export HSA_ENABLE_SDMA=0
export HSA_XNACK=1
unset HSA_OVERRIDE_GFX_VERSION

export DFLASH_DS4_SPEC=0
export LUCE_MMVQ_MAX_NCOLS=4

MODEL=~/models/ds4-flash/DeepSeek-V4-Flash-0731-ROCMFPX-MIX-STRIX.gguf

~/rocm-llm/lucebox/server/build-hip/dflash_server "$MODEL" \
  --host 127.0.0.1 --port 8000 \
  --target-device hip:0 \
  --ds4-fused-decode \
  --ds4-expert-top-k 4 \
  --ds4-prefill sparse \
  --chunk 2048 \
  --agent-turn-cache \
  --prefill-cache-slots 16 \
  --prefix-cache-slots 32 \
  --max-concurrency 1 \
  --max-ctx 262144 \
  --default-max-tokens 8192 \
--model-name DeepSeek-V4-Flash启动日志应出现 Device 0: ... gfx1151 且 prefill=sparse。加载权重需要一段时间(约十几分钟量级),请等端口起来再测。
不要加
--kv-cache-dir:deepseek4 后端快照只在内存,服务端会打印disk-cache disabled: backend snapshots are memory-only。重启后前缀全丢。
五、冒烟测试
curl -s http://127.0.0.1:8000/v1/models

curl -s -X POST http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "只回答:ok"}],
    "max_tokens": 16,
    "temperature": 0
}' | jq .应返回短文本,且进程不 abort。
六、本机测评结果
机器:Ryzen AI MAX+ 395 / Radeon 8060S(gfx1151),124.9 GiB 统一内存,ROCm 7.1.0,GPU high @ 2900 MHz。数字取服务端计时。
6.1 Decode:8K→256K 几乎是一条水平线
把 --max-ctx 从 8K 拉到 256K,短 prompt 输出 64 / 128 / 256 token,decode 稳定在 24.7–25.1 tok/s。
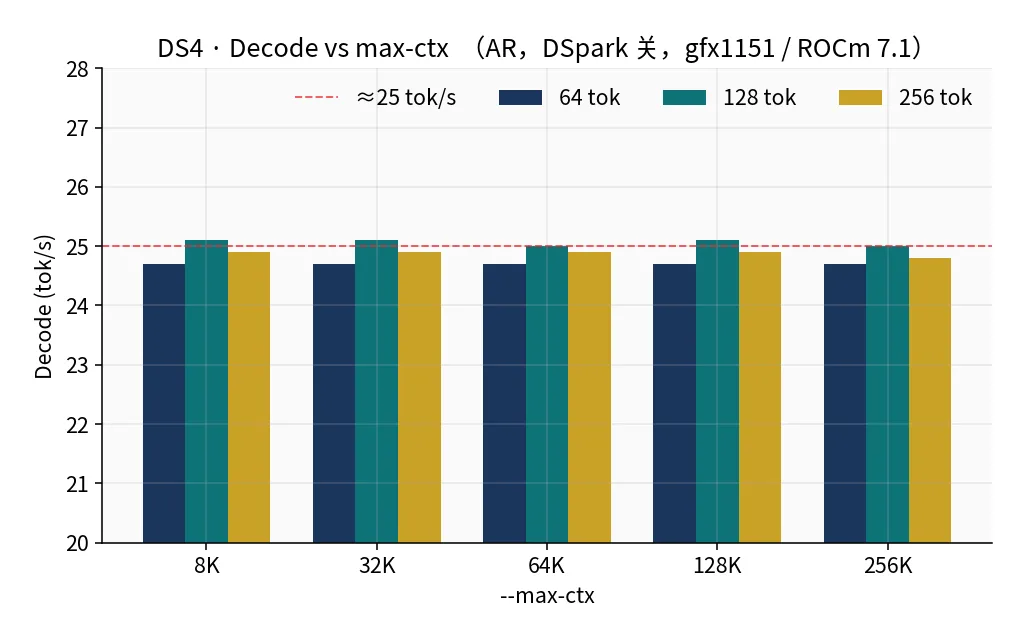
| max-ctx | 64 tok | 128 tok | 256 tok |
|---|---|---|---|
| 8K | 24.7 | 25.1 | 24.9 |
| 32K | 24.7 | 25.1 | 24.9 |
| 64K | 24.7 | 25.0 | 24.9 |
| 128K | 24.7 | 25.1 | 24.9 |
| 256K | 24.7 | 25.0 | 24.8 |
单位:tok/s。spec_decode_ran=false。日常可以一直开 256K,对当前负载没有速度代价。
6.2 Prefill:sparse 约 210–230 tok/s
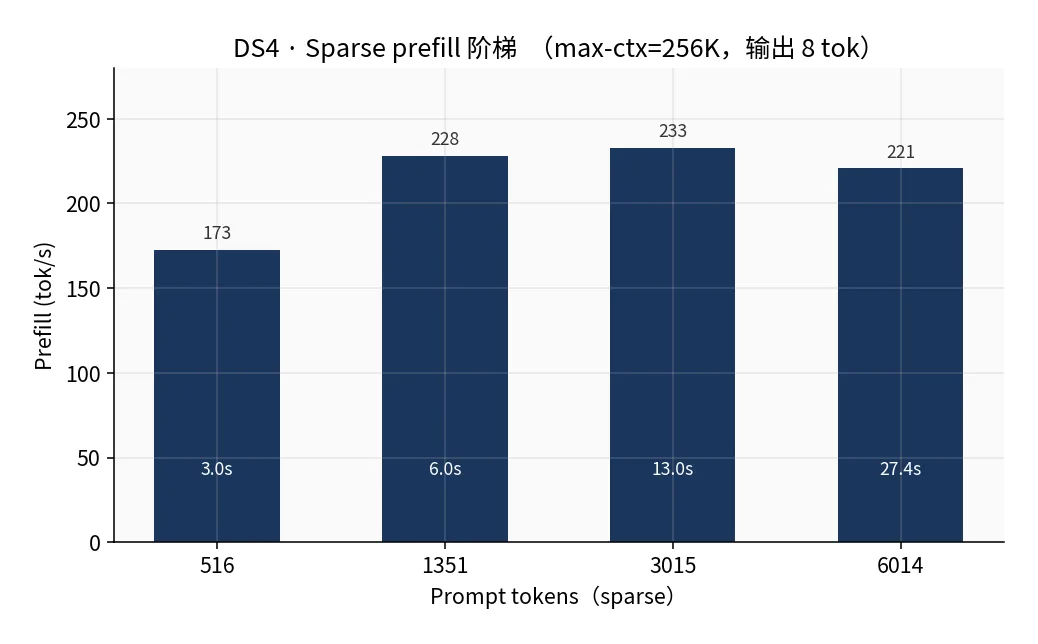
| Prompt | tok/s | 墙钟 |
|---|---|---|
| 516 | 172.6 | 3.05 s |
| 1351 | 228.2 | 6.00 s |
| 3015 | 232.8 | 13.04 s |
| 6014 | 220.7 | 27.36 s |
约 3K prompt 的流式首字 ≈ 13.1 s(等于整段 prefill,中间不提前吐字)。Docker exact 模式同长度大约 24 tok/s / 100 s,sparse 大约快一个数量级。
质量代价: sparse prefill + expert top-4 是近似计算。官方标注 adaptive 权重 top-4 时 exact-copy 约 60%。要绝对精确应改
--ds4-prefill exact,prefill 会掉回约 24 tok/s。
6.3 缓存:精确命中 0.09 s,但必须传 tools
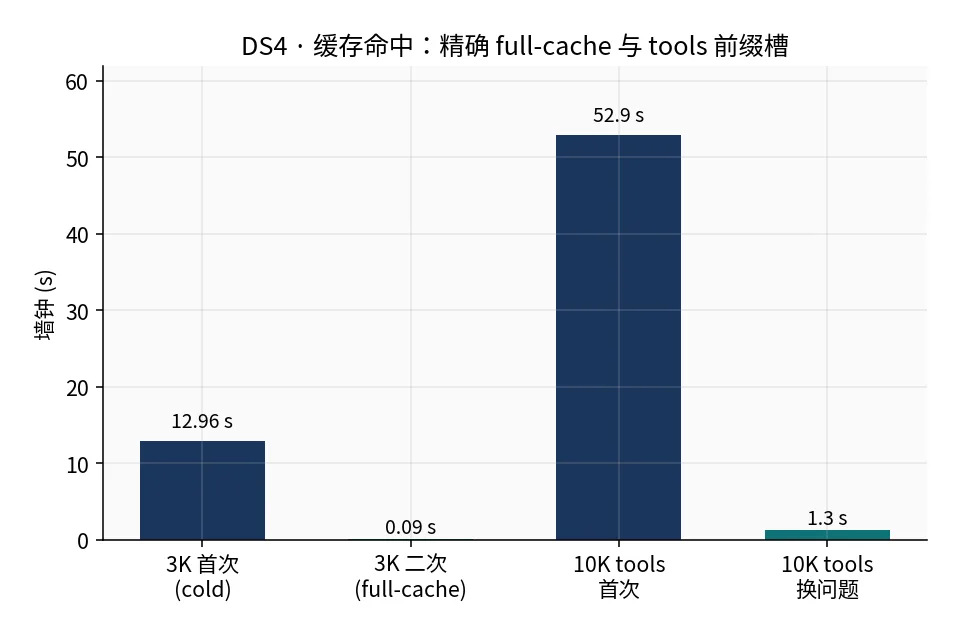
| 场景 | 冷 | 热 |
|---|---|---|
| 同一份 3K prompt 再发 | 13.0 s | 0.09 s |
| 10K tools 前缀追加 / 换问题 | 52.9 s | 1.3–2.4 s |
硬门槛: 请求必须带 OpenAI tools 数组。服务端只有 tools 非空才走 inline 前缀槽;把工具说明写进 system 文本、不传 tools,每一轮都是全量 prefill。
6.4 内存
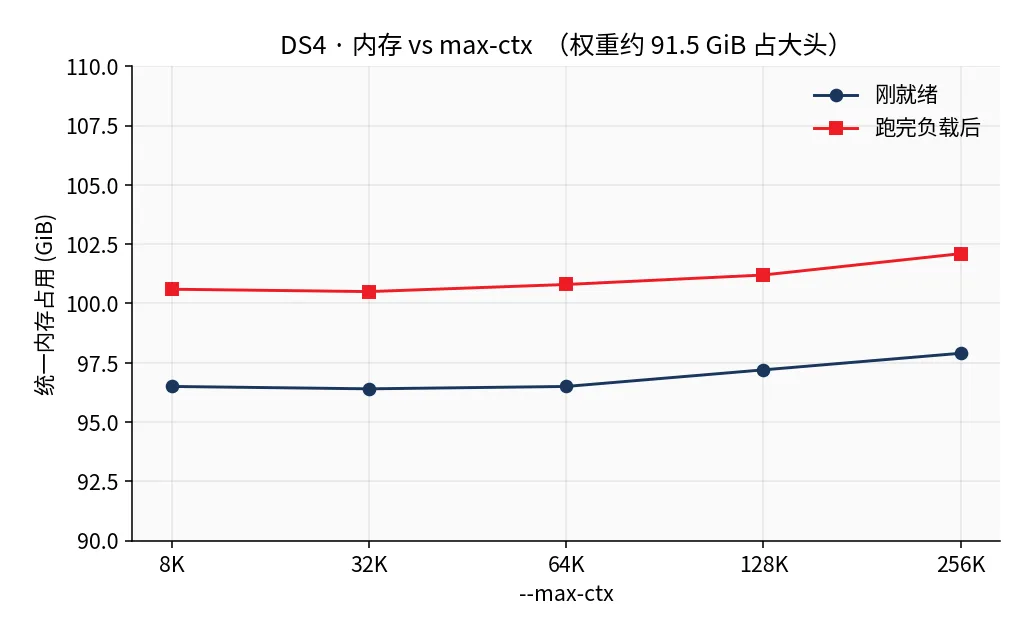
刚就绪约 96.5–97.9 GiB,跑完负载约 100.6–102.1 GiB。--max-ctx 从 8K 到 256K 只多大约 1.5 GiB。
七、接入注意
{
  "model": "DeepSeek-V4-Flash",
  "messages": [{"role": "user", "content": "你好"}],
  "tools": [],
  "temperature": 0.7,
  "max_tokens": 2048
}| 项 | 建议 |
|---|---|
| Base URL | http://127.0.0.1:8000/v1 |
| 工具 | 必须走 tools 字段,不要写进 system |
| 思考 | 默认关。长 prompt 开思考极慢(本机 36K 记录过 233 s prefill) |
| 并发 | --max-concurrency 1,第二请求排队 |
| DSpark | 日常关。短输出 accept≈0.50,开了更慢 |
Agent / 多轮工具调用示例(schema 保持稳定,才能复用前缀):
curl -s -X POST http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "现在几点?"}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "now",
        "description": "返回当前时间",
        "parameters": {"type": "object", "properties": {}}
      }
    }]
}'八、常见问题
Q: 启动后 abort,或日志里有 GGML_ASSERT?
先确认没有 HSA_OVERRIDE_GFX_VERSION,且编译目标是 gfx1151。Docker 旧镜像常用 override 跑 11.0.0,sparse 会断言失败。
Q: 每一轮都要预填充十几秒?
检查请求有没有 tools 数组。没有的话前缀槽不会钉住,换一句提问就全量重算。
Q: 能不能和 Qwen3.8-Flash-CIRU 一起开?
不能。两套都要约 96 GiB 统一内存。先停掉其中一个再启动另一个。
Q: 官方说能到 32 tok/s,为什么我只有 25?
官方数字来自 ROCm 7.2.4 + 锁频 + 开 DSpark + 较长输出。本教程日常关投机,decode 是可预测的 ~25 tok/s。有 sudo 锁频后再开 DSpark,短输出仍可能更慢。