第2章:符号的黎明——因果的第一次建模
如果你能把世界写成 If-Then,那你就拥有了世界。问题是,你写不完。
一、一个赌注
1965 年,Herbert Simon 撂下一句话。此后六十年,这句话被人反复引用:
“二十年内,机器将能完成人类能做的任何工作。”
Simon 拿过诺贝尔经济学奖,是认知科学的奠基人之一,聪明得不像话。他不是在吹牛。他手里有证据:一台机器第一次像人一样推理。
不是计算。是推理。
Logic Theorist 由 Newell 和 Simon 在 1956 年写出。给一组公理和推理规则,它自己证出了罗素《数学原理》第二章 38 条定理里的 36 条。有一条证明,比罗素本人的版本更简洁。Simon 写信给朋友:“我们发明了一台会思考的机器。”
此后大约三十年,人工智能的主流,就靠一个简单到漂亮的赌注撑着:
如果你能把世界的知识写成符号,把推理规则写成逻辑,机器就能推理。
本章讲的就是这个赌注。它怎么下的,在哪里赢了,又为什么最终输了。
二、If-Then 的美学
先把范式的骨架拆开看。
一个基于规则的推理系统,结构简单得很。两个部分:
知识库(Knowledge Base):一组描述世界规律的 If-Then 规则。推理引擎(Inference Engine):给它一个问题,它沿着规则链推出答案。
经典的例子是 1972 年斯坦福的 MYCIN。它诊断细菌性血液感染,知识库里约 600 条规则,长这样:
IF  Gram stain of bacterium = positive
AND  shape of bacterium = spherical
AND  growth pattern of bacterium = clustered
THEN species of bacterium = Staphylococcus aureus (confidence 0.7)
拿到一个具体病例,引擎把观测事实代进规则,一条接一条往前推,推出诊断和用药方案。
MYCIN 表现得好。1979 年,斯坦福做了一次盲测:10 个真实病例交给 MYCIN 和 5 位医学专家,8 位感染病权威给所有答案打分,不告诉他们哪份来自机器。MYCIN 排在前列,压过其中几位人类医生。
那是 1979 年。
Simon 那一代人的乐观,不难理解。一个领域的专家知识只要能写成规则,机器就能当这个领域的专家。它不会累,不会因为值完夜班就判断力下降。
这个想法有一种纯粹的美。世界很复杂,复杂底下压着规律。规律能写出来。写出来,机器就能操作它。
问题是,写规则这件事本身,比看起来难得多。
三、知识瓶颈
专家系统有个让所有人头痛的毛病,还起了名字:知识获取瓶颈(Knowledge Acquisition Bottleneck)。
知识获取瓶颈:为什么专家的知识很难写成规则?
“知识获取瓶颈”说的是:把专家脑子里的知识,变成机器能处理的规则,这件事难到近乎不可能。
原因有两层:
- 专家说不清自己在做什么:很多判断早已沉到潜意识里,他自己也翻不出那个显式版本(见下方“内隐知识”)。
- 知识看情境:同一条信息换个场合就换个意思,规则系统不会优雅地处理这种依赖。
这是专家系统时代最要命的实践困难。这项技术最后就垮在这儿。
一句话:把专家的知识写成规则,这件事本身几乎完不成。
找一个有三十年经验的外科医生,问他怎么判断病人要不要手术。他会给你标准答案:看影像,看血液指标,看症状持续了多久。你把这些写进规则,系统的表现却很糟。他没说的那部分,是三十年攒下来的直觉:病人说某句话时他皱眉的样子,两种指标一起出现时那股说不清的“感觉”,某类病人在某个季节的特别模式。
这些都是真知识,是让他成为顶级外科医生的东西。可他说不出来。不是不肯说,是那些知识已经沉到他认知的底层,他自己也调不出显式版本。
认知科学管这叫内隐知识(tacit knowledge)。你会骑车。可一个不会骑的人问你,骑车时到底做了哪些精确的力学调整,你答不上来。
内隐知识(Tacit Knowledge):说不出来的那部分知识
内隐知识这个概念来自哲学家迈克尔·波兰尼(Michael Polanyi)。1958 年,他说:“我们知道的,比我们能说出来的要多。”
典型例子:
- 骑自行车——你会骑,但你能一帧一帧说出自己在做的调整吗?
- 人脸识别——一眼认出老朋友,可你说得出是哪几个像素触发的吗?
- 专家判断——老中医“一看气色”,外科医生“感觉不对劲”
所以专家系统注定撞上“知识永远写不完”这堵墙:最值钱的专家经验,恰恰是专家自己讲不出来的那部分。
所以知识工程师(建知识库的人)过得很苦。大量时间耗在访谈上,拿到几条规则,放进系统,测试,撞到覆盖不了的边角,回去再问、再改、再测。慢,贵,没有尽头。
写到 1000 条,发现还差 1000 条。写到 10000 条,新病例又踩中了前 1000 条都没想过的情况。
世界不是封闭的。规则永远写不完。
四、逻辑门是因果的最简形式
讲专家系统怎么失败之前,先插一段物理学的注脚。
“规则推理”听着抽象。落到实处,是一个非常具体的物理过程。
一个逻辑门,AND、OR、NOT,干的就一件事:给定输入,吐出确定的输出。因果关系最干净的物理实现。
一个 AND 门:A=1 且 B=1,输出就是 1;否则是 0。一条 If-Then 规则刻在硅片上,用电子来跑。
专家系统也好,逻辑推理也好,最底层都是这个。因果在电路里变成实物:一个状态导致另一个状态,没有例外,也没有含糊的余地。
电路里藏着下一层。
计算机不“思考”。它执行一连串确定的因果变换,每一步输入决定输出,没有半点不确定。麦卡锡和明斯基那代人的直觉是:思维只要能拆成足够多的确定步骤,机器就能把它复现出来。
这个直觉对了一半。数学证明能拆成符号操作的序列,每一步都确定。MYCIN 的推理也确定——同样的事实,永远同样的答案。国际象棋的棋步搜索同样确定。一大类“精确定义的问题”,都能这么处理。
可“思维”不止是精确定义的问题。
五、封闭世界假设
该正式请出一个概念了。本章所有麻烦都从它来。
它叫封闭世界假设(Closed World Assumption,CWA)。
封闭世界假设:你不知道的,系统认为不存在
封闭世界假设(CWA) 是规则系统的默认活法:凡是没被明确写进知识库的事实,一律算“不成立”或者“不存在”。
对比一下两种世界观:
- 封闭世界:没写进去的 = 不存在(查数据库的逻辑)
- 开放世界:没写进去的 = 我不知道(更接近现实)
领域封闭、有界,这假设就合理,比如航班数据库。放到开放的现实里,它很危险:系统会把“我没见过”当成“不存在”,然后自信地答错。
今天的大语言模型——在海量文本上训练、用来预测下一个词的模型——也有类似的问题:训练数据的边界,就是一种新形式的“封闭世界”。这个问题会跟这本书走到底。
规则系统只会用你放进去的知识。你没明说的事,它一律当作“不存在”。
举个例子。你建了一个航班数据库。有人问:“从北京到火星有没有直飞?”库里没有这条记录,封闭世界假设下系统答:没有。答对了。
换个问法:“今天下午有没有北京到上海的航班?”库里没有,系统照样答:没有。可数据库也许只是不全,真有这班飞机,只是你没录进去。
两种情况,系统答得一模一样。一个是正确推断,另一个是错误推断。封闭世界假设分不清“明确不存在”和“不知道在不在”。
专家系统里,这问题更重。你的规则库盖住了医生知识的 70%。剩下 30% 呢?系统不会说“我不知道”。它顺着现成的规则往上爬,硬推一个答案出来。这答案可能完全错,而它信心十足。
这是一种很危险的失败方式。
它不会困惑。它只会崩溃——而且崩溃得很自信。
六、MYCIN 的后代们
故事接着走。
MYCIN 之后,专家系统往每一个想得到的领域里钻。石油勘探,PROSPECTOR,1978 年,其中一个案例探出了价值约一亿美元的钼矿。贷款审批,进了大量银行系统。生产调度,DEC 的 XCON,每年替公司省下数千万美元。
1980 年代,这行烫手。有公司卖专家系统开发工具。“知识工程师”成了一个专门的职位。大学开了专门的课。1982 年,日本政府上马“第五代计算机系统”,要造一台靠逻辑推理干活的超级计算机,放话十年内突破人工智能。美国被吓着了,DARPA 专门搞了个 Strategic Computing Initiative 接招。
听着耳熟吗?每隔几十年,这故事就重演一遍。
再往后,裂缝慢慢露出来。
维护成本。系统一大,规则之间的相互作用就变得极其复杂。改一条,毁掉另外三条的推理链。专家系统开始变脆——不是边界上脆,是在它本该最强的核心区,被内部矛盾压垮。
可扩展性。600 条扩到 6000 条,行为就不可预测了。知识工程师脑子里再也装不下所有交互,更别说看懂它们合起来是什么样。
适应性。MYCIN 写于 1972 年。医学在往前走:新的病原体,新的检测手段,新的药。每次更新,知识工程师都得钻进系统,找出受影响的规则,手动改,还得当心别碰坏别处。它不会自己学。它是一张需要人永远维护的静态快照。
到 1980 年代末,日本的第五代项目陷进泥里。专家系统的局限越来越清楚。1987 年,专家系统硬件市场崩盘,AI 行业进入第二次“寒冬”。
七、一个简单的专家系统
不只是抽象历史。看一个真实的微型专家系统。
它诊断“这是什么动物”。最早由 Winston 和 Horn 在 1981 年的教科书里给出,是专家系统教学的老案例:
你输入的事实:["has fur", "eats meat", "is tan", "has dark spots", "has claws", "forward-facing eyes"]
推理过程:
R1 fired: ['has fur'] -> is a mammal
R5 fired: ['is a mammal', 'eats meat'] -> is a carnivore
R6 fired: ['is a mammal', 'has claws', 'forward-facing eyes'] -> is a carnivore  [already known]
R8 fired: ['is a carnivore', 'is tan', 'has dark spots'] -> is a cheetah

Final conclusion: is a cheetah逻辑清楚,可追溯,可解释。每一步推理,你都能指出来自哪条规则。这是专家系统的一大优势——透明度。
现在换个问法:要是这只动物既有深色斑点,又有黑色条纹呢?
系统不知道怎么办。R8 和 R9 各满足一半,结论却不一边——猎豹还是老虎?结果看实现:有时报第一个匹配上的结论,有时吐出两个互相打架的结论。
它不会困惑。它不说“我不知道”。它给你一个答案。
那个答案,可能毫无意义。
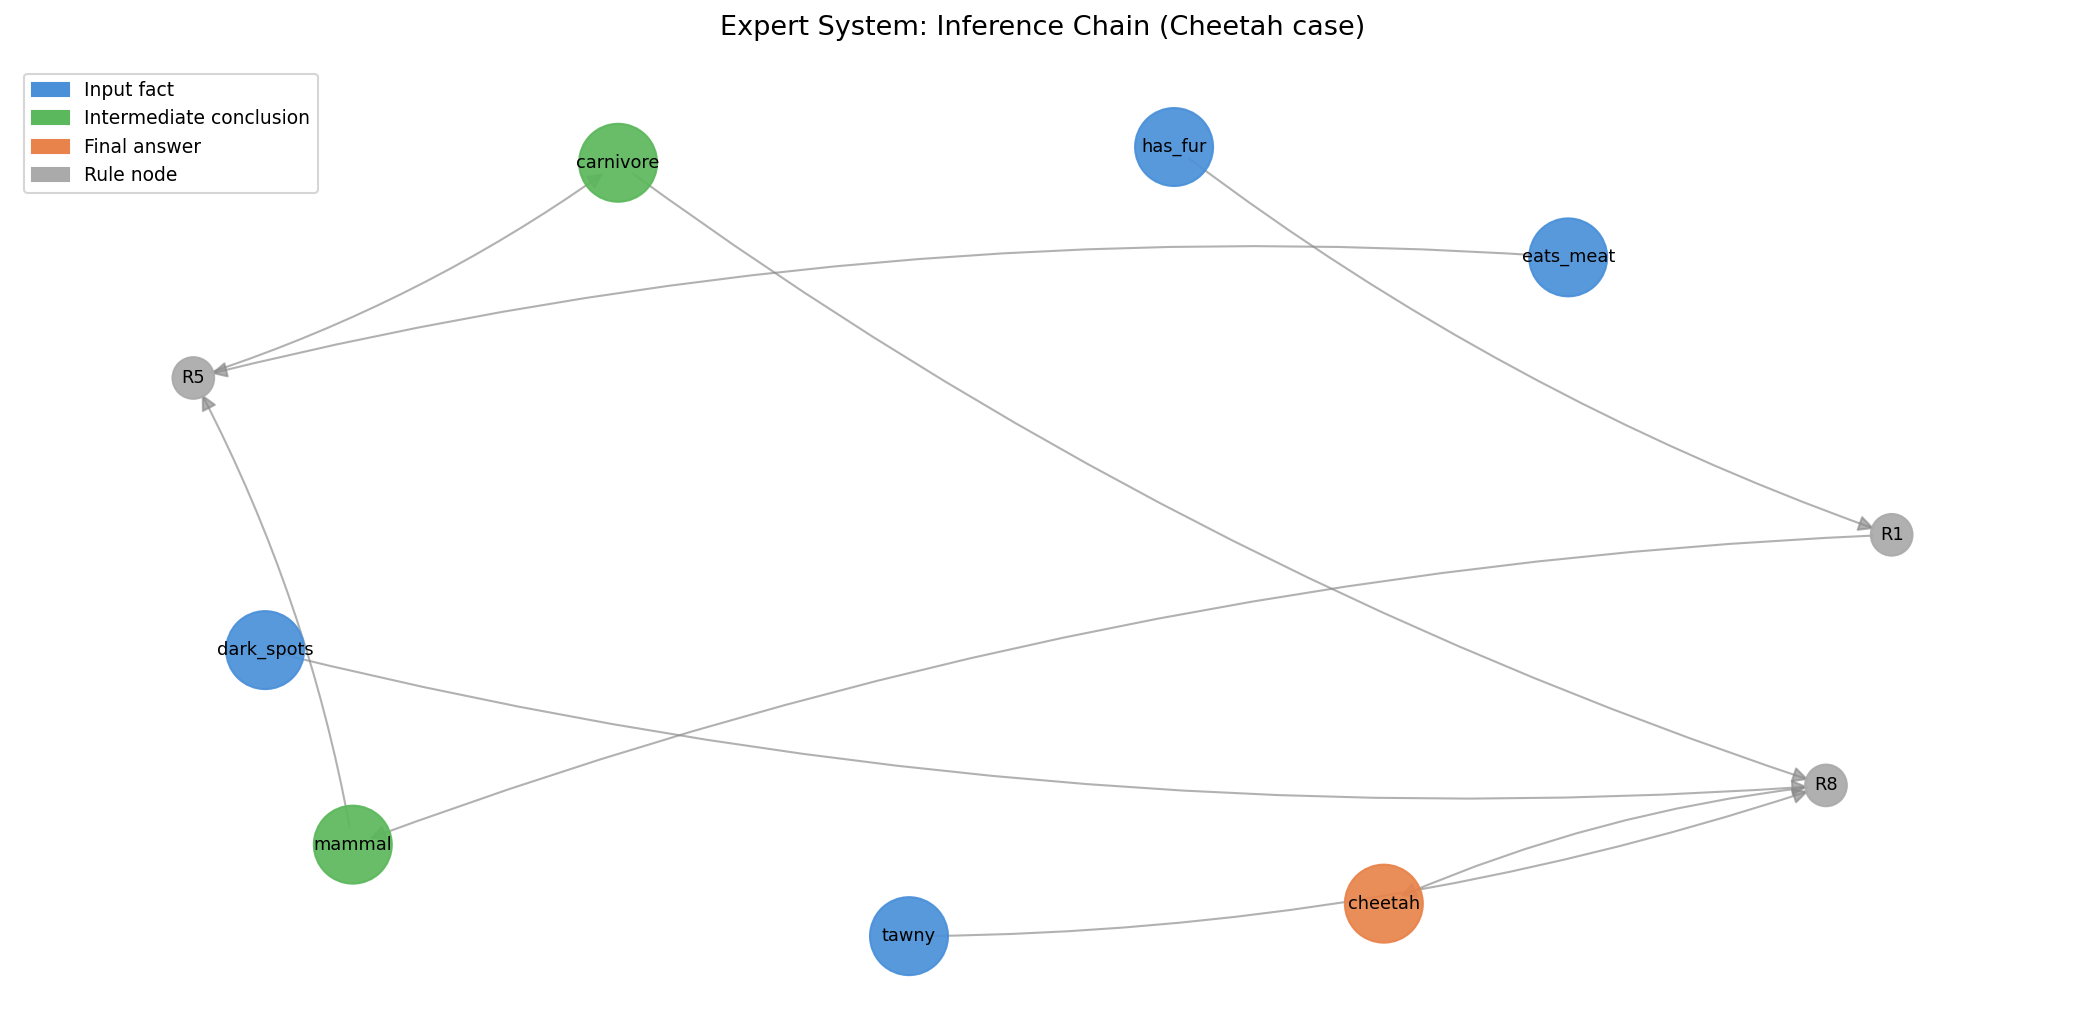
图1:MYCIN 式前向链接推理的 DAG 结构。每个节点是一个事实或结论;每条边是一条触发的规则。推理路径清晰可追溯——这是专家系统最大的优势,也是它的天花板。
八、为什么它失败——真正的原因
还有一层,比“知识永远写不完”更深。
专家系统的核心假设:推理能拆成一条条独立的、可枚举的规则,规则间的相互作用有限,而且可预测。
在很受限的领域里,它成立。MYCIN 做细菌感染诊断,边界清楚,协议标准,变量有限。那里知识库接近写全,推理接近闭合。
换到开放的现实世界,它从根本上就错了。
人的推理不是规则系统。走进一间没见过的屋子,你不会去翻“房间”规则库,一条条对照。大脑做的是把这个新场景塞进一个内部的世界模型——高度压缩,用几十年建起来,被无数次经验改过。模型是连续的,是生成式的。它能插值,能外推,能在没见过的情况里给出像样的猜测。
规则系统没有这个本事。它离散,靠枚举,只能在显式覆盖的范围内推理。碰到边界,它不猜。它崩。
再往深里,是个哲学问题。1972 年,哲学家 Hubert Dreyfus 在《计算机不能做什么》里挑明了:人的智能依赖一种直觉——什么重要。这直觉是情境性的(situated),是活在世界里的身体攒出来的经验。你没法把它抽成脱离情境的规则。它本来就不长成规则的样子。
当时 AI 社区笑他。后来发现,他大体上是对的。
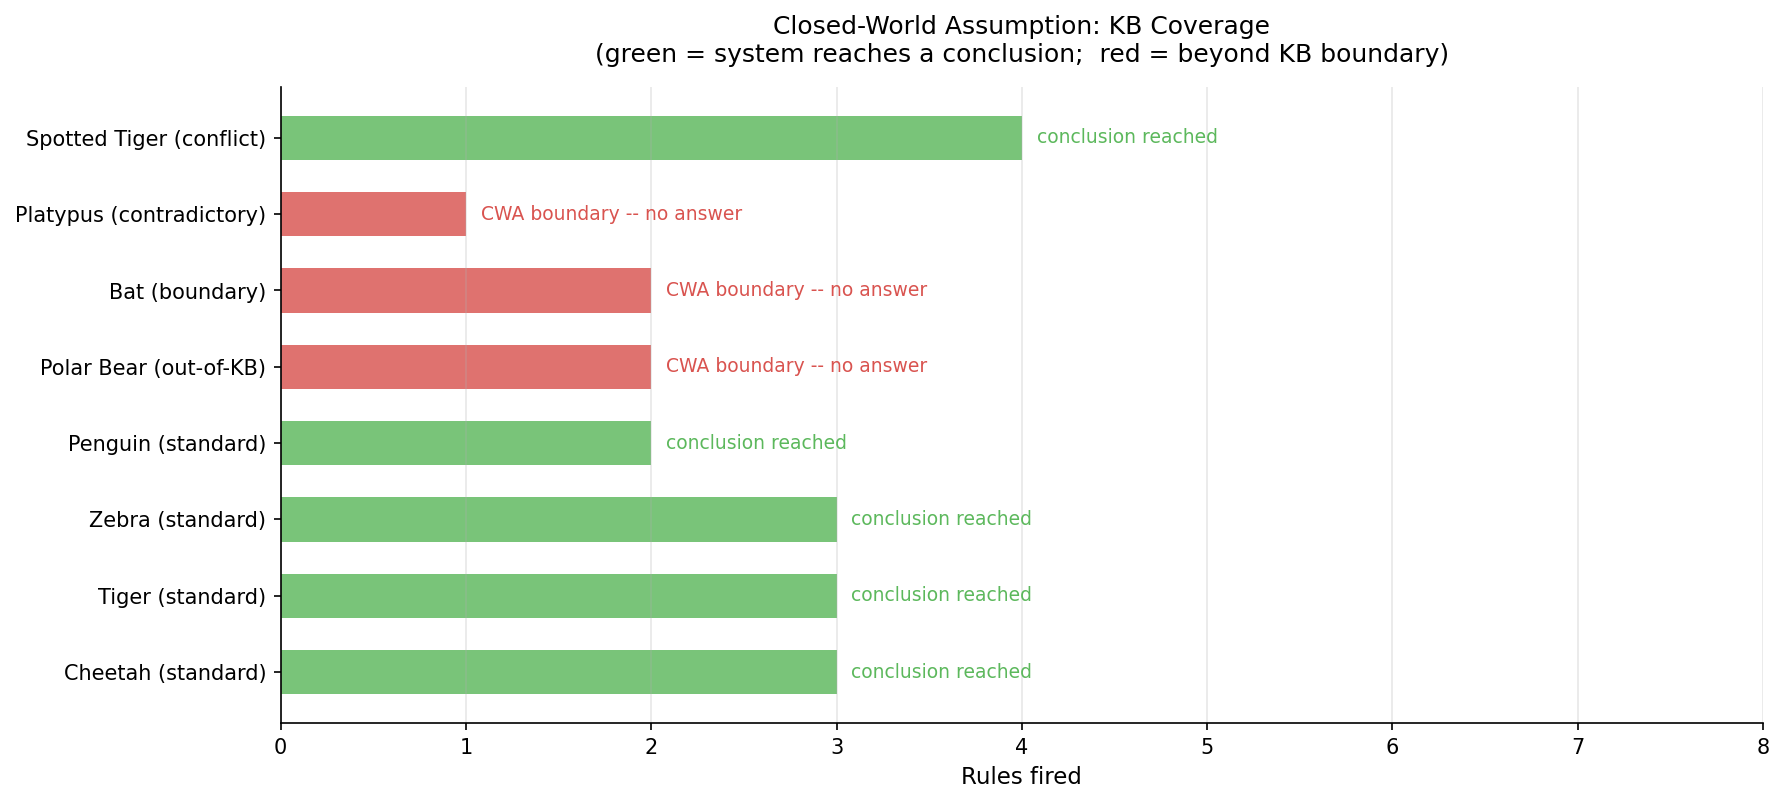
图2:知识库覆盖的区域(已知)与覆盖范围之外(未知)之间的边界。在已知区域内,专家系统推理精准。在边界处,它不会说“我不知道”——而是沿着最近的已知规则,给出一个自信的错误答案。封闭世界假设把“不在库里”等同于“不存在”。
九、它留下了什么
这一章,不该收在一个失败故事上。那不是全貌。
专家系统在擅长的地方确实出色。规则有限、边界清楚、知识能枚举完的问题——XCON 真替 DEC 省了数千万美元。贷款审批里,规则写得好,偏见就能被摆到明面上审、改,比黑盒里藏着掖着透明得多。医疗决策支持到今天还在用规则引擎,处理那些格式规整的子任务。
更要紧的是,这个时代留下了几样真东西:
清晰的问题分解。把复杂问题拆成能独立处理的子问题,这本事值钱。现代软件工程还在这么干。
推理的可解释性。每一步推理都追得到。在今天,这是稀罕东西。可解释性在深度学习时代又成了热门,而这件事,专家系统做得最好。
知识表示理论。围着专家系统长出来的知识表示理论,后来变成本体论、描述逻辑和语义网,至今还在不少工业系统里跑。
本体论、描述逻辑、语义网:这三者是什么关系?
这三个词,说的是知识怎么在计算机里被摆成结构:
- 本体论(Ontology):在计算机里,把某个领域的概念体系和它们的关系形式化地定下来。比如医学本体 SNOMED,定好了“疾病”“症状”“药物”的层级。
- 描述逻辑(Description Logic):搭本体论用的逻辑语言。比自然语言精确,比完整的一阶逻辑好算。OWL(Web 本体语言)就建在它上面。
- 语义网(Semantic Web):Tim Berners-Lee 提的愿景——网页数据不光给人读,机器也能“理解”里面的语义关系。RDF 和 OWL 是它的核心技术。
三者一条链:本体论是目标,描述逻辑是工具,语义网把前两样铺到网上。
最后一样,也是最要紧的:
一个关于推理边界的清晰反例。专家系统用实打实的工程证明了:推理要是靠一个写全的显式知识库,它能走多远,就全看这个库有多全。世界是开放的,库是封闭的。这条缝,就是所有规则系统的天花板。
教训的另一面,就是此后几十年 AI 转向的方向:别再把规则一条条写死,让机器从数据里学,连人说不出的内隐知识一起学。
这次转向不容易,也没完全成功。那是下一章的事。
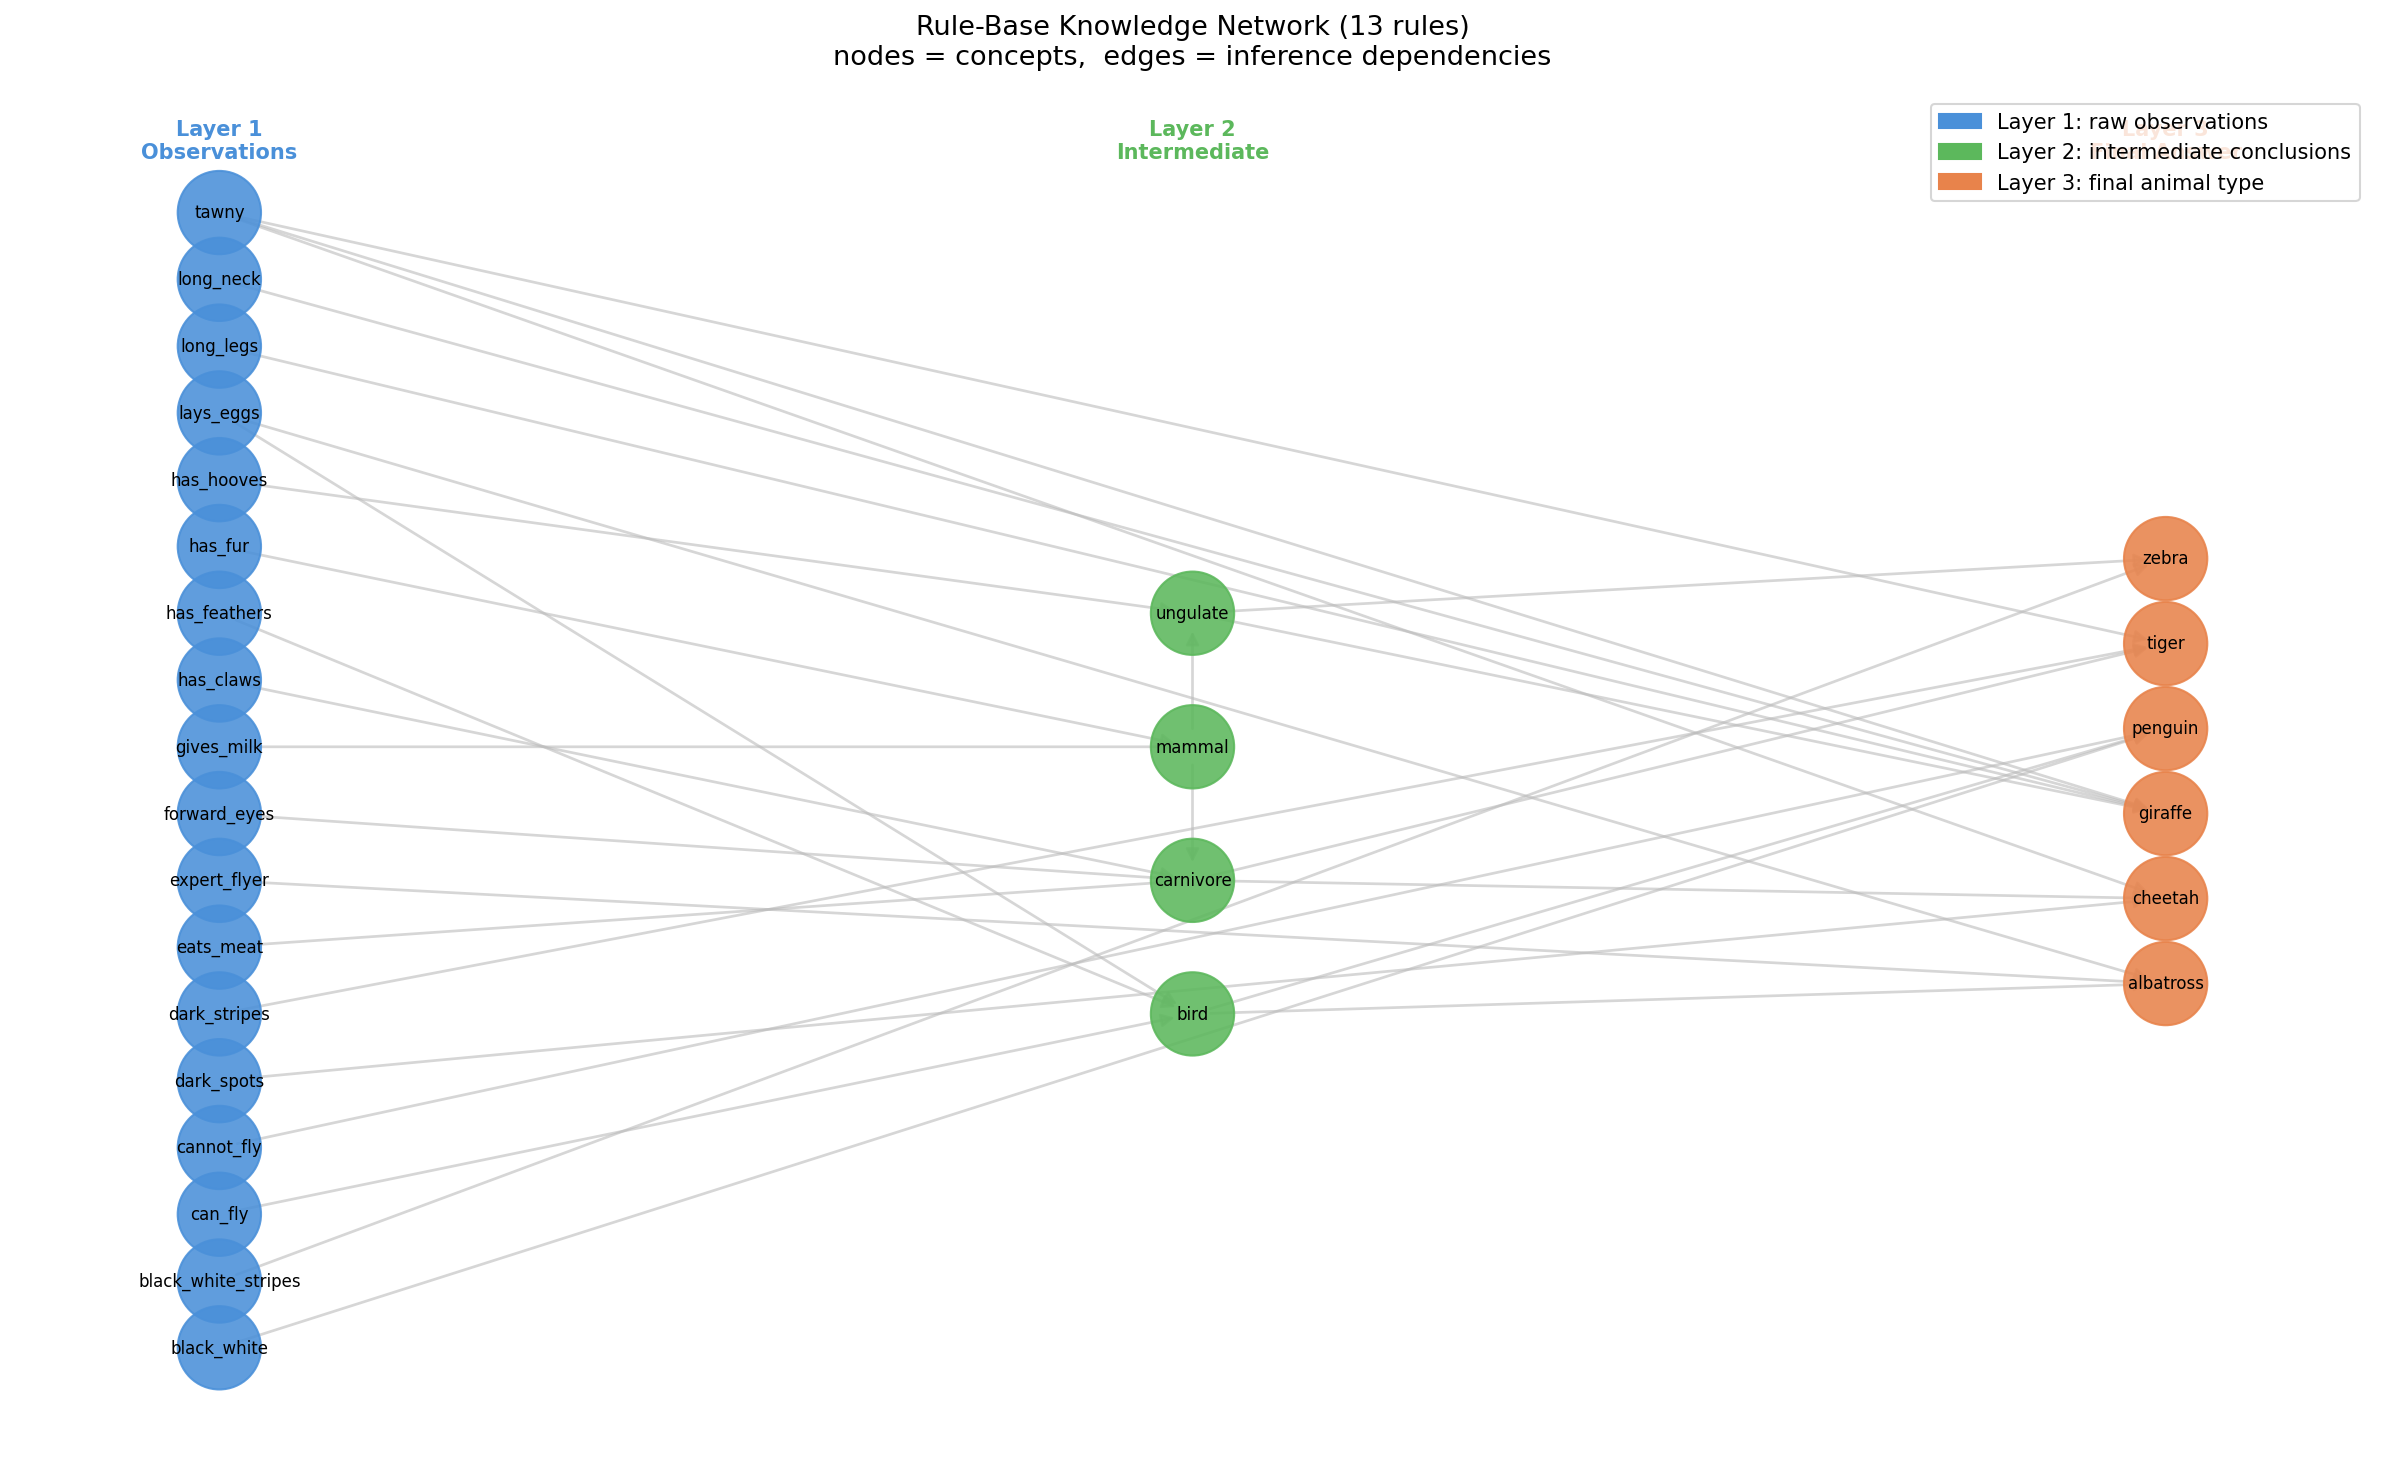
图3:动物识别专家系统的完整规则网络。左层是原始观测事实(输入);中层是中间结论(哺乳动物、鸟类、食肉动物……);右层是最终分类。节点之间的连线是规则依赖关系。这张图也展示了这个范式的极限:当规则数量从 10 条增长到 10000 条,没有人能在脑子里追踪这张图。
十、一个小小的停顿
把这一章捋一遍。
符号 AI 和专家系统的时代,留下一个干净的教训:把世界的知识显式写成规则,原则上就完不成。不是不够努力。是知识本身不长规则的样子——它看情境,藏在暗处,是连续的,还会生成。
逻辑门是因果最简的物理实现,规则系统是因果推理最直接的建模。在擅长的地方,它们干得极好。可世界比这宽得多。
封闭世界假设是这个范式的死穴:在你知道的范围里它很强,到了边界就失效得很体面。边界在哪儿?你永远不知道——你不知道自己不知道什么。
这个模式不只属于专家系统,属于任何推理系统。每个系统都有自己的封闭世界边界:它明说或默认某些东西不存在、某些事不会发生。现实一碰上去,推理就失效。
失效的方式不同,教训一样:推理需要一个世界模型,模型的边界就是推理的边界。
第三章往另一头走:向量,连续表示空间,表示学习。从离散符号到连续向量,这一步跨得大。它带来的新问题,不见得比解决的旧问题少。
符号失败了,留下一个问题:意义是什么?下一章,向量会给“意义”配一组几何坐标。
符号的规模化:从专家系统到知识图谱
本章结束前,看一眼符号主义的遗产——知识图谱——怎么在现代 AI 里接着活。
知识图谱:符号主义的规模化
知识图谱就是专家系统知识库的规模化、结构化版本:
- 实体顶替了专家系统的“概念”
- 关系顶替了 If-Then 规则的“条件”
- 三元组(头实体——关系——尾实体)是知识的基本单元
麻烦也相似:
- 构建成本:大量人工标注,或者复杂的抽取算法
- 覆盖问题:没有哪张知识图谱能盖住所有知识
- 动态更新:世界在变,图谱得一直跟着改
- 知识表示:模糊的、带概率的、看上下文的知识,怎么表示?
知识图谱与大模型的对话
现在的一个前沿方向,是把符号(知识图谱)和统计(大模型)接起来。不是谁替代谁,是互补:
| 维度 | 知识图谱 | 大模型 |
|---|---|---|
| 知识表示 | 显式、结构化、离散 | 隐式、分布式、连续 |
| 可解释性 | 高:清晰的三元组结构 | 低:黑盒的向量运算 |
| 推理方式 | 符号逻辑推理 | 统计模式匹配 |
| 知识获取 | 人工构建/抽取 | 从文本中隐式学习 |
| 动态性 | 更新成本高 | 可通过微调适应 |
结合策略:RAG 与知识注入
目前主要有这么几种:
- 检索增强生成(RAG):知识图谱当外部记忆,给大模型递事实
- 知识注入:把三元组翻成训练数据,喂进大模型
- 符号引导生成:用图谱的结构管住大模型的输出
- 混合推理:确定的知识走符号,不确定的走统计
深层问题:符号与统计的根本差异
这结合有硬骨头:
- 表示鸿沟:离散符号对连续向量
- 推理鸿沟:逻辑演绎对概率推断
- 知识鸿沟:显式陈述对隐式蕴含
- 更新鸿沟:局部更新对全局重训
关键问题:知识图谱慢而准,大模型快而模糊。怎么让它们协同,而不是拿胶水一粘?
思考题:符号主义的现代复兴?
知识图谱接上大模型,算符号主义复兴吗?还是统计的框子里借了个符号的壳?
再深一层:大模型既然能从文本里“学”知识,还要显式图谱干什么?一个答案:可解释、可验证、可更新。医疗、法律、金融这些要命的地方,缺不了这三样。
悬而未决
大语言模型是不是偷偷把封闭世界假设又请回来了?训练数据的分布,算不算一种新的“知识库边界”?
可解释性是真优势。可解释和正确是一回事吗?讲得清一个推理,不等于这推理对。
Dreyfus 咬住的一点是:情境性知识没法显式化。大模型抓住它了吗?还是只在高维空间里做模式匹配?
符号与统计的结合:图谱给结构,大模型给泛化。这结合是“1+1>2”,还是油和水?真要融起来,得先解决什么?
知识的双重表示:同一个事实,在知识图谱里是离散三元组,在大模型里是连续向量。两套表示怎么互相验、互相补?打起来听谁的?
动手试试:构建你自己的专家系统,然后看它崩溃
本章的教训是:规则写不完,边界找不到,失败来得悄无声息。只读不做,这些就只是抽象的格言。你需要亲手把它造出来,然后亲眼看着它在边界处崩溃。
第一步:选一个你真正了解的领域
不要选医学。不要选法律。选一个你实际有经验的领域——那种你能说出“这种情况下你应该这样做”的领域。
几个建议:
- 判断一道菜的口味风格(川菜 / 粤菜 / 日料……)
- 诊断一台电脑的常见故障(网络 / 硬件 / 软件……)
- 判断一篇文章是否值得精读(领域 / 来源 / 关键词……)
- 评估一道编程题的难度级别(简单 / 中等 / 困难)
选好之后,在纸上写下:这个领域的最终结论有哪些?(一个类别列表,不超过 10 个。)
第二步:写出你的规则库
使用本章第 7 节展示的格式,写出至少 15 条 If-Then 规则。
# Rule data structure: each rule is a dictionary
# 'conditions' : list of conditions (ALL must hold to trigger)
# 'conclusion' : rule conclusion (a string)
# 'name'       : rule name, for tracing the reasoning path

# Example: a rule base for classifying cuisines
rules = [
    # --- middle-level rules: ingredient features ---
    {"name": "R1",  "conditions": ["has fish mint"],
     "conclusion": "uses Sichuan ingredients"},
    {"name": "R2",  "conditions": ["has chili pepper", "has Sichuan pepper"],
     "conclusion": "mala style"},
    {"name": "R3",  "conditions": ["has sashimi"],
     "conclusion": "uses Japanese ingredients"},
    {"name": "R4",  "conditions": ["has miso"],
     "conclusion": "uses Japanese ingredients"},
    {"name": "R5",  "conditions": ["has fermented black beans", "has steamed-fish soy sauce"],
     "conclusion": "Cantonese seasoning"},
    {"name": "R6",  "conditions": ["has ginger and scallion"],
     "conclusion": "Cantonese base"},

    # --- middle-level rules: cooking style ---
    {"name": "R7",  "conditions": ["stir-fried over high heat"],
     "conclusion": "high-heat stir-fry style"},
    {"name": "R8",  "conditions": ["steamed"],
     "conclusion": "light cooking style"},
    {"name": "R9",  "conditions": ["charcoal-grilled"],
     "conclusion": "barbecue style"},

    # --- terminal rules: conclude the cuisine ---
    {"name": "R10", "conditions": ["uses Sichuan ingredients", "mala style"],
     "conclusion": "is Sichuan cuisine"},
    {"name": "R11", "conditions": ["uses Japanese ingredients"],
     "conclusion": "is Japanese cuisine"},
    {"name": "R12", "conditions": ["Cantonese seasoning", "light cooking style"],
     "conclusion": "is Cantonese cuisine"},
    {"name": "R13", "conditions": ["Cantonese base", "Cantonese seasoning"],
     "conclusion": "is Cantonese cuisine"},
    {"name": "R14", "conditions": ["barbecue style", "uses Sichuan ingredients"],
     "conclusion": "is Sichuan-style barbecue"},
    {"name": "R15", "conditions": ["high-heat stir-fry style", "Cantonese seasoning"],
     "conclusion": "is Cantonese stir-fry"},
]
写的时候,注意两件事:
a. 写中间层规则,不要只写直奔结论的规则。
坏的写法:
IF has fish mint AND has chili pepper THEN is Sichuan cuisine好的写法:
IF has fish mint THEN uses Sichuan ingredients
IF has chili pepper AND has Sichuan pepper THEN mala style
IF uses Sichuan ingredients AND mala style THEN is Sichuan cuisine
中间层让推理链变得可解释,也让问题暴露得更清楚。
b. 试着从结论往回推,而不只是从条件往前推。
问自己:“要得出‘是川菜’,最少需要哪些前提?这些前提够吗?有没有例外?”
第三步:实现前向链接引擎
本章已经给了你引擎的完整逻辑:
def forward_chain(rules, initial_facts):
    """
    Forward-chaining inference engine.
    rules: list of rules, each with 'conditions', 'conclusion', 'name'.
    initial_facts: set of initially observed facts.
    Returns: (final fact set, reasoning trace list)
    """
    # known facts = the observed input set
    known_facts = set(initial_facts)
    reasoning_trace = []  # record which rule fired (the reasoning trace)

    # repeat inference until no new fact is added
    while True:
        new_fact_added = False  # whether a new fact was added this round

        for rule in rules:
            # check whether all rule conditions are in the known fact set
            conditions_met = all(cond in known_facts for cond in rule["conditions"])

            if conditions_met and rule["conclusion"] not in known_facts:
                # add the rule conclusion to the known fact set
                known_facts.add(rule["conclusion"])
                # record which rule fired (your reasoning trace)
                reasoning_trace.append(
                    f"fired {rule['name']}: {rule['conditions']} -> {rule['conclusion']}"
                )
                new_fact_added = True

        # stop if this round added nothing new
        if not new_fact_added:
            break

    # output: known fact set + reasoning trace
    return known_facts, reasoning_trace


# --- Example run ---
# Initial observations: the dish features on the table
initial_observations = {"has fish mint", "has chili pepper", "has Sichuan pepper", "stir-fried over high heat"}

final_facts, trace = forward_chain(rules, initial_observations)

print("=== Reasoning trace ===")
for step in trace:
    print(" ", step)

print("\n=== Final conclusions ===")
conclusions = [f for f in final_facts if f.startswith("is ")]
for c in conclusions:
    print(" ", c)
你不需要图形界面,不需要数据库,不需要配置文件。最简单的实现:用列表存规则,用集合存已知事实,用一个循环做推理。
第四步:构造三个测试用例——让一个通过,让两个失败
案例 A:正常案例。 一个你的规则库能完整覆盖的典型案例。输入观测,得到正确结论,推理轨迹完整。这证明系统“能工作”。
案例 B:边界案例。 构造一个处在两个类别之间的模糊案例——两个不同结论的前提都同时满足。观察系统的行为:它报告两个结论?选择第一个匹配的?还是悄悄给出一个错误答案?
你的第一个问题: 你的系统在案例 B 中的行为,是“可以接受的失败”,还是“危险的沉默失败”?这两者之间有什么区别?
案例 C:分布外案例。 构造一个你的规则库从未预料到的案例——比如一道同时有四川和日本食材的融合菜;或者一台故障跨越所有已知类别的电脑。
观察:系统给了你什么?它说“我不知道”了吗?还是它沿着某条最近的规则链往上爬,递给你一个看起来合理、实际上错误的答案?
你的第二个问题: 案例 C 的输入触发了哪些规则?这些规则本来是为哪些情况设计的?系统误用它们的方式,揭示了封闭世界假设的什么具体缺陷?
第五步:算一算这笔账
你写了多少条规则?它们覆盖了这个领域的多少?
估算一下:这个领域还有多少知识在你的规则之外?那些缺失的部分,是因为你不知道,还是因为你“知道却说不出来”?
你的第三个问题(也是最难的一个): 如果要把你在这个领域的全部知识都转化成规则,你需要多少条?这个数字是有限的吗?
检验你的成果
完成这个练习后,你应该能回答:
- 你的规则库的边界在哪里——不是你猜的边界,而是你亲手撞上去的那个边界
- 系统在边界处的失败方式,是否与本章描述的“自信的错误”一致
- 知识工程师为什么说这是“一个几乎无法完成的任务”
第三条,你不需要在理论上解释清楚。你只需要在你自己的小小领域里,亲身感受一次为什么。
延伸阅读
Shortliffe, E. H. (1976). MYCIN: Computer-Based Medical Consultations — 专家系统的奠基性案例研究
Dreyfus, H. L. (1972). What Computers Can’t Do — 对符号 AI 范式的哲学批判,当时被嘲笑,后来被证明深刻
Reiter, R. (1978). “On Closed World Databases.” Logic and Data Bases — 封闭世界假设的形式化定义;本章核心概念的原始来源
Minsky, M. (1975). “A Framework for Representing Knowledge.” The Psychology of Computer Vision — Frame 系统,另一种解决知识表示问题的尝试
Winston, P. H. & Horn, B. K. P. (1981). LISP — 包含经典的动物识别专家系统;本章脚本的原始灵感
[Bader et al., 2004, arXiv:cs/0408069] — 神经-符号整合:连接主义与一阶逻辑知识表示的统一挑战;专家系统时代问题在现代的回响