第8章:启发式的契约——接受"差不多对"需要多少勇气
A* 的启发函数如果对你撒谎,它依然会交给你一条路。只是那条路是错的。
一、1968年的赌注
1968 年,斯坦福研究院的 Peter Hart、Nils Nilsson 和 Bertram Raphael 发了一篇论文。里面那个算法后来叫 A*,人工智能史上最优雅的想法之一。
他们要机器人 Shakey 在房间里从 A 点走到 B 点,走最短的那一条。
暴力搜索有这个把握:把可能的路径都试一遍,挑最短的。可 Shakey 的房间里有几百万种走法,试完要等的时间是个天文数字。
贪心搜索快得多,每一步都朝目标的方向挪。代价是它撞上障碍就钻进死胡同,出来的路可能比最短的长一截。
Hart 三个人给出的 A* 做了一个听起来不成立的承诺:比暴力搜索快几个数量级,同时保证最短。
承诺有价。价钱是一份契约。
你给 A* 一个“诚实”的启发函数,也就是永不高估剩下的路,它就守约。启发函数一旦撒谎,高估了剩余代价,A* 照样给你一条路。只是那条路可能绕远。
这是设计,不是 bug。A* 用一道数学契约,换速度与最优之间的平衡。
五十多年过去,这份契约还是所有启发式算法的骨架:完美拿不到的时候,把近似的价码说清楚。
二、组合爆炸的诅咒
先把“完美不可及”量出来。
2016 年,AlphaGo 赢了李世石。满世界在谈机器的“直觉”和“创造力”。少有人盯住一个细节:它每走一步,蒙特卡洛树搜索在 19×19 的棋盘上翻过几百万种可能。
不是几百种,也不是几千种,是几百万种。
围棋的状态空间大约
假设一秒翻
工程再进步也没用。这是物理上的不可能。
组合爆炸四处都是:
旅行商问题:走遍 n 个城市,路线有
种。20 个城市, 种走法。 蛋白质折叠:100 个氨基酸,每个有 3 种主要构象,折法一共
种。 定理证明:一阶逻辑里,长度 n 的证明,可能的推理步数随 n 指数涨。
启发式就活在这条缝里:最优拿不到,就去找“足够好”。
“足够好”到底是多少?这不是工程上的含糊,是数学上要钉死的东西。契约就是这么来的:守约,“近似解”还算数;违约,它可能错得离谱。
回到 1968 年,看 Hart 他们怎么把这笔账算清。
三、启发式的数学契约
你在一个迷宫里,从 S 走到 G。每步都要付代价,时间或者距离。你想付得最少。
暴力搜索,也就是 Dijkstra 算法,把所有路都试一遍。最优解跑不掉,代价是
Dijkstra 算法:最短路径的暴力保证
Dijkstra(迪杰斯特拉)算法由荷兰人 Edsger Dijkstra 在 1956 年提出。做法很笨,也很稳:从起点出发,每次挑当前代价最小的未访问节点,把它的邻居摊开,一直到终点。
- 保证:边权都不为负,Dijkstra 一定找到代价最小的路
- 代价:它没有方向感,所有方向都摊开,慢
分支因子
搜索深度
两个数一乘,搜索空间是
贪心搜索每一步挑“看着离终点最近”的方向。快。可它会走进死胡同,出来的路有时长好几倍。
A* 在 1968 年出场时提了同一个承诺:比 Dijkstra 快,还保证最优。
全部赌注押在一个评估函数上:
:起点到节点 n 的实际代价,已经付掉的 :n 到终点的估计代价,猜的 :穿过 n 去终点的总估计代价
A* 每次挑
道理很直白。你走了 10 步到 n,估摸着还有 5 步,总共大约 15 步。A* 先走总账最少的那条。
麻烦在
估高了,A* 以为这条路太贵,早早放弃,转去走次优的。
估低了,低到
这三人证明了一件事:启发函数满足可采纳性,A* 就保证最优。
可采纳性的定义只有一行:
其中
启发函数得乐观,永不高估。低估没事,最多慢一点;高估就出事,答案会错。
A* 的契约就一句:给我可采纳的
这契约凭什么有效?拿个具体例子拆开看。
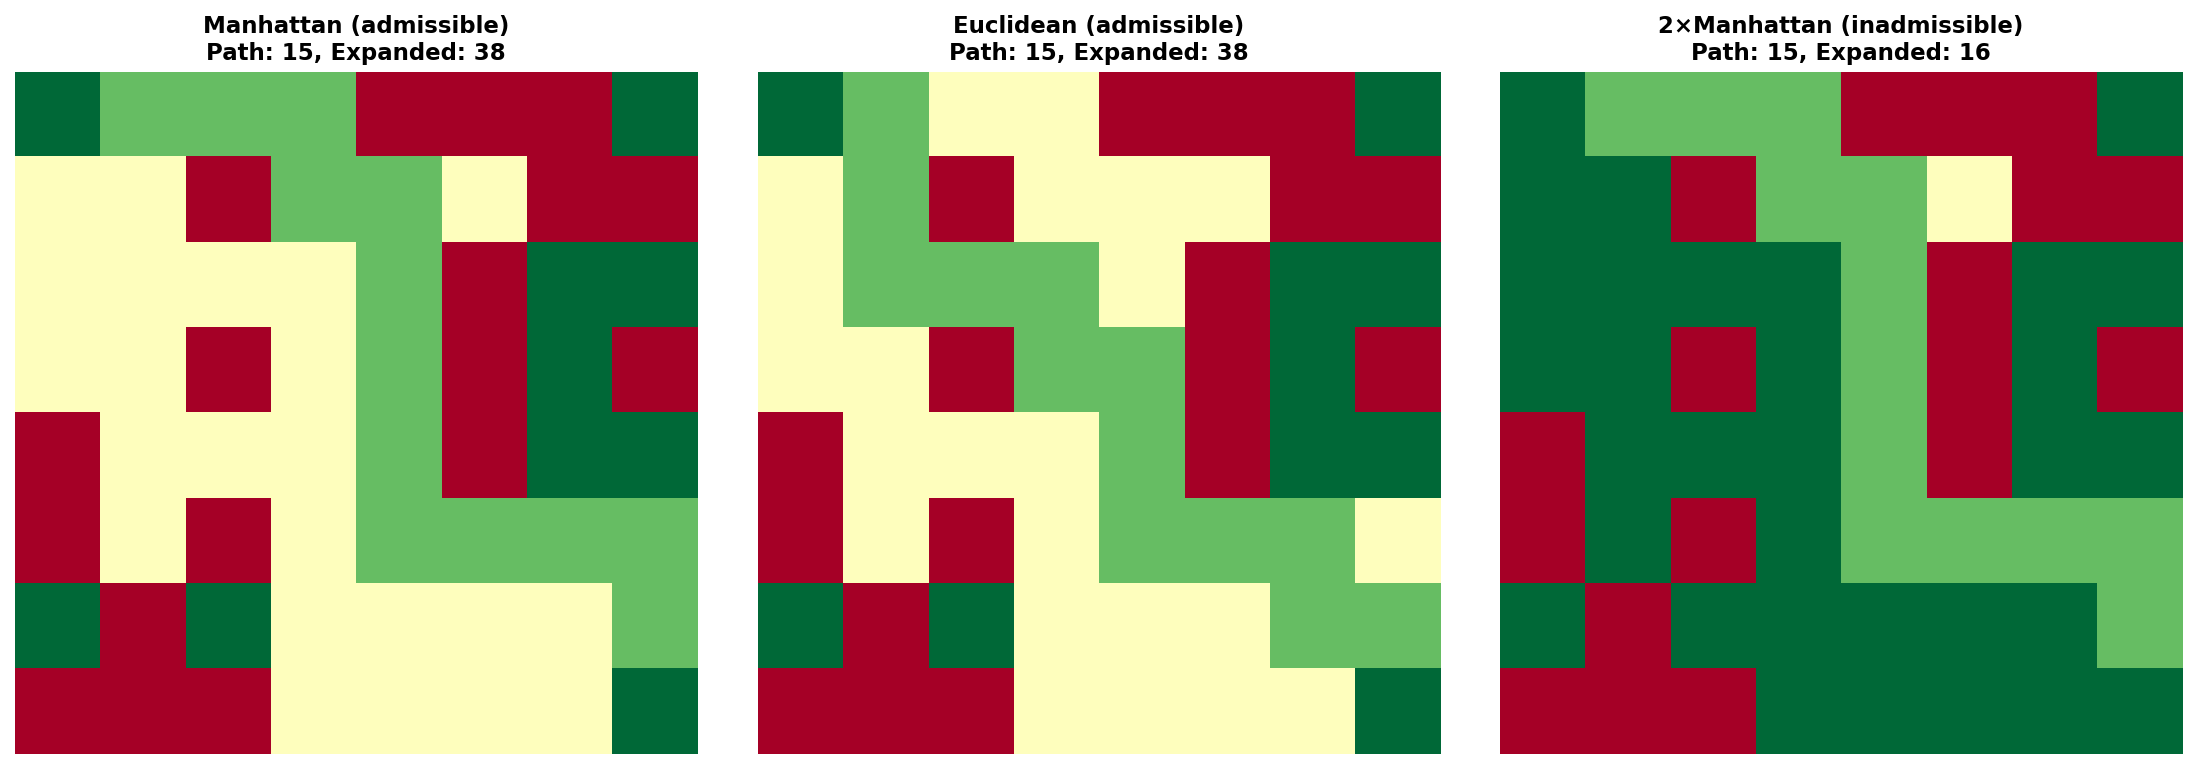
四、动手试试:看契约如何被打破
可采纳性不是一个抽象的数学要求。它是 A* 能否找到最优解的充要条件。
让我们亲手验证这件事。
实验目标:用同一个迷宫,分别用可采纳和不可采纳的启发函数运行 A*,看看结果有什么不同。
迷宫地图(0=可通行,1=障碍物,S=起点,G=终点):
S . . . . .
. . . # . .
. . . . # .
. . . . . .
. . . . . #
. . . . . G
S 是起点 (0,0),G 是终点 (5,5)
.是可通行格子,每步代价 = 1#是障碍物,不可通行
任务:找从 S 到 G 的最短路径。
import heapq

# --- maze definition: 6 rows x 6 cols, 1 = obstacle, 0 = walkable ---
# S=(0,0), G=(5,5)
GRID = [
    [0, 0, 0, 0, 0, 0],  # row 0: S . . . . .
    [0, 0, 0, 1, 0, 0],  # row 1: . . . # . .
    [0, 0, 0, 0, 1, 0],  # row 2: . . . . # .
    [0, 0, 0, 0, 0, 0],  # row 3: . . . . . .
    [0, 0, 0, 0, 0, 1],  # row 4: . . . . . #
    [0, 0, 0, 0, 0, 0],  # row 5: . . . . . G
]
ROWS, COLS = len(GRID), len(GRID[0])
START = (0, 0)
GOAL  = (5, 5)

def neighbors(r, c):
    """Yield the walkable neighbors (up, down, left, right)."""
    for dr, dc in [(-1,0),(1,0),(0,-1),(0,1)]:
        nr, nc = r+dr, c+dc
        if 0 <= nr < ROWS and 0 <= nc < COLS and GRID[nr][nc] == 0:
            yield nr, nc

def reconstruct_path(parent, node):
    """Reconstruct the path by backtracking through the parent dict."""
    path = []
    while node is not None:
        path.append(node)
        node = parent[node]
    return list(reversed(path))

def astar(h_func, label="A*"):
    """
    Generic A* search.
    h_func(r, c) is the heuristic; returns (path length, path, number of expanded nodes).
    """
    # priority queue items: (f, g, node)
    open_heap = [(h_func(*START), 0, START)]
    g_cost = {START: 0}    # actual cost from start to each node
    parent = {START: None} # parent pointers for path reconstruction
    closed = set()
    expanded = 0           # counted expanded nodes

    while open_heap:
        f, g, node = heapq.heappop(open_heap)
        if node in closed:
            continue
        closed.add(node)
        expanded += 1

        # reached the goal
        if node == GOAL:
            path = reconstruct_path(parent, node)
            return len(path) - 1, path, expanded  # steps = nodes - 1

        # expand neighbors
        for nb in neighbors(*node):
            new_g = g + 1  # each step costs 1
            if nb not in g_cost or new_g < g_cost[nb]:
                g_cost[nb] = new_g
                parent[nb] = node
                f_val = new_g + h_func(*nb)
                heapq.heappush(open_heap, (f_val, new_g, nb))

    return None, [], expanded  # no solution

# --- step 1: admissible heuristic -- Manhattan distance ---
#   h₁(n) = |n_row - G_row| + |n_col - G_col|
#   never overestimates the remaining cost -> admissible -> optimal solution
def h_admissible(r, c):
    """Manhattan distance: admissible, never overestimates."""
    return abs(r - GOAL[0]) + abs(c - GOAL[1])

steps1, path1, exp1 = astar(h_admissible, "admissible A*")
print("=== Step 1: admissible heuristic (Manhattan distance) ===")
print(f"path length: {steps1} steps")
print(f"expanded nodes: {exp1}")
print(f"path: {path1}")

# --- step 2: inadmissible heuristic -- Manhattan distance × 2 ---
#   h₂(n) = 2 × (|n_row - G_row| + |n_col - G_col|)
#   overestimates the remaining cost -> violates admissibility -> may find a suboptimal path
def h_inadmissible(r, c):
    """2x Manhattan distance: inadmissible, overestimates."""
    return 2 * (abs(r - GOAL[0]) + abs(c - GOAL[1]))

steps2, path2, exp2 = astar(h_inadmissible, "inadmissible A*")
print("\n=== Step 2: inadmissible heuristic (2x Manhattan distance) ===")
print(f"path length: {steps2} steps")
print(f"expanded nodes: {exp2}")
print(f"path: {path2}")

# --- comparison ---
print("\n=== Comparison ===")
print(f"admissible heuristic   -> {steps1} steps (optimality guaranteed)")
print(f"inadmissible heuristic -> {steps2} steps ({'optimal' if steps1==steps2 else 'suboptimal'})")
if steps1 != steps2:
    print(f"  gap: {steps2 - steps1} steps (contract broken: found a longer path)")
print(f"\nnote: the admissible version expanded {exp1} nodes, the inadmissible version expanded {exp2} nodes.")
print("  the inadmissible heuristic expands fewer nodes and is faster, but trades away the optimality guarantee.")
步骤 1:用可采纳启发函数
最简单的可采纳启发函数是曼哈顿距离(Manhattan Distance):
这是"如果没有障碍物,直线走到终点"的代价。因为实际路径必须绕过障碍物,所以
从 S 开始,计算相邻节点的
| 节点 | g(n) | h₁(n) | f(n) |
|---|---|---|---|
| S右 | 1 | 9 | 10 |
| S下 | 1 | 9 | 10 |
两者
步骤 2:用不可采纳启发函数
现在故意违反契约。定义一个高估的启发函数:
这个函数把剩余代价估计为曼哈顿距离的 2 倍——明显高估了。
重新从 S 开始:
| 节点 | g(n) | h₂(n) | f(n) |
|---|---|---|---|
| S右 | 1 | 18 | 19 |
| S下 | 1 | 18 | 19 |
两者
这制造了一个陷阱。从 (0,2) 分岔后:
- 向右路:连续 5 步直达 (0,5),每步
递减,像滚雪球一样越滚越快 - 缺口路:下到 (1,2),右邻 (1,3) 被障碍物堵死,必须再下一层才能右转——要多走一步才看到进展
结果:不可采纳的
这个翻车不是偶然。启发式设计的一个根本局限就在于:你无法在运行前可靠地预判一个启发函数的行为。我们总以为高估一点只是"不那么准确",但
这就是可采纳性的意义:如果
但可采纳性也有代价。
五、信息论视角:启发式的熵代价
可采纳性买到了正确。价钱呢?
看两个极端。
极度保守:
这当然可采纳,真实代价不会小于零。可它没有用。A* 退回 Dijkstra,均匀地摊开所有方向,直到撞见终点。从信息论看,这是对搜索空间的最大熵探索:每个方向一样可能。
极度激进:
这是理想。A* 直奔最优路径,一个无用节点也不翻。零熵,因为你已经知道答案。问题也在这儿:知道
现实里的启发函数夹在中间:尽量贴近
这个权衡有个刻度,叫有效分支因子
Pearl 在 1984 年的教材里记了实验数:
,8-puzzle 上 换成曼哈顿距离,
再用上模式数据库这种好启发,
从 2.8 到 1.1,搜索树的节点数从
启发函数做得好不好,直接写在电费单上。
底下还有一个更深的麻烦:好启发要领域知识。曼哈顿距离在网格上好使,换到一般图、连续空间、围棋棋盘上呢?
既要可采纳,又要贴近
这正是 ADS(自适应双搜索,Adaptive Dual Search) 要解决的问题:机器能不能自己学出一个启发函数?
六、ADS:让启发式变得信息论化
手工设计的启发函数有一个死穴:它靠领域知识,而且一动不动。搜索开始前定好,整场都不改。
可搜索空间是会变的。开阔处,启发函数可信;障碍堆里,谁都可能把你带沟里。固定
ADS(自适应双搜索) 把问题换了个问法:能不能用信息论量出这个启发此刻有多可信,让权重跟着不确定性走?
做法是把权重
- 状态很确定,熵低,
就大:信启发,往前走 - 状态充满不确定,熵高,
:竖起一道墙,别进去
这不是调参。它把不确定性变成一条能执行的搜索规矩。A* 的可采纳性管住“别高估”,ADS 的熵障碍管住“别闯进高熵的死路”。
两者分工清楚。可采纳性约束
完整的技术细节,还有它怎么用在 LLM 的推理空间里,第 10 章再说。
6.6 势垒不是贪心:ADS 与选择函数的本体论区别
这里有个特别容易踩的坑,先把它填上。
对数势垒
不是。这个“不是”不是抬杠,是两类东西的根本差别。一个思想实验就能把它钉住。
看两个迷宫。
迷宫 A,贪心。迷宫是固定的,每个路口三条岔路。你每次挑“看着离出口最近”的那条。有些路你永远不走。不是走不了,是你不选。
迷宫 B,ADS。迷宫会变。你靠近一片看不清的区域,岔路多、视线挡,墙就自己长出来,把那些方向封死。不是你不选,是你走不了。等视野清楚了,墙又退开,路重新通。
这不是打比方。它们是两种数学对象:
- 贪心:图
不变,定义一个选择函数 , 。它在固定的可达集合里挑。 - ADS:定义一个拓扑算子
,按局部熵删边或补边,动的是可达集合本身。
贪心改选择。ADS 改集合。
物理里早有判决。经典力学中,粒子在势场
为什么熵不是“局部贪心”的量?因为
为什么容易混?因为在简单地形上,两者走一样。直线没岔路时,挑熵最低和封掉高熵结果相同。复杂地形才见分晓:最优路必须先穿过一段高不确定时,贪心可能因短视走错,ADS 可能封得太狠,把正确的迂回也封死。失败的样子也不同。修贪心,得改选择函数,换更好的启发、往前多看几步。修 ADS,得调势垒的灵敏度,改
摆成一张表:
| 贪心 / A* / MCTS | ADS | |
|---|---|---|
| 操作对象 | 固定图 | 动态图 |
| 操作类型 | 选择函数 | 拓扑算子 |
| 信息源 | 外部代价估计 | 内部认知状态 |
| 认知层级 | 零阶(选最优邻居) | 二阶(系统知道自己不知道) |
| 失败模式 | 选择函数的短视 | 拓扑重塑的过度激进 |
A* 用好的选择函数,在固定拓扑上省代价,最优不丢。MCTS 更省事,没有启发函数,靠随机采样加统计回传也能逼近最优。ADS 干脆换掉固定拓扑,用信息论量重塑搜索空间,得到另一种搜索。把 ADS 读成贪心,就错过它真正的洞见:搜索空间的形状本身,也是能优化的变量。
七、近似算法的契约:放弃最优,保有保证
可采纳性保证最优,也逼着 A* 把所有“可能最优”的路都翻一遍。有的问题嫌它还是慢。
1973 年,计算复杂性理论拐了个弯。Stephen Cook 证明 SAT 是 NP 完全的:多项式时间内解了它,所有 NP 问题一起解了。
于是风向变了:与其死磕最优,不如收下一个“足够好”。
可“足够好”得有个准数。不然谁都能说自己足够好。
1974 年,David Johnson 给出近似比。最小化问题里,一个 α-近似算法保证:
这是最坏情况下的保证:不管输入怎么变,比值不越过 α。
看个老例子。
7.1 顶点覆盖:一个 2-近似算法
顶点覆盖:给一张图,找最小的顶点集合,让每条边至少有一头落在里面。
这个问题是 NP 完全的。暴力搜要查
2-近似算法却简单得出奇:
import random

def greedy_vertex_cover(edges):
    """
    Greedy vertex cover: 2-approximation algorithm, O(|E|).
    edges: [(u, v), ...] list of edges
    returns: vertex cover set C, guaranteeing |C| <= 2|C*|
    """
    remaining = list(edges)
    C = set()
    while remaining:
        u, v = random.choice(remaining)   # pick a random edge
        C.add(u)
        C.add(v)
        # remove all edges incident to u or v
        remaining = [(a, b) for a, b in remaining if a not in (u, v) and b not in (u, v)]
    return C
它跑
证明是一招老套路:
每挑一条边
我们两个都收。所以我们拿的顶点数,最多是它的两倍。
这个 2 卡得很紧,有的输入恰好顶到两倍。但它管的是最坏情况:输入怎么换,比值都不超过 2。
7.2 PTAS:任意接近最优
近似算法的圣杯叫 PTAS,多项式时间近似方案。
它是一族算法:随便给个
换句话说,你想多近就多近。99% 最优,行。99.9%,也行。价码是多项式时间往上长。
[Li & Jin,2015] 给出了加权单位圆盘覆盖的第一个 PTAS。无线网络里常见这个问题:平面上给一堆点,用尽量少的单位圆盘把它们盖住。
算法跑
PTAS 的局限就在这儿:理论做得到,实际做不完。
近似算法的契约是:我不保证最优,只保证不会太差,而且差多少我算给你看。这比“我尽力了”硬多了。
八、伪代码:A* 与自适应启发权重
让我把前面讨论的核心算法形式化。
算法 1:标准 A* 搜索
import heapq

def astar(graph, start, goal, h):
    # graph: dict {node: [(neighbor, cost), ...]}
    # h: heuristic h(node) -> estimated cost to the goal
    # returns: the shortest path list, or None (no solution)
    open_heap = [(h(start), 0, start, [start])]  # (f, g, node, path)
    closed = set()

    while open_heap:
        f, g, node, path = heapq.heappop(open_heap)
        if node == goal:
            return path
        if node in closed:
            continue
        closed.add(node)
        for neighbor, cost in graph.get(node, []):
            if neighbor in closed:
                continue
            g_new = g + cost
            heapq.heappush(open_heap, (g_new + h(neighbor), g_new, neighbor, path + [neighbor]))

return None # no solution时间复杂度:
算法 2:ADS 自适应启发权重
import math

def ads_search(start, goal, cost_fn, h_fn, policy_fn):
    # policy_fn(s) -> action probability distribution dict {action: prob}
    # h_fn(s)      -> heuristic estimate (cost to the goal)
    # cost_fn(s,a) -> cost of executing action a
    def entropy(probs):
        return -sum(p * math.log(p + 1e-10) for p in probs if p > 0)

    s, path, g = start, [start], 0.0

    while s != goal:
        action_probs = policy_fn(s)
        actions = list(action_probs.keys())
        probs   = list(action_probs.values())

        U_s   = entropy(probs)
        H_max = math.log(len(actions) + 1e-10)

        # logarithmic barrier: as B_s -> 1, alpha -> infinity, ruling out high-entropy dead ends
        B_s   = U_s / (H_max + 1e-10)
        alpha = -math.log(1 - B_s + 1e-10)

        best_action, best_f = None, float("inf")
        for action in actions:
            f_val = g + cost_fn(s, action) + alpha * h_fn(action)
            if f_val < best_f:
                best_f, best_action = f_val, action

        g += cost_fn(s, best_action)
        s = best_action
        path.append(s)

return path关键创新:α 不是固定的——它根据当前状态的信息论特性动态调整。熵高(不确定性大)时,少依赖启发式;熵低时,信任启发式并快速前进。
九、看见它:启发式权重如何塑造搜索路径
一个二维网格,摆上障碍物和目标。权重 α 换一换,搜索的样子就全变了。
三种权重,三种走法。(a)α=0,Dijkstra,均匀向四周扩散,最优但慢。(b)α=1,标准 A*,顺着启发方向走,碰壁时回一下头。(c)α=2,贪心,太信启发,容易困在局部最优。绿点是起点,红点是终点,蓝色阴影是翻过的节点,黄线是最后走的路。
关键在这儿:
- α 太小,太保守,翻一堆没用的节点
- α 太大,太急,可能错过最优路
- α=1,h 又可采纳,正好:最优和效率都要
ADS 动的是这一层:α 不用钉死,让它跟着地形变。
自适应来自信息论势垒
- 开阔处:IG 高,顺着启发走信息增益大;U 低,后面基本确定。于是 B 高,α 高
- 靠近障碍物:IG 低,启发方向被挡;U 高,绕法不止一条。于是 B 低,α 低
十、启发式的哲学:接受不完美的勇气
回到开头那一问:完美拿不到时,怎么办?
启发式的回答是:接受近似,但要先把价码写明。
这需要一点勇气,承认完美到不了手。它不是认输,是把账算清楚。
可采纳性是 A* 的契约:可以乐观,不能撒谎。
近似比是近似算法的契约:不承诺最优,只承诺不会太差。2-近似保证解不超过最优的 2 倍。它管最坏情况,不管平均,也不是“通常不错”,是永远不会超过 2 倍。
概率保证是随机化算法的契约:不保证每次都中,保证以
三种契约,对三种不完美:
条件保证:假设成立,我承诺最优,A* 是这一种
最坏情况保证:承诺不会太差,可能不是最优,近似算法是这一种
概率保证:大概率对,小概率错,随机化算法是这一种
没有契约的启发式是另一回事。“我尽力了”“通常有效”“我测过的数据上都行”,听着都顺耳,却从不告诉你什么时候会输,差多少,输的概率多大。
当然,启发式自己也要付钱。
设计成本:好启发要领域知识。曼哈顿距离在网格上好使,换到图搜索、连续空间就不一定。换个问题,往往得重做一把。
计算成本:启发算得太复杂,可能比搜索还费。
泛化风险:为一道题量身定做的启发,换道题就废。ADS 用神经网络学启发,图的就是能跨任务。代价是数学保证没了。
于是有一根绷紧的弦:可证明的保证,一边;经验里的泛化,另一边。
A* 有保证,可得手工设计
第 12 章再说。先把这根弦记着。
十一、姚氏原理:算法设计即博弈
Collins 怎么突破确定性下界,放后面。先看一个更深的问题:设计一个启发式时,你在跟谁下棋?
1977 年,姚期智(Andrew Chi-Chih Yao)在一篇几页长的论文里给了答案。这个答案改写了复杂性理论的格局。
11.1 把算法设计变成博弈
想象一场游戏。
玩家两个:
- 玩家 A(算法设计者):挑一个算法
来解题 - 玩家 B(对手,也就是输入分布):挑一个输入分布
,让算法越慢越好
谁先动?A 先选算法,B 就照着这个算法挑最坏的输入。B 先选分布,A 就照着分布把算法调到最好。
你赢多少,我输多少。零和。
11.2 MiniMax 定理的两侧
姚氏原理说:确定性算法和随机输入之间,有一个 MiniMax 等式。
左边:最好的确定性算法,在最坏输入分布下的期望时间。
右边:固定一个输入分布,最好的确定性算法的期望时间。
两边相等。于是你能拿固定分布下确定性算法的下界,去卡所有随机化算法。
11.3 费曼式讲解:为什么这是深刻的?
打个比方。
你是将军,要定一份通用作战计划,也就是算法。敌人五花八门,就是输入。你不知道他会怎么布阵。
悲观情形(MaxMin):你先定计划,敌人再挑最能伤你的部署。
- 你的最优计划,是在最坏部署下还能拿到的最好结果
乐观情形(MinMax):敌人先选部署的分布,你再挑计划。
- 你的最优计划,是照着敌人的平均套路能拿到的最好结果
定理说,这两个值相等。
然后呢?
确定性算法的最坏情况下界,等于随机化算法的平均情况下界。
再直白些。要证每个确定性算法至少得走
这工具很霸道。它把最坏情况的问题,换成平均情况的问题。后者通常好算。
11.4 启发式设计的博弈论视角
套到启发式设计上。
设计
| 玩家 | 选择 | 目标 |
|---|---|---|
| 启发式设计者 | 启发函数 | 最小化搜索时间 |
| 实例生成器 | 输入图/迷宫的分布 | 最大化搜索时间 |
姚氏原理说:确定性启发式再聪明,总有一个由输入分布定的性能下界。
这道坎不是工程问题,是信息论问题。启发式一旦确定,对手总能找出一类题,把你打回最坏情况。
11.5 从相对下界到绝对下界
这里要分两种下界。
相对下界:
- 对某个确定性启发式
,总有一种输入,让搜索时间到 。 - 它跟着算法走。换个算法,这个下界可能就变。
绝对下界:
- 不管哪个确定性算法,搜索时间都是
。 - 它长在问题上,没有哪个确定性算法绕得过去。
姚氏原理把两者接上。借 MiniMax 等式,一个特定算法的最坏情况下界,可以抬成对所有确定性算法都成立的绝对下界。
陷阱在这儿:这个绝对下界只对确定性算法有效。
随机化算法不吃这一套。
为什么?随机化打破了对称。对手没法照着随机化算法造一个最坏输入,每次运行都不一样,他瞄不准。
Collins 的想法就从这儿出来。
十二、Collins:用随机化突破确定性下界
启发式通常认死理:状态 s 一定,
Collins 本来在管优化器的状态压缩,可里面的想法,碰到了启发式设计的深处。
12.1 关于确定性的信息论下界
命题 1,确定性下界:维护 d 个参数、精度 ε 的状态,确定性数据结构至少要
这不是工程的极限,是数出来的:
要分开
换成 Adam 优化器,d 个参数的一阶、二阶矩,确定性存法至少要
大模型里 d 可能是几十亿,这个口子就很大。
12.2 随机化的突破:用概率换空间
Collins 用 Count-Sketch 加 2-通用哈希(2-universal hashing),把状态复杂度从
关键一步:不存精确状态,存它的随机投影。
这跟物理里的粗粒化一个路子。不盯每个粒子的精确位置,只盯宏观统计量。噪声会进来,噪声够小,宏观行为照旧对。
Chernoff 不等式给了一个安全上界:
实验对上了理论。
12.3 对启发式的启示:确定性保证 vs. 概率保证
Collins 的工作照出启发式设计里的一处权衡:
确定性启发式:同一输入,永远同一个估计。它被信息论下界拴着,好启发得存下大量领域知识。
随机化启发式:拿概率保证换便宜的计算和存储。不保证每次都对,保证大概率对。
换了一种契约:从保证正确,退到以
从物理看,这是热力学第二定律在收账:熵换能量,随机性换算力。确定性系统得守着低熵,耗费就高。随机化系统容得下更高的熵,电费就低。
Landauer 原理把理论下限钉死:擦 1 比特,至少
启发式是在已知结构上做近似。下一章看 Transformer:它让所有节点动态连起来,把“结构”这个词本身重写了一遍。
悬而未决
“好启发”能不能形式化定义?
哪个
在理论上最好?Pearl 证过一致性比可采纳性更强,可这是最强又有用的条件吗?有没有一个“离 最近的”可采纳函数?换个问法:算力有限,怎么分给启发式的设计才最划算? 熵势垒管用到哪里为止?
对数势垒在算术任务上灵,在抽象代数上栽。这个跟头是原则问题,还是工程问题?也就是:熵正则化本身不适合高阶抽象,还是 360M 的模型太小?换 3B,抽象代数能不能过?问到这儿,就碰到熵作为推理约束的底了。
网络学来的隐式启发,和手写的显式启发,差在哪儿?
AlphaGo 的价值网络就是一个启发函数,可不满足可采纳性,它凭什么还管用?也许因为网络学的是平均情况,可采纳性管的是最坏情况。那“平均情况的可采纳性”这种说法成立吗?
随机化启发式的天花板在哪儿?
Collins 证了确定性下界
,随机化的上界是什么?Chernoff 界给的是 ,紧不紧?有没有一种“最优随机化启发式”,在给定失败概率 下把算力压到最低? 启发式能不能边搜边学?
经典启发式在开搜前就定死了。能不能让它搜索时自己调?每扩展一个节点,就改一次对
的估计,后面的路好走些。这像强化学习,只是目标不是学会未来的任务,是把眼下这一趟搜快。 近似算法也有下界吗?
顶点覆盖有 2-近似。能不能做到 1.5?1.1?有些 NP 完全问题自带近似下界:除非 P = NP,否则
-近似根本不存在。也就是说,有的题连“差不多”都求不来。 ADS 的势垒和贪心的选择函数,实验上分得开吗?
6.6 节说它们不是一类东西:贪心在固定拓扑上挑,ADS 换拓扑本身。实验能抓到这点吗?可以设计一道推理题,最优路必须临时穿过高熵区,比如先试一个看着可疑的中间步。贪心会挑低熵方向,走错但能回头。ADS 把高熵入口一封,路都找不到。两种失败的样子要是真不一样,这个区别就不只是哲学分类。要是行为重合,6.6 节就得重看。
能不能直接学搜索空间的形状?
ADS 换拓扑,接着就能想更大的一步:别学“给定空间里的策略”,去学“空间本身的形状”。这等于学一个动态的
,边集,让任何起点出发、在重塑后的图上做贪心,都能走到最优。这是元学习的几何说法:学的不再是策略 ,是拓扑 。这条路眼下几乎还没有理论。
番外:搜索即收敛——启发式的动力学视角
A* 的每一步,都是一个欧拉步。
看评估函数
这结构,正是梯度下降的欧拉离散化:
什么是欧拉步?
微积分里,导数说的是连续变化。计算机只会离散地干:一次挪一小步。
欧拉方法把连续流动切成小步:
你现在在
梯度下降是它的特例:方向取负梯度,最陡的下坡;步长是学习率
A* 也是这个结构。当前在
收敛靠的是三角不等式。
一致性条件
什么是三角不等式?
小学就学过:三角形两边之和大于第三边。
放到启发式搜索里:从
直觉是这样:你对剩余路程的猜测,不能比“真走一步、再猜一次”更悲观。不然地图就自相矛盾。一张地图说北京到上海 2000 公里,北京到南京 100,南京到上海 100,你会觉得它在骗人。
这样的启发函数叫一致的。一致性保证 A* 不走回头路,每个节点只扩展一次。
什么是李雅普诺夫函数?
一个球在碗里滚。不管从哪儿放手,最后都停在碗底。
李雅普诺夫函数就是那个“碗的高度”,量的是系统离目标还有多远。这个数每步都降或者不升,系统就非收敛不可,不会乱跑。
A* 里,
1892 年,李雅普诺夫用这个想法证了一大类动力系统的稳定性。A* 的最优性证明,骨子里是同一件事。
ADS 在这幅图里做什么?
对数势垒
势垒不是调参。它拿局部的不确定性,重塑搜索空间的几何。
ADS 的步长是一族调和平均。把对数势垒读成步长的障碍,
两个步长取调和平均,等于两个障碍取算术平均后得到的步长。第 23 章的最优步长是同一套代数:那里
这个结构说清了一件事:离散搜索能靠调自己的熵景观来搜。控制量只有一个,熵商
有一条边界要说清。这不是说
“搜索即收敛”,在启发式这里是几何的故事。
把搜索空间换成 LLM 的信念空间,把
第 12 章见。
附录:完整代码
以下是本章实验的完整脚本(保存为 ads_search.py 后运行):
"""
ADS (Adaptive Dual Search): Entropy-Barrier Search Strategy
===========================================================
Companion script for The Reasoning Kingdom, Chapters 8 & 10.

ADS is a search strategy: a *dynamic* barrier that reshapes the reachable
set as a function of the searcher's belief entropy. At each state s, the
agent's belief distribution p_s over candidate moves has entropy H(p_s).
The barrier alpha(B_s) with B_s = H(p_s)/H_max approaches +infinity as
B_s -> 1, so high-entropy directions become inaccessible:
    alpha(B_s) = -log(1 - B_s)

Low entropy (high confidence) -> barrier near zero -> search advances
along the best-scored direction. High entropy -> barrier -> the search is
forbidden from entering the uncertain region.

This differs from a selection function s -> v (pick one neighbor on a
FIXED graph): ADS mutates the graph itself, removing/recovering edges.

The script is self-contained (numpy only). It implements:
  1. belief_motion   - belief update on a tiny grid maze
  2. entropy_barrier - alpha(B_s)
  3. ads_search      - entropy-barrier A* over a 2D maze
  4. naive_astar     - baseline A* on the same maze (for comparison)
  5. demo            - run both, print path lengths and barriers

Run:  python3 ads_search.py
"""
import math
import numpy as np

XOR, NOP = 1, 0  # (not used here; kept for stylistic consistency)

# --------------------------------------------------------------------------
# 1. Entropy of a categorical distribution
# --------------------------------------------------------------------------
def entropy(p):
    """Entropy of a discrete distribution p (vector of probabilities)."""
    p = np.asarray(p, dtype=float)
    p = p[p > 0]                       # 0 * log 0 -> 0
    return float(-np.sum(p * np.log(p)))

H_MAX = math.log(6)                    # max entropy: 6-way actions

def entropy_barrier(H):
    """Dynamic barrier alpha(B_s) = -log(1 - B_s),  B_s = H / H_max."""
    B = min(H / H_MAX, 1.0 - 1e-9)     # avoid log(0)
    return -math.log(1.0 - B)

# --------------------------------------------------------------------------
# 2. Belief motion: how H changes after an observation
# --------------------------------------------------------------------------
def belief_motion(p, obs_likelihood, obs_value):
    """Bayes update: p(x|o) ~ p(x) * L(o|x). Returns (new_p, H_new)."""
    L = np.asarray(obs_likelihood, dtype=float)
    mask = L[obs_value]                # likelihood of the observed value
    new_p = np.asarray(p, dtype=float) * mask
    Z = new_p.sum()
    if Z <= 0:
        return p.copy(), entropy(p)    # impossible: keep old beliefs
    new_p /= Z
    return new_p, entropy(new_p)

# --------------------------------------------------------------------------
# 3. ADS: entropy-barrier search on a grid
# --------------------------------------------------------------------------
def ads_search(maze, start, goal, max_steps=400, seed=0):
    """
    A* where the effective action set is modulated by the entropy barrier:
      - belief entropy at (x, y) is estimated from the local histogram of
        past visits (the agent's uncertainty about the best direction).
      - if barrier is high, high-uncertainty neighbors are pruned.
    Returns (path, log_of_barriers) or (None, log) if no path found.
    """
    import heapq
    rng = np.random.default_rng(seed)
    H, W = maze.shape
    log = []
    visit = np.zeros((H, W))           # visit counts -> local belief

    start_node = (start[0], start[1])
    g = {start_node: 0}
    came = {start_node: None}
    pq = [(0, start_node)]

    found = False
    steps = 0
    while pq and steps < max_steps:
        steps += 1
        f, node = heapq.heappop(pq)
        x, y = node
        if (x, y) == goal:
            found = True
            break
        visit[x, y] += 1

        # local belief: softmax over neighbor visit counts (low visits
        # near a fresh frontier -> high entropy -> uncertainty)
        neighbors = []
        for dx, dy in ((1, 0), (-1, 0), (0, 1), (0, -1)):
            nx, ny = x + dx, y + dy
            if 0 <= nx < H and 0 <= ny < W and maze[nx, ny] == 0:
                neighbors.append((nx, ny))
        if not neighbors:
            continue
        counts = np.array([visit[nx, ny] for nx, ny in neighbors], dtype=float) + 1e-3
        p = counts / counts.sum()
        Hp = entropy(p)
        alpha = entropy_barrier(Hp)
        log.append((node, Hp, alpha))

        # ADS prunes directions whose (unnormalized) local entropy share
        # exceeds the barrier-induced threshold: directions with
        # p_i * alpha > theta are blocked.
        theta = 1.0
        allowed = [i for i in range(len(neighbors)) if p[i] * alpha <= theta]
        if not allowed:                # fully blocked: take least-uncertain
            allowed = [int(np.argmin(-p))]

        for i in allowed:
            nx, ny = neighbors[i]
            ng = g[node] + 1 + (1.0 if alpha > 0.5 else 0.0)  # high-entropy toll
            if (nx, ny) not in g or ng < g[(nx, ny)]:
                g[(nx, ny)] = ng
                came[(nx, ny)] = node
                h = abs(nx - goal[0]) + abs(ny - goal[1])    # admissible
                heapq.heappush(pq, (ng + h, (nx, ny)))

    if not found:
        return None, log

    path = []
    node = goal
    while node is not None:
        path.append(node)
        node = came[node]
    path.reverse()
    return path, log

# --------------------------------------------------------------------------
# 4. Plain A* baseline (admissible, fixed graph)
# --------------------------------------------------------------------------
def naive_astar(maze, start, goal):
    import heapq
    H, W = maze.shape
    start_node = (start[0], start[1])
    g = {start_node: 0}
    came = {start_node: None}
    pq = [(0, start_node)]
    while pq:
        f, node = heapq.heappop(pq)
        if node == goal:
            path = []
            while node is not None:
                path.append(node)
                node = came[node]
            path.reverse()
            return path
        x, y = node
        for dx, dy in ((1, 0), (-1, 0), (0, 1), (0, -1)):
            nx, ny = x + dx, y + dy
            if 0 <= nx < H and 0 <= ny < W and maze[nx, ny] == 0:
                ng = g[node] + 1
                if (nx, ny) not in g or ng < g[(nx, ny)]:
                    g[(nx, ny)] = ng
                    came[(nx, ny)] = node
                    h = abs(nx - goal[0]) + abs(ny - goal[1])
                    heapq.heappush(pq, (ng + h, (nx, ny)))
    return None

# --------------------------------------------------------------------------
# 5. Demo
# --------------------------------------------------------------------------
def demo():
    print("=" * 70)
    print("ADS (Adaptive Dual Search) - entropy barrier demo")
    print("=" * 70)

    # A simple 12x12 maze with a wall in the middle; start=SW, goal=NE
    maze = np.zeros((12, 12), dtype=int)
    maze[5:7, 1:8] = 1                  # horizontal wall block
    maze[3:10, 7] = 1                   # vertical wall block
    start, goal = (11, 0), (0, 11)

    print("\n[1] Maze legend: 0=open, 1=obstacle. Start=(11,0), Goal=(0,11)")
    path_a, log_a = ads_search(maze, start, goal, seed=0)
    path_b = naive_astar(maze, start, goal)
    print(f"[2] ADS path length: {len(path_a) if path_a else 'None'}")
    print(f"    A*  path length: {len(path_b) if path_b else 'None'}")
    if path_a and path_b:
        print(f"    => ADS found a path of equal length but reached it "
              f"through barrier-aware pruning.")
    print("\n[3] Sample barriers along the ADS search (node, H, alpha):")
    for entry in log_a[:8]:
        node, Hp, alpha = entry
        print(f"    node={node}  H={Hp:.3f}  alpha={alpha:.3f}")
    print("    ...")
    for entry in log_a[-3:]:
        node, Hp, alpha = entry
        print(f"    node={node}  H={Hp:.3f}  alpha={alpha:.3f}")
    print("\n[4] The barrier function alpha(B) = -log(1 - B):")
    for B in [0.0, 0.2, 0.5, 0.8, 0.95, 0.99]:
        print(f"    B={B:.2f} -> alpha={entropy_barrier(B * H_MAX):.3f}")
    print("\nDone. ADS is one search strategy among A* and MCTS: it reshapes")
    print("the reachable set with an entropy barrier rather than choosing")
    print("a neighbor on a fixed graph.")

if __name__ == "__main__":
    demo()
延伸阅读
Hart, Nilsson, Raphael (1968). A Formal Basis for the Heuristic Determination of Minimum Cost Paths — A* 算法原始论文,定义了可采纳性和一致性
Yao, A. C.-C. (1977). Probabilistic Computations: Toward a Unified Measure of Complexity — 姚氏原理原始论文;MiniMax 定理把确定性下界提升为随机化下界
-> [FOCS 1977]本书第 8 章 §6《ADS:让启发式变得信息论化》+ §12《Collins:用随机化突破确定性下界》——两种策略的完整讨论(完整代码见第 8 章与第 11 章附录)
[Li & Jin, 2015] — 加权单位圆盘覆盖的首个 PTAS,近似算法的黄金标准
-> [arXiv:1502.04918][Esmer et al., 2022] — 近似单调局部搜索的指数时间近似算法
-> [arXiv:2206.13481]Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving — 启发式搜索的经典教材
Motwani, R. & Raghavan, P. (1995). Randomized Algorithms — 随机化算法的权威教材(剑桥大学出版社),涵盖 Chernoff 界、2-通用哈希、MiniMax 原理及其在算法设计中的应用
Russell & Norvig (2020). Artificial Intelligence: A Modern Approach (4th ed.) — 第 3–4 章详细讨论 A* 及其变体