第5章:拟合的陷阱——统计相关性不是推理
模型见过一百万只猫之后,它知道猫是什么吗?
一、一个让人不安的实验
2021 年,Bender 等人发了篇论文,题目不客气:“论随机鹦鹉的危险”(On the Dangers of Stochastic Parrots)。
标题不是修辞。是诊断。
论文的靶子是大型语言模型。它在海量文本上训练,干的活只有一件:预测下一个词。Bender 等人的判断是,不管喂进去多少文本,它做的都是统计模式匹配——记住哪些词常一起出现,再把见过的模式复现出来。像鹦鹉。听多了人说话,它能在合适的时机说“你好”,也能说“再见”。它不知道这两个词是什么意思。
比喻刺耳,因为它戳到一件事:统计相关和因果理解之间,隔着一道沟。
先看一个具体的实验。
2023 年,Hodel 和 West 做了个简单的测试。他们让 GPT-3 做字母串类比题——Webb 等人(2023)说,GPT-3 已经从这个任务上“涌现”出了类比推理。他们来验这句话。
原题长这样:
input: abc -> abd, kji -> ?
expected output: kjj
规律很简单:最后一个字母往后挪一位。GPT-3 在这个任务上做得很好。
然后 Hodel 和 West 动了最简单的两处:把字母串从 3 位改成 4 位;把字母表的顺序稍微打乱。
GPT-3 立刻塌了。
不是掉几个点,是从接近 100%,掉到接近瞎猜。人类在这些变体上几乎没受影响。人抓的是规律,不是绑在长度和字母表上的表面模式。
这一章要问的就是:模型把训练误差压到最低的时候,它学到的到底是什么?
二、经验风险最小化的契约
把这件事说得精确一点。
监督学习的标准范式叫经验风险最小化(Empirical Risk Minimization,ERM)。手里有训练数据
这里
经验风险最小化(ERM):训练模型在做什么?
经验风险最小化是大多数机器学习背后的引擎。大白话:在训练数据上,把模型的预测误差压到尽可能小。
几个关键术语:
- 假设
:模型本身,比如一个神经网络。给输入 ,它吐出预测 - 损失函数
:给“预测有多差”打分。标签是“狗”却猜了“猫”,损失很大;猜对了,损失很小 - 经验风险
:所有训练样本上的平均损失。最小化它,就是让模型在训练集上尽量多答对
问题就在这儿:把训练误差压到最小,不等于真的懂规律。模型可能只是在“背答案”,也就是过拟合;也可能学到了表面模式,没摸到底层机制。这一章追的就是后者:ERM 到底学到了什么?
ERM 的理论保证来自一个朴素的直觉:训练数据若是从某个分布
收敛有多快?假设空间有限,速度是
这里藏着一个前提:ERM 优化的东西,和我们真正关心的东西,是不是同一件事?
拆开看。
ERM 在做什么?它找一个函数
推理要的又是什么?它要模型抓住
两回事。
统计学习理论有个经典结果,Vapnik 和 Chervonenkis 在 1970 年代建的框架,讲的是泛化界:
不等式说的是:假设空间不太复杂,训练误差低的模型,测试误差也会低。
注意里面的条件:测试数据和训练数据得来自同一个分布
现实里,这个条件几乎从不成立。
训练数据是你手头能收集到的:某一家医院,某一个时间段。模型部署之后,撞上的是别的医院、别的季节。
分布偏移不是例外。是常态。
一偏移,ERM 学到的那些“在训练数据上有效的相关性”,就可能整个失效。
停顿一下
模型把训练集背下来,叫过拟合。这是错误,要罚。
但如果模型记住了整个互联网呢?
那我们该叫它什么?
GPT-4 的训练数据,差不多是人类写过的东西里的一大勺。它也“记住”了这一切的话,跟过拟合差在哪儿?只是规模,还是另有什么东西?
还有一层。分布偏移来了,ERM 会失效。人也会。换个陌生的文化,人照样判断失准;进一个新领域,照样犯低级错误。
所以这个缺陷,是机器学习独有的,还是每个归纳学习的系统都有?你也是其中一个。
先搁桌上。
三、捷径学习:当相关性比因果更容易
一个思想实验。
假设你要训练一个模型认“奶牛”。训练集里有 1000 张奶牛照片:950 张的背景是草地,50 张的背景是沙滩,来自某个海边农场。
ERM 会学到什么?
模型要是够简单,会学到:“背景是草地,就猜奶牛。”这条规则在训练集上有 95% 的准确率。不坏。
它抓住奶牛的本质了吗?没有。搬到沙滩农场,每一头奶牛都会被它认错。
这有个名字,捷径学习:模型捡训练数据里的虚假相关用,绕开了真正的因果特征。
2020 年,Geirhos 等人把这类现象查了个遍。结论:深度学习里到处都是捷径。
- 纹理偏见:在 ImageNet 上训练的模型靠纹理分类,不靠形状;人反过来
- 背景依赖:检测模型把背景当线索,比如“船总在水面上”
- 数据集偏见:情感模型盯着几个高频词,“terrible”“amazing”,句子整体说什么反倒不管
为什么会这样?
因为 ERM 没有办法分开有用的相关和虚假的相关。哪个特征在训练数据里跟标签沾边,它就用哪个,不管出了训练分布还成不成立。
2023 年,Puli 等人挖到更深一层。虚假特征一点额外信息也不给的时候,稳定特征已经完全定了标签的时候,默认的 ERM 设置——梯度下降加交叉熵——还是偏爱捷径。
为什么?梯度下降暗地里在最大化分类边界。数据线性可分时,最大的边界往往属于那个“稳定特征和捷径一起用”的解——哪怕光靠稳定特征就能把训练误差压到零。
这不是过拟合。训练误差已经是零。这是归纳偏置:梯度下降加交叉熵天生偏爱某一类解,捷径在场时,这类解就会往捷径上压。
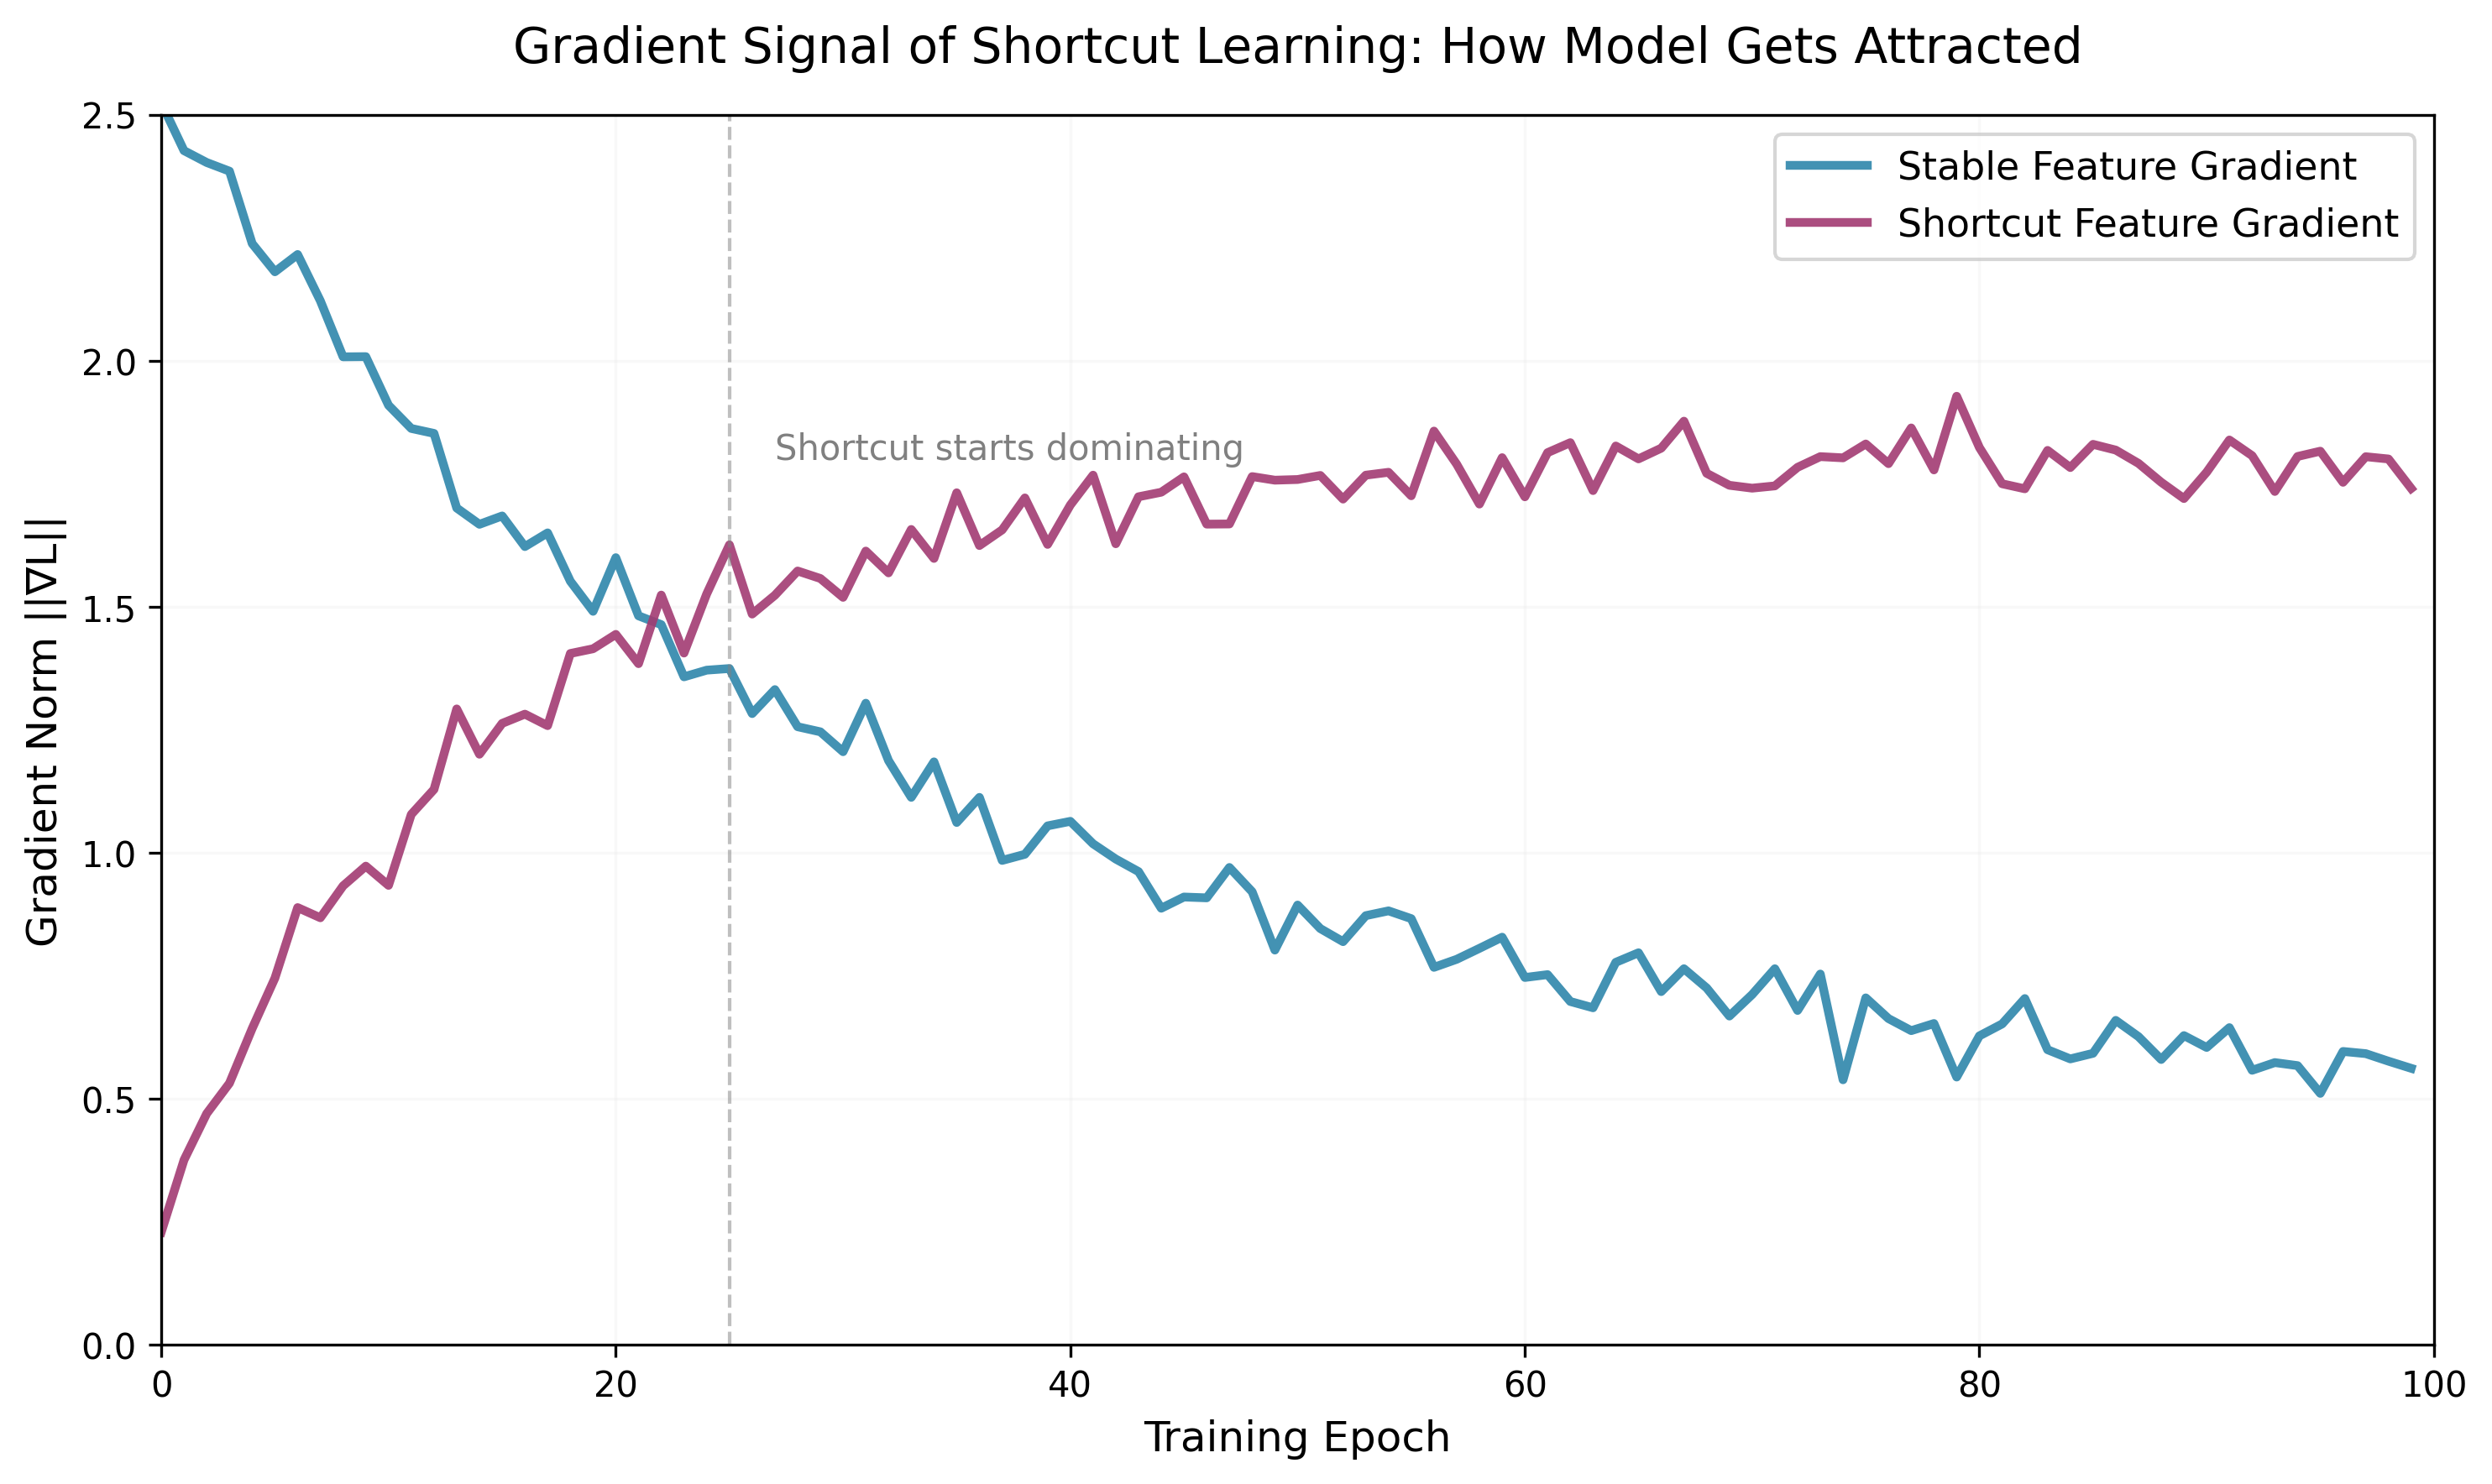
图1:训练过程中,捷径特征的梯度范数迅速上升并保持高位,而稳定特征的梯度持续衰减。模型在优化过程中逐渐被捷径吸引,即使稳定特征已经足以完成任务。
换个更形式化的框架来说。
四、因果图视角:稳定特征与虚假特征
假设数据生成过程能用一个因果图写下来。三个变量:
:标签(比如“这是不是一头奶牛”) :稳定特征(比如奶牛的形状和纹理) :捷径特征(比如背景是不是草地)
真实的因果关系是:
也就是说,标签
这种相关性不是因果。
ERM 只看得见联合分布
训练数据里
问题在测试那天。数据换个分布,
跟模型聪不聪明无关。这是 ERM 的构造限制:它优化的是
Pearl 的因果阶梯说,要回答一个干预问题——“把背景换成沙滩,模型还认不认得出奶牛?”——光有条件概率不够。得要一个因果模型。
ERM 只看得到观测数据。分不开相关和因果。
五、随机鹦鹉假说:复读不是理解
回到开头的问题:大型语言模型是随机鹦鹉吗?
要害不在它有没有意识、懂不懂。那些是哲学问题,先放一边。要害是:它的行为,有多少能拿“记住加检索训练数据里的模式”解释掉?
2025 年,Zhao 等人做了个能定胜负的测试:思维链(CoT)推理,把步骤一步步写下来,到底是真推理,还是训练分布照出来的一面镜子?
实验环境叫 DataAlchemy,完全可控。模型从头训练,然后他们一点点拉开训练数据和测试数据的分布差距:
- 任务分布偏移:训练时见过加法,测试时做乘法
- 长度分布偏移:训练时见过 3 位数运算,测试时做 5 位数运算
- 格式分布偏移:训练时见过“step 1”和“step 2”的格式,测试时换成“first”和“second”
结果很难看。三种偏移下,CoT 都明显退化。模型不是在推理,是在做模式匹配。它学会的是“什么样的输入配什么样的思维链格式”,测试时把格式照着摆一遍。
测试分布一换,这套复现就失效。
第一节里 GPT-3 在字母串上塌掉,是同一个现象。模型抓住的是表面的统计规律,不是底下的抽象规则。
底下还有一层。
Bender 等人的批评里藏着一个假设:模型只是在做统计模式匹配的话,本事就有上限,越不过训练数据的统计结构。
这个假设对吗?
2023 年,Wei 等人提出反驳:模型就算只是在做模式匹配,只要训练数据足够大、足够多样,光靠模式匹配也可能长出看起来像“推理”的行为。
争的是一个词:涌现。模型和数据大到某个坎上,会不会突然换一个性质?
现在的证据两头都有。
一头是让人吃惊的本事。GPT-4 在某些推理任务上,已经接近人类的平均水平。
另一头是这些本事一碰分布偏移就碎。碎得太容易,让人怀疑它还是复杂的模式匹配。
能定胜负的只有一条:训练里没见过的组合,它做得对吗?
下一节就把分布偏移当试金石。
六、分布偏移:推理能力的试金石
模型真懂自己在干什么的话,输入分布一变,它的性能应该慢慢退,不该塌。
这一条可以检验。
分布内(In-Distribution,ID)性能量的是模型在与训练数据相似的数据上表现如何。这就是标准的测试集评估。
分布外(Out-of-Distribution,OOD)性能量的是模型在训练分布之外的数据上表现如何。这才是真泛化。
看几个例子。
例子一:医学图像分割中的捷径
2024 年,Woodland 等人研究了医学图像分割中的 OOD 检测。在肝脏分割上训练的模型,遇上不同医院、不同扫描仪的图像,性能明显下降。
图像本身没毛病。毛病在模型:它把训练数据里的设备特异性伪影当成了捷径。
比如某一种型号的 CT 扫描仪,会在图像的一个角落留下特定的噪声。模型学会了拿这块噪声帮忙分割——训练数据里,噪声和肝脏位置绑得很紧。
换一种扫描仪,噪声没了,模型的准确率跟着塌。
例子二:自然语言理解中的虚假相关
2023 年,Shuieh 等人把三种后训练算法(SFT、DPO、KTO)放在虚假相关底下挨个试了一遍。
三类任务——数学推理、指令遵循、文档问答——数据里植入不同程度的虚假相关,从 10% 到 90%。
结果一致:虚假相关一高,所有模型都明显掉分。偏好学习(DPO、KTO)在数学推理上能扛,换到依赖上下文的任务,监督微调(SFT)反倒更好。
没有一种训练方法能通用地挡住捷径。怎么选,看任务,也看虚假相关长什么样。
例子三:CoT 推理的分布脆弱性
回到 Zhao 的 DataAlchemy。核心发现是:CoT 只是训练分布的一面镜子,一碰就裂。
任务一偏、长度一偏,CoT 就明显变弱;格式偏了也一样。它学的是训练数据里推理链的样子,不是怎么推理。
更糟的是,它错得很有规律。不是偶尔失手,是某几类输入上稳定地错——那些输入触发了训练数据里没有的模式。
三个例子说的是同一件事:分布偏移不是边角料,是正题。只在分布内好看的模型,学的多半是统计相关,不是因果机制。
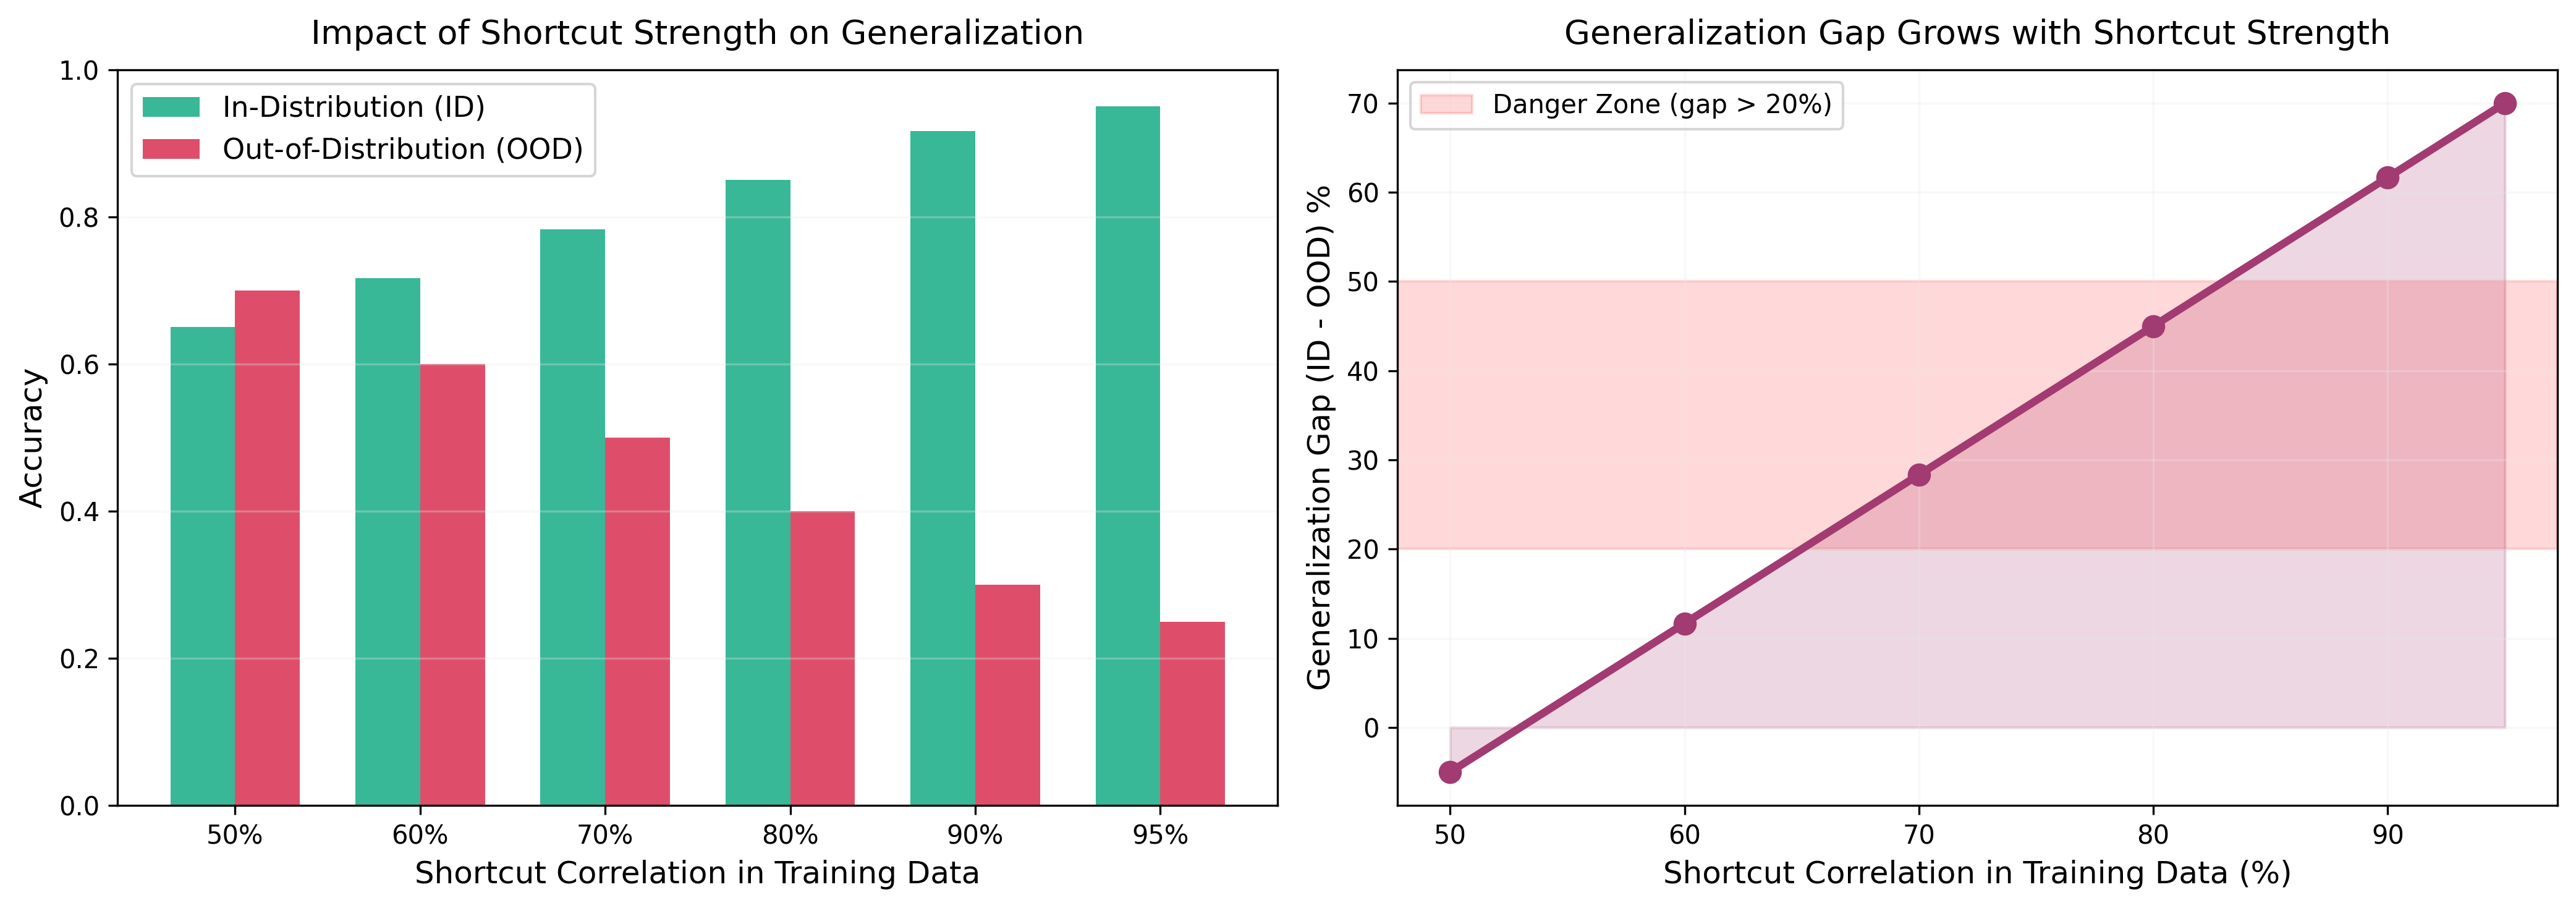
图2:左图:训练数据中的捷径相关性越强,ID 准确率越高,但 OOD 准确率越低。右图:泛化差距(ID − OOD)随捷径强度线性增长;一旦捷径相关性超过 80%,差距就进入危险区(>20%)。这量化了捷径学习对分布外泛化的破坏。
七、为什么 ERM 的归纳偏置不够
这里要分清一件事。
问题不在 ERM。ERM 本身是个合理的原则。问题在它的搭配:梯度下降配交叉熵,生出来的归纳偏置不适合学因果结构。
展开说。
归纳偏置是学习算法中的隐含假设——当多个假设都能拟合训练数据时,它决定了算法会选哪一个。
梯度下降 + 交叉熵的归纳偏置是什么?
在线性可分的情况下,梯度下降收敛到最大边界解——使决策边界到最近训练样本的距离最大的那个解。
这通常是好事。最大边界往往意味着更好的泛化——因为它对训练数据的微小扰动更鲁棒。
捷径一在,最大边界解往往就把稳定特征和捷径一起用上了。
为什么?两个特征一起用,边界能推得更远。哪怕其中一个在分布外会失效。
Puli 等人 2023 年的研究精确刻画了这一现象。他们证明:在一个简单的线性感知机任务中,即使稳定特征已经完全决定标签,梯度下降仍然会给捷径分配非零权重——因为这样做能最大化边界。
那么,解法是什么?
一个方向是改变归纳偏置。例如,不追求最大边界,而是追求均匀边界——让所有训练样本到边界的距离尽可能相等。
Puli 的 MARG-CTRL(Margin Control)走的就是这条路:把损失函数改个形状,逼模型给出均匀边界,少靠捷径。
另一条路是显式地建模因果结构。这要越过观测数据,用干预,用反事实。这是第六章的主题。
但即使不借助因果推断,更聪明的训练策略也能缓解捷径学习。
八、缓解策略:从数据增强到对抗训练
知道捷径在哪儿,能做什么?
策略一:数据增强
最直接的方法:让训练数据更多样,打破虚假相关。
在奶牛的例子中,如果你能收集到足够多的“沙滩上的奶牛”图片,模型就不会过度依赖“草地背景”这个捷径。
但这个方法有两个问题。
第一,你得先知道捷径是什么。真实场景里,捷径藏着,你不知道模型在拿什么虚假相关凑数。
第二,即使你知道捷径,收集多样化的数据也可能非常昂贵,或者根本不可行。
策略二:重加权训练样本
有些训练样本“太容易”,模型走捷径就能猜对。那就调低它们的权重,逼模型去啃难的。
这就是 Li 等人在 2020 年提出的 Tilted ERM 的思路。通过引入一个“倾斜”参数
当
通过调节
策略三:对抗训练
另一个思路:专门造“对抗样本”——模型靠捷径就会栽的那些输入——拿它们来练。
Sricharan 和 Srivastava 在 2018 年提出:用 GAN 生成模型高置信度分类、但实际上是 OOD 的样本,然后最大化模型在这些样本上的熵(不确定性)。
这迫使模型不要在分布外输入上过度自信,从而减少对捷径的依赖。
策略四:因果正则化
如果我们对因果结构有先验知识,就可以把它编码进一个正则项。
例如,如果我们知道某个特征
这里
这些办法有个共同的软肋:全都得有人看着。要么手里有关于捷径的先验,要么备着现成的 OOD 数据。
完全无监督的时候,检测和缓解捷径,还是没解。
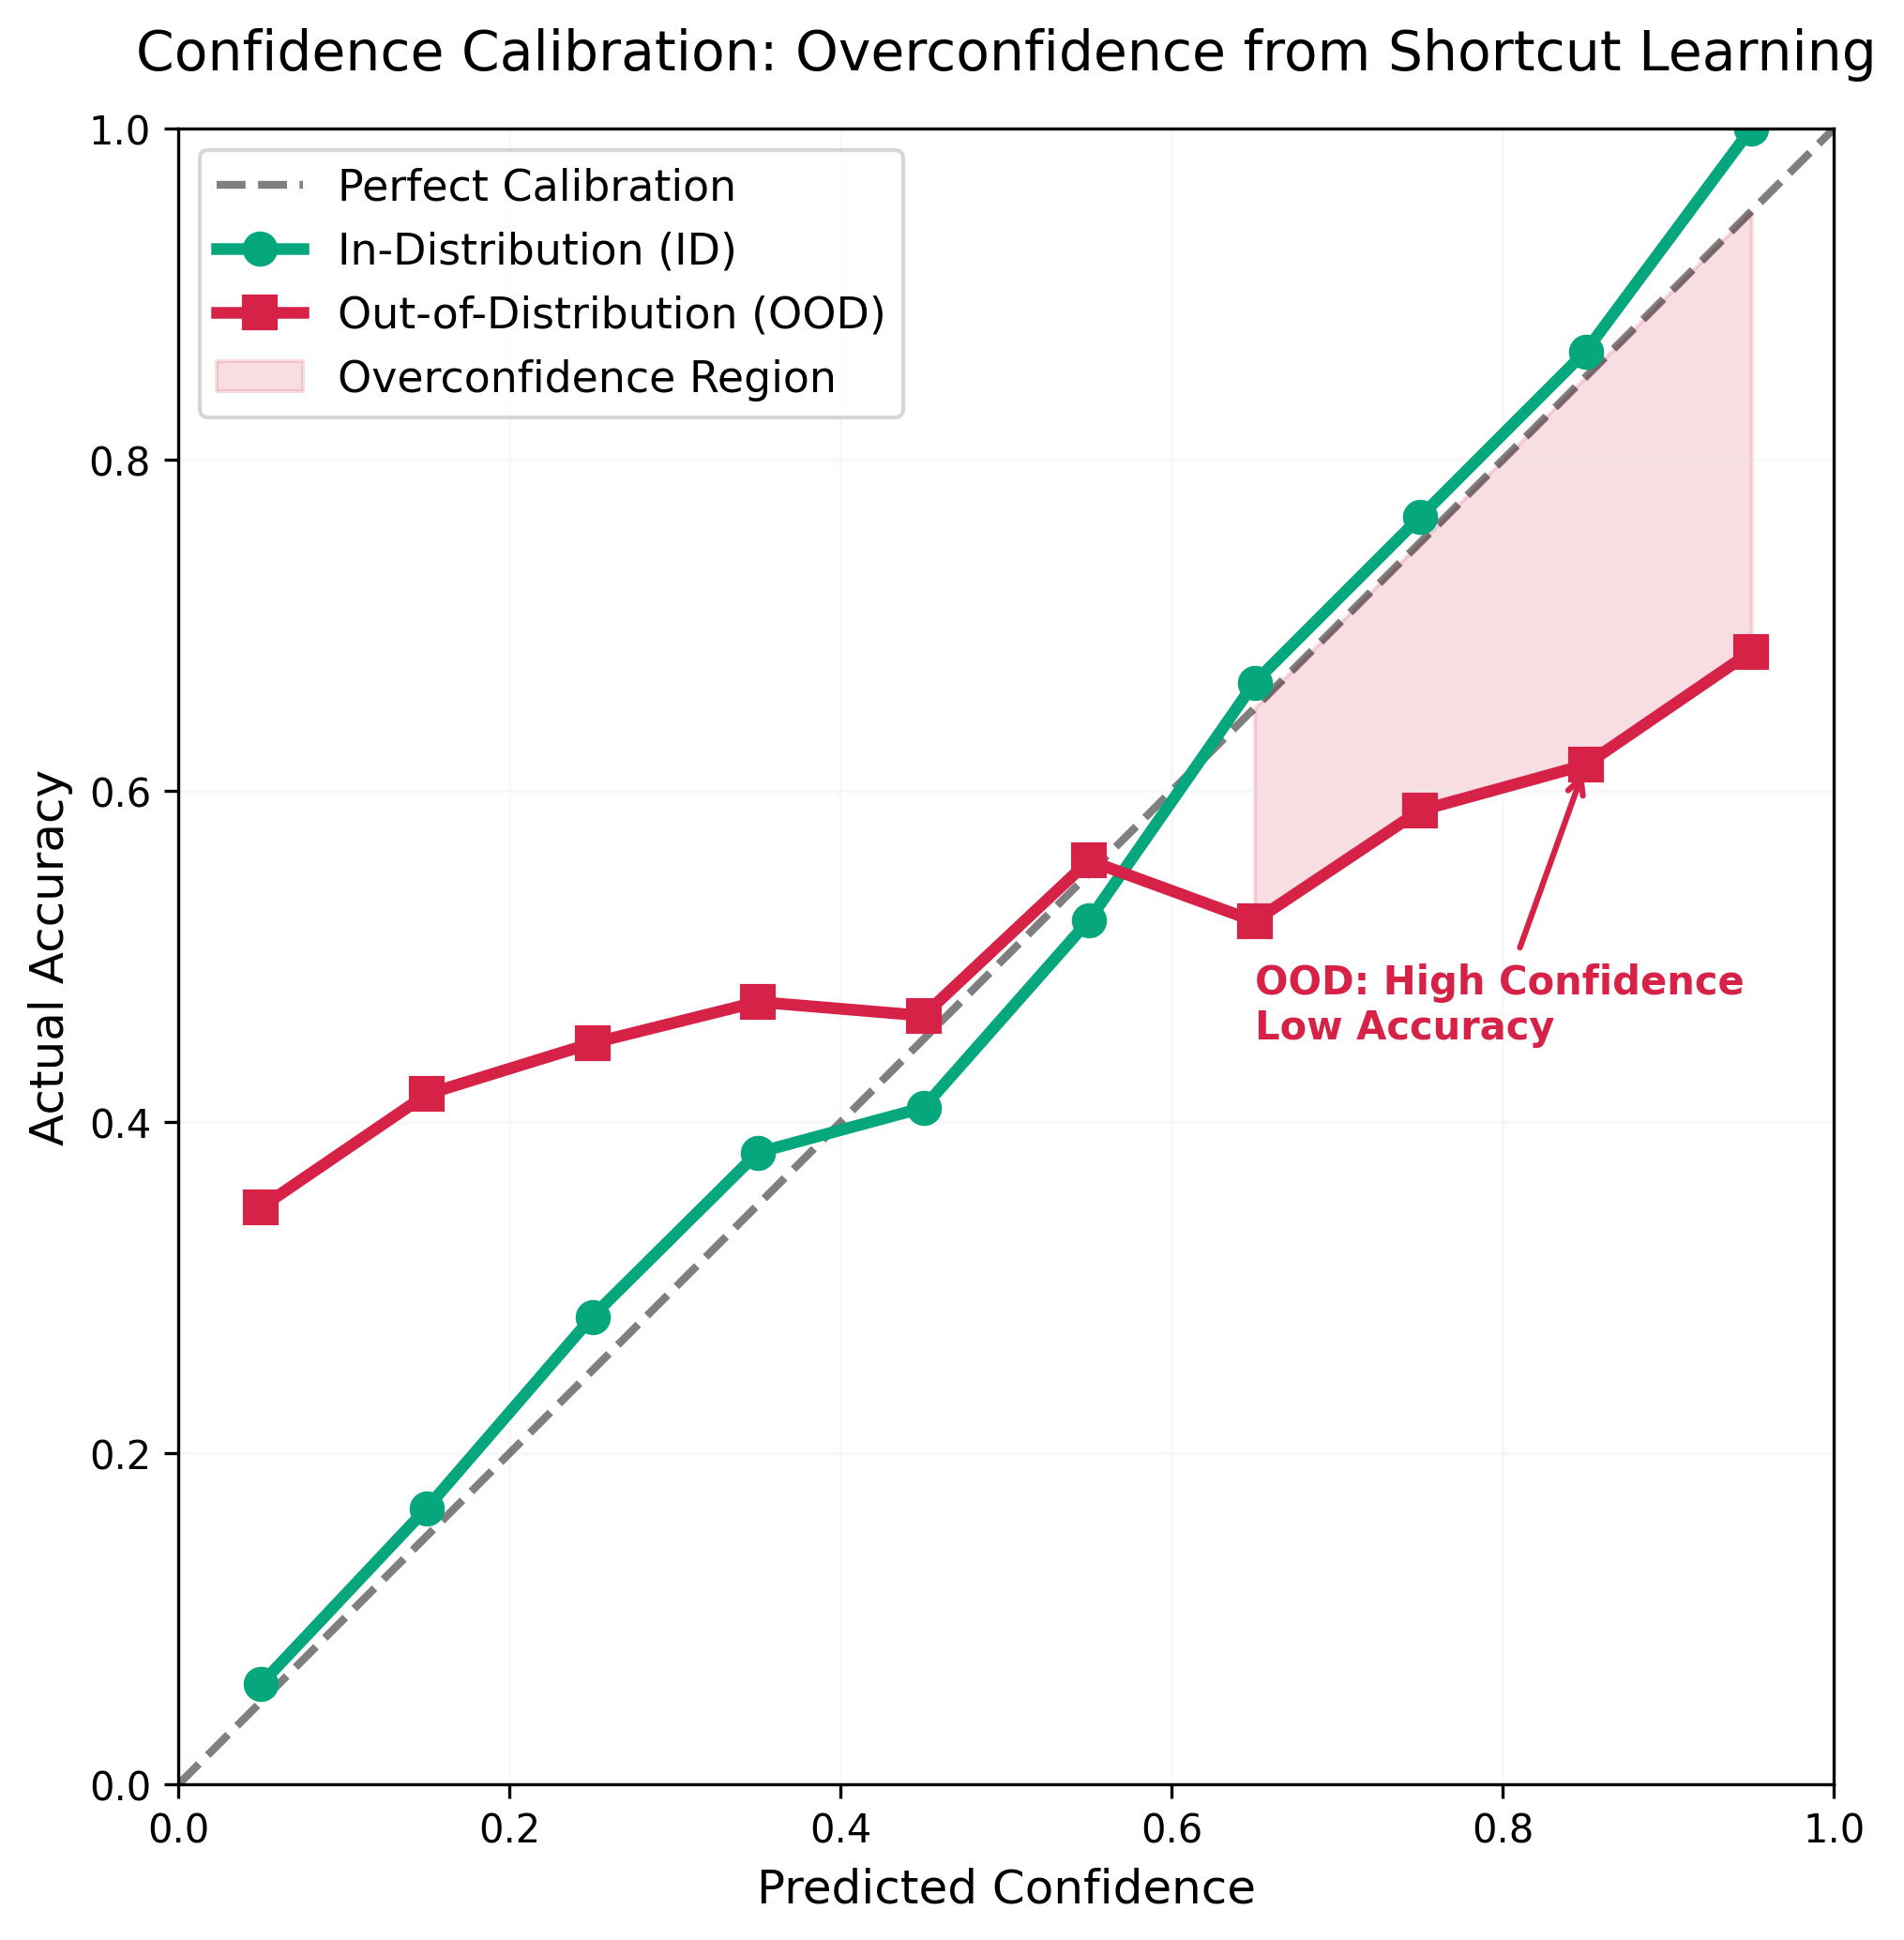
图3:置信度校准曲线,捷径学习最危险的后果——过度自信。ID 数据(绿色)贴着对角线,OOD 数据(红色)严重偏离:置信度在 0.8–0.9 时,模型的实际准确率只有 0.6–0.7。阴影区是过度自信区,模型在那儿自信地给错答案,一点不确定的提醒都没有。
九、伪代码:捷径检测与 OOD 泛化测试
让我把上面讨论的核心算法形式化。
算法1:基于梯度的捷径检测
import torch

def shortcut_detection(model, dataloader, shortcut_indices, stable_indices, tau=0.5):
    """
    Gradient-based shortcut detection.
    shortcut_indices: column indices of the shortcut features in the input
    stable_indices:   column indices of the stable features in the input
    Returns: shortcut dependence score S (higher means stronger shortcut reliance)
    """
    model.eval()
    ratios = []
    criterion = torch.nn.CrossEntropyLoss()

    for x, y in dataloader:
        x = x.requires_grad_(True)
        output = model(x)
        loss = criterion(output, y)
        loss.backward()

        g = x.grad  # shape: (batch, n_features)
        g_c = g[:, shortcut_indices].norm(dim=1)   # norm of gradients w.r.t. shortcut features
        g_s = g[:, stable_indices].norm(dim=1)     # norm of gradients w.r.t. stable features
        ratio = g_c / (g_s + 1e-8)
        ratios.append(ratio.detach())

    S = torch.cat(ratios).mean().item()
    if S > tau:
        print(f"S={S:.3f} > τ={tau}: model relies significantly on shortcut features")
    else:
        print(f"S={S:.3f} ≤ τ={tau}: model mostly relies on stable features")
    return S
这个算法背后的直觉是:如果模型过度依赖捷径,损失对捷径特征的梯度就会很大——因为改变捷径特征会明显改变预测。
算法2:分布偏移下的泛化测试
def generalization_test(model, id_loader, ood_loader, device="cpu"):
    """
    Evaluate the model on ID and OOD test sets and report the generalization gap.
    """
    def evaluate(loader):
        model.eval()
        correct, total, high_conf_wrong = 0, 0, 0
        with torch.no_grad():
            for x, y in loader:
                x, y = x.to(device), y.to(device)
                logits = model(x)
                probs = torch.softmax(logits, dim=1)
                pred = probs.argmax(dim=1)
                conf = probs.max(dim=1).values
                correct += (pred == y).sum().item()
                # high-confidence but wrong samples (overconfidence detection)
                high_conf_wrong += ((conf > 0.8) & (pred != y)).sum().item()
                total += y.size(0)
        return correct / total, high_conf_wrong / total

    acc_id,  hcw_id  = evaluate(id_loader)
    acc_ood, hcw_ood = evaluate(ood_loader)
    gap = acc_id - acc_ood

    print(f"ID  accuracy:        {acc_id:.1%}")
    print(f"OOD accuracy:       {acc_ood:.1%}")
    print(f"Generalization gap: {gap:.1%}")
    if gap < 0.05:
        print("-> good generalization; the model may have learned stable features")
    elif gap < 0.20:
        print("-> moderate generalization; partial shortcut reliance")
    else:
        print("-> poor generalization; the model heavily relies on shortcuts")
    if hcw_ood > 0.1:
        print(f"⚠ OOD high-confidence error rate {hcw_ood:.1%}: overconfidence present")
    return acc_id, acc_ood, gap
算法3:Tilted ERM 训练
import torch
import torch.nn as nn

def tilted_erm_train(model, dataloader, t=5.0, lr=1e-3, epochs=50):
    """
    Tilted ERM training: gives more weight to hard samples to reduce shortcut reliance.
    t > 0: larger values focus more on high-loss samples; t = 0 reduces to standard ERM.
    """
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)
    criterion = nn.CrossEntropyLoss(reduction="none")

    for epoch in range(epochs):
        model.train()
        for x, y in dataloader:
            losses = criterion(model(x), y)          # per-sample losses
            # Tilted loss: log-sum-exp softens the max
            tilted_loss = (1.0 / t) * torch.log(
                (1.0 / len(losses)) * torch.sum(torch.exp(t * losses))
            )
            optimizer.zero_grad()
            tilted_loss.backward()
            optimizer.step()

    return model
当
十、一个小小的停顿
把这一章收一收。
经验风险最小化是监督学习的标准范式。它的理论保证压在一个条件上:训练和测试的数据来自同一个分布。
现实里,这个条件几乎从不成立。分布偏移是常态。
一偏移,ERM 学到的相关就可能整个失灵。这不是 bug,是它构造决定的:它优化的是统计相关,不是因果机制。
捷径学习是这个问题最具体的形态:模型捡虚假相关用,绕开因果特征。更糟的是,虚假特征明明不带来任何信息,梯度下降加交叉熵还是会让模型靠上去。因为这样能把边界推得更远。
随机鹦鹉假说说的是:大模型可能只是在做复杂的统计模式匹配,不是推理。分布偏移下的表现支持它——任务一变、格式一变,CoT 就崩。
缓解办法有数据增强、重加权、对抗训练、因果正则化。都得有人盯着。完全无监督时,检测和缓解捷径,还是没解。
这就引到第六章:统计相关不够的话,还缺什么?缺因果。要的不只是看
相关性是捷径,不是推理。下一章正面回答:因果是什么,为什么观测数据永远说不出答案。
悬而未决
- 大模型的“涌现能力”,是真质变,还是同一类东西越堆越多?模型再大,答案会变吗?
- 完全无监督时,有没有通用的捷径检测法?还是说,检测捷径本身就得先知道任务是什么?
- 最大边界这种归纳偏置,什么时候帮人,什么时候害人?有没有一个统一的框架说得清这个权衡?
- 拿纯随机数据训练一个网络,它能学出什么样的“捷径”?这个思想实验能照出捷径的什么底细?
- 人也会走捷径吗?会的话,人怎么绕开?这对设计学习算法有什么用?
动手试试:构造一个捷径陷阱,然后看着模型掉进去
本章有一个核心主张:ERM 会利用训练数据中的任何相关性,不管它是否因果。你即将亲手验证这一点——不是通过阅读,而是通过亲眼看着它发生。
第一步:设计你的捷径数据集
挑一个简单的二分类任务,然后故意在数据中植入一个捷径。
选项 A:图像分类(推荐)
任务:区分两种简单形状(比如圆形 vs. 方形)
捷径设计:
- 训练集:90% 的圆形放在图像左半边,90% 的方形放在右半边
- 测试集(ID):保持同样的位置偏差
- 测试集(OOD):翻转位置——圆形在右,方形在左
选项 B:文本分类
任务:情感分类(正面 vs. 负面)
捷径设计:
- 训练集:给 90% 的正面评论追加“recommended!”,给 90% 的负面评论追加“not recommended”
- 测试集(ID):保留同样的标记
- 测试集(OOD):移除所有标记,只保留评论正文
你的第一个问题(在生成任何数据之前回答): 你认为模型会学到什么?它会依赖位置/标记(捷径),还是依赖形状/语义(稳定特征)?为什么?
第二步:训练一个标准 ERM 模型
使用最简单的架构:
- 图像:2–3 层卷积网络
- 文本:简单的 LSTM 或 Transformer
训练目标:最小化交叉熵损失,直到训练准确率 > 95%
不要做任何特殊处理——就是标准的梯度下降 + 交叉熵。
记录:
- 训练曲线(loss vs. epoch)
- 最终训练准确率
第三步:在三个测试集上评估
import numpy as np
import torch
import torch.nn as nn
from sklearn.metrics import accuracy_score

# --- Helper: evaluate model accuracy -----------------------------------
def evaluate(model, dataloader, device='cpu'):
    """Return the accuracy (0~1) of the model on the given dataset."""
    model.eval()
    all_preds, all_labels = [], []
    with torch.no_grad():
        for X_batch, y_batch in dataloader:
            X_batch = X_batch.to(device)
            logits = model(X_batch)
            preds = logits.argmax(dim=1).cpu().numpy()
            all_preds.extend(preds)
            all_labels.extend(y_batch.numpy())
    return accuracy_score(all_labels, all_preds)

# 1. ID test set (same distribution as training; shortcut still present)
acc_id = evaluate(model, test_id_loader)
print(f"ID test set accuracy: {acc_id:.3f}")

# 2. OOD test set (shortcut broken: position/marker reversed)
acc_ood = evaluate(model, test_ood_loader)
print(f"OOD test set accuracy: {acc_ood:.3f}")

# 3. No-shortcut baseline (optional): retrain on data with a 50% shortcut correlation, then evaluate on OOD
# train_baseline = regenerate a training set with a 50% (random) shortcut correlation
# model_baseline = train a new model (same architecture, same hyperparameters)
# acc_baseline_ood = evaluate(model_baseline, test_ood_loader)
# print(f"No-shortcut baseline OOD accuracy: {acc_baseline_ood:.3f}")

# 4. Compute the generalization gap
gap = acc_id - acc_ood
print(f"\nGeneralization gap (ID - OOD): {gap:.3f}")
if gap < 0.05:
    print("-> good generalization; the model may have learned stable features")
elif gap < 0.20:
    print("-> partial shortcut reliance; moderate generalization")
else:
    print("-> heavy shortcut reliance; the model fell into the trap!")
你的第二个问题: 泛化差距有多大?如果差距 > 30%,说明模型严重依赖捷径。你的模型掉进陷阱了吗?
第四步:可视化模型在看什么
对于图像: 使用梯度加权类激活图(Grad-CAM)或简单的显著性图,看看模型做预测时关注图像的哪个区域。
import torch
import torch.nn.functional as F
import matplotlib.pyplot as plt
import numpy as np

# --- Gradient-based saliency map (for image classification models) -------
def saliency_map(model, x_sample, target_class):
    """
    Compute the absolute gradients of the prediction w.r.t. the input pixels as the saliency.
    x_sample: tensor of shape=(1, C, H, W); requires_grad will be enabled
    target_class: index of the target class (0 or 1)
    Returns a saliency map of shape=(H, W) (max over channels)
    """
    model.eval()
    x = x_sample.clone().detach().requires_grad_(True)  # enable gradient tracking

    # Forward pass to obtain the prediction logits
    logits = model(x)
    y_hat = logits[0, target_class]  # logit of the target class

    # Backward pass: gradient of y_hat w.r.t. the input x
    model.zero_grad()
    y_hat.backward()

    # Take absolute gradients and max over channels to get a 2-D saliency map
    saliency = x.grad.data.abs()           # shape=(1, C, H, W)
    saliency, _ = saliency.max(dim=1)      # shape=(1, H, W)
    saliency = saliency.squeeze().numpy()  # shape=(H, W)
    return saliency

# Take one sample from the OOD test set and see where the model looks
sample_x, sample_y = next(iter(test_ood_loader))  # take one batch
x0 = sample_x[0:1]   # first image, shape=(1, C, H, W)
pred_class = model(x0).argmax(dim=1).item()

sal = saliency_map(model, x0, target_class=pred_class)

# Visualization: overlay the saliency on the original image
fig, axes = plt.subplots(1, 2, figsize=(10, 4))

# Left: original image (if it is a single-channel grayscale image)
axes[0].imshow(x0.squeeze().detach().numpy(), cmap='gray')
axes[0].set_title(f'Original image (true class={sample_y[0].item()}, prediction={pred_class})')
axes[0].axis('off')

# Right: saliency heatmap
im = axes[1].imshow(sal, cmap='hot')
axes[1].set_title('Saliency map (region the model attends to)')
axes[1].axis('off')
plt.colorbar(im, ax=axes[1])

plt.suptitle('If the saliency concentrates on the left/right half, the model is using the position shortcut')
plt.tight_layout()
plt.show()

# If the model relies on the position shortcut, the saliency will concentrate
# on the left/right half instead of the shape edges.
对于文本: 计算每个词对预测的贡献(通过遮挡或梯度)。
如果模型依赖“recommended!”这个词,那么遮挡这个词会让预测翻转,而遮挡其他词几乎没有影响。
你的第三个问题: 模型的注意力/显著性集中在哪里?它看的是捷径,还是稳定特征?
第五步:测试置信度校准
模型在 OOD 数据上失败时,它知道自己正在失败吗?
import torch
import torch.nn.functional as F
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import accuracy_score

# --- Confidence analysis: compare max softmax probabilities on ID and OOD data ---
def get_confidence_and_accuracy(model, dataloader):
    """
    Return the max softmax probability (confidence) of each sample and whether the prediction is correct.
    """
    model.eval()
    confidences, corrects = [], []
    with torch.no_grad():
        for X_batch, y_batch in dataloader:
            logits = model(X_batch)
            probs = F.softmax(logits, dim=1)          # convert to a probability distribution
            conf, pred = probs.max(dim=1)             # the max probability is the confidence
            corrects.extend((pred == y_batch).numpy())
            confidences.extend(conf.numpy())
    return np.array(confidences), np.array(corrects)

# Compute confidences on ID and OOD data separately
conf_id,  correct_id  = get_confidence_and_accuracy(model, test_id_loader)
conf_ood, correct_ood = get_confidence_and_accuracy(model, test_ood_loader)

# Print summary statistics
print(f"ID data  - accuracy: {correct_id.mean():.3f}, mean confidence: {conf_id.mean():.3f}")
print(f"OOD data - accuracy: {correct_ood.mean():.3f}, mean confidence: {conf_ood.mean():.3f}")

# Plot confidence histograms
fig, axes = plt.subplots(1, 2, figsize=(12, 4), sharey=True)
axes[0].hist(conf_id,  bins=20, color='steelblue', edgecolor='white', alpha=0.85)
axes[0].set_title(f'ID confidence distribution\n(accuracy={correct_id.mean():.2f})')
axes[0].set_xlabel('Max softmax probability')
axes[0].set_ylabel('Number of samples')
axes[1].hist(conf_ood, bins=20, color='tomato',    edgecolor='white', alpha=0.85)
axes[1].set_title(f'OOD confidence distribution\n(accuracy={correct_ood.mean():.2f})')
axes[1].set_xlabel('Max softmax probability')
plt.tight_layout()
plt.show()

# Diagnosis: overconfidence test
if conf_ood.mean() > 0.8 and correct_ood.mean() < 0.5:
    print("⚠ Overconfident! OOD data: high confidence + low accuracy -> the model is confidently wrong (dangerous!)")
elif conf_ood.mean() < 0.6:
    print("✓ The model knows it is uncertain (lower OOD confidence); relatively safe")
else:
    print("OOD confidence is moderate; judge it together with accuracy")

# Summary:
# - ID data: high accuracy + high confidence -> normal
# - OOD data: low accuracy + high confidence -> overconfidence (dangerous!)
# - OOD data: low accuracy + low confidence -> the model knows it is uncertain (relatively safe)
你的第四个问题(核心问题): 模型在 OOD 数据上的平均置信度是多少?如果置信度仍然很高(> 0.8),而准确率很低(< 0.5),说明模型在自信地犯错——这是捷径学习最危险的后果。
第六步(可选):尝试一种缓解方法
从第 8 节中选一种方法:
方法 A:数据增强 往训练集里加入一些“反捷径”样本(比如圆形在右、方形在左),把比例从 10% 逐步提高到 50%,观察泛化差距如何变化。
方法 B:样本重加权 实现一个简化版的 Tilted ERM:降低“太容易”的样本(模型已经高置信度预测正确的样本)的权重。
观察:缓解方法是否缩小了泛化差距?代价是什么(训练时间?ID 准确率下降?)?
检查清单
完成这个练习后,你应该能回答:
- 你的模型掉进捷径陷阱了吗?泛化差距有多大?
- 模型的注意力/显著性是否集中在捷径特征上?
- 模型在 OOD 数据上是否过度自信?
- 如果你尝试了缓解方法,它有效吗?代价是什么?
如果你只做一件事,就做第四步。它是最短的实验,也是最能让你对“模型在看什么”形成直觉的实验。
延伸阅读
- Bender, E. M., et al. (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? —— “随机鹦鹉”假说的原始论文,引发了关于大型语言模型本质的广泛讨论
- Hodel, D. & West, J. (2023). Response: Emergent analogical reasoning in large language models —— 对 GPT-3“涌现推理能力”的批判性反驳,展示了分布偏移下的脆弱性 -> [arXiv:2308.16118]
- Geirhos, R., et al. (2020). Shortcut Learning in Deep Neural Networks —— 捷径学习的系统性综述,涵盖视觉、语言和语音
- Puli, A., et al. (2023). Don't blame Dataset Shift! Shortcut Learning due to Gradients and Cross Entropy —— 揭示梯度下降 + 交叉熵的归纳偏置如何导致捷径学习 -> [arXiv:2308.12553]
- Zhao, C., et al. (2025). Is Chain-of-Thought Reasoning of LLMs a Mirage? A Data Distribution Lens —— DataAlchemy 实验,表明 CoT 推理是训练分布的一面脆弱镜子 -> [arXiv:2508.01191]
- Li, T., et al. (2020). Tilted Empirical Risk Minimization —— 通过对样本重加权来平衡鲁棒性和公平性 -> [arXiv:2007.01162]
- Sricharan, K. & Srivastava, A. (2018). Building robust classifiers through generation of confident out of distribution examples —— 用 GAN 生成 OOD 样本进行对抗训练 -> [arXiv:1812.00239]
- Woodland, M., et al. (2024). Dimensionality Reduction and Nearest Neighbors for Improving Out-of-Distribution Detection in Medical Image Segmentation —— 医学影像中的 OOD 检测与捷径学习 -> [arXiv:2408.02761]
- Vapnik, V. & Chervonenkis, A. (1971). On the Uniform Convergence of Relative Frequencies of Events to Their Probabilities —— 统计学习理论的奠基工作,也是 ERM 的理论基础
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference —— 因果推理的经典教材;理解统计相关性与因果性之区别的必读之作