第6章:因果的边界——观测数据永远不够
你看过一千次日出。这能证明明天太阳会升起吗?休谟说:不能。
一、归纳的幽灵
1748年,大卫·休谟在《人类理解研究》里撂下一个问题:
我们凭什么相信未来会像过去一样?
太阳每天升起。你看过一千次日出,一万次日出。这能证明明天太阳还会升起吗?
休谟说:不能。
把“过去天天升起”摆到“明天还会升起”面前,中间没有一条逻辑通道。你也可以设想一个世界:太阳升起一万次,第一万零一次停了。这个设想不违反任何逻辑。
这就是归纳问题:有限的观测推不出普遍规律。
它震动了哲学史。科学靠归纳活着——从实验数据里抽出自然定律。归纳要是站不住,科学站在哪儿?
三百年后,同一个问题换了件技术外衣回来:从观测数据里,能抽出因果关系吗?
还是不能。
这一章讲这个“不能”到底卡在哪儿,也讲卡着它,我们还能推出什么有用的东西。
二、相关性的陷阱
先看一个老案子。
1950年代,流行病学家盯上一组数据:吸烟者得肺癌的比例,比不吸烟的人高出一大截。
这能证明吸烟导致肺癌吗?
烟草公司的律师说:不能。他们另给了一个解释。也许有个隐藏变量,比如基因型,它同时让人爱吸烟、又容易得肺癌。真要是这样,吸烟和肺癌就没有因果,只是同一个原因结出的两个果子。
用因果图来表示:
假说1(因果):
Smoking -> Lung Cancer
假说2(混淆):
Genotype -> Smoking
Genotype -> Lung Cancer
假说2里,这条相关性是虚假的。两个变量一起动,靠的是背后那只看不见的手,不是谁推谁。
问题来了:只拿观测数据,你能分开这两个假说吗?
答案是:不能。
基因型看不见——1950年代确实看不见。两个假说因此给出完全一样的预测。它们观测等价。
加数据没用。一百万个样本只会让相关性更刺眼,方向还是定不下来。观测数据只肯交出联合分布
观测是一个问题,干预是另一个。
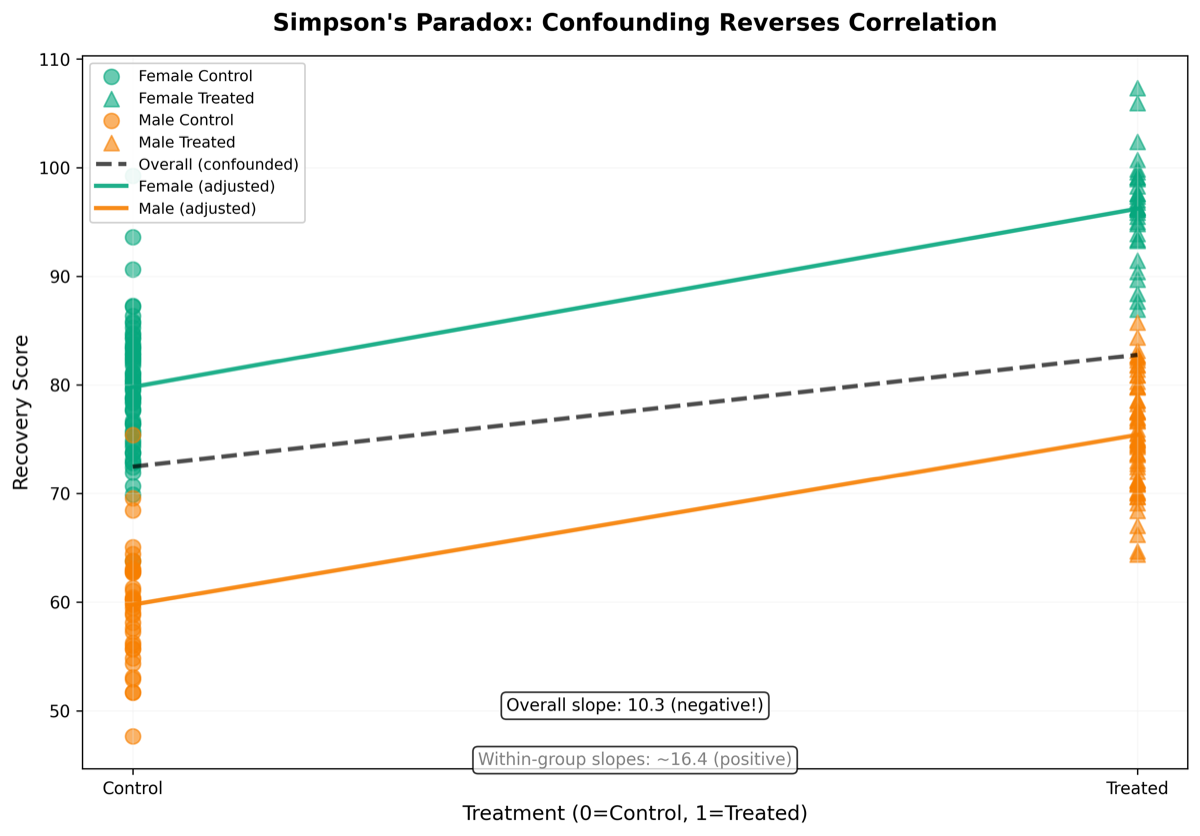
图2:辛普森悖论的几何。总体回归线是黑色虚线,斜率为负——治疗组看起来康复得更差。按性别拆开,女性一条蓝线,男性一条红线,斜率都转正。性别这只手同时拨动了“谁接受治疗”和“基线康复率”,把总体的方向拧反了。后门调整把这只手按住,因果效应才露出原来的符号。
三、贝叶斯网络:概率的因果外衣
Pearl的因果理论,得从贝叶斯网络讲起。它是结构因果模型的前身,也是它的坑。
贝叶斯网络画成一张有向无环图(DAG):节点是随机变量,边是两个变量之间的条件依赖。
贝叶斯网络和 DAG:图上的概率是什么意思?
有向无环图(DAG):一堆节点,加一堆连接它们的边。“有向”是说每条边有箭头,A->B 和 B->A 是两条不同的路。“无环”是说顺着箭头走,走不回起点。
贝叶斯网络在 DAG 上再挂一层概率:
- 每个节点是一个随机变量(比如“是否下雨”,“是否带伞”)
- 有向边 A->B 表示“A 对 B 有条件影响”——知道 A 的值,会改变我们对 B 的估计
关键是条件依赖。给定 A,B 和 C 就互不相干了,A 成了把它们劈开的分离点。贝叶斯网络就靠这些条件独立,把一整个联合分布拆成一小块一小块的局部概率,参数少了一大截。
注意:边画的是统计依赖,不一定是因果。这一节的坑就在这儿。
给定一个贝叶斯网络
这么一拆,高维分布变成一串低维条件分布相乘,要估的参数少得多。
微妙的地方在边上:贝叶斯网络的边不一定是因果关系。
它只是把联合分布拆开的一种拆法。同一个联合分布,常常能拆出好几张不同的网络,只要条件独立性对得上。
看三个变量:
真实的因果结构是:
B -> A ← E
贼进来了,或者地震了,警报都会响。
可你从纯概率的角度看,下面这张图编码的条件独立性一模一样:
A -> B, A -> E
警报一响,贼和地震的概率都跟着涨。
两张图在观测数据上等价,联合分布都是
第一张说:对
第二张说:对
贝叶斯网络是概率模型,不是因果模型。边画的是条件依赖,不是因果流。
Pearl往上加了一层因果语义:把边读成因果,再规定在这个读法下,干预和反事实各是什么意思。
停顿一下
边不是因果。这已经够别扭了。
底下还有一层:就算你手里有Pearl的因果图,凭什么说这张图画对了?
图是你画的。画的时候,你把对世界的先验假设一起画了进去。数据能告诉你哪些变量条件独立,能圈掉一批候选图,但圈不到只剩一张。
于是每一个因果结论,都踩在一个数据验不了的假设上:那张图。
图画错了,do算子算得再顺,干预效应也是错的。答案前后自洽,从头到尾就是错。
那凭什么信它?经验,直觉,领域知识。
都算答案。没有一样是从数据里长出来的。
这个问题先搁在桌上。
四、Pearl的因果阶梯
2000年,Judea Pearl在《Causality》里搭了一把三层梯子,后来被叫作因果阶梯。
因果阶梯:观测、干预、反事实——三种不同的问题
因果问题分三层。一层比一层难,一层比一层需要更硬的假设。
第一层(观测):看到 X,Y 的概率是多少? 纯统计,只要有数据。问的是:吸烟的人里,多大比例得了肺癌?
第二层(干预):如果我强制 X 发生,Y 的概率是多少? 要因果图。问的是:把所有人随机分去吸烟,肺癌率会变成多少?随机对照试验干的就是这件事。
第三层(反事实):如果过去 X 不同,Y 现在会是什么? 要一整套结构因果模型。问的是:这个病人吸了烟,得了肺癌——他要是从没吸过,现在会怎样?这是问某一个人,实验没法直接回答。
关键点:低层的信息,答不了高层的问题。观测数据堆到天上去,也答不了干预和反事实。“观测数据永远不够”,说的就是这件事。
第一层:关联(观测)
问题形式:
看到
纯统计。有数据,就能估条件概率。机器学习大多停在这一层:给特征
第二层:干预
问题形式:
硬把
看药。
可能很高。病轻的人更愿意吃药,病轻的人本来就更容易好。 才是药的真本事。把谁吃药随机一派,吃药组好得快多少。
前者是看,后者是动手。把这两个混成一件,是医学研究里最常见的错之一。
第三层:反事实
问题形式:
过去
这层最难。它要你对着没有发生的事推理。
例子:
观测:这个病人吃了药,康复了。
反事实:如果这个病人没吃药,他会康复吗?
光有数据不够,还得有结构因果模型:一套关于世界怎么运转的机制假设。
Pearl的要害在这儿:这三层不能互相顶替。第一层答不了第二层,第二层也答不了第三层。
往上爬一层,就得多押一层假设,多搭一层结构。
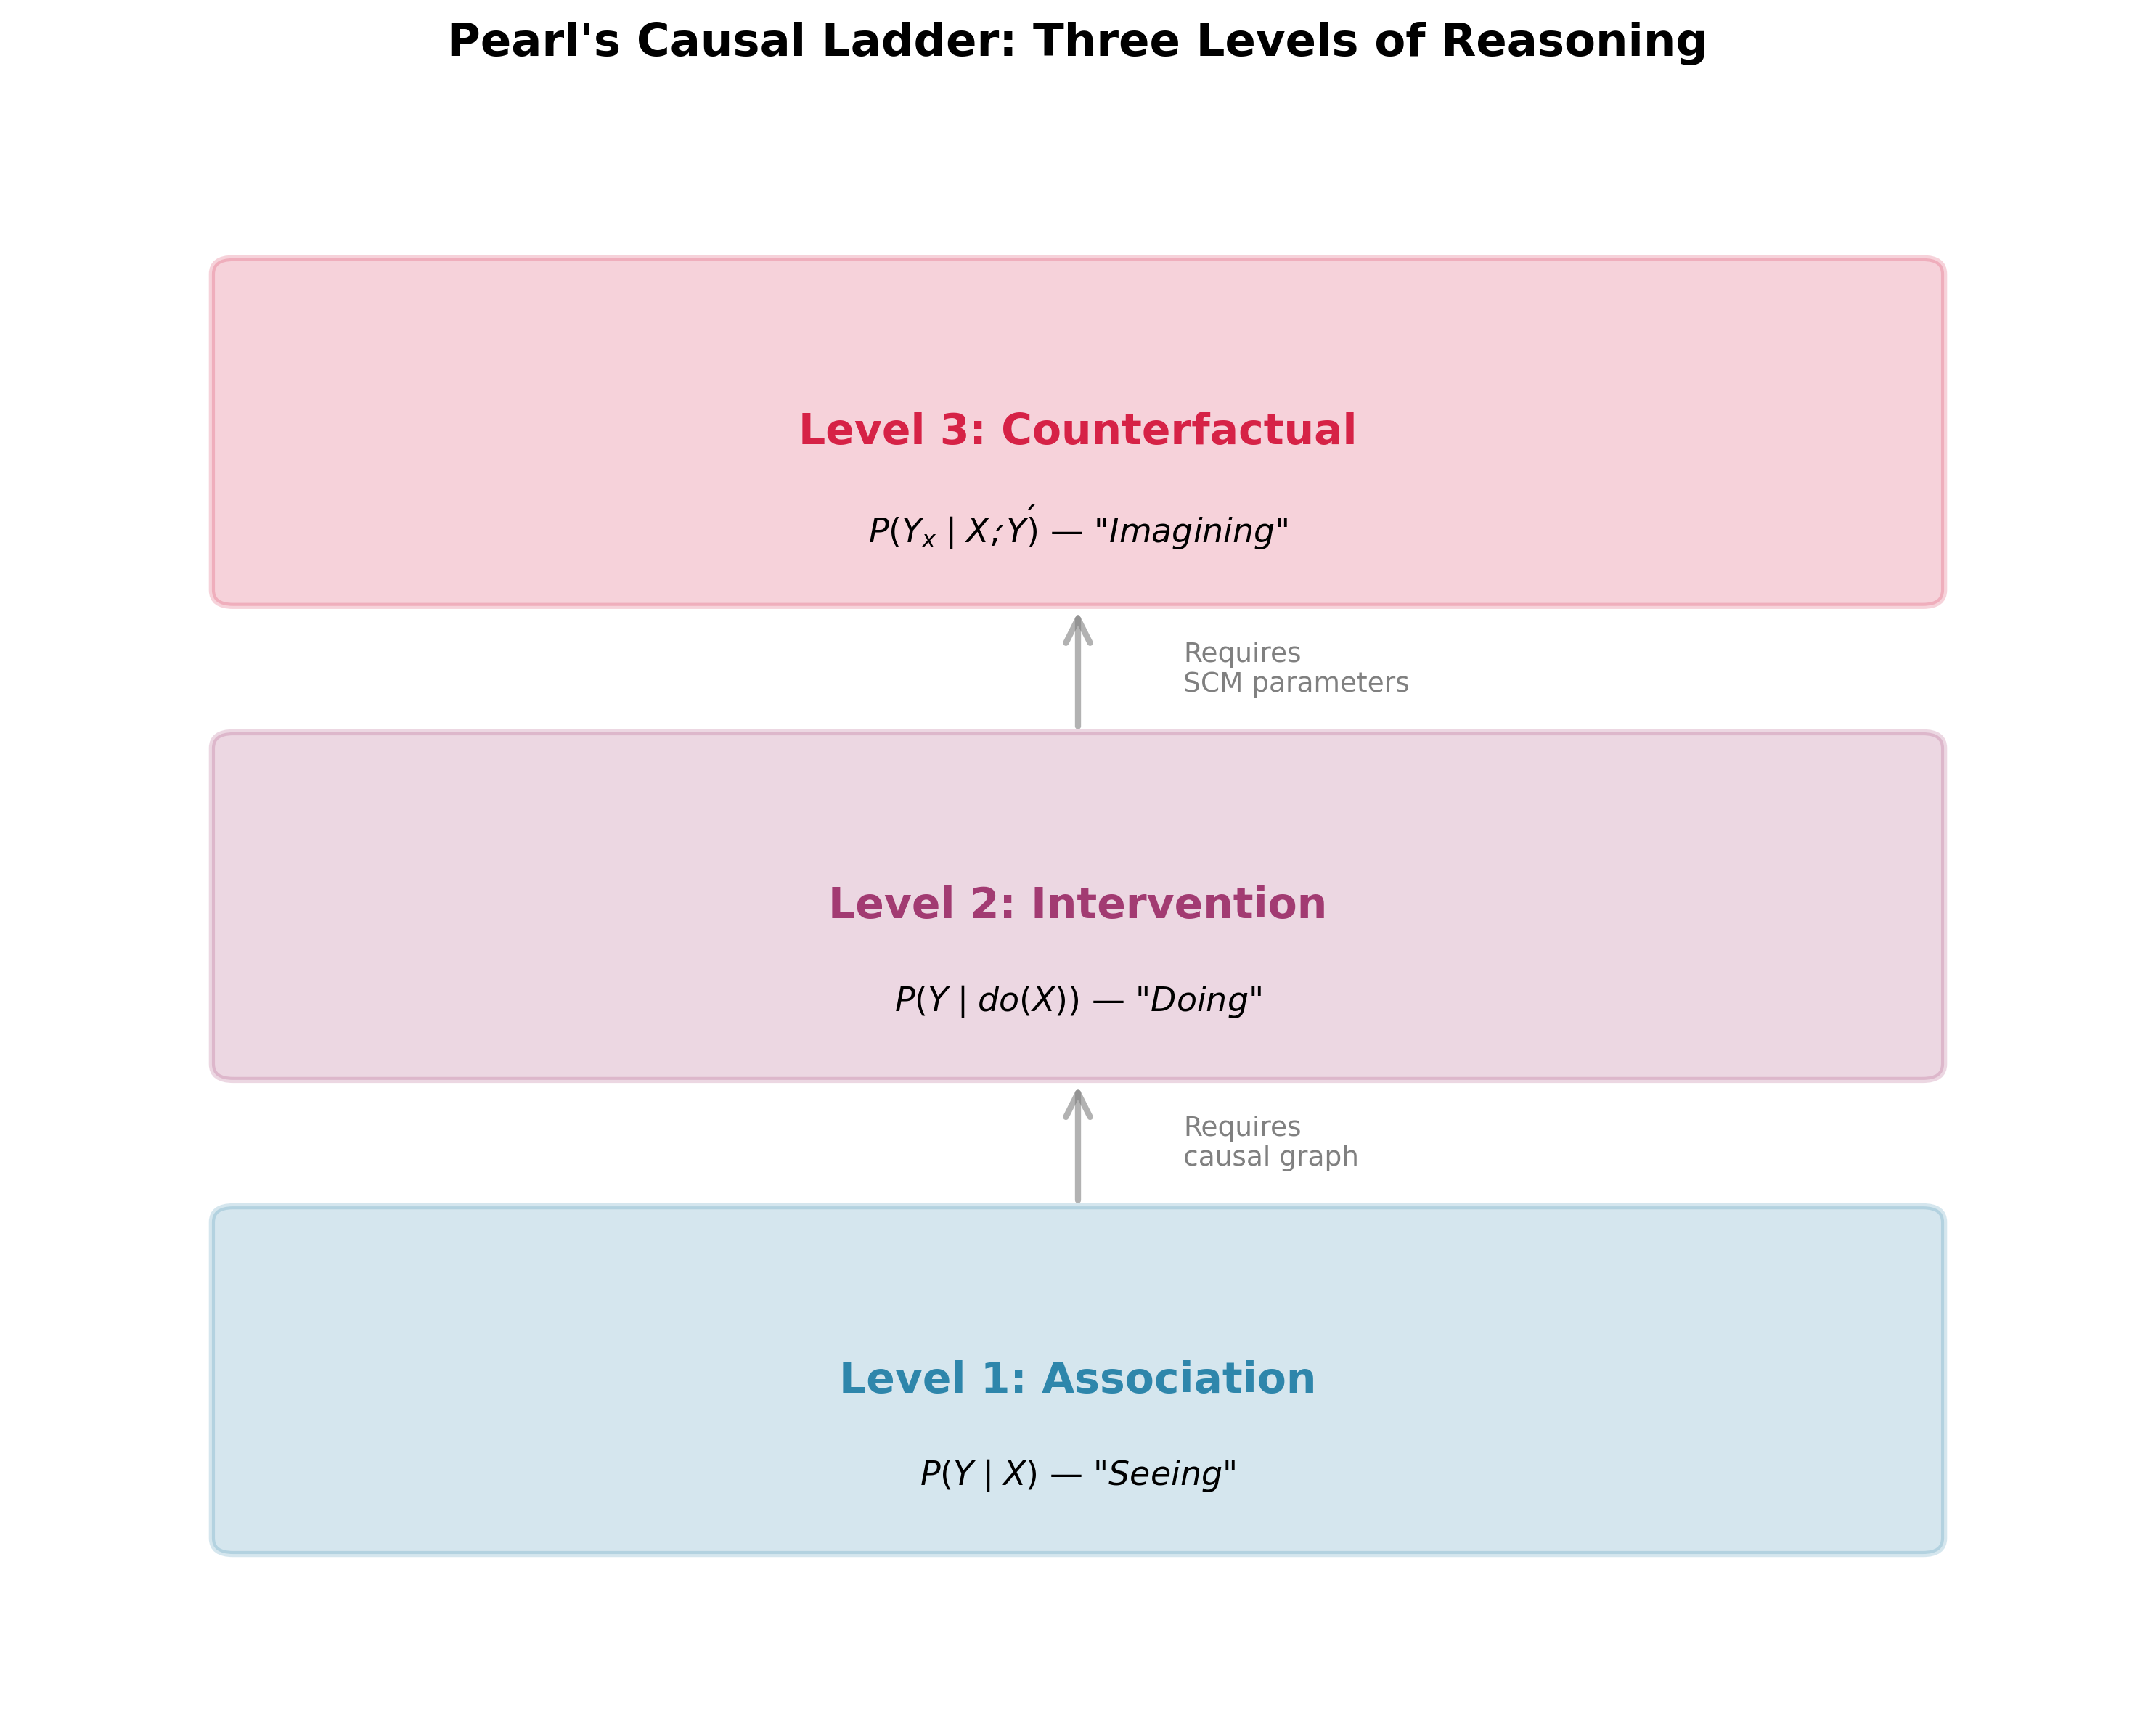
图1:Pearl的因果阶梯。最底下一层是观测,只要数据,回答“看到 X 之后 Y 的概率”。中间一层是干预,要因果图,回答“强制 X 之后 Y 的概率”。最上面一层是反事实,要完整的 SCM 参数,回答“如果 X 曾经不同,Y 会如何不同”。每往上走一级,脚下的结构假设就更硬。
五、结构因果模型:世界的机制蓝图
干预和反事实,得靠结构因果模型(SCM)。
一个SCM,三样东西:
内生变量
:图里要算的变量 外生变量
:外面来的随机扰动,看不见 结构方程
:每个内生变量,都由一个函数管着
例子:吸烟与肺癌
变量:
:这个人是否吸烟 :他是否得肺癌 :基因型(不可观测)
结构方程:
G = U_G                    (the genotype is set by exogenous factors)
S = f_S(G, U_S)            (smoking tendency is influenced by genes and other factors)
C = f_C(S, G, U_C)         (lung cancer is influenced by smoking, genes, and other factors)
因果图:
G -> S -> C
G -> C
模型里塞着一条假设:基因
有了SCM,干预就能定义了:
干预后,模型变成:
G = U_G
S = s                      (forced)
C = f_C(s, G, U_C)
现在
改过的模型里,就算出干预后的分布
关键在这里:
六、do 演算:从观测到干预的桥梁
核心问题来了:手里只有观测数据,算不算得出干预分布?
换句话说,能不能从
Pearl的do 演算说:有些条件下,可以。
三条规则。守着因果图
规则1:插入 / 删除观测
直觉很直白:干预了
规则2:行动 / 观测交换
规则3:插入 / 删除行动
在图变成这样之后,
三条规则技术味很重。它们的分量在于:完备。
Pearl和同事证过:一个因果效应
反过来,推不出来,就是认不出——观测数据加图,定不了这个效应。
七、后门准则与前门准则
do 演算是理论上的完备工具。日常用起来,还有更直的路:判断一个因果效应认不认得出。
后门准则
拿一张因果图
堵死所有从 到 的后门路径,也就是带指向 的边的路径 中没有 的后代
那因果效应就能用调整公式算:
这就是调整:按混淆变量
回到吸烟与肺癌:
因果图:
G -> S -> C
G -> C
随机对照试验(RCT)为什么管用,也在这儿:随机分配
前门准则
混淆变量看不见怎么办?
Pearl找到一个巧办法。混淆看不见,只要有个中介变量
把 对 的效应全接了, 只能穿过 去碰 阻断了所有从 到 的后门路径 什么都不用挡,从
到 本来就没有后门
那因果效应能用前门公式算:
公式里没有混淆变量。它从
例子:吸烟、焦油与肺癌
U -> S -> T -> C
U -> C
有些结构就是这样:混淆藏着,观测数据也够认出因果效应。
“有些”两个字是绳子。不是每张图都过得了后门或前门。
八、观测等价类:因果图何时不可区分
这是本章最硬的一块。观测数据无穷多,因果图还是定不死——几张不同的图可以生出同一个观测分布。
这些图归成一类,马尔可夫等价类。
定义: 两张DAG
等价的图,骨架一样,把箭头抹掉剩同一张无向图;v-结构也一样,都是
例子:三个变量的等价类
三个变量
X -> Y -> Z
X ← Y -> Z
X ← Y ← Z
它们编码同一条条件独立:
观测数据分不开这三张图。同一个联合分布,套在哪张上都合身。
因果含义天差地别:
第一个图:
影响 , 影响 第二个图:
同时影响 和 第三个图:
影响 , 影响
你要问
不可识别性从何而来
跟数据量无关,跟算法也无关。这是结构上的不可能。
观测数据只会说条件独立:给定这几个变量,那几个就不相干。因果问的比这多,它问干预下它会怎么动。
两张图观测分布一模一样,动手一干预,各走各的路。
所以,光靠观测数据,因果发现最多摸到整个等价类,摸不到唯一的那张图。
想从类里挑出一张,得有别的信息:
干预数据:能做实验,按住一些变量,看别的怎么动,方向就定了
时间顺序:
明明在 前面, 就没戏 函数形式假设:假定机制是线性的,或者属于加性噪声模型,有些等价类就散架了
先验知识:明知道某条边不可能,像“年龄被收入影响”,那张图就排除
只有观测数据,手里一点额外假设都没有,图就认不出。
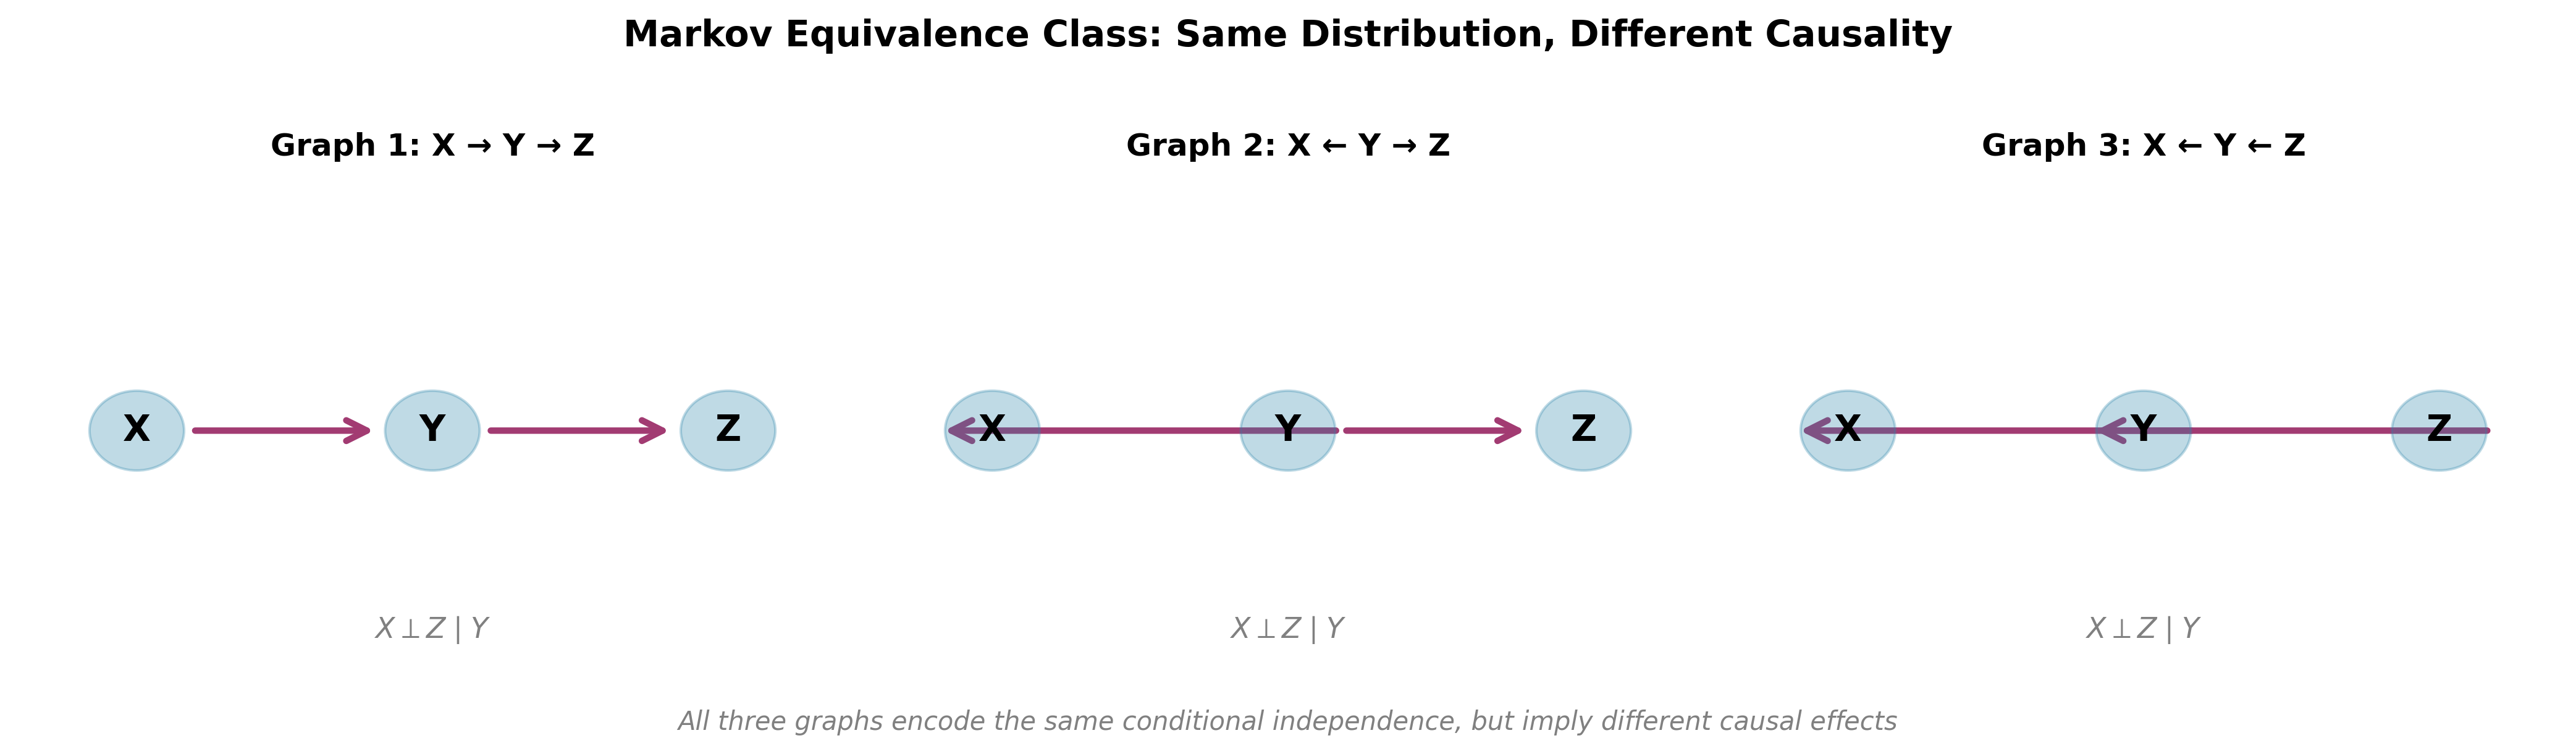
图3:马尔可夫等价类示例。三张图:X->Y->Z、X←Y->Z、X←Y←Z。条件独立 X ⊥ Z | Y 全对得上,观测数据上分不出谁。可它们的因果含义不同:第一张里对 X 动手,Z 会变;第二张里不会。光看数据,挑不出那唯一的一张。
九、忠实性假设:一座脆弱的桥梁
因果发现算法,像PC和GES,通常靠两个假设。
假设1:因果马尔可夫条件
给定父节点,一个变量跟它的非后代互不相干。
这是贝叶斯网络的老规矩,一般没毛病。
假设2:忠实性
数据里每一条条件独立,都得在图上有一条d-分离对得上。
说白点:数据里
听着无害,其实很凶。
一个反例:参数的巧合抵消
看这张图和这套方程:
X -> Y -> Z
X -> Z

Y = a·X + U_Y
Z = b·Y + c·X + U_Z
参数要是正好满足
数据这时会说
忠实性假设把这类巧合一刀切掉:它假定参数待在“一般位置”,不会正好互相抵消。
可现实里,这种巧合不见得少。生物系统、经济系统里净是反馈和平衡,参数咬着参数,几条效应抵成零,不稀奇。
忠实性失败的后果
忠实性一塌,算法就画出错图。数据里两个变量看着独立,它就当那条边不存在。其实因果在,只是效应被抵消了。
底下埋着一根软肋。因果发现押了一个关于参数的假设,数据却验不了它——真正的独立,和碰巧抵成零,在数据里长得一模一样。
十、反事实:最难的一层
因果阶梯最上面一层是反事实。它最难,因为它要你对着没发生的事推理。
定义反事实
手里一个SCM,看到证据
算它分三步。
步骤1:溯因
拿看到的证据,回头改一改对外生变量
步骤2:行动
改SCM,把
步骤3:预测
在改过的模型里,用新的
例子:药物的个体因果效应
看一个SCM:
X = U_X                    (whether the drug was taken; set by exogenous factors)
Y = a·X + U_Y              (recovery outcome)
看到的是:一个病人吃了药,
反事实问:他没吃药,
步骤1:从
步骤2:干预
步骤3:计算反事实结果:
反事实的不可识别性
麻烦在这儿:反事实通常不可识别。
因果图在手,观测数据无限,反事实分布还是定不死。它靠的是外生变量
前头的例子里,不知道
光有图不够,还得有参数化的结构方程。这比图结构押得更狠。
反事实在实践里为什么这么难,就在这儿。它要一个完整、带参数的世界模型,这种模型,数据通常喂不出来。
十一、伪代码:因果推断的核心算法
让我把上面讨论的核心算法形式化。
算法1:后门调整
import itertools
import numpy as np

def backdoor_adjustment(data, x_col, y_col, z_cols, x_val):
    """
    Estimate the causal effect P(Y | do(X=x_val)) via backdoor adjustment.
    data:    pandas DataFrame containing observational data
    x_col:   column name of the intervention variable
    y_col:   column name of the outcome variable
    z_cols:  list of adjustment-set column names (satisfying the backdoor criterion)
    x_val:   intervention value
    Returns: estimate of P(Y=1 | do(X=x_val))
    """
    if not z_cols:
        raise ValueError("Empty adjustment set; the causal effect is not identifiable via backdoor adjustment")

    # Enumerate all value combinations of Z
    z_values = [data[z].unique() for z in z_cols]
    result = 0.0

    for z_combo in itertools.product(*z_values):
        # Conditional probability P(Y | X=x_val, Z=z_combo)
        mask_xz = (data[x_col] == x_val)
        for z_col, z_val in zip(z_cols, z_combo):
            mask_xz &= (data[z_col] == z_val)
        if mask_xz.sum() == 0:
            continue
        p_y_given_xz = data.loc[mask_xz, y_col].mean()

        # Marginal probability P(Z=z_combo)
        mask_z = np.ones(len(data), dtype=bool)
        for z_col, z_val in zip(z_cols, z_combo):
            mask_z &= (data[z_col] == z_val)
        p_z = mask_z.mean()

        result += p_y_given_xz * p_z

    return result
十二、一个小小的停顿
这一章走到这儿,盘一盘。
休谟的问题,三百年后换了因果推断的壳回来:观测数据能推出因果吗?不能。至少推不出唯一的那一个。
观测只交联合分布
Pearl把因果问题搭成三层:观测、干预、反事实。越往上,押的假设越硬。机器学习大多蹲在第一层;真正的因果推理得爬到第二层、第三层。
结构因果模型(SCM)用方程和图把世界的机制写下来。有了它,干预就是剪边,反事实就是溯因、行动、预测三步走。
do 演算给了一套完备规则,从观测分布推干预分布。后门、前门更直接,专管那些“光靠数据也认得出”的图。
限制没走:
马尔可夫等价类:几张图生同一个观测分布,光看数据分不开
忠实性假设:因果发现押参数不打架,这事数据验不了
反事实的不可识别性:光有图不够,还要带参数的结构方程
第七章接着问:观测不够,那要什么?要干预。伸手改世界,不再蹲着看。随机对照试验(RCT)被当成黄金标准,不是因为它秤更准,是因为它把观测的笼子砸了。
因果推断把观测的天花板掀给大家看。下一章换个方向:计算自己身上的不对称——为什么认出一个答案,比找出一个答案容易那么多?
悬而未决
忠实性假设在现实里多久塌一次?塌了,看得出来吗?
同一个等价类里的两张图,干预预测不一样,该信哪张?这算科学选择,还是哲学选择?
反事实要一套参数齐全的SCM。哪些参数能从数据里学出来,哪些永远学不到?
大语言模型会不会因果推理?它从文本里学到的是
,还是 ?这个答案划出它的能力边界。 拿纯观测数据训一个因果发现算法,再拿干预数据考它,它会在哪儿成片地错?这个错法说明了什么?
动手试试:用辛普森悖论看穿观测的谎言
本章的核心主张是:观测数据会撒谎,因为它包含混淆。你要亲手构造一个辛普森悖论的例子,看着同一组数据在不同的分层下给出完全相反的结论。
第一步:生成带混淆的数据
构造以下因果结构:
Causal graph:
G -> T -> Y
G -> Y

where:
G = gender (0=female, 1=male)
T = whether the patient received treatment (0=no, 1=yes)
Y = recovery outcome (continuous, higher is better)
真实的因果机制:
- 男性更常接受治疗(因为他们病得更重)
- 治疗有正效应(提高康复)
- 但男性的基线康复更低(因为他们病得更重)
import numpy as np
import pandas as pd

np.random.seed(42)
N = 1000  # sample size

# Generate gender (confounder): 0=female, 1=male, 50% each
G = np.random.binomial(1, 0.5, N)

# Generate the treatment decision (affected by gender)
# Men are sicker and more likely to be treated
p_treatment = np.where(G == 1, 0.7, 0.3)  # men 70%, women 30%
T = np.random.binomial(1, p_treatment, N)

# Generate the recovery outcome (affected by both gender and treatment)
# Female baseline recovery score 80; male baseline 60 (men are sicker)
baseline = 80 - 20 * G        # vectorized: baseline score per sample
treatment_effect = 15 * T     # treatment adds 15 points (true causal effect)
noise = np.random.normal(0, 5, N)  # random noise
Y = baseline + treatment_effect + noise

# Arrange into a DataFrame for the following analysis
df = pd.DataFrame({'G': G, 'T': T, 'Y': Y})
print(f"Data generation complete: {N} samples")
print(df.describe().round(2))
print(f"\nTrue causal effect (treatment parameter) = +15 points")
你的第一个问题(在生成任何数据之前回答): 在这个设定下,治疗的真实因果效应是多少?如果我们随机分配治疗(切断 G -> T),治疗组的康复分数会比对照组高多少?
第二步:计算观测到的相关性(不调整混淆)
生成数据后,直接计算:
import pandas as pd

# Compare treatment vs. control directly, ignoring the gender confounder
treated_mean   = df[df['T'] == 1]['Y'].mean()   # mean of the treatment group
untreated_mean = df[df['T'] == 0]['Y'].mean()   # mean of the control group
observed_effect = treated_mean - untreated_mean  # observed effect (no confounder adjustment)

print(f"Treatment group mean: {treated_mean:.2f}")
print(f"Control group mean: {untreated_mean:.2f}")
print(f"Observed effect (unadjusted): {observed_effect:.2f}")
print(f"True causal effect: +15.00")
你的第二个问题: 观测到的效应是什么符号?它是正的(治疗组更好)还是负的(对照组更好)?它和真实因果效应一致吗?
如果不一致,你就遇到了辛普森悖论——总体相关性和因果效应的方向相反。
第三步:分层分析(调整混淆)
现在按性别分层,计算每一层内部的结果:
import pandas as pd

# --- Treatment effect within the female group (G=0) ---------------------------
female_treated   = df[(df['G'] == 0) & (df['T'] == 1)]['Y'].mean()
female_untreated = df[(df['G'] == 0) & (df['T'] == 0)]['Y'].mean()
effect_female    = female_treated - female_untreated

# --- Treatment effect within the male group (G=1) -----------------------------
male_treated   = df[(df['G'] == 1) & (df['T'] == 1)]['Y'].mean()
male_untreated = df[(df['G'] == 1) & (df['T'] == 0)]['Y'].mean()
effect_male    = male_treated - male_untreated

# --- Backdoor adjustment: weighted average of the stratified effects by gender's marginal distribution ---
P_G0 = (df['G'] == 0).mean()  # proportion of female samples
P_G1 = (df['G'] == 1).mean()  # proportion of male samples
adjusted_effect = P_G0 * effect_female + P_G1 * effect_male  # weighted average

print(f"Effect within females (G=0): {effect_female:.2f}")
print(f"Effect within males (G=1): {effect_male:.2f}")
print(f"Adjusted causal effect (backdoor adjustment): {adjusted_effect:.2f}")
print(f"True causal effect: +15.00")
print(f"Observed effect (unadjusted): {observed_effect:.2f}")
你的第三个问题(核心问题): 分层之后,每个性别内部的治疗效应是什么符号?它和第二步的观测效应相同吗?
如果第二步是负的,而两个性别内部的效应都是正的,你刚刚亲眼看到了辛普森悖论:总体相关性和分层因果效应方向相反。
第四步:可视化混淆的几何
画一个散点图,横轴是治疗(0 或 1),纵轴是康复分数:
import numpy as np
import matplotlib.pyplot as plt
from numpy.polynomial.polynomial import polyfit

fig, ax = plt.subplots(figsize=(9, 6))

# Scatter of the four subgroups (small jitter to avoid overlaps)
jitter = 0.04
groups = [
    (0, 0, 'royalblue',  'o', 'Females, control (G=0, T=0)'),
    (0, 1, 'royalblue',  '^', 'Females, treatment (G=0, T=1)'),
    (1, 0, 'tomato',     'o', 'Males, control (G=1, T=0)'),
    (1, 1, 'tomato',     '^', 'Males, treatment (G=1, T=1)'),
]
for g_val, t_val, color, marker, label in groups:
    mask = (df['G'] == g_val) & (df['T'] == t_val)
    t_jittered = df.loc[mask, 'T'] + np.random.uniform(-jitter, jitter, mask.sum())
    ax.scatter(t_jittered, df.loc[mask, 'Y'],
               c=color, marker=marker, alpha=0.5, s=20, label=label)

# Helper: draw an OLS regression line
def plot_regression(x, y, color, linestyle, label):
    coeffs = np.polyfit(x, y, 1)   # linear regression; coeffs=[slope, intercept]
    x_line = np.array([x.min(), x.max()])
    ax.plot(x_line, np.polyval(coeffs, x_line),
            color=color, linestyle=linestyle, linewidth=2, label=label)
    return coeffs[0]  # return the slope

# 1. Overall regression line (ignoring gender) -- black dashed line
slope_overall = plot_regression(df['T'].values, df['Y'].values,
                                'black', '--', 'Overall regression line (ignoring gender)')

# 2. Within-female regression line -- blue solid line
female_mask = df['G'] == 0
slope_female = plot_regression(df.loc[female_mask, 'T'].values,
                               df.loc[female_mask, 'Y'].values,
                               'royalblue', '-', 'Within-female regression line')

# 3. Within-male regression line -- red solid line
male_mask = df['G'] == 1
slope_male = plot_regression(df.loc[male_mask, 'T'].values,
                             df.loc[male_mask, 'Y'].values,
                             'tomato', '-', 'Within-male regression line')

ax.set_xlabel('Received treatment (0=no, 1=yes)')
ax.set_ylabel('Recovery score Y')
ax.set_title("The geometry of Simpson's paradox\nOverall line slopes down, but within-group lines slope up")
ax.set_xticks([0, 1])
ax.set_xticklabels(['Control (T=0)', 'Treatment (T=1)'])
ax.legend(fontsize=8, loc='upper left')

print(f"Overall regression slope: {slope_overall:.2f} ({'positive' if slope_overall > 0 else 'negative'} -- treatment {'beneficial' if slope_overall > 0 else 'harmful'}?)")
print(f"Within-female regression slope: {slope_female:.2f}")
print(f"Within-male regression slope: {slope_male:.2f}")
plt.tight_layout()
plt.show()
你的第四个问题: 总体回归线的斜率是什么符号?女性内部和男性内部的斜率又如何?
如果总体线向下(负斜率),而两条组内线都向上(正斜率),这就是辛普森悖论的几何:混淆变量反转了相关性的方向。
第五步:反转因果图,看看会发生什么
现在假设你错误地认为因果图是:
Wrong causal graph:
T -> G -> Y
(treatment affects gender? obviously absurd, but let's pretend we don't know)
在这个错误的图下,后门准则告诉你:不需要调整,因为没有后门路径。
# Under the wrong causal graph T -> G -> Y:
# the graph says T is a cause of G, so G is not a confounder of T,
# the backdoor path T<-G->Y does not exist (the arrow direction is wrong),
# so we simply use the observed correlation as the "causal effect"

# "Causal effect" under the wrong graph = the direct observed effect (no adjustment)
wrong_causal_effect = observed_effect  # the unadjusted value computed in step 2

print(f"'Causal effect' under the wrong graph: {wrong_causal_effect:.2f}")
print(f"Correctly adjusted causal effect:       {adjusted_effect:.2f}")
print(f"True causal effect (generation setting): +15.00")
print(f"Deviation of the wrong inference from the truth: {abs(wrong_causal_effect - 15):.2f} points")
print()
print("Conclusion: a wrong causal graph assumption -> the inference deviates entirely from the true effect")
print("Observational data alone cannot tell you which graph is correct.")
你的第五个问题: 如果你使用了错误的因果图,你会得出什么结论?这个结论离真实因果效应有多远?
这就是第八节的核心论点:因果图的结构假设是不可避免的。如果图错了,推断就是错的——而观测数据无法告诉你图是否正确。
检验标准
完成这个练习后,你应该能够回答:
辛普森悖论是如何发生的?混淆变量如何让观测相关性和因果效应方向相反?
后门调整(分层分析)如何消除混淆?为什么分层后的效应更接近真实因果效应?
如果因果图的结构假设错了,后门调整会给出什么结果?误差有多大?
如果你只做一件事,做第四步。那张图会让你一眼看清混淆是如何扭曲相关性的。
动手试试:手写 do 运算——咖啡真的让你更聪明吗?
在辛普森悖论的练习中,你看到了观测数据为什么会撒谎。这个练习更进一步:你要亲手计算
场景:你在一家科技公司的数据团队工作。老板看到数据:喝咖啡的员工写出更多代码。他准备推行“每人每天三杯咖啡”的政策。你需要告诉他,观测到的相关性和强制喝咖啡的真实效应是不是同一回事。
因果图:
Work Stress (S) ─────> Coffee (C) ─────> Code Output (Y)
     │                              ↑
└──────────────────────────────┘- S(Stress,工作压力):0 = 低压,1 = 高压
- C(Coffee,今天喝了咖啡):0 = 没喝,1 = 喝了
- Y(代码产出,行/小时,连续值)
真实机制:高压员工更想喝咖啡(他们靠咖啡保持清醒),但高压本身会降低产出。咖啡本身对产出只有轻微的正面效应。
第一步:生成数据,感受混淆
import numpy as np
import pandas as pd
np.random.seed(42)

N = 2000

# Work stress (confounder)
S = np.random.binomial(1, 0.5, N)          # 50% high stress

# Coffee intake (driven by stress)
p_coffee = np.where(S == 1, 0.80, 0.25)    # high stress: 80% drink coffee; low stress: 25%
C = np.random.binomial(1, p_coffee, N)

# Code output (dragged down by stress, slightly boosted by coffee)
Y = (50                    # baseline output
     - 20 * S              # high stress reduces output by 20 lines
     + 5  * C              # coffee raises output by 5 lines (true causal effect)
     + np.random.normal(0, 8, N))

df = pd.DataFrame({'S': S, 'C': C, 'Y': Y})问题1:咖啡对产出的真实因果效应是多少?(直接从生成过程中读出来。)
第二步:计算观测到的相关性
# Directly compare coffee drinkers vs. non-drinkers
obs_effect = df[df.C == 1]['Y'].mean() - df[df.C == 0]['Y'].mean()
print(f"Observed effect P(Y|C=1) - P(Y|C=0) = {obs_effect:.2f}")问题2:观测到的效应是正的还是负的?它比真实因果效应更大还是更小?为什么?
(提示:高压员工既喝更多咖啡,产出又更低——这把咖啡和更低的产出绑在了一起。)
第三步:手写 do 运算——后门调整公式
现在你要亲手实现
后门准则告诉我们:S 位于 C 和 Y 之间的后门路径上(
公式是:
翻译成代码:
def do_calculus(df, intervention_value):
    """
    Compute P(Y | do(C = intervention_value))

    Steps:
    1. Stratify by S; within each stratum, compute the mean of Y at C=intervention_value
    2. Weight-average using the marginal distribution of S

    This is the code implementation of "cutting the arrow C<-S."
    """
    result = 0.0

    for s_val in [0, 1]:
        # Step 1: expectation of Y when S=s and C=intervention_value
        # (in this subset, the value of C is what we "observed", not what we intervened on)
        subset = df[(df['S'] == s_val) & (df['C'] == intervention_value)]
        E_Y_given_C_S = subset['Y'].mean()

        # Step 2: marginal probability of S=s (estimated from the original data)
        P_S = (df['S'] == s_val).mean()

        result += E_Y_given_C_S * P_S

    return result

# Compute the intervention effects
E_Y_do_C1 = do_calculus(df, intervention_value=1)  # do(C=1)
E_Y_do_C0 = do_calculus(df, intervention_value=0)  # do(C=0)

causal_effect = E_Y_do_C1 - E_Y_do_C0
print(f"Expectation of Y given do(C=1): {E_Y_do_C1:.2f}")
print(f"Expectation of Y given do(C=0): {E_Y_do_C0:.2f}")
print(f"Causal effect P(Y|do(C=1)) - P(Y|do(C=0)) = {causal_effect:.2f}")
print(f"True causal effect (set at generation time) = 5.00")问题3:do_calculus 函数与“先分层再取加权平均”做的是同一件事——与第二步的直接比较相比,哪一个更接近真实因果效应?
第四步:理解“切断箭头”意味着什么
do 运算的本质是构造一个干预数据集:强制 C 取某个值,同时让 S 保持不变(S 是 C 的原因,但 C 不是 S 的原因,所以强制喝咖啡不会改变工作压力)。
# Build the intervention dataset: do(C=1) -- everyone drinks coffee
df_do_C1 = df.copy()
df_do_C1['C'] = 1   # force everyone to drink coffee
# Note: do not modify S! S is an external variable, unaffected by C

# On the intervention dataset, recompute Y (using the true generation formula)
df_do_C1['Y'] = (50
                 - 20 * df_do_C1['S']
                 + 5  * df_do_C1['C']   # C is now all 1s
                 + np.random.normal(0, 8, N))

# Build the intervention dataset: do(C=0) -- nobody drinks coffee
df_do_C0 = df.copy()
df_do_C0['C'] = 0
df_do_C0['Y'] = (50
                 - 20 * df_do_C0['S']
                 + 5  * df_do_C0['C']   # C is now all 0s
                 + np.random.normal(0, 8, N))

effect_intervention = df_do_C1['Y'].mean() - df_do_C0['Y'].mean()
print(f"Effect estimate from the direct intervention experiment: {effect_intervention:.2f}")问题4:do_calculus 的结果(第三步)与“直接干预实验”的结果(第四步)应该很接近。如果它们接近,说明了什么?如果有差距,差距从哪里来?
第五步:告诉老板真相
print("=" * 50)
print(f"Observed correlation (wrong basis): {obs_effect:.1f} lines/hour")
print(f"do-calculus causal effect (right basis): {causal_effect:.1f} lines/hour")
print(f"True causal effect (generation setting): 5.0 lines/hour")
print()
print("Conclusion:")
print(f"Observational data shows coffee-drinking employees output {'higher' if obs_effect > 0 else 'lower'} by {abs(obs_effect):.1f} lines")
print("But most of this gap comes from the confounder (work stress)")
print(f"The true effect of a mandatory coffee policy is only about 5 lines/hour")最终问题:如果老板推行“三杯咖啡”政策,他期待的效果是多少?实际会发生什么?
这就是 do 运算的真正价值:在没有随机对照试验的情况下,从观测数据中估计干预效应。
扩展挑战(选做)
如果你想更深入,试着修改因果图,加入一个对撞节点:
S ───-> C ───> Y
           ↗
    Overtime (O)──-> Y
         ↑
         S
加班(O)也受工作压力影响,也影响产出。现在后门路径变了——你需要调整 S,但绝不能调整 O(O 是 C 的下游)。试着修改 do_calculus 来处理这个更复杂的图。
延伸阅读
Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.) — 因果推断的奠基之作;完整讨论 SCM、do 演算与反事实框架
Pearl, J. & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect — 因果阶梯的通俗版本;因果革命的历史与哲学
Spirtes, P., Glymour, C. & Scheines, R. (2000). Causation, Prediction, and Search — 因果发现算法的经典教科书;PC 算法与 FCI 算法的原始出处
Peters, J., Janzing, D. & Schölkopf, B. (2017). Elements of Causal Inference — 从机器学习角度讲因果推断,包括独立因果机制和加性噪声模型
-> [MIT Press]Hume, D. (1748). An Enquiry Concerning Human Understanding — 归纳问题的哲学起点;“过去不能证明未来”
Hernán, M. A. & Robins, J. M. (2020). Causal Inference: What If — 流行病学与医学中的因果推断,强调干预与观测的区别
-> [Free online]Schölkopf, B. et al. (2021). Toward Causal Representation Learning — 因果推断与深度学习的交叉;如何从数据中学习因果结构
-> [arXiv:2102.11107]Bareinboim, E. & Pearl, J. (2016). Causal inference and the data-fusion problem — 如何从多个异质数据源中识别因果效应
-> [PNAS]Zhang, K. & Hyvärinen, A. (2009). On the Identifiability of the Post-Nonlinear Causal Model — 非线性因果模型的可识别性;打破马尔可夫等价类的一种途径
-> [UAI 2009]Uhler, C., Raskutti, G., Bühlmann, P. & Yu, B. (2013). Geometry of the faithfulness assumption in causal inference — 忠实性假设的几何分析及其失败条件
-> [arXiv:1207.0547]