第4章:流形假设——高维数据的隐秩序
你以为数据是随机散布在高维空间的。它不是。它被挤在一个薄薄的曲面上。
一、维度的荒谬
先撒点。
在一根线段上随手撒 100 个点。相邻两点平均隔开线段长度的 1/100。够密,够用。
同样 100 个点摊进正方形,密度立刻稀掉。要补回原来的密度,得撒
立方体里要
1957 年,Bellman 给这件事起了名字:维度诅咒(Curse of Dimensionality)。他当时在讲动态规划,大概没料到这个词后来会压住整个机器学习。
维度诅咒:为什么高维空间里一切都稀疏?
维度诅咒说的是:维度一涨,想用同样的密度填满空间,样本量得指数级地涨。
看一个例子:
- 1 维线段(0 到 1)上撒 100 个点,平均间距是 0.01,还相当密
- 2 维正方形要保持同样的密度,得撒 100² 个点,也就是 10 000 个
- 10 维超立方体得撒 100¹⁰ = 10²⁰ 个,比可观测宇宙里的原子还多
麻烦不止是“数据要得更多”。高维里,距离这个概念本身塌了——任何两点之间的距离都挤到同一个数附近,“最近邻”和“最远邻”分不出来。
所以,低维里好用的算法,k-NN、聚类,一进高维就失灵。流形假设给了一条出路,下面讲:真实数据并不是均匀撒在高维空间里的,它有自己的低维结构。
样本量指数爆炸,这只是表层。真正怪的事在几何上。
在一个
距离的方差同时趋于零。
所有点对的距离收敛到同一个值。最近邻和最远邻差不多远。余弦相似度、欧氏距离、
随机初始化两个 1000 维向量,余弦相似度几乎总是接近零。不是语义相反。是 1000 维里的随机向量本来就几乎正交。
正交意味着什么? 就是
这两件事在两个地方冒出来。
回响一:专家系统的概念空间。 第 2 章里,专家系统拿离散符号表示知识——"是哺乳动物"、"有翅膀"、"会飞"——一个符号一个原子,概念之间的关系得靠人写进规则。换个高维几何的角度看:每个符号都像在某根正交基上占了一个维度。"猫"和"狗"之间没有内在联系,两个独立 token,像两个随机单位向量,几乎必然正交。专家系统卡住的地方就在这儿:它抓不到概念之间连续的相似性。它把世界塞进一组人工正交基。世界不正交。符号系统假装它正。
高维里的正交不是 bug,是 feature。维度一高,随机向量几乎必然正交,天然解耦,各管各的。高维嵌入能吃上这口免费午餐,靠的就是这个:每一维可以单独描一个语义侧面,不用像低维那样挤成一团。
专家系统的毛病正好相反。它刻意制造正交,却只用得起极少的维度。每个概念硬编码成一根正交基向量,干净,整齐,能表示的东西却少得可怜。概念之间的连续相似性它抓不住,高维天然正交白送的那份便利,它也用不上。
真正的高维嵌入,比如词向量,强在把这件事交给数据。训练不强加正交。统计约束把向量往流形上推——那个曲面既不是完全随机、彼此正交的沙漠,也不是黏成一团的低维沼泽。它是折过的,语义挤在褶皱里。
回响二:词向量的类比算术。 第 3 章见过那个漂亮的等式: doctor - man + woman ≈ nurse,不是女医生。语料的偏见把那一带的流形拧歪了。那里的曲率属于语料统计,不属于客观概念。
两个回响撞在同一件事上。随机的高维空间是一片正交的沙漠。可学习的数据不是随机的。有东西把它压进了低维结构,流形假设说的就是这个东西。
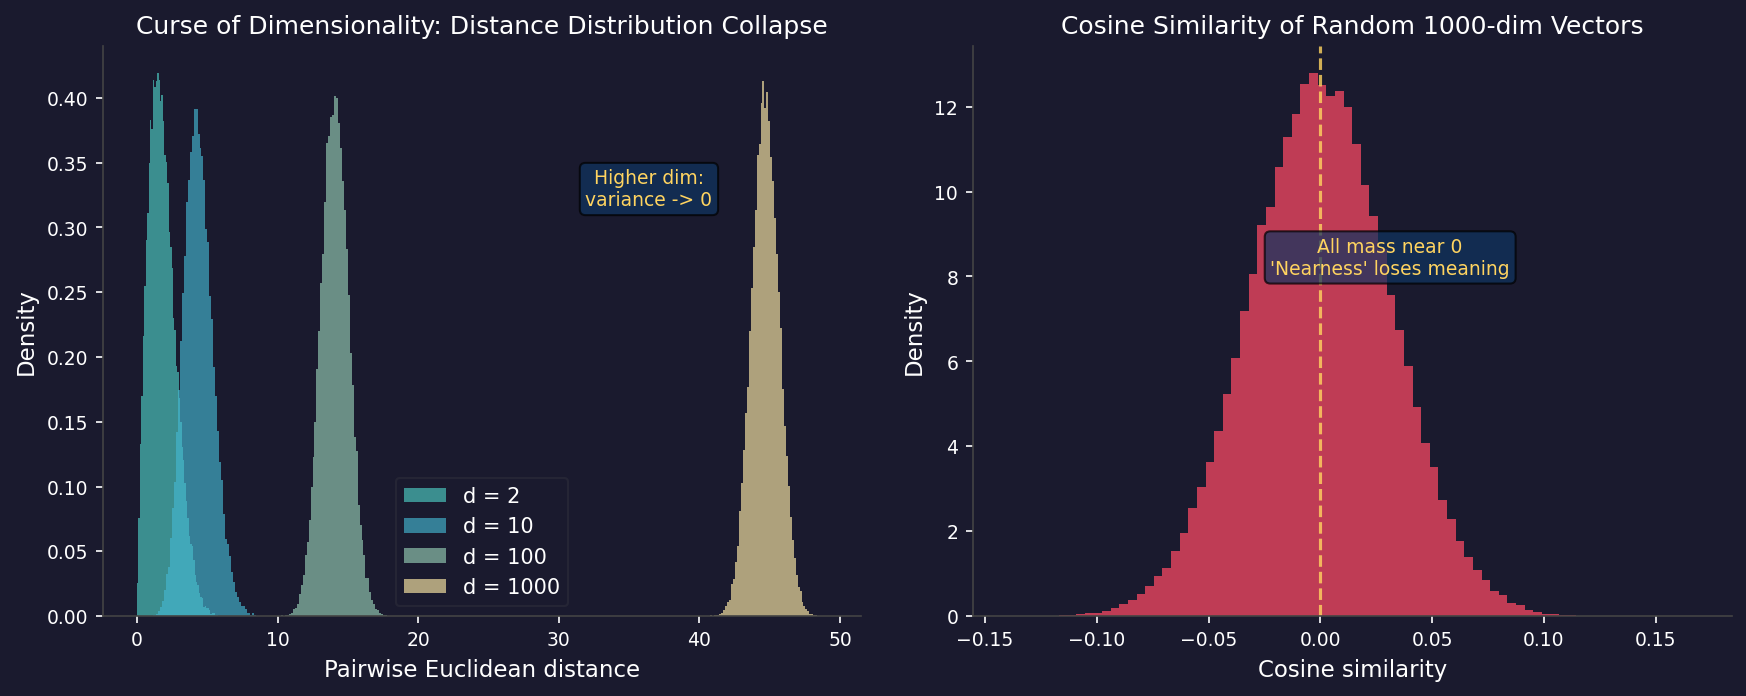
图1:左图,随机点对在 2、10、100、1000 维空间中的距离分布。维度越高,分布越集中,方差 → 0——“距离”失去区分能力。右图,1000 维随机向量两两余弦相似度的直方图,几乎全部堆积在零附近。
于是问题摆在面前:数据如果真是高维随机的,任何靠距离或相似度的算法——神经网络也算——都不该工作。
可它们在工作。
解释无非两条。
一条:算法用了某种我们还看不透的办法,绕开了高维几何。
另一条:数据根本不是高维随机的。
第二条对。
停顿一下
先别急着收下“第二条对”。
自然数据为什么挤在低维流形上?这是要解释的事,不是公理。
有一种答法:物理定律把可能状态的空间卡住。人脸受骨骼、肌肉和光照的支配,可能的人脸远远少于可能的像素组合。
这个答法偷偷塞进一个假设:世界有规律,而且规律是低维的。
它凭什么成立?要是世界真正的规律又高维又混沌,流形假设当场崩溃,机器学习也不该有用。
可它有用。是物理定律真的低维,还是我们碰巧只在流形假设成立的问题上做了测试?
先搁着。
二、流形假设:约束造就曲面
流形假设(Manifold Hypothesis)就一句话:
图像、语言、声音,名义上住在高维空间里,其实挤在一张光滑曲面附近。这张曲面的内在维度,比它所在的空间低得多。
“流形”是数学词。它只说一件事:局部摊平了看,像欧氏空间。三维空间里的一张二维曲面就是流形。地球表面算一个,莫比乌斯带算一个,一根弯水管的表面也算一个。
流形:用地球表面来理解
流形是几何对象,定义很短:局部看是平的,像普通欧氏平面;整体可以弯。
地球表面是最省事的例子。站在任意一点,眼睛只扫脚下那一小块,它跟平地没区别——这就是局部像欧氏空间。退到外面看,它是一个球面。二维流形,嵌在三维里。
放进机器学习里:
- 49152 维的人脸图像空间,对应上文的整个三维空间
- 人脸真正待着的那几十维曲面,对应地球表面
流形假设的分量在这儿:它解释了机器学习为什么有效。数据不是高维随机的,它挤在低维曲面上,算法学的是那张曲面。
换一个具体的。
一张
真实的人脸只占极小一片。决定一张脸的参数有哪些?
身份(这是谁)
姿态(头转了几度,仰了多少)
光照(光从哪来,多强)
表情(在笑,在皱眉)
年龄
十几个到几十个参数,就能描出人脸的大部分变化。它的内在维度是几十,不是 49 152。
人脸图像挤在 49 152 维空间里一张几十维的曲面上。
语言也一样。合法的英语句子只占所有可能词序列的一小片。合理的语义,在合法句子里占的片更小。每加一层约束,流形就多折一次。
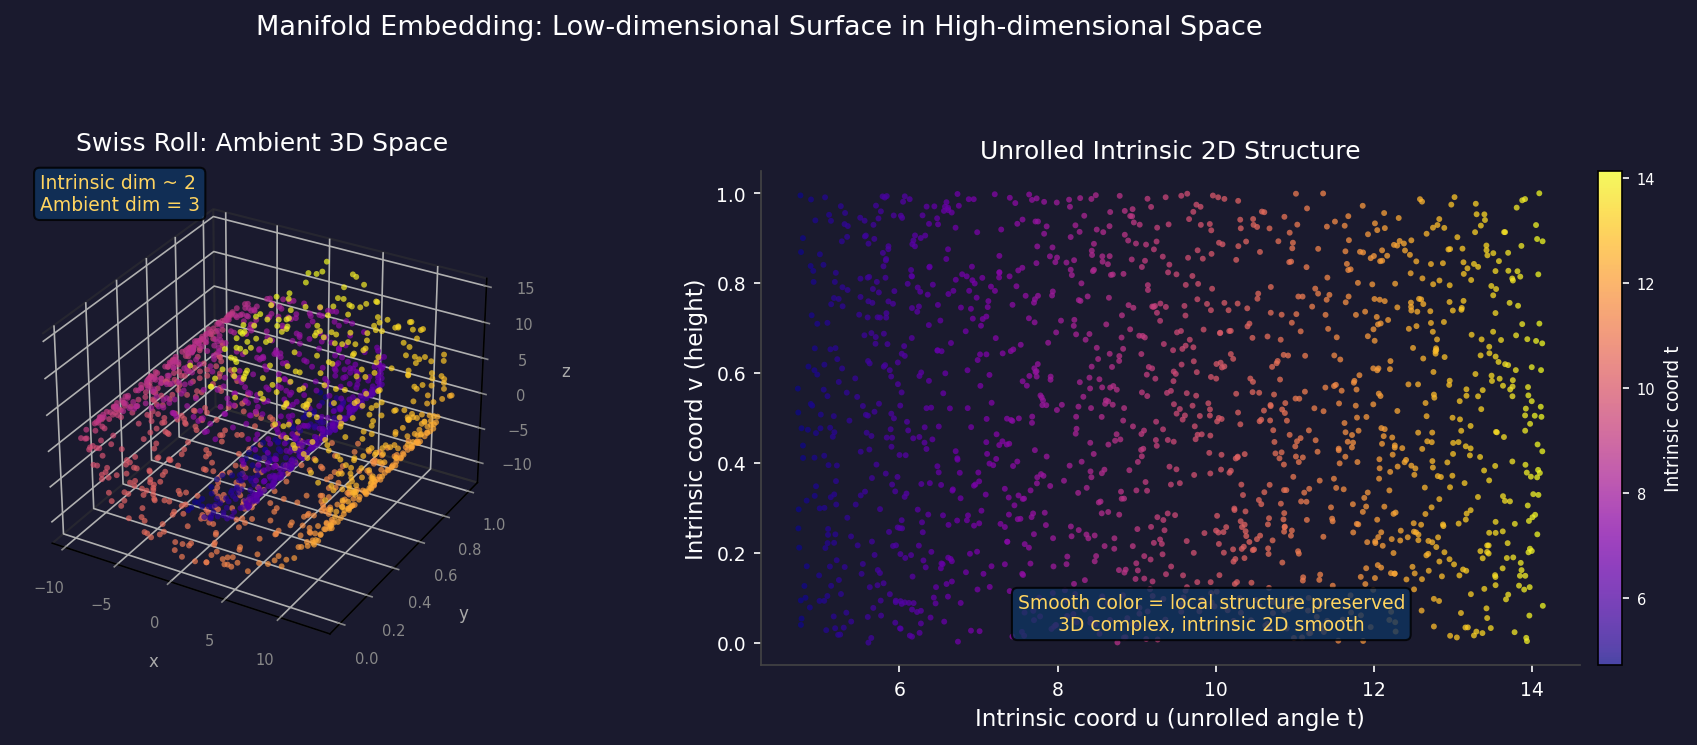
图2:左图,一个二维流形(Swiss Roll 数据集)嵌入在三维空间中——三维坐标看起来复杂,但数据沿两个内在维度(展开后的 u、v 坐标)平滑分布。右图,对同一数据集做流形学习(UMAP),恢复了内在的二维结构。颜色编码内在坐标的连续性——局部邻居在高维空间中仍然是邻居。
自然数据为什么聚在流形上?因为生成过程就那么长出来的。
人脸由生物过程生成:DNA、骨骼、皮肤纹理,参数有限,而且连续变化。语言由语法和语义约束生成。音乐由声波和文化惯例生成。
生成过程的约束,就是流形的曲率。约束越紧,流形越低维,越弯。
所以,内在维度不是数据自己带的属性。它是生成数据的那个世界,在数据上投下的影子。
三、训练是折叠
这一章最要紧的部分到了。
平时我们说神经网络在“学习”——学认猫,学翻译,学猜下一个词。这个说法靠不住。“学习”听起来像理解,像把知识咽进肚子里。
更准的说法是:神经网络在做流形变换。
拆开一个自动编码器看:
其中
编码器
编码器学到的是流形的参数化:一组能标出流形上每个点的坐标。解码器学的是这组坐标和高维表示之间的对应。
分类网络也一样。ResNet 认图像,最后一个全连接层之前那串特征向量,就是它学出来的流形坐标,只不过这套坐标是照着分类的需要摆的。
反向传播干的活,就是调这套坐标。每走一步梯度,网络把高维输入映射到低维空间的方式就变一点,流形的参数化也跟着变。
训练说到底,是把见过的数据的流形结构,折进参数的曲率里。
“折叠”不是修辞。不是“存储”,也不是“记忆”。网络没有足够的参数,逐条塞下训练集。真正发生的是:数据的统计结构,连同所在流形的几何,被压进权重的配置里。
这不是学习。是拓扑压缩。
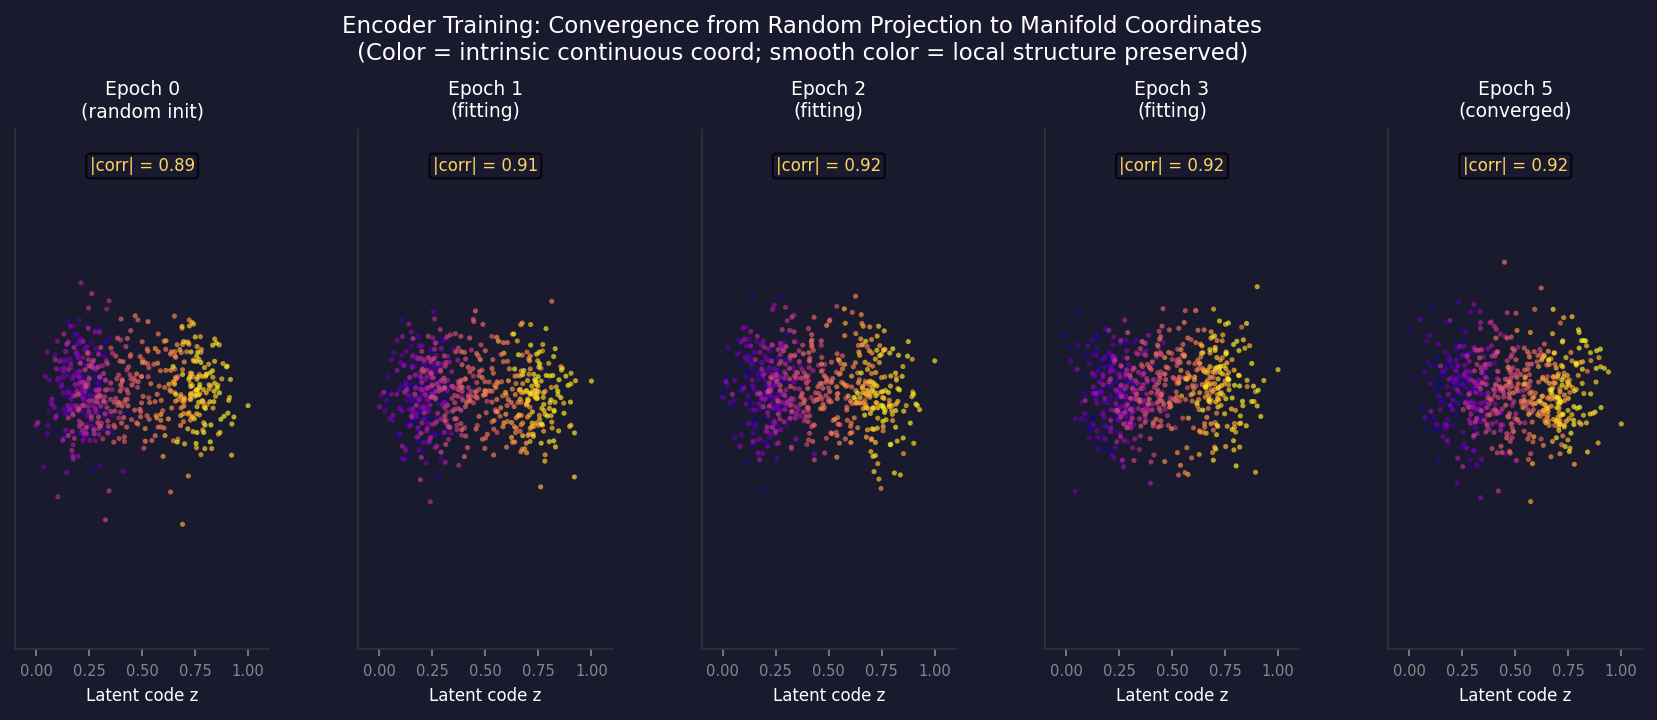
图3:上方,编码器将高维数据(散布在二维流形上的三维点云)逐步映射到一维潜在编码。下方,训练过程中潜在空间的演化——随着 epoch 增加,潜在表示从混乱走向结构化。颜色代表数据在原始流形上的连续坐标;颜色连续意味着局部结构被保留。
参数里到底存了什么?
直觉会说,存的是知识:猫长什么样,语法规则,物理定律。
更准的说法:参数存的是训练数据流形结构的压缩编码。
知道这一点,预训练为什么有效就不用解释了。同一个流形,比如自然图像,能供好几个任务共用;预训练里学到的参数化可以直接搬。
微调为什么有时改得动模型,有时改不动,也有了着落。看新任务的流形是不是预训练流形的子集。
大模型为什么会产生幻觉,从这里也能看出苗头。第四幕细讲。
四、压缩的账单
压缩都要付账。这不是经验之谈,是信息论定理。
Shannon 的信源编码定理把话说明白了:无损压缩的天花板是信源的熵。越过去,一定丢信息。神经网络的压缩远远越过了这条线,所以它一定在丢东西。
丢的是什么?
第一笔账:流形外的点
训练完,参数里编的是训练数据所在的那张流形。测试时撞上一个不在这张流形上的点——别的分布的图像、没见过的语言现象、反事实的场景——网络怎么办?
它没有警报。它不知道“这个点不在我的流形上”。它把点拽到最近的流形区域,按那个区域的规矩回答。
于是它自信地错。不是“我不知道”,是“它看着像 X,那就答 X”。X 全错,它也照答不误。
分布偏移(Distribution Shift)的根子就在几何上。模型学的流形和真实世界的流形,在训练分布之外对不上。偏得越远,错得越多。置信度却不降。它算的是流形坐标的函数,不是“这个点离流形有多远”的函数。
第二笔账:流形内部的等距性
压缩的时候,流形有些地方被拉开,有些地方被挤扁。
数据密的地方,参数化的分辨率高。挨着的输入映到挨着的编码,局部几何保得住。
数据稀的地方,分辨率低。挨着的输入可能被甩到很远,离得很远的输入也可能挤到一起。
所以网络在密处泛化好,在稀处泛化差。这种差不是乱来的,有规律:稀处的流形结构被“脑补”了,填进去的是训练数据里最常见的模样,不是那片地方真实的样子。
脑补出来的就是幻觉(hallucination)。
第三笔账:Tishby 的信息瓶颈
2017 年,Naftali Tishby 给这件事套了个框架:信息瓶颈(Information Bottleneck)。
训练本质上是一笔权衡:
其中
第一项
第二项
两头拉扯的最优解叫“充分统计量”:预测标签要用的信息全留,冗余全扔。
Tishby 主张训练分两步走。先“拟合”:网络抓和标签有关的信息,
这个理论漂亮,也有争议。后续研究,Saxe 等人在 2018 年发现,压缩阶段在很多情况下根本不来,来不来要看激活函数。信息瓶颈是个好用的分析框架,不是完整的理论 -> [Tishby & Schwartz-Ziv, 2017, arXiv:1703.00810] -> [Saxe et al., 2018, arXiv:1812.09881]。
最终的账
三笔加起来,压缩的代价是一张表:
分布内:泛化好,置信度也准
分布边缘:泛化开始掉,置信度还很高。危险区
分布外:泛化差,置信度可能高得离谱。最危险的地方
网络不知道自己的脚已经踩到流形边上。它只知道输入映到了潜在空间的某个坐标,然后照那个坐标的规矩输出。没有传感器告诉它:你正在推断一片自己从没真正懂过的地方。
不是 bug。压缩的结构性后果,躲不掉。
五、压缩的极限:流形能被压到多小?
流形假设说高维数据被挤到低维流形上。那“低”能低到哪儿?压缩能走多远?
这是信息论的问题,几何管不到底。
速率-失真理论给出一个下界
Shannon 的速率-失真理论:要用失真
对流形上的数据:
把隐藏层从
内在维度
它说的是描述流形最少要几根坐标。这个数能从两两距离的分布里估出来:
其中
实测的数字很扎眼。ImageNet 图像的内在维度大约 40,原始像素维度是
真实世界的数据确实被压到了极低维的流形上。
但存在一个硬下界
压缩有底。压到内在维度以下,失真猛地上升。丢的不再是噪声,是流形本身的结构。
知识蒸馏就是这样撞墙的。大模型压成小模型,过了某个压缩比,模型不是差一点,是彻底塌掉。速率-失真曲线在拐点之后往下栽。
这道硬下界,还有随机化怎么绕开确定性压缩的极限,是第 11 章的事。
六、一个小小的停顿
停一下,收一收。
高维空间里,随机数据学不动:距离没意义,采样要指数级多的点。机器学习能用,不是它战胜了高维,是数据本身不高维随机。自然数据聚在低维流形上——物理过程、生物约束、语法规则,一起把数据挤到了那儿。
训练神经网络,就是把数据的流形结构压进参数。不是存,是压。压缩比在 100 比 1 到 1000 比 1 之间。
账单跑不掉。流形外的点被硬拽进来,稀处被脑补,分布一偏,置信度就和准确率脱钩。这不是工程没做好,是信息论把价码钉死了。
第 5 章接着问:如果模型学的是流形结构,不是因果规律,它为什么一出版训练分布就成片地错?统计相关和真正的推理,差在哪儿?
流形只说数据在哪里。它不说模型有没有学到真规律。下一章看统计拟合怎么变成陷阱。
悬而未决
网络学到的流形和真实世界的流形,到底贴得多紧?眼下还没有好尺子量这件事。
内在维度估得准吗?各家方法各自押了什么假设?LLM 的激活空间里,这个数是多少?
压缩丢掉的信息里,有没有推理要用的结构?还是说推理恰好躲在留下来的那部分里?
拿纯随机数据训练一个网络,它会学出什么样的“流形”?这个思想实验能试出流形假设的分量。
信息瓶颈的两段论,实验上还没吵完。要是压缩阶段压根不存在,泛化又该怎么解释?
知识的流形结构:知识图谱是离散的符号流形,词向量是连续的语义流形。两者怎么互相映射、互相验证?会不会有一套统一的知识流形?
多层次的流形:生命的相空间、知识的逻辑空间、学习的表示空间,各是一个流形。它们之间有同构或映射吗?
动手试试:压缩一个流形,然后找到它的账单
这一章的核心主张是:压缩有代价,而且代价发生的位置不是随机的——它有规律。你将用一个最小的自动编码器亲手验证这一点——不是为了得到一个好模型,而是为了精确指出压缩究竟在哪里撒了谎。
第一步:生成你的流形数据
不要使用真实数据集——干扰太多。从一个你完全理解其生成过程的流形开始。
生成以下之一:
选项 A:嵌入三维空间的二维圆环
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
N = 2000  # number of sample points

# Uniformly sample the two angular parameters of the torus
t = np.random.uniform(0, 2 * np.pi, N)   # angle around the main axis
phi = np.random.uniform(0, 2 * np.pi, N) # angle around the tube cross-section

r = 3.0    # main ring radius
tube = 1.0 # tube radius

# Torus parametric equations: embedded in 3D space
x = (r + tube * np.cos(phi)) * np.cos(t)
y = (r + tube * np.cos(phi)) * np.sin(t)
z = tube * np.sin(phi)

# Add a small amount of Gaussian noise to simulate measurement error
noise_std = 0.05
x += np.random.normal(0, noise_std, N)
y += np.random.normal(0, noise_std, N)
z += np.random.normal(0, noise_std, N)

# Stack the three coordinates into a data matrix of shape=(N, 3)
data_torus = np.stack([x, y, z], axis=1)
# Save intrinsic coordinates for later coloring (t is the main angle, phi is the tube angle)
intrinsic_t = t
intrinsic_phi = phi

# Visualize (colored by the t value)
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')
sc = ax.scatter(x, y, z, c=t, cmap='hsv', s=2, alpha=0.6)
plt.colorbar(sc, label='intrinsic coordinate t')
ax.set_title('Torus manifold (Option A)')
plt.tight_layout()
plt.show()
选项 B:Swiss Roll(本章图示中的数据集)
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_swiss_roll

np.random.seed(42)
N = 2000  # number of sample points

# Generate the standard Swiss Roll with sklearn
# t is the intrinsic coordinate (unfold angle), z is the intrinsic coordinate along the height
data_swiss, t_swiss = make_swiss_roll(n_samples=N, noise=0.1, random_state=42)
# data_swiss has shape=(N, 3); the columns are x, y, z (3D embedding coordinates)

# Or generate it manually (equivalent):
t_manual = np.random.uniform(1.5 * np.pi, 4.5 * np.pi, N)  # unfold angle
x_manual = t_manual * np.cos(t_manual)
z_manual = np.random.uniform(0, 1, N)                        # height (second intrinsic dimension)
y_manual = t_manual * np.sin(t_manual)
# Add a small amount of Gaussian noise
x_manual += np.random.normal(0, 0.1, N)
y_manual += np.random.normal(0, 0.1, N)
z_manual += np.random.normal(0, 0.05, N)

# Visualize the manually generated Swiss Roll (colored by t)
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')
sc = ax.scatter(x_manual, y_manual, z_manual, c=t_manual, cmap='viridis', s=2)
plt.colorbar(sc, label='intrinsic coordinate t (unfold angle)')
ax.set_title('Swiss Roll manifold (Option B)')
plt.tight_layout()
plt.show()

# Use the sklearn version from here on (more standard)
data = data_swiss          # 3D coordinates, shape=(N, 3)
intrinsic_t = t_swiss      # intrinsic coordinate t, used for coloring
选项 B 的内在维度是 2(t 和 z),嵌入在三维空间中。
你的第一个问题(写代码之前回答): 这个数据的“真实内在维度”是多少?如果你用 PCA 降维,你认为需要保留多少个主成分才能保留大部分方差?写下你的预测,之后与实际结果比较。
第二步:实现一个最小自动编码器
结构定义:
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# --- Autoencoder architecture ---
class Autoencoder(nn.Module):
    def __init__(self, bottleneck_dim):
        super().__init__()
        # Encoder: 3 -> 16 -> d (bottleneck dimension)
        self.encoder = nn.Sequential(
            nn.Linear(3, 16),      # 3D input (embedded data points)
            nn.ReLU(),             # non-linear activation
            nn.Linear(16, bottleneck_dim)  # d-dimensional latent code z
        )
        # Decoder: d -> 16 -> 3 (reconstruct the original coordinates)
        self.decoder = nn.Sequential(
            nn.Linear(bottleneck_dim, 16),
            nn.ReLU(),
            nn.Linear(16, 3)       # 3-dimensional reconstruction
        )

    def forward(self, x):
        z = self.encoder(x)    # encode
        x_hat = self.decoder(z)  # decode
        return x_hat, z

# --- Training function ---
def train_autoencoder(data_tensor, bottleneck_dim, n_epochs=300, lr=1e-3):
    """
    Train the autoencoder until the reconstruction error converges.
    Returns the trained model.
    """
    dataset = TensorDataset(data_tensor)
    loader = DataLoader(dataset, batch_size=256, shuffle=True)

    model = Autoencoder(bottleneck_dim)
    optimizer = optim.Adam(model.parameters(), lr=lr)
    loss_fn = nn.MSELoss()  # loss function: mean squared error (reconstruction error)

    for epoch in range(n_epochs):
        for (batch,) in loader:
            optimizer.zero_grad()
            x_hat, _ = model(batch)
            loss = loss_fn(x_hat, batch)  # reconstruction error
            loss.backward()
            optimizer.step()

    return model

# --- Example: use the Swiss Roll data, starting with bottleneck dimension d=2 ---
# (Assume data was generated in the previous step, shape=(N, 3))
data_tensor = torch.tensor(data, dtype=torch.float32)  # convert to a PyTorch tensor

# Train an autoencoder with bottleneck dimension d=2
model_d2 = train_autoencoder(data_tensor, bottleneck_dim=2)
print("Autoencoder for d=2 trained")
训练至重建误差收敛。不需要调超参数——默认设置即可。
第三步:系统地改变瓶颈维度,记录账单
用 d = 1, 2, 3, 4, 5 训练,并对每个 d 记录:
import matplotlib.pyplot as plt
import torch
import torch.nn as nn

# Split the data into train and test sets (80% / 20%)
N = len(data_tensor)
split = int(0.8 * N)
train_data = data_tensor[:split]
test_data  = data_tensor[split:]

results = {}  # stores the results for each bottleneck dimension

for d in [1, 2, 3, 4, 5]:
    # 1. Train the autoencoder
    model = train_autoencoder(train_data, bottleneck_dim=d, n_epochs=300)
    model.eval()

    with torch.no_grad():
        # 2. Compute the average reconstruction error (MSE) on the train set
        train_hat, train_z = model(train_data)
        train_mse = nn.MSELoss()(train_hat, train_data).item()

        # 3. Compute the average reconstruction error on the test set
        test_hat, test_z = model(test_data)
        test_mse = nn.MSELoss()(test_hat, test_data).item()

    results[d] = {'train_mse': train_mse, 'test_mse': test_mse,
                  'train_z': train_z.numpy(), 'model': model}

    # 4. Visualize the latent space (colored by intrinsic coordinate t)
    train_t = intrinsic_t[:split]  # intrinsic coordinates of the train set
    if d == 1:
        # d=1: the latent space is a line, plot a 1D scatter
        fig, ax = plt.subplots(figsize=(8, 2))
        sc = ax.scatter(train_z.numpy()[:, 0],
                        np.zeros(len(train_z)),
                        c=train_t, cmap='viridis', s=5)
        plt.colorbar(sc, label='intrinsic coordinate t')
        ax.set_title(f'd={d} latent space (1D)')
    elif d == 2:
        # d=2: plot a 2D scatter directly
        fig, ax = plt.subplots(figsize=(6, 5))
        sc = ax.scatter(train_z.numpy()[:, 0],
                        train_z.numpy()[:, 1],
                        c=train_t, cmap='viridis', s=5)
        plt.colorbar(sc, label='intrinsic coordinate t')
        ax.set_title(f'd={d} latent space (2D)')
    plt.tight_layout()
    plt.show()

    # 5. Sample 20 points from the latent space, decode them, and plot them in 3D
    with torch.no_grad():
        # Uniformly sample the latent space (using the range of the train-set latent codes)
        z_min = train_z.min(dim=0).values
        z_max = train_z.max(dim=0).values
        z_samples = torch.rand(20, d) * (z_max - z_min) + z_min
        decoded_samples = model.decoder(z_samples).numpy()

    fig = plt.figure(figsize=(7, 5))
    ax = fig.add_subplot(111, projection='3d')
    ax.scatter(data[:split, 0], data[:split, 1], data[:split, 2],
               c='lightblue', s=1, alpha=0.3, label='train data')
    ax.scatter(decoded_samples[:, 0], decoded_samples[:, 1], decoded_samples[:, 2],
               c='red', s=50, zorder=5, label='randomly decoded points')
    ax.set_title(f'd={d} random decoding (randomly sampled latent points)')
    ax.legend()
    plt.tight_layout()
    plt.show()

    print(f"d={d}: train MSE={train_mse:.4f}, test MSE={test_mse:.4f}")

print("\nComparison across bottleneck dimensions:")
for d, r in results.items():
    print(f"  d={d}: train MSE={r['train_mse']:.4f}, test MSE={r['test_mse']:.4f}")
你的第二个问题: 当 d=1 时,编码器把一个二维流形压缩到一维。它保留了什么?丢失了什么?潜在空间中点的排列是否保留了原始流形的拓扑(例如圆环循环的关系)?
你的第三个问题(核心问题): 当 d=2 时,如果用原始内在坐标(t 和 φ,或 t 和 z)给潜在空间的点染色,颜色会连续变化吗?如果是,说明什么?如果不是,又说明什么?
第四步:看看分布外点会怎样
生成一批不在你的流形上的点——例如三维空间中的随机高斯噪声点。
把这批点送进你的自动编码器:
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt

# Use the d=2 model for out-of-distribution testing
model = results[2]['model']
model.eval()

# OOD data: sample 100 points from a standard 3D Gaussian distribution
# Note: these points are scattered across the whole 3D space, not restricted to the manifold
ood_data = torch.randn(100, 3)  # standard normal with mean 0 and variance 1

with torch.no_grad():
    # Reconstruct with the autoencoder (encode -> decode)
    ood_reconstructed, ood_z = model(ood_data)

# Compute the reconstruction errors for both datasets
loss_fn = nn.MSELoss(reduction='none')  # compute the error for each sample individually
with torch.no_grad():
    train_hat, _ = model(train_data)
    # MSE of each train sample (averaged over the three dimensions)
    train_errors = loss_fn(train_hat, train_data).mean(dim=1).numpy()
    # MSE of each OOD sample
    ood_errors   = loss_fn(ood_reconstructed, ood_data).mean(dim=1).numpy()

# Compare the reconstruction errors
print(f"Average reconstruction error on train set: {train_errors.mean():.4f} ± {train_errors.std():.4f}")
print(f"Average reconstruction error on OOD points: {ood_errors.mean():.4f} ± {ood_errors.std():.4f}")

# Visualize: plot the reconstruction of the OOD points in 3D
# Observe where they land (whether they are "pulled" toward the manifold)
fig = plt.figure(figsize=(10, 5))

# Left panel: the original OOD points
ax1 = fig.add_subplot(121, projection='3d')
ax1.scatter(data[:500, 0], data[:500, 1], data[:500, 2],
            c='lightblue', s=2, alpha=0.3, label='train manifold')
ax1.scatter(ood_data[:, 0], ood_data[:, 1], ood_data[:, 2],
            c='red', s=30, label='OOD points (original)')
ax1.set_title('OOD points (scattered in 3D space)')
ax1.legend(fontsize=8)

# Right panel: OOD points after reconstruction by the autoencoder
ax2 = fig.add_subplot(122, projection='3d')
ax2.scatter(data[:500, 0], data[:500, 1], data[:500, 2],
            c='lightblue', s=2, alpha=0.3, label='train manifold')
ax2.scatter(ood_reconstructed[:, 0].numpy(),
            ood_reconstructed[:, 1].numpy(),
            ood_reconstructed[:, 2].numpy(),
            c='orange', s=30, label='OOD points (reconstructed)')
ax2.set_title('OOD points after reconstruction — "pulled" toward the manifold')
ax2.legend(fontsize=8)

plt.tight_layout()
plt.show()
你的第四个问题: 经过自动编码器之后,分布外的点被“拉”到了哪里?它们的重建结果是随机的,还是系统性地落在训练流形的某个区域?
这正是本章第 4 节所说的:“网络没有‘这个点不在我的流形上’的警报。它只能把这个点强行拖到最近的流形区域。”你刚刚亲手观察到了这个过程。
第五步:估计你的流形的内在维度
回到第一步——现在做一次数据驱动的内在维度估计:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

# Run PCA on the training data (a numpy array, not a tensor)
train_np = data[:split]  # shape=(N_train, 3)

pca = PCA()               # keep all components (no limit)
pca.fit(train_np)

# Variance ratio explained by each principal component
explained_ratio = pca.explained_variance_ratio_
# Cumulative explained variance curve
cumulative_ratio = np.cumsum(explained_ratio)

# Plot the cumulative variance curves
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# Left panel: variance explained by each principal component
axes[0].bar(range(1, len(explained_ratio) + 1), explained_ratio, color='steelblue')
axes[0].set_xlabel('Principal component index')
axes[0].set_ylabel('Explained variance ratio')
axes[0].set_title('Variance explained by each principal component')

# Right panel: cumulative explained variance curve, find the "elbow"
axes[1].plot(range(1, len(cumulative_ratio) + 1), cumulative_ratio,
             marker='o', color='tomato')
axes[1].axhline(y=0.95, color='gray', linestyle='--', label='95% threshold')
axes[1].set_xlabel('Number of principal components')
axes[1].set_ylabel('Cumulative explained variance ratio')
axes[1].set_title('Cumulative variance curve (find the elbow)')
axes[1].legend()

plt.tight_layout()
plt.show()

# Find how many principal components are needed to explain 95% of the variance
n_components_95 = np.searchsorted(cumulative_ratio, 0.95) + 1
print(f"Principal components needed for cumulative variance >= 95%: {n_components_95}")
print(f"Variance explained by each component: {explained_ratio.round(4)}")
print(f"Cumulative explained variance: {cumulative_ratio.round(4)}")

# Compare with the autoencoder results
print(f"\nIntrinsic dimension estimated by PCA: {n_components_95}")
print("Test MSE of the autoencoder at each bottleneck dimension:")
for d, r in results.items():
    print(f"  d={d}: test MSE={r['test_mse']:.4f}")
print("(The point where the MSE jumps sharply corresponds to the intrinsic dimension estimated by the autoencoder)")
把这个数字与你在第一步写下的预测比较。
你的第五个问题: 你用 PCA 估计的内在维度,是否与自动编码器给出的“最小无损瓶颈维度”一致?如果不同,你认为原因是什么——PCA 的线性假设,还是自动编码器的非线性?
清单
完成这五步之后,你应该能够回答以下三个问题——并且用你自己的实验数据来回答,而不是用本章的文字:
压缩到流形的内在维度以下,代价是什么?代价出现在哪里?
分布外的点经过自动编码器之后,是如何被“幻觉式处理”的?
“训练数据密集的地方泛化好,稀疏的地方泛化差”——在你的实验中,稀疏区域对应流形的哪一部分?那里的重建误差更高吗?
如果你只做一件事,就做第四步。它是最短的实验,也是最能让你直观感受到“幻觉”如何发生的实验。
小结:从流形到知识结构——前四章的深层联系
四章走完,回头看一遍。第 1 章和第 2 章各自添了一块,它们和后面两块接得上。
三个层次的推理系统
前四章讲了三层推理系统。它们长得不一样,底下的元模式是一个。
物理层(第 1 章新增):生命系统,一个开放系统
- 靠能量流把局部的熵压下去
- 代价是环境那边涨熵
- 耗散结构:远离平衡,自己组织起来
符号层(第 2 章新增):知识系统,一堆符号
- 靠逻辑规则做精确推理
- 代价是构建成本,换来的是可解释
- 知识图谱:符号 AI 放大规模的样子
统计层(第 3–4 章):学习系统,一个统计模型
- 从数据流里学模式
- 代价是算力,换来泛化
- 流形假设:高维数据里的低维结构
统一视角:结构、代价、流动
三层共用一套统一框架:
| 维度 | 物理层(生命) | 符号层(知识) | 统计层(学习) |
|---|---|---|---|
| 核心机制 | 能量流 | 逻辑推理 | 模式识别 |
| 有序形式 | 物理结构秩序 | 符号结构秩序 | 表示空间秩序 |
| 维持代价 | 环境熵 | 构建成本 | 计算复杂度 |
| 外部输入 | 能量 / 物质 | 知识 / 规则 | 数据 / 样本 |
| 结构假设 | 耗散结构 | 封闭世界 | 流形假设 |
从离散到连续:表示的演进
四章还排出了一条知识表示的路:
- 离散符号(第 2 章):If-Then 规则、知识图谱三元组
- 连续向量(第 3 章):词嵌入、语义空间
- 低维流形(第 4 章):内在维度、数据的内部结构
关键洞见:知识图谱是离散的符号流形,词向量是连续的语义流形。两边都在描世界的结构,用的语言不一样。
元问题:在多个层次上推理
于是撞上一个元问题:推理是什么?
- 物理答案:生命拿来对抗熵的认知策略
- 符号答案:符号系统顺着逻辑规则的推导
- 统计答案:统计模型在流形上的模式匹配
三个答案都对,也都不全。真要拼起来:
- 物理层给存在基础(为什么要推理)
- 符号层给精确框架(怎么形式化)
- 统计层给实现机制(怎么算)
思考题:边界在哪里?
每一层都有自己的边界:
- 物理层卡在热力学极限(Landauer 原理)
- 符号层卡在知识边界(封闭世界假设)
- 统计层卡在泛化边界(流形假设)
最后一个问题:AI 在“推理”的时候,站在哪一层?还是说真智能得把三层缝在一起,才够?
延伸阅读
Tishby, N. & Schwartz-Ziv, M. (2017). Opening the Black Box of Deep Neural Networks via Information——信息瓶颈理论的深度学习版本,提出两阶段训练假说
-> [arXiv:1703.00810]Saxe, A. et al. (2018). On the Information Bottleneck Theory of Deep Learning——对 Tishby 理论的批评与修正,表明压缩阶段取决于激活函数的选择
-> [arXiv:1812.09881]Fefferman, C., Mitter, S. & Narayanan, H. (2016). Testing the Manifold Hypothesis——对流形假设的数学检验:它何时成立、何时不成立
-> [arXiv:1204.1423]Bengio, Y., Courville, A. & Vincent, P. (2013). Representation Learning: A Review and New Perspectives——表示学习综述,涵盖流形学习与深度表示之间的关系
-> [arXiv:1206.5538]Bellman, R. (1957). Dynamic Programming——维度诅咒的原始出处;Bellman 在优化语境中命名了这一现象
本书第 11 章第 5–9 节:Collins 随机化优化器——
状态压缩与安全压缩比 的信息论证明与实验(代码见第 11 章附录: collins_adam.py)