第3章:从符号到向量——表示空间的第一次解放
把“国王”减去“男人”,加上“女人”,你就得到了“女王”。这是推理——还是算术?
一、那句话
2013 年,Tomas Mikolov 在论文里写下了一个方程。后来,它被引用的次数,大概超过了那个时代任何一篇 NLP 论文:
读法是这样:国王的向量,减去男人的向量,加上女人的向量,最近的那个词是女王。
这例子不是谁设计出来的。实验跑完,它自己躺在那儿。没人教过算法“国王之于男人,犹如女王之于女人”,它自己学会了。
那天,整个 AI 研究界愣了一下。
因为这看起来像机器在做类比推理。不是逻辑演绎,是更接近人的那点直觉:抓住一段关系,再把它挪到新对象上。
可它真的在推理吗?
这一章就回答这个。向量表示是什么,凭什么比符号强,力气从哪来,又在哪里用完。
二、符号的问题,重说一遍
上一章讲过符号 AI 的死结:知识得一条条写出来,而世界的知识写不完。
还有一层当时没展开:符号的意思,是从外面贴上去的。
在专家系统里,"is a mammal" 只是一串 token,一个掰不开的原子。它不知道哺乳动物和动物是什么关系,不知道猫离爬行动物有多远,也不知道猫比鲸更像哺乳动物。
这些关系,全得拿规则一条条写出来。
IF  is a mammal
THEN is an animal  [R_base_1]

IF  is a mammal
AND is not a whale
THEN usually has legs  [R_mammal_legs]
每条关系一条规则。关系无穷,规则永远写不完。
根子在这儿:符号系统用离散的 token 装概念,概念之间的关系却是连续的,有远近,有层次。猫和狗都是哺乳动物,这句写得出;猫比蛇更靠近狗,这句写不出。
向量表示补上了这一块。补得不算全,但补到了要紧处。
三、分布假设:意义藏在邻居里
向量表示的根子,可以追到语言学家 J·R·弗斯 1957 年写下的一句话:
“你可以通过一个词交往的朋友来认识它。”(Firth 原话:You shall know a word by the company it keeps)
这直觉后来有了名字,叫分布假设(distributional hypothesis):一个词的意义,由它出现的上下文分布决定。
上下文相似的词,意思相近。猫和狗都常出现在“我养了一只__”“给它喂食”“它叫了”这样的句子里。所以它们是邻居。
这直觉能动手。建一张表:行是词,列是上下文,格子里记两者一起出现的次数。每一行,就是一个词的向量。意思相近的词,最后会在高维空间里挤到一起。
最早这么干的东西叫分布语义模型(DSM),1990 年代就有。它管用,可有两个毛病:维度太高,能到几十万维;向量太稀,格子大多是零。
分布语义模型(DSM):词义藏在共现矩阵里
分布语义模型是一类把词义写成向量的办法。建一张“词 × 上下文”的大表,记下谁和谁一起出现,再把每一行当成那个词的向量。
- 高维:语料里有 10 万个词,表就有 10 万列,每个词的向量也是 10 万维,长得没边
- 稀疏:大多数词对很少同框,格子大片是 0,存起来极浪费
Word2Vec(Mikolov,2013)绕开了这张表。它训练一个神经网络,把共现信息隐式地压进 100 到 300 维的稠密向量。
Mikolov 2013 年那篇走得更远。
四、Word2Vec:通过预测来压缩
Word2Vec 不建表。它训一个网络,只做一件事:给定一个词,猜它的上下文(Skip-gram),或者反过来,给定上下文,猜中心词(CBOW)。
Skip-gram 和 CBOW:Word2Vec 的两种训练模式
Word2Vec 有两个变体,差别只在预测的方向。
- Skip-gram:喂中心词,猜四周。句子“I like eating apples”里,喂 eat,猜 like 和 apples。小数据上稳,罕见词也照顾得好。
- CBOW(Continuous Bag of Words):喂四周,猜中心词。喂 like 和 apples,猜 eat。训得快,大数据合适。
两个都只是路。目的地是词向量。训练一完,预测头扔掉,嵌入矩阵留下。
听着平平无奇。宝贝在副产品里。
训练时,每个词都落成一个低维向量,通常 100 到 300 维。想猜得准,这些向量就得装下词的一点底细——不懂词和词怎么搭,就猜不出谁会跟谁一块儿出现。
训练完,预测头丢掉。剩下的嵌入矩阵,就是词向量。
怪事在这儿。
没人教过网络国王和女王的关系,一条语义规则都没给。它只被要求猜文本序列。等它学会了猜,king − man + woman ≈ queen 自己冒了出来。
为什么?自然语言里,国王出现的地方,女王也以平行的姿势出现,只是换到女性的语境。想猜准,网络就得把这条平行线编进向量。皇室是一条轴,性别是另一条,对应空间里的两个方向。减男人、加女人,就是沿性别轴推一格。
意义,从分布里长出来。
五、几何中的浅层逻辑
把这个方程看仔细一点。
king − man + woman ≈ queen;paris − france + japan ≈ tokyo;walk − walked + swim ≈ swam。过去时也被编进了方向里。
每一个类比,都是向量空间里的一次平移。从男人到女人的位移,和从国王到女王的位移,是同一个方向,沿性别轴挪一步。
干净得很。语义关系,变成了方向。
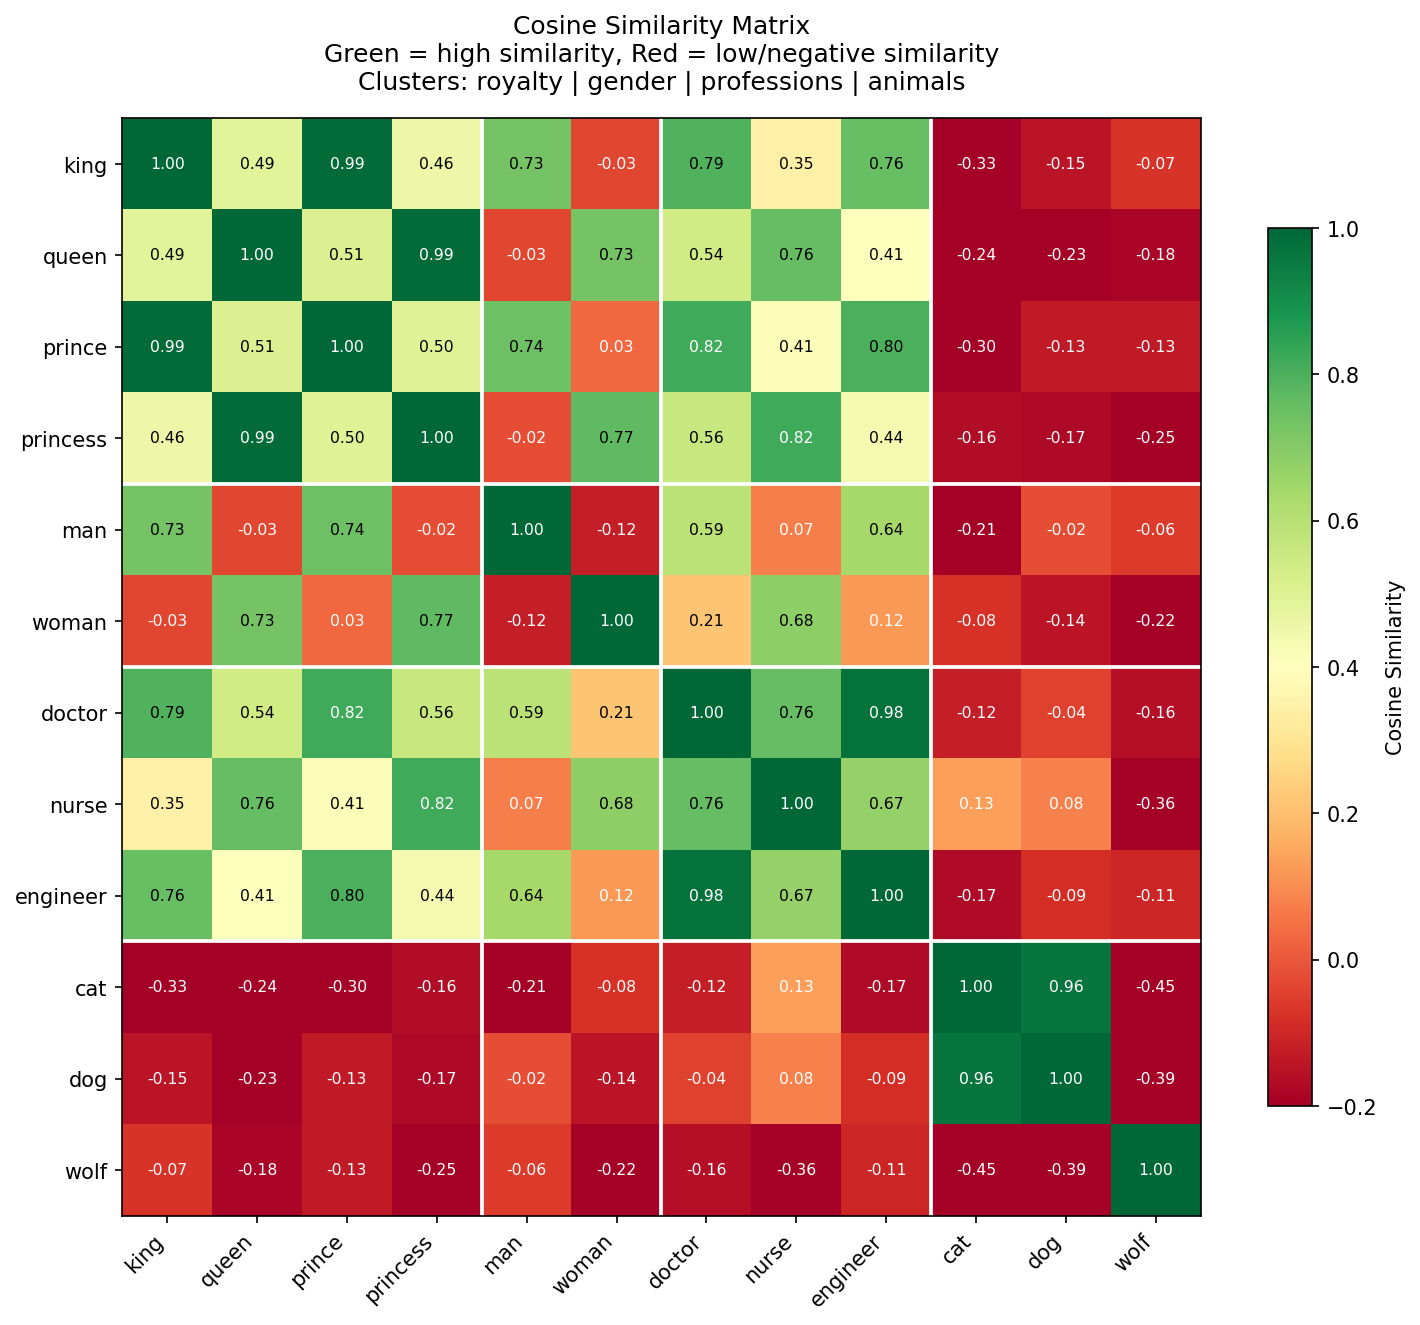
图4:12 个词两两的余弦相似度矩阵。绿色是高相似,红色是低或负。白线划出四个语义簇:皇室、性别、职业、动物。同一簇内,相似度远高于跨簇;动物簇跟另外三簇几乎不沾边。语义相近的词在向量空间里彼此相邻,这张图就是证据。
六、向量的偏见:语料即世界观
Word2Vec 学到的不是语言的真理,是语料的统计。语料是人写的。人带着偏见,历史带着偏见,文化也带着。
这不是边角料。是分布假设的账,早晚要付。
Bolukbasi 等人 2016 年的实验
他们在 Google News 上训出来的 Word2Vec 里,发现了这个:
男人之于医生,如同女人之于护士。这个类比在向量空间里成立,因为它在语料里统计上成立。
还有个更直白的:
不是女程序员,是家庭主妇。
算法没坏。它把语料学得太对了。坏的是我们:把统计规律当成了语义真相。
偏见从哪来?
意义藏在邻居里。可要是邻居本身就偏了——
- 新闻里,CEO 的邻居多是“他的决定”,不是“她的决定”
- 旧文本里,科学家更常跟男人的名字挨着
- 小说里,情感词分给两性的份额不一样
Word2Vec 照单全收。它是一面镜子,照出语料,不照世界。
这就是分布假设的边界。
向量空间学到的是描述,推理要的是规范。“X 和 Y 常一起出现”,不等于“X 和 Y 有因果”,也不等于“这么配是对的”。
去偏见有现成的办法,Bolukbasi 的论文给了一种线性投影。可那是创可贴,贴得住伤口,治不了病。根子在于:从统计相关出发,到不了语义真相。
到了 Transformer 和大语言模型时代,这条界线还在。语料更大,偏见更广。底层那套逻辑,一动没动。
七、类比的幻觉
回到那个方程。
它真的在推理吗?
拆开看。
等式要成立,国王和男人之间的差,得约等于女王和女人之间的差。
这是什么?一句话:两段的偏移方向对得上。几何上的整齐,不是逻辑上的推导。
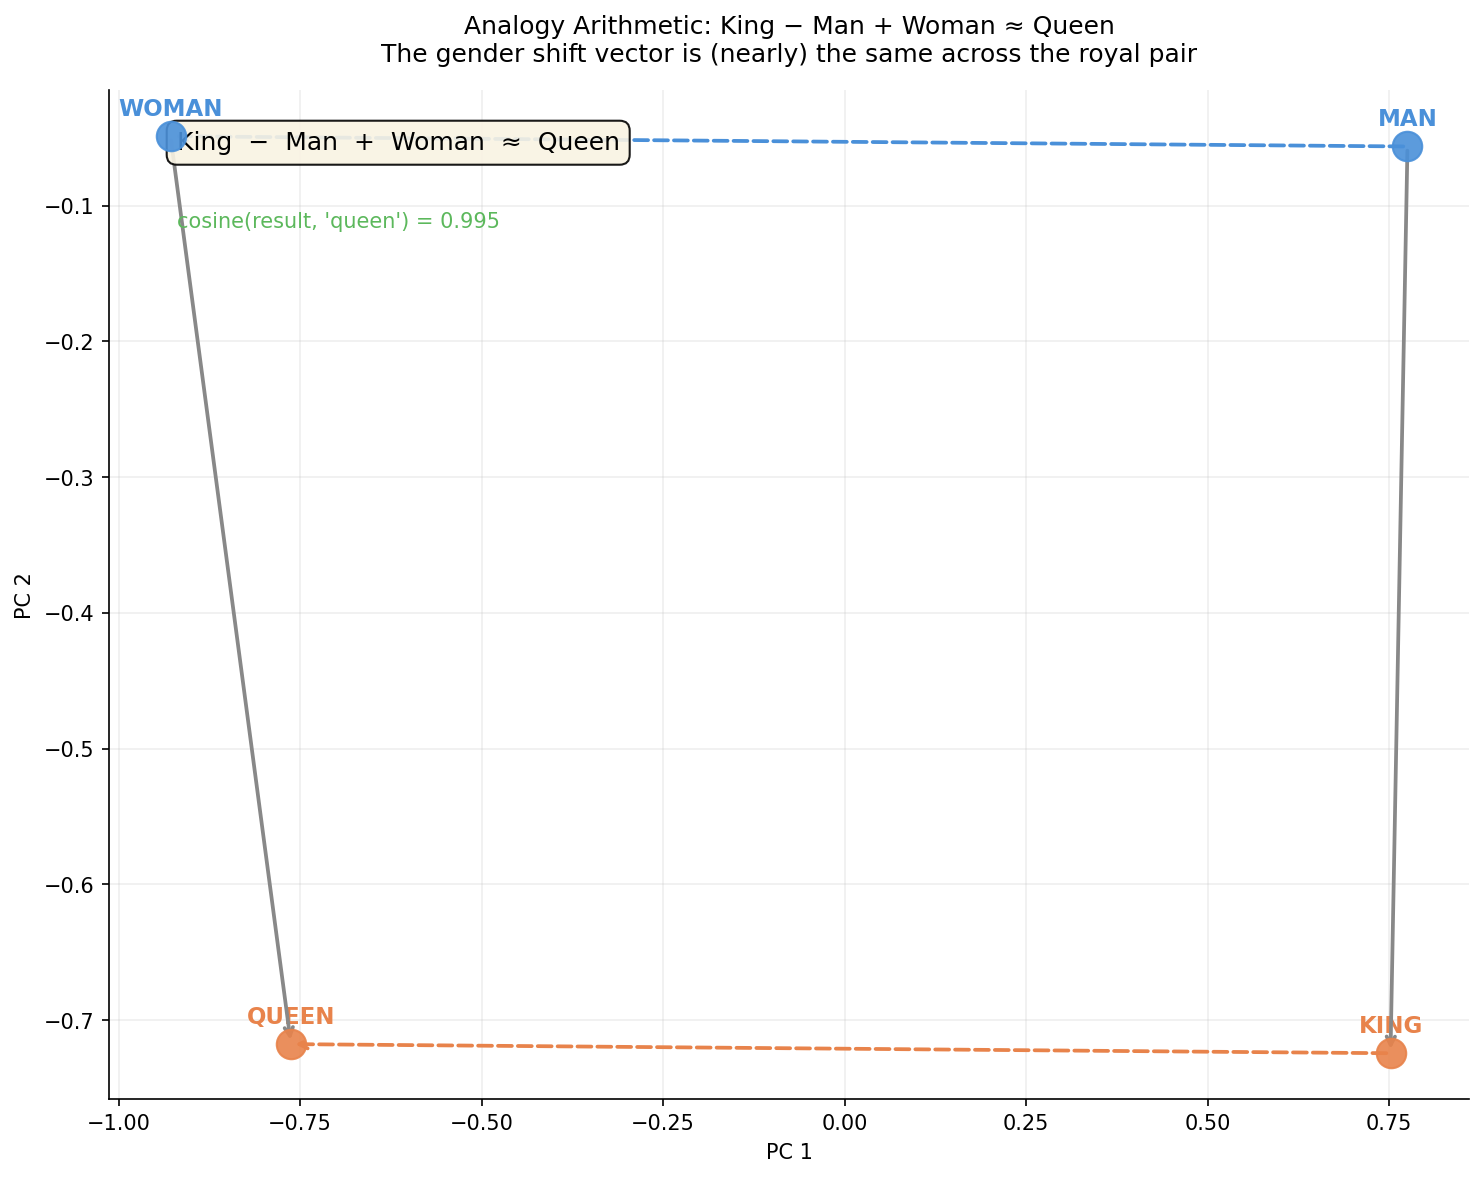
图2:向量类比的几何视图。四个词在二维 PCA 空间里摆成一个近似平行四边形——man→king 和 woman→queen 是两条几乎平行的边,man→woman 和 king→queen 是另一对。这就是“性别位移在皇室词对上保持一致”的意思。King − Man + Woman 的余弦相似度接近 0.995。
逻辑里的推理,是规则加事实,得结论。所有国王都是男人,伊丽莎白是女王,所以伊丽莎白不是国王。这里头有传递,有变量,有量词。
向量算术里,这些一样没有。它只说:这几个词在语义空间里的位置,摆成了一个平行四边形。
更要紧的是,这个等式常常不成立。
Fournier 等人(2020)把类比测试翻了个底朝天。那些著名的等式,严重依赖一个取巧的评分办法:把输入词从候选里剔掉。可最近邻往往就是输入词自己。换一种评法,报告出来的类比能力大片往下掉 -> [Fournier et al., 2020, arXiv:2010.03446]。
还有个更直接的。试试这个:
doctor - man + woman ≈ ?
在某些语料上,你拿到的不是女医生,是护士。
因为在那堆语料里,医生更常挨着男人,护士更常挨着女人。模型学到的不是职业的中立意思,是它在这份语料里的统计位置。
向量不装真理,装的是语料的统计分布。语料偏,向量就偏。这不是 bug,这是它的工作方式。
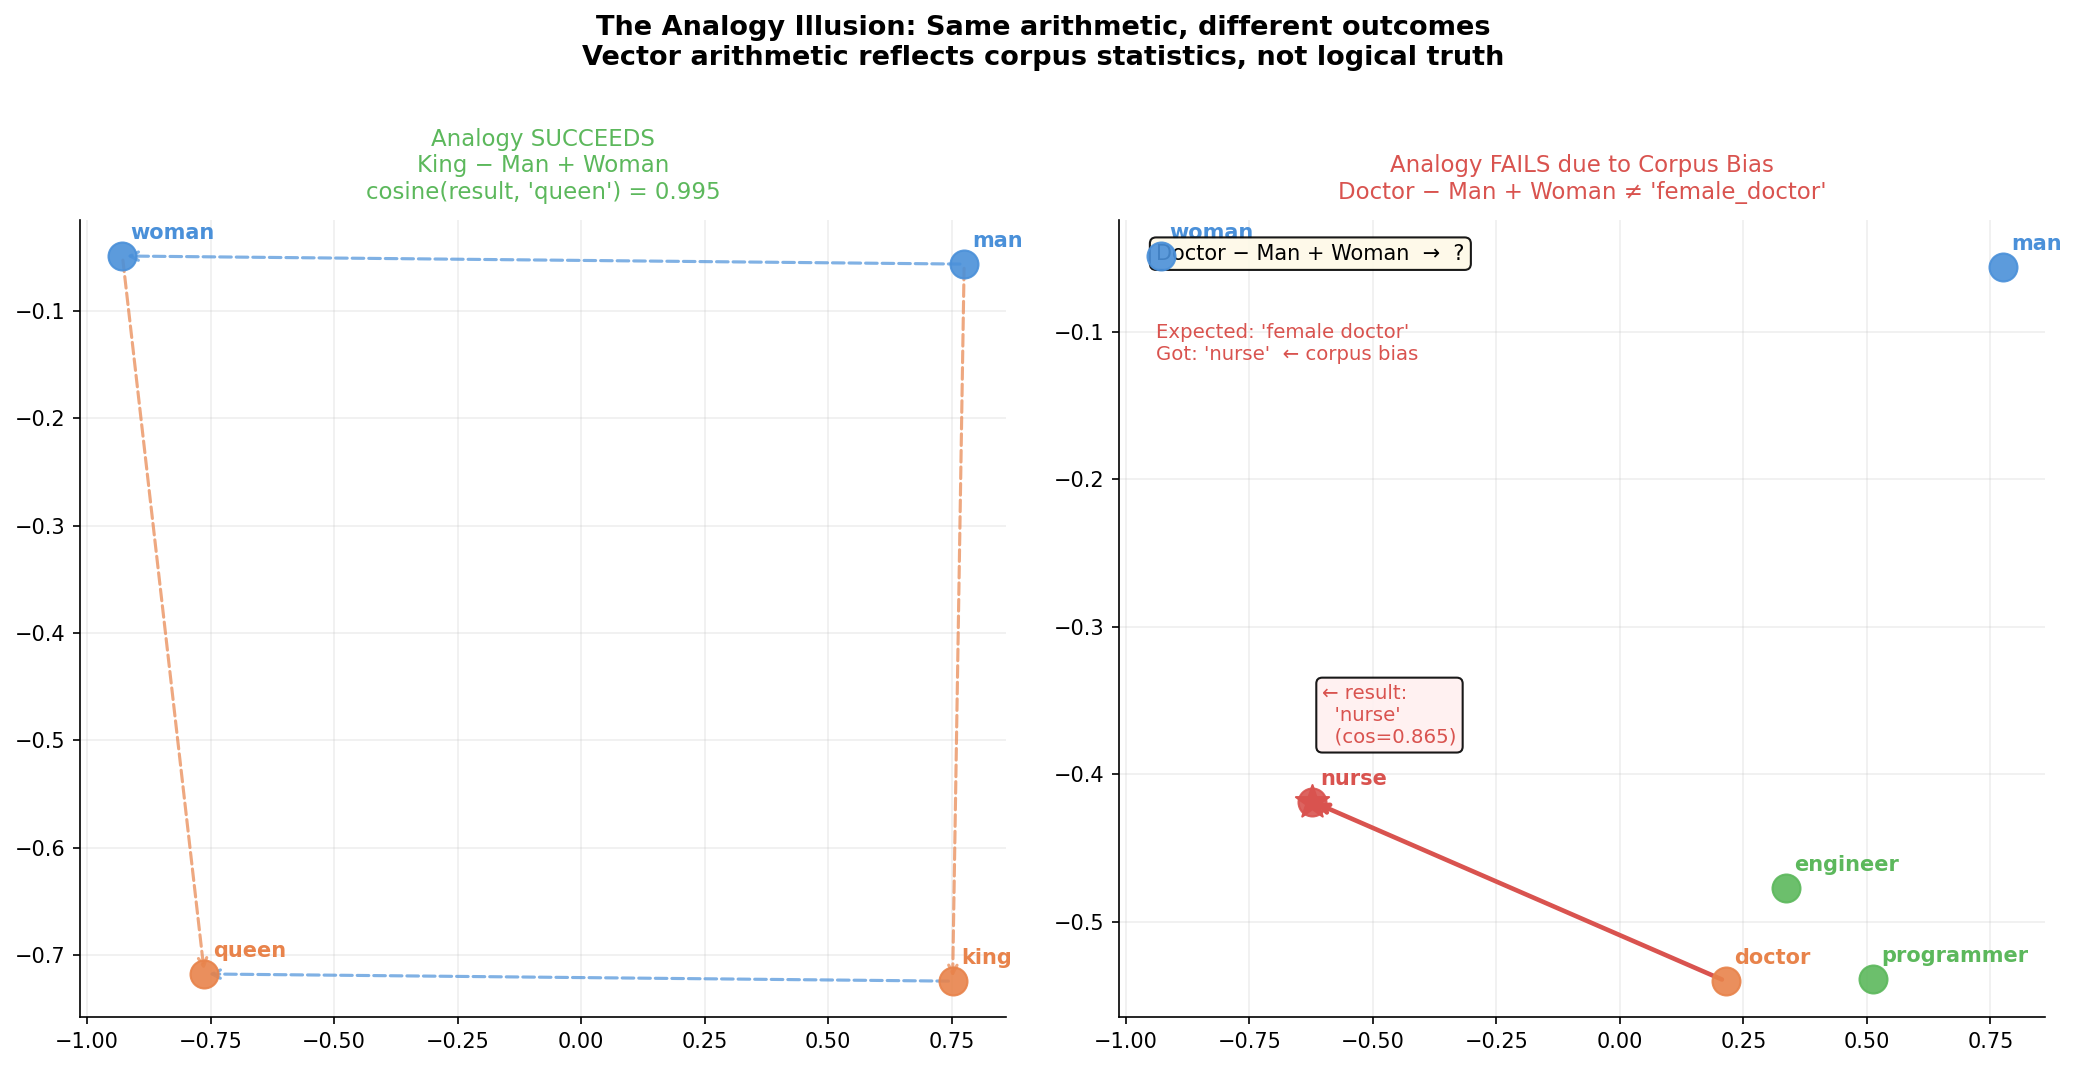
图3:左图,皇室类比成立。King − Man + Woman 的结果向量几乎贴着 Queen(余弦约 0.995),平行四边形清清楚楚。右图,职业类比塌了。Doctor − Man + Woman 不指向女医生,指向 Nurse(余弦约 0.865)。原因在语料:Doctor 偏男性语境,Nurse 偏女性语境。同一套算术,两种偏见。
八、分布假设的极限
再往里想一层。分布假设的边界在哪?
它说,意义由上下文分布决定。多数时候对。可它顺带承认了一件事:两个词要是上下文分布一模一样,模型就把它们当成同一个意思。
“I like cats”和“I like dogs”,结构完全对称,cat 和 dog 在分布上几乎分不开。这也对,它们本来就近。
但是:
“The earth orbits the sun”和“the sun orbits the earth”。
只看分布,earth 和 sun 出现在很像的上下文里,天文、引力、轨道,都是它们的邻居。可这两句话,一句真,一句假。
分布语义模型没有真值这个概念。它不知道哪句真、哪句假。它只知道哪个词跟哪个词挨着。那是统计,不是关于世界的因果模型。
所以,向量表示在许多任务上很能打,却始终没碰到推理。它解决的是表示:把概念铺得更连续、更丰富,让相近的概念在几何上靠拢。可靠近不是有逻辑关系,共现也不是因果。
维特根斯坦有句话,搁这儿正合适:语言的意义就是它的使用。分布假设抓住了这直觉的一半——一个词的意思,确实在它怎么被用里。可用是统计的。理解也是统计的吗?这问题还悬着。
九、从词向量到句子:代价不断累积
Word2Vec 给的是静态词向量:一个词一个固定向量,不管它落在哪句话里。
bank 在“I went to the bank to withdraw money”里是银行,在“wildflowers grew all over the river bank”里是河岸,拿到的向量一模一样。
ELMo(2018)和 BERT(2018)先后出现,带来了上下文化词向量:同一个词,在不同句子里变一副面孔。这是大步子,也要另付一笔账:再没有一张能离线查的干净词表,每回都得把整个网络跑一遍。
ELMo 和 BERT:什么是上下文化词向量?
静态词向量(Word2Vec)里,一个词一个向量,走到哪都不变。apple 是水果还是公司,一个样。
上下文化词向量(ELMo、BERT)里,整句话进网络,每个词的表示由它的上下文捏出来,同一个词换个句子就换一副面孔。
- ELMo(2018,Allen AI):双向 LSTM 生成上下文敏感的词向量,当特征喂给下游任务
- BERT(2018,Google):用 Transformer 编码器预训练双向语言模型,再到下游任务上微调
代价是查不了表了。每猜一次,整张网都得跑一遍,算力噌噌往上加。准确率和效率之间那杆秤,又晃了起来。
还有更深的一层:句子的意思,不是词向量的简单相加。
“Cat bites dog”和“dog bites cat”。把词向量平均,两个句子几乎重合,用的都是那三个词。可两句话说的是相反的事。
词的意思能装进向量,句子的意思却由结构决定:谁是主语,谁是宾语,动词拉着几个论元。向量算术一点没碰这些。
Transformer 就是从这个坑里长出来的——用注意力动态处理词与词的关系,不再把它们一摞了事。那是第九章。
十、一个小小的停顿
盘一下。
从符号到向量,一次真正的换轨。它解决了符号 AI 的一个核心问题:意义怎么表示。概念不再是无意义的原子,它在空间里有了位置、距离、方向。相近的靠拢,关系变成位移。
本事是真的:语义搜索、类比推理(勉强算)、语义聚类,还有迁移学习的地基。
可推理没解决。三条原因。
第一,它抓的是统计,不是因果。语料有偏,向量就偏;语料里只有相关,向量里也只有相关。相关不是因果,分布不是真相。
第二,它没有组合性。词向量一平均,句子的结构就没了。Cat bites dog 和 dog bites cat,在词袋里长得一样。这是硬伤。
第三,类比方程看着像推理,其实不是。它是几何上的平行,不是逻辑上的传递。失效的时候,比如碰上带偏见的类比,它不声不响给你一个错答案,连个警告都没有。
向量表示是推理的前提。可它自己还不是推理。
十一、还有一个更深的问题
分布假设底下还压着一个假设:语言装得下意义,而且这意义能从用词的模式里抠出来。
这假设经不起推敲。
Searle 的中文房间,1980 年,是这一路上最出名的一击。一个不懂中文的人关在屋里,手边一本厚规则书。每递进来一个中文符号,规则书告诉他递回哪个符号。从门缝外看,他像懂中文,对答如流。可那些符号什么意思,他一点不知道。他只是在照章办事。
兔狲教授说
这实验是面镜子,照出符号操作的尴尬:理解可以模仿得天衣无缝,里头却空空如也。词向量模型干的事,跟这间中文屋子有点像。它从海量文本里刮出极细的统计花纹,许多任务上表现得像懂了。可它真懂那些词的意思吗?没有轻松答案。先得说清“懂”是什么。
有个更实在的考法:分布偏移。把模型拎到训练分布外边,让它处理没见过的组合。它要是当场垮掉,你就有理由怀疑:它记住的是分布,不是语言。
这是第五章的事。先记着这个疙瘩。
向量拿得住相似,拿不住因果。下一章进高维的几何——流形假设会告诉你,数据为什么不乱长。
悬而未决
类比方程
vec(King) - vec(Man) + vec(Woman) ≈ vec(Queen)是推理的证据,还是统计的巧合?它对一些成立,对另一些塌掉。这种前后不一,说明了什么?分布假设的边界在哪?有些意义,是不是永远学不到?颜色?疼痛?身体里的感觉?
词向量带着社会偏见。这是缺陷,还是特性?把偏见从向量里抠掉,会不会连世界的某些真实结构一起抠了?
拿纯噪声文本去训 word2vec,会得到什么?这个念头本身,就够想一会儿。
动手试试:用向量算术戳破类比的幻觉
这一章提出了一个重要的主张:类比方程看起来像推理,但它只是一个几何上的平行结构。你需要亲手验证这个区别——不是读懂它,而是感受它崩溃的那一刻。
你需要一个预训练词向量模型。最简单的选择:用 Python 的 gensim 库加载 Google 公开发布的 word2vec 模型,或者使用 fasttext 的预训练向量。
第一步:验证那个著名的方程
从最经典的类比开始:
用第五节的逻辑来实现:
import numpy as np

# Assume model is a loaded gensim KeyedVectors object
# Example of loading it:
#   from gensim.models import KeyedVectors
#   model = KeyedVectors.load_word2vec_format('GoogleNews-vectors-negative300.bin', binary=True)

def analogy_query(model, positive_word, minus_word, plus_word, topn=5):
    """
    Perform a vector analogy query: vec(positive_word) - vec(minus_word) + vec(plus_word)
    model: a gensim KeyedVectors object
    Returns: a list of nearest neighbor words with their cosine similarity scores
    """
    # Compute the target vector: vec("king") - vec("man") + vec("woman")
    target_vector = (model[positive_word]
                     - model[minus_word]
                     + model[plus_word])

    # Find the words in the vocabulary with the highest cosine similarity to the target vector
    # gensim's similar_by_vector can automatically exclude the input words (via the negative parameter)
    results = model.similar_by_vector(
        target_vector,
        topn=topn + 3  # fetch a few extra, so the input words can be filtered out manually
    )

    # Exclude positive_word, minus_word, plus_word themselves
    exclude = {positive_word.lower(), minus_word.lower(), plus_word.lower()}
    filtered = [(word, score) for word, score in results
                if word.lower() not in exclude][:topn]

    return filtered


# ── Run the classic analogy: king - man + woman ≈ ? ───────────────────────
results = analogy_query(model, "king", "man", "woman")

print("Analogy query: king - man + woman ≈ ?")
print("-" * 35)
for rank, (word, score) in enumerate(results, 1):
    print(f"  Rank {rank}: {word:15s}  cosine similarity = {score:.4f}")
你应该会得到“queen”,余弦相似度接近 0.7 到 0.9。
你的第一个问题: 这个结果让你意外吗?在继续之前,先写下你的直觉:这看起来“像推理”还是“像算术”?在你回答之前,不要往下读。
第二步:系统性地测试,然后寻找反例
从下面四类中每类挑 3 对,依次测试:
类别 1:性别——把 man -> woman 的类比应用到:king、doctor、professor、nurse、engineer……
类别 2:首都——france -> paris,应用到:china、japan、germany、usa……
类别 3:时态——go -> went 的类比,应用到:run、swim、eat、think……
类别 4:反义词——good -> bad 的类比,应用到:big、hot、fast、happy……
对每个测试案例,记录:- 你预期是什么 - 实际返回的前 5 个最近邻 - 余弦相似度分数
你的第二个问题: 哪一类成功率最高?哪一类最低?你能猜到原因吗——是训练语料的问题,还是这类关系本来就不适合被编码为线性位移?
第三步:亲手复现职业偏见实验
测试第七节描述的那个失败案例:
doctor - man + woman ≈ ?
然后扩展测试:- engineer - man + woman ≈ ? - nurse - woman + man ≈ ? - CEO - man + woman ≈ ? - janitor - woman + man ≈ ?
记录每一个结果。
你的第三个问题: 对于那些输出明显有偏的词对,你的解释是什么?这些偏见是词向量系统的 bug,还是训练语料真实统计结构的如实反映?如果是后者,那么“去偏见”到底意味着什么?
第四步:找到类比方程的几何条件
做一个更精确的测试:类比方程什么时候精确成立,什么时候严重失效?
搭一个这样的实验:
对于一组你自己选择的类比对,计算两个量:
import numpy as np

def cosine_similarity(v1, v2):
    """Compute the cosine similarity between two vectors."""
    return np.dot(v1, v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))

def analogy_precision(model, analogies):
    """
    Measure analogy precision in bulk.
    analogies: a list of (A, B, C, D) tuples, each encoding an analogy of the form A:B :: C:D.
    Returns: detailed measurements for each analogy.
    """
    results = []

    for (A, B, C, D) in analogies:
        # Compute the predicted vector: vec(B) - vec(A) + vec(C)
        predicted_vector = model[B] - model[A] + model[C]

        # Get the whole vocabulary ranked by similarity (input words excluded after filtering)
        exclude = {A.lower(), B.lower(), C.lower()}
        neighbors = model.similar_by_vector(predicted_vector, topn=len(model.key_to_index))
        # Filter out the input words to get a ranked word list
        filtered_neighbors = [(word, score) for word, score in neighbors
                               if word.lower() not in exclude]

        # Actual nearest neighbor rank: the position of D in the similarity ranking
        rank_of_D = None
        for idx, (word, score) in enumerate(filtered_neighbors, 1):
            if word.lower() == D.lower():
                rank_of_D = idx
                break

        # Compute offset consistency: the cosine similarity of vec(B) - vec(A) and vec(D) - vec(C)
        # This directly measures whether the two pairs have the same "relationship direction"
        offset_AB = model[B] - model[A]
        offset_CD = model[D] - model[C]
        offset_consistency = cosine_similarity(offset_AB, offset_CD)

        results.append({
            "analogy": f"{A}:{B} :: {C}:{D}",
            "top1_hit": rank_of_D == 1,           # whether D ranks first (exact hit)
            "top5_hit": rank_of_D is not None and rank_of_D <= 5,  # whether D appears in the top 5
            "rank_of_D": rank_of_D,
            "offset_consistency": offset_consistency,  # offset consistency (a geometric measure)
        })

    return results


# ── Example test suite ────────────────────────────────────────────────────
test_analogies = [
    ("man",    "king",    "woman",  "queen"),    # gender x royalty
    ("france", "paris",   "japan",  "tokyo"),    # country x capital
    ("go",     "went",    "run",    "ran"),      # verb tense
    ("good",   "bad",     "big",    "small"),    # antonyms
    ("man",    "doctor",  "woman",  "nurse"),    # occupational bias case
]

precision_results = analogy_precision(model, test_analogies)

print(f"{'Analogy':30s} {'Top-1 hit':^8s} {'Top-5 hit':^8s} {'Rank':^6s} {'Offset consistency':^10s}")
print("-" * 70)
for r in precision_results:
    print(f"{r['analogy']:30s} "
          f"{'✓' if r['top1_hit'] else '✗':^8s} "
          f"{'✓' if r['top5_hit'] else '✗':^8s} "
          f"{str(r['rank_of_D']):^6s} "
          f"{r['offset_consistency']:^10.4f}")
你的第四个问题(核心问题): 当一个类比失败时,“偏移一致性”分数是高还是低?也就是说,几何结构(相同的位移方向)是否仍然成立,而最近邻检索却失败了?如果是这样,失败到底在几何上,还是在检索方法上?这说明了第七节的哪个论断?
第五步:构造一个让余弦相似度撒谎的例子
余弦相似度衡量的是方向,不是长度。找两个词,它们的余弦相似度很高,你却觉得它们在语义上相距很远——或者反过来:余弦相似度很低,但你觉得它们应该在语义上很接近。
def find_counterintuitive_similarities(model, word, topn=20, low_threshold=0.3):
    """
    For a given word W:
    1. Find the topn words with the highest cosine similarity, and look for any that feel out of place
    2. Find words with cosine similarity below low_threshold, and check whether any are semantically related yet geometrically distant
    model: a gensim KeyedVectors object
    """
    print(f"=== Cosine similarity analysis for word '{word}' ===\n")

    # Find the topn words with the highest cosine similarity
    top_neighbors = model.most_similar(word, topn=topn)
    print(f"Top {topn} words by cosine similarity (look for any that feel out of place):")
    for w, score in top_neighbors:
        print(f"  {w:20s}  similarity = {score:.4f}")

    print()

    # Check whether any low-similarity words still seem semantically related to you
    # Method: compute the similarity directly for a set of candidate words
    candidate_words = ["science", "art", "mathematics", "philosophy",
                       "literature", "music", "history", "biology"]
    print(f"Cosine similarity of candidate words (below {low_threshold} but semantically related?):")
    for candidate in candidate_words:
        if candidate in model:
            sim = model.similarity(word, candidate)
            flag = "  <- semantically related but distant?" if sim < low_threshold else ""
            print(f"  {candidate:20s}  similarity = {sim:.4f}{flag}")


# ── Example run ───────────────────────────────────────────────────────────
find_counterintuitive_similarities(model, word="physics", topn=20, low_threshold=0.3)
你的第五个问题: 余弦相似度没有捕获哪一类语义关系?这和第八节“分布假设的极限”有什么联系?
检验标准
完成这个练习后,你应该有三样东西:
一张表:你测试过的每一个类比、成功/失败,以及你的解释
一个偏见案例:你亲手复现的、让你不舒服的结果,以及你对它的立场
一个反直觉的余弦相似度案例:向量几何与语言直觉之间真实存在的裂缝
第三样最重要。那条裂缝,就是向量表示与真正推理之间的距离。
延伸阅读
Mikolov et al. (2013). Efficient Estimation of Word Representations in Vector Space — word2vec 原始论文:CBOW 与 Skip-gram 架构,
-> [arXiv:1301.3781]Mikolov et al. (2013). Distributed Representations of Words and Phrases and their Compositionality — 负采样、短语向量与组合性,
-> [arXiv:1310.4546]Fournier, Dupoux & Dunbar (2020). Analogies minus analogy test — 对类比测试的批判性分析,表明标准评估有缺陷,
-> [arXiv:2010.03446]Firth, J.R. (1957). A synopsis of linguistic theory 1930-55 — 分布假设的哲学起点:“你可以通过一个词交往的朋友来认识它”
Searle, J. (1980). Minds, Brains, and Programs — 中文房间思想实验,对符号操作能否产生理解的哲学攻击
Bolukbasi et al. (2016). Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings — 词嵌入偏见问题的经典实证研究