第9章:Transformer——动态拓扑的注意力革命
每一个 Attention Head 都在问同一个问题:此刻,哪些部分对哪些部分重要?
一、2017年6月的一篇论文
2017 年 6 月 12 日,Google Brain 的 Ashish Vaswani 带着八位作者,在 arXiv 挂出一篇论文:“Attention Is All You Need”。
标题很狂。那会儿机器翻译的主流还是 RNN(循环神经网络)和 LSTM(长短期记忆网络),这套东西统治 NLP(自然语言处理)二十多年。论文说:都不要,注意力够。
狂的在后面。他们是对的。
五个月后,NIPS 2017 收了它。再过两年,BERT 和 GPT-2 出场,都建在 Transformer 上。又过三年,GPT-3 把参数堆到 1750 亿。
今天的大语言模型,从 ChatGPT 到 Claude,基本都是它的变体。
回到 2017 年 6 月。那会儿摆在桌上的问题只有一个:循环结构,能不能整根拔掉?
1.1 顺序依赖的代价
RNN 的干法很直白:从左往右,一个词一个词吃。每吃一个,就把当前词和之前攒下的“记忆”揉一揉,更新一次隐状态。
看着像人读书。人也是一个词一个词读的。可这套办法有两个硬伤。
RNN 和 LSTM:什么是循环神经网络?
RNN(循环神经网络):按时间步吃序列的网络。每一步收下当前输入
打个比方:每读一个词,你脑子里那幅关于句子的图就改一版,再读下一个词。RNN 模仿的就是这个动作。
LSTM(长短期记忆网络):RNN 的加强版。它加了“门”——遗忘门、输入门、输出门——决定哪些留、哪些扔,用来拖住长距离的信息。
梯度消失:训练时,误差信号从输出层往回传。路一长——比如一个长句子——梯度每过一站就乘一个小于 1 的数,越乘越小,最后贴到零。离输出远的那些权重,等于什么也没学到。LSTM 的门能缓解,治不了根。
缺陷 1:无法并行化
要算第 10 个词,得先有第 9 个;要第 9 个,得先有第 8 个。一环扣一环,拆不开。
这在 GPU 时代很难受。一块 GPU 有几千个核,本来可以几千件事一起干。RNN 偏要排成一队,一次一个词。
长度 N,就要 N 个串行步骤。一步 1 毫秒,1000 个词也要 1 秒。
缺陷 2:长依赖中的信息衰减
看这句英文:
"The cat, which we found in the garden last summer, was very friendly."
主语“cat”和动词“was”隔着 12 个词。RNN 得把“cat”的信息一路搬 12 步。
每搬一步,掉一点。LSTM 的门能兜住一部分,兜不住全部。还是梯度消失,换了一副面孔。
1994 年,Bengio 和同事就证过:RNN 学长程依赖,梯度会指数衰减。LSTM 缓解了,没根治。
1.2 Vaswani 的赌注
Vaswani 他们的赌法是:让每个词直接看见其他每一个词,信息根本不用挤过隐状态。
这就是自注意力。每个位置跟所有位置算一遍相关性,再按相关性把对方的信息加权拢过来。
没有循环,也没有先后。所有位置一起算。
价钱写在账单上:复杂度从
自注意力:每个词都问其他每个词“你重要吗?”
一句话概括自注意力:处理一句话时,每个词都去问其他所有词“你对我有多重要”,然后照答案把信息加权收拢。
拿“The bank failed”看。轮到“failed”时,它去问“the”“bank”和每一个别的词,发现“bank”最要紧,就多听“bank”的。
为什么值得? 因为
长度 N,自注意力得铺一张
这是一笔押注:拿
他们押中了。
停顿一下
“押中了”之后还有一句没答:为什么中?
是自注意力的结构更贴近语言的真实结构?还是
换成大白话:Transformer 能成,是因为它的归纳偏置对,还是因为它的归纳偏置弱到近乎没有,弱到蛮力数据能把它填满?(归纳偏置是一个架构对“数据长什么样”的内置假设。)
“没有归纳偏置”本身也是一种归纳偏置。Transformer 假设任意位置的词都可能对任意别的词重要。这个假设对语言成立吗?对每个任务都成立吗?
先搁着。
二、自注意力的数学:一个优雅的对称性
Transformer 的心脏是自注意力。它只干一件事:
给一个序列,每个位置怎么看见所有其他位置,又怎么决定谁重要?
写法很省。输入序列
三个矩阵各管一头:
Query:“我在找什么?”——这个位置想找的模式
Key:“我这儿有什么?”——每个位置挂出来的索引
Value:“我的内容是什么?”——每个位置真正揣着的信息
然后:
拆开看。四步。
步骤 1:相似度——
每个 query 跟每个 key 点一下。第
点积凭什么当相似度?因为
步骤 2:缩放——除以
这一步是技术上的要紧处。
按这里的初始化假设,
步骤 3:归一化——softmax(把一行分数变成和为 1 的概率分布)逐行归一化
分数成了概率。第
步骤 4:加权求和——乘以
拿注意力权重把 value 加权拢一遍。位置
这叫软寻址。不挑一个位置,而是对所有位置取加权平均,权重由相似度定。
这个机制好在哪:
全局视野:每个位置直接看见所有其他位置,不用穿过隐状态
完全并行:所有位置的输出同时算,没有先后
动态拓扑:注意力矩阵当场按输入内容生成,不是一组事先钉死的权重
三、动手试试:看注意力在看什么
拿出一张纸,亲手算一个简单的例子。
输入句子:“cat sat mat”(3 个词,保持简单)
假设每个词已经嵌入为二维向量:
cat: [1, 0]
sat: [0, 1]
mat: [1, 1]
步骤 1:计算 Q、K、V
简单起见,令
步骤 2:计算注意力分数
除以
步骤 3:应用 softmax(逐行)
对第一行
完整的注意力矩阵(近似):
逐行阅读:
第 1 行:“cat”对自己(0.42)和对“mat”(0.42)的关注大致相同,对“sat”较少(0.16)
第 3 行:“mat”关注每一个词,但最关注自己(0.46)
步骤 4:加权求和
第一个词的输出:
这个向量混合了“cat”和“mat”的信息,因为这两个注意力权重高。
关键观察:注意力矩阵
兔狲教授的独白:隐藏空间的动态拓扑
教科书有个毛病。
它们说,注意力建模的是 token 与 token 之间的显式关系。它们说,自注意力让每个 token 直接看见其他所有 token。
不对。
这个误会不小。它混进了顶会的论文,让整行人顺着错直觉走了好几年。
空间的混淆:隐藏空间 vs. token 空间
人们总以为注意力在“token 空间”里动。可“token 空间”是什么?一张嵌入查找表。那儿只存词形,是死的,躺在词表一层。
真正的动作在隐藏空间里。
序列
位置编码、层归一化,不是摆设。它们把死的嵌入变成跟着上下文走的隐藏表示。
然后注意力才上台:
注意:
注意力真正在做什么:隐藏空间中的表征检索
那注意力在比什么?
它不比“token A”和“token B”。它比“位置 A 的隐藏表示”和“位置 B 的隐藏表示”。
说白了:
嵌入空间:词形 -> 静态向量
隐藏空间:上下文理解 -> 动态向量
注意力在隐藏空间里做表征检索。
相似度
RNN 的硬瓶颈 vs. Transformer 的动态拓扑
这个差别,把两种架构的底子摊开了。
RNN:显式记忆递归的硬瓶颈
是一个固定维度的隐藏向量 历史全得塞进那个低维空间
这是硬瓶颈——信息被迫挤进更小的维度,像把一本书压成一页摘要
梯度消失、梯度爆炸,是这条一维链子躲不掉的账
低熵结构:连接模式钉死,信息容量恒定
Transformer:隐藏空间中的动态拓扑
每个隐藏表示
都过一遍 QKV 投影,变成 注意力权重
当场算,连成一张动态连接图 没有固定维度的瓶颈——信息容量跟着序列长度长
高熵结构:连接权重现场生成,表达自由度大
熵与表征自由度
换成稍定量的话:
RNN 的表征自由度:
,跟序列长度无关 注意力的表征自由度:
,跟着序列长度线性长
可注意力不止是“多存了点”。它的高熵来自动态选择性。
每来一个输入,它当场搭一张最贴这个语境的拓扑。能在隐藏空间里按需接线,这才是智能冒头的地方。
GPT 的金字塔结构
这也解释了剪掉 GPT 几层,它为什么还能干活。
Transformer 不是一块平铺的板,是一座金字塔:
浅层隐藏空间:管表层语法和局部依赖
中层隐藏空间:管短语结构和中距离依赖
深层隐藏空间:管语义角色、逻辑关系和长程依赖
每层在隐藏空间里做一轮“表征精炼”。削掉顶层,最抽象的理解没了,地基还在。
动态拓扑究竟意味着什么
那“动态拓扑”到底是什么,说清楚:
注意力是一张建在隐藏空间里的动态连接图,按当前上下文实时搭起来。连不连,不由 token 决定,由那些 token 在这个语境下的隐藏表示决定。
同一个词,“bank”:
在河岸的语境里,它的隐藏表示装着“河流、岸边、自然”
在金融的语境里,装着“金融、货币、商业”
所以它跟别的词的注意力模式,完全两样。
这就是动态拓扑——连接看上下文,看内容,边用边变。
不是“所有 token 平等地看见所有其他 token”。是“在当前隐藏表示下,哪些位置的理解跟这个位置最对得上”。
图论视角的澄清:看见 ≠ 抵达
还有一个更深的误会,教科书里最常见。
那些书爱用“两个小孩交朋友”讲注意力:每个孩子都看得见所有孩子,再决定跟谁牵手。画面生动,漏了最要紧的一环。
看见,不等于抵达,更不等于把话带到。
用图论说:一层 Transformer 是一张完全图,每个节点都有一条边指向其余所有节点。这条边就是注意力:我看得见你的隐藏表示,我能从你那儿取东西。
但这条边的带宽有限。一次注意力,只是一次浅层的信息整合。想跟远处一个节点深谈——把它的语义揉进你的语法,再跟第三个节点的语用掺一掺——得多走几步。
在 Transformer 里,一步就是一层。
所以:
一层 Transformer:每个位置都看得见所有位置,但只能浅着整合一次
两层 Transformer:信息走两步——A 从 B 取、揉进来,再从 C 取
L 层 Transformer:信息能在图里走 L 步,做出多跳的深谈
深度要紧,就紧在这儿。
同样是
浅网络:路短,只做得了局部或浅层的模式匹配
深网络:信息在隐藏空间里走得更远,跨几层抽象整合
信息能走多远,约等于网络有多深。
图论就摆在那儿:图
比如:
第 1 层:学词性标签,名词、动词
第 2 层:学短语结构,名词短语、动词短语
第 3 层:学句法角色,主语、宾语
第 4 层:学语义关系,施事、受事
第 5 层:学语用意图,陈述、疑问、命令
每一层都踩在前一层上,做更深一层的交流。深度不够,信息就旅不到那么抽象的层级。
所以,听到“Transformer 让每个 token 看见每个 token”时,记着一句:
它说的是一层的事
真正的理解,靠多层摞出来的深度传播
GPT-3 有 96 层,不是 1 层,原因就在这儿
看见不要钱。抵达要拿层数来换。
回到那个经典问题
悬着的那个问题,现在能答了:
Transformer 能成,是因为归纳偏置对?
答:一部分是。
它的偏置不是“所有 token 之间都可能相关”,是更深的一层:
“在正确的隐藏空间里,上下文相关的表征可以靠动态拓扑被挑着整合。”
这比 RNN 的“序列是一条马尔可夫链”更贴语言的真实结构,又不至于弱到没有偏置。
它躺在两个极端中间:灵活到接得住语言的复杂,又偏到学得动。
“好,回去讲多头注意力。”
兔狲教授的第二次独白:S×S 矩阵——隐藏空间里的搜索引擎
接着往下说。上一节讲注意力不在 token 空间、在隐藏空间。可隐藏空间里那个矩阵——
它不是
作为搜索引擎的自注意力
信息检索系统就三样东西:query,问“我在找什么”;index,说“我这篇有什么”;content,是真货。过程是:拿 query 对 index -> 排序 -> 抽最相关那几篇的 content。
自注意力的三个投影矩阵,干的是同一件事:
:把隐藏状态投成 query——“这个语境下,我缺什么?” :把隐藏状态投成 key——“这个语境下,我这儿挂什么标签?” :把隐藏状态投成 content——“我实际揣着的信息是什么?”
每一层 Transformer,都在隐状态空间里走一步检索。当前隐状态
与显式搜索的比较
| A* | MCTS | Transformer | |
|---|---|---|---|
| 搜索空间 | 离散图 | 离散树 | 连续流形 |
| 搜索算子 | UCB + 模拟 | ||
| 信息整合 | 沿路径累积 | 沿树回传 | 加权平均(软) |
| 拓扑 | 固定 | 固定 | 动态重塑(每层不同) |
| 保证 | 最优性( | 对数收敛 | 无理论保证 |
Transformer 的搜索跟 A*、MCTS 是一副骨架:在一个空间里找相关信息,每步做一次“往哪走”的决定,算力有限。区别在于,它用连续空间里的软加权平均,替掉了离散空间里的硬选择。好处是可微分、可并行,整条链还能端到端训;坏处是没有理论保证,容易被噪声稀释,还顶着永霖极限。
softmax 温度与 ADS 势垒:空间与时间中的熵控制
这里有一根很深的线。
自注意力的
ADS 的势垒
两套机制都在拿熵调搜索的“尖度”:
| 维度 | 机制 | 受控量 | 效应 |
|---|---|---|---|
| 空间( | softmax 温度 | 注意力分布的熵 | 低 |
| 时间(搜索步长) | ADS 势垒 | 信念分布的熵 | 低熵 -> 大步,高熵 -> 刹车 |
摆在一起,它们在一个搜索系统里各管一头:空间里管“看多宽”,时间里管“走多快”。Transformer 的
多层 S×S 与永霖极限
每一层都有自己的
把 CoT 看成摞在 S×S 搜索上的外循环:每吐一个 token,隐状态先走
S×S 矩阵给 Transformer 一副在隐状态空间里搜索的本事。本事有边界:搜索只能发生在训练好的权重圈定的那些子空间里,而那些权重的底子,就是
本书中搜索的统一谱系
| 形态 | 空间 | 算子 | 拓扑 | 保证 | 章节 |
|---|---|---|---|---|---|
| 显式离散搜索 | 离散图 | 固定 | 最优性(可采纳) | 第 8 章 | |
| 显式随机搜索 | 离散树 | UCB + 模拟 | 固定 | 对数收敛 | 第 10 章 |
| 拓扑重塑搜索 | 动态流形 | 动态 | 局部可采纳 | 第 8、10、12 章 | |
| 隐式连续搜索 | 隐状态流形 | 动态(每层) | 无 | 第 9 章 |
四种形态不是各过各的,它们连成一条谱:从离散到连续,从固定拓扑到动态拓扑,从选择函数到几何算子。问的是同一件事:在不确定里找到通向目标的那条路。Transformer 的 S×S 矩阵坐在连续那一头——它不只在一个连续空间里搜,它一边搜一边重画那个空间本身。
四、多头注意力:分工与协作
一个注意力头,只抓得住一种关系。可语言里的关系不止一种:
句法关系:主谓、修饰语-中心词
语义关系:代词-先行词、同义词
位置关系:相邻词、长距离依赖
多头注意力的办法是:并排开几个头,各学各的关系模式。
其中每个头是:
直觉:把
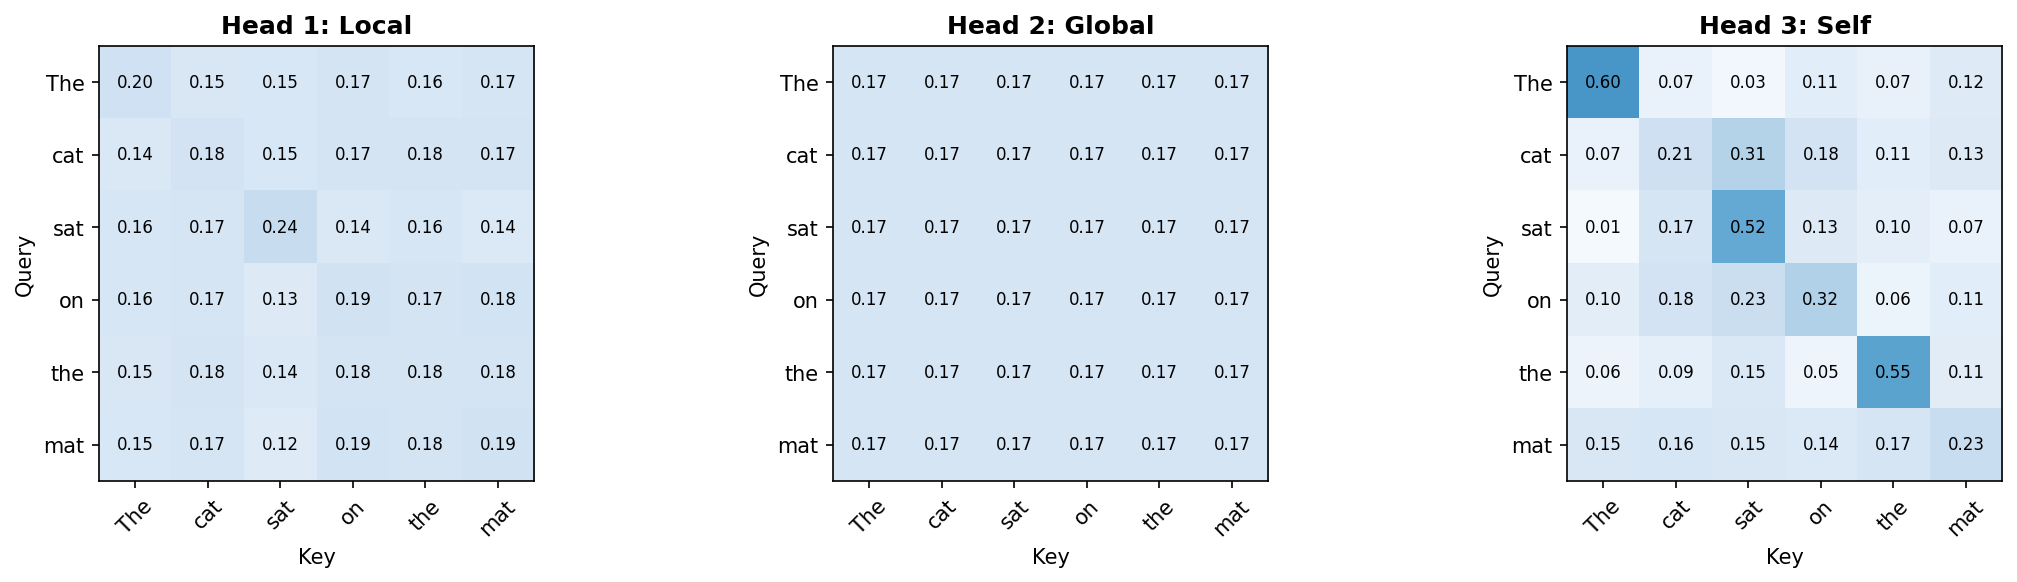
实验里看到的(BERT 的可视化研究):
Head 1:盯相邻词,管局部句法
Head 2:盯代词和它的先行词,管指代
Head 3:盯句子的头和尾,管全局结构
Head 4:盯标点,管句法边界
没人教它们分工。头自己长出了不同的语言学活儿。
五、O(N²) 的代价:为全局视野付出的热力学账单
自注意力算一遍,时间
省不掉。这就是架构的底价。
5.1 为什么是 N²?
算
存注意力矩阵,要
跟别的架构搁一块看:
RNN:
——长度上是线性的,可只能串着来 CNN:
——长度上线性,但视野被卷积核大小 卡住 Transformer:
——全局视野,平方的账
5.2 信息论视角:全连接的熵成本
从信息论看,
RNN 是链式拓扑:每个节点只接前一个。信息从一头流到另一头,单向。连接模式是固定的,不用存。这是低熵结构。
Transformer 是全连接拓扑:每个节点接其他所有节点。这是高熵结构——连接权重是活的,注意力矩阵得存。
香农那套信息论把话说死了:描述一张
实现上偷不了懒。这是信息论下界。
5.3 物理学视角:Landauer 原理的约束
Landauer 原理:擦 1 比特,最少要
每跑一次前向,Transformer 就算一遍、存一遍
也就是说,处理长度
GPT-3 训练吃掉约 1287 MWh 电。其中一大块,花在算和存注意力矩阵上。
5.4 这个代价值得吗?
序列短于 2048,值。机器翻译、文本生成、问答,Transformer 全面压过 RNN。
序列一长——整篇文档翻译、长文摘要、基因组——
于是冒出一大串“高效 Transformer”:
Sparse Attention:只算一部分注意力,比如局部窗口加全局 token
Linear Attention:拿核技巧把复杂度压到
Reformer:用局部敏感哈希近似注意力
Longformer:局部窗口和全局注意力掺着用
都有代价。要么丢全局视野,要么引入近似误差。
全局视野和线性复杂度,只能挑一个。工程上没辙。信息论和热力学把门关上了。
六、线性注意力:用结合律换掉 softmax
那不要 softmax 呢?
6.1 核函数视角
标准注意力长这样:
softmax 里的
核函数有一种通用近似:特征映射。只要找得到一个函数
注意力就能改写成:
关键一步:用加法与矩阵乘法的结合律,换个括号顺序
现在,
所有
总复杂度
6.2 线性注意力的致命缺陷:圆滑性
听着很完满。可上手一比,线性注意力一直打不过标准注意力,尤其在需要尖、需要准的时候——指代消解、关键词匹配。
原因在 softmax。它天生就尖;线性核尖不起来。
softmax 的指数把大的分放得更大,小的压得更小。结果是一头拿走 0.95 的权重,其余只剩 0.05。
线性核
看着“公平”。问题恰恰在公平。
打个比方。你在吵翻天的派对上听一个人说话,那是信号。softmax 让你把 95% 的注意力压在那个人身上,5% 留给满屋子的噪声。线性注意力把注意力平分给所有人。你还能听见那个人,可噪声也一起放大了,信号淹了。
线性注意力太圆滑。它把噪声和信号一视同仁地加,尖的地方磨平了。
说正式点:线性注意力是对 Key-Value 外积矩阵
所以它的底子是一块容量有限的循环状态,不是真正的全局视野。
七、状态空间模型:从线性注意力到选择性记忆
线性注意力这一路看下来,问题更清楚了:全局视野和线性复杂度,能不能同时拿?
能,除非再多一维:选择性。
状态空间模型(SSM)和 Mamba,就长在这个想法上。
7.1 从线性注意力中看到 SSM 的影子
线性注意力的递推,反复是这么个形状:
其中
这个递推跟经典线性状态空间模型(Linear SSM)一个模子:
线性注意力的
SSM 的改法:让
7.2 HiPPO:用正交多项式压缩历史
2020 年,Albert Gu 和同事提出 HiPPO(High-order Polynomial Projection Operator),给
直觉:HiPPO-
线性注意力的覆写问题,到这儿有了着落:旧信息不再被一视同仁地累加,而是按重要性压成一份低维的“历史摘要”。
7.3 Mamba:选择性状态空间模型
2023 年,Albert Gu 和 Tri Dao 提出 Mamba。要紧的一步是选择性机制(Selective SSM,S6)。
标准 SSM 里,
Mamba 让
离散化后的状态转移:
选择性的要点:
大: ,状态猛掉——模型主动忘掉旧信息,盯住眼前 小: ,状态几乎不动——模型主动记住旧信息,不理眼前
不是一条钉死的遗忘曲线。是内容驱动的选择性记忆。token 要紧,衰减就放慢,让它在状态里多待;token 是噪声,就让它快点走。
7.4 选择性为什么能解决线性注意力的问题
回到圆滑那个毛病:线性注意力把所有信息一视同仁地堆进状态,信号就被噪声稀释了。
Mamba 用会变的
撞上重要信息 ->
大 -> 状态大改,旧噪声被冲掉 撞上噪声 ->
小 -> 状态不动,噪声被略过
这是 softmax 的尖,在循环架构里的替身。不在空间上收拢注意力,改在时间上挑着记。
7.5 代价:局部性回来了
Mamba 对序列长度是
账还是要付:选择性是局部的。
要精确对上远处某个 token——比如翻出 1000 个 token 前出现过的某个词——Mamba 不如 Transformer。
躲不掉:直接全局访问和线性复杂度,不能同时拿。Mamba 拿线性换来的,是一条间接的路——通过压历史去够远处。
7.6 Transformer、线性注意力、Mamba:三方权衡
| 架构 | 时间复杂度 | 空间复杂度 | 长程能力 | 精确匹配能力 |
|---|---|---|---|---|
| Transformer | 直接全局访问 | 强(softmax 尖锐) | ||
| 线性注意力 | 有限容量状态 | 弱(平滑,被噪声稀释) | ||
| Mamba(SSM) | 压缩历史记忆 | 中(选择性记忆) |
没有免费午餐。全局视野、线性复杂度、精确匹配,三样里最多挑两样。
这是信息论划的线。跟工程做得好不好无关。
八、位置编码:Transformer 如何理解“顺序”
自注意力有个怪脾气:它不认词序。
把“cat sat mat”打乱成“mat cat sat”,注意力矩阵会变,因为
语言偏偏讲顺序。“cat sat mat”和“mat sat cat”是两回事。
补法是位置编码:把位置信息加进输入嵌入。
原始 Transformer 用的是正弦位置编码:
其中
为什么挑正弦?因为它有个漂亮的性子:
相对位置,能写成绝对位置的线性函数。模型学“相对位置关系”就省力了。
正弦位置编码是绝对位置编码:确定的,没有可学参数,不添学习的噪声。可它靠加法注进去,每个 token 表示里的内容和绝对位置捆在一起,注意力计算时很难掰开。它从不显式建 token 之间的相对位置,模型得从绝对位置反推。这多一层负担。
还有一层。这种隐式建模,可能拖累长距离依赖,也拖累模型往没见过的序列长度上外推。
后来的做法是相对位置编码:
RoPE(旋转位置嵌入):在注意力计算里头直接编码相对位置
ALiBi:给注意力分数加一个位置偏置——隔得越远,权重越低
这两种对长序列外推更好:在 512 的长度上训,拿到 2048 上测。
九、伪代码:Transformer 的完整前向传播
让我把 Transformer 的核心算法形式化。
算法 1:自注意力层
import torch
import torch.nn.functional as F

def self_attention(X, W_Q, W_K, W_V):
    # X: (N, d_model), W_Q/W_K/W_V: (d_model, d_k)
    Q = X @ W_Q          # (N, d_k)
    K = X @ W_K          # (N, d_k)
    V = X @ W_V          # (N, d_v)
    d_k = Q.shape[-1]
    scores = Q @ K.T / d_k ** 0.5              # (N, N)
    attn   = F.softmax(scores, dim=-1)         # normalize each row
    return attn @ V                            # (N, d_v)
# Time complexity O(N²·d), space complexity O(N²)
算法 2:多头注意力
import torch
import torch.nn as nn

class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0
        self.h  = num_heads
        self.dk = d_model // num_heads
        self.W_Q = nn.Linear(d_model, d_model, bias=False)
        self.W_K = nn.Linear(d_model, d_model, bias=False)
        self.W_V = nn.Linear(d_model, d_model, bias=False)
        self.W_O = nn.Linear(d_model, d_model, bias=False)

    def forward(self, X):
        B, N, D = X.shape
        # project and split into multiple heads (B, h, N, dk)
        Q = self.W_Q(X).view(B, N, self.h, self.dk).transpose(1, 2)
        K = self.W_K(X).view(B, N, self.h, self.dk).transpose(1, 2)
        V = self.W_V(X).view(B, N, self.h, self.dk).transpose(1, 2)
        attn = F.softmax(Q @ K.transpose(-2, -1) / self.dk**0.5, dim=-1)
        out  = (attn @ V).transpose(1, 2).reshape(B, N, D)  # concatenate the heads
        return self.W_O(out)
算法 3:完整的 Transformer 块
class TransformerBlock(nn.Module):
    def __init__(self, d_model, num_heads, d_ff):
        super().__init__()
        self.attn  = MultiHeadAttention(d_model, num_heads)
        self.ff1   = nn.Linear(d_model, d_ff)
        self.ff2   = nn.Linear(d_ff, d_model)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)

    def forward(self, X):
        X = self.norm1(X + self.attn(X))                         # attention + residual + LN
        X = self.norm2(X + self.ff2(F.relu(self.ff1(X))))        # FFN + residual + LN
        return X
# A full Transformer = stacking multiple TransformerBlocks
十、注意力的哲学:理解还是检索?
Transformer 成了,留下一个问题:注意力是在“理解”关系,还是在“检索”信息?
看这句:
"The trophy doesn't fit in the suitcase because it is too big."
人知道“it”指“trophy”,不指“suitcase”。因为人懂“太大”这笔账:trophy 太大,塞不进去。
Transformer 也确实让“it”的注意力压到“trophy”上。可它是懂了因果,还是只学会了一条统计规律——“it”多半指前面那个名词,而挨着“too big”的“it”更可能指第一个名词?
没有痛快答案。有几条线索:
证据 1:注意力模式的可解释性
有人发现,某些注意力头真学到了语言学上有意义的模式:主谓一致、修饰语跟中心词的搭配、代词跟先行词的绑定。
不是乱撞出来的。是系统性的。
证据 2:分布一偏就散架
测试数据的分布跟训练数据一岔开,这些模式就塌。训练时“it”总指第一个名词,测试时碰上“it”指第二个名词,模型就翻车。
这说明它学到的可能是统计捷径,不是底下的因果理解。
证据 3:注意力不等于解释
更微妙的是:注意力权重未必是模型决策的真原因。2019 年一项研究把注意力权重随机打乱,模型的输出有时几乎不变——真信息也许在 value 向量里,不在注意力分布里。
注意力是好用的工具。理解的充分条件,还轮不到它。
十一、可视化:注意力头在看什么
Transformer 摆好了推理的地基。下一章看它怎么跟搜索接上——在状态空间里找那条最好的推理路径。
悬而未决
注意力真的在“理解”关系吗?
还是只在做复杂的模式匹配?做个测试:打乱注意力权重,value 向量不动,看输出变多少。Jain & Wallace(2019)发现,某些任务上打乱权重对输出影响很小。这说明什么?是权重不重要,还是真信息压根就在 value 向量里?
平方的代价能不能从根上绕开?
所有“高效 Transformer”都在做交易:要么丢全局视野,要么引入近似。真躲不开?信息论下界说,描述一张
节点全连接图要 比特。可也许我们不必存整张注意力矩阵——也许有一种隐式表示,用 的空间编码 条连接? 位置编码的底子是什么?
正弦函数为什么管用?RoPE(旋转位置嵌入)为什么在外推上更好?位置信息的最优编码长什么样?换成同一个问题:怎么在保住置换不变性的同时,把顺序塞进去?
多头注意力,几个头才够?
BERT 用 12 个头,GPT-3 用 96 个。这数字怎么定的?有没有一个最优头数的理论?一个角度:每个头学一个子空间的关系模式,那头数就该等于“语言关系的内在维度”。可那个维度是几?
注意力权重能当解释用吗?
如果注意力不是解释——按 Jain & Wallace 的论证——那模型的决策过程该怎么读?再深一层:可解释性需要因果吗?我们要的也许不是“模型在看什么”,而是“我改一下输入,输出会怎么变”。
Transformer 的归纳偏置是什么?
CNN 有局部性偏置,卷积核。RNN 有顺序性偏置,循环结构。Transformer 呢?“没有归纳偏置”本身算不算一种归纳偏置?这问题碰到“架构即先验”:每个架构都在假设数据有某种结构,只是有些假设藏得深。
S×S 矩阵能有理论保证吗?(见兔狲教授的第二次独白)
A* 有可采纳性保证,MCTS 有对数收敛保证,ADS 有局部可采纳的步长条件。Transformer 的 S×S 搜索什么保证也没有——它“通常有效”,可没人说得清它什么时候失效、失效长什么样、边界在哪。能不能给
、 加某种约束,让 S×S 搜索也拿到类似“可采纳性”的保证?这是连续隐藏空间里悬着的题。 动态温度能把 ADS 移植进 Transformer 吗?(见兔狲教授的第二次独白)
ADS 用
在时间上动态调步长:熵高刹车,熵低加速。Transformer 用钉死的 在空间上调注意力的尖锐度。要是让 softmax 温度也跟着局部熵 变——高不确定时逼它聚焦(低 ),高确定时放它铺开(高 )——能不能在 Transformer 里复现 ADS 的自适应?那会是一次对调:熵控制这个题目底下,对数势垒和 softmax 温度换位置。 多层 S×S 矩阵的谱结构,跟推理深度什么关系?(见兔狲教授的第二次独白)
第
层的 S×S 矩阵有自己的特征值分布。大特征值管主推理方向,小特征值管探路。盯着谱结构随层深怎么变,能不能提前看出推理链从哪儿开始跑偏?说具体点:有效秩陡然掉下去,是不是“模型不推理了,开始吐先验”的早期警报——永霖收敛的先兆?
延伸阅读
Vaswani et al. (2017). Attention Is All You Need — Transformer 原始论文,开启了 NLP 的新纪元
-> [arXiv:1706.03762]Katharopoulos et al. (2020). Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention — 线性注意力的核函数推导;结合律换来
复杂度,以及它的圆滑性代价 -> [arXiv:2006.16236]Gu, A. et al. (2020). HiPPO: Recurrent Memory with Optimal Polynomial Projections — 用勒让德多项式做最优历史压缩;SSM 的理论基础
-> [arXiv:2008.07669]Gu, A. & Dao, T. (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces — 选择性 SSM;内容驱动的
在时间维度上实现 softmax 的尖锐度 -> [arXiv:2312.00752]Devlin et al. (2018). BERT: Pre-training of Deep Bidirectional Transformers — 双向 Transformer 预训练,展示了注意力机制的力量
-> [arXiv:1810.04805]Su et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding — RoPE 旋转位置嵌入,改进长序列外推
-> [arXiv:2104.09864]Press et al. (2021). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation — ALiBi 位置偏置方法
Clark et al. (2019). What Does BERT Look At? An Analysis of BERT's Attention — 注意力可视化与可解释性研究
Tay et al. (2020). Efficient Transformers: A Survey — 高效 Transformer 架构综述
Jain & Wallace (2019). Attention is not Explanation — 对注意力作为解释工具的批判性分析
Wiegreffe & Pinter (2019). Attention is not not Explanation — 对上述批判的反驳,为注意力辩护