⚠️ Alpha内测版本警告:此为早期内部构建版本,尚不完整且可能存在错误,欢迎大家提Issue反馈问题或建议。
Skip to content

第25章循环神经网络 ​

习题25.1 ​

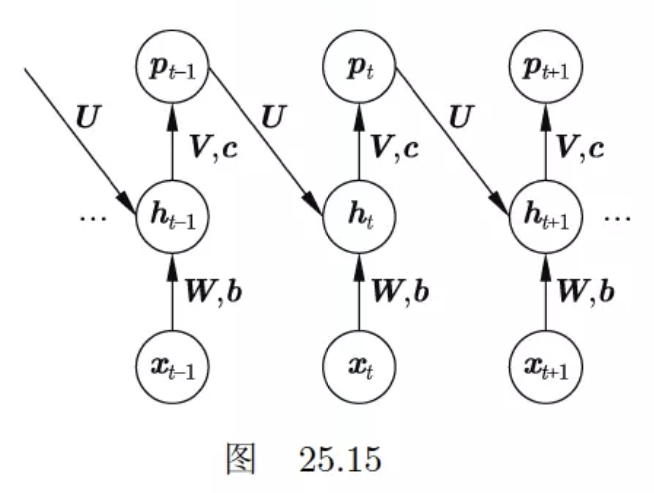
  Jordan提出的循环神经网络如图25.15所示。试写出这种神经网络的公式,并与Elman提出的简单循环神经网络做比较。
25-1.png

解答:

解答思路:

  1. 给出简单循环神经网络(S-RNN)的定义
  2. 给出Jordan提出的循环神经网络的公式
  3. 比较Jordan RNN和S-RNN

解答步骤:

第1步:简单循环神经网络(S-RNN)的定义

  根据书中第25.1.1节的定义25.1的简单循环神经网络(即Elman提出的简单循环神经网络)的定义:

定义25.1(简单循环神经网络) 称以下的神经网络为简单循环神经网络。神经网络以序列数据x1,x2,⋯,xT为输入,每一项是一个实数向量。在每一个位置上重复使用同一个神经网络结构。在第t个位置上(t=1,2,⋯,T),神经网络的隐层或中间层以xt和ht−1为输入,以ht为输出,其间有以下关系成立:

(25.1)ht=tanh⁡(U⋅ht−1+W⋅xt+b)

其中,xt表示第t个位置上的输入,是一个实数向量(xt,1,xt,2,⋯,xt,n)T;ht−1表示第t−1个位置的状态,也是一个实数向量(ht−1,1,ht−1,2,⋯,ht−1,m)T;ht表示第t个位置的状态(ht,1,ht,2,⋯,ht,m)T,也是一个实数向量;U,W是权重矩阵;b是偏置向量。神经网络的输出层以ht为输入,pt为输出,有以下关系成立:

(25.2)pt=softmax(V⋅ht+c)

其中,pt表示第t个位置上的输出,是一个概率向量(pt,1,pt,2,⋯,pt,l)T,满足pt,i⩾0 (i=1,2,⋯,l),∑i=1lpt,i=1;V是权重矩阵;c是偏置向量。神经网络输出序列数据p1,p2,⋯,pT,每一项是一个概率向量。
  以上公式还可以写作

(25.3)rt=U⋅ht−1+W⋅xt+b(25.4)ht=tanh⁡(rt)(25.5)zt=V⋅ht+c(25.6)pt=softmax(zt)

其中,rt是隐层的净输入向量,zt是输出层的净输入向量。隐层的激活函数通常是双曲正切函数,也可以是其他激活函数;输出层的激活函数通常是软最大化函数。

第2步:给出Jordan提出的循环神经网络的公式

  根据图25.15的循环神经网络架构,可得循环神经网络的公式如下:

rt=U⋅pt−1+W⋅xt+bht=tanh⁡(rt)zt=V⋅ht+cpt=softmax(zt)

第3步:比较Jordan RNN和S-RNN

  • 相同点:

    1. 两者都是描述动态系统的非线性模型
    2. 两者都满足循环神经网络的基本特点,包括可以处理任意长度的序列数据、属于自回归模型、具有强大的表示能力
    3. 两者都不能进行并行化处理
  • 不同点:

    1. Jordan RNN采用softmax处理隐含层后的输出层作为下一层隐含层的输入,而 S-RNN 采用的是softmax处理前的隐含层作为下一层隐含层的输入
    2. 由于Jordan RNN采用的是经softmax处理后的隐含层,所以其分布较原本的隐含层改变了,尤其是类别间的差距被非线性放大或缩小(负值厌恶),这种对正负向的偏好在信息量表达上是不利的,这里直接建模相邻时间节点的隐含层可以建立更直接的相邻隐含层分布之间的关系,拥有更高的拓展性和普适性,所以后续的循环神经网络多以 S-RNN 作为基础机构。

习题25.2 ​

  写出循环神经网络的层归一化的公式。

解答:

解答思路:

  1. 给出层归一化的基本概念
  2. 写出循环神经网络的层归一化的公式

解答步骤:

第1步:层归一化的基本概念

  根据书中第23.2.5节的层归一化的描述:

  层归一化(layer normalization)是另一种防止内部协变量偏移的方法。其基本想法与批量归一化相同,但是是在每一层的神经元上进行归一化,而不是在每一个批量的样本上进行归一化。优点是实现简单,也没有批量大小的超参数需要调节。
  层归一化在每一层的神经元的净输入上进行。假设当前层的神经元的净输入是z=(z1,z2,⋯,zm)T,其中zj是第j个神经元的净输入,m是神经元个数。训练和预测时,首先计算这一层的神经元的净输入的均值与方差(无偏估计)。

(23.65)μ=1m∑j=1mzj(23.66)σ2=1m−1∑j=1m(zj−μ)2

然后对每一个神经元的净输入进行归一化,得到数值:

(23.67)z¯j=zj−μσ2+ϵ, j=1,2,⋯,m

其中,ϵ是一个很小的正数。之后再进行仿射变换,得到数值:

(23.68)z~j=γ⋅z¯j+β, j=1,2,⋯,m

其中,γ和β是参数。最后将归一化加仿射变换的结果作为这一层神经元的实际净输入。在每一层都做相同的处理。神经网络的每一层都有两个参数γ和β。

第2步:写出循环神经网络的层归一化的公式

  对于第l层循环神经网络层输入为z(l),其层归一化后的输出z~(l)为:

z~(l)=γ⋅z(l)−μ(l)σ(l)+ϵ+β

记作LNγ,β(z(l)),其中γ, β 这里是缩放和平移的参数向量,和 z(l) 的维度相同;μ(l)为μ(l)=1n(l)∑i=1n(l)zi(l);σ(l)=1n(l)−1∑i=1n(l)(zi(l)−μ(l))2。

在循环神经网络中,假设在t时刻,隐层为ht,其归一化的公式为

zt=Uht−1+Wxt+bht=f(LNγ,β(zt))

其中xt 表示第 t 个位置上的输入,U,W 为权重矩阵,f(⋅)是激活函数。

习题25.3 ​

  比较前馈神经网络的反向传播算法与循环神经网络的反向传播算法的异同。

解答:

解答思路:

  1. 给出前馈神经网络的反向传播算法
  2. 给出循环神经网络的反向传播算法
  3. 比较两者的异同

解答步骤:

第1步:前馈神经网络的反向传播算法

  根据书中第23.2.3节的算法23.3的前馈神经网络的反向传播算法:

算法23.3 (前馈神经网络的反向传播算法)
输入:神经网络f(x;θ),参数向量θ,一个样本(x,y)
输出:更新的参数向量θ
超参数:学习率η
1.正向传播,得到各层输出h(1),h(2),⋯,h(s)

h(0)=x

For t=1,2,⋯,s,do {

z(t)=W(t)h(t−1)+b(t)h(t)=a(z(t))

}

f(x)=h(s)

2.反向传播,得到各层误差δ(s),⋯,δ(2),δ(1),同时计算各层的梯度,更新各层的参数。
计算输出层的误差

δ(s)=h(s)−y

For t=s,⋯,2,1,do {
  计算第t层的梯度

∇W(t)L=δ(t)⋅h(t−1)T∇b(t)L=δ(t)

  根据梯度下降公式更新第t层的参数

W(t)←W(t)−η∇W(t)Lb(t)←b(t)−η∇b(t)L

   If (t>1) {
     将第t层的误差传到第t−1层

δ(t−1)=∂a∂z(t−1)⊙(W(t)T⋅δ(t))

  }
} 3.返回更新的参数向量

第2步:循环神经网络的反向传播算法

  根据书中第25.1.2节的算法25.1的循环神经网络的反向传播算法:

算法25.1(随时间的反向传播算法)
输入:循环神经网络f(x;θ),参数θ,样本(x1,x2,...,xT) 和 (y1,y2,...,yT)。
输出:更新的参数θ
超参数:学习率 η 1.正向传播,得到各个位置的输出
For t=1,2,⋯,T,do {
  将信号从前向后传播,计算隐层的输出ht和输出层的输出pt

rt=U⋅ht−1+W⋅xt+bht=tanh⁡(rt)zt=V⋅ht+cpt=softmax(zt)

} 2.反向传播,得到各个位置的梯度
For t=T,⋯,2,1,do {
  计算输出层的梯度∂L∂zt

∂L∂zt=yt−pt

  将梯度从后向前传播,计算隐层的梯度∂L∂rt
  If (t<T) {

∂L∂rt=diag(1−tanh2⁡rt)⋅UT⋅∂L∂rt+1+diag(1−tanh2⁡rt)⋅VT⋅∂L∂zt

  } else {

∂L∂rT=diag(1−tanh2⁡rT)⋅VT⋅∂L∂zT

  }
}
3.进行参数更新
计算梯度

∂L∂c=∑t=1T∂L∂zt∂L∂V=∑t=1T∂L∂zt⋅htT∂L∂b=∑t=1T∂L∂rt∂L∂U=∑t=1T∂L∂rt⋅ht−1T∂L∂W=∑t=1T∂L∂rt⋅xtT

根据梯度下降公式更新参数

c←c−η∂L∂cV←V−η∂L∂Vb←b−η∂L∂bW←W−η∂L∂WU←U−η∂L∂U

4.返回更新的参数

第3步:比较两者的异同

  • 相同点:

    1. 两者的反向传播学习的过程步骤相同,都是正向传播、反向传播、参数更新、返回更新的参数
    2. 两者在反向传播过程中都会因矩阵连乘,导致梯度消失和梯度爆炸
  • 不同点:

    1. 在循环神经网络的反向传播中,矩阵的连乘接近矩阵的连续自乘,导致其梯度消失与爆炸的风险更严重;
    2. 循环神经网络的反向传播算法需要在时间上展开,计算量更大;
    3. 循环神经网络的反向传播算法中,每一个位置的参数共享,传播梯度为所有位置求和。而前馈网络神经网络的反向传播算法中没有参数共享;
    4. 循环神经网络的反向传播算法中,隐层的梯度来自输出层的梯度和下一个位置的隐层梯度两个方向。而前馈网络神经网络的反向传播算法中,隐层梯度只来自于输出层的梯度。

习题25.4 ​

  写出LSTM模型的反向传播算法公式。

解答:

解答思路:

  1. 给出LSTM的基本概念
  2. 写出LSTM的反向传播算法公式推导
  3. 写出LSTM的反向传播算法

解答步骤:

第1步:LSTM的基本概念

  根据书中第25.2.1节的定义25.2的长短期记忆网络(LSTM):

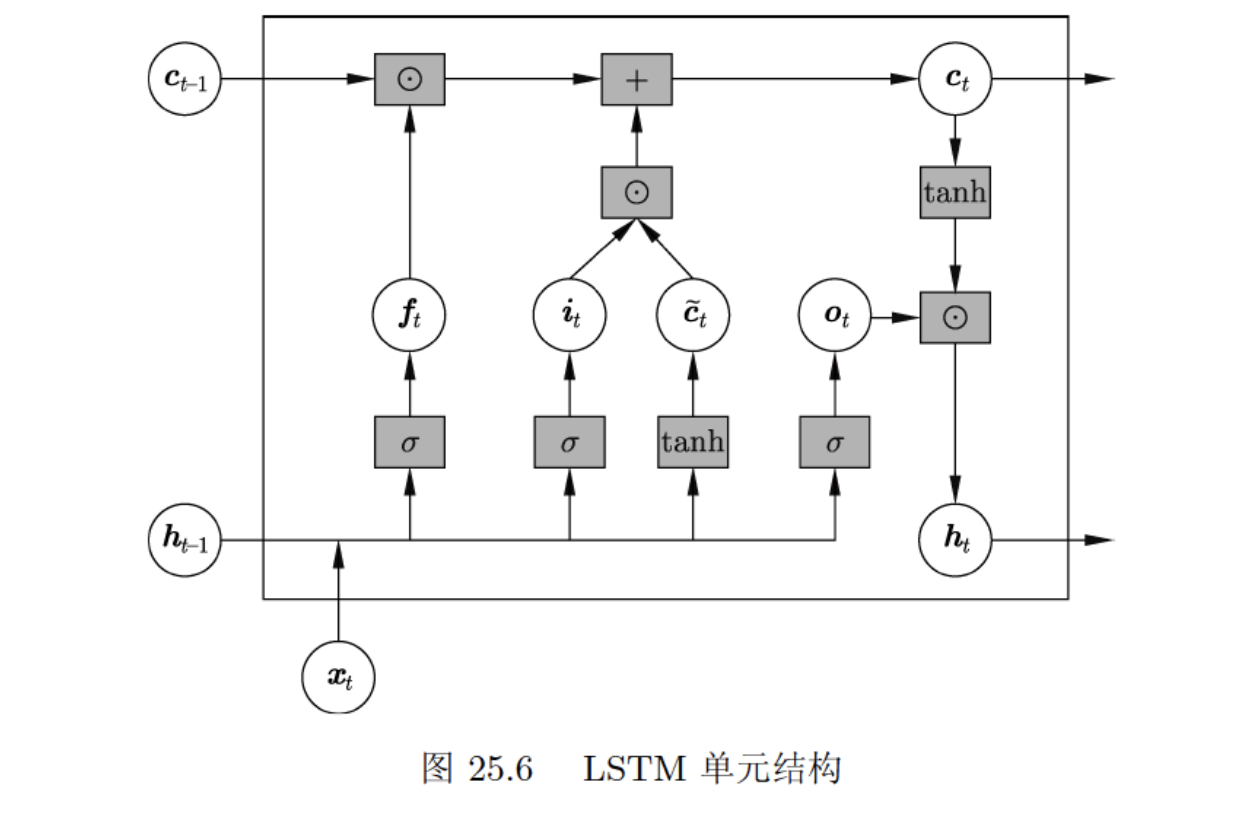
  定义25.2(长短期记忆网络) 以下的循环神经网络称为长短期记忆网络。在循环网络的每一个位置上有状态和记忆元,以及输入门、遗忘门、输出门,构成一个单元。第t个位置上(t=1,2,⋯,T)的单元是以当前位置的输入xt、之前位置的记忆元ct−1、之前位置的状态ht−1为输入,以当前位置的状态ht和当前位置的记忆元ct为输出的函数,由以下方式计算。

(25.20)it=σ(Ui⋅ht−1+Wi⋅xt+bi)(25.21)ft=σ(Uf⋅ht−1+Wf⋅xt+bf)(25.22)ot=σ(Uo⋅ht−1+Wo⋅xt+bo)(25.23)c~t=tanh⁡(Uc⋅ht−1+Wc⋅xt+bc)(25.24)ct=it⊙c~t+ft⊙ct−1(25.25)ht=ot⊙tanh⁡(ct)

这里it是输入门,ft是遗忘门,ot是输出门,c~t是中间结果。状态ht、记忆元ct、输入门it、遗忘门ft、输出门ot都是向量,其维度相同。

25-4

第2步:写出LSTM的反向传播算法公式推导

  由上述LSTM算法公式,现为了区分c~t 和 ct,使用 gt 代替 c~t:

it=σ(i~t)=σ(Ui⋅ht−1+Wi⋅xt+bi)ft=σ(f~t)=σ(Uf⋅ht−1+Wf⋅xt+bf)ot=σ(o~t)=σ(Uo⋅ht−1+Wo⋅xt+bo)gt=tanh⁡(g~t)=c~t=tanh⁡(Uc⋅ht−1+Wc⋅xt+bc)ct=it⊙gt+ft⊙ct−1ht=ot⊙tanh⁡(ct)zt=V⋅ht+cpt=softmax(zt)

这里it是输入门,ft是遗忘门,ot是输出门,gt是中间结果。状态ht、记忆元ct、输入门it、遗忘门ft、输出门ot都是向量,其维度相同。

  现考虑,已知∂L∂zt,∂L∂ct+1,∂L∂o~t+1,∂L∂f~t+1,∂L∂i~t+1,∂L∂g~t+1 求某个隐层的梯度时,首先应该找到该隐层的输出层,然后分别计算输出层的梯度乘以输出层对该隐层的梯度,最后相加即可得到该隐层的梯度。

  假设某一隐层的输出ht,现计算∂L∂ht时,可找到该层神经元的后一层所有已连接的神经元的净输出 $ z_t, \tilde{o}{t+1}, \tilde{f}, \tilde{i}{t+1}, \tilde{g}$ ,然后分别计算该隐层的输出层的梯度(如∂L∂zt)与输出层的神经元对该隐层ht的梯度的乘积(如 $\displaystyle \frac{\partial L}{\partial z_t} U^T_c $),最后相加即可得到该隐层的梯度:

∂L∂ht=∂L∂ztVT+∂L∂o~t+1UoT+∂L∂f~t+1UfT+∂L∂i~t+1UiT+∂L∂g~t+1UcT

根据上述计算过程,可计算各个计算公式的中间输出结果的梯度:

∂L∂ct=∂L∂tanh⁡(ct)dtanh⁡(ct)dct+∂L∂ct+1⊙ft+1=(∂L∂ht⊙ot)⋅diag(1−tanh2⁡ct)+∂L∂ct+1⊙ft+1∂L∂g~t=∂L∂gt(1−gt2)=(1−gt2)⋅∂L∂ct⊙it∂L∂i~t=∂L∂itit(1−it)=it(1−it)⋅∂L∂ct⊙gt∂L∂f~t=∂L∂ftft(1−ft)=ft(1−ft)⋅∂L∂ct⊙ct−1∂L∂o~t=∂L∂otit(1−ot)=it(1−ot)⋅∂L∂ht⊙tanh⁡(ct)∂L∂xt=∂L∂o~tWoT+∂L∂f~tWfT+∂L∂i~tWiT+∂L∂g~tWcT

可求得各个参数的梯度,注意参数是在每个位置共享的,需要对所有位置求和。

∂L∂Uo=∑t=1T∂L∂o~t+1⋅htT∂L∂Uf=∑t=1T∂L∂f~t+1⋅htT∂L∂Ui=∑t=1T∂L∂i~t+1⋅htT∂L∂Uc=∑t=1T∂L∂g~t+1⋅htT∂L∂V=∑t=1T∂L∂zt⋅htT∂L∂Wo=∑t=1T∂L∂o~t⋅xtT∂L∂Wf=∑t=1T∂L∂f~t⋅xtT∂L∂Wi=∑t=1T∂L∂i~t⋅xtT∂L∂Wc=∑t=1T∂L∂g~t⋅xtT∂L∂bi=∑t=1T∂L∂i~t∂L∂bf=∑t=1T∂L∂f~t∂L∂bo=∑t=1T∂L∂o~t∂L∂bc=∑t=1T∂L∂g~t

第3步:写出LSTM的反向传播算法

输入:LSTM网络 y=f(x;θ),参数θ,样本(x1,x2,⋯,xT) 和 (y1,y2,⋯,yT)。
输出:更新的参数θ
超参数:η

  1. 正向传播,得到各个位置的输出

For t=1,2,⋯,T do {
  将信号从前向后传播,计算隐层的输出ht 和输出层的输出pt

it=σ(i~t)=σ(Ui⋅ht−1+Wi⋅xt+bi)ft=σ(f~t)=σ(Uf⋅ht−1+Wf⋅xt+bf)ot=σ(o~t)=σ(Uo⋅ht−1+Wo⋅xt+bo)gt=tanh⁡(g~t)=c~t=tanh⁡(Uc⋅ht−1+Wc⋅xt+bc)ct=it⊙gt+ft⊙ct−1ht=ot⊙tanh⁡(ct)zt=V⋅ht+cpt=softmax(zt)

}

  1. 反向传播,得到各个位置的梯度

For t=T,⋯,2,1 do {
  计算输出层的梯度$\displaystyle \frac{\partial{L}}{\partial{z_t}} $

∂L∂zt=yt−pt

  将梯度从后向前传播,计算隐层的梯度∂L∂i~t,∂L∂f~t,∂L∂o~t
  If (t<T) {

∂L∂i~t=it(1−it)⋅∂L∂ct⊙gt∂L∂f~t=ft(1−ft)⋅∂L∂ct⊙ct−1∂L∂o~t=it(1−ot)⋅∂L∂ht⊙tanh⁡(ct)

    其中

∂L∂ct=(∂L∂ht⊙ot)⋅diag(1−tanh2⁡ct)+∂L∂ct+1⊙ft+1∂L∂ht=∂L∂ztVT+∂L∂o~t+1UoT+∂L∂f~t+1UfT+∂L∂i~t+1UiT+∂L∂g~t+1UcTgt=tanh⁡(Uc⋅ht−1+Wc⋅xt+bc)

  } else {

∂L∂i~T=iT(1−iT)⋅∂L∂cT⊙gT∂L∂f~T=fT(1−fT)⋅∂L∂cT⊙cT−1∂L∂o~T=iT(1−oT)⋅∂L∂hT⊙tanh⁡(cT)

    其中

∂L∂cT=(∂L∂hT⊙oT)⋅diag(1−tanh2⁡cT)∂L∂hT=∂L∂zTVTgT=tanh⁡(Uc⋅hT−1+Wc⋅xT+bc)

  }

  1. 进行参数更新

计算梯度

∂L∂Uo=∑t=1T∂L∂o~t+1⋅htT∂L∂Uf=∑t=1T∂L∂f~t+1⋅htT∂L∂Ui=∑t=1T∂L∂i~t+1⋅htT∂L∂Uc=∑t=1T∂L∂g~t+1⋅htT∂L∂V=∑t=1T∂L∂zt⋅htT∂L∂Wo=∑t=1T∂L∂o~t⋅xtT∂L∂Wf=∑t=1T∂L∂f~t⋅xtT∂L∂Wi=∑t=1T∂L∂i~t⋅xtT∂L∂Wc=∑t=1T∂L∂g~t⋅xtT∂L∂bi=∑t=1T∂L∂i~t∂L∂bf=∑t=1T∂L∂f~t∂L∂bo=∑t=1T∂L∂o~t∂L∂bc=∑t=1T∂L∂g~t

根据梯度下降公式更新参数

Uo←Uo−η∂L∂UoUf←Uf−η∂L∂UfUi←Ui−η∂L∂UiUc←Uc−η∂L∂UcV←V−η∂L∂VWo←Wo−η∂L∂WoWf←Wf−η∂L∂WfWi←Wi−η∂L∂WiWc←Wc−η∂L∂Wcbo←bo−η∂L∂bobf←bf−η∂L∂bfbi←bi−η∂L∂bibc←bc−η∂L∂bc
  1. 返回更新的参数

习题25.5 ​

  推导LSTM模型中记忆元的展开式(25.26)。

解答:

解答思路:

  1. 给出LSTM模型的记忆元表达式
  2. 使用递归法推导记忆元的展开式

解答步骤:

第1步:LSTM模型的记忆元表达式

  根据书中第25.2.1节的LSTM的模型特点:

  当输入门和遗忘门满足it=1,ft=0时,当前位置的记忆元ct只依赖于当前位置的输入xt和之前位置的状态ht−1,LSTM是S-RNN的近似。当输入门和遗忘门满足it=0,ft=1时,当前位置的记忆元ct只依赖于之前位置的记忆元ct−1,LSTM将之前位置的记忆元复制到当前位置。
  当前位置的记忆元ct可以展开成以下形式:

(25.26)ct=it⊙c~t+ft⊙ct−1=∑i=1t(∏j=i+1tfj⊙ii)⊙c~i=∑i=1twit⊙c~i

其中,wit表示计算得到的第t个位置的权重。

第2步:使用递归法推导记忆元的展开式

  根据递推形式,在第t个位置时,可得当前位置的记忆元ct:

(1)ct=it⊙c~t+ft⊙ct−1

  在第t−1个位置时,可得之前位置的记忆元ct−1:

(2)ct−1=it−1⊙c~t−1+ft−1⊙ct−2

  将式(2)带入式(1)中,可得:

(3)ct=it⊙c~t+ft⊙(it−1⊙c~t−1+ft−1⊙ct−2)=it⊙c~t+ft⊙it−1⊙c~t−1+ft⊙ft−1⊙ct−2

  逐步递归,可得:

ct=it⊙c~t+ft⊙it−1⊙c~t−1+ft⊙ft−1⊙ct−2=it⊙c~t+ft⊙it−1⊙c~t−1+ft⊙ft−1⊙(it−2⊙c~t−2+ft−2⊙ct−3)=it⊙c~t+ft⊙it−1⊙c~t−1+ft⊙ft−1⊙it−2⊙c~t−2+ft⊙ft−1⊙ft−2⊙ct−3=it⊙c~t+ft⊙it−1⊙c~t−1+ft⊙ft−1⊙it−2⊙c~t−2+⋯+ft⊙ft−1⊙f3⊙i2⊙c~2+ft⊙ft−1⊙f2⊙c1=∑i=2t(∏j=i+1tfj⊙ii)⊙c~i+ft⊙ft−1⊙f2⊙c1

  当在第1个位置时,i1=1,则c1=i1⊙c~1

  所以

ct=∑i=2t(∏j=i+1tfj⊙ii)⊙c~i+ft⊙ft−1⊙f2⊙c1=∑i=2t(∏j=i+1tfj⊙ii)⊙c~i+ft⊙ft−1⊙f2⊙i1⊙c~1=∑i=1t(∏j=i+1tfj⊙ii)⊙c~i

  令第t个位置的权重可表示为

wit=∏j=i+1tfj⊙ii

则

ct=it⊙c~t+ft⊙ct−1=∑i=1t(∏j=i+1tfj⊙ii)⊙c~i=∑i=1twit⊙c~i

习题25.6 ​

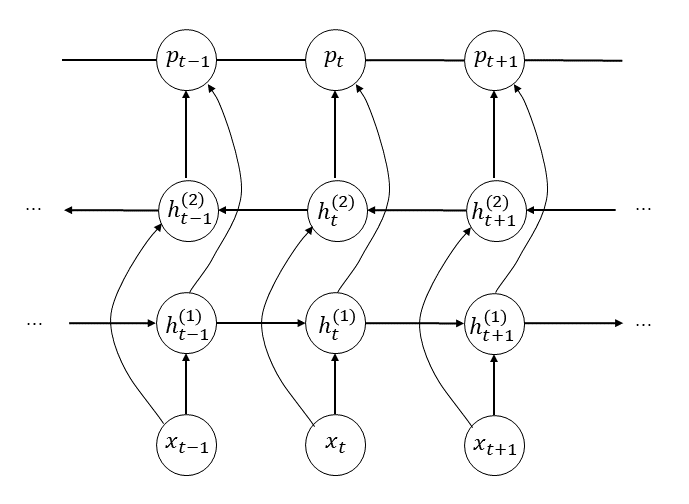
  写出双向LSTM-CRF的模型公式。图25.16是双向LSTM-CRF的架构图。
25-6.png

解答:

解答思路:

  1. 给出双向循环神经网络的模型公式
  2. 给出LSTM模型公式
  3. 给出CRF模型公式
  4. 根据双向LSTM-CRF架构图,写出模型公式

解答步骤:

第1步:双向循环神经网络的模型公式

  根据书中第25.2.4节的双向循环神经网络:

  前向的循环神经网络的隐层(状态)是:

(25.35)ht(1)=tanh⁡(U(1)⋅ht−1(1)+W(1)⋅xt+b(1))

后向的循环神经网络的隐层(状态)是:

(25.36)ht(2)=tanh⁡(U(2)⋅ht−1(2)+W(2)⋅xt+b(2))

两者的拼接是

(25.37)ht=[ht(1);ht(2)]

其中,;表示两个向量的拼接。

pt=softmax(V⋅ht+c)

第2步:LSTM模型公式

  根据书中第25.2.1节的长短期记忆网络(LSTM)的模型公式:

it=σ(Ui⋅ht−1+Wi⋅xt+bi)ft=σ(Uf⋅ht−1+Wf⋅xt+bf)ot=σ(Uo⋅ht−1+Wo⋅xt+bo)c~t=tanh⁡(Uc⋅ht−1+Wc⋅xt+bc)ct=it⊙c~t+ft⊙ct−1ht=ot⊙tanh⁡(ct)

这里it是输入门,ft是遗忘门,ot是输出门,c~t是中间结果。状态ht、记忆元ct、输入门it、遗忘门ft、输出门ot都是向量,其维度相同。

第3步:CRF模型公式

  根据书中第11.2.3节的条件随机场(CRF)的简化形式:

条件随机场可以写成向量w与F(y,x)的内积的形式:

(11.19)Pw(y|x)=exp⁡(w⋅F(y,x))Zw(x)

其中,$$ Z_w(x) = \sum_y \exp (w \cdot F(y, x)) \tag{11.20} $$

第4步:根据双向LSTM-CRF架构图,写出模型公式

  双向LSTM-CRF的基本架构是在双向LSTM的输出层引入CRF,是序列标注的有代表性的方法。

  前向的LSTM的隐层(状态)是

htf=LSTMf(xt,ht−1f)

后向的LSTM的隐层(状态)是

htb=LSTMb(xt,ht+1b)

其中,LSTMf 和 LSTMb 分别表示前向LSTM和后向LSTM,ht−1f 和 ht+1b 分别表示前向LSTM和后向LSTM的上一个位置的隐藏状态。

两者的拼接是

ht=[hif;hib]

其中,;表示两个向量的拼接。

  将 ht 输入到CRF层中,得到每个时间步的标签 yt,并计算其对数概率 p(y|x):

p(y|x)=exp⁡(score(x,y))∑y′exp⁡(score(x,y′))

其中,score(x,y) 表示序列 x 对应标签序列 y 的得分,可以使用线性模型进行计算:

score(x,y)=∑t=1nAyt,yt−1+∑t=1nBt,yt

其中,A 是状态转移矩阵,B 是发射矩阵,Ayt,yt−1 表示从状态 yt−1 转移到状态 yt 的得分,Bt,yt 表示在第t个位置,标签为 yt 的发射得分。