
최전선 연구 동향: Genie
아키텍처 7: Genie, 비디오에서 동작을 암묵적으로 발견하기
대표 시스템: Genie(Google DeepMind, 2024), Genie 2(2024)
지금까지 다룬 아키텍처 계열은 모두 하나의 공통 전제를 깔고 있습니다. 학습 데이터에 동작 레이블이 있거나(상호작용형), 아예 동작이 필요 없다는(관측형) 전제입니다. Genie는 주석 없는 인터넷 비디오에서 암묵적인 잠재 동작을 자동으로 발견해 이 이분법을 깨뜨립니다.
이 절의 제목에서 자연스럽지만 잘못된 생각이 하나 떠오르기 쉽습니다. 동작을 비디오에서 발견했으니, 조이스틱 입력처럼 로봇에 그대로 꽂아 넣을 수 있으리라는 생각입니다. 그렇지 않습니다. 잠재 동작은 두 프레임 사이에 어떤 종류의 변화가 일어났는지를 나타내는 코드일 뿐이며, 순전히 픽셀 차이에서 유도된 것이라 특정 모터 명령이나 물리적 단위와 맞아떨어진다는 보장이 전혀 없습니다. 이 절 끝의 한계 설명이 그 결과를 직접적으로 말해줍니다. 잠재 동작이 실제 컨트롤러에 의미를 가지려면 여전히 별도의 정렬 단계가 필요합니다.
학습 데이터는 사람이 게임을 하고 물체를 조작하는 대량의 비디오 클립이며, 어떤 동작 레이블도 없습니다. Genie는 세 모듈을 공동으로 학습시킵니다. 프레임 시퀀스를 시공간 이산 토큰으로 압축하는 비디오 토크나이저(ST-ViT, Spatiotemporal Vision Transformer, 시공간 비전 트랜스포머로, 시간과 공간 두 차원에서 동시에 패치 단위 인코딩을 적용해 시공간 이산 토큰을 만들어냅니다), 인접한 프레임 쌍으로부터 이산적인 잠재 동작 코드를 추론하는 잠재 동작 모델(LAM, 인접 프레임 사이 변화의 유형을 추론하도록 학습됩니다), 그리고 잠재 동작을 조건으로 다음 프레임의 토큰 시퀀스를 예측하는 동역학 모델입니다. 추론 시에는 사용자가 잠재 동작을 직접 지정할 수 있고 모델은 그에 맞춰 다음 프레임을 생성하므로, 전체 과정이 완전히 상호작용 가능합니다.
📖 잠재 동작(latent action): "왼쪽으로 이동" 같은 키보드 입력이나 관절 공간의 토크가 아니라, 순전히 비디오 프레임 사이의 차이에서 귀납된 이산 코드입니다. "인접한 프레임 사이에 어떤 종류의 변화가 일어났는가"를 포착할 뿐, 구체적인 물리적 동작을 나타내지는 않습니다. 두 비디오 클립의 장면 전환 패턴이 비슷하다면(예: "어떤 물체가 오른쪽으로 이동한다"), 실제로 찍힌 것이 게임이든 로봇 조작이든 상관없이 같은 잠재 동작 코드를 공유해야 합니다.
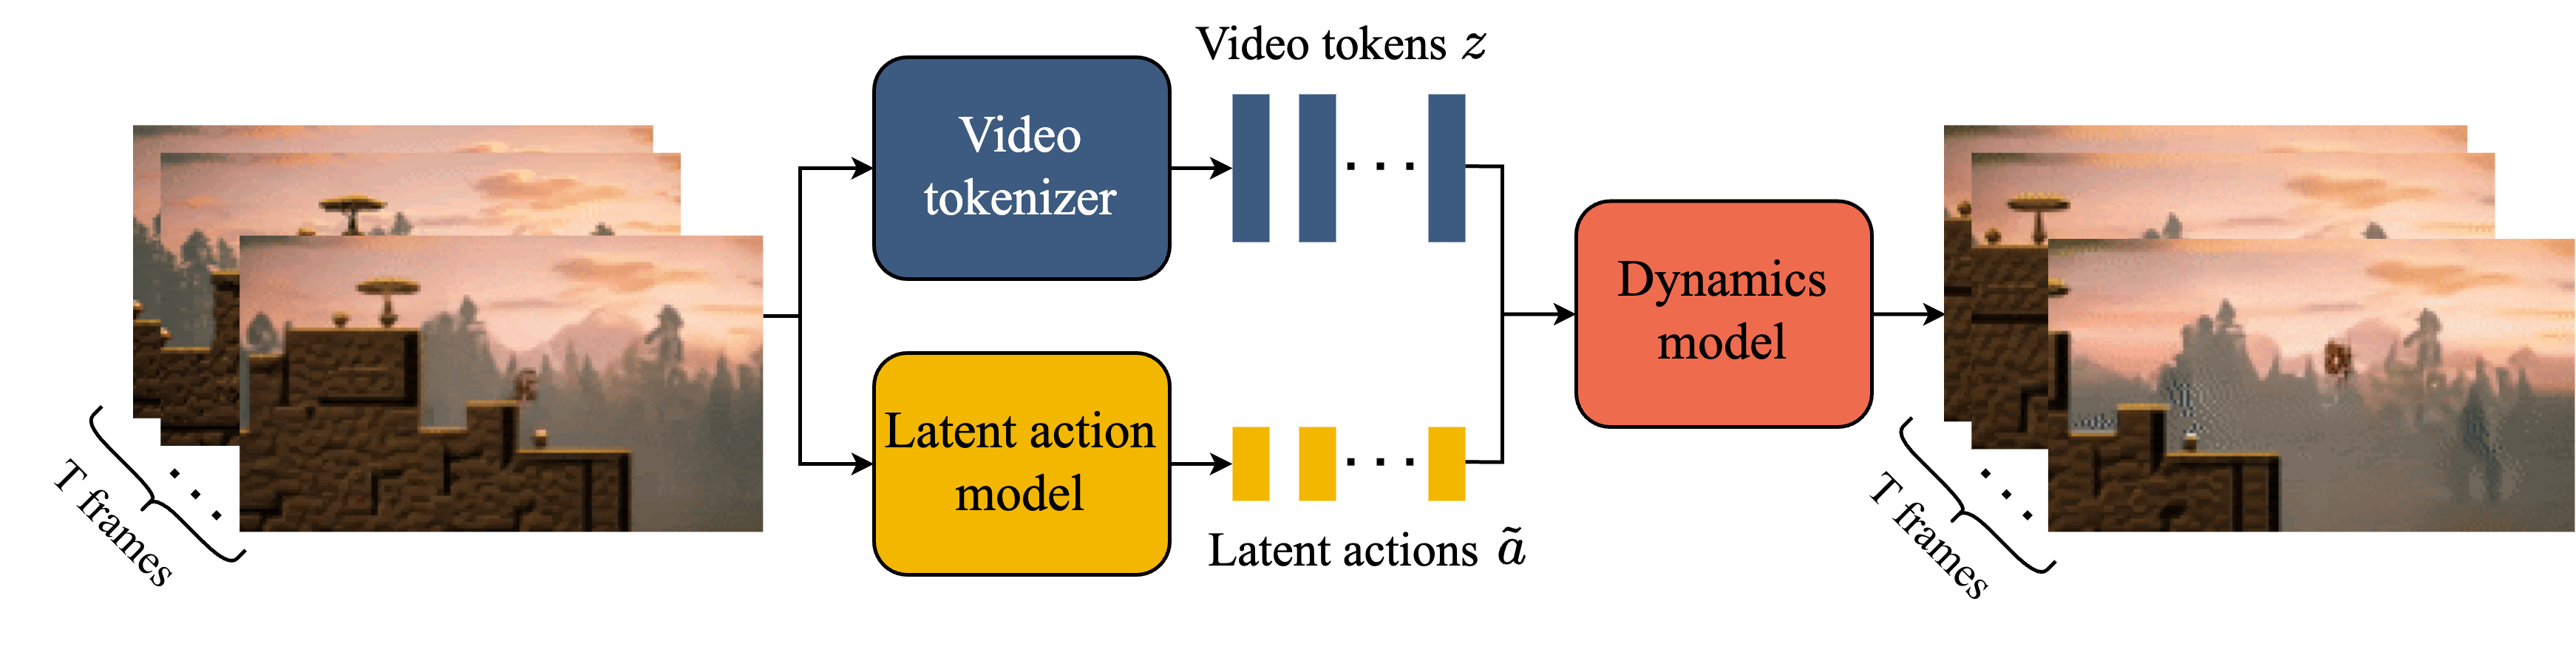
Genie는 3만 시간의 플랫포머 게임 비디오(동작 주석 없음)와 110억 개의 파라미터로 학습되었습니다. 논문은
학습 패러다임: 관측형과 상호작용형 사이에 있습니다. 학습은 비디오만으로 이루어지지만(관측형), 추론은 동작 조건화 생성을 지원합니다(상호작용형). 이 발상은 이후 WAM 계열에 직접적인 영감을 주었으며, 이어지는 절에서 다룹니다.
한계: 잠재 동작은 자동으로 귀납된 것이라 실제 물리적 동작과 정렬되어 있지 않아, 로봇 제어에 곧바로 쓸 수 없습니다. 잠재 동작에서 실제 정책으로 가려면 여전히 추가적인 정렬 단계가 필요합니다.
다음: 두 아키텍처 계열 더
Genie의 잠재 동작 트릭은 다음 페이지가 두 가지 다른 방향에서 답하는 질문 하나를 던집니다. LoopWM은 동역학 모델의 깊이를 파라미터 수와 분리할 수 있는지를 묻고, WAM은 월드모델과 정책이 애초에 분리된 모듈이어야 하는지를 묻습니다. 둘 다 여기서 소개한 발상을 곧바로 기반으로 삼으니, 계속 읽기 전에 잠시 짚고 넘어갈 가치가 있습니다.