
물리적 일관성과 호라이즌 드리프트
Diffusion 월드모델(Diamond)
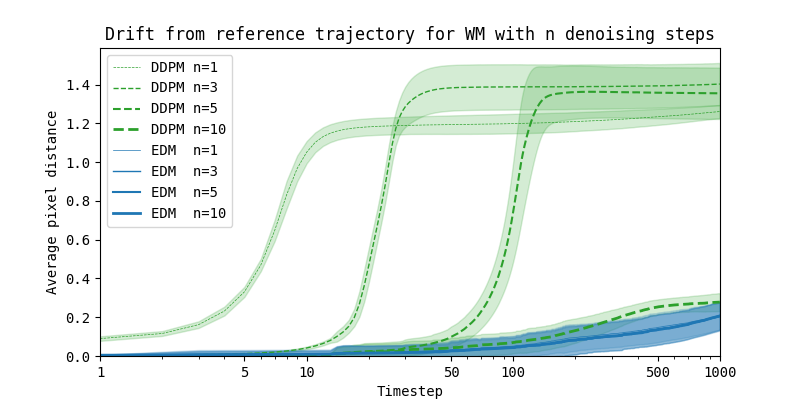
Diamond(2024)는 Diffusion 과정을 강화학습 학습 루프에 직접 통합한 최초의 월드모델로, Atari 100k 벤치마크에서 평균 HNS 1.46을 기록하며 기존의 모든 월드모델 방법을 능가했습니다. Diffusion 모델은 과거 프레임과 동작을 조건으로 다음 프레임을 반복적으로 노이즈 제거해 생성하며, 각 노이즈 제거 스텝은 U-Net의 완전한 순전파 한 번에 해당합니다. 이 방식은 고품질 생성을 얻는 대신, 생성 속도가 느리고 물체 지속성을 유지하기 어렵다는 대가를 치릅니다.
FVD(시퀀스 동역학 품질)
STORM 절에서 설명했듯, FVD는 Diffusion 월드모델의 시퀀스 품질을 보고할 때 선호되는 지표입니다. Diamond 논문이 보고한 FVD는 무척 낮아서, 실제 Atari 게임 프레임끼리 비교했을 때 나오는 FVD보다도 낮은 수준입니다. 즉 생성된 영상이 실제 영상과 통계적으로 거의 구분되지 않을 만큼 품질이 뛰어나다는 뜻입니다.
물리 일관성
이는 Diffusion 월드모델만의 고유한 난제입니다. 프레임 하나하나의 품질이 높다고 해서 시퀀스 전체에 걸쳐 물리적 관계가 일관되게 유지된다는 보장은 없습니다. 구체적인 실패 사례를 들면, 물체가 탁자에서 떨어지는 장면은 개별 프레임만 보면 사실적이지만, 다음 프레임에서 그 물체가 갑자기 탁자 위로 "되돌아가" 중력과 지속성 제약을 어길 수 있습니다.
평가 방법: 평가 시퀀스에 객체 추적기를 적용합니다(예: SAM2, Segment Anything Model 2, Meta가 2024년에 공개한 비디오 분할·추적 모델로 비디오 프레임 전체에 걸쳐 지정된 객체의 마스크를 실시간으로 추적할 수 있습니다; 또는 DINO 특징 매칭, 자기지도 Transformer 사전학습에 기반한 시각 특징 추출기로, 같은 객체라면 서로 다른 프레임에서도 DINO 특징 벡터의 코사인 유사도가 높게 나와 프레임 간 대응 관계를 매칭하는 데 쓸 수 있습니다). 핵심 물체의 위치 궤적을 연속된 프레임에 걸쳐 추적해, 프레임 간 이동량이 합리적인 임계값을 넘는 지점을 위반으로 표시합니다. 물리 일관성 점수는 이런 위반이 없는 프레임의 비율이며, 높을수록 좋습니다.
동작 조건화 정확도(Action-Conditioning Fidelity)
Diffusion 월드모델은 동작을 조건으로 프레임을 생성하지만, 이 조건화 신호를 어떻게 주입하느냐가 생성된 프레임이 동작과 얼마나 잘 맞아떨어지는지를 좌우합니다. 동작 신호가 U-Net의 일부 층에만 주입된다면, 모델이 동작 조건화를 무시하고 "시각적으로는 그럴듯하지만 동작과는 무관한" 프레임을 만들어낼 수 있습니다.
평가 방법: 같은 초기 프레임에서 출발해 서로 반대되는 두 동작(예: "왼쪽으로 이동", "오른쪽으로 이동")을 각각 조건으로 5스텝짜리 롤아웃을 생성한 뒤, 두 궤적 사이의 분기가 기대되는 동작 효과와 일치하는지 확인합니다. 정확도 지표는 동작 방향 분기율입니다.
깊이 위반율(Depth Violation Rate)
Diamond 평가 체계에서 가장 구체적인 자동화 진단 지표입니다. 물리 일관성 위반이 시각적으로 가장 눈에 띄게 드러나는 형태는 3차원 관계의 역전입니다. 전경에 있어야 할 물체가 배경 물체 뒤에 나타나거나, 두 물체의 가림 관계가 연속된 프레임 사이에서 뒤집히는 경우입니다.
계산 절차:
- DepthAnything(단일 RGB 이미지만으로 장면 속 모든 픽셀의 상대적 깊이를 추정하는 단안 깊이 추정 모델로, 스테레오 카메라나 라이다가 필요 없습니다)으로 각 프레임의 단안 깊이 맵을 추정합니다.
- DINO 특징(위의 물리 일관성 평가 방법 참고)으로 인접 프레임 사이에서 핵심 객체를 매칭해 같은 객체를 추적합니다.
- 같은 객체의 깊이값이 인접 프레임 사이에서 급변하는지(전체 깊이 범위의 20%를 넘는 변화) 확인합니다.
- 깊이 위반율 = 위반 프레임 쌍 수 / 전체 인접 프레임 쌍 수
진단 규칙: 깊이 위반율이 10%를 넘는다면, 동작 정보를 병목에만 주입하지 말고 U-Net의 모든 해상도 층에 주입하고, 손실 함수에 깊이 일관성 제약(인접 프레임의 깊이 맵 차이에 대한 L1 페널티)을 추가하는 것이 좋습니다.
호라이즌 드리프트: 모든 월드모델의 보편적 실패 양상
충분히 긴 롤아웃 아래에서는 모든 아키텍처가 잠재 상태나 생성 콘텐츠가 실제 세계 분포에서 체계적으로 벗어나는 현상을 보입니다. 이것이 호라이즌 드리프트입니다. 드리프트가 구체적으로 나타나는 형태는 아키텍처마다 다릅니다.
| 아키텍처 | 드리프트 양상 |
|---|---|
| RNN/RSSM | 잠재 벡터 z_t가 실제 관측에 대응하는 영역에서 벗어남; PSNR 저하 |
| Transformer(STORM) | 자기회귀 오차가 누적됨; 토큰 예측 잔차가 점점 커짐 |
| Diffusion(Diamond) | 물체의 정체성, 위치, 가림 관계가 긴 시퀀스에 걸쳐 조용히 바뀜 |
| TD-MPC | 잠재 일관성 손실이 커짐; 계획 효율이 떨어짐 |
탐지: 드리프트 곡선
표준 탐지 절차는 다음과 같습니다.
- 실제 초기 상태 배치 하나에서 출발해, teacher forcing 없이 모델이
스텝 동안 자기회귀적으로 롤아웃하게 합니다. - 매 스텝마다 예측 상태와 실제 상태 사이의 차이 지표(PSNR, 구간별 FVD, 또는 코사인 유사도)를 계산합니다.
- 이 값을 스텝 수에 따라 그래프로 그립니다.
이상적인 곡선은 처음 5~10스텝 동안 대략 선형으로 증가하다가 이후 평평해지는 형태입니다.
경고 신호: 처음 5스텝 안에 초깃값보다 30% 넘게 떨어진다면, 모델의 단일 스텝 예측 오차가 지나치게 커서 롤아웃 능력이 사실상 무너졌다는 뜻입니다. 처음 20스텝 안에 수렴하는 기미 없이 단조롭게 나빠진다면, 오차가 계속 누적되고 있다는 뜻으로 모델이 롤아웃 중에 합리적인 상태 분포를 유지하지 못하고 있는 것입니다.
완화 전략
1. 짧은 호라이즌 학습(Short Horizon Training)
억지로 긴 시퀀스를 학습시키는 대신, 학습 시 롤아웃 스텝 수를 모델이 신뢰할 수 있게 예측할 수 있는 범위로 제한합니다. 대부분의 아키텍처에서는 4~8스텝이 견고한 학습 구간이며, 시퀀스가 길어지면 그라디언트에 노이즈가 커져 오히려 단일 스텝 정확도가 나빠질 수 있습니다. 이는 타협이 아니라, "1스텝을 확실하게 예측하는 것"이 "20스텝을 겨우 예측하는 것"보다 계획에 더 쓸모 있다는 사실을 인정하는 것입니다.
2. 타깃 네트워크(Target Network)
시간차(TD) 타깃을 계산할 때, 메인 네트워크 대신 파라미터 업데이트가 더 느린 복제 네트워크(타깃 네트워크)를 사용합니다. 이렇게 하면 오차가 시간 방향으로 역전파되는 것을 끊어, 단일 스텝 예측 오차가 스텝을 거듭하며 누적되는 것을 줄일 수 있습니다. TD-MPC와 Dreamer V3 모두 이 기법을 채택하고 있습니다.
3. 실제 데이터 끼워 넣기(Real Data Interleaving)
상상 롤아웃에 쓰이는 미니배치에 실제 궤적을 주기적으로 끼워 넣어, 모델의 그라디언트가 전적으로 자기 자신의 예측에만 이끌리지 않도록 합니다. 권장 비율은 상상 롤아웃 4스텝마다 실제 데이터 1스텝을 끼워 넣는 것(실제 데이터 25%)입니다. 이는 RSSM의 KL 붕괴를 막아주는 부가 효과도 있습니다.
4. 호라이즌 어닐링(Horizon Annealing)
짧은 롤아웃(예: 1~2스텝)으로 학습을 시작해, 단일 스텝 정확도가 좋아짐에 따라 롤아웃 길이를 점진적으로 늘립니다(예: 1만 스텝마다 1스텝씩 늘려 최대 8스텝까지). 이렇게 하면 학습 초반에 모델이 자기 자신의 저품질 예측으로 스스로를 지도하지 않아도 되어, 부트스트래핑 오차가 줄어듭니다.
더 읽을거리
- Alonso et al. (2024): Diamond: Diffusion 월드모델, NeurIPS 2024, Atari 100k 평균 HNS 1.46
- Zhang et al. (2023): STORM: Transformer 기반 동역학 월드모델, FVD 평가 베이스라인
- Carreira & Zisserman (2017): I3D: FVD가 사용하는 비디오 특징 추출 백본