
계획과 제어: CEM-MPC와 잠재 Actor-Critic
월드모델이 있을 때 에이전트는 이를 어떻게 활용해 동작을 선택할까요? L02의 공 밀기 과제는 RSSM이 후보 동작에 따라 공에 무슨 일이 일어날지 예측할 수 있는 지점에서 멈췄습니다. 이 절이 묻는 것은 그 예측이 어떻게 실제로 미는 동작으로 이어지는가입니다. 이 절은 P03의 직접적인 선행 지식이며, 나중에 아키텍처들을 비교할 때 필요한 계획 관련 배경지식을 제공합니다. 가장 직관적인 무작위 탐색에서 Dreamer의 상상 기반 학습을 거쳐 TD-MPC의 하이브리드 방식에 이르는 세 가지 계획 메커니즘을 소개합니다.
세 가지 계획 메커니즘에 들어가기 전에, 월드모델 아키텍처 하나를 더 소개해야 하는데, 바로 MuZero입니다. 계획과 나란히 다루는 이유는, MuZero의 핵심 특징이 트리 탐색과 떼려야 뗄 수 없기 때문입니다. 그 월드모델 자체가 탐색을 뒷받침하도록 의도적으로 설계되었으므로, 그것을 소비하는 쪽 없이 표현만 이해하면 시스템의 절반만 이해한 셈이 됩니다.
흔한 오해
세 메커니즘을 다루기 전에, "월드모델로 계획한다"는 말이 무엇을 요구하는지에 대한 세 가지 가정을 먼저 바로잡을 필요가 있습니다.
"계획은 MuZero처럼 트리 탐색을 하는 것이다." MCTS는 예측된 가치를 활용하는 한 가지 구체적인 방법일 뿐이며, MuZero가 이산적인 행동 공간에서 트리 형태로 탐색하도록 설계된 것과 묶여 있습니다. CEM-MPC는 트리를 전혀 만들지 않습니다. 여러 동작 시퀀스 전체를 병렬로 샘플링한 뒤 가장 좋은 것들을 중심으로 분포를 다시 맞출 뿐입니다. Dreamer의 Actor-Critic은 의사결정 시점에 탐색을 전혀 하지 않습니다. 정책 네트워크는 상상된 궤적을 거쳐 역전파로 이미 학습되어 있으므로, 실제 각 스텝에서는 그저 동작 하나를 출력하면 됩니다. 트리 탐색은 MuZero라는 특정 설계의 속성이지, 월드모델의 예측을 활용하기 위한 필수 조건이 아닙니다.
"월드모델로 계획하려면 반드시 미분 가능해야 한다." CEM-MPC는 모델을 그저 앞으로 굴려볼 수만 있으면 되는 블랙박스로 취급하며, 모델을 통해 그라디언트를 구하는 일이 전혀 없습니다. 미분 가능성은 Dreamer의 Actor-Critic이 샘플 효율성을 위해 특별히 활용하는 성질이지, 계획 일반이 요구하는 전제조건이 아닙니다. TD-MPC는 이 둘을 명확히 분리해서 보여줍니다. 잠재 동역학은 미분 가능한 일관성 손실로 학습하면서도, 의사결정 시점에는 여전히 그라디언트가 필요 없는 CEM으로 탐색합니다.
"월드모델의 보상 예측을 더 강하게 밀어붙이는 최적화기일수록 항상 더 나은 동작을 찾아낸다." 이는 모델 악용 문제를 간과한 것입니다. 공격적인 최적화기는 그 동작이 실제로 좋아서가 아니라 그 지점에서 모델이 틀렸기 때문에 점수가 높게 나오는 동작을 찾아낼 가능성이 똑같이 있습니다. CEM-MPC가 탐색 결과를 그대로 실행하지 않고 매 스텝마다 다시 계획하는 이유, Dreamer가 상상 구간을 제한하고 주기적으로 실제 데이터로 재학습하는 이유, TD-MPC가 TD 부트스트래핑으로 누적되는 모델 오차를 억제하는 이유가 모두 여기에 있습니다. 세 메커니즘 모두 모델을 더 신뢰하는 대신, 모델 자신의 맹점을 경계하는 데 실질적인 노력을 씁니다.
세 오해는 모두 같은 뿌리를 공유합니다. MCTS, 미분 가능한 역전파, 제약 없는 최적화라는 특정 시스템의 구체적인 공학적 선택을, 월드모델로 계획하는 일반적인 속성인 것처럼 착각하는 것입니다. 실제로 메커니즘마다 달라지는 부분은 훨씬 좁습니다. 최적화기에 그라디언트가 필요한지, 탐색 트리가 필요한지, 그리고 모델 자신의 오차를 스스로 악용하지 않도록 어떻게 막는지입니다.
MuZero와 반사실적 패러다임
반사실적 추론을 극단까지 밀어붙이는 부류의 과제도 있는데, 바로 픽셀 예측을 아예 포기하고 가치나 보상이라는 추상적인 레벨에서만 정확한 예측을 하는 반사실적 패러다임입니다. 이 패러다임을 대표하는 MuZero(Nature, 2020)는 월드모델을 세 함수로 분해합니다.
- 표현 함수
: 과거 관측 를 내부 은닉 상태로 압축합니다. - 동역학 함수
: 이전 은닉 상태와 후보 동작이 주어지면 즉시 보상과 다음 은닉 상태를 예측합니다. - 예측 함수
: 은닉 상태로부터 정책 사전 분포와 가치를 예측합니다.
세 함수는 다음 손실로 엔드투엔드 공동 학습됩니다.
기호 설명은 다음과 같습니다.
MuZero는 세 개의 예측 헤드를 유지합니다.
| 예측 헤드 | 예측 대상 | 역할 |
|---|---|---|
| reward head | 즉시 보상 | 현재 스텝의 좋고 나쁨을 평가 |
| value head | 미래 누적 가치 | MCTS 탐색 방향을 유도 |
| policy prior | 동작 확률 분포 | MCTS가 탐색해야 할 분기 수를 줄임 |
세 헤드 모두 전개된 동역학 함수를 통해 실제 상호작용 데이터로 공동 학습됩니다.
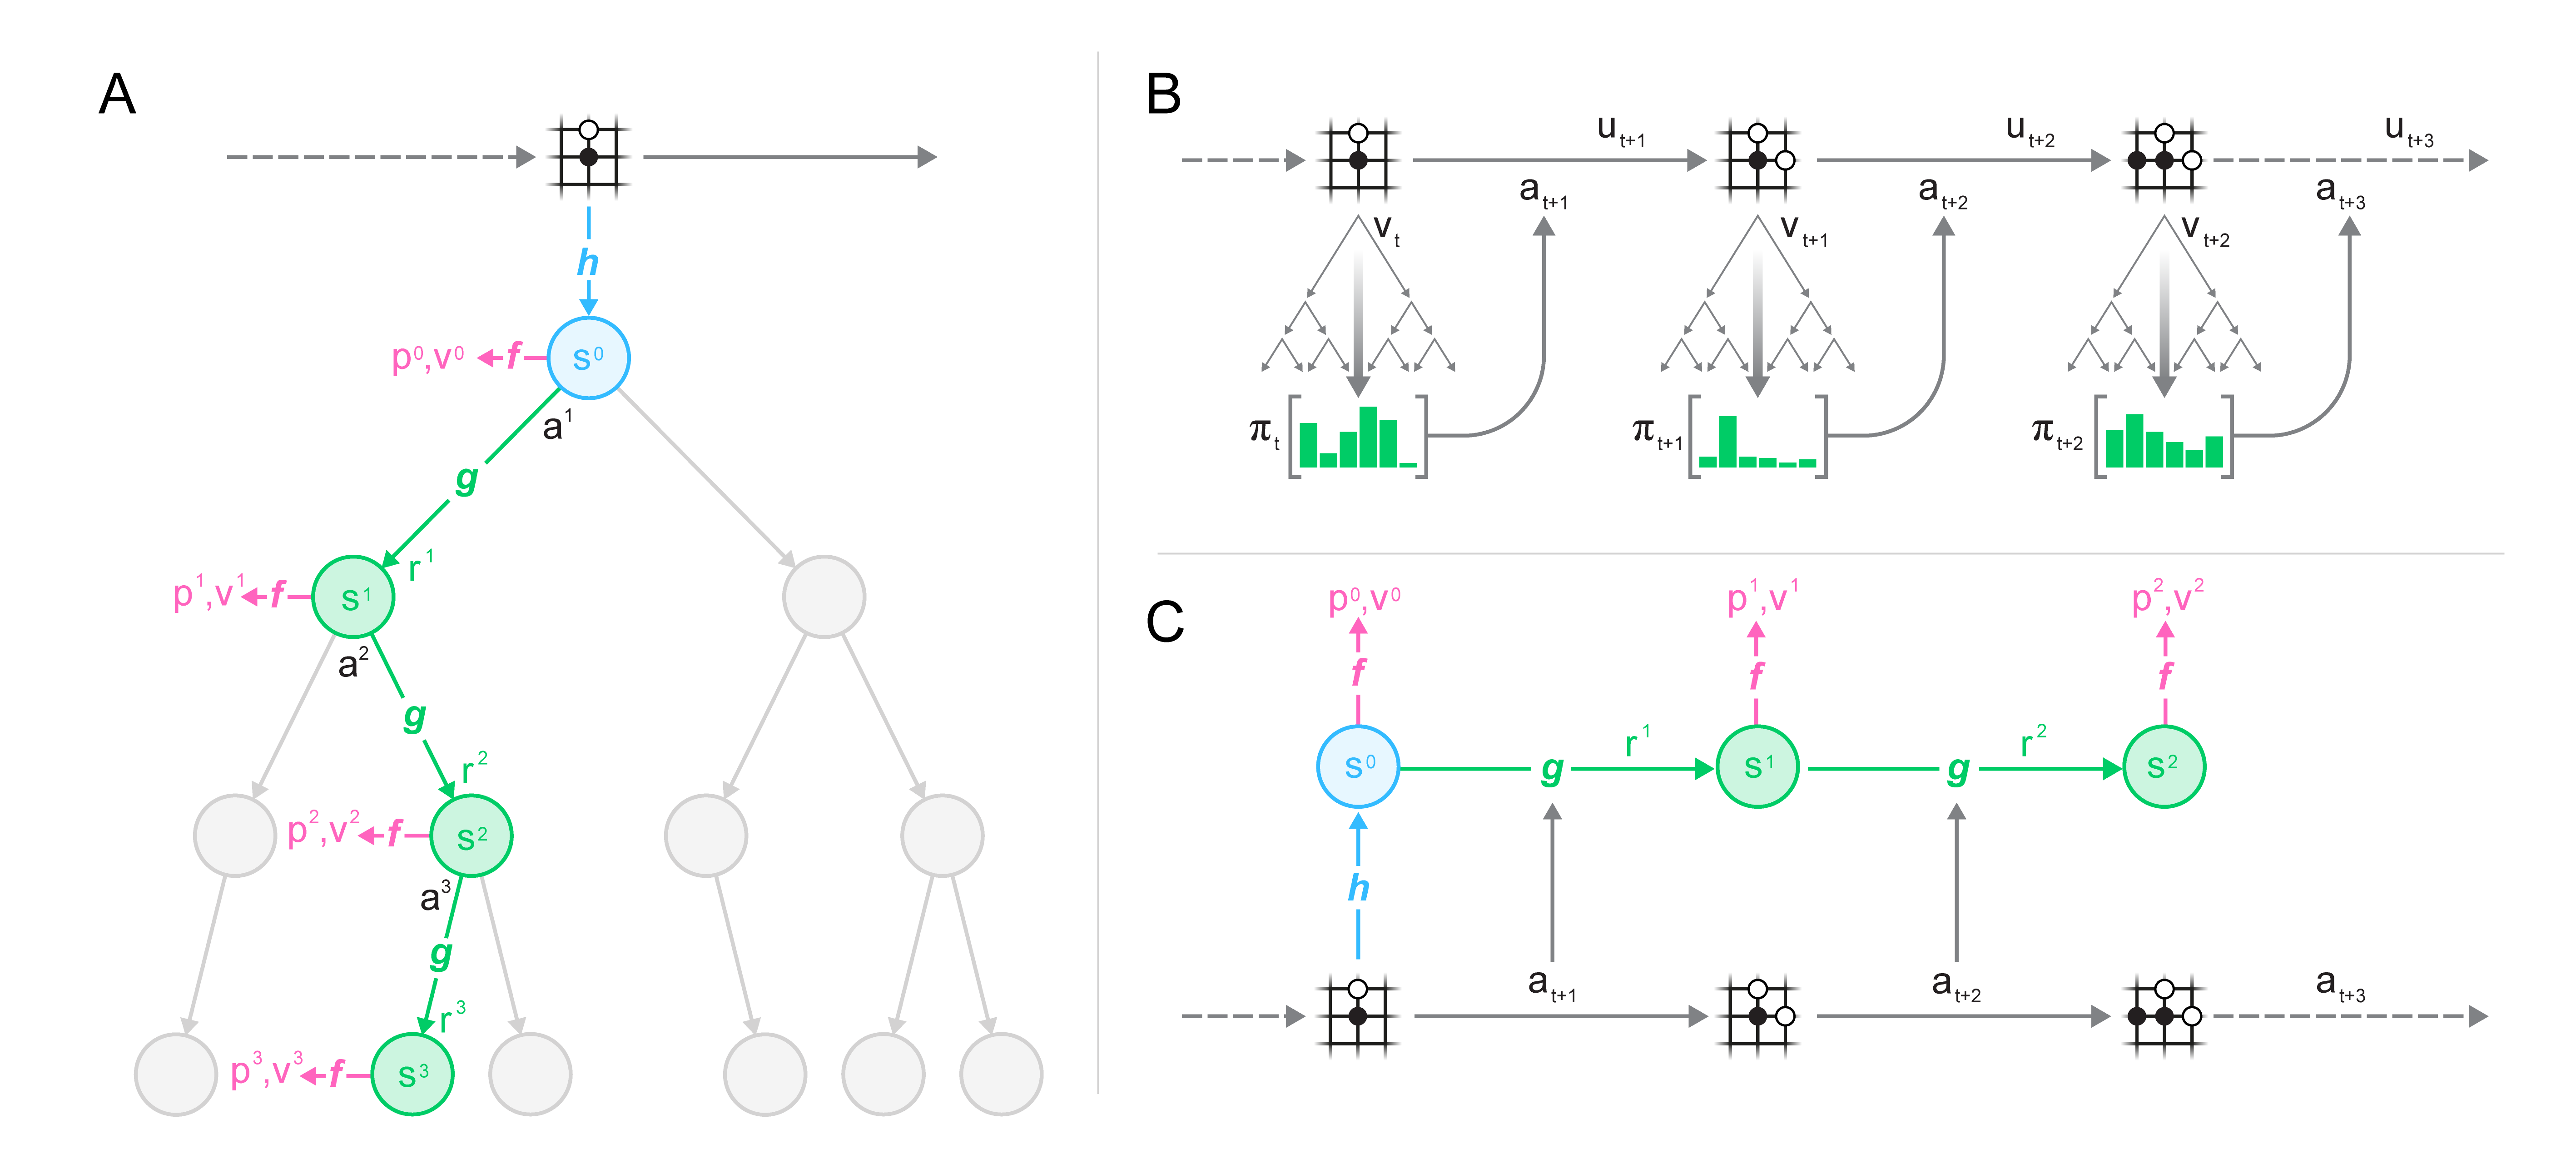
이 세 예측 헤드만 정확하다면 잠재 상태
📖 MCTS(Monte Carlo Tree Search, 몬테카를로 트리 탐색): 현재 상태에서 출발해 네 단계를 반복합니다. (1) 선택(Select): 트리를 따라 내려가면서 UCB 점수(Upper Confidence Bound, 신뢰 상한,
이며, 는 해당 동작의 평균 가치, 은 부모 노드의 총 방문 횟수, 는 해당 동작의 방문 횟수, 는 탐색 계수입니다. UCB는 "알려진 좋은 동작을 선택하는 것"과 "방문 횟수가 적은 동작을 탐색하는 것" 사이의 균형을 잡아줍니다)가 가장 높은 노드를 선택합니다. (2) 확장(Expand): 리프 노드에서 새 동작을 시도합니다. (3) 시뮬레이션/평가(Simulate/Evaluate): 신경망으로 새 노드의 가치를 추정합니다(MuZero는 롤아웃 없이 value head를 곧바로 사용합니다). (4) 역전파(Backpropagate): 경로를 따라 위로 가치 추정을 갱신합니다. 수백 번 반복한 뒤 가장 많이 방문된 동작이 바로 "충분히 탐색한 끝에 최적이라고 판단된 동작"입니다. MuZero가 AlphaZero에서 확장한 핵심은 단일 에이전트 영역(2인 게임뿐 아니라)과 중간 스텝 보상(아타리)을 지원한다는 것이며, 가치 타깃도 최종 승패가 아니라 스텝 부트스트래핑으로 구성합니다.
메커니즘 1: CEM 슈팅법 MPC
📖 CEM과 MPC: CEM(Cross-Entropy Method, 교차 엔트로피 방법)은 샘플링 기반 최적화 알고리즘입니다. 어떤 분포(예: 가우시안)에서 대량의 후보 해를 샘플링하고, 상위 일부(엘리트 샘플)만 남겨 이 엘리트 샘플들로 분포를 다시 맞춘 뒤, 이를 반복해 샘플링이 점점 고품질 영역으로 집중되게 만듭니다. 여기서는 동작 시퀀스 공간을 탐색하는 데 쓰이므로 "슈팅법(shooting method)"이라 부릅니다. MPC(Model Predictive Control, 모델 예측 제어)는 그 결과를 어떻게 쓰는지를 정합니다. 매 시점마다 모델로 미래
스텝을 예측하고 최적의 동작 시퀀스를 골라 그중 첫 번째 동작만 실행한 뒤, 다음 스텝에서 다시 계획을 세웁니다. 모델이 완벽하지 않더라도 잦은 재계획이 오차를 바로잡아줄 수 있습니다.
한 문장으로 요약하면, 동작 시퀀스 배치 하나를 무작위로 샘플링해 모델 안에서 "상상으로" 실행해보고, 기대 리턴이 가장 높은 시퀀스를 골라 그 첫 스텝만 실행한 뒤 이를 반복하는 방식입니다.
알고리즘 단계:
CEM-MPC 계획 루프(매 스텝마다 1회 실행)

입력: 현재 상태 s_t, 월드모델 f, 보상 모델 r, 계획 스텝 수 H, 정제 라운드 수 K

1. 동작 분포 초기화: μ ← 0, σ ← 1

2. FOR k = 1 to K (정제 라운드):
   a. N(μ, σ²)에서 N개의 동작 시퀀스를 샘플링: {a^(i)_{t:t+H}}
   b. FOR 각 시퀀스 i:
        상상 궤적 전개: s^(i)_{t+1} = f(s_t, a^(i)_t), ..., s^(i)_{t+H}
        누적 보상 계산: R^(i) = Σ_{h=0}^{H-1} γ^h · r(s^(i)_{t+h}, a^(i)_{t+h})
        # γ(감마)는 할인율로, 0 < γ < 1이며 미래 보상의 가중치를 스텝 수에 따라 지수적으로 감소시킴
        # γ=0.99이면 100스텝 뒤의 보상도 현재 가치의 0.99^100 ≈ 0.37배로 유지됨
   c. R^(i) 내림차순으로 상위 K개 시퀀스 선택
   d. 상위 K개 시퀀스로 재적합: μ ← mean(Top-K), σ ← std(Top-K)

3. μ의 첫 번째 동작을 실행: a_t ← μ[0]
직접 계산해보기: 어느 정제 라운드에서 후보 동작 시퀀스 5개를 샘플링했고, 상상 전개 결과 누적 보상이
다음 라운드는
첫 라운드의 샘플링은 넓은 범위를 낮은 정밀도로 훑어 "높은 보상 영역이 대략 어디인지"를 찾아냅니다. 이후 라운드에서는 엘리트 시퀀스로 분포를 다시 맞춰, 샘플링 범위를 높은 보상 영역으로 점점 좁혀갑니다.
한계: 고차원 연속 동작 공간(예: 로봇 팔이 7개 관절을 동시에 제어)에서는 무작위 탐색의 효율이 극도로 떨어집니다. 이것이 바로 TD-MPC가 해결하려는 핵심 문제인데, 맹목적으로 샘플링하는 대신 Q함수로 탐색을 유도하는 것입니다.
장점: 단순하고, 그라디언트가 필요 없으며, 구현이 쉽고, 월드모델의 미분 가능성에 대한 요구가 없습니다.
메커니즘 2: 잠재 공간에서의 Actor-Critic(Dreamer의 방식)
📖 Actor-Critic 아키텍처: 두 네트워크로 구성됩니다. Actor(정책 네트워크
)는 "의사결정"을 맡고, Critic(가치 네트워크 )은 "평가"를 맡습니다. Critic이 제공하는 베이스라인(baseline)은 그라디언트 추정의 분산을 크게 낮춰 학습을 더 안정적으로 만들어줍니다.
Dreamer의 핵심 통찰은 이렇습니다. 실제 환경에서 대량의 데이터를 수집해 정책을 학습시키는 대신, 월드모델의 상상 궤적 안에서 학습시키는 편이 더 빠르고 위험이 없으며 미분 가능하다는 것입니다.
학습 절차:
- 상상 전개: 현재 잠재 상태
에서 출발해 Actor로 동작을 샘플링하고 RSSM으로 스텝을 굴려 예측합니다. - Critic 평가: 상상된 각 상태에 대해
를 계산하고, -return으로 학습 타깃을 구성합니다. - Actor 최적화: Actor는 상상 궤적 전체를 가로지르는 역전파를 통해 Critic이 예측한 누적 가치를 최대화합니다.
- 월드모델 갱신: 실제 환경 데이터(재구성 손실 + KL)로 RSSM과 인코더를 갱신합니다.
미분 가능성이 중요한 이유: Actor의 그라디언트는 RSSM의 미분 가능한 동역학을 직접 통과해 흐르며, 이는 몬테카를로 샘플링으로 정책 그라디언트를 추정하는 것보다 훨씬 정확합니다.
모델 악용(Model Exploitation) 문제: 정책이 모델 안에서는 높은 보상을 받지만 실제 세계에서는 성립하지 않는 동작을 찾아낼 수 있습니다. 예를 들어 고빈도 진동 동작이 월드모델 안에서는 높은 점수를 받지만, 실제 로봇에서는 모터만 망가뜨릴 뿐입니다. Dreamer 시리즈는 실제 환경 데이터로 월드모델을 주기적으로 갱신하고 상상 전개 스텝 수를 제한하는 방식으로 이 문제를 완화하지만, 근본적으로 해결하지는 못했습니다.
CEM은 고차원 동작 공간에서 효율이 낮고, Actor-Critic은 모델 악용 위험을 안고 있습니다. TD-MPC의 핵심 가치는 바로 이 둘을 결합해 두 문제를 동시에 완화한다는 데 있습니다.