
각 노선의 핵심 베팅과 마무리 질문
각 노선의 핵심 베팅
L03에서는 이미 아홉 가지 주요 아키텍처 계열의 장단점을 공학적 선택의 관점에서 비교했습니다. 여기서는 관점을 바꿔, 각 노선이 어떤 가정에 베팅하고 있으며 그 가정이 맞다면 무엇을 뜻하는지를 살펴봅니다.
| 아키텍처 노선 | 핵심 베팅 | 베팅이 맞다면 |
|---|---|---|
| RNN/RSSM | 물리 세계의 핵심 동역학은 픽셀 단위 재구성 없이도 압축된 순환 상태로 표현할 수 있다 | Dreamer 방식의 샘플 효율적인 RL이 복잡한 실제 과제로 확장될 수 있다 |
| Transformer | 지능의 핵심은 장거리 시퀀스 의존성이며, 통일된 어텐션 메커니즘이 수작업으로 설계한 상태 분리보다 더 강력하다 | STORM/Dreamer V4 계열이 범용 월드모델 백본으로 수렴할 것이다 |
| Diffusion | 물리 세계의 규칙성은 픽셀 분포 안에 담겨 있으며, 고품질 생성 자체가 곧 이해다 | 충분히 큰 Diffusion 모델은 명시적인 모델링 없이도 물리적 추론 능력을 자동으로 발달시킬 것이다 |
| JEPA | 픽셀은 노이즈이고 의미가 신호이며, 예측은 지각이 아니라 추상적 표현 레벨에서 일어나야 한다 | 픽셀을 생성하지 않는 모델이 생성 모델보다 더 빨리 물리적 이해에 도달할 것이다 |
| RWM | 로보틱스에서 진짜 병목은 단순한 생성 품질이 아니라 장기 롤아웃 안정성과 정책 악용에 대한 내성이다 | 불확실성을 인지하고 self-forcing으로 학습된 월드모델이 더 큰 백본보다 먼저 실제 하드웨어에 배포될 것이다 |
| 공간 3D/4D | 물체 지속성과 다중 시점 일관성에는 충분히 큰 평평한 잠재 벡터가 아니라 명시적인 3D 기하 구조가 필요하다 | 장면 수준의 3D 표현이 엠보디드 AI와 자율주행 월드모델의 기본 상태 형식이 될 것이다 |
| Genie | 동작은 쌍을 이룬 동작 레이블 없이도 레이블 없는 비디오에서 발견될 수 있다 | 텔레오퍼레이션 데이터가 아니라 인터넷 규모의 비디오가 상호작용형 월드모델의 주된 데이터 원천이 될 것이다 |
| LoopWM | 동역학 모델의 실질적인 깊이는 순환적이고 스펙트럼 안정화된 연산을 통해 파라미터 수와 분리될 수 있다 | 반복적인 잠재 깊이가 모델 크기, 데이터양과 나란한 세 번째 스케일링 축이 될 것이다 |
| WAM | 월드모델과 정책은 분리된 두 모듈이어서는 안 되며, 비디오 자체가 동작 학습의 지도 신호다 | 공동 학습이 모델 기반과 정책 학습 사이의 분업을 깨뜨려 새로운 창발적 능력을 만들어낼 것이다 |
| CWM | 코드 실행 공간도 명시적으로 모델링할 수 있는 일종의 "세계"이며, LLM은 프로그램 상태 전이를 예측하는 법을 배워야만 비로소 코드를 진짜로 이해한 것이다 | 월드모델 접근법이 물리적 지각뿐 아니라 디지털 공간으로도 전이될 수 있다 |
이 베팅들은 서로 배타적이지 않지만, "지능의 핵심이 무엇인가"에 대한 답은 서로 충돌합니다. RNN파는 상태 표현이 핵심이라 보고, Transformer파는 시퀀스 모델링이 핵심이라 보며, Diffusion파는 생성 품질이 핵심이라 봅니다. JEPA파는 의미적 추상화가 핵심이라 보고, RWM파는 배포 신뢰성이 핵심이라 보며, 공간 3D/4D파는 명시적 기하 구조가 핵심이라 봅니다. Genie파는 레이블 없는 비디오에서 동작을 발견하는 것이 핵심이라 보고, LoopWM파는 반복적 깊이가 핵심이라 보며, WAM파는 동작과 지각의 공동 모델링이 핵심이라 봅니다. 그리고 CWM은 언어파와 월드모델파에 걸쳐 있는 질문을 던집니다. "세계"가 Python 인터프리터이고 LLM이 그 안에서 예측하는 법을 배운다면, 그것은 어느 쪽에 속할까요?
이 논쟁은 논문으로는 결판나지 않으며, 앞으로 몇 년간의 벤치마크가 답을 강제로 끌어낼 것입니다.
CWM: 코드 실행 공간의 월드모델
CWM은 비교를 위해 다루는 도메인 확장 사례이지, 제3강의 열 번째 동역학 백본 계열이 아닙니다. 아홉 계열을 다루는 비교는 물리적 예측이나 시각적 예측에 쓰이는 아키텍처를 분류하는 반면, CWM은 모델링 대상 환경이 프로그램 인터프리터일 때도 같은 역량 기준을 그대로 적용할 수 있는지를 묻습니다.
물리 세계의 월드모델은 픽셀, 관절 각도, 센서 값을 예측합니다. 하지만 "세계"가 꼭 물리적일 필요는 없습니다. Meta가 2024년 발표한 CWM(Code World Model, arXiv:2510.02387)은 이 발상을 코드 실행 공간으로 확장합니다. Python 인터프리터 자체가 결정론적 동역학 시스템이라는 것입니다. 코드를 한 줄 실행할 때마다, "현재 프로그램 상태"에 "동작"을 가해 "다음 프로그램 상태"를 만들어냅니다.
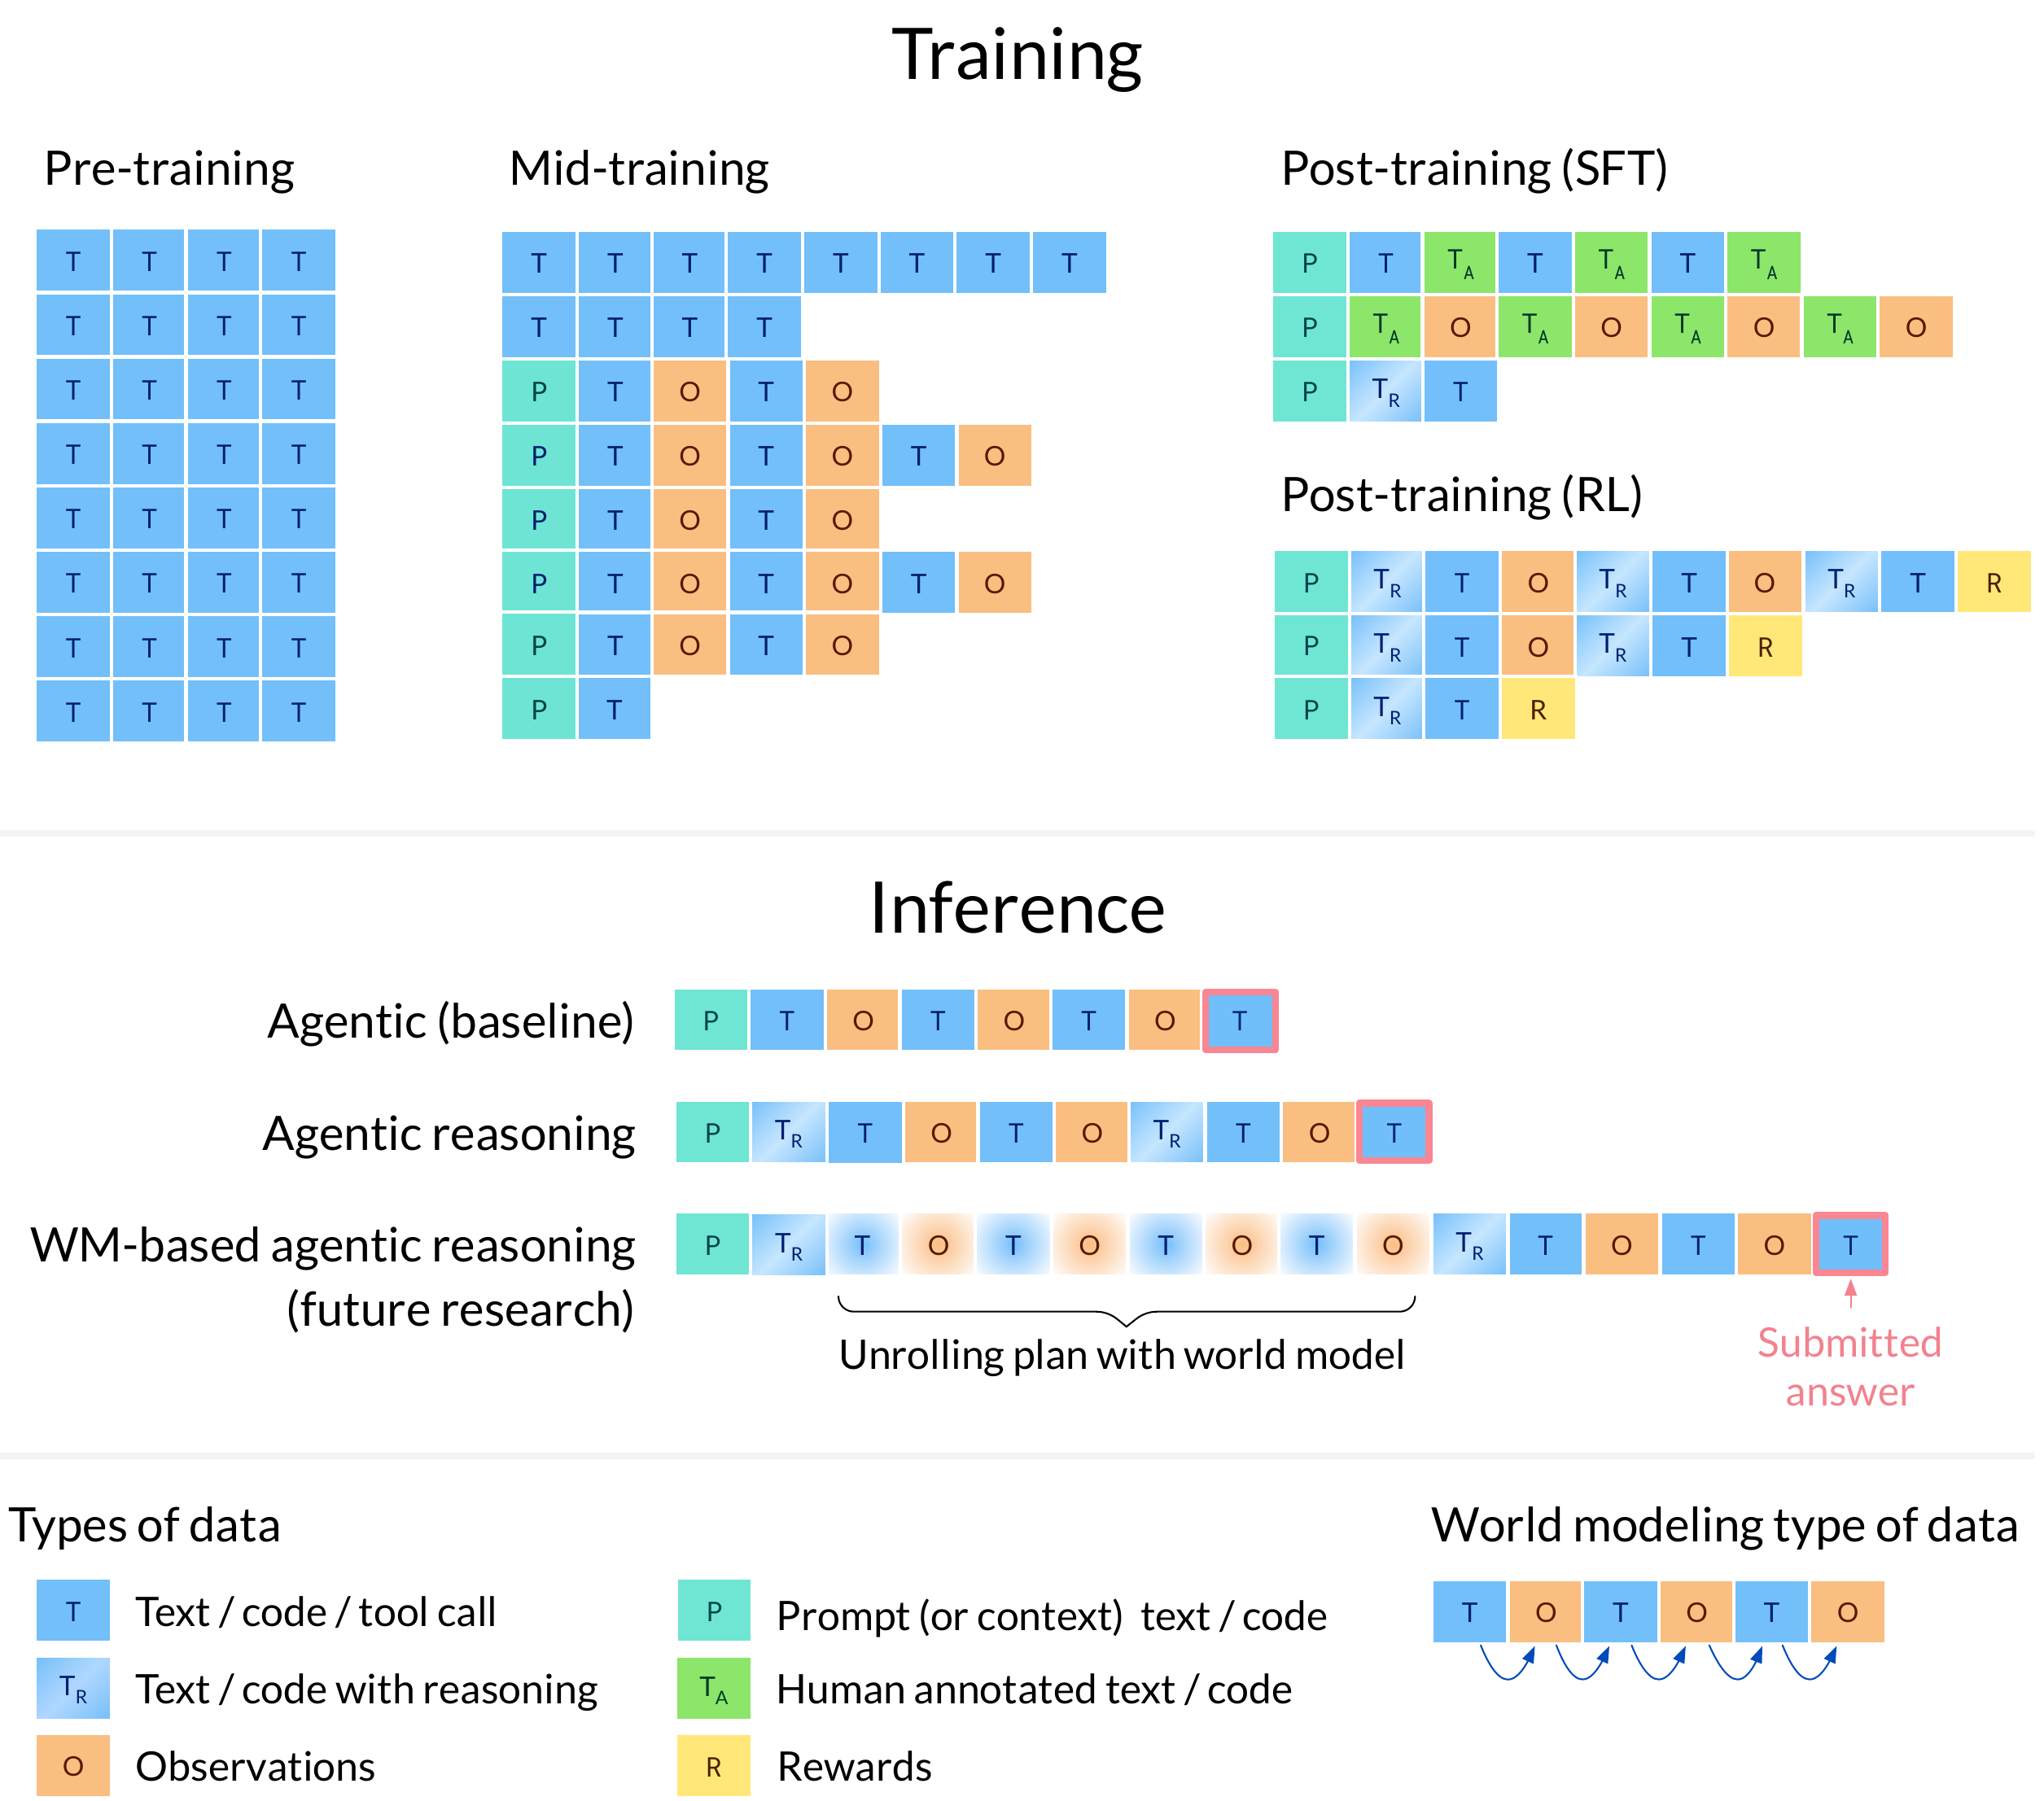
CWM은 320억 파라미터짜리 오픈소스 LLM으로, 사전학습 이후 중간 학습(mid-training)을 거쳤으며, 두 가지 유형의 실행 궤적을 사용합니다.
- Python 실행 궤적: 동작 = Python 문장 하나, 관측 = 실행 후 지역 변수의 전체 상태(변수명, 타입, 값). 학습 목표는 모델에게 "이 줄이 문법적으로 맞는가"가 아니라 "이 줄이 실행된 뒤 메모리에 무엇이 담기는가"를 가르치는 것입니다.
- ForagerAgent 궤적: Docker 컨테이너 안에서 소프트웨어 공학 과제를 자율적으로 수행하는 에이전트로, 코드를 수정하고 오류 출력을 관찰한 뒤 다시 수정하는 과정을 대규모 궤적으로 생성합니다. 동작은 셸 명령이나 코드 수정이고, 관측은 터미널 응답입니다.
이 설계는 물리 세계 월드모델의 RSSM 프레임워크와 거의 일대일로 대응됩니다. 인코더가 프로그램 상태를 표현으로 압축하고, 동역학 함수가 다음 상태를 예측하는데, 유일한 차이는 "물리 엔진"이 "Python 인터프리터"로 바뀌었다는 것뿐입니다.
왜 이것이 경계의 문제일까요? CWM의 존재는 언어파와 월드모델파 사이의 경계를 흐릿하게 만듭니다. CWM은 Transformer 아키텍처(언어파의 주력 도구)를 쓰고, 자연어 텍스트에 코드를 더한 데이터(언어파의 데이터)로 학습하지만, 학습 목표는 프로그램 실행 상태의 동적 변화를 예측하는 것(월드모델파의 핵심 주장)입니다. CWM이 결국 "코드를 이해한다는 것 = 인터프리터 안에서 예측할 수 있다는 것"임을 입증한다면, 다음 질문은 이것입니다. 물리를 이해한다는 것도 "물리 엔진 안에서 예측할 수 있다는 것"을 뜻할까요? 이 질문의 답은 두 진영 모두의 미래와 맞닿아 있습니다.
비주류의 베팅
Saining Xie는 자신이 하는 일이 주류가 아니라는 걸 알고 있습니다.
"우리를 믿지 않아도 되고, 두고 보면 됩니다. 저는 지금 이 길에 올인했는데, 당신도 함께하시겠습니까?"
2012년의 Hinton도 같은 어조였습니다. 2016년의 Sutton(Richard Sutton, 강화학습 분야의 창시자 중 한 명이자 《Reinforcement Learning: An Introduction》의 저자로, 앞서 나온 Bitter Lesson을 쓴 바로 그 연구자)도 마찬가지였는데, 대부분이 믿지 않을 때 강화학습을 밀어붙이며 다수가 거부한 방향에 올인했습니다.
LeCun의 낙관은 범위가 더 넓지만, 방향은 일관됩니다.
"이건 예전에 딥러닝과 신경망에서 일어났던 일과 정확히 똑같습니다. 세상이 어디로 향하는지 명확히 보는 소수의 사람들은 언제나 존재합니다."
나란히 놓고 보면, 이 두 발언은 선언이자 동시에 위험 고지이기도 합니다. 역사를 보면 소수 집단이 옳았던 경우도 분명 있습니다. 하지만 더 많은 소수 집단은 끝내 자신들이 기다리던 그 전환점을 보지 못했습니다.
월드모델 연구자들의 베팅은 이렇습니다. 언어는 사고의 기반이 아니며, 물리 세계를 예측하고 이해하는 것이 지능의 핵심이라는 것입니다. 만약 그들이 옳다면, 향후 10년간 AI의 중심은 실리콘밸리의 데이터센터가 아니라 공장, 병원, 농장의 센서 네트워크가 될 것입니다.
만약 그들이 틀렸다면, Scaling Law는 계속 유효할 것이고, LLM은 더 많은 데이터와 더 큰 모델을 통해 점차 물리적 이해에 다가갈 것입니다. 월드모델을 거쳐서가 아니라, 언어를 거쳐서 말입니다.
앞으로 이어갈 세 가지 질문
질문 1: 언어는 월드모델로 가는 "지름길"일까요, 아니면 "빠른 길"일까요?
"지름길"이란 진짜 어려운 과제를 우회한 길이라, 결국은 막다른 곳에 다다른다는 뜻입니다. "빠른 길"이란 더 효율적인 경로를 택했을 뿐, 결국 같은 목적지에 도달한다는 뜻입니다. 이 둘의 차이가 LLM의 한계가 어디에 있는지를 결정합니다.
질문 2: Sutton의 Bitter Lesson이 옳다면, 월드모델도 자신만의 Bitter Lesson 순간을 맞이하게 될까요?
언젠가 AlphaZero가 Deep Blue를 뛰어넘고 Transformer가 LSTM을 뛰어넘었듯, "더 단순하고 더 일반적인" 방법이 나타나 월드모델파가 공들여 설계한 아키텍처를 단번에 추월하게 될까요? Bitter Lesson 자체도 스스로의 Bitter Lesson을 가질 수 있을까요?
질문 3: 월드모델은 모두가 결국 도달하게 될 종착지일까요, 아니면 여러 갈래 길 중 하나일까요?
어쩌면 최종적인 답은 "누가 이겼는가"가 아니라, 서로 다른 응용 분야가 서로 다른 기술 노선으로 수렴한다는 것일지도 모릅니다. 언어 생성과 코드 어시스턴트는 LLM 노선을, 로보틱스·산업 제어·자율주행은 월드모델 노선을 따르고, 어쩌면 여러분과 제가 가장 자주 마주하는 어떤 과제들은 영원히 그 둘 사이의 회색지대에 남아 있을지도 모릅니다.
만약 그렇다면, 이 논쟁의 의의는 승자를 가리는 데 있는 것이 아니라, 우리가 다음을 더 명확히 이해하도록 돕는 데 있습니다. 우리가 실제로 풀려는 문제는 무엇이며, 우리가 걷고 있는 길은 어디로 향하는가.