
잠재 동역학
인코더만으로는 부족하다: 미래를 예측해야 한다
탁자 위의 공이라는 예시가 앞의 두 페이지를 관통했습니다. 한 프레임은 속도를 확정하지 못하고, 그 프레임을 압축하는 인코더도 속도를 보존한다는 보장이 없습니다. VAE는 현재 프레임
잠재 공간에서, 현재 상태
와 동작 가 주어졌을 때 다음 상태 을 예측합니다.
이 예측 능력 덕분에 에이전트는 머릿속으로 미래를 "시뮬레이션"하며 실제로 동작을 실행하지 않고도 계획을 세울 수 있는데, 월드모델이 샘플 복잡도를 줄이는 핵심 이유가 바로 여기에 있습니다.
가장 단순한 동역학 모델: GRU
게이트 순환 유닛(Gated Recurrent Unit, GRU)은 시퀀스 모델링의 기본 도구입니다. 동역학 모델로서 GRU는
📖 GRU 내부 구조(요약): GRU는 두 개의 "게이트"로 정보 흐름을 제어합니다. 리셋 게이트(reset gate)는 "과거를 얼마나 잊을지"를 결정하고, 업데이트 게이트(update gate)는 "기존 상태를 얼마나 유지하고 새 정보를 얼마나 반영할지"를 결정합니다. 게이트 값은 0과 1 사이이며 현재 입력과 이전 은닉 상태에 의해 함께 결정됩니다. 이 덕분에 GRU는 관련 없는 정보는 버리면서도 장기 의존성은 선택적으로 유지할 수 있어, 일반 RNN보다 긴 시퀀스를 더 잘 다룹니다. LSTM과 비교하면 GRU는 게이트가 하나 적고(별도의 메모리 셀이 없음) 파라미터도 더 적어 학습 속도가 더 빠릅니다.
GRU의 장점은 단순함과 안정적인 학습이고, 한계는 결정론적 예측만 내놓을 뿐 불확실성을 표현하지 못한다는 점입니다. 실제 환경에서는 같은 동작이 여러 다른 결과로 이어질 수 있습니다. 앞에서 다룬 공을 밀면 매끄럽게 굴러갈 수도 있고, 화면 밖의 무언가에 부딪혀 멈출 수도 있는데, 결정론적 예측 하나로는 이 두 가능성을 동시에 표현할 수 없습니다.
MDN-RNN: 불확실성 모델링하기
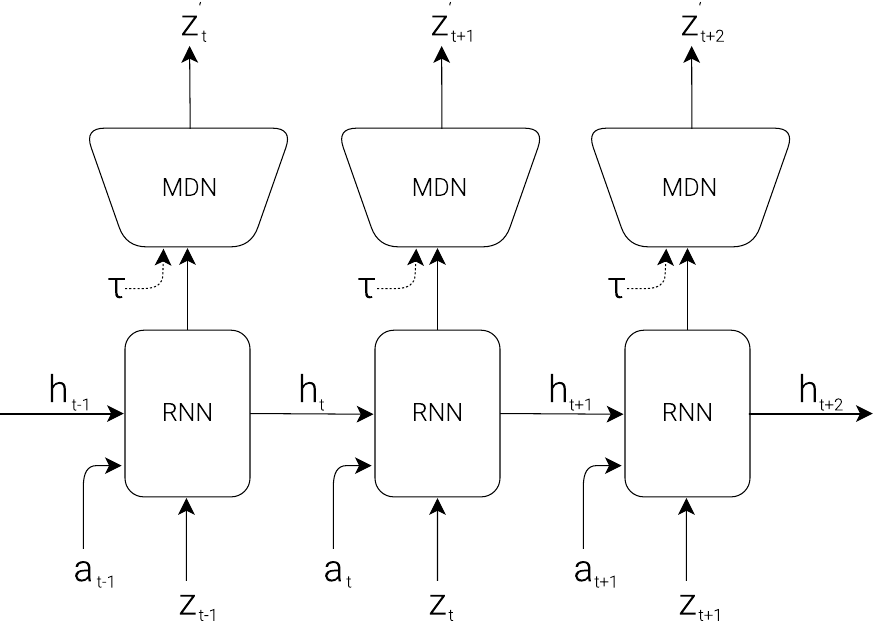
Ha & Schmidhuber, 2018에서 제안된 MDN-RNN(Mixture Density Network + RNN)은 가우시안 혼합 분포를 이용해 다음 상태의 불확실성을 모델링합니다.
개의 가우시안 성분이 있으며, 각각 고유한 평균 (분포의 중심)와 분산 (분포의 폭)를 가집니다 - 혼합 가중치
: 번째 가우시안 성분의 확률 질량으로, , 을 만족합니다. " 번째 미래가 일어날 확률"로 해석할 수 있습니다. 네트워크는 값을 출력한 뒤 소프트맥스로 정규화해 가중치의 합이 1이 되도록 합니다.
MDN-RNN은 다봉 분포를 포착할 수 있습니다. 환경이 여러 개의 서로 다른 다음 상태로 전이할 수 있을 때, 모델은 그 모든 가능성을 표현할 수 있습니다.
RSSM: 결정론적 요소와 확률적 요소의 분리
RSSM(Recurrent State Space Model, 순환 상태 공간 모델)은 PlaNet에서 처음 도입되었고 이후 Dreamer 시리즈의 핵심 상태 모델이 되었습니다. RSSM은 상태를 두 부분으로 나눕니다.
- 결정론적 은닉 상태
: RNN이 유지하며, 과거 궤적의 정보를 축적할 뿐 확률성이 없습니다 - 확률적 잠재 상태
: 를 조건으로 하는 분포에서 샘플링되며, 현재의 불확실성을 표현합니다
RSSM의 핵심 방정식:
📖 아래첨자
(파이): , , 에 붙은 아래첨자 는 "이 함수의 파라미터가 "라는 뜻으로, 신경망의 학습 가능한 가중치를 가리킵니다. 는 " 를 파라미터로 갖는 함수 "라고 읽습니다. 학습 중에는 경사하강법이 를 업데이트해 이 함수들의 예측이 점점 더 정확해지도록 만듭니다. 이후 등장하는 (세타)도 마찬가지로, 또 다른 학습 가능한 파라미터 집합을 가리킬 때 흔히 쓰이는 기호입니다.
📖 사전 확률 vs 사후 확률: 베이즈 통계의 기본 개념입니다. 사전 확률(prior)은 "데이터를 보기 전의 추정"으로, RSSM이 이력
만으로 현재 상태 에 대해 세우는 추측입니다. 사후 확률(posterior)은 "데이터를 본 뒤 갱신된 추정"으로, 실제 관측 로 사전 확률을 보정해 더 정확한 추정치를 얻습니다. 학습 중에는 사후 확률이 를 생성하고 KL 손실을 계산합니다(사전 확률과 사후 확률의 격차를 측정). 추론이나 상상 단계에서는 실제 가 없으므로 사전 확률만 사용할 수 있고, RSSM은 사전 확률만으로 앞으로 나아갑니다.
왜 분리하는가?
| 상태 | 역할 | 성질 |
|---|---|---|
| 기억 | 결정론적, 이력을 축적 | |
| 지각 | 확률적, 불확실성을 표현 |
이렇게 분리하고 나면, 모델은 실제 관측 없이 사전 확률
PlaNet 논문(Hafner et al., ICML 2019)은 제거 실험(ablation study, 모델의 특정 구성요소를 체계적으로 제거하고 성능 변화를 관찰함으로써 그 구성요소의 필요성을 검증하는 방법)을 통해 이 설계를 검증했습니다. 순수하게 확률적인 경로만 있으면(결정론적
직접 계산해보기(단순화된 단일 스텝 전이): 실제
사전 확률 네트워크(이 역시 선형층 하나로 단순화)에서
마지막으로 재매개변수화 트릭으로
이 연쇄 계산은 RSSM 한 스텝 전이의 전체 데이터 흐름, 즉 GRUCell이고(위 GRU 콜아웃 참고) 사전 확률 네트워크도 선형층 하나보다 복잡하므로 실제 수치는 다르겠지만, 데이터가 거쳐 가는 각 단계는 위 계산 과정과 완전히 같습니다. P02는 같은 숫자를 이 단순화된 연쇄에 그대로 넣어 공식과 코드가 일치하는지 검증합니다.
세 가지 동역학 모델 비교
| 모델 | 불확실성 모델링 | 기억 메커니즘 | 주요 용도 |
|---|---|---|---|
| GRU | 없음(결정론적 출력) | 고정 차원 은닉 상태 | 단순 시퀀스 예측, 빠른 프로토타이핑 |
| MDN-RNN | 가우시안 혼합(다봉 분포) | 고정 차원 은닉 상태 | 다봉 불확실성, Ha & Schmidhuber의 M 모듈 |
| RSSM | 사전/사후 확률 분리(가우시안) | 이중 경로: 결정론적 | Dreamer의 핵심, 순수 상상 계획 지원 |
세 모델은 하나의 발전 과정을 이룹니다. GRU가 시퀀스 모델링의 토대를 놓고, MDN-RNN이 불확실성을 도입하며, RSSM은 여기서 한 걸음 더 나아가 "기억"과 "지각의 불확실성"을 분리해 실제 관측 없이도 모델이 앞으로 나아가며 계획을 세울 수 있게 합니다.
다음으로 학습 분포와 자유 롤아웃을 읽고 이 모델들이 자신의 예측을 반복해서 입력으로 사용할 때 어떤 일이 일어나는지 살펴보세요. P02 전에 이 내용을 익히면 단일 스텝 오차와 장기 표류의 차이가 더 구체적으로 보입니다.