
논쟁 1과 2: 언어라는 아편, 그리고 Bitter Lesson
지능을 바라보는 두 시각의 분기점
2024년의 시점에서 돌아보면, AI 연구에는 뚜렷한 갈림길이 나타났습니다.
언어파는 지능의 핵심이 상징적 추론과 언어 이해에 있다고 봅니다. LLM이 AGI(Artificial General Intelligence, 범용 인공지능. 특정 과제만 처리하는 "협소한 AI"와 달리, 모든 인지 과제에서 인간과 동등하거나 그 이상의 성능을 내는 AI 시스템을 가리킵니다)로 가는 올바른 길이며, Scaling Law(스케일링 법칙. 파라미터 수, 데이터양, 연산량이 늘어날수록 모델 성능이 예측 가능한 방식으로 향상된다는 경험적 규칙성으로, Kaplan et al.(2020)이 처음으로 체계적으로 연구했습니다)가 그 답이라고 믿습니다. GPT-4, Claude, Gemini의 성공이 이 길을 계속 입증하고 있습니다. 실리콘밸리 전역에서, OpenAI부터 Google, Anthropic, Meta에 이르기까지 대부분의 자원이 이 길에 쏠려 속도를 내고 있습니다.
월드모델파는 지능의 핵심이 물리 세계에 대한 예측과 인과적 이해에 있다고 봅니다. 언어는 인간 지식이 고도로 압축된 산물, 즉 사고의 도구가 아니라 소통의 도구일 뿐입니다. 진정한 에이전트라면 물리 세계에서 행동하고 예측하고 계획할 수 있어야 하는데, 바로 이 지점이 LLM의 맹점입니다. Saining Xie(NYU 컴퓨터 비전 연구자, AMI Labs 공동창업자 겸 CSO. 과거 Meta AI Research에서 ResNeXt와 ConvNeXt 연구를 이끌었고, 현재는 물리 세계 지각에 기반한 엠보디드 AI 연구에 집중하고 있습니다), Yann LeCun, 그리고 로보틱스와 강화학습 커뮤니티의 연구자들이 이 흐름을 거스르고 있습니다.
이 논쟁의 핵심 쟁점은 한 문장으로 요약할 수 있습니다.
언어모델은 다음 토큰을, 월드모델은 다음 상태를 예측합니다.
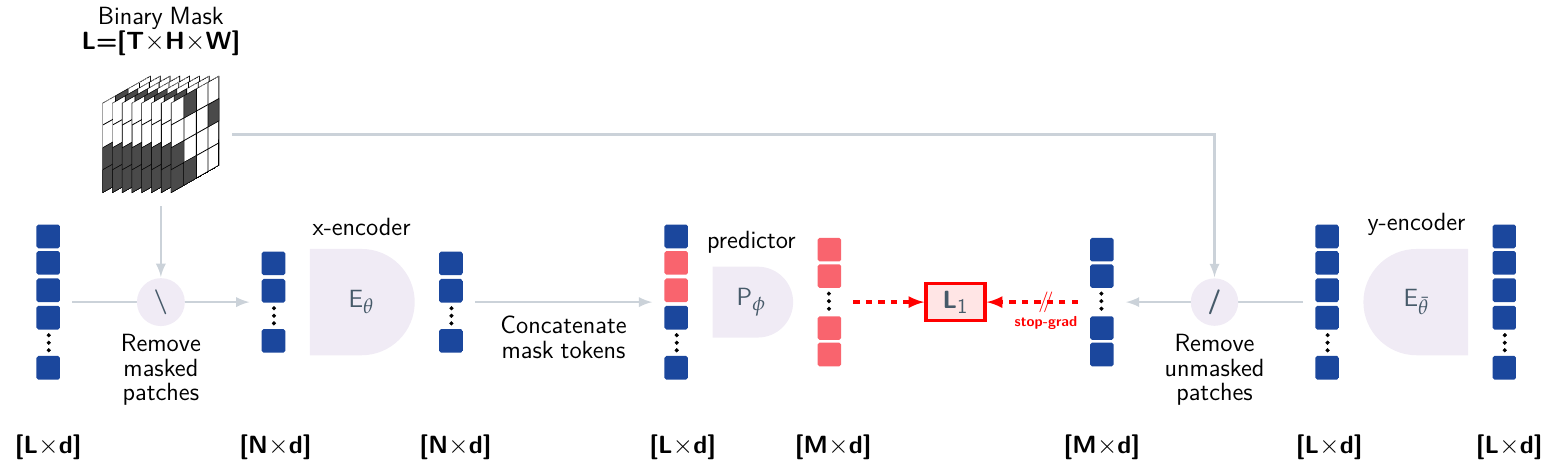
단어 하나만 바뀐 것처럼 들리지만, 그 이면에는 지능을 근본적으로 다르게 바라보는 두 가지 관점이 있습니다. "이해"란 무엇인가, 그리고 AI는 궁극적으로 어디로 향하는가에 대해 서로 다른 답을 내놓는 것입니다.
논쟁 1: 언어는 도구인가, "아편"인가?
Saining Xie의 핵심 주장
Saining Xie에게는 이 논쟁 전체에서 가장 강렬한 발언으로 꼽히는 대목이 있습니다.
"언어는 사실 일종의 '독'입니다. '아편'이라고 불러도 됩니다. 언어를 더 쓸수록 더 행복해지지만, 유용한 지름길일 뿐입니다. 아편을 계속 피우면 폐인이 됩니다. 목발을 계속 짚으면 다리 근육을 영영 단련시킬 수 없습니다."
이 비유의 논리는 풀어서 이해할 필요가 있습니다.
언어는 수천 년에 걸친 인류 문명의 산물이며, 고도로 압축된 추상적 지식 구조입니다. "컵이 떨어져 깨졌다"라고 말하는 순간, 이미 중력 가속도, 충돌 시의 응력 분포, 파편의 궤적, 재료의 취성 계수 같은 물리적 과정 전부를 버린 셈입니다. 이 문장 어디에도 그런 물리 정보는 담겨 있지 않습니다.
물리 세계에서 행동해야 하는 에이전트에게는, 바로 그 빠진 디테일이 가장 중요합니다. 산업용 로봇 팔은 토크 값이 필요하고, 수술 로봇은 조직 변형 데이터가 필요하며, 자율주행차는 노면 마찰 계수가 필요합니다. 언어는 이 중 어느 것도 표현할 수 없습니다.
Xie는 AI 시스템의 학습 공간을 두 층으로 나눕니다.
- X 공간: 물리 세계 그 자체, 연속적이고 고차원적이며 노이즈가 섞인 센서 신호
- Y 공간: 지도(supervision) 정보, 즉 인간이 붙인 레이블, 인간이 쓴 텍스트, 인간이 주석 단 범주
그의 핵심 지적은 LLM이 영원히 Y 공간에 갇혀 있다는 것입니다. LLM이 배우는 건 인간이 세계를 어떻게 묘사하는가이지, 세계 그 자체가 아닙니다. 이는 방법론의 한계가 아니라 데이터 양식(modality) 자체의 근본적인 제약입니다.
이 한계는 LLM의 성공을 만들어낸 바로 그 근원이기도 합니다. 소설, 논문, 코드, 채팅, 수학 문제처럼 서로 다른 텍스트 과제는 겉보기엔 천차만별이지만, 그것들을 만들어내는 메커니즘은 상당 부분 공유됩니다. 복잡한 물리 세계를 먼저 인간의 뇌가 이해하고 압축한 뒤, 그것을 다시 언어로 표현하는 것입니다. 바로 이 "세계에서 뇌로, 뇌에서 언어로, 언어에서 토큰으로" 이어지는 공유된 경로 덕분에, LLM은 Y 공간에서 학습하는 것만으로도 인류가 수천 년에 걸쳐 쌓아온 지식을 그대로 물려받을 수 있으며, 이는 파운데이션 모델이 애초에 성공할 수 있었던 가장 근본적인 이유 중 하나로 꼽힙니다. 하지만 같은 경로가 한계도 함께 정합니다. 뇌가 세계를 압축하는 과정에서 버린 정보(토크, 재료 변형, 마찰 계수 같은 것들)는 언어에 결코 담기지 않으므로, LLM 역시 그것을 배울 수 없습니다. 뇌는 LLM이 이기는 이유이자 지는 이유이기도 한 셈입니다.
그는 언어가 시각을 오염시킨다는 더 직설적인 주장도 합니다. 시각 시스템은 연속적이고 고차원적이며 노이즈로 가득한 물리 신호를 처리하는 반면, 언어는 이산적이고 상징적입니다. 시각 모델에게 "이해"를 언어로 표현하도록 강제하는 순간, 이미 그 표현 공간을 맞지 않는 그릇에 억지로 눌러 담은 셈입니다.
📖 표현 학습(representation learning): 특징을 손으로 설계하는 대신, 모델이 원본 데이터로부터 내부 표현을 자동으로 학습하게 하는 방식입니다. 월드모델의 핵심 목표 중 하나는 예측과 계획을 뒷받침할 수 있는 물리 세계의 표현을 학습하는 것이며, 그 표현은 Y 공간이 아니라 X 공간에 있어야 합니다.
반박: 언어파의 가장 강력한 주장
언어파는 이 비판을 조용히 받아들이지 않습니다. 몇 가지 강력한 반론을 내놓습니다.
첫째, GPT-4는 물리적 추론을 할 수 있으며, 이는 단순한 묘사가 아니라 이해입니다. GPT-4에게 막대기가 물에 잠기면 왜 휘어 보이는지 물으면, 굴절률로 설명합니다. 물체에 작용하는 힘을 예측하라고 하면, 뉴턴 법칙으로부터 답을 도출합니다. 이것이 물리학을 이해하는 게 아니라면, 대체 무엇이 이해란 말입니까?
둘째, 인간도 언어로 사고합니다. "컵이 떨어져 깨졌다"라는 문장이 의미를 갖는 건, 그 말 뒤에 수많은 실제 경험으로 쌓인 물리적 직관이 자리하고 있기 때문입니다. 언어와 물리적 이해는 대립하는 게 아니라 공생 관계입니다. 인간은 언어로 지식을 전달하고, 추론하고, 계획을 세웁니다. 언어가 인간을 "폐인"으로 만들지 않는다면, AI라고 다를 이유가 있을까요?
셋째, Scaling Law는 물리적 이해에서도 여전히 유효합니다. BIG-Bench Physical Intuition(Beyond the Imitation Game Benchmark의 물리적 직관 부분집합으로, 물체의 운동, 중력, 충돌 등 일상적인 물리 시나리오에 대해 언어모델을 평가합니다) 같은 물리적 추론 벤치마크에서, 더 큰 모델이 계속해서 더 좋은 성능을 냅니다. 이 추세는 둔화될 기미가 보이지 않습니다. 언어가 목발이라면, 더 세게 기댈수록 왜 결과가 더 좋아지는 걸까요?
여러분에게 남기는 질문(논쟁 1)
LLM이 정말로 물리 세계를 "이해"하고 있다고 생각하나요, 아니면 정교한 패턴 매칭을 수행하고 있을 뿐이라고 생각하나요? 둘 사이에 원칙에 입각한 구분이 존재할까요, 그리고 그 구분이 정말 중요할까요?
우리가 고안할 수 있는 모든 물리적 추론 테스트에서 어떤 시스템이 진짜 이해와 구분되지 않는 성능을 낸다면, 그래도 우리는 그것이 "그저 패턴을 맞추고 있을 뿐"이라고 주장할 근거를 가질 수 있을까요?
논쟁 2: Bitter Lesson은 실제로 무엇을 말했는가?
Sutton의 원래 주장
2019년, Richard Sutton은 짧은 에세이 The Bitter Lesson을 발표했습니다. 글은 짧았지만, AI 분야에서 가장 오래 지속되는 논쟁 중 하나를 촉발했습니다.
핵심 주장은 이렇습니다.
인간의 도메인 지식은 아무리 영리해 보여도, "연산을 활용하는 더 단순하고 더 일반적인 방법"에 의해 반복적으로 추월당한다.
그는 역사적 증거를 제시합니다. 체스: Deep Blue는 방대한 체스 전문 지식을 인코딩했습니다. AlphaZero는 그 전부를 버리고 오직 셀프플레이와 신경망에만 의존해, Deep Blue의 후계자들을 물리쳤습니다. 바둑: 인간은 수십 년에 걸쳐 정석, 맥, 형태를 연구했지만, AlphaGo는 지도학습과 강화학습을 결합해 모든 인간 기사를 능가했습니다. 음성 인식: 언어학자들은 수십 년에 걸쳐 음소 모델, 포먼트 모델, 음향 모델을 구축했지만, 결국 모두 엔드투엔드 신경망으로 대체되었습니다. 이미지 분류: SIFT나 HOG 같은 손으로 설계한 특징은 AlexNet의 엔드투엔드 학습에 밀려났습니다.
Sutton은 이것이 바로 그 "쓰라린 교훈"이라고 결론짓습니다. 연구자들은 인간의 지식을 시스템에 하드코딩하는 같은 실수를 계속 반복하고, 그때마다 더 단순하고 더 일반적인 방법에 추월당합니다. 옳은 방향은 인간의 개입을 줄이고 연산과 학습이 일을 하도록 놔두는 것입니다.
Xie의 반대 해석
여기서 주장이 가장 흥미로워집니다. Xie는 Bitter Lesson 자체에 반대하지 않습니다. 그가 반대하는 건 그것을 LLM을 옹호하는 근거로 쓰는 것입니다.
"LLM은 Bitter Lesson에 한참 못 미칩니다. 어떤 의미에서는, LLM은 반-Bitter Lesson입니다."
논리는 이렇습니다. Bitter Lesson이 요구하는 건 손으로 설계한 특징과 규칙을 줄이고 탐색과 학습에 더 의존하라는 것입니다. 하지만 언어 자체가 극도로 정교한 인간의 산물입니다.
Common Crawl(웹 페이지를 지속적으로 수집하는 공개 데이터셋으로, 수십억 개 페이지의 텍스트를 포함하며 GPT나 LLaMA 같은 대형 언어모델을 학습시키는 주요 원본 데이터 소스 중 하나입니다)로 LLM을 학습시킬 때, 여러분은 "가공되지 않은 세계 데이터"를 먹이는 게 아닙니다. 철학, 과학, 역사, 문학, 법률, 대화까지, 수천 년에 걸친 인류 문명의 지혜가 언어로 압축된 것을 먹이는 것입니다. 이는 극도로 교묘하게 위장된 귀납적 편향(inductive bias)입니다.
📖 귀납적 편향(inductive bias): 머신러닝 모델이 학습 데이터를 넘어 일반화하기 위해 의존하는 가정들의 집합으로, 가설 공간을 좁혀줍니다. 예를 들어 CNN의 귀납적 편향은 "전역적 특징보다 지역적 특징이 더 중요하고, 특징은 평행이동에 불변하다"는 것입니다. 언어 데이터로 학습된 LLM은 "세계는 인간의 언어로 충분히 기술될 수 있다"는 귀납적 편향을 갖게 되며, Xie의 비판은 바로 이 가정을 정면으로 겨냥합니다.
이는 "모델이 스스로 패턴을 발견하도록 놔두는" 것이 아닙니다. "영리한 인간들이 지금껏 알아낸 모든 패턴이 여기 다 있으니, 흡수해"라고 말하는 것입니다.
이는 AlphaZero가 체스 전문 지식을 버린 것과 정확히 반대입니다. AlphaZero는 X 공간에서 출발해 바둑의 규칙을 정말로 스스로 "발견"합니다. LLM은 Y 공간에서 출발해 인간이 이미 발견해 놓은 모든 패턴을 "흡수"할 뿐입니다.
여기서 한 걸음 더 나아가면, 언어모델의 Scaling Law에는 "거품"이 낄 수 있다는 함의가 나옵니다. 모델은 세계를 진짜로 이해하지 않고도 그에 관한 질문에 답할 수 있는데, 이는 시험 고득점자가 깊은 이해력이 아니라 단지 뛰어난 암기력만 갖고 있을 수도 있는 것과 비슷합니다. 월드모델의 Scaling Law는 다르게 나타나는데, 모델은 인간이 미리 소화해주지 않은 날것의 물리 신호를 마주하며 성공하려면 정말로 "이해"해야만 합니다.
📖 분포 밖(OOD, Out-of-Distribution): 어떤 분포로 학습된 모델은, 그 분포를 벗어난 입력으로 테스트하면 신뢰도가 급격히 떨어집니다. 이는 모델이 정말로 "이해"하고 있는지 아니면 그저 "암기"하고 있는지를 가르는 대표적인 시험대이며, 월드모델파가 LLM의 Scaling에 거품이 있다고 주장하는 핵심 근거이기도 합니다.
반박: "인간 지식을 흡수하는 것"이 반-Bitter Lesson은 아닌 이유
Bitter Lesson이 반대하는 건 손으로 설계한 특징과 규칙이지, 인간이 축적한 데이터를 활용하는 것 자체가 아닙니다. 언어 데이터는 "규칙"이 아니라 "예시"입니다. 인간 언어에 담긴 지식으로부터 배우는 것은, 체스 기보 데이터베이스로부터 배우는 것과 방법론적으로 다르지 않습니다. AlphaZero도 인간이 발명한 바둑 규칙을 환경으로 삼지 않았습니까? 그 규칙 역시 인간의 지식입니다.
이렇게 보면, LLM은 오히려 Bitter Lesson 정신을 가장 철저하게 구현한 사례입니다. 손으로 설계한 특징을 버리고, 모든 것을 엔드투엔드 학습으로 만드는 것입니다. 유일한 차이는 이번의 "끝"이 픽셀이 아니라 언어라는 점뿐입니다.
여러분에게 남기는 질문(논쟁 2)
Bitter Lesson의 정신은 "연산과 학습을 믿고, 사람이 만든 규칙을 믿지 말라"는 것입니다. LLM은 이 정신을 따랐을까요, 아니면 어겼을까요?
더 날카로운 버전의 질문도 있습니다. 언젠가 월드모델이 Deep Blue가 AlphaZero에게 추월당했던 것처럼 어떤 "더 단순하고 더 일반적인" 방법에 추월당한다면, 그 순간을 월드모델의 Bitter Lesson이라 부를 수 있을까요? 아니면 Bitter Lesson 자체도 스스로의 Bitter Lesson을 갖게 될까요?