
관측 인코딩
왜 압축이 필요한가
앞 페이지의 탁자 중앙에 놓인 공 사진으로 돌아가봅시다. 이를 64×64 RGB 스크린샷으로 렌더링하면 이 한 프레임은 64 × 64 × 3 = 12,288개의 픽셀 값을 담고 있습니다. 이 픽셀을 그대로 정책 네트워크나 동역학 모델 학습에 사용하면 세 가지 문제가 생깁니다.
- 차원의 저주: 고차원 입력은 학습을 극도로 비효율적으로 만들어 방대한 양의 샘플이 필요합니다.
- 중복 정보: 대부분의 픽셀(배경, 텍스처 디테일)은 의사결정과 무관합니다.
- 연산 비용: 매 스텝마다 수만 차원의 입력을 처리하는 것은 지나치게 느립니다.
해법은 원본 관측
인코더는 중복이 많은 고차원 픽셀 공간(12,288차원)을 간결하고 다루기 쉬운 잠재 공간(32차원)으로 바꿔주며, 그 결과 다운스트림 동역학 모델은 의미 정보만 처리하면 됩니다.
압축은 최종 목표가 아니다
차원이 낮다고 해서 표현이 자동으로 좋아지는 것은 아닙니다. 월드모델에 필요한 것은 가장 작은 파일이 아니라 미래를 쉽게 예측하고 과제 변수를 쉽게 읽을 수 있는 상태 표현입니다. 인코더가 탁자의 질감은 정밀하게 보존하면서 공의 속도를 버릴 수도 있습니다. 바로 앞 페이지의 사진이 알려주지 못했던 그 숨은 변수이자, 다음 프레임에서 공이 왼쪽으로 갈지 오른쪽으로 갈지를 결정하는 바로 그 값입니다.
표현은 세 종류의 증거로 점검할 수 있습니다.
| 증거 | 점검하는 질문 | 한계 |
|---|---|---|
| 재구성 | 표현으로 현재 관측을 복원할 수 있는가? | 의사결정과 무관한 픽셀 세부사항을 선호할 수 있음 |
| 프로브 | 위치, 속도, 접촉을 표현에서 읽을 수 있는가? | 프로브 실패가 정보의 부재를 증명하지는 않음 |
| 다운스트림 예측 | 표현이 행동 조건부 미래를 더 쉽게 예측하게 하는가? | 동역학 모델의 용량에도 영향을 받음 |
P01이 VAE를 사용하는 이유는 표현 학습을 명확하게 학습시키고 시각화할 수 있는 출발점을 제공하기 때문이지, 재구성 목표가 모든 월드모델에 최적이기 때문은 아닙니다. 뒤에서 다룰 JEPA와 과제 지향 표현은 서로 다른 기준으로 보존할 정보를 선택합니다.
VAE 직관: 압축과 재구성을 함께 배우기
VAE(Variational Autoencoder)[1]는 이 압축을 구현하는 핵심 도구입니다. 두 부분으로 구성됩니다.
- 인코더(Encoder): 이미지
를 잠재 공간으로 매핑해 분포의 평균 (뮤, 분포의 중심)와 표준편차 (시그마, 분포의 폭)를 출력하고, 여기서 를 샘플링합니다. - 디코더(Decoder): 잠재 벡터
로부터 원본 이미지 를 재구성합니다(hat 기호는 "모델의 추정값"을 뜻하며, 실제 값 와 구분됩니다).
핵심 성질은 잠재 공간이 연속적이라는 점입니다. 즉
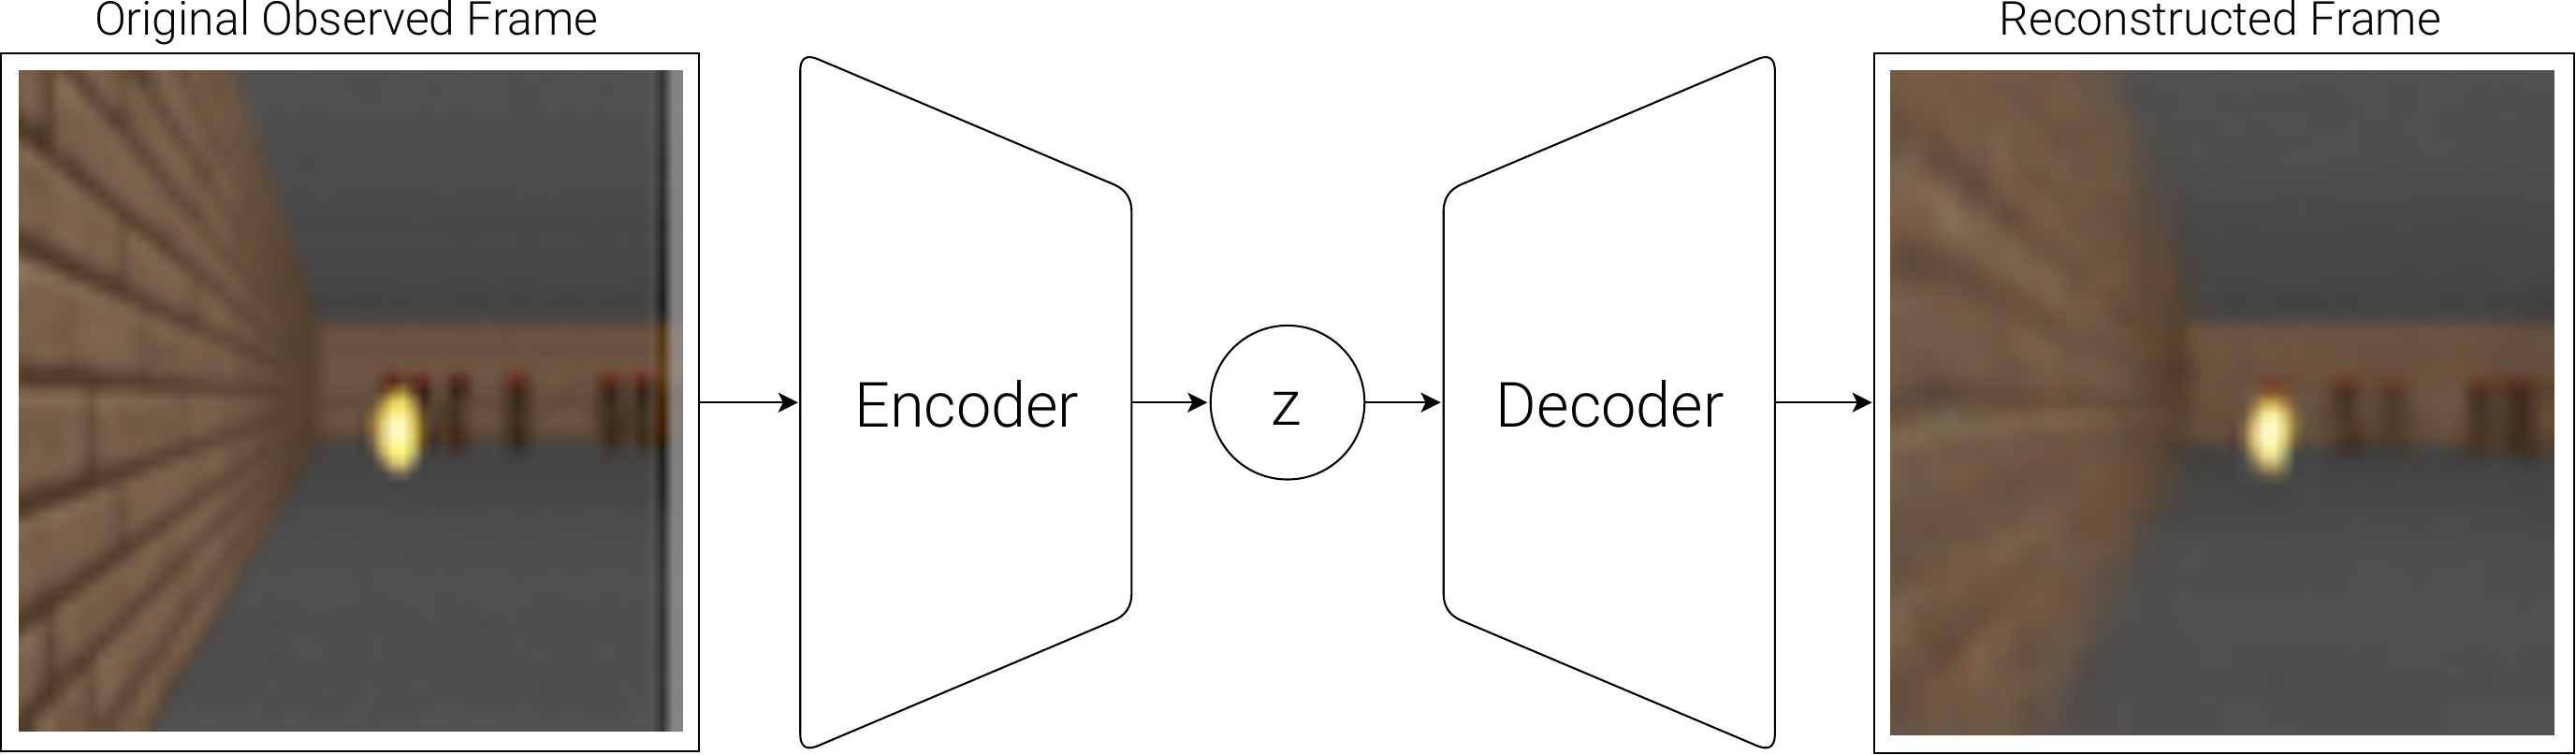
데이터는 한 방향으로 흘러, CNN(합성곱 신경망, Convolutional Neural Network) 인코더가 원본 이미지를 잠재 벡터 z로 압축하고 CNN 디코더가 z로부터 이미지를 재구성합니다.
📖 전치 합성곱(Transposed Convolution, 디컨볼루션이라고도 함): 일반적인 합성곱은 큰 특징 맵을 더 작은 특징 맵으로 압축합니다(공간 해상도를 낮춤). 전치 합성곱은 그 반대로, 작은 특징 맵을 더 큰 특징 맵으로 업샘플링합니다(공간 해상도를 높임). 디코더는 전치 합성곱을 이용해 저차원 잠재 벡터를 점진적으로 원본 이미지 크기로 "복원"합니다.
ELBO 손실 함수: 두 목표 사이의 균형
VAE의 학습 목표는 ELBO(Evidence Lower Bound, 증거 하한)이며, 두 개의 항으로 구성됩니다.
📖 ELBO란 무엇인가? 우리가 진짜로 최대화하고 싶은 것은 "모델이 실제 이미지를 생성할 확률", 즉
입니다. 하지만 이 값은 가능한 모든 에 대해 적분해야 해서 직접 계산할 수 없습니다. 그래서 대신 ELBO라는 값을 계산합니다. ELBO는 항상 보다 작거나 같은 값, 즉 계산 가능한 하한이기 때문에, ELBO를 최대한 끌어올리면 원래 목표였던 도 함께 커지도록 유도할 수 있습니다. 이름에 담긴 "하한"이라는 말이 바로 라는 뜻입니다. 실제로는 음의 ELBO를 손실 함수 로 삼아 이를 최소화하는 방식으로 학습합니다.
📖 KL 발산이란 무엇인가?
는 두 확률분포 사이의 "격차"를 측정합니다. 가 와 비슷할수록 KL 값은 0에 가까워지고, 격차가 클수록 KL 값도 커집니다(항상 0 이상). 여기서는 인코더가 출력하는 분포 가 사전 확률 (표준정규분포 )에서 너무 벗어나지 않도록 제약하는 데 쓰이며, 이를 통해 잠재 공간의 서로 다른 영역들이 "구멍"(보간된 지점을 재구성했을 때 앞뒤가 맞지 않는 출력이 나오는 영역) 없이 부드럽게 이어지도록 합니다.
| 손실 항 | 목표 | 직관 |
|---|---|---|
| 재구성 손실 | 재구성된 이미지가 원본과 닮아야 함 | "압축해도 다시 재구성할 수 있어야 한다" |
| KL 발산 | 잠재 분포가 표준정규분포 | "잠재 공간이 잘 정돈되고 연속적이어야 한다" |
두 항은 함께 작동해, 재구성 손실은
📖 재매개변수화 트릭: 인코더가 평균
와 표준편차 를 출력하고 나면, 분포 에서 를 샘플링해야 합니다. 직접 샘플링할 때의 문제는, 샘플링 연산 자체가 미분 불가능해서 그라디언트가 에서 와 로 되돌아 흐를 수 없고, 그러면 인코더를 학습시킬 수 없다는 것입니다. 해법은 샘플링을 로 다시 쓰는 것입니다. 여기서 는 독립적으로 샘플링된 노이즈입니다(네트워크 파라미터와 무관합니다). 그 결과 는 와 에 대해 미분 가능해지고, 그라디언트가 정상적으로 흐르며, 인코더를 엔드투엔드로 학습시킬 수 있습니다.
직접 계산해보기: 인코더가 어떤 이미지의 한 잠재 차원에 대해
역전파 과정에서 reparameterize 함수가 바로 이 계산을 그대로 검증합니다.
CNN 인코더 구조
실제로는 인코더가 이미지를 처리하기 위해 합성곱 신경망(Convolutional Neural Network, CNN)을 사용하는데, CNN이 국소적인 공간 특징을 포착하는 데 본래 적합하기 때문입니다.
- 여러 층의 합성곱: 각 층이 더 높은 수준의 특징(경계, 텍스처, 형태, 의미)을 추출합니다
- 스트라이드(stride) 합성곱: 공간 해상도를 점진적으로 낮춰 정보를 압축합니다
- 완전연결층: 최종 특징 맵을 1차원 벡터로 펼쳐서
와 두 벡터를 출력합니다
일반적인 구조는 64×64×3 입력에 스트라이드 2인 Conv(4×4) 층 세 개를 차례로 통과시켜 해상도를 점진적으로 줄인 뒤, 이를 평탄화(Flatten)해 선형층에 통과시켜 (
인코딩만으로는 해결되지 않는 것
압축이 이 페이지의 모든 검증, 낮은 재구성 오차, 위치는 물론 속도까지 읽어내는 프로브를 통과하더라도, 공의 속도가 화면 밖 장애물과 부딪힌 뒤 어떻게 바뀌는지는 여전히 알 수 없습니다. 이 질문에 답하려면 더 나은 인코더가 아니라 이력과 상태 변화 모델이 필요합니다. 다음 페이지가 바로 그 문제를 다룹니다.
직접 해보기: VAE 시각화
프로젝트에서 demos/vae-visualizer.html을 열어보세요. 다음을 할 수 있습니다.
- 사전 학습된 VAE를 불러옵니다
- 슬라이더로 잠재 벡터
의 개별 차원을 조정합니다 - 디코더의 출력 이미지가 실시간으로 어떻게 바뀌는지 관찰합니다
주목할 점: 어떤 차원이 주로 색상, 위치, 형태에 영향을 주는지, 한 차원을 바꿀 때 다른 속성도 함께 변하는지 기록하세요. 일반적인 VAE가 완전히 분리된 표현을 보장하지는 않습니다. 잠재 순회는 각 차원이 독립적인 의미를 가진다고 미리 가정하는 도구가 아니라 표현이 실제로 무엇을 배웠는지 검사하는 도구입니다.