
자기회귀 롤아웃 품질: STORM이라는 실전 사례
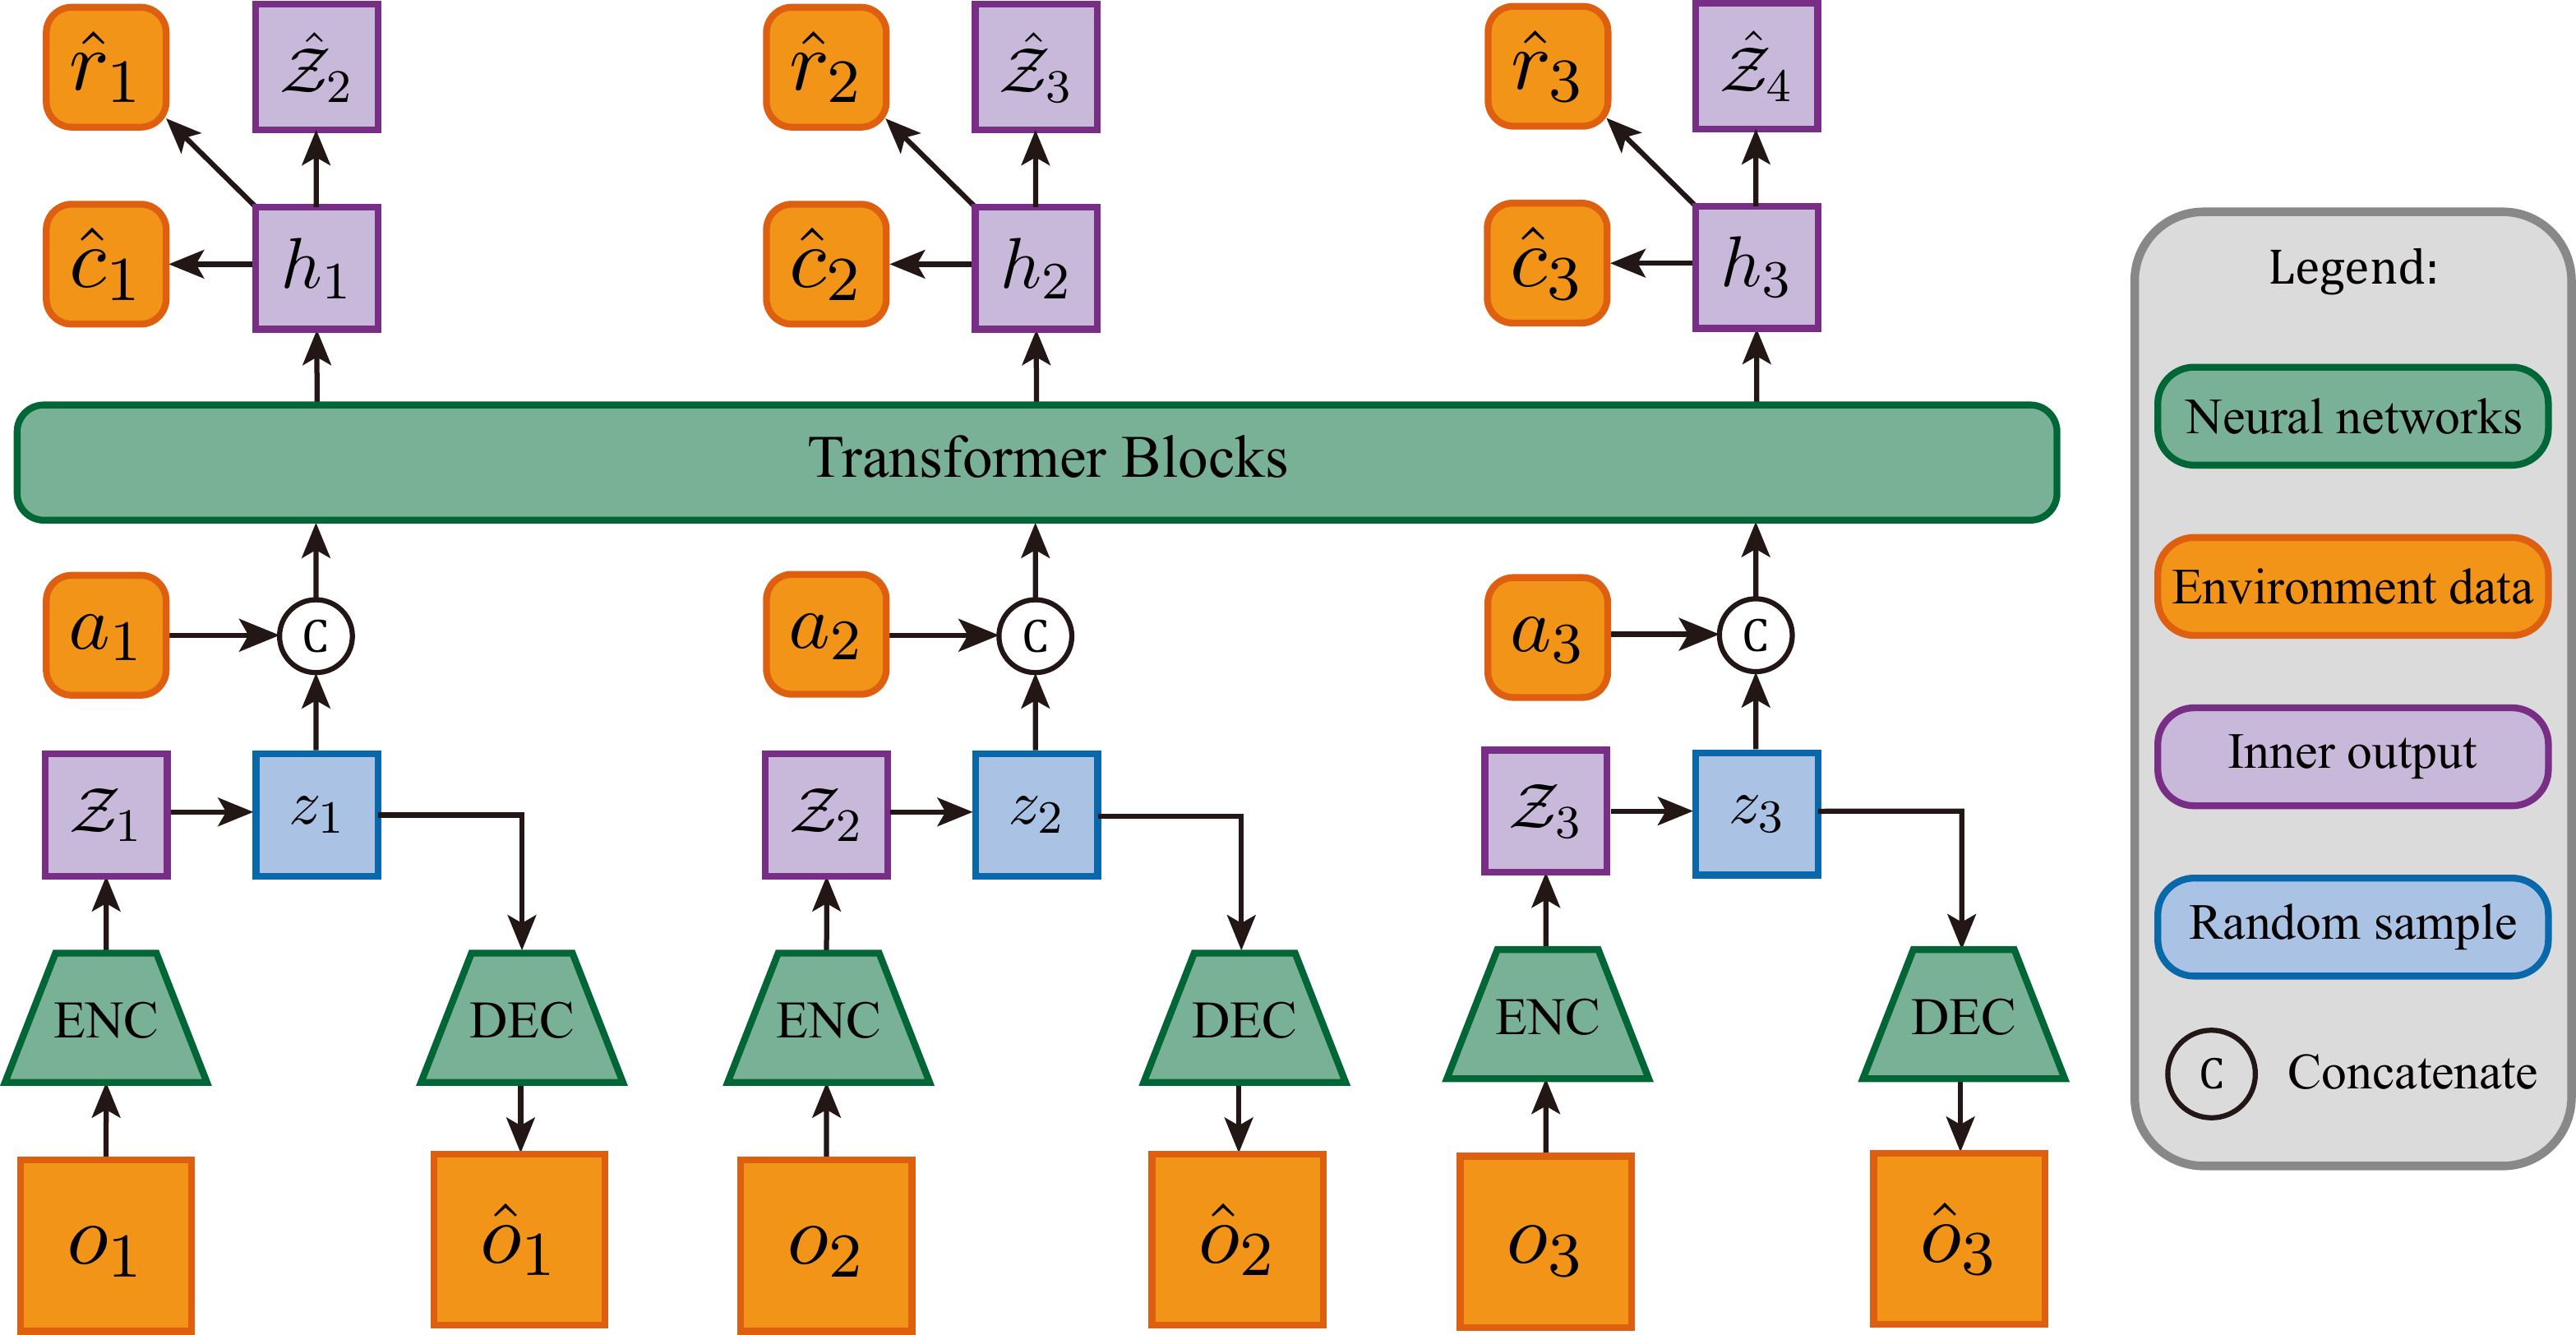
STORM(Transformer 동역학) [L03 더 읽을거리 [1] 참고]
P04에서는 RSSM의 동역학 백본을 STORM 스타일의 Transformer로 교체합니다. 이어서 P05는 그 롤아웃 동작을 Dreamer 체크포인트와 나란히 평가합니다.
STORM의 핵심 아이디어는 RSSM의 순환 상태를 Transformer의 셀프 어텐션 시퀀스 모델링으로 대체하는 것입니다. 과거 프레임을 토큰 시퀀스로 인코딩하고, 동작을 추가 토큰으로 이어붙인 뒤, Transformer가 인과적 마스크(causal mask, 셀프 어텐션 계산에서 현재 위치 이후의 모든 위치에 대한 어텐션 점수를
STORM을 평가하려면 완전히 다른 두 시간 척도를 구분해야 합니다. 프레임별 정확도(매 스텝의 토큰 예측이 정확한가)와 시퀀스 동역학 품질(전체 비디오 구간의 움직임 궤적이 그럴듯한가)입니다. 이 두 범주의 문제는 서로 다른 지표로 다룹니다.
토큰 예측 손실(Token Prediction Loss)
이는 STORM의 학습 목적 함수이자 가장 직접적인 온라인 모니터링 지표입니다. 학습이 안정적이라면 이 손실은 단조롭게 감소해야 합니다. 이상 징후는 두 가지 형태로 나타납니다.
- 손실 곡선이 학습 도중 5천 스텝 넘게 정체기에 머무는 경우: 대개 학습률이 너무 크거나, 컨텍스트 윈도우 길이가 학습 시 사용한 시퀀스 길이를 넘어서 어텐션 가중치가 무너지는 것이 원인입니다.
- 짧은 시퀀스에서는 손실이 낮은데 긴 시퀀스에서는 높은 경우: teacher forcing 격차가 과도하다는 초기 신호입니다(아래 참고).
진단 규칙: 슬라이딩 윈도우(예: 윈도우 길이 20스텝 대 50스텝)로 토큰 예측 손실을 각각 계산해보는 것이 좋습니다. 둘 사이의 격차가 계속 벌어진다면, 더 긴 문맥에서 모델의 예측 능력이 크게 떨어진다는 뜻이므로 학습 시퀀스 길이를 줄이거나 상대 위치 인코딩(relative positional encoding, Transformer에서 위치 정보를 인코딩하는 방식 중 하나로, 절대 위치 인코딩은 각 위치에 고정된 인코딩을 부여해 학습 길이보다 긴 시퀀스에 대한 일반화가 떨어지는 반면, 상대 위치 인코딩은 두 토큰 사이의 상대적 거리만 인코딩해 학습 길이를 넘어서는 시퀀스에도 더 잘 외삽됩니다)을 도입해야 합니다.
장기 PSNR(Long-Horizon PSNR)
최대 신호 대 잡음비(PSNR, Peak Signal-to-Noise Ratio)는 생성된 프레임과 실제 프레임 사이의 픽셀 단위 일치도를 측정합니다.
여기서 MAX는 픽셀 최댓값(보통 255 또는 1.0)이고, MSE는 생성 프레임과 실제 프레임 사이의 평균제곱오차입니다. PSNR 값이 높을수록 좋으며, 일반적인 범위는 20~40dB이고 20dB 아래면 대개 사람 눈에도 생성 품질 저하가 보일 정도입니다.
왜 "장기"가 중요한가: teacher forcing 학습 방식에서는 모델이 학습 중에는 항상 실제 과거 프레임을 입력받지만, 추론 시에는 자기 자신의 이전 예측을 입력으로 써야 합니다. 이 학습-추론 간 분포 격차는 스텝이 진행될수록 누적되므로, PSNR은 무작위로 흔들리는 게 아니라 롤아웃 스텝 수가 늘어날수록 체계적으로 하락합니다. STORM을 평가할 때는 한 스텝짜리 평균값만 보고할 게 아니라, 롤아웃 스텝 수에 따른 PSNR 곡선을 그려봐야 합니다.
진단 규칙: PSNR이 처음 10스텝 안에 5dB 넘게 급락한다면 teacher forcing 격차가 주된 원인입니다. scheduled sampling(계획된 샘플링, 학습 중 과거 입력으로 쓰이는 실제 프레임을 생성된 프레임으로 무작위로 교체하되 그 비율을 점점 늘려, 모델이 추론 시의 자기회귀 방식에 적응하도록 만드는 기법으로, L03의 RWM 절 참고)이나 Self-Forcing 학습을 시도해보는 것이 좋습니다.
📖 Teacher Forcing(정의는 L03의 Transformer 아키텍처 절 참고): 학습 중에는 모델이 항상 실제 과거 프레임을 입력받지만, 추론 시에는 자신의 예측 프레임을 입력으로 써야 하기 때문에 학습과 추론 사이에 분포 격차가 생깁니다. 이는 자기회귀 월드모델에서 오차가 누적되는 가장 흔한 원인입니다.
FVD(Fréchet Video Distance)
FVD는 FID의 아이디어를 비디오 시퀀스로 확장한 것입니다. 사전학습된 I3D 네트워크(비디오 동작 인식 과제로 학습된 3D 합성곱 네트워크)로 비디오 클립의 시공간 특징을 추출한 뒤, 실제 비디오와 생성 비디오의 특징 분포 사이의 프레셰 거리를 계산합니다. 값은 낮을수록 좋습니다.
수식 형태는 FID와 같지만, 특징 추출기가 I3D로 바뀌었다는 점이 다릅니다. 이때 특징 벡터는 한 프레임의 시각적 품질이 아니라 비디오 클립 전체의 동역학을 인코딩합니다. FVD는 움직임 패턴과 물체 궤적의 일관성에 더 민감해, 월드모델의 시퀀스 품질을 평가하는 표준 지표로 쓰입니다.
역할 분담: 디버깅에는 PSNR을 쓰고(빠르고 픽셀 단위라 학습 중 모니터링에 적합), 정책 평가와 논문 보고에는 FVD를 씁니다(시퀀스 동역학 품질을 포착하고 사람의 지각적 판단과 더 잘 맞습니다). 결국 두 가지 지표 모두 필요합니다. PSNR은 높은데 FVD가 나쁘다면 프레임별 픽셀 정합은 괜찮지만 전체 움직임 궤적이 일관되지 않다는 뜻이고, FVD는 좋은데 PSNR이 낮다면 모델이 합리적인 동역학 패턴은 익혔지만 프레임별 생성에 노이즈가 많다는 뜻입니다.
더 읽을거리
- Zhang et al. (2023): STORM: Transformer 동역학 월드모델, 10만 상호작용 이내에서의 효율적인 학습
- Carreira & Zisserman (2017): I3D: FVD가 사용하는 비디오 특징 추출 백본