
논쟁 3: 월드모델과 LLM은 경쟁 관계인가, 상호 보완적인가?
Saining Xie의 분업 논리
이 지점에서 Saining Xie는 의외로 온건합니다. 그는 "LLM은 막다른 길이다"라고 말하지 않습니다. 대신 이렇게 말합니다.
"LLM이 없었다면, Vision은 오늘날과 같은 진정한 의미의 멀티모달 대규모 지능으로 확장할 방법이 없었을 것입니다."
그의 AMI Labs는 LLM을 거부하지 않으며, 오히려 LLM이 만들어낸 진전을 명시적으로 인정합니다. LLM은 언어 이해와 지시 따르기라는 두 가지 핵심 문제를 해결해, 시각 시스템에 "언어 인터페이스"를 부여했고, 그 덕분에 월드모델이 자연어 명령을 받아들일 수 있게 되었습니다.
그의 입장은, 두 패러다임이 서로 다른 차원의 정보를 다루며 각자 강점을 발휘하는 영역이 다르다는 것입니다.
| 패러다임 | 강점 영역 |
|---|---|
| LLM | 디지털 공간에서의 추론, 코드, 텍스트 생성, 지식 검색 |
| 월드모델 | 물리 세계 예측, 로봇 제어, 산업 지각, 엠보디드 AI |
| WAM | 둘의 통합: 비디오와 동작의 공동 모델링, 언어 명령을 받아들이면서 물리를 이해 |
Dreamer V3는 정확히 월드모델 행에 속합니다. 동작을 입력으로 받아 잠재 상태를 예측하며, 단일 하이퍼파라미터 세트로 7개 도메인에 걸쳐 그 성능이 입증되었습니다.
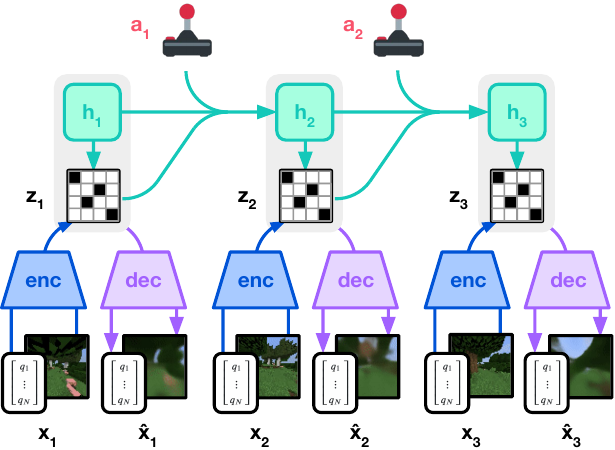
WAM: 공동 모델링 접근법
WAM(World Action Model)이라는 개념은 따로 설명할 가치가 있습니다.
📖 WAM(World Action Model): 비디오 예측과 동작 예측을 공동으로 모델링하는 아키텍처 계열입니다. 핵심 발상은 단순히 "세계를 이해하는 것"이 아니라 "세계를 이해하고 그 안에서 어떻게 행동해야 하는지 아는 것"입니다. 비디오 프레임은 물리적 제약을 제공하고, 동작 신호는 인과적 주석을 제공합니다. 이 둘을 함께 학습시킨 모델은 따로따로 학습시킨 모듈들을 조합한 것보다 동작의 결과를 더 잘 이해합니다.
전통적인 월드모델과 정책은 서로 분리된 두 모듈입니다. 먼저 세계 상태를 모델링한 뒤, 그 월드모델 안에서 계획을 세웁니다. WAM은 이 분업을 깨뜨립니다. 비디오 자체가 동작 학습의 지도 신호가 되며, 명시적인 보상 함수나 동작 주석이 필요 없습니다.
기존 월드모델들을 행렬로 이해해보면, 가로축은 "동작 신호를 입력으로 받는가", 세로축은 "무엇을 예측하는가"입니다.
- Dreamer(RSSM + 잠재 Actor-Critic, L02-L03 참고): 동작을 입력으로 받아 잠재 상태를 예측하는, 좁은 의미의 월드모델이자 능동적인 의사결정자
- STORM(Stochastic Transformer-based wORld Models, 범주형 VAE + Transformer 동역학, L03 참고): 동작을 입력으로 받고(동작이 토큰으로 시퀀스에 이어붙여짐), 다음 프레임의 잠재 토큰을 예측하는 상호작용형
- WAM: 동작을 입력으로 받는 동시에 의미까지 이해하는, 둘의 통합
이 세 패러다임은 L03에서 공학적 관점으로 이미 비교했습니다. 여기서 던지는 질문은 다릅니다. WAM은 어떤 가정에 베팅하고 있을까요? 월드모델과 정책은 분리된 두 모듈이어서는 안 되며, 비디오 자체가 동작 학습의 지도 신호여야 한다는 것입니다. 이 가정이 맞다면, 공동 학습은 모델 기반과 정책 학습 사이의 분업을 해체하고 새로운 창발적 능력을 만들어낼 것입니다.
JEPA: 또 다른 길
LeCun의 JEPA(Joint Embedding Predictive Architecture, LeCun 2022)는 다른 방향을 취합니다.
📖 JEPA(Joint Embedding Predictive Architecture): LeCun이 2022년에 제안한 아키텍처 원칙입니다. 핵심 발상은 예측이 픽셀이 아니라 추상적 표현 레벨에서 일어나야 한다는 것입니다. 모델이 미래의 픽셀 하나하나를 예측하게 하는 대신(극도로 어렵고 무관한 노이즈로 가득합니다), 미래의 의미적 표현을 예측하게 합니다. V-JEPA 2는 이 접근법의 비디오 버전입니다.
JEPA는 픽셀을 생성하지 않고, 오직 의미적 표현만 예측합니다. 이 선택에는 "픽셀은 노이즈이고, 의미가 신호"라는 분명한 입장이 담겨 있습니다. 이미지를 전혀 생성하지 않는 모델이 오히려 Diffusion 기반 월드모델보다 물리 세계에 대한 구조적 이해를 더 빨리 얻을 수도 있습니다.
LeCun은 이 베팅에 구체적인 시점까지 못 박았습니다. 2026년 5월 인터뷰에서 그는 2027년 초가 되면 업계 전체가 패러다임을 바꿔야 한다는 사실을 깨닫게 될 것이며, 5년 안에 JEPA 계열 아키텍처가 마치 Linux가 운영체제의 표준이 되었듯 AI의 근본적인 표준이 될 것이라고 말했습니다.
그의 주장이 가장 날카로워지는 지점은 두 종류의 모델을 비교할 때입니다. VLA(Vision-Language-Action) 모델은 시각 입력과 언어 지시를 받아 곧바로 동작을 출력하는데, 이는 현재 대부분의 엔드투엔드 로봇·자율주행 시스템이 취하는 접근법입니다. 테슬라의 Autopilot이 바로 이 논리를 따르는데, 수백만 시간 분량의 주행 영상으로 학습해 지각을 핸들 조작으로 매핑합니다. 하지만 LeCun의 비판은 VLA가 근본적으로 잘못된 방향이라는 것입니다. VLA는 방대한 상황 목록을 암기할 뿐, 결과를 예측하는 내부 모델이 없습니다. 정말로 처음 보는 상황을 마주치면, 다음에 무슨 일이 일어날지 추론할 원칙적인 방법이 전혀 없습니다.
18세 청소년이 13시간 만에 운전을 배울 때, 그는 도로 상황을 암기하지 않습니다. 차량, 물리 법칙, 다른 운전자의 행동에 대한 내부 모델을 만들고, 그 모델을 이용해 예측하고 계획을 세웁니다. 이것이 바로 JEPA가 키우려는 능력으로, 토큰을 하나씩 출력하는 게 아니라 의도적인 계획을 가능하게 하는 미래 표현의 구조적 예측입니다.
JEPA와 WAM은 월드모델파 내부의 또 다른 논쟁, 즉 예측이 어느 공간에서 이루어져야 하는가를 보여줍니다. 픽셀 공간에서의 예측은 해석 가능하지만 연산 비용이 크고 무관한 디테일에 쉽게 주의를 빼앗기는 반면, 표현 공간에서의 예측은 효율적이지만 표현의 질이 모든 것을 좌우합니다.
핵심 쟁점: 결국 수렴할 것인가?
양쪽 진영 모두를 불편하게 만드는 질문이 하나 있습니다. 월드모델이 결국 언어와 연결되어야 하고(자연어 명령을 받아들여야 하고), LLM이 결국 시각과 연결되어야 한다면(이미지와 비디오를 처리해야 한다면), 둘은 결국 같은 것으로 수렴하게 될까요?
GPT-4o(OpenAI가 2024년 공개한 멀티모달 대형 언어모델로, 텍스트·이미지·오디오 입력을 동시에 처리하고 그에 대응하는 출력을 생성할 수 있으며, "o"는 "omni"를 뜻합니다)는 이미지를 보고, 소리를 듣고, 이미지를 생성할 수 있습니다. V-JEPA 2는 픽셀을 전혀 생성하지 않고 의미적 표현만 예측하지만, 과제를 기술하려면 역시 언어가 필요합니다. 두 갈래 길이 서로 반대 방향에서 같은 지점으로 다가가고 있는 셈입니다.
어쩌면 "LLM 대 월드모델" 논쟁은 최종 산출물의 형태가 아니라 근본적으로 핵심 설계 철학에 관한 것일지도 모릅니다. 언어에서 출발해 물리적 이해로 확장할 것인가? 아니면 물리적 지각에서 출발해 언어 인터페이스로 확장할 것인가?
출발점이 다르면, 최종 능력이 비슷해 보이더라도 시스템 아키텍처, 학습 데이터, 평가 지표에서 근본적인 차이가 생길 수 있습니다.
이 질문에 대한 Saining Xie의 답은 AMI Labs의 기술적 선택에 그대로 담겨 있습니다. 물리적 지각에서 출발하고, 언어는 토대가 아니라 인터페이스로 쓰는 것입니다. 이 선택에는 분명한 대가가 따르는데, Common Crawl이 아니라 물리 세계의 센서 기록이라는 완전히 다른 종류의 데이터가 필요하다는 것입니다.
여러분에게 남기는 질문
V-JEPA 2는 픽셀을 전혀 생성하지 않고 의미적 표현만 예측하는 반면, GPT-4o는 이미지를 보고 생성할 수 있습니다. 5년 뒤에도 이 두 갈래 길이 여전히 나뉘어 있을 거라고 생각하나요?
만약 수렴한다면 누가 "승자"일까요, 언어파일까요 아니면 월드모델파일까요? 아니면 이 질문 자체가 잘못 던져진 걸까요?