
일곱 가지 흔한 함정, 배포 전략, 그리고 강의 총정리
실전 배포에서 가장 흔한 일곱 가지 함정
동작 의미 불일치
시뮬레이션에서는 action 하나가 이상적인 관절 목표값(관절 각도에 직접 대입)일 수 있지만, 실제 로봇에서는 PD 컨트롤러(Proportional-Derivative controller, 비례-미분 제어기. 현재 오차의 크기(비례항 P)와 오차의 변화율(미분항 D)을 바탕으로 제어 신호를 출력해 관절 각도가 목표값을 따라가게 만드는 고전적인 폐루프 제어기입니다. 실제 로봇은 거의 예외 없이 이 저수준 제어 층을 갖고 있지만, 시뮬레이션에서는 흔히 단순화되거나 생략됩니다), 하드웨어 한계, 속도 제약, 모터 응답 지연을 거쳐야 합니다. 월드모델을 "이상적인 동작"으로 학습시키면, 이 모델이 배우는 동역학은 존재하지 않는 "완벽한 로봇"을 묘사하게 되고, 정책이 학습한 동작 시퀀스는 실제 하드웨어에서 실행되지 못할 수 있습니다.
시간 지연과 비동기 센서
카메라(보통 30Hz나 60Hz), 힘 센서(보통 1kHz), 관절 상태(250Hz 이상), 제어 명령(가변 주파수)은 서로 동기화되어 있지 않은 경우가 많습니다. 월드모델은 o_t와 a_t가 같은 순간에 수집됐다고 가정하지만, 실제로는 수십에서 수백 밀리초까지 차이가 날 수 있습니다. 고속 보행이나 접촉이 많은 조작 과제에서는 이 시간 차이만으로도 예측이 무효화되기에 충분합니다. 로봇이 "다리가 방금 땅에 닿았다"고 예측하는 순간, 실제로는 그 다리가 이미 다시 떠 있을 수 있습니다.
보이지 않는 접촉 상태
접촉한 것처럼 보인다고 해서 힘이 실제로 전달됐다는 뜻은 아니고, 움직이지 않는 것처럼 보인다고 해서 물체가 미세하게 미끄러지지 않았다는 뜻도 아닙니다. 이것이 시각 기반 월드모델이 조작 과제에서 가장 크게 놓치는 부분입니다. 물건 잡기, 핀 끼우기, 뚜껑 조이기, 서랍 당기기 같은 과제는 모두 보이지 않는 접촉 변수(수직항력, 접선력, 접촉 면적)에 크게 의존합니다. RGB 입력에만 의존하는 월드모델의 예측 한계는 이런 종류의 과제에서 인간의 기대치를 훨씬 밑돕니다.
장기 호라이즌 드리프트
비디오 월드모델은 짧은 롤아웃(1~5스텝)에서는 그럴듯해 보이지만, 시간이 길어질수록 물체의 정체성(빨간 공이 파란 공으로 바뀜), 기하학적 관계(두 물체의 상대 위치가 뒤집힘), 접촉 상태("손에 쥔 물체"가 "허공에 뜬 물체"로 바뀜)가 모두 조용히 무너집니다. 표현 공간 예측(TD-MPC 방식), self-forcing 학습(STORM 방식), 3D 명시적 표현(NeRF, Neural Radiance Field, 3D 장면을 신경망으로 암묵적으로 표현해 임의의 시점에서 이미지를 렌더링할 수 있는 방법; 3DGS, 3D Gaussian Splatting, 대량의 3D 가우시안으로 장면을 명시적으로 표현해 NeRF보다 훨씬 빠르게 렌더링하는 방법. 둘 다 명시적인 3D 기하 구조를 유지하기 때문에 프레임 사이에서 물체 지속성을 지키는 데 도움이 됩니다)이 모두 이 문제를 완화해주지만, 지금 시점에서 완전한 해결책은 없습니다.
정책이 모델의 허점을 파고드는 문제(모델 악용, Model Exploitation)
정책은 보상을 최적화할 뿐이라서, 월드모델 안에서는 높은 보상을 받지만 실제 세계에서는 성립하지 않는 동작을 찾아냅니다. 이건 정책의 잘못이 아니라 최적화라는 것의 본질입니다. 전형적인 사례로, 학습된 시뮬레이터 안에서 정책이 "관절을 작고 빠르게 진동시켜 높은 보상을 얻는" 요령을 찾아내는 경우가 있습니다. 이 동작 패턴은 모델 안에서는 모든 물리 제약을 우회하지만, 실제 로봇에서는 모터를 망가뜨리거나 비상 정지를 유발할 뿐입니다.
탐지 방법: 정책이 학습한 고보상 동작 시퀀스를 실제 환경에서 주기적으로 실행해보고, "모델 안에서는 효과 있지만 실제 로봇에서는 효과 없는" 동작이 있는지 확인합니다. 그 비율이 20%를 넘으면, 적대적 학습을 도입하거나 월드모델의 허점을 체계적으로 손봐야 합니다.
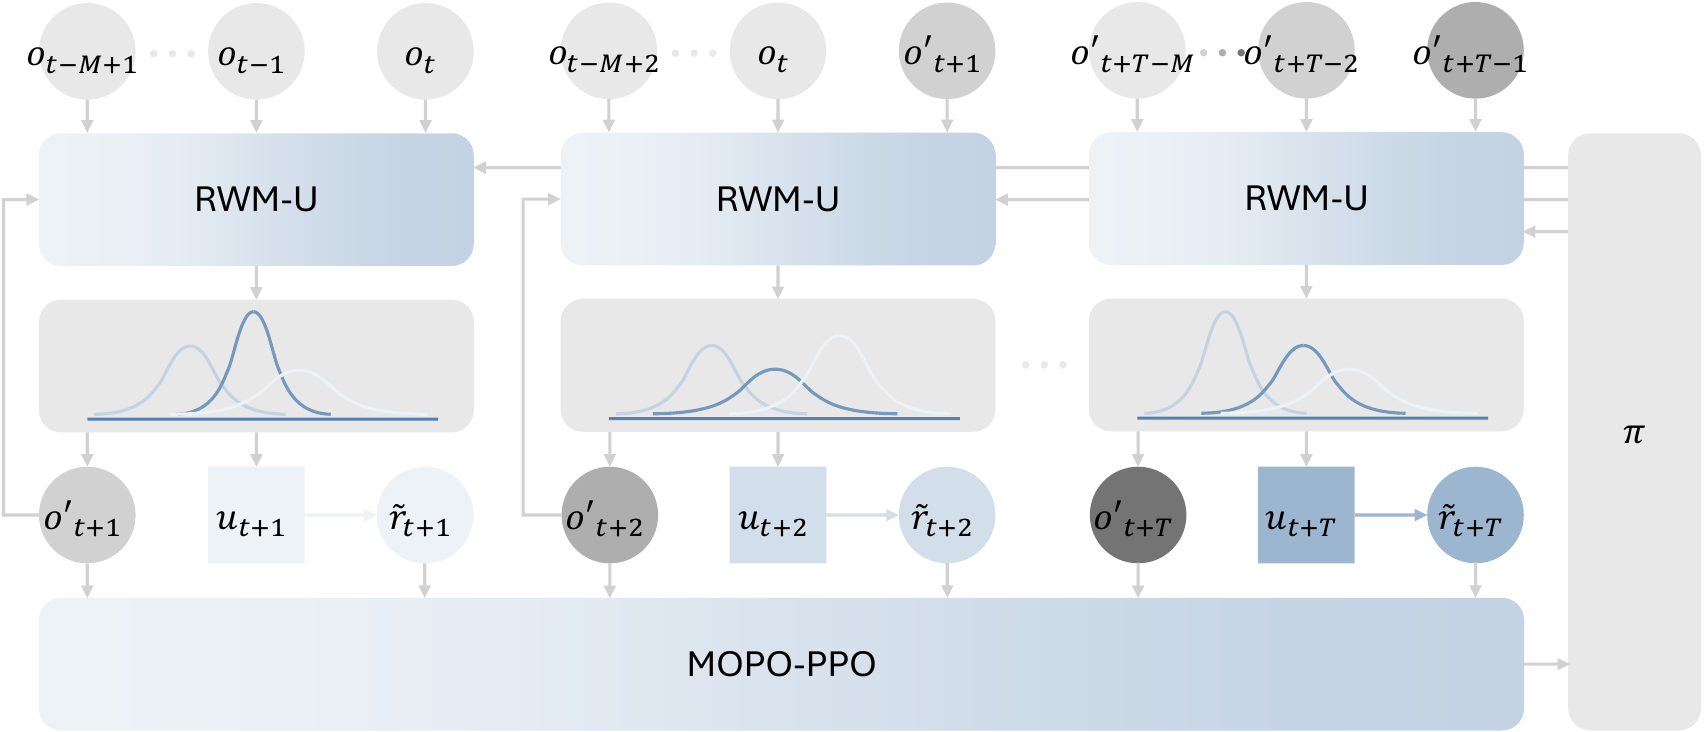
불확실성이 제어 결정에 반영되지 않는 문제
많은 월드모델이 그럴듯해 보이는 미래 예측을 내놓으면서도, 하위 정책에게 "사실 여기랑 비슷한 상태를 본 적이 없다"는 사실을 알려주지 않습니다. 이 소리 없는 실패 양상은 명백한 예측 오류보다 더 위험합니다. 정책은 자신이 익숙한 지형을 지나가고 있다고 믿지만, 실제로는 이미 분포 밖 영역에 들어선 상태이기 때문입니다.
실전 배포에서는 계획을 세울 때 불확실성을 반드시 고려해야 합니다. 불확실할 때는 속도를 늦추거나, 더 보수적인 동작을 고르거나, 능동적으로 사람의 개입을 요청해야 합니다. 간단한 구현 방법은 월드모델의 잠재 공간에 학습 데이터에 대한 밀도 추정기를 두는 것입니다(예: 커널 밀도 추정(kernel density estimation), 학습 데이터 점들 주위에 가우시안 커널을 놓아 확률 밀도를 추정하는 비모수적 방법으로, 밀도가 낮으면 현재 상태가 학습 분포에서 멀리 떨어져 있다는 뜻입니다; 또는 정규화 흐름(normalizing flow), 학습된 분포 아래에서 임의의 입력 점의 확률 밀도를 정확히 계산할 수 있는 가역적인 신경망 모델). 새 관측의 밀도가 임계값 아래로 떨어지면 "높은 불확실성" 플래그가 발동됩니다.
안전은 보상 셰이핑만으로는 완전히 해결되지 않습니다
가정과 공장의 로봇에는 하드 안전 계층이 필요합니다. 관절 속도 제한, 엔드 이펙터(end-effector, 로봇 팔 끝에 달려 물체를 직접 잡거나 조작하는 부분으로, 그리퍼나 로봇 손이 대표적입니다) 힘 제한, 작업 공간 충돌 감지, 비상 정지, 사람 개입 프로토콜이 여기에 해당합니다. 이런 것들은 월드모델이 학습한 "안전 인식"에만 전적으로 의존할 수 없습니다. 월드모델 자체가 틀릴 수 있기 때문입니다.
월드모델은 위험 예측의 역할을 맡을 수 있습니다("이 동작을 실행하면 다음 3스텝 안에 충돌할 확률이 40%다"처럼). 하지만 최종적인 하드 안전 보장은 학습에 의존하지 않는 독립적인 제어 계층에서 나와야 합니다. 안전 제약은 ML 학습만의 문제가 아니라 소프트웨어 공학의 문제이기도 합니다.
더 읽을거리
- Dreamer 시리즈 논문: L01 더 읽을거리(Dreamer V1)와 L02 더 읽을거리(V2/V3/V4) 참고
- MuZero: L03 더 읽을거리(Schrittwieser et al., 2020) 참고
- TD-MPC: L03 더 읽을거리(Hansen et al., 2022) 참고
- STORM: L04 STORM 지표 페이지의 더 읽을거리(Zhang et al., 2023) 참고
- Alonso et al. (2024): Diamond: Diffusion 월드모델, NeurIPS 2024
- Heusel et al. (2017): FID: Fréchet Inception Distance 원 논문