
백본 선택: RSSM, Transformer, Diffusion
P03을 마친 뒤에 이 페이지를 읽으세요. 이제 여러분에게는 실제로 동작하는 RSSM 기반 에이전트가 있으므로, 대안 아키텍처를 실제로 관찰한 실패 사례와 비교해볼 수 있습니다. RNN/RSSM과 Transformer는 P04에 필요한 핵심 비교 대상입니다. Diffusion 절은 온라인 제어에 필요한 낮은 지연 시간보다 시각적 품질이 더 중요한 과제를 위한 확장 내용입니다.
복습: 이미 RNN 기준선을 갖고 있습니다
P02의 RSSM은 두 개의 병렬 경로를 가지고 있습니다.
- 결정론적 경로(GRU):
, 부드러운 동적 추세를 포착합니다 - 확률적 경로:
, 잠재 공간에서 현재 시점의 불확실성을 샘플링합니다
이 설계는 Dreamer V1/V2에서 검증되었으며, 매우 낮은 연산 비용으로 연속 제어 태스크에서 준수한 정책 성능을 냅니다. 한계도 뚜렷한데, GRU의 기억 용량은 시퀀스가 길어질수록 저하되어 수백 스텝에 걸친 추론이 필요한 과제에는 역부족입니다.
이어지는 다섯 가지 아키텍처 계열은 모두 이 한계를 돌파하려는 시도지만, 각자 다른 방향을 택합니다.
흔한 오해
"아키텍처는 최신일수록 무조건 낫다." Transformer와 diffusion 백본이 일부 벤치마크에서 더 높은 점수를 받는 것은 사실이지만, 둘 다 대가를 치릅니다. Transformer는 시퀀스 길이에 따라 계산량이 제곱으로 늘어나고 수렴하는 데 더 많은 데이터가 필요하며, diffusion 샘플링은 프레임당 10에서 100번의 디노이징을 거쳐야 하고 엔드투엔드로 미분 가능하지도 않습니다. 온라인 지연 시간이나 동역학 모델을 통한 그라디언트 접근이 원시 시퀀스 길이나 시각적 품질보다 더 중요한 상황이라면 RSSM이 여전히 옳은 선택이며, L03 계획 절에서 Dreamer의 Actor-Critic이 처한 상황이 정확히 이 경우입니다.
"더 긴 컨텍스트 윈도우는 RSSM의 제한된 기억력을 공짜로 업그레이드해준다." 셀프 어텐션이 GRU의 은닉 상태 병목을 없애 모든 위치가 이전의 어느 시점이든 직접 볼 수 있게 해주는 것은 맞습니다. 하지만 비용까지 없애주지는 않습니다. 어텐션의 계산량은 시퀀스 길이에 대해
"생성된 프레임이 보기 좋을수록 더 좋은 월드모델이다." Diamond의 프레임은 시각적 품질에서 이전의 모든 월드모델을 능가하지만, 시각적 품질과 쓸모 있는 상태는 서로 다른 축입니다. Diffusion 모델은 각 프레임을 거의 독립적으로 디노이징하며 명시적인 물체 기억이 없어서, 개별 프레임 하나하나는 그럴듯해 보이더라도 물체의 정체성, 위치, 가림 관계가 긴 롤아웃에 걸쳐 조금씩 어긋날 수 있습니다. 이것이 객체 지속성 문제이며, 이미지 품질을 높인다고 고쳐지지 않는 상태 추적의 실패입니다.
세 오해 모두 최신성, 컨텍스트 길이, 시각적 품질이라는 하나의 벤치마크 축이 그 자체로 아키텍처 선택을 결정짓는다고 착각합니다. 실제로 선택을 결정하는 것은 여러분의 배포 루프에서 어떤 제약이 실제로 발목을 잡는가입니다. 지연 시간인지, 미분 가능성인지, 연산 예산인지, 아니면 장기간의 정체성 추적인지가 그것입니다.
아키텍처 1: RNN / RSSM(이미 구현한 기준선)
대표 시스템: Ha & Schmidhuber World Models(2018), Dreamer V1(2019), Dreamer V2(2020)
GRU는 시퀀스 길이와 무관하게 스텝당 O(1)의 비용으로 은닉 상태를 점진적으로 갱신합니다. RSSM은 여기에 확률적 경로
학습 패러다임: 상호작용형입니다.
적용 시나리오: 단순~중간 복잡도의 연속 제어 태스크(예: DMControl, DeepMind Control Suite, MuJoCo 물리 엔진 기반의 표준 연속 제어 벤치마크 모음으로 치타 달리기, 카트폴 균형 잡기, 리처 목표 도달 등의 과제를 포함합니다; Atari, 범용 의사결정 능력을 평가하는 데 쓰이는 57개 게임으로 구성된 고전 비디오 게임 벤치마크 모음), 지연 시간에 민감한 온라인 강화학습.
한계: 장기 기억이 약하며, GRU 은닉 상태의 유효 기억 범위는 보통 50~100 스텝 사이입니다. 생성 품질은 Diffusion에 못 미치고, 실제 로봇에서의 데이터 수집은 여전히 비쌉니다.
아키텍처 2: Transformer 기반(2022, 2023)
대표 시스템: IRIS(2022), STORM(2023)
핵심 메커니즘
GRU를 Transformer로 교체하고, 과거 관측 시퀀스
📖 소프트맥스(softmax)와 셀프 어텐션의 Q, K, V: 소프트맥스는 임의의 실수 벡터
를 확률분포로 바꿔줍니다(모든 원소가 0 이상이고 합이 1이 되도록): . 가 클수록 출력 확률도 커지고, 작을수록 확률이 0에 가까워집니다. 셀프 어텐션은 먼저 시퀀스의 각 위치 벡터를 세 가지 역할로 선형 변환합니다. 쿼리(Query, Q)는 현재 위치가 "무엇을 묻고 있는가", 키(Key, K)는 다른 위치가 "어떤 정보를 제공하는가", 밸류(Value, V)는 실제로 담고 있는 정보 내용을 나타냅니다. 는 위치 쌍 사이의 연관성 점수를 계산하고, 로 나누어 차원이 커질수록 내적 값이 과도하게 커져 소프트맥스 출력이 지나치게 뾰족해지는 것을 막으며, 소프트맥스가 점수를 가중치로 정규화하고, 이 가중치로 의 가중합을 계산합니다.
시퀀스의 어느 위치든 과거의 어떤 시점이든 직접 "볼" 수 있어, 더 이상 GRU의 은닉 상태 병목에 갇히지 않습니다.
IRIS: 이미지를 "문장"으로 바꾸기
IRIS(Imagination with auto-Regression over an Inner Speech, ICLR 2023)의 핵심은 VQ-VAE 양자화로, 연속적인 이미지 프레임을 이산 토큰 시퀀스로 바꿉니다. GPT가 "다음 단어"를 예측할 수 있는 이유는 단어가 이산적이고 유한해서 소프트맥스로 확률분포를 정확히 모델링할 수 있기 때문입니다. 이미지도 "단어"와 비슷한 이산 단위로 바꾸면, GPT 스타일의 자기회귀 Transformer를 그대로 적용해 "다음 시각적 단어"를 예측할 수 있습니다.
📖 VQ(vector quantization, 벡터 양자화)의 작동 원리: ① 인코더가 이미지 패치를 연속 벡터
로 매핑합니다. ② 코드북(codebook)에서 와 가장 가까운 벡터 를 찾습니다( ). ③ 연속 벡터 대신 의 인덱스 를 Transformer에 전달합니다. 역전파 시에는 STE(straight-through estimator)를 사용합니다. 순전파에서는 양자화된 이산 벡터를 쓰고, 역전파에서는 양자화 연산이 없는 것처럼 취급해 그라디언트를 그대로 통과시킵니다.
IRIS의 Transformer는 프레임 토큰과 동작이 교차로 배열된 시퀀스를 입력받습니다. 각 프레임은 VQ-VAE에 의해
IRIS의 처리 과정은 하나의 파이프라인입니다. VQ-VAE가 원본 프레임을 이산 토큰 시퀀스로 인코딩하고, Transformer가 다음 프레임의 토큰 시퀀스를 자기회귀적으로 예측하며, VQ-VAE가 이를 다시 재구성된 이미지로 디코딩합니다.
STORM의 핵심 개선: 단일 토큰 확률적 잠재 변수
STORM(Stochastic Transformer-based wORld Models, NeurIPS 2023)이 IRIS와 다른 주된 지점은 잠재 변수 설계입니다. IRIS는 VQ-VAE로 프레임 하나를 여러 개의 이산 토큰(
Transformer는 인과적 마스킹(causal masking)으로 시퀀스를 처리하며,
📖 Teacher Forcing: 학습 중에는 모델이 매 시점마다 자신의 이전 예측이 아니라 실제 과거 프레임을 조건으로 사용합니다. 이렇게 하면 학습이 더 안정적이고 수렴도 빨라지지만, "학습 때는 항상 정확한 과거 프레임이 있지만 추론 때는 모델 자신의 예측 프레임밖에 없다"는 분포 격차가 생깁니다. 자기회귀 월드모델에서 이는 오차가 누적되는 가장 흔한 원인이며, STORM의 평가 지표 중 장기 호라이즌 PSNR(Long-Horizon PSNR)은 바로 이 격차를 정량화하기 위해 설계되었습니다(자세한 내용은 L04의 STORM 지표 절 참고).
DreamerV3의 GRU 기반 RSSM과 비교하면, STORM의 Transformer 시퀀스 모델은 긴 시퀀스 모델링에 더 강하고 학습을 병렬화할 수 있습니다. 대가는 RSSM의 순환 은닉 상태
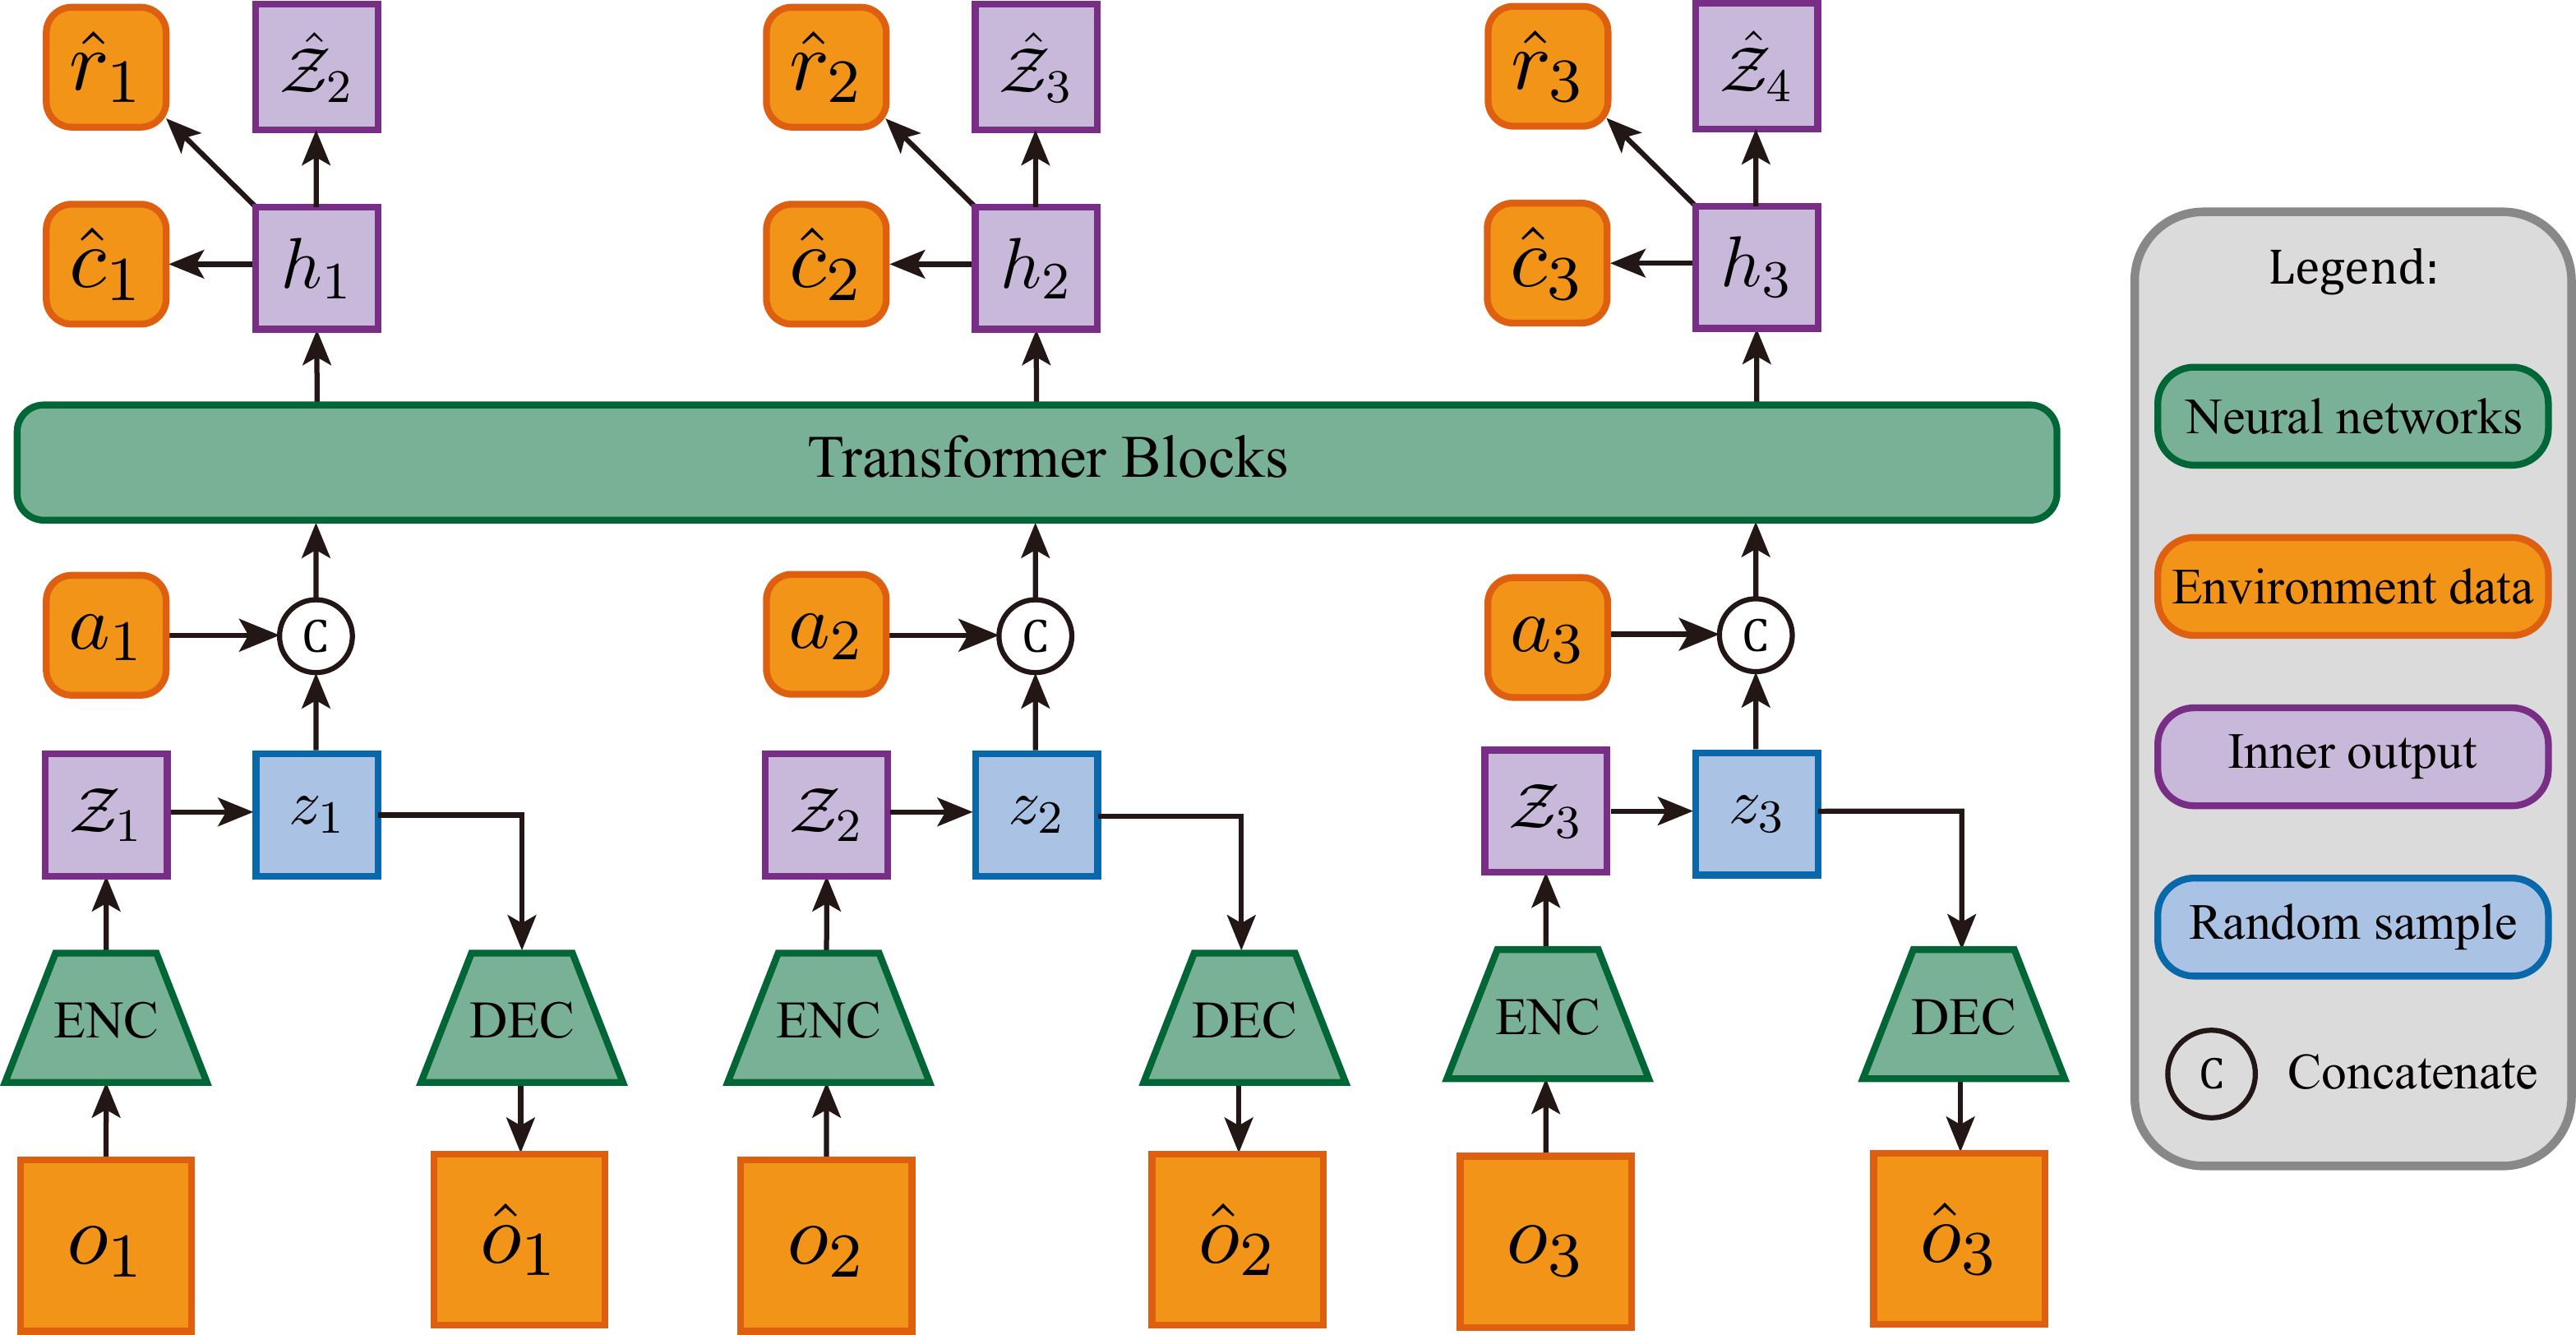
학습 패러다임: 상호작용형(동작 조건화). 동작
적용 시나리오: 복잡한 게임(긴 Atari 게임, 전략 게임), 다단계 계획이 필요한 과제이며, 연산과 데이터가 충분할 때 우선적으로 고려할 선택지입니다.
한계: 연산량이 시퀀스 길이에 대해 제곱으로 증가하고(
아키텍처 3: Diffusion 기반(2023, 2024)
대표 시스템: Diamond(2024), GameNGen(Google, 2024)
핵심 메커니즘
Diffusion 모델은 반복적인 노이즈 제거를 통해 출력을 생성합니다. 실제 프레임에 가우시안 노이즈를 더한 뒤, 그 노이즈를 예측하도록 네트워크를 학습시킵니다.
월드모델에서는 과거 프레임과 동작을 조건으로, Diffusion 모델이 다음 프레임을 점진적으로 "노이즈 제거"해 만들어냅니다. 노이즈 제거 한 스텝은 신경망을 한 번 완전히 순전파하는 것이며, "동작 조건"의 안내를 받아 "어디의 노이즈를 제거할지"를 결정합니다.
📖 U-Net: 인코더-디코더 구조를 가진 합성곱 신경망으로, 모양이 알파벳 "U"를 닮았다고 해서 이런 이름이 붙었습니다. 인코더는 공간 해상도를 점진적으로 낮추며(특징을 추출) 디코더는 해상도를 점진적으로 복원하는데(디테일을 되살림), 이때 스킵 커넥션(skip connection)이 인코더 각 층의 특징을 대응하는 디코더 층으로 직접 전달해 고주파 디테일을 보존합니다. 병목(bottleneck)은 U자 구조에서 가장 아래, 해상도가 가장 낮은 층으로, 여기서 정보가 고도로 압축되었다가 다시 점진적으로 펼쳐집니다. Diffusion 월드모델은 노이즈 제거 단계마다 U-Net으로 이미지를 처리해 점점 더 선명해지는 프레임을 예측합니다.
GameNGen(2024)은 신경망으로 완전한 게임 엔진을 실시간으로 구동한 최초의 시스템으로, 20fps로 《DOOM》을 시뮬레이션합니다. 모델 자체가 게임 엔진인 셈입니다. 프레임 하나를 생성하는 데 10~100회의 노이즈 제거 반복이 필요하고 매 스텝이 U-Net을 한 번씩 완전히 순전파하는 것이라, Diffusion 월드모델은 온라인 RL 학습 루프에서는 대단히 비쌉니다.
Diamond: Diffusion 과정과 RL 학습 루프를 결합한 월드모델
Diamond(NeurIPS 2024)는 Diffusion 과정을 강화학습 학습 루프와 직접 결합합니다. 과거 몇 프레임과 현재 동작을 조건으로 U-Net으로 노이즈를 제거해 다음 프레임을 생성하고, 이 전체 생성 체인이 정책 학습을 위한 환경 시뮬레이터 역할을 합니다.
Diamond가 내린 핵심 설계적 결정은, 동작 정보를 크로스 어텐션(cross-attention, 셀프 어텐션의 변형으로 Query는 한 시퀀스에서 Key와 Value는 다른 시퀀스에서 가져와 서로 다른 두 정보 소스를 정렬하는 방식이며, 여기서는 이미지 특징이 동작 정보를 "조회"하는 데 쓰입니다)을 통해 병목(U-Net에서 해상도가 가장 낮은 층)뿐 아니라 U-Net의 모든 해상도 층에 주입한다는 점이며, 이 덕분에 생성된 프레임이 동작 지시와 더 긴밀하게 맞물립니다. Atari 100k 벤치마크에서 Diamond는 평균 HNS 1.46으로 기존의 모든 월드모델 방법을 능가하면서도 뛰어난 시각적 생성 품질을 유지했습니다.
Diffusion 월드모델은 각 프레임을 독립적으로 노이즈 제거하고 명시적인 물체 상태를 유지하지 않다 보니, 긴 시퀀스에서 물체의 정체성, 위치, 가림 관계가 슬금슬금 어긋나는 물체 지속성(object persistence) 문제를 고질적으로 안고 있습니다. Diamond는 롤아웃 스텝 수를 제한하고 손실에 깊이 일관성 페널티를 더해 이 문제를 완화합니다(더 많은 진단 방법은 L04 참고).
학습 패러다임: 상호작용형(Diamond는 동작 조건화) 또는 관측형(순수 비디오 Diffusion 모델). 관측형 Diffusion 모델은 방대한 인터넷 비디오로 학습되어 세계의 시각적 규칙성은 배우지만 동작 조건이 없어서, "다른 동작을 했다면 어떻게 됐을까"라는 질문에는 답할 수 없습니다.
적용 시나리오: 오프라인 비디오 예측, 고정밀 시뮬레이터, 영화·게임 콘텐츠 생성이며, 실시간 폐루프 제어가 필요한 RL 시나리오에는 적합하지 않습니다.
한계: 추론이 느리고(10~100스텝의 노이즈 제거), 정책 최적화와 직접 연결하기 어려우며(샘플링 과정이 미분 불가능), 물체 지속성을 유지하기 어렵고, 학습과 추론 비용이 상당합니다.
이 절의 핵심 정리
P04를 위한 실질적인 비교 대상은 RSSM과 Transformer입니다. 순환 상태(recurrent state)는 지연 시간이 낮은 온라인 업데이트를 제공하고, 어텐션은 더 많은 연산을 들이는 대신 더 긴 문맥에 접근할 수 있습니다. 계속 진행하기 전에 P04: 동역학 백본 교체를 완료하세요. 이후에 나오는 페이지들은 선택적으로 읽으면 되는 최전선 연구 동향으로, 프로젝트들에서 구현하지 않는 방향을 살펴봅니다.