이론적 초석
첫 번째 초석: Craik의 소형 모델 (1943)
영국의 심리학자 Kenneth Craik은 제2차 세계대전 중에 얇은 책 한 권 《The Nature of Explanation》[1]을 쓰며, 시대를 앞선 아이디어를 제시했습니다.
"만약 유기체가 머릿속에 외부 현실과 자신이 취할 수 있는 행동에 대한 '축소된 규모의 모델'을 지니고 있다면, 여러 가능성을 미리 시험해보고 그중 최선이 무엇인지 판단해, 실제 위급 상황에 부딪히기 전에 미래를 예측하는 데 이 지식을 쓸 수 있을 것이다."
Craik은 뇌가 자극을 수동적으로 받아들이고 반응을 수동적으로 출력하는 블랙박스가 아니라, 내부 시뮬레이터를 능동적으로 유지하는 존재라고 보았습니다. 이 시뮬레이터는 미래로 "빨리 감기"하고 과거로 "되감기"할 수 있어서, 생물이 실제 대가를 치르기 전에 최선의 행동을 미리 걸러낼 수 있게 해줍니다.
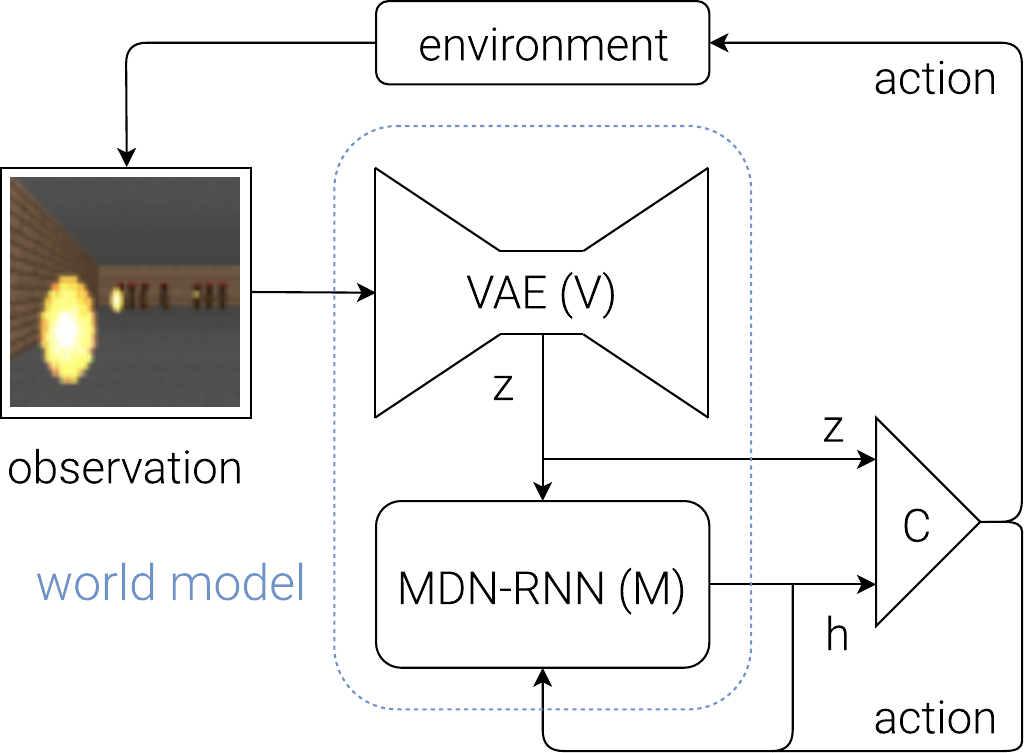
지각 입력은 내부 모델로 들어가고, 내부 모델은 예측을 생성해 의사결정을 이끌며, 예측 오차는 다시 모델을 수정하는 데 쓰입니다.
안타깝게도 Craik은 1945년 자전거 사고로 31세라는 젊은 나이에 세상을 떠났고, 그의 사상은 수십 년간 잠들어 있다가 인지과학과 신경과학이 부상하면서 비로소 재발견되었습니다.
뇌의 예언 메커니즘: 예측 부호화 (1990년대)
1990년대에 신경과학자들은 예측 부호화(Predictive Coding)라는 개념으로 뇌의 작동 방식을 설명하기 시작했습니다.
핵심 아이디어는 뜻밖에도 단순합니다.
뇌는 세계를 "보고" 있는 것이 아니라 세계를 예측하고 있으며, 그중 "예측이 틀린 부분"만 처리합니다.
시각 피질은 눈에서 들어오는 모든 픽셀을 하나하나 성실하게 뇌로 전달하지 않는데, 그렇게 하기에는 너무 많은 에너지가 들기 때문입니다. 대신 뇌의 상위 영역은 하위 영역으로 끊임없이 "예측을 하달"하고, 하위 영역은 예측과 실제 감각 신호 사이의 오차만 위로 전달하면 됩니다.
익숙한 방에 들어가면 뇌는 거의 아무 정보도 처리할 필요가 없는데, 모든 것이 예상 범위 안에 있기 때문입니다. 하지만 의자 위치가 바뀌었다면, 그 "어긋난" 신호는 즉시 증폭되어 주의를 끌게 됩니다.
이 메커니즘은 우리가 변화에는 왜 그렇게 민감하고 익숙한 배경에는 왜 그렇게 무심한지를 설명해줍니다. 정확하게 예측된 부분은 압축되어 사라지고, 오직 오차만이 주목할 가치를 갖습니다.
제어 이론이 준 통찰: 내부 모델 원리 (1960년대)
거의 같은 시기에 제어 공학 분야에서도 비슷한 사상이 독자적으로 발견되어, 1960년대에 내부 모델 원리(Internal Model Principle)가 정식으로 제안되었습니다.
어떤 시스템을 완벽하게 제어하려면, 컨트롤러 내부에 그 시스템의 모델이 반드시 포함되어 있어야 한다.
공학 용어처럼 들리지만 직관은 아주 명료합니다. 자율 주행차가 커브길에서 차선을 유지하려면, 그 제어 알고리즘은 차량이 커브에서 어떻게 움직이는지를 "알고" 있어야 합니다. 단순한 반응이 아니라 예측에 의해서입니다.
이 원리는 로보틱스, 우주항공, 경제 모델 등 곳곳에 존재하며, 훗날 강화학습에서 "모델 기반 방법"의 이론적 뿌리가 되었습니다. 무언가를 제어하려면 먼저 그것을 이해해야 한다는 상식을, 내부 모델 원리는 수학적으로 필요한 조건으로 바꿔놓았습니다.
회의론자의 반박과 2025년의 증명
모두가 동의한 것은 아니었습니다. 1991년, 로봇공학자 Rodney Brooks는 《Intelligence without Representation》에서 "세계 그 자체가 세계의 가장 좋은 모델이다"라며 정반대의 주장을 펼쳤습니다. 실제 세계 자체가 언제나 최신 상태의 지도가 되어주므로, 에이전트는 환경에 대한 모델을 따로 지니고 다닐 필요가 없습니다. 대신 중간에 판단 과정을 거치지 않고 지각이 곧장 행동으로 이어지는 긴밀한 순환 구조만으로도 충분히 지능적으로 행동할 수 있습니다. 이는 수십 년간 단순한 철학적 입장에 머물지 않았습니다. 모델 프리 에이전트들이 누구도 명시적인 월드모델을 심어주지 않았는데도 다양한 태스크에 걸쳐 실제로 일반화에 성공했고, 그래서 Brooks의 주장을 쉽게 일축하기 어려웠습니다.
2025년, Google DeepMind의 연구자들은 또 하나의 주장이 아니라 증명으로 이 논쟁을 매듭지었습니다. 《General Agents Need World Models》에서 Richens, Abel, Bellot, Everitt는 폭넓은 범위의 목표에 걸쳐 일반화할 수 있는 에이전트라면 반드시 자신의 환경에 대한 예측 모델을 암묵적으로 학습했을 수밖에 없으며, 이 모델은 에이전트의 내부를 들여다보지 않고도 오직 행동만으로 항상 복원할 수 있음을 보였습니다. Craik의 1943년 직관은 뇌에 대한 비유에 그치지 않고, 현대의 학습된 에이전트에 대한 정리(theorem)였던 셈입니다.
📖 궁금한 분들을 위한 정리 내용: 이 논문은 환경을 전이 함수
를 가진 통제된 마르코프 과정으로 형식화하고, 최선의 정책 대비 깊이 까지의 복합 목표에서 실패율이 최대 인 경계가 있는(bounded) 목표 조건화 에이전트를 고려했습니다. 핵심 결과는, 이런 에이전트의 정책만으로도 오차가 로 제한되는 월드모델 가 결정된다는 것입니다. 에이전트가 더 유능해질수록( ) 또는 더 긴 호라이즌의 목표를 다뤄야 할수록(더 큰 ), 복원 가능한 월드모델은 더 정확해집니다. 즉 충분히 일반적인 정책을 학습하는 것은 정보 이론적으로 정확한 월드모델을 학습하는 것과 동등합니다. 이 논문은 또한 " 번 시도 안에 어떤 상태에 도달하기"와 " 번보다 더 많은 시도로 그 상태에 도달하기"처럼 이분법적으로 갈라지는 목표 쌍을 에이전트에게 질의하고, 에이전트가 어느 쪽을 선호하는지 읽어내는 것만으로 이 모델을 추출하는 알고리즘도 함께 제시했습니다. 이 결과는 여러 스텝에 걸친 호라이즌으로 계획하는 에이전트에만 성립합니다. 즉각적인 보상만 최적화하는 순전히 근시안적인 에이전트는 장기적인 결과를 예측할 필요가 전혀 없으므로, 원칙적으로는 월드모델 학습을 피할 수 있습니다. 이 결과가 Brooks의 주장을 뒤엎는 것도 아니라, 오히려 그 범위를 한정합니다. 짧은 호라이즌의 목표만 마주하는 에이전트는 정말로 풍부한 내부 모델 없이도 그럭저럭 해낼 수 있지만, 폭넓은 범위의 장기 호라이즌 목표에 걸쳐 일반화하는 에이전트라면 그 어떤 것도 월드모델을 만들지 않고는 해낼 수 없습니다.
이 강좌에 실질적으로 주는 함의는 이렇습니다. 이후 어떤 강의에서 명시적으로 사람이 설계한 월드모델 없이도 어떤 벤치마크에서 이기는 시스템을 보게 되면, 올바른 질문은 "그것이 월드모델을 가지고 있는가"가 아니라 "그것이 어디에 숨어 있는가"입니다. 알려진 바에 따르면, LLM이 만들어낸 것을 포함해 충분히 유능한 목표 지향적 정책이라면 누구도 그렇게 학습시키려 하지 않았더라도 자신의 환경을 복원 가능하게 시뮬레이션하는 방식으로 인코딩합니다.
헷갈리기 쉬운 문제: 넓은 의미와 좁은 의미의 월드모델
본격적으로 역사적 서사에 들어가기 전에 반드시 짚고 넘어가야 할 개념적 경계가 하나 있습니다. 이후에 등장하는 모든 사례가 이 경계와 관련되기 때문입니다. "월드모델"이라는 용어는 맥락에 따라 서로 다른 것을 가리킵니다.
넓은 의미의 월드모델: 예측만 하면 충분
넓은 의미에서, "다음에 무엇이 일어날지"를 예측하는 모델이라면 무엇이든 월드모델이라 부를 수 있습니다.
- 언어 모델이 다음 토큰(언어 모델이 텍스트를 처리하는 기본 단위로, 단어 하나, 글자 하나, 혹은 더 작은 단위일 수 있습니다)을 예측하는 것도 넓은 의미의 월드모델에 속합니다
- 비디오 생성 모델이 다음 프레임을 예측하는 것도 넓은 의미의 월드모델에 속합니다
- 일기예보 모델이 내일 기온을 예측하는 것도 넓은 의미의 월드모델에 속합니다
이 정의에 따르면 Veo, Sora, Genie, Cosmos 모두 "월드모델"이라는 큰 우산 아래에 놓일 수 있습니다. 이들은 실제로 어떤 의미에서는 세계의 통계적 규칙을, 즉 빛과 그림자가 어떻게 변하는지, 물체가 어떻게 움직이는지, 장면이 어떻게 전개되는지를 학습했습니다.
좁은 의미의 월드모델: 반드시 동작 조건화가 필요
하지만 로보틱스와 강화학습(Reinforcement Learning, RL)의 맥락에서 "월드모델"은 더 엄격한 의미를 갖습니다. 반드시 동작(action)을 조건으로 삼아야 합니다.
단순히 "다음 프레임이 어떤 모습일까"가 아니라, "내가 이 동작을 했을 때 세계가 어떻게 바뀔까"를 예측해야 합니다. 이를 수식으로 표현하면 다음과 같습니다.
📖 첨자 표기 안내: 수식에서 첨자
t는 시간 스텝(time step)을 순서대로 세는 숫자입니다.t=0은 첫 번째 스텝,t=1은 두 번째 스텝이며 이런 식으로 이어집니다.는 "시각 t의 관측"(observation), 는 "시각 t의 동작"(action), 은 "다음 시각의 관측"이라고 읽습니다. 이 첨자 표기법은 강좌 전체에서 계속 쓰입니다. t첨자가 붙은 변수는 모두 그 시간 스텝의 값을,t+1첨자가 붙은 변수는 다음 스텝의 값을 가리킵니다.
여기서 a_t는 에이전트가 시각 t에 실행하는 동작입니다. 이 조건 하나가 있음으로써 월드모델은 "방관자"에서 "참여자"로 바뀝니다. 세계가 어떻게 될지만 알려주는 것이 아니라, 당신의 선택이 어떤 결과를 가져올지도 알려줄 수 있게 되는 것입니다.
넓은 의미의 월드모델은 예언가로, "미래에 무슨 일이 일어날지"를 알려줍니다. 좁은 의미의 월드모델은 조언자로, "당신이 이렇게 하면 미래에 무슨 일이 일어날지"를 알려줍니다. 로봇에게 필요한 것은 조언자이지, 예언가만이 아닙니다.
실용적인 분류를 위한 세 가지 질문
구체적인 모델을 마주했을 때, 다음 세 가지 질문으로 그것이 어떤 종류의 월드모델인지 빠르게 판단할 수 있습니다.
| 분류 기준 | 선택지 | 대표 시스템 |
|---|---|---|
| 무엇을 예측하는가? | 픽셀 / 원본 프레임 | 비디오 확산 모델(Video Diffusion Model) |
| 잠재 벡터(신경망 내부의 저차원 압축 표현) | Dreamer(잠재 공간에서 정책(policy)을 학습하는 강화학습 시스템, L02–L03 참고), RSSM(Dreamer의 동역학 핵심, L02 참고) | |
| 구조화된 상태(픽셀 없이 의사결정에 필요한 정보만 유지) | MuZero, TD-MPC | |
| 동작 그 자체(비디오에서 자동으로 추론된 latent action) | Genie | |
| 동작을 입력받는가? | 동작을 받지 않음(수동적 비디오 예측) | Veo |
| 주어진 동작을 받음(제어 가능한 시뮬레이션) | Dreamer, 월드모델 기반 로봇 | |
| 스스로 동작을 학습함(latent action) | Genie | |
| 어떤 목적에 쓰이는가? | 콘텐츠 생성(비디오, 이미지) | Veo |
| 정책 평가 / 반사실 시뮬레이션 | 자율 주행 테스트 | |
| 꿈속에서 정책 학습 | Dreamer, Ha & Schmidhuber | |
| 물리 이해, 지식 전이 | JEPA, 파운데이션 월드모델 |
이 강좌가 다루는 것은 좁은 의미의 월드모델, 즉 동작을 조건으로 하면서 계획(planning)과 정책 학습에 쓰일 수 있는 동역학 모델입니다.