
1.8 矩阵分解应用
核心问题: 如何用矩阵分解方法解决信号处理问题?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
矩阵分解基础
奇异值分解(Singular Value Decomposition, SVD)
定义: 任何矩阵都可以分解为三个矩阵的乘积。
其中:
: 酉矩阵(左奇异向量) : 对角矩阵(奇异值) : 酉矩阵的共轭转置(右奇异向量)
奇异值:
秩:
特征值分解(Eigenvalue Decomposition, EVD)
定义: 在复数域上,方阵
其中:
:特征向量矩阵 :特征值对角矩阵
对于Hermitian矩阵:
其中
QR分解
定义: 对
其中:
: 、满足 的矩阵 : 上三角矩阵
应用: 数值稳定的最小二乘求解。
信号处理中的矩阵表示
数据矩阵
问题: 如何用矩阵表示信号?
方法1:向量表示
方法2:Hankel矩阵
用途: 将一维信号转换为二维矩阵,便于矩阵分解。
协方差矩阵
定义: 对随机向量
样本协方差矩阵: 对
部分信号处理实现使用
性质:
- Hermitian矩阵:
- 半正定:所有特征值
- 特征值反映信号的功率分布
子空间方法
信号子空间和噪声子空间
问题: 给定观测
方法: 对协方差矩阵进行EVD。
其中:
:信号子空间(对应大特征值) :噪声子空间(对应小特征值)
关键性质: 信号子空间和噪声子空间正交。
MUSIC算法(Multiple Signal Classification)
问题: 估计多个信号的频率。
观测模型:
MUSIC算法步骤:
构造数据矩阵
其中
计算协方差矩阵
EVD分解
MUSIC谱
其中
是导向向量 峰值检测 找到
的 个最大峰值
优点:
- 在模型阶数正确、快拍数和 SNR 足够等条件下,分辨率可以高于普通周期图
- 在模型匹配和高 SNR 等条件下,估计方差可能接近 CRB
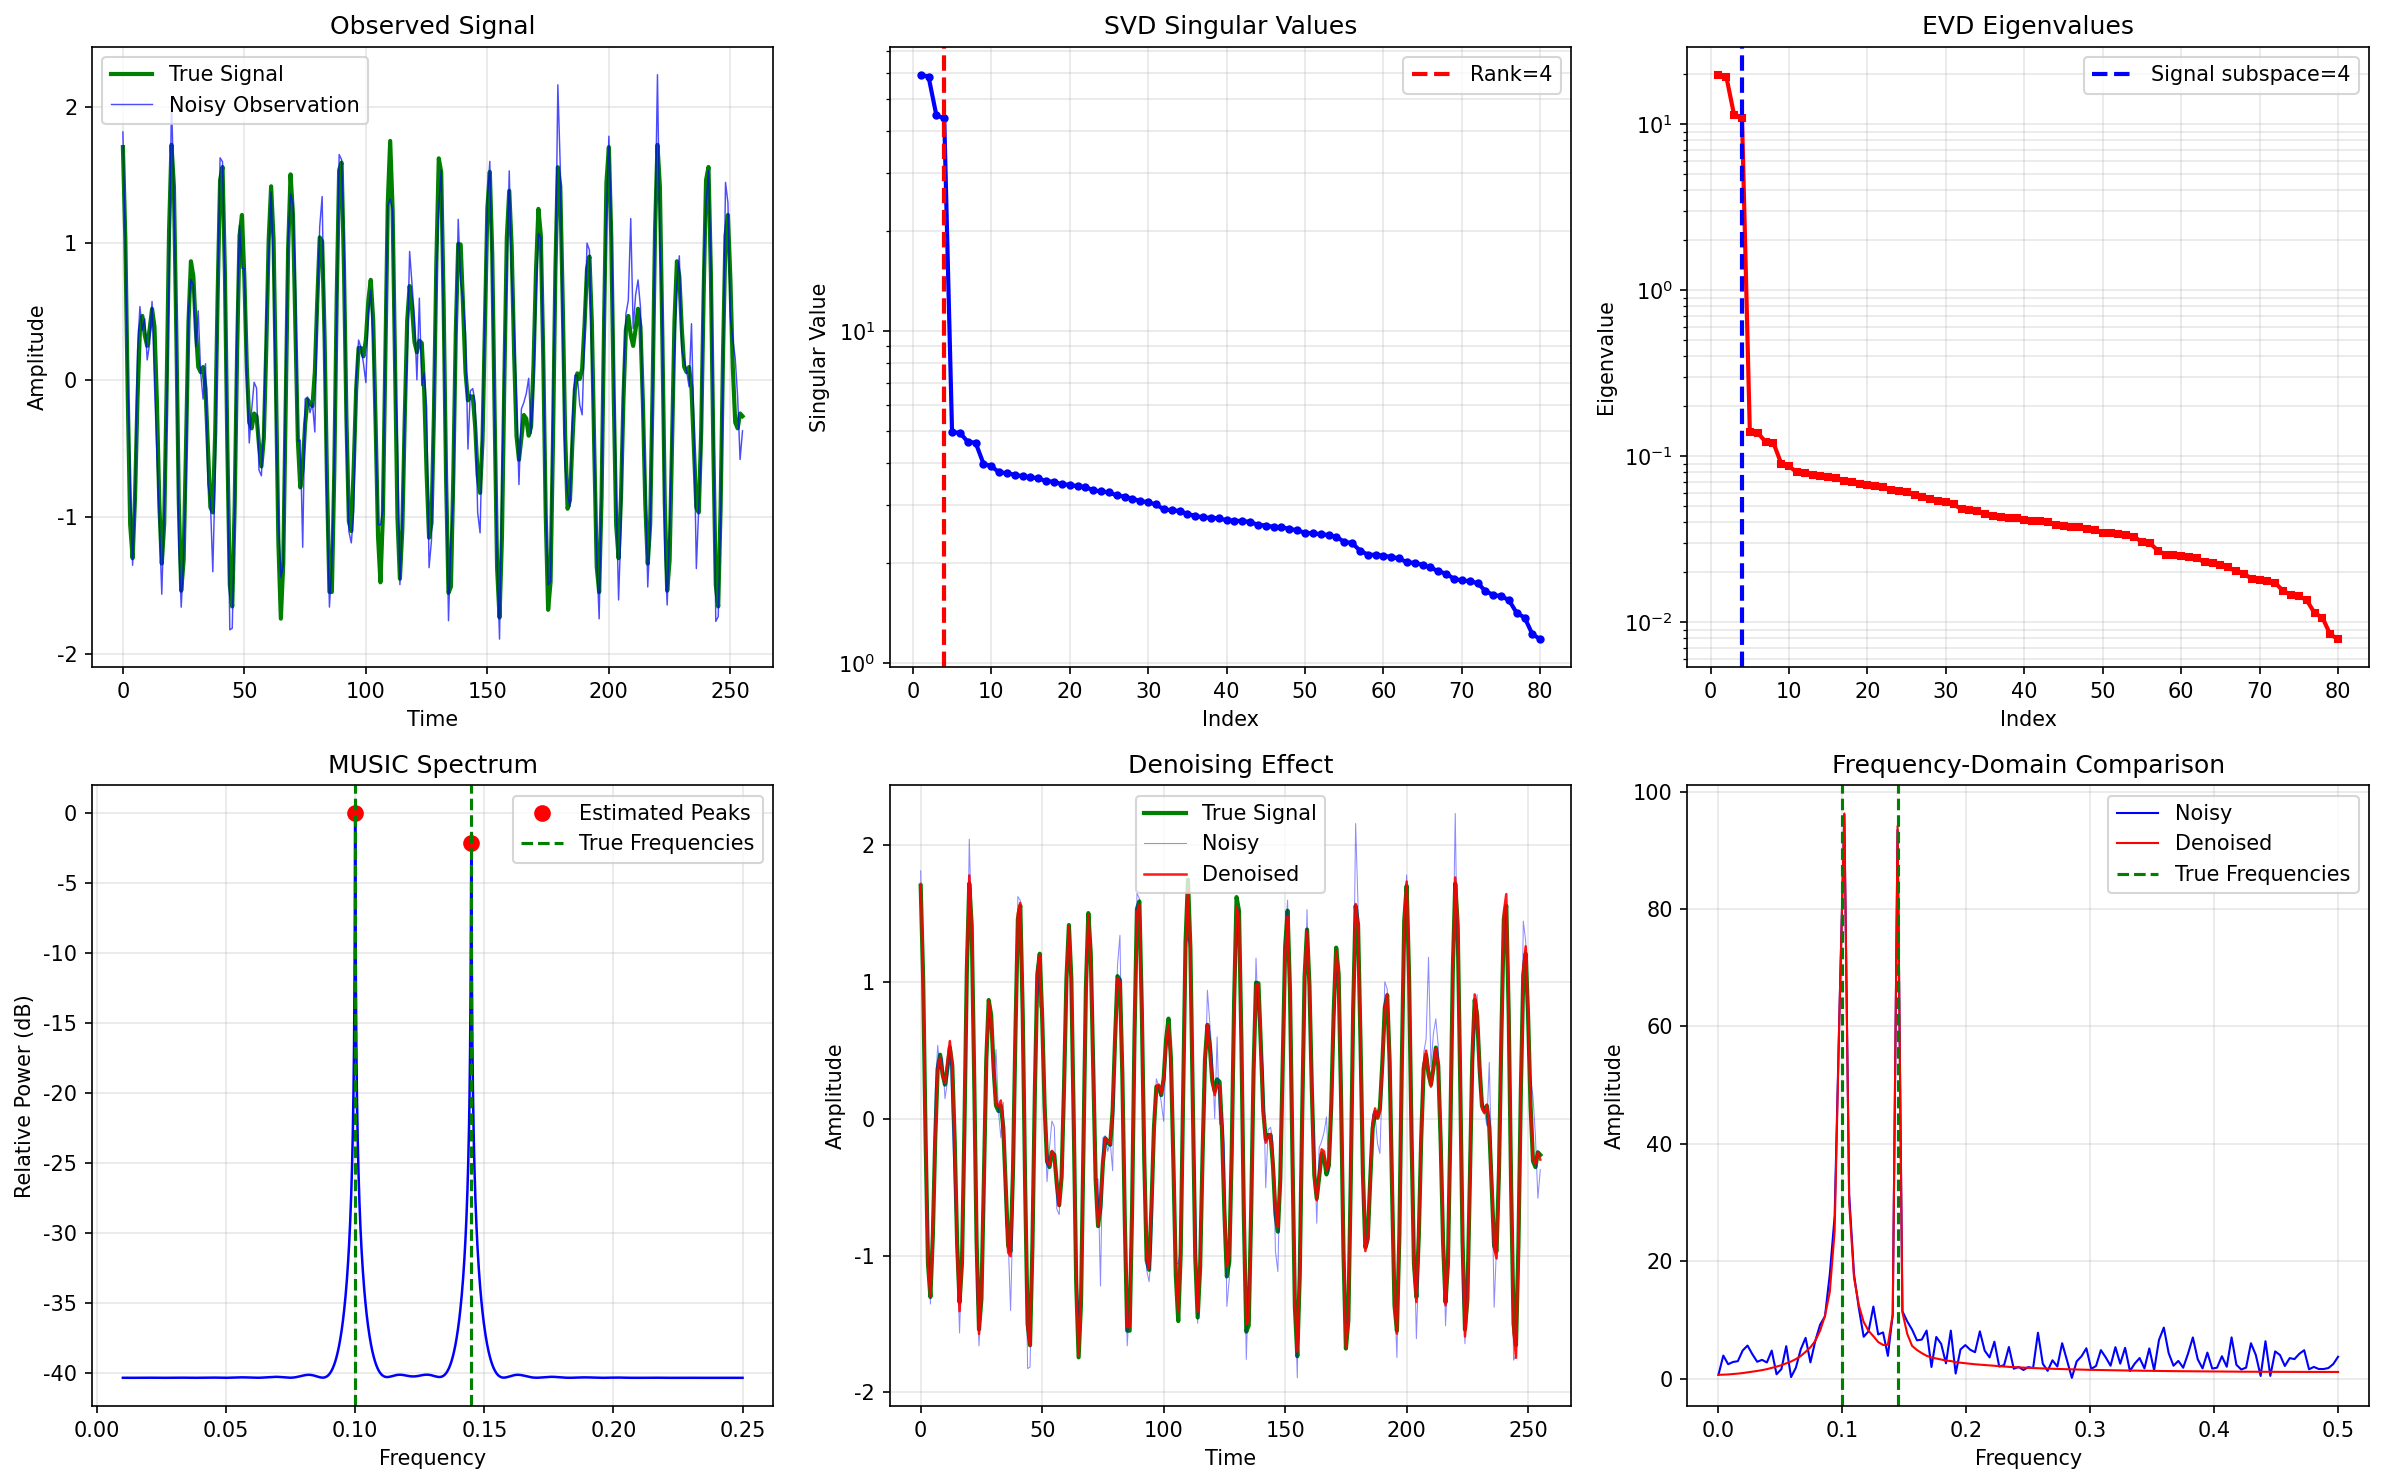
代码文件: code/ch01_dsp/music_algorithm.py
运行方式: python code/ch01_dsp/music_algorithm.py
图1.9:矩阵分解在信号子空间分析中的示意。通过分解协方差矩阵,可以把主要信号结构与噪声成分区分开。
缺点:
- 需要知道信号个数
- 计算复杂度较高
ESPRIT算法(Estimation of Signal Parameters via Rotational Invariance Techniques)
思想: 利用信号的旋转不变性。
特点:
- 利用移位不变结构直接估计参数,不需要像 MUSIC 那样进行谱峰搜索
- 仍依赖阵列或数据模型满足相应的移位不变条件
- 计算量和估计性能取决于矩阵规模、模型匹配程度与 SNR
应用: 频率估计、到达角估计
主成分分析(Principal Component Analysis, PCA)
原理
问题: 如何从高维数据中提取主要特征?
方法: 找到方差最大的方向。
步骤:
中心化数据
计算协方差矩阵
EVD分解
选择主成分 选择特征值最大的
个特征向量 降维
这里
表示按数学编号取前 个特征向量;若使用 Python,则对应切片通常是 Q[:, :K]。
在信号处理中的应用
1. 信号去噪
思想: 信号集中在少数几个主成分,噪声分散在所有主成分。
方法:
- 对信号进行PCA
- 保留主要的主成分
- 丢弃小的主成分(主要是噪声)
- 重构信号
2. 特征提取
应用: 从复杂信号中提取关键特征。
例子:
- 语音识别:从语谱图提取主要特征
- 人脸识别:从人脸图像提取特征脸(eigenfaces)
- 心电图分析:提取心跳的主要特征
PCA、SVD 以及基于滤波器组的特征(如 MFCC、HOG、SIFT)都可用于压缩或描述信号。PCA 和 SVD 按线性代数准则选择方向,手工特征由设计者规定变换;神经网络则根据训练目标学习表示。三者的假设与适用范围不同,详见 第3章深度学习基础。
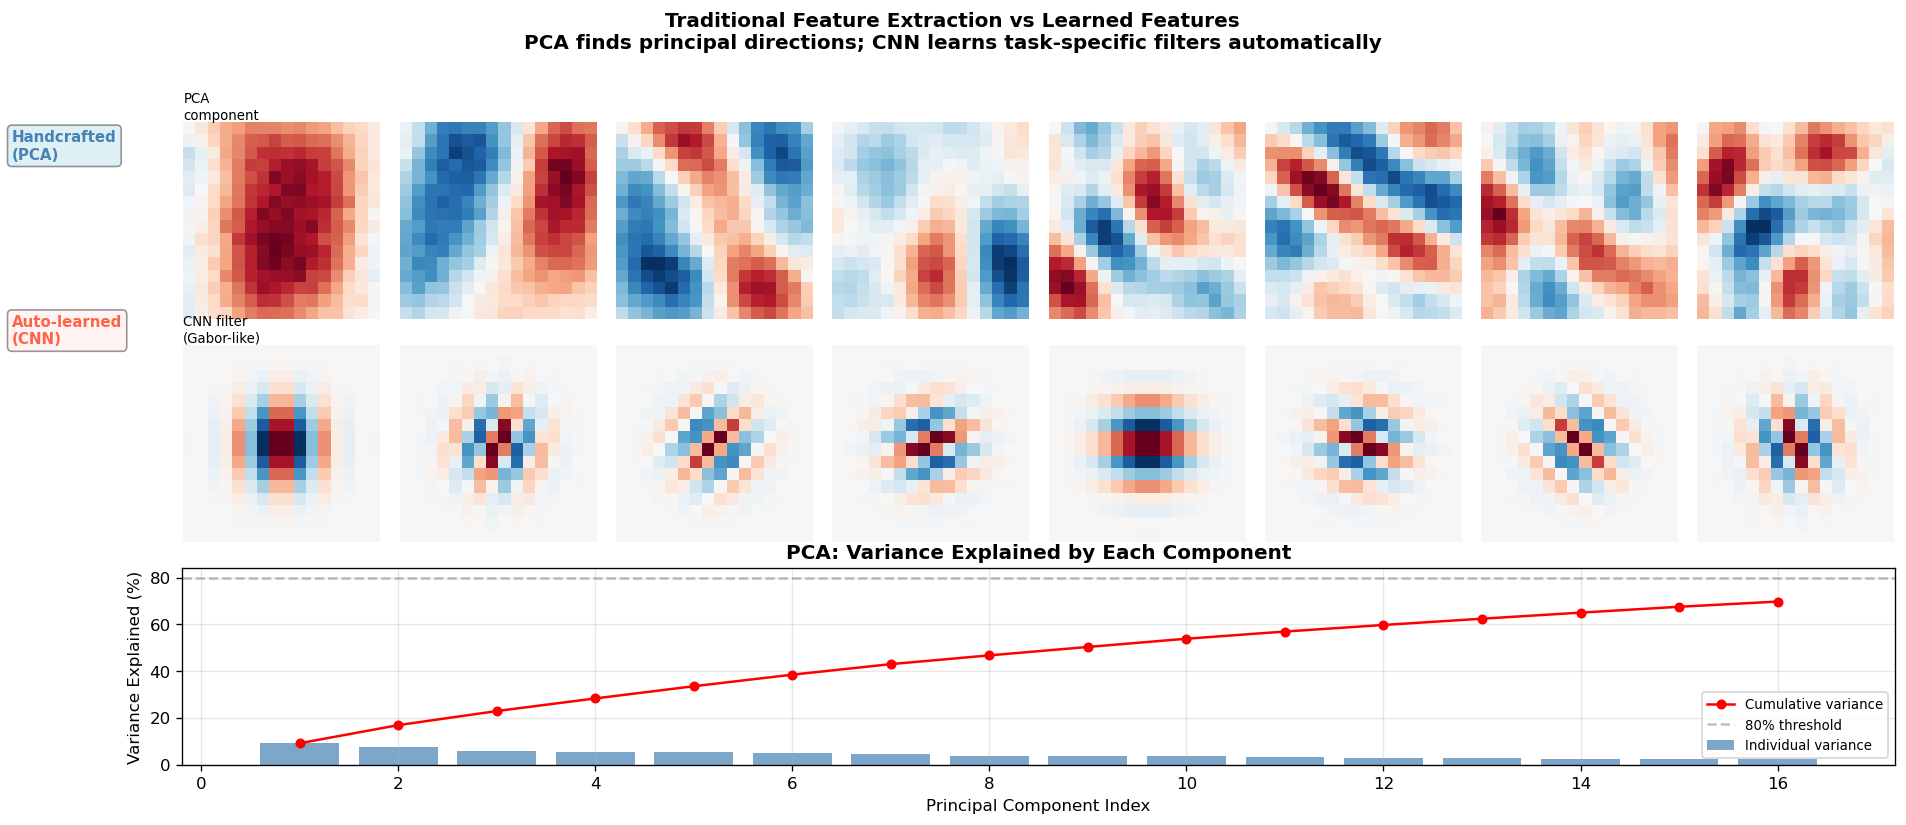
图1.8b:传统特征提取与深度学习特征的对比。上行:PCA 主成分,通过统计方差最大化方向手工提取;中行:CNN 学到的 Gabor 类滤波器,通过任务驱动自动优化;下行:PCA 各主成分解释的方差比例,少数主成分即可覆盖大部分信息。
代码文件: code/ch01_dsp/feature_extraction_comparison.py
运行方式: python code/ch01_dsp/feature_extraction_comparison.py
3. 数据压缩
思想: 用少数主成分表示原始数据。
保留维度比例:
其中
低秩近似和去噪
低秩近似
问题: 用低秩矩阵近似原始矩阵。
方法: 使用SVD的截断版本。
其中
性质: 根据 Eckart--Young--Mirsky 定理,截断 SVD 在所有秩不超过
信号去噪
观测模型:
其中
去噪方法:
SVD分解
阈值处理
重构
优点:
- 简单有效
- 保留信号结构
从子空间到频率估计
MUSIC 先把协方差矩阵的特征向量分成信号子空间和噪声子空间,再寻找与噪声子空间近似正交的导向向量。实验中的实信号包含两个正弦分量,因此 Hankel 矩阵的理想信号秩取 4。
代码文件: code/ch01_dsp/music_algorithm.py
运行方式: python code/ch01_dsp/music_algorithm.py
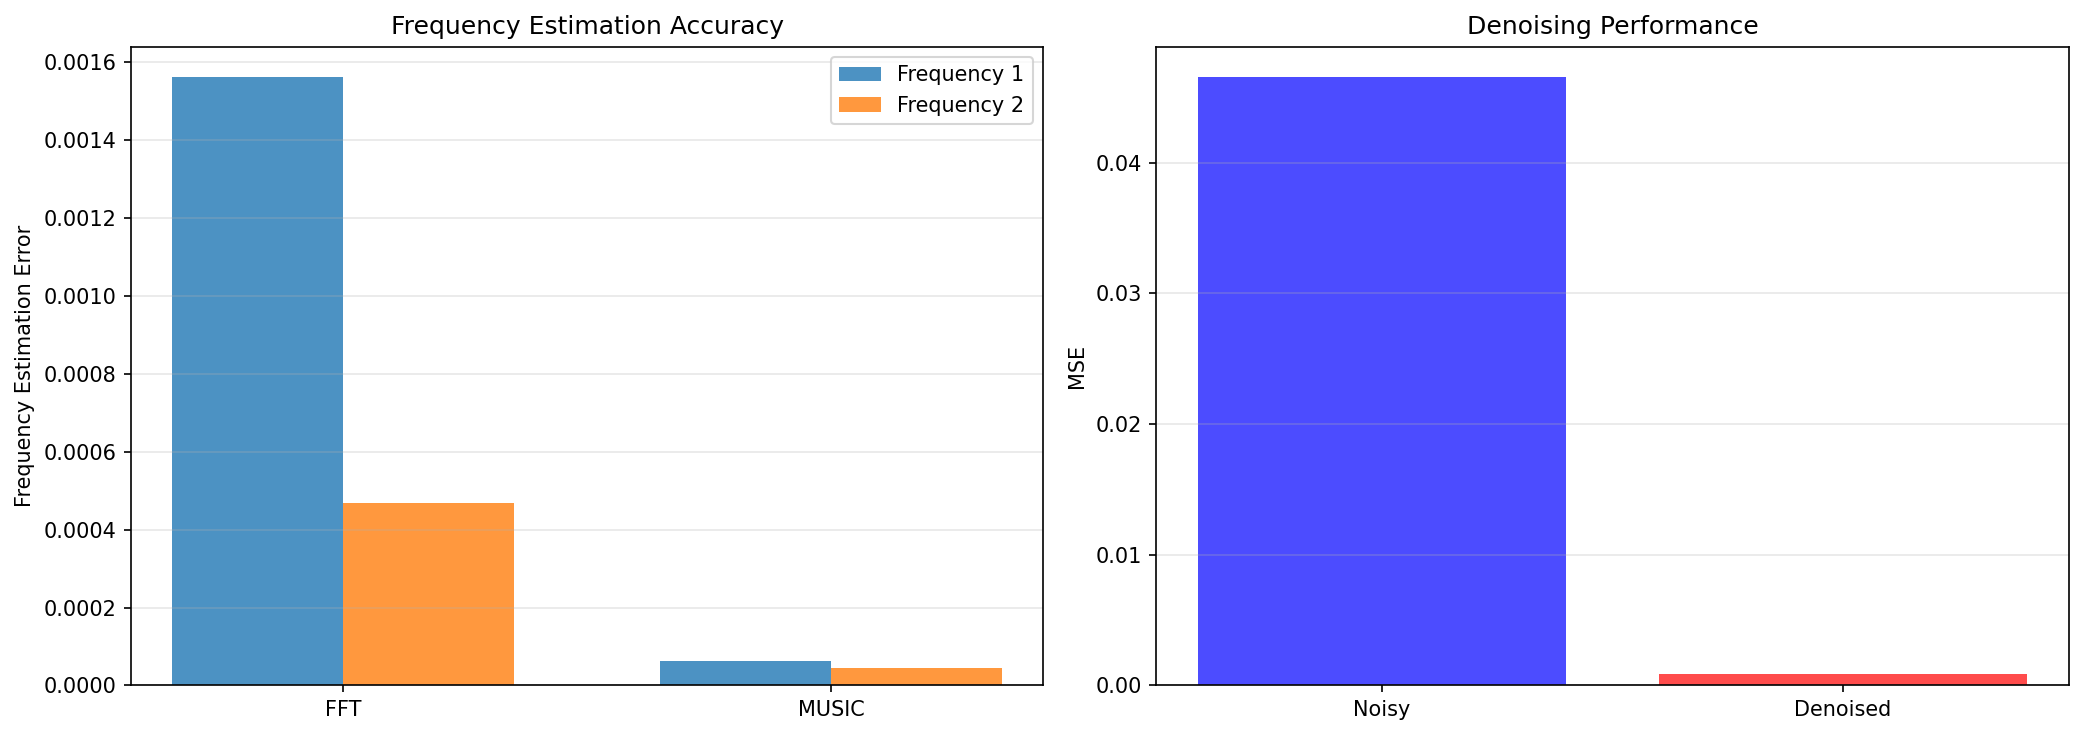
图 1.10:同一次实验中的两个步骤。左图按设定秩划分信号与噪声子空间,右图用噪声子空间构造 MUSIC 伪谱并读取峰值。参数为
子空间方法还可用于阵列到达角估计;低秩近似可用于去噪和压缩。能否获得更小误差,取决于信号数估计、样本量、噪声模型和信号间隔。
本节小结
本节的关键不是记住算法清单,而是理解三个操作:用特征值或奇异值判断主要维度,用子空间正交性寻找信号参数,用截断分解完成低秩重构。
与后续章节的联系
矩阵分解提供了后续章节会反复使用的语言:主方向对应表示压缩,低秩约束对应参数或特征的有效维度,正交化关系到数值稳定性。这里先掌握“分解—选择—重构”的过程,不需要提前套用到所有模型。
下一章: 第2章:优化与机器学习