
5.2 训练数据
核心问题: 如何设计、清洗和验证语言模型训练数据?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
数据预算不只是 token 数量
训练结果同时受模型规模、数据覆盖、重复率、质量规则和训练步数影响。不同公开模型的结果通常不是控制变量实验,不能只根据参数量或 token 数判断某种数据方案更好。
建立数据方案时,先回答:
- 目标任务和语言是什么;
- 数据是否允许用于训练及发布;
- 各来源包含哪些重复、隐私、有害内容和评测污染;
- 如何用消融实验判断某类数据的增量作用。
数据类型与用途
| 数据类型 | 可能提供的训练信号 | 需要检查的风险 |
|---|---|---|
| 网页与百科 | 广泛主题和语言表达 | 垃圾页、重复、过时事实、版权 |
| 书籍与长文 | 长距离上下文和连贯写作 | 授权、领域偏差 |
| 代码 | 形式语法、API 使用和可执行反馈 | 许可证、密钥、脆弱代码 |
| 论文与专业文本 | 领域术语和论述结构 | 覆盖不均、版本和授权 |
| 对话与论坛 | 口语和交互格式 | 隐私、攻击性内容、低质量回答 |
| 合成数据 | 可控制任务和格式 | 生成模型错误、模式单一、数据闭环 |
预训练、指令微调和偏好优化需要的数据结构不同:
预训练:连续文本或代码 → 学习条件 token 分布
SFT:指令 + 参考回答 → 学习任务与输出格式
偏好训练:指令 + 回答对 + 排序 → 调整回答偏好
代码或合成数据是否改善通用推理,必须在目标模型和独立评测集上验证,不能由数据形式直接推出。
清洗管线
1. 记录来源与许可
为每批数据保存来源、抓取时间、许可或使用依据、语言、处理版本和负责人。无法说明来源的数据很难在后期审计或删除。
2. 解析与规范化
去除网页模板、损坏编码和无意义控制字符,并保留文档边界、标题和代码块等必要结构。规范化规则应版本化,避免同一原始数据得到不可复现的结果。
3. 去重
- 精确去重处理相同文档;
- 段落级去重减少大量转载内容;
- MinHash 等近似方法处理轻微改写或模板重复。
去重阈值过严可能删除合法的公式、代码模板或固定表达,因此要按数据类型抽样检查。
4. 质量与安全过滤
长度、语言、字符比例和模型评分都可以作为过滤特征,但单一阈值容易误删方言、代码或专业文档。隐私信息、有害内容和凭证泄漏需要单独检测,并保留抽样复核记录。
5. 评测污染检查
训练数据若包含评测题目或近似答案,分数会高估泛化能力。应在训练前保存评测集指纹,检查精确与近似重合,并记录排除规则。
数据配比
数据配比是采样概率,不等同于磁盘文件大小。分词方式、样本长度、重复采样和训练轮数都会改变某类数据实际贡献的 token 数。
一种可检查的流程是:
- 设定与产品目标对应的语言、领域和任务指标;
- 建立基础混合比例;
- 每次只调整一类数据或一个清洗规则;
- 在固定训练预算下比较验证损失和下游指标;
- 同时检查能力退化,例如增加代码后自然语言任务是否下降。
没有通用的最佳比例。公开模型的数据配方可以作为实验起点,不能直接当作当前项目的答案。
合成数据
合成数据适合补充格式明确、可自动校验的任务,例如代码单元测试、数学题答案或结构化输出。生成后至少应做:
- 规则或执行验证;
- 与原始语料及评测集去重;
- 随机人工抽查;
- 生成模型、提示词和筛选规则留档;
- 与真实数据混合比例的消融实验。
反复使用同一模型生成并筛选数据,可能放大其错误和表达模式。增加合成样本数量不等于增加有效信息。
数据版本与评测记录
每次训练应能追溯到明确的数据清单:
数据版本与哈希
各来源文档数和 token 数
语言、领域和质量分布
去重与过滤规则版本
许可和删除记录
评测集污染检查结果
只有训练配置和数据版本同时固定,模型结果才具备可复现性。
代码实验
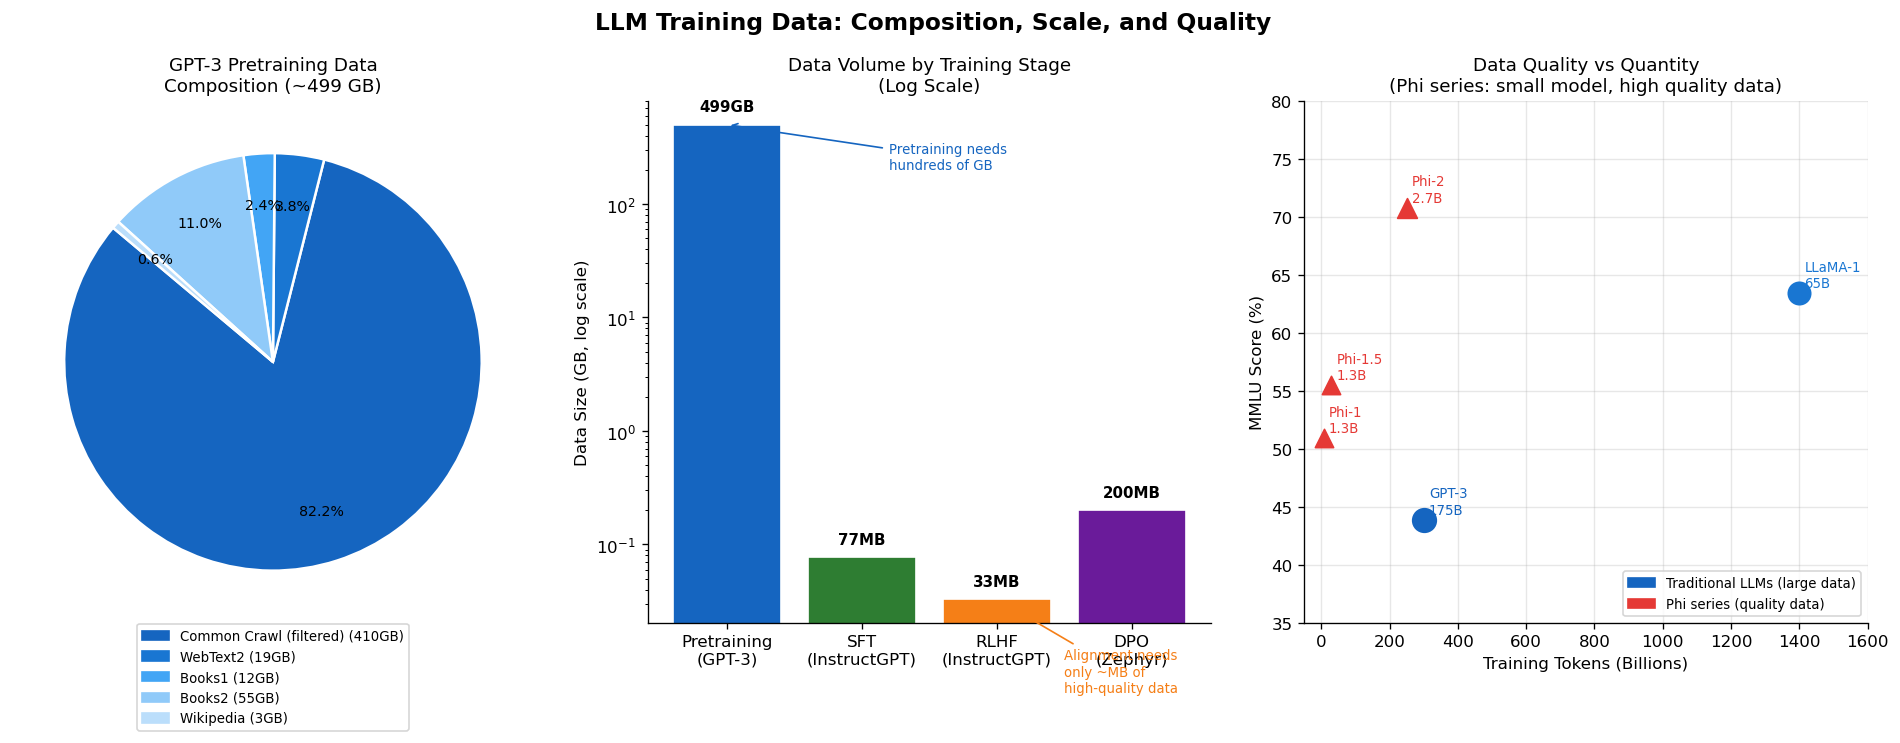
图5.2:示例数据配比与清洗流程。比例用于演示分析方法,不是推荐配方。
代码文件: code/ch05_llm_basics/training_data_composition.py
运行方式: python code/ch05_llm_basics/training_data_composition.py
修改一类数据的采样比例,并同时记录总 token 预算,避免把“比例变化”和“训练量变化”混在一起。
本节小结
- 数据来源、许可、重复、污染和配比都需要版本化记录。
- 数据质量不能由单个过滤分数或“精选”标签代表。
- 配比与合成数据的作用应通过固定预算的消融实验验证。
下一节: 5.3 模型家族与选型